Retrieval-augmented generation (RAG) dengan cepat menjadi salah satu evolusi paling praktis dalam penggunaan model bahasa besar. Ini bukan model baru atau pengganti LLM; melainkan sistem inovatif yang membantu LLM bernalar menggunakan fakta yang diambil dari sumber data nyata. Intinya, RAG memecahkan beberapa tantangan terbesar dalam AI generatif: halusinasi, memori terbatas, dan pengetahuan usang. Menggabungkan retrieval dan generation dalam satu pipeline memungkinkan model menambatkan jawabannya pada konteks yang mutakhir dan relevan, sering kali spesifik untuk bisnis atau domain.
Perubahan ini kini semakin penting. Di lingkungan enterprise, LLM diharapkan menjawab dengan akurasi dan keterjelasan alasan. Pengembang menginginkan keluaran yang mencerminkan dokumentasi produk, wiki internal, atau tiket dukungan, bukan pengetahuan web generik. RAG mewujudkannya.
Panduan ini menjelaskan cara kerja framework RAG, posisi RAG dalam tumpukan AI Anda, dan cara menggunakannya dengan alat serta data fundamental.
Apa Itu Framework RAG?
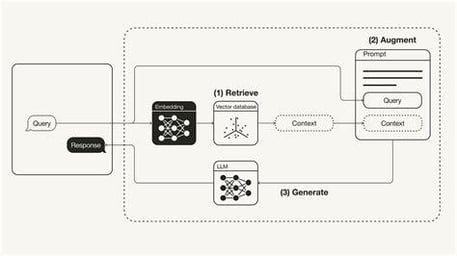
RAG adalah singkatan dari Retrieve, Augment, Generate. Ini cara cerdas untuk memberi model bahasa besar (LLM) akses ke pengetahuan eksternal tanpa melatih ulang model.
Gagasannya seperti ini: ketika pengguna mengajukan pertanyaan, alih-alih langsung melempar pertanyaan itu ke model dan berharap jawabannya bagus, RAG terlebih dahulu mengambil (retrieve) informasi relevan dari basis pengetahuan. Lalu, ia memperkaya (augment) prompt asli dengan konteks tambahan ini. Terakhir, LLM menghasilkan respons menggunakan pertanyaan dan informasi tambahan.
Pendekatan ini membantu mengatasi keterbatasan utama LLM—seperti halusinasi, memori pendek (context window), dan cutoff pengetahuan—dengan memasukkan data nyata, terkini, dan relevan secara langsung.
Mengapa Menggunakan Framework RAG?
LLM mandiri memang mengesankan, tetapi punya titik buta. Mereka bisa berhalusinasi, mudah lupa, dan tidak mengetahui apa pun yang lebih baru daripada saat terakhir dilatih. RAG mengubah itu. Dengan menggabungkan LLM dan retrieval real-time, Anda mendapatkan:
- Akurasi faktual: Respons didasarkan pada data Anda yang sebenarnya, bukan tebakan.
- Relevansi domain: Anda bisa menyuntikkan pengetahuan khusus atau internal.
- Tanpa perlu pelatihan ulang: Cukup perbarui basis pengetahuan Anda—tidak perlu fine-tuning.
- Skalabilitas: Cocok untuk chatbot, alat pencarian, asisten dukungan, dan banyak lagi.
Singkatnya, RAG memungkinkan Anda membangun sistem AI yang lebih cerdas dan tepercaya dengan upaya jauh lebih sedikit.
Framework RAG Sumber Terbuka Terbaik
Ekosistem RAG tumbuh pesat, dengan puluhan proyek sumber terbuka yang membantu pengembang membangun aplikasi cerdas berbasis retrieval. Baik Anda mencari sesuatu yang plug-and-play dan sederhana atau pipeline full-stack dengan komponen yang dapat dikustomisasi, kemungkinan besar ada alat yang cocok untuk Anda.
Di bawah ini, kami akan meninjau framework RAG sumber terbuka teratas. Setiap entri menyoroti daya tarik GitHub, gaya deployment, kekuatan unik, use case utama, dan visual untuk memberi gambaran cepat tentang proyeknya.
1. Haystack
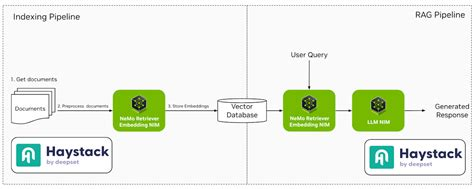
Haystack adalah framework modular yang tangguh, dirancang untuk membangun sistem NLP siap produksi. Ia mendukung berbagai komponen seperti retriever, reader, dan generator, memungkinkan integrasi mulus dengan alat seperti Elasticsearch dan Hugging Face Transformers.
- Bintang GitHub: ~13,5 ribu
- Deployment: Docker, Kubernetes, Hugging Face Spaces
- Fitur unggulan: Komponen modular, integrasi kuat dengan Hugging Face, dukungan multibahasa
- Use case: Sistem QA kelas enterprise, chatbot, pencarian dokumen internal (TrueFoundry, Anyscale, LobeHub)
2. LlamaIndex
LlamaIndex adalah kerangka data yang menghubungkan sumber data kustom ke model bahasa besar. Ia menyederhanakan proses pengindeksan dan kueri data, sehingga lebih mudah membangun aplikasi yang memerlukan respons kontekstual.
- Bintang GitHub: ~13 ribu
- Deployment: Berbasis Python, berjalan di mana saja dengan data file atau web
- Fitur unggulan: Abstraksi sederhana untuk indexing, retrieval, dan routing
- Use case: Asisten pribadi, bot pengetahuan, demo RAG (GitHub)
3. LangChain
LangChain adalah framework komprehensif yang memungkinkan pengembang membangun aplikasi yang didukung model bahasa. Ia menawarkan alat untuk merangkai berbagai komponen seperti template prompt, memori, dan agen guna menciptakan alur kerja yang kompleks.
- Bintang GitHub: ~72 ribu
- Deployment: Python, JavaScript, didukung di semua cloud besar
- Fitur unggulan: Perangkaian alat, agen, template prompt, integrasi melimpah
- Use case: Aplikasi LLM end-to-end, agen data, alur chat dinamis
4. RAGFlow
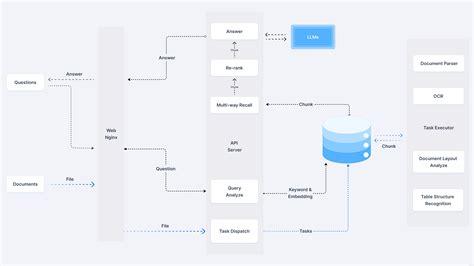
RAGFlow adalah mesin sumber terbuka yang berfokus pada pemahaman dokumen mendalam. Ia menyediakan alur kerja ringkas bagi bisnis untuk menerapkan sistem RAG, menekankan tanya jawab yang faktual dengan kutipan dari format data kompleks.
- Bintang GitHub: ~1,1 ribu
- Deployment: Docker; mendukung microservices berbasis FastAPI
- Fitur unggulan: Visualizer chunk, integrasi Weaviate, konfigurasi fleksibel
- Use case: Backend RAG ringan, prototipe enterprise (jina.ai)
5. txtAI
txtAI adalah framework AI serba ada yang menggabungkan pencarian semantik dengan kapabilitas RAG. Ia memungkinkan pembangunan aplikasi yang secara efisien mencari, mengindeks, dan mengambil informasi, mendukung berbagai tipe dan format data.
- Bintang GitHub: ~3,9 ribu
- Deployment: Berbasis Python; berjalan hanya dengan beberapa baris kode.
- Fitur unggulan: Sangat ringan, mode offline, dukungan penilaian/pemeringkatan
- Use case: Mesin pencari berbasis embedding, chat dengan PDF, tanya jawab metadata (Introduction | LangChain, GitHub, GitHub)
6. Cognita
Cognita adalah framework RAG modular yang dirancang untuk kustomisasi dan deployment yang mudah. Ia menawarkan antarmuka frontend untuk bereksperimen dengan berbagai konfigurasi RAG, cocok untuk lingkungan pengembangan maupun produksi.
- Bintang GitHub: Signifikan
- Deployment: Docker + integrasi TrueFoundry
- Fitur unggulan: Berbasis API, siap UI, mudah diskalakan
- Use case: Asisten AI untuk bisnis, chatbot berbasis data (TrueFoundry, LlamaIndex)
7. LLMWare
LLMWare menyediakan framework terpadu untuk membangun aplikasi RAG kelas enterprise. Ia menekankan penggunaan model kecil yang terspesialisasi dan dapat dideploy secara privat, memastikan keamanan dan kepatuhan data.
- Bintang GitHub: ~2,5 ribu
- Deployment: Alat CLI, API, templat proyek yang dapat dikustomisasi
- Fitur unggulan: Pipeline tanpa kode, alat parsing dokumen
- Use case: Agen dokumen, asisten pengetahuan (LinkedIn)
8. STORM
STORM adalah asisten riset yang memperluas konsep RAG berbasis garis besar. Ia berfokus pada pembuatan artikel komprehensif dengan mensintesis informasi dari berbagai sumber, ideal untuk tugas pembuatan konten.
- Bintang GitHub: Niche
- Deployment: Instalasi source code
- Fitur unggulan: Mesin penalaran Co-STORM, eksplorasi berbasis graf
- Use case: Setup RAG kustom, pipa QA riset (GitHub)
9. R2R
R2R (Reason to Retrieve) adalah sistem retrieval AI tingkat lanjut yang mendukung RAG dengan fitur siap produksi. Ia menawarkan pemasukan konten multimodal, pencarian hibrida, dan integrasi knowledge graph, memenuhi kebutuhan enterprise yang kompleks.
10. EmbedChain
EmbedChain adalah pustaka Python yang memudahkan pembuatan dan deployment aplikasi AI menggunakan model RAG. Ia mendukung berbagai tipe data, termasuk PDF, gambar, dan halaman web, sehingga serbaguna untuk berbagai use case.
- Bintang GitHub: ~3,5 ribu
- Deployment: Pustaka Python, juga tersedia sebagai SaaS hosted
- Fitur unggulan: Penyiapan aplikasi dengan satu perintah, berorientasi API
- Use case: Prototyping cepat, membangun bot pengetahuan untuk bidang apa pun (LLMWare AI for Complex Enterprises)
11. RAGatouille
RAGatouille mengintegrasikan metode retrieval tingkat lanjut seperti ColBERT ke dalam pipeline RAG. Ia memungkinkan eksperimen modular dengan berbagai teknik retrieval, meningkatkan fleksibilitas dan kinerja sistem RAG.
- Bintang GitHub: Niche namun berkembang
- Deployment: Paket Python
- Fitur unggulan: Eksperimen retrieval, input modular
- Use case: Mengevaluasi teknik retrieval dalam pipeline RAG
12. Verba
Verba adalah asisten personal yang dapat dikustomisasi dan memanfaatkan RAG untuk melakukan kueri dan berinteraksi dengan data. Ia terintegrasi dengan database kontekstual Weaviate, memungkinkan pengambilan dan interaksi informasi yang efisien.
- Bintang GitHub: Moderat
- Deployment: Didukung lokal dan cloud
- Fitur unggulan: Memori kontekstual, tanya jawab data personal
- Use case: Membangun asisten sendiri, eksplorasi data (LinkedIn, Brandfetch)
13. Jina AI
Jina AI menawarkan alat untuk membangun aplikasi AI multimodal dengan opsi deployment yang dapat diskalakan. Ia mendukung berbagai protokol komunikasi, sehingga cocok bagi pengembang yang ingin membangun dan menskalakan layanan AI.
- Bintang GitHub: ~18 ribu (organisasi utama)
- Deployment: Docker, REST/gRPC/WebSocket API
- Fitur unggulan: Pipeline multimodal, pencarian hibrida
- Use case: Aplikasi kelas enterprise yang menggabungkan teks, gambar, atau video
14. Neurite
Neurite adalah framework RAG yang sedang berkembang dan menyederhanakan pembuatan aplikasi bertenaga AI. Penekanannya pada pengalaman pengembang dan prototyping cepat membuatnya menarik untuk eksperimen.
- Bintang GitHub: Kecil namun menjanjikan
- Deployment: Source setup
- Fitur unggulan: Fusi neural-simbolik
- Use case: Eksperimen riset AI, prototipe sistem (GitHub, Hugging Face, GitHub)
15. LLM-App
LLM-App adalah framework untuk membangun aplikasi yang didukung model bahasa besar. Ia menyediakan templat dan alat untuk merampingkan proses pengembangan, sehingga lebih mudah mengintegrasikan kapabilitas RAG ke berbagai aplikasi.
- Bintang GitHub: Berkembang
- Deployment: Deployment berbasis Git dan alat CLI
- Fitur unggulan: Templat awal aplikasi, siap OpenAI
- Use case: Proyek RAG personal, alat hackathon
Setiap framework menawarkan fitur unik yang disesuaikan untuk berbagai use case dan preferensi deployment. Bergantung pada kebutuhan spesifik Anda—kemudahan deployment, kustomisasi, atau kapabilitas integrasi—pilih framework yang paling selaras dengan tujuan proyek Anda.
Memilih Framework RAG yang Tepat
Memilih framework RAG yang tepat bergantung pada kebutuhan spesifik Anda: analisis dokumen legal, riset akademik, atau pengembangan lokal yang ringan. Gunakan tabel ini untuk membandingkan cepat framework RAG sumber terbuka populer berdasarkan cara deployment, tingkat kustomisasi, dukungan untuk retrieval lanjutan, kapabilitas integrasi, dan kegunaan terbaik tiap alat.
|
Framework
|
Deployment
|
Kustomisasi
|
Retrieval Lanjutan
|
Dukungan Integrasi
|
Terbaik Untuk
|
|
Haystack
|
Docker, K8s, Hugging Face
|
Tinggi
|
Ya
|
Elasticsearch, Hugging Face
|
Pencarian & QA enterprise
|
|
LlamaIndex
|
Python (lokal/cloud)
|
Tinggi
|
Ya
|
LangChain, FAISS
|
Bot sadar dokumen
|
|
LangChain
|
Python, JS, Cloud
|
Tinggi
|
Ya
|
OpenAI, API, DB
|
Agen & pipeline LLM
|
|
RAGFlow
|
Docker
|
Sedang
|
Ya
|
Weaviate
|
Dokumen legal/terstruktur
|
|
txtAI
|
Lokal (Python)
|
Sedang
|
Dasar
|
Transformers
|
Pengembangan lokal ringan
|
|
Cognita
|
Docker + UI
|
Tinggi
|
Ya
|
TrueFoundry
|
Alat bisnis berbasis GUI
|
|
LLMWare
|
CLI, API
|
Tinggi
|
Ya
|
LLM privat
|
RAG enterprise privat
|
|
STORM
|
Instal sumber
|
Tinggi
|
Ya
|
LangChain, LangGraph
|
Asisten riset
|
|
R2R
|
REST API
|
Tinggi
|
Ya
|
Multimodal
|
RAG akademik & hibrida
|
|
EmbedChain
|
Python, SaaS
|
Sedang
|
Dasar
|
Web, PDF, Gambar
|
Prototyping cepat
|
|
RAGatouille
|
Python
|
Tinggi
|
Ya
|
ColBERT
|
Eksperimen retriever
|
|
Verba
|
Cloud/Lokal
|
Sedang
|
Dasar
|
Weaviate
|
Asisten kontekstual
|
|
Jina AI
|
Docker, REST/gRPC
|
Tinggi
|
Ya
|
API multimodal
|
Aplikasi multimodal yang skalabel
|
|
Neurite
|
Source setup
|
Sedang
|
Tidak
|
N/A
|
Eksperimentasi
|
|
LLM-App
|
CLI, Git
|
Sedang
|
Tidak
|
OpenAI
|
Aplikasi LLM untuk hackathon
|
Jebakan Umum saat Menerapkan RAG
Sistem RAG bisa tangguh, tetapi juga punya sisi tajam. Jika tidak hati-hati, jawaban model Anda bisa jadi lebih buruk daripada tanpa retrieval sama sekali. Berikut empat masalah umum yang perlu dihindari—dan apa yang sebaiknya dilakukan.
1. Mengindeks terlalu banyak "sampah"
Tidak semua hal perlu dimasukkan ke vector store Anda. Menjejalkan setiap dokumen, posting blog, atau utas email mungkin terasa menyeluruh, tetapi itu hanya mencemari pencarian. Retriever menarik konteks bernilai rendah yang harus disaring oleh model (sering kali disalahgunakan). Sebaliknya, bersikaplah selektif. Hanya indeks konten yang akurat, tertulis dengan baik, dan bermanfaat. Rapikan sebelum menyimpan.
2. Mengabaikan batas token
LLM punya memori pendek. Jika prompt Anda, ditambah semua potongan yang diambil, melampaui batas token model, akan ada bagian yang terpotong. Bagian itu bisa jadi yang paling penting. Sebagai gantinya, buat prompt ringkas. Batasi jumlah potongan yang diambil atau ringkas terlebih dahulu sebelum dikirim ke model.
3. Mengoptimalkan untuk recall, bukan presisi
Mengambil lebih banyak dokumen demi "mencakup semuanya" memang menggoda. Namun jika hasil tambahan hanya terkait samar, Anda memenuhi prompt dengan hal yang tidak penting. Model menjadi terdistraksi atau—lebih buruk lagi—bingung. Alih-alih, kejarlah presisi tinggi. Beberapa potongan yang sangat relevan lebih baik daripada daftar panjang kecocokan lemah.
4. Terbang buta tanpa log
Saat model memberi jawaban buruk, apakah Anda tahu penyebabnya? Jika Anda tidak mencatat kueri, dokumen yang diambil, dan prompt akhir, Anda sedang mengurai masalah dalam gelap. Sebaliknya, catat alur RAG secara penuh. Termasuk masukan pengguna, konten yang diambil, apa yang dikirim ke model, dan respons model.
Kesimpulan
RAG bukan obat mujarab untuk semua masalah, tetapi jika digunakan dengan benar, ini adalah salah satu cara paling efektif untuk membuat LLM lebih cerdas, praktis, dan berpijak pada data yang penting bagi bisnis Anda.
Kuncinya adalah memahami apa yang Anda kerjakan. Memilih framework yang tepat adalah bagiannya, tetapi keberhasilan bergantung pada seberapa baik Anda memahami data Anda dan seberapa cermat Anda menyetel pipeline retrieval. Prinsip garbage in, garbage out tetap berlaku, apalagi saat Anda membangun sistem yang menghasilkan bahasa, bukan sekadar mengambil fakta.
Pastikan pengindeksan Anda tepat, perhatikan penggunaan token, dan pantau alurnya dari ujung ke ujung. Ketika semua bagian itu selaras, RAG dapat mentransformasi aplikasi AI Anda dari sekadar mengesankan menjadi benar-benar membantu.





Retrieval-augmented generation (RAG) dengan cepat menjadi salah satu evolusi paling praktis dalam penggunaan model bahasa besar. Ini bukan model baru atau pengganti LLM; melainkan sistem inovatif yang membantu LLM bernalar menggunakan fakta yang diambil dari sumber data nyata. Intinya, RAG memecahkan beberapa tantangan terbesar dalam AI generatif: halusinasi, memori terbatas, dan pengetahuan usang. Menggabungkan retrieval dan generation dalam satu pipeline memungkinkan model menambatkan jawabannya pada konteks yang mutakhir dan relevan, sering kali spesifik untuk bisnis atau domain.
Perubahan ini kini semakin penting. Di lingkungan enterprise, LLM diharapkan menjawab dengan akurasi dan keterjelasan alasan. Pengembang menginginkan keluaran yang mencerminkan dokumentasi produk, wiki internal, atau tiket dukungan, bukan pengetahuan web generik. RAG mewujudkannya.
Panduan ini menjelaskan cara kerja framework RAG, posisi RAG dalam tumpukan AI Anda, dan cara menggunakannya dengan alat serta data fundamental.
Apa Itu Framework RAG?
RAG adalah singkatan dari Retrieve, Augment, Generate. Ini cara cerdas untuk memberi model bahasa besar (LLM) akses ke pengetahuan eksternal tanpa melatih ulang model.
Gagasannya seperti ini: ketika pengguna mengajukan pertanyaan, alih-alih langsung melempar pertanyaan itu ke model dan berharap jawabannya bagus, RAG terlebih dahulu mengambil (retrieve) informasi relevan dari basis pengetahuan. Lalu, ia memperkaya (augment) prompt asli dengan konteks tambahan ini. Terakhir, LLM menghasilkan respons menggunakan pertanyaan dan informasi tambahan.
Pendekatan ini membantu mengatasi keterbatasan utama LLM—seperti halusinasi, memori pendek (context window), dan cutoff pengetahuan—dengan memasukkan data nyata, terkini, dan relevan secara langsung.
Mengapa Menggunakan Framework RAG?
LLM mandiri memang mengesankan, tetapi punya titik buta. Mereka bisa berhalusinasi, mudah lupa, dan tidak mengetahui apa pun yang lebih baru daripada saat terakhir dilatih. RAG mengubah itu. Dengan menggabungkan LLM dan retrieval real-time, Anda mendapatkan:
Singkatnya, RAG memungkinkan Anda membangun sistem AI yang lebih cerdas dan tepercaya dengan upaya jauh lebih sedikit.
Framework RAG Sumber Terbuka Terbaik
Ekosistem RAG tumbuh pesat, dengan puluhan proyek sumber terbuka yang membantu pengembang membangun aplikasi cerdas berbasis retrieval. Baik Anda mencari sesuatu yang plug-and-play dan sederhana atau pipeline full-stack dengan komponen yang dapat dikustomisasi, kemungkinan besar ada alat yang cocok untuk Anda.
Di bawah ini, kami akan meninjau framework RAG sumber terbuka teratas. Setiap entri menyoroti daya tarik GitHub, gaya deployment, kekuatan unik, use case utama, dan visual untuk memberi gambaran cepat tentang proyeknya.
1. Haystack
Haystack adalah framework modular yang tangguh, dirancang untuk membangun sistem NLP siap produksi. Ia mendukung berbagai komponen seperti retriever, reader, dan generator, memungkinkan integrasi mulus dengan alat seperti Elasticsearch dan Hugging Face Transformers.
2. LlamaIndex
LlamaIndex adalah kerangka data yang menghubungkan sumber data kustom ke model bahasa besar. Ia menyederhanakan proses pengindeksan dan kueri data, sehingga lebih mudah membangun aplikasi yang memerlukan respons kontekstual.
3. LangChain
LangChain adalah framework komprehensif yang memungkinkan pengembang membangun aplikasi yang didukung model bahasa. Ia menawarkan alat untuk merangkai berbagai komponen seperti template prompt, memori, dan agen guna menciptakan alur kerja yang kompleks.
4. RAGFlow
RAGFlow adalah mesin sumber terbuka yang berfokus pada pemahaman dokumen mendalam. Ia menyediakan alur kerja ringkas bagi bisnis untuk menerapkan sistem RAG, menekankan tanya jawab yang faktual dengan kutipan dari format data kompleks.
5. txtAI
txtAI adalah framework AI serba ada yang menggabungkan pencarian semantik dengan kapabilitas RAG. Ia memungkinkan pembangunan aplikasi yang secara efisien mencari, mengindeks, dan mengambil informasi, mendukung berbagai tipe dan format data.
6. Cognita
Cognita adalah framework RAG modular yang dirancang untuk kustomisasi dan deployment yang mudah. Ia menawarkan antarmuka frontend untuk bereksperimen dengan berbagai konfigurasi RAG, cocok untuk lingkungan pengembangan maupun produksi.
7. LLMWare
LLMWare menyediakan framework terpadu untuk membangun aplikasi RAG kelas enterprise. Ia menekankan penggunaan model kecil yang terspesialisasi dan dapat dideploy secara privat, memastikan keamanan dan kepatuhan data.
8. STORM
STORM adalah asisten riset yang memperluas konsep RAG berbasis garis besar. Ia berfokus pada pembuatan artikel komprehensif dengan mensintesis informasi dari berbagai sumber, ideal untuk tugas pembuatan konten.
9. R2R
R2R (Reason to Retrieve) adalah sistem retrieval AI tingkat lanjut yang mendukung RAG dengan fitur siap produksi. Ia menawarkan pemasukan konten multimodal, pencarian hibrida, dan integrasi knowledge graph, memenuhi kebutuhan enterprise yang kompleks.
10. EmbedChain
EmbedChain adalah pustaka Python yang memudahkan pembuatan dan deployment aplikasi AI menggunakan model RAG. Ia mendukung berbagai tipe data, termasuk PDF, gambar, dan halaman web, sehingga serbaguna untuk berbagai use case.
11. RAGatouille
RAGatouille mengintegrasikan metode retrieval tingkat lanjut seperti ColBERT ke dalam pipeline RAG. Ia memungkinkan eksperimen modular dengan berbagai teknik retrieval, meningkatkan fleksibilitas dan kinerja sistem RAG.
12. Verba
Verba adalah asisten personal yang dapat dikustomisasi dan memanfaatkan RAG untuk melakukan kueri dan berinteraksi dengan data. Ia terintegrasi dengan database kontekstual Weaviate, memungkinkan pengambilan dan interaksi informasi yang efisien.
13. Jina AI
Jina AI menawarkan alat untuk membangun aplikasi AI multimodal dengan opsi deployment yang dapat diskalakan. Ia mendukung berbagai protokol komunikasi, sehingga cocok bagi pengembang yang ingin membangun dan menskalakan layanan AI.
14. Neurite
Neurite adalah framework RAG yang sedang berkembang dan menyederhanakan pembuatan aplikasi bertenaga AI. Penekanannya pada pengalaman pengembang dan prototyping cepat membuatnya menarik untuk eksperimen.
15. LLM-App
LLM-App adalah framework untuk membangun aplikasi yang didukung model bahasa besar. Ia menyediakan templat dan alat untuk merampingkan proses pengembangan, sehingga lebih mudah mengintegrasikan kapabilitas RAG ke berbagai aplikasi.
Setiap framework menawarkan fitur unik yang disesuaikan untuk berbagai use case dan preferensi deployment. Bergantung pada kebutuhan spesifik Anda—kemudahan deployment, kustomisasi, atau kapabilitas integrasi—pilih framework yang paling selaras dengan tujuan proyek Anda.
Memilih Framework RAG yang Tepat
Memilih framework RAG yang tepat bergantung pada kebutuhan spesifik Anda: analisis dokumen legal, riset akademik, atau pengembangan lokal yang ringan. Gunakan tabel ini untuk membandingkan cepat framework RAG sumber terbuka populer berdasarkan cara deployment, tingkat kustomisasi, dukungan untuk retrieval lanjutan, kapabilitas integrasi, dan kegunaan terbaik tiap alat.
Framework
Deployment
Kustomisasi
Retrieval Lanjutan
Dukungan Integrasi
Terbaik Untuk
Haystack
Docker, K8s, Hugging Face
Tinggi
Ya
Elasticsearch, Hugging Face
Pencarian & QA enterprise
LlamaIndex
Python (lokal/cloud)
Tinggi
Ya
LangChain, FAISS
Bot sadar dokumen
LangChain
Python, JS, Cloud
Tinggi
Ya
OpenAI, API, DB
Agen & pipeline LLM
RAGFlow
Docker
Sedang
Ya
Weaviate
Dokumen legal/terstruktur
txtAI
Lokal (Python)
Sedang
Dasar
Transformers
Pengembangan lokal ringan
Cognita
Docker + UI
Tinggi
Ya
TrueFoundry
Alat bisnis berbasis GUI
LLMWare
CLI, API
Tinggi
Ya
LLM privat
RAG enterprise privat
STORM
Instal sumber
Tinggi
Ya
LangChain, LangGraph
Asisten riset
R2R
REST API
Tinggi
Ya
Multimodal
RAG akademik & hibrida
EmbedChain
Python, SaaS
Sedang
Dasar
Web, PDF, Gambar
Prototyping cepat
RAGatouille
Python
Tinggi
Ya
ColBERT
Eksperimen retriever
Verba
Cloud/Lokal
Sedang
Dasar
Weaviate
Asisten kontekstual
Jina AI
Docker, REST/gRPC
Tinggi
Ya
API multimodal
Aplikasi multimodal yang skalabel
Neurite
Source setup
Sedang
Tidak
N/A
Eksperimentasi
LLM-App
CLI, Git
Sedang
Tidak
OpenAI
Aplikasi LLM untuk hackathon
Jebakan Umum saat Menerapkan RAG
Sistem RAG bisa tangguh, tetapi juga punya sisi tajam. Jika tidak hati-hati, jawaban model Anda bisa jadi lebih buruk daripada tanpa retrieval sama sekali. Berikut empat masalah umum yang perlu dihindari—dan apa yang sebaiknya dilakukan.
1. Mengindeks terlalu banyak "sampah"
Tidak semua hal perlu dimasukkan ke vector store Anda. Menjejalkan setiap dokumen, posting blog, atau utas email mungkin terasa menyeluruh, tetapi itu hanya mencemari pencarian. Retriever menarik konteks bernilai rendah yang harus disaring oleh model (sering kali disalahgunakan). Sebaliknya, bersikaplah selektif. Hanya indeks konten yang akurat, tertulis dengan baik, dan bermanfaat. Rapikan sebelum menyimpan.
2. Mengabaikan batas token
LLM punya memori pendek. Jika prompt Anda, ditambah semua potongan yang diambil, melampaui batas token model, akan ada bagian yang terpotong. Bagian itu bisa jadi yang paling penting. Sebagai gantinya, buat prompt ringkas. Batasi jumlah potongan yang diambil atau ringkas terlebih dahulu sebelum dikirim ke model.
3. Mengoptimalkan untuk recall, bukan presisi
Mengambil lebih banyak dokumen demi "mencakup semuanya" memang menggoda. Namun jika hasil tambahan hanya terkait samar, Anda memenuhi prompt dengan hal yang tidak penting. Model menjadi terdistraksi atau—lebih buruk lagi—bingung. Alih-alih, kejarlah presisi tinggi. Beberapa potongan yang sangat relevan lebih baik daripada daftar panjang kecocokan lemah.
4. Terbang buta tanpa log
Saat model memberi jawaban buruk, apakah Anda tahu penyebabnya? Jika Anda tidak mencatat kueri, dokumen yang diambil, dan prompt akhir, Anda sedang mengurai masalah dalam gelap. Sebaliknya, catat alur RAG secara penuh. Termasuk masukan pengguna, konten yang diambil, apa yang dikirim ke model, dan respons model.
Kesimpulan
RAG bukan obat mujarab untuk semua masalah, tetapi jika digunakan dengan benar, ini adalah salah satu cara paling efektif untuk membuat LLM lebih cerdas, praktis, dan berpijak pada data yang penting bagi bisnis Anda.
Kuncinya adalah memahami apa yang Anda kerjakan. Memilih framework yang tepat adalah bagiannya, tetapi keberhasilan bergantung pada seberapa baik Anda memahami data Anda dan seberapa cermat Anda menyetel pipeline retrieval. Prinsip garbage in, garbage out tetap berlaku, apalagi saat Anda membangun sistem yang menghasilkan bahasa, bukan sekadar mengambil fakta.
Pastikan pengindeksan Anda tepat, perhatikan penggunaan token, dan pantau alurnya dari ujung ke ujung. Ketika semua bagian itu selaras, RAG dapat mentransformasi aplikasi AI Anda dari sekadar mengesankan menjadi benar-benar membantu.