
कोर्स
LangChain के साथ LLM एप्लिकेशन विकसित करना
3 घंटा
51.8K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंरिट्रीवल‑ऑगमेंटेड जेनरेशन (RAG) बड़े भाषा मॉडल्स का उपयोग करने में सबसे व्यावहारिक विकासों में तेजी से उभर रहा है। यह कोई नया मॉडल नहीं है और न ही LLMs का विकल्प—बल्कि एक अभिनव सिस्टम है जो उन्हें वास्तविक डेटा स्रोतों से खींचे गए तथ्यों के साथ तर्क करने में मदद करता है। मूल रूप से, RAG जेनेरेटिव AI की कुछ सबसे बड़ी चुनौतियों—भ्रम (हेल्युसिनेशन), सीमित मेमोरी और पुराना ज्ञान—को हल करता है। रिट्रीवल और जेनरेशन को एक ही पाइपलाइन में जोड़ने से मॉडल अपने उत्तरों को वर्तमान और प्रासंगिक संदर्भ में आधारित कर पाते हैं, जो अक्सर किसी व्यवसाय या डोमेन के लिए विशिष्ट होता है।
यह बदलाव पहले से कहीं अधिक मायने रखता है। एंटरप्राइज सेटिंग्स में, LLMs से सटीक और समझाई जा सकने वाले उत्तरों की अपेक्षा की जाती है। डेवलपर्स चाहते हैं कि आउटपुट प्रोडक्ट डॉक्यूमेंटेशन, आंतरिक विकी या सपोर्ट टिकट्स को प्रतिबिंबित करे—सिर्फ़ सामान्य वेब नॉलेज नहीं। RAG इसे संभव बनाता है।
यह गाइड बताता है कि RAG फ्रेमवर्क कैसे काम करता है, यह आपके AI स्टैक में कहाँ फिट बैठता है, और इसे बुनियादी टूल्स व डेटा के साथ कैसे उपयोग करें।
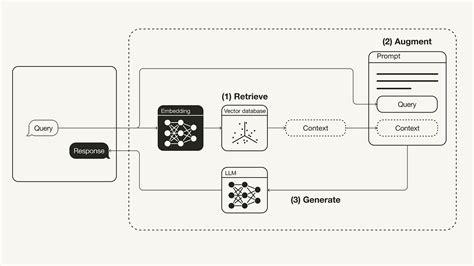
RAG का अर्थ है Retrieve, Augment, Generate। यह बड़े भाषा मॉडल्स (LLMs) को बिना रीट्रेन किए बाहरी ज्ञान तक पहुंच देने का बुद्धिमानी भरा तरीका है।
विचार यह है: जब कोई यूज़र सवाल पूछता है, तो उस सवाल को सीधे मॉडल पर फेंककर अच्छे उत्तर की उम्मीद करने के बजाय, RAG पहले रिलेटेड जानकारी रिट्रीव करता है—किसी नॉलेज बेस से। फिर यह उस अतिरिक्त संदर्भ से मूल प्रॉम्प्ट को ऑगमेंट करता है। अंत में LLM जेनरेट करता है—सवाल और जोड़ी गई जानकारी के आधार पर उत्तर।
यह तरीका LLM की प्रमुख सीमाएँ—जैसे हेल्युसिनेशन, छोटी मेमोरी (कॉन्टेक्स्ट विंडोज) और नॉलेज कटऑफ—को ताज़ा, वास्तविक और प्रासंगिक डेटा ऑन‑द‑फ्लाई प्लग करके दूर करने में मदद करता है।
स्टैंडअलोन LLM प्रभावशाली हैं, पर उनकी सीमाएँ हैं। वे भ्रम पैदा कर सकते हैं, भूल सकते हैं, और अपनी आखिरी ट्रेनिंग रन से नए कुछ नहीं जानते। RAG इसे बदलता है। LLMs को रियल‑टाइम रिट्रीवल के साथ जोड़कर, आपको मिलता है:
संक्षेप में, RAG आपको कम प्रयास में अधिक स्मार्ट और भरोसेमंद AI सिस्टम बनाने देता है।
RAG इकोसिस्टम तेजी से बढ़ रहा है, और दर्जनों ओपन‑सोर्स प्रोजेक्ट्स डेवलपर्स को अधिक स्मार्ट, रिट्रीवल‑ऑगमेंटेड एप्लिकेशन बनाने में मदद कर रहे हैं। चाहे आप प्लग करने योग्य और सरल कुछ ढूंढ रहे हों, या कस्टमाइज़ेबल कॉम्पोनेंट्स के साथ फुल‑स्टैक पाइपलाइन—संभावना है कि आपके लिए कोई टूल मौजूद है।
नीचे, हम शीर्ष ओपन‑सोर्स RAG फ्रेमवर्क्स की समीक्षा करेंगे। हर प्रविष्टि में GitHub पर स्थिति, डिप्लॉयमेंट शैली, विशिष्ट खूबियाँ, मुख्य उपयोग‑केस, और प्रोजेक्ट का त्वरित अहसास दिलाने हेतु एक विज़ुअल शामिल है।
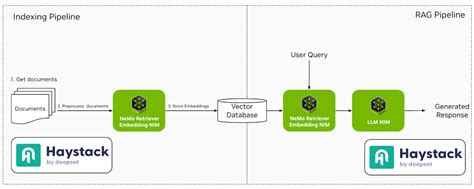
Haystack एक मजबूत, मॉड्यूलर फ्रेमवर्क है जो प्रोडक्शन‑रेडी NLP सिस्टम बनाने के लिए डिज़ाइन किया गया है। यह रिट्रीवर्स, रीडर्स और जेनरेटर्स जैसे विभिन्न कॉम्पोनेंट्स को सपोर्ट करता है, और Elasticsearch तथा Hugging Face Transformers जैसे टूल्स के साथ सहज एकीकरण देता है।
LlamaIndex एक डेटा फ्रेमवर्क है जो कस्टम डेटा स्रोतों को बड़े भाषा मॉडल्स से जोड़ता है। यह डेटा को इंडेक्स और क्वेरी करने की प्रक्रिया को सरल बनाता है, जिससे संदर्भ‑सचेत उत्तरों की ज़रूरत वाले एप्लिकेशन बनाना आसान हो जाता है।
LangChain एक व्यापक फ्रेमवर्क है जो डेवलपर्स को भाषा मॉडल‑संचालित एप्लिकेशन बनाने में सक्षम बनाता है। यह प्रॉम्प्ट टेम्पलेट्स, मेमोरी और एजेंट्स जैसे विभिन्न कॉम्पोनेंट्स को एक साथ जोड़ने के टूल्स देता है, ताकि जटिल वर्कफ़्लोज़ बनाए जा सकें।
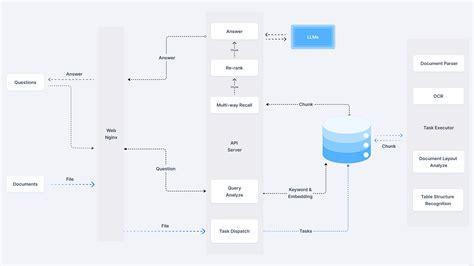
RAGFlow एक ओपन‑सोर्स इंजन है जो डीप डॉक्यूमेंट अंडरस्टैंडिंग पर केंद्रित है। यह व्यवसायों के लिए RAG सिस्टम लागू करने हेतु सुव्यवस्थित वर्कफ़्लो देता है, और जटिल डेटा फॉर्मैट्स से संदर्भ उद्धरणों के साथ सत्यनिष्ठ प्रश्न‑उत्तर पर जोर देता है।
txtAI एक ऑल‑इन‑वन AI फ्रेमवर्क है जो सेमान्टिक सर्च को RAG क्षमताओं के साथ जोड़ता है। यह विभिन्न डेटा प्रकारों और फ़ॉर्मैट्स का समर्थन करते हुए ऐसे एप्लिकेशन बनाने देता है जो जानकारी को कुशलतापूर्वक खोजें, इंडेक्स करें और रिट्रीव करें।
Cognita एक मॉड्यूलर RAG फ्रेमवर्क है जिसे आसान कस्टमाइज़ेशन और डिप्लॉयमेंट के लिए डिज़ाइन किया गया है। यह विभिन्न RAG कॉन्फ़िगरेशन के साथ प्रयोग करने के लिए एक फ्रंटएंड इंटरफ़ेस देता है, जिससे यह डेवलपमेंट और प्रोडक्शन दोनों वातावरणों के लिए उपयुक्त बनता है।
LLMWare एंटरप्राइज‑ग्रेड RAG एप्लिकेशन बनाने के लिए एक एकीकृत फ्रेमवर्क प्रदान करता है। यह छोटे, विशेषज्ञ मॉडल्स के निजी डिप्लॉयमेंट पर जोर देता है, जिससे डेटा सुरक्षा और कंप्लायंस सुनिश्चित होती है।
STORM एक रिसर्च असिस्टेंट है जो आउटलाइन‑ड्रिवन RAG की अवधारणा का विस्तार करता है। यह विभिन्न स्रोतों से जानकारी संश्लेषित करके व्यापक लेख उत्पन्न करने पर केंद्रित है, जिससे यह कंटेंट क्रिएशन कार्यों के लिए आदर्श बनता है।
R2R (Reason to Retrieve) एक उन्नत AI रिट्रीवल सिस्टम है जो प्रोडक्शन‑रेडी फीचर्स के साथ RAG को सपोर्ट करता है। यह मल्टीमोडल कंटेंट इन्जेशन, हाइब्रिड सर्च, और नॉलेज ग्राफ इंटीग्रेशन प्रदान करता है, जो जटिल एंटरप्राइज आवश्यकताओं को पूरा करता है।
EmbedChain एक Python लाइब्रेरी है जो RAG मॉडल्स का उपयोग करके AI एप्लिकेशन बनाना और डिप्लॉय करना सरल बनाती है। यह PDFs, इमेजेज़ और वेब पेजों सहित विभिन्न डेटा प्रकारों को सपोर्ट करती है, जिससे यह अलग‑अलग उपयोग‑केस के लिए बहुमुखी बनती है।
RAGatouille ColBERT जैसे उन्नत रिट्रीवल तरीकों को RAG पाइपलाइन्स में एकीकृत करता है। यह अलग‑अलग रिट्रीवल तकनीकों के साथ मॉड्यूलर प्रयोग की अनुमति देता है, जिससे RAG सिस्टम्स की लचीलापन और परफॉर्मेंस बढ़ती है।
Verba एक कस्टमाइज़ेबल पर्सनल असिस्टेंट है जो RAG का उपयोग करके डेटा को क्वेरी और इंटरैक्ट करता है। यह Weaviate के कॉन्टेक्स्ट‑अवेयर डेटाबेस के साथ इंटीग्रेट करता है, जिससे कुशल सूचना रिट्रीवल और इंटरैक्शन संभव होता है।
Jina AI स्केलेबल डिप्लॉयमेंट विकल्पों के साथ मल्टीमोडल AI एप्लिकेशन बनाने के टूल्स देता है। यह विभिन्न संचार प्रोटोकॉल्स को सपोर्ट करता है, जिससे डेवलपर्स के लिए AI सर्विसेस बनाना और स्केल करना उपयुक्त बनता है।
Neurite एक उभरता हुआ RAG फ्रेमवर्क है जो AI‑संचालित एप्लिकेशन बनाना सरल करता है। डेवलपर अनुभव और तेज़ प्रोटोटाइपिंग पर इसका जोर इसे प्रयोग के लिए आकर्षक विकल्प बनाता है।
LLM‑App बड़े भाषा मॉडल्स से संचालित एप्लिकेशन बनाने का एक फ्रेमवर्क है। यह डेवलपमेंट प्रक्रिया को सुव्यवस्थित करने के लिए टेम्पलेट्स और टूल्स प्रदान करता है, जिससे विभिन्न एप्लिकेशंस में RAG क्षमताओं का एकीकरण आसान हो जाता है।
हर फ्रेमवर्क अलग‑अलग उपयोग‑केस और डिप्लॉयमेंट प्राथमिकताओं के अनुसार विशिष्ट फीचर्स देता है। आपकी विशिष्ट आवश्यकताओं—जैसे डिप्लॉयमेंट की आसानी, कस्टमाइज़ेशन या इंटीग्रेशन क्षमताएँ—के आधार पर वह फ्रेमवर्क चुनें जो आपके प्रोजेक्ट के लक्ष्यों से सबसे बेहतर मेल खाता हो।
उपयुक्त RAG फ्रेमवर्क का चयन आपकी विशिष्ट ज़रूरतों पर निर्भर करता है: लीगल डॉक्यूमेंट विश्लेषण, अकादमिक रिसर्च, या लाइटवेट लोकल डेवलपमेंट। इस तालिका का उपयोग करें ताकि लोकप्रिय ओपन‑सोर्स RAG फ्रेमवर्क्स की तुलना तेजी से कर सकें—उनके डिप्लॉयमेंट तरीके, कस्टमाइज़ेबिलिटी, उन्नत रिट्रीवल सपोर्ट, इंटीग्रेशन क्षमताएँ, और प्रत्येक टूल किसके लिए सर्वोत्तम है, के आधार पर।
RAG सिस्टम मज़बूत हो सकते हैं, पर इनके तेज़ किनारे भी हैं। यदि आप सावधान नहीं हैं, तो आपके मॉडल के उत्तर बिना रिट्रीवल के भी बदतर हो सकते हैं। यहाँ चार आम समस्याएँ हैं जिनसे बचना चाहिए—और उनकी जगह क्या करें।
हर चीज़ को आपके वेक्टर स्टोर में जाना ज़रूरी नहीं। हर डॉक्यूमेंट, ब्लॉग पोस्ट या ईमेल थ्रेड को डंप करना भले ही पूरा लग सकता है, पर यह आपकी सर्च को दूषित करता है। रिट्रीवर लो‑वैल्यू संदर्भ खींचता है, जिसे मॉडल को छाँटना पड़ता है (अक्सर गलत तरीके से)। इसके बजाय, चयनात्मक बनें। केवल वही कंटेंट इंडेक्स करें जो सटीक, अच्छी तरह लिखा और उपयोगी हो। स्टोर करने से पहले सफ़ाई करें।
LLMs की मेमोरी छोटी होती है। यदि आपका प्रॉम्प्ट और सभी रिट्रीव किए गए चंक्स मिलकर मॉडल की टोकन लिमिट से ज़्यादा हो जाएँ, तो कुछ न कुछ कट जाएगा—और वही हिस्सा महत्वपूर्ण भी हो सकता है। इसके बजाय, प्रॉम्प्ट्स को संक्षिप्त रखें। रिट्रीव किए जाने वाले चंक्स की संख्या सीमित करें या उन्हें मॉडल को भेजने से पहले संक्षेपित करें।
“सब कवर हो जाए” यह सोचकर अधिक डॉक्यूमेंट रिट्रीव करना आकर्षक लगता है। पर यदि अतिरिक्त परिणाम ढीले‑ढाले संबंधित हों, तो आप प्रॉम्प्ट को फालतू सामग्री से भर देते हैं। मॉडल का ध्यान भटकता है, या बदतर—भ्रमित हो जाता है। इसके बजाय, उच्च प्रिसिजन का लक्ष्य रखें। कुछ अत्यंत प्रासंगिक चंक्स लंबे कमजोर मैचों की सूची से बेहतर हैं।
जब मॉडल गलत उत्तर देता है, तो क्या आपको पता होता है क्यों? यदि आप क्वेरी, रिट्रीव किए गए डॉक्यूमेंट्स और अंतिम प्रॉम्प्ट को लॉग नहीं कर रहे, तो आप अँधेरे में डिबग कर रहे हैं। इसके बजाय, पूरे RAG फ्लो को लॉग करें। इसमें यूज़र इनपुट, रिट्रीव किया गया कंटेंट, मॉडल को भेजा गया अंतिम प्रॉम्प्ट और मॉडल की प्रतिक्रिया शामिल करें।
RAG हर चीज़ का जादुई समाधान नहीं है, लेकिन सही तरह से इस्तेमाल करने पर यह LLMs को अधिक स्मार्ट, व्यावहारिक और आपके व्यवसाय के महत्वपूर्ण डेटा में ग्राउंडेड बनाने के सबसे प्रभावी तरीकों में से एक है।
कुंजी यह है कि आप किसके साथ काम कर रहे हैं, उसे अच्छी तरह जानें। सही फ्रेमवर्क चुनना इसका एक हिस्सा है, पर सफलता अंततः इस पर निर्भर है कि आप अपने डेटा को कितना समझते हैं और अपनी रिट्रीवल पाइपलाइन को कितनी सावधानी से ट्यून करते हैं। कचरा अंदर, कचरा बाहर—यह अब भी उतना ही लागू होता है, खासकर जब आप ऐसे सिस्टम बना रहे हैं जो सिर्फ़ तथ्य रिट्रीव नहीं, बल्कि भाषा जेनरेट भी करते हैं।
अपनी इंडेक्सिंग सही करें, टोकन उपयोग पर नज़र रखें, और एंड‑टू‑एंड फ्लो की मॉनिटरिंग करें। जब ये सारे हिस्से एक साथ फिट बैठते हैं, तो RAG आपके AI एप्लिकेशंस को प्रभावशाली से वास्तव में सहायक बना सकता है।
DataCamp के साथ AI सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें