
什么是小型语言模型?
小型语言模型是我们常听到的庞大 LLM 的紧凑且高效版本。像 GPT-4o 这样的 LLM 拥有数千亿参数,而 SLM 使用的参数要少得多——通常在数百万到数十亿之间。
SLM 的关键特征包括:
- 高效:SLM 不需要 LLM 所需的海量算力。这使它们非常适合在资源受限的设备上使用,例如智能手机、平板电脑或物联网设备——可在这篇关于边缘 AI的博文中进一步了解。
- 可及性:预算有限的人也能在无需高端基础设施的前提下部署 SLM。它们同样适用于对隐私与数据安全要求很高的本地部署,因为并不总是依赖云端。
- 可定制性:SLM 易于微调。更小的规模意味着它们能更快适配小众任务与专门领域。这使其非常适合客服、医疗或教育等特定应用(稍后我们会详细展开!)。
- 更快的推理:SLM 需要处理的参数更少,因此响应时间更短。它们非常适合实时应用,如聊天机器人、虚拟助理,或任何对快速决策至关重要的系统。在低时延为刚需的环境中,您无需等待回复。
小型语言模型示例
2019 到 2024 年间,SLM 的发展十分迅速,许多新模型应运而生以满足更高效 AI 的需求。2019 年始于 GPT-2,随后模型逐步更聚焦、更迅速。到 2022 年,Bloom 与 Galactica 等模型已能处理多语言与科学数据;2023 年,Pythia 与 Cerebras-GPT 等模型针对编程与逻辑推理等任务而设计。
2024 年,更多 SLM 发布,如 LaMini-GPT、MobileLLaMA 与 TinyLlama,面向移动设备与其他低功耗系统进行优化。Meta、Google 与 Microsoft 等公司引领着这些模型的研发,其中有些向公众开放,有些则保持私有。
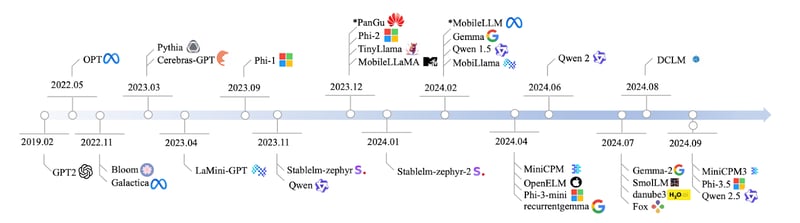
来源: Lu 等,2024
由于轻量、快速且运行所需资源较少,实践者在诸多行业中使用 SLM。以下是部分模型及其参数与主要特性:
|
模型名称 |
参数规模 |
是否开源 |
主要特性 |
|
Qwen2 |
0.5B, 1B, 7B |
是 |
可扩展,适用于多种任务 |
|
Mistral Nemo 12B |
12B |
是 |
复杂 NLP 任务,本地部署 |
|
Llama 3.1 8B |
8B |
是* |
性能与效率均衡 |
|
Pythia |
160M - 2.8B |
是 |
聚焦推理与编程 |
|
Cerebras-GPT |
111M - 2.7B |
是 |
计算高效,遵循 Chinchilla 缩放法则 |
|
Phi-3.5 |
3.8B |
是** |
长上下文(128K tokens),多语言 |
|
StableLM-zephyr |
3B |
是 |
推理速度快,适合边缘系统 |
|
TinyLlama |
1.1B |
是 |
高效适配移动与边缘设备 |
|
MobileLLaMA |
1.4B |
是 |
为移动与低功耗设备优化 |
|
LaMini-GPT |
774M - 1.5B |
是 |
多语言,指令跟随任务 |
|
Gemma2 |
9B, 27B |
是 |
本地部署,实时应用 |
|
MiniCPM |
1B - 4B |
是 |
性能均衡,对英文与中文优化 |
|
OpenELM |
270M - 3B |
是 |
多任务、低时延、节能高效 |
|
DCLM |
1B |
是 |
常识推理与逻辑演绎 |
|
Fox |
1.6B |
是 |
为移动应用进行速度优化 |
* 带有使用限制
** 仅限科研用途
想进一步了解这些模型,请参阅我撰写的另一篇文章:顶级小型语言模型。
SLM 的工作原理
我们来看看小型语言模型是如何工作的。
下一词预测
与 LLM 一样,SLM 通过预测文本序列中的下一个词来工作。SLM 利用其训练文本中的模式来猜测接下来出现的内容。这一简单而强大的概念是所有语言模型的核心。
例如,给定输入:“在《哈利·波特》系列中,主角的挚友名叫罗恩……”SLM 会分析上下文并预测最可能的下一个词——在此例中为“Weasley(韦斯莱)”。
Transformer 架构
Transformer 架构是 LLM 与 SLM 理解与生成语言的关键。可将 Transformer 理解为语言模型的“大脑”。它们利用自注意力来判断句中哪些词彼此最相关。这有助于模型理解上下文——例如分辨“Paris”是指城市还是您工作中认识的那位同事。
规模与性能的平衡
SLM 的优势在于能在规模与性能间取得平衡。它们使用的参数远少于 LLM,通常从数百万到数十亿不等,而 LLM 则常达数千亿。
参数更少意味着训练所需算力与数据更低,这让资源有限的情况下也更易上手。SLM 的紧凑规模使其能更快处理输入并生成输出,这对移动键盘或语音助手等实时应用至关重要。
SLM 或许不如大型模型那样通用或理解更深,但在特定任务上表现出色。比如,一个专门训练来分析法律文本的 SLM,可能在该领域优于通用 LLM。
SLM 的构建:技术与方法
蒸馏
这是一种通过将较大“教师”模型的知识迁移到较小“学生”模型来创建 SLM 的技术。目标是在不显著损失性能的情况下,将教师模型学到的知识压缩进学生模型。
这一过程使 SLM 在保持大型模型大量准确性的同时,大幅降低规模与算力需求。借助该技术,小模型不仅学习教师的最终预测,还能学到其潜在模式与细微差别。
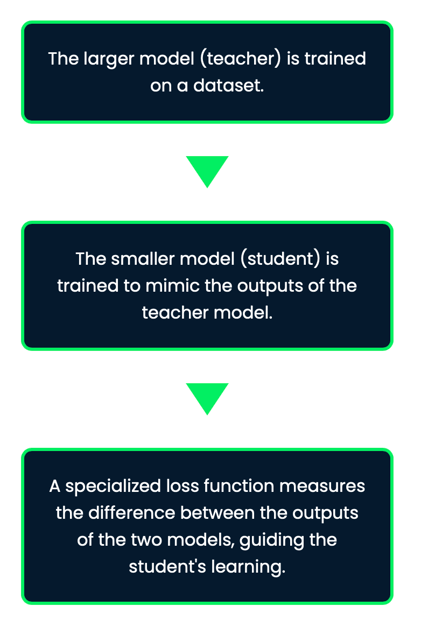
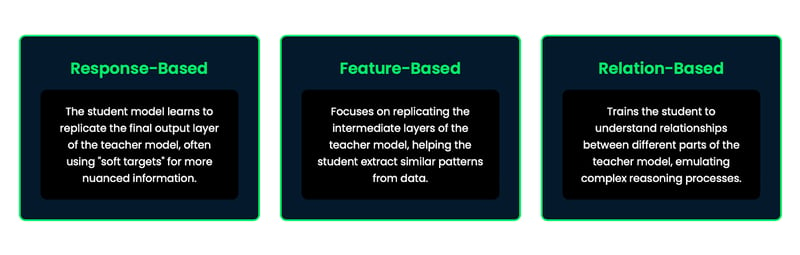
常见的知识蒸馏方法包括:
- 基于响应:学生模型学习复现教师模型的最终输出层,通常使用“软目标”以获取更细腻的信息。
- 基于特征:聚焦复现教师模型的中间层,帮助学生从数据中提取相似的模式。
- 基于关系:训练学生理解教师模型不同部分之间的关系,从而模拟复杂的推理过程。
剪枝
剪枝有点像“修剪冗余”。在剪枝过程中,会移除对整体性能贡献不大的模型部分——例如不太重要的神经元或参数。该技术有助于在不显著影响准确度的情况下缩小模型体量。不过剪枝也有难度,过于激进可能会去除过多,从而损伤模型性能。
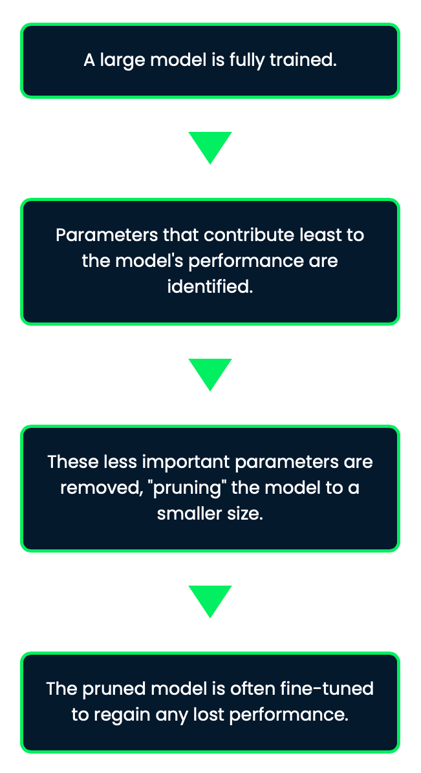
剪枝能在保持大部分原始性能的同时显著减小模型规模,是构建 SLM 的一种行之有效的技术。
量化
量化指用更少的比特数存储模型中的数值。通常模型会使用 32 位数值,而通过该方法可将其降为 8 位,更为精简。这使模型占用更少空间并运行更快。更重要的是,尽管精度降低,模型的准确性通常只受到较小影响,仍能良好工作。
想象您在天气应用中存储温度值。若以高精度(如 32 位)存储,往往超出实际所需。将精度降至 8 位,虽会丢失细微信息,但应用依然可用,同时运行更快、占用内存更少。
这对在内存与算力有限的设备(如智能手机或边缘设备)上部署 AI 尤其有用。
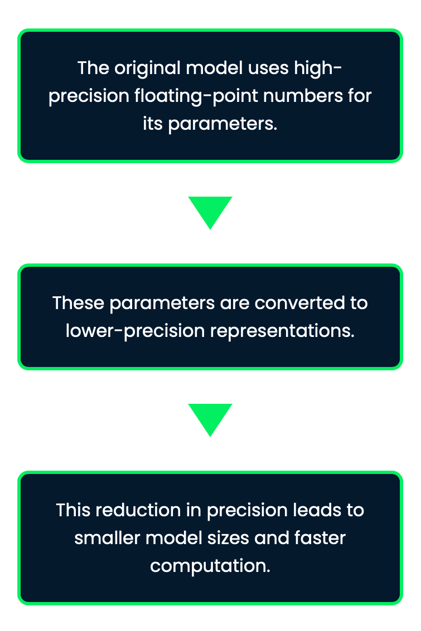
量化在资源受限设备上部署模型时尤为有效,因为它可降低内存需求并提升推理速度。
小型语言模型的应用
SLM 的魅力在于无需庞大基础设施或持续联网也能提供强大的 AI 能力,从而开启众多应用可能。
端侧 AI
以移动助理为例——手机上的语音助理帮助您安排日程。SLM 正是其背后的关键。它们让文本实时预测、语音指令,甚至翻译在本地完成,无需将数据发往云端。一切都在本地完成,意味着响应更快、隐私更有保障。
例如,SwiftKey 与 Gboard 利用 SLM 提供具备上下文的文本建议,从而提升输入速度与准确度。
这也扩展到离线应用,即使没有网络连接,AI 仍能工作,在网络受限地区尤为实用。
例如,Google 翻译提供由 SLM 驱动的离线翻译能力,帮助在网络受限环境下进行交流。
个性化 AI
SLM 的一大优势在于可针对特定任务或用户偏好进行定制。想象一个专为您企业客服微调的聊天机器人,或一个能基于您过往交互精准辅助的 AI。由于模型更小,更易微调并在各行业中部署。
示例如下:
- 医疗:SLM 可针对医学文本分析进行定制,在智能可穿戴设备上提供实时健康监测与建议,并可独立于持续云连接运行。
- 智能家居设备:嵌入智能家居系统的 SLM 能学习个人在温度与照明方面的偏好,自动针对不同时间或特定场景调整设置。
- 教育:采用 SLM 的教育应用能适配个体化学习风格与节奏,为学生提供个性化指导与支持。
物联网
SLM 在日常设备(如智能家居系统或其他小工具)中静默运行。它们帮助设备直接理解并响应您的需求,无需联网,从而更快更智能。
其他应用
SLM 还在众多其他领域发挥作用:
- 实时语言翻译:SLM 实现即时翻译,对全球交流至关重要。一些旅行应用已利用 SLM 实时翻译标识、菜单或口语指引,帮助用户跨语言沟通。
- 汽车系统:在汽车中,SLM 提供智能导航,给出实时路况并建议最佳路线;也改进了语音指令,驾驶者可免手控音乐、拨打电话或发送消息。
- 娱乐系统:智能电视与游戏主机利用 SLM 进行语音控制,并根据过往观看或游玩记录推荐节目或游戏。
- 客户服务:SLM 帮助企业更高效地处理客户问题。零售门店使用 SLM 回答有关产品、订单状态或退货政策的咨询,从而减少对人工客服的依赖。
LLM 与 SLM 对比
接下来谈谈何时选择规模更大的 LLM,何时 SLM 更合适。
任务复杂度
对于高度复杂的任务,如深度理解、长文创作或解决棘手问题,GPT-4o等大型模型通常优于 SLM。它们能从海量数据中调取信息,提供更细致的答案。代价是需要大量算力与时间来支撑这种复杂度。
|
LLM |
SLM |
|
擅长处理复杂、精细且通用的任务 |
更适合相对恰当、较简单的任务 |
|
在不同任务上具有更高的准确度与整体性能 |
在专用应用与特定领域任务上表现出色 |
|
能在长篇幅内容中保持上下文并提供连贯回应 |
可能在复杂语言任务与长程上下文理解上有所欠缺 |
例如,若您要开发一个通用型聊天机器人,需要处理广泛话题与复杂查询,那么 LLM 更合适。然而,对于专注于某条产品线的客服机器人,SLM 或许已绰绰有余,并可能因训练更聚焦而优于 LLM。
资源约束
当面临资源约束时,SLM 具有明显优势。它们在训练与部署时对算力的需求要小得多。如果您在资源受限的环境中工作,SLM 是极佳选择。
|
LLM |
SLM |
|
需要大量算力与内存 |
资源消耗更经济 |
|
推理常需 GPU 等专用硬件 |
可在标准硬件上运行,甚至运行于树莓派或智能手机等设备 |
|
因资源需求高而运营成本更高 |
训练时间更短,更便于快速部署 |
在算力有限的情境下,如移动设备或边缘计算,SLM 往往是更优选,因为它们在性能与效率之间取得良好平衡。
部署环境
如果在云端服务器上部署且资源充足,需要较高准确度与流畅度的回复时,LLM 可能更合适。但若在 CPU 或 GPU 能力有限的设备上工作,如物联网设备或移动应用,SLM 则更为契合。
|
LLM |
SLM |
|
最适合算力充足的云环境 |
也可用于云端,但更小的体量使其在资源受限环境表现更佳,更高效地处理较小任务 |
|
不适用于端侧 AI,因为需要大量算力并依赖网络连接 |
非常适合端侧 AI,可离线使用并具备更快响应。无需联网即可运行移动助理、语音识别与其他实时应用 |
|
不适合边缘计算,因为算力需求高且响应可能较慢 |
非常适合边缘计算,强调快速响应与高效用资源。可在物联网设备、智能家居与其他边缘应用中启用 AI |
在考虑部署环境时,务必评估网络连接状况、时延要求与隐私顾虑等因素。对于需要离线运行或尽量降低时延的应用,将 SLM 部署在端侧或边缘往往是更好的选择。
在 LLM 与 SLM 之间进行选择取决于任务复杂度、可用资源以及部署位置。LLM 适合对准确度要求高的复杂任务,而 SLM 高效、适用性广、易于落地。
结语
SLM 正在让 AI 变得更易获得。与需要大量算力的 LLM 不同,SLM 在更少资源上即可运行。这意味着中小企业、个人开发者,甚至初创公司无需庞大服务器或巨额预算也能使用它们。
若想进一步学习小型语言模型,推荐以下两篇资源:
常见问题解答
在典型企业应用中,运行 SLM 与 LLM 的能耗具体有何差异?
SLM 与 LLM 在能耗上的差异可能相当显著。对于典型企业应用,SLM 可能仅消耗 LLM 所需能源的 10%–20%。例如,运行一个用于客服聊天机器人的 SLM 每月大约消耗 50–100 kWh,而用于相同任务的 LLM 则可能需要 500–1000 kWh。不过,具体数值会因模型规模、使用模式与硬件效率而异。Google 与 OpenAI 等公司报告称,运行其最大模型的能耗可相当于数百户家庭,而 SLM 往往可在标准服务器甚至边缘设备上运行,所需功耗显著更低。
为特定任务创建自定义 SLM 与微调现有 LLM 的开发时间线如何比较?
为特定任务构建自定义 SLM 与微调现有 LLM 的开发周期差异较大。从零开始创建自定义 SLM 通常更耗时,对于经验丰富的数据科学团队而言,往往需要 3–6 个月,涉及数据收集、模型架构设计、训练与大量测试。针对特定任务微调现有 LLM 则可能快得多,或许只需几周。不过,权衡在于微调后的 LLM 在效率或专业化程度上未必能达到自建 SLM 的水平。选择通常取决于具体用例、可用资源与期望的性能特征。
在部署 SLM 与 LLM 时,法律与伦理层面,尤其是数据隐私与知识产权方面,需要考虑哪些问题?
数据隐私是主要关注点。LLM 往往含有大量训练数据,可能增加个人信息暴露风险。SLM 因更聚焦,可能使用更小且可控的数据集,从而降低隐私风险。知识产权问题同样关键:在多元互联网数据上训练的 LLM 可能复现受版权保护的内容;而在更特定数据上训练的 SLM 或会面临较少此类风险,但仍取决于其训练数据。此外,模型决策的可解释性与可说明性在 SLM 上通常更容易,这对受监管行业的应用尤为重要。
在多语言能力方面,尤其针对不常见语言,SLM 与 LLM 有何比较?
SLM 与 LLM 在处理多语言,尤其是不常见语言时存在差异。LLM 受益于海量训练数据,往往能在多种语言(包括稀缺语言)上表现良好,但代价是模型庞大而复杂。SLM 虽然更小,却可针对特定语言或语系进行定制,有时在这些领域甚至优于 LLM。对于不常见语言,专门训练的 SLM 由于聚焦于高质量、特定语言的数据,可能提供更准确、更契合文化语境的翻译或文本;而 LLM 使用的数据更广泛,但精度可能不如专门化数据。
在生产环境中,针对 SLM 与 LLM 的版本控制与模型治理有哪些最佳实践?
在生产环境中管理 SLM 与 LLM 的版本与治理有相似之处,也有关键差异。两者都需对模型、训练数据与配置进行良好的版本化管理。不过,LLM 由于规模大且对微调较敏感,在版本控制上往往需要更复杂的基础设施。SLM 因更小,更易管理与部署不同版本。在治理方面,LLM 因能力范围更广、潜在不可预期行为更多,通常需要更严格的监督;SLM 则因用途更具体,可能需要较少的整体监督,但更有针对性的治理。对两者而言,定期审查、性能监测,以及清晰记录模型局限与预期用途,都是负责任使用 AI 的重要实践。

Ana Rojo Echeburúa 是一位人工智能与数据专家,拥有应用数学博士学位。她热衷于将数据转化为可执行的洞见,并在带领技术团队方面拥有丰富经验。Ana 喜欢与客户密切合作,解决其业务难题并打造创新的 AI 解决方案。她以出色的问题解决能力和清晰的沟通著称,对人工智能,尤其是生成式 AI 充满热情。Ana 致力于持续学习与负责任的 AI 开发,同时专注于简化复杂问题,并以通俗易懂的方式解释技术。
小型语言模型(SLM)通过比大型语言模型(LLM)更小、更快、且更易定制,解决了在资源受限条件下让 AI 更易用、更高效的问题。
SLM 的参数更少(通常低于 100 亿),这大幅降低了计算成本与能耗。它们聚焦于特定任务,并在较小数据集上训练,从而在性能与资源效率之间取得平衡。