
स्मॉल लैंग्वेज मॉडल्स क्या हैं?
स्मॉल लैंग्वेज मॉडल्स उन विशाल लार्ज लैंग्वेज मॉडल्स के कॉम्पैक्ट, अत्यधिक कुशल संस्करण हैं जिनके बारे में हम बहुत सुनते आए हैं। GPT-4o जैसे LLMs में सैकड़ों बिलियन पैरामीटर होते हैं, जबकि SLMs कहीं कम—आमतौर पर कुछ मिलियन से लेकर कुछ बिलियन तक—का उपयोग करते हैं।
SLMs की प्रमुख विशेषताएँ हैं:
- कुशलता: SLMs को LLMs जैसी भारी कंप्यूटिंग शक्ति की आवश्यकता नहीं होती। इससे वे सीमित संसाधनों वाले डिवाइसेज़, जैसे स्मार्टफ़ोन, टैबलेट, या IoT डिवाइसेज़ पर बेहतरीन काम करते हैं—इस बारे में अधिक जानें इस ब्लॉग में एज AI पर।
- सुलभता: सीमित बजट वाले लोग हाई-एंड इन्फ्रास्ट्रक्चर के बिना भी SLMs लागू कर सकते हैं। ये ऑन-प्रिमाइसेस डिप्लॉयमेंट के लिए भी उपयुक्त हैं, जहाँ गोपनीयता और डेटा सुरक्षा बहुत महत्वपूर्ण होती है, क्योंकि ये हमेशा क्लाउड-आधारित इन्फ्रास्ट्रक्चर पर निर्भर नहीं रहते।
- कस्टमाइजेशन: SLMs को फाइन-ट्यून करना आसान होता है। छोटा आकार होने से वे निच कार्यों और विशेष डोमेनों में जल्दी अनुकूल हो जाते हैं। इससे वे ग्राहक सहायता, स्वास्थ्य सेवा, या शिक्षा जैसी विशिष्ट एप्लिकेशनों के लिए उपयुक्त हो जाते हैं (हम आगे इस पर विस्तार से बात करेंगे!)।
- तेज़ इन्फ़रेंस: कम पैरामीटर होने के कारण SLMs की प्रतिक्रिया समय तेज़ होता है। इससे वे चैटबॉट्स, वर्चुअल असिस्टेंट्स, या किसी भी ऐसे सिस्टम के लिए उपयुक्त हैं जहाँ तेज़ निर्णय आवश्यक हैं। आपको प्रतिक्रियाओं के लिए इंतज़ार नहीं करना पड़ता, जो कम लेटेंसी वाले परिवेशों में बहुत अच्छा है।
स्मॉल लैंग्वेज मॉडल्स के उदाहरण
2019 से 2024 तक SLMs का विकास तेज़ रहा है, और अधिक कुशल AI की ज़रूरत को पूरा करने के लिए कई नए मॉडल बनाए गए हैं। यह 2019 में GPT-2 से शुरू हुआ, और समय के साथ मॉडल अधिक केंद्रित और तेज़ होते गए। 2022 तक, Bloom और Galactica जैसे मॉडल बहुभाषी और वैज्ञानिक डेटा को संभाल सकते थे, और 2023 में Pythia और Cerebras-GPT जैसे मॉडल कोडिंग और तार्किक सोच जैसे कार्यों के लिए डिज़ाइन किए गए।
2024 में, LaMini-GPT, MobileLLaMA, और TinyLlama जैसे और भी SLMs जारी हुए, जो मोबाइल डिवाइसेज़ और अन्य लो-पावर सिस्टम्स पर बेहतर ढंग से काम करने के लिए बनाए गए हैं। Meta, Google, और Microsoft जैसी कंपनियाँ इन मॉडलों के विकास का नेतृत्व कर रही हैं—कुछ सार्वजनिक रूप से उपलब्ध हैं और कुछ निजी रखे गए हैं।
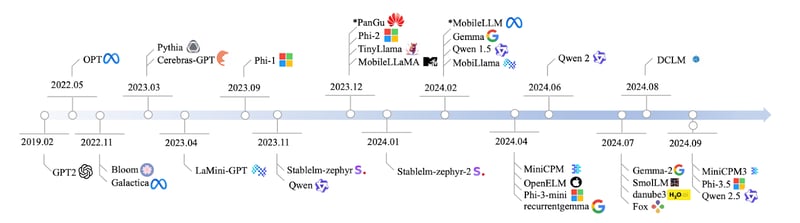
स्रोत: Lu et al., 2024
व्यवसायिक लोग SLMs का उपयोग कई उद्योगों में करते हैं क्योंकि ये हल्के, तेज़, और चलाने में कम संसाधन मांगते हैं। नीचे कुछ मॉडलों के पैरामीटर और प्रमुख विशेषताएँ दी गई हैं:
|
Model Name |
Parameters |
Open Source |
Key Features |
|
Qwen2 |
0.5B, 1B, 7B |
Yes |
Scalable, suitable for various tasks |
|
Mistral Nemo 12B |
12B |
Yes |
Complex NLP tasks, local deployment |
|
Llama 3.1 8B |
8B |
Yes* |
Balanced power and efficiency |
|
Pythia |
160M - 2.8B |
Yes |
Focused on reasoning and coding |
|
Cerebras-GPT |
111M - 2.7B |
Yes |
Compute-efficient, follows Chinchilla scaling laws |
|
Phi-3.5 |
3.8B |
Yes** |
Long context length (128K tokens), multilingual |
|
StableLM-zephyr |
3B |
Yes |
Fast inference, efficient for edge systems |
|
TinyLlama |
1.1B |
Yes |
Efficient for mobile and edge devices |
|
MobileLLaMA |
1.4B |
Yes |
Optimized for mobile and low-power devices |
|
LaMini-GPT |
774M - 1.5B |
Yes |
Multilingual, instruction-following tasks |
|
Gemma2 |
9B, 27B |
Yes |
Local deployment, real-time applications |
|
MiniCPM |
1B - 4B |
Yes |
Balanced performance, English and Chinese optimized |
|
OpenELM |
270M - 3B |
Yes |
Multitasking, low-latency, energy-efficient |
|
DCLM |
1B |
Yes |
Common-sense reasoning, logical deduction |
|
Fox |
1.6B |
Yes |
Speed-optimized for mobile applications |
*उपयोग संबंधी प्रतिबंधों के साथ
**केवल शोध प्रयोजनों के लिए
इन मॉडलों के बारे में अधिक जानने के लिए मैंने लिखा हुआ यह अलग लेख देखें: शीर्ष स्मॉल लैंग्वेज मॉडल्स।
SLMs कैसे काम करते हैं
आइए समझते हैं कि स्मॉल लैंग्वेज मॉडल्स कैसे काम करते हैं।
अगले शब्द की भविष्यवाणी
LLMs की तरह, SLMs भी टेक्स्ट के अनुक्रम में अगले शब्द की भविष्यवाणी करके काम करते हैं। SLMs अपने प्रशिक्षण पाठ से मिले पैटर्न का उपयोग करके अनुमान लगाते हैं कि आगे क्या आएगा। यह एक सरल लेकिन शक्तिशाली अवधारणा है जो सभी भाषा मॉडलों के केंद्र में है।
उदाहरण के लिए, इनपुट दिया जाए: "In the Harry Potter series, the main character's best friend is named Ron..." एक SLM इस संदर्भ का विश्लेषण करेगा और सबसे संभावित अगला शब्द भविष्यवाणी करेगा—इस मामले में, "Weasley."
ट्रांसफॉर्मर आर्किटेक्चर
ट्रांसफॉर्मर आर्किटेक्चर यह समझने और भाषा जनरेट करने में LLMs और SLMs की कुंजी है। ट्रांसफॉर्मर्स को भाषा मॉडलों के दिमाग के रूप में समझा जा सकता है। ये सेल्फ-अटेंशन का उपयोग करते हैं ताकि यह तय किया जा सके कि किसी वाक्य में कौन-से शब्द एक-दूसरे से सबसे अधिक संबंधित हैं। यह मॉडल को संदर्भ समझने में मदद करता है—उदाहरण के लिए, यह पहचानना कि “Paris” शहर के लिए है या आपके कार्यस्थल के किसी व्यक्ति के लिए।
आकार और प्रदर्शन का संतुलन
SLMs की ताकत उनके आकार और प्रदर्शन के बीच संतुलन बनाने की क्षमता में है। वे LLMs की तुलना में काफी कम पैरामीटर का उपयोग करते हैं—आमतौर पर कुछ मिलियन से लेकर कुछ बिलियन तक—जबकि LLMs में सैकड़ों बिलियन तक होते हैं।
कम पैरामीटर होने के कारण, SLMs को प्रशिक्षण के लिए कम कंप्यूटिंग शक्ति और डेटा की आवश्यकता होती है, जिससे सीमित संसाधनों में भी इन्हें अपनाना आसान होता है। SLMs का कॉम्पैक्ट आकार इनपुट प्रोसेस करने और आउटपुट जनरेट करने को तेज़ बनाता है, जो मोबाइल कीबोर्ड या वॉइस असिस्टेंट जैसे रियल-टाइम एप्लिकेशनों के लिए बेहद महत्वपूर्ण है।
SLMs बड़े मॉडलों जितने बहुमुखी या गहन समझ वाले न हों, फिर भी वे विशिष्ट कार्यों को बेहतरीन तरीके से संभालते हैं। उदाहरण के लिए, कानूनी पाठ का विश्लेषण करने के लिए प्रशिक्षित कोई SLM उस क्षेत्र में किसी सामान्य LLM से बेहतर प्रदर्शन कर सकता है।
SLMs कैसे बनाए जाते हैं: तकनीकें और तौर-तरीके
SLMs छोटे, तेज़ और अधिक कुशल बनने के लिए डिस्टिलेशन, प्रूनिंग, और क्वांटाइज़ेशन जैसी तकनीकों का उपयोग करते हैं।
डिस्टिलेशन
यह SLMs बनाने की एक तकनीक है जिसमें बड़े "टीचर" मॉडल से ज्ञान को छोटे "स्टूडेंट" मॉडल में स्थानांतरित किया जाता है। उद्देश्य यह है कि टीचर मॉडल ने जो सीखा है उसे स्टूडेंट मॉडल में इस प्रकार संकुचित किया जाए कि प्रदर्शन में बहुत अधिक कमी न आए।
इस प्रक्रिया से SLMs बड़े मॉडलों की काफ़ी सटीकता बनाए रखते हुए आकार और संगणनात्मक आवश्यकताओं के लिहाज़ से अधिक प्रबंधनीय बनते हैं। इस तकनीक में छोटा मॉडल केवल टीचर के अंतिम पूर्वानुमानों को ही नहीं, बल्कि अंतर्निहित पैटर्न और बारीकियों को भी सीखता है।
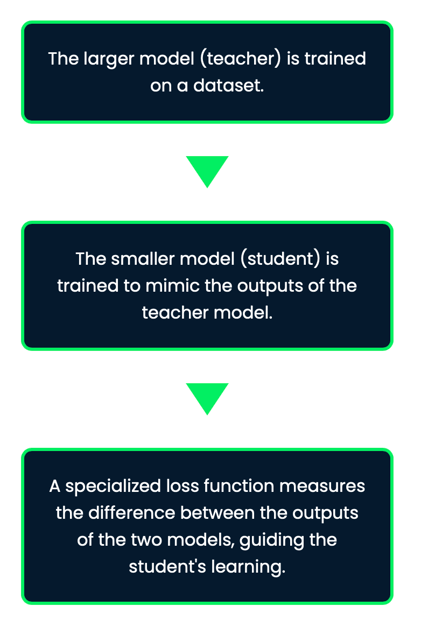
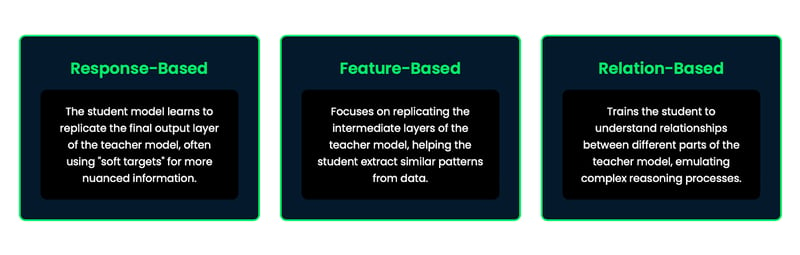
नॉलेज डिस्टिलेशन के कई तरीके हैं:
- रिस्पॉन्स-आधारित: स्टूडेंट मॉडल टीचर मॉडल की अंतिम आउटपुट लेयर को दोहराना सीखता है, अक्सर अधिक सूक्ष्म जानकारी के लिए "सॉफ्ट टार्गेट्स" का उपयोग करते हुए।
- फ़ीचर-आधारित: टीचर मॉडल की मध्यवर्ती लेयर्स को दोहराने पर केंद्रित, जिससे स्टूडेंट डेटा से मिलते-जुलते पैटर्न निकालना सीखता है।
- रिलेशन-आधारित: स्टूडेंट को टीचर मॉडल के विभिन्न भागों के बीच संबंधों को समझने के लिए प्रशिक्षित किया जाता है, जिससे वह जटिल तर्क प्रक्रियाओं का अनुकरण कर सके।
प्रूनिंग
प्रूनिंग कुछ-कुछ गैर-ज़रूरी हिस्सों की कटौती जैसा है। इस प्रक्रिया में मॉडल के वे हिस्से हटाए जाते हैं—जैसे ऐसे न्यूरॉन्स या पैरामीटर जो कुल प्रदर्शन में कम योगदान देते हैं। यह तकनीक मॉडल को छोटा बनाने में मदद करती है, बिना सटीकता पर बहुत अधिक असर डाले। हालाँकि, प्रूनिंग पेचीदा हो सकती है क्योंकि अगर यह बहुत आक्रामक हुई तो आप ज़रूरत से ज़्यादा काट सकते हैं और मॉडल के प्रदर्शन को नुकसान पहुँच सकता है।
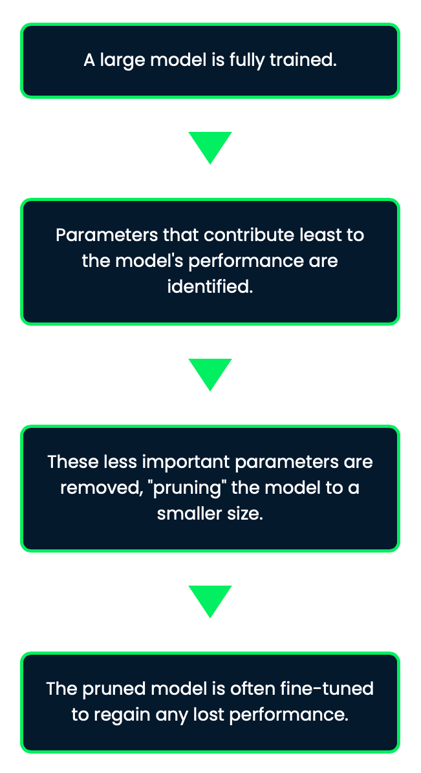
प्रूनिंग मूल प्रदर्शन का बड़ा हिस्सा बनाए रखते हुए मॉडल का आकार उल्लेखनीय रूप से घटा सकती है, इसलिए SLMs बनाने के लिए यह एक प्रभावी तकनीक है।
क्वांटाइज़ेशन
क्वांटाइज़ेशन में मॉडल की संख्याओं को स्टोर करने के लिए कम बिट्स का उपयोग किया जाता है। सामान्यतः, कोई मॉडल 32-बिट संख्याएँ इस्तेमाल कर सकता है, लेकिन इस विधि में इन्हें 8-बिट मानों तक घटा दिया जाता है, जो बहुत छोटे होते हैं। इससे मॉडल कम जगह लेता है और तेज़ चलता है। सबसे अच्छी बात यह है कि भले ही संख्याएँ कम परिशुद्ध हों, फिर भी मॉडल थोड़ी-सी सटीकता में कमी के साथ अच्छा काम करता है।
मान लीजिए आप किसी वेदर ऐप में तापमान मान संग्रहीत कर रहे हैं। आप उन्हें अत्यधिक परिशुद्धता (जैसे 32-बिट) के साथ स्टोर करेंगे, जो ज़रूरत से ज़्यादा है। परिशुद्धता को 8-बिट तक घटाकर आप कुछ विवरण खो सकते हैं, लेकिन ऐप तेज़ चलेगा और कम मेमोरी उपयोग करेगा—और फिर भी उपयोगी रहेगा।
यह विशेष रूप से उन डिवाइसेज़ पर AI डिप्लॉय करने के लिए उपयोगी है जिनकी मेमोरी और कंप्यूटिंग शक्ति सीमित है, जैसे स्मार्टफ़ोन या एज डिवाइसेज़।
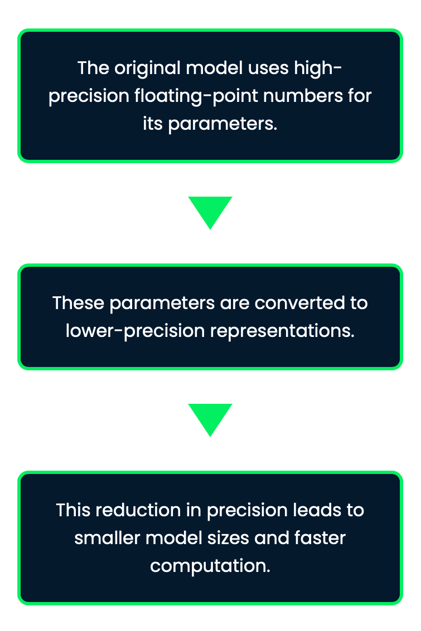
क्वांटाइज़ेशन सीमित संसाधनों वाले डिवाइसेज़ पर मॉडल्स को डिप्लॉय करने में विशेष रूप से प्रभावी है क्योंकि यह मेमोरी की ज़रूरत घटाता है और इन्फ़रेंस स्पीड बढ़ाता है।
स्मॉल लैंग्वेज मॉडल्स के उपयोग
SLMs की खूबसूरती यह है कि वे बिना भारी-भरकम इन्फ्रास्ट्रक्चर या लगातार इंटरनेट कनेक्टिविटी के भी सशक्त AI प्रदान कर सकते हैं—जिससे अनेक उपयोग-क्षेत्र खुलते हैं।
ऑन-डिवाइस AI
सोचिए मोबाइल असिस्टेंट्स के बारे में—आपके फ़ोन पर वे वॉइस असिस्टेंट जो आपके दिन को व्यवस्थित करने में मदद करते हैं। SLMs इसे संभव बनाते हैं। वे रियल-टाइम टेक्स्ट प्रेडिक्शन, वॉइस कमांड, और यहाँ तक कि अनुवाद की सुविधा भी बिना डेटा को क्लाउड पर भेजे देते हैं। सब कुछ लोकल होता है—मतलब तेज़ प्रतिक्रियाएँ और अधिक गोपनीयता-सुरक्षित इंटरैक्शन।
उदाहरण के लिए, SwiftKey और Gboard संदर्भानुकूल सटीक टेक्स्ट सुझाव देने के लिए SLMs का उपयोग करते हैं, जिससे टाइपिंग की गति और शुद्धता बेहतर होती है।
यह ऑफ़लाइन एप्लिकेशनों तक भी विस्तृत है, जहाँ इंटरनेट कनेक्शन न होने पर भी AI काम कर सकता है—जो सीमित कनेक्टिविटी वाले क्षेत्रों में उपयोगी है।
उदाहरण के तौर पर, Google Translate ऑफ़लाइन अनुवाद क्षमताएँ प्रदान करता है, जो SLMs द्वारा संचालित होती हैं, और सीमित इंटरनेट एक्सेस वाले क्षेत्रों में संचार को सहज बनाती हैं।
व्यक्तिगत (पर्सनलाइज़्ड) AI
SLMs की एक बड़ी ख़ासियत यह है कि उन्हें विशिष्ट कार्यों या उपयोगकर्ता प्राथमिकताओं के अनुसार कस्टमाइज़ किया जा सकता है। कल्पना कीजिए कि आपके व्यवसाय के लिए खास तौर पर कस्टमर सर्विस वाला चैटबॉट फाइन-ट्यून किया गया हो, या ऐसा AI जो आपकी पिछली बातचीत के आधार पर ठीक उसी तरह आपकी सहायता करे जैसी आपको ज़रूरत है। छोटे होने के कारण इन मॉडलों को फाइन-ट्यून और विभिन्न उद्योगों में डिप्लॉय करना कहीं आसान है।
कुछ उदाहरण देखें:
- हेल्थकेयर: SLMs को चिकित्सा-पाठ विश्लेषण के लिए कस्टमाइज़ किया जा सकता है ताकि स्मार्ट वियरेबल्स पर रियल-टाइम हेल्थ मॉनिटरिंग और सलाह मिल सके। ये सतत क्लाउड कनेक्टिविटी से स्वतंत्र होकर काम कर सकते हैं।
- स्मार्ट होम डिवाइसेज़: स्मार्ट होम सिस्टम्स में एम्बेडेड SLMs तापमान और लाइटिंग के लिए व्यक्तिगत पसंद सीख सकते हैं और दिन के अलग-अलग समय या विशेष मौकों के लिए सेटिंग्स स्वतः समायोजित कर सकते हैं।
- शिक्षा: SLMs का उपयोग करने वाले शैक्षिक ऐप्स व्यक्तिगत सीखने की शैली और गति के अनुकूल हो सकते हैं, जिससे छात्रों को निजी मार्गदर्शन और सहयोग मिलता है।
इंटरनेट ऑफ थिंग्स
SLMs आपके स्मार्ट होम सिस्टम या अन्य गैजेट्स जैसे रोज़मर्रा के डिवाइसेज़ पर पृष्ठभूमि में चुपचाप चलते हैं। वे इन डिवाइसेज़ को इंटरनेट से जुड़े बिना ही आपको सीधे समझने और प्रतिक्रिया देने में मदद करते हैं, जिससे वे तेज़ और अधिक स्मार्ट बनते हैं।
अन्य उपयोग
SLMs कई अन्य क्षेत्रों में भी जगह बना रहे हैं:
- रियल-टाइम भाषा अनुवाद: SLMs त्वरित अनुवाद संभव बनाते हैं, जो वैश्विक संचार के लिए महत्वपूर्ण है। कुछ ट्रैवल ऐप्स अब साइनबोर्ड, मेनू, या बोले गए निर्देशों का रियल-टाइम में अनुवाद करने के लिए SLMs का उपयोग करते हैं। इससे उपयोगकर्ताओं को विदेशी भाषाओं में नेविगेट करने में मदद मिलती है।
- ऑटोमोटिव सिस्टम्स: कारों में, SLMs स्मार्ट नेविगेशन प्रदान करते हैं—रियल-टाइम ट्रैफ़िक अपडेट और सर्वश्रेष्ठ मार्ग सुझाते हैं। ये वॉइस कमांड्स को भी बेहतर बनाते हैं, जिससे ड्राइवर बिना हाथ उपयोग किए संगीत नियंत्रित कर सकते हैं, कॉल कर सकते हैं, या संदेश भेज सकते हैं।
- एंटरटेनमेंट सिस्टम्स: स्मार्ट टीवी और गेमिंग कंसोल वॉइस कंट्रोल और आपकी पिछली पसंद के आधार पर शो या गेम सुझाने के लिए SLMs का उपयोग करते हैं।
- कस्टमर सर्विस: SLMs कंपनियों को ग्राहक प्रश्नों का प्रबंधन अधिक कुशलता से करने में मदद करते हैं। रिटेल स्टोर उत्पादों, ऑर्डर स्थिति, या रिटर्न नीतियों से जुड़े प्रश्नों के उत्तर देने के लिए SLM का उपयोग करते हैं। इससे मानव ग्राहक सहायता की ज़रूरत कम हो सकती है।
LLMs बनाम SLMs
अब बात करते हैं कि कब LLMs जैसे बड़े मॉडल चुनें और कब SLMs बेहतर विकल्प हैं।
कार्य की जटिलता
बहुत जटिल कार्यों—जैसे गहन समझ, लंबी कंटेंट क्रिएशन, या कठिन समस्याओं को हल करना—के लिए GPT-4o जैसे बड़े मॉडल आमतौर पर SLMs से बेहतर प्रदर्शन करते हैं। वे विशाल मात्रा में डेटा से खींचकर अधिक विस्तृत उत्तर दे सकते हैं। हालांकि, इसकी कीमत भारी कंप्यूटिंग शक्ति और समय के रूप में चुकानी पड़ती है।
|
LLMs |
SLMs |
|
जटिल, परिष्कृत और सामान्य कार्यों को संभालने में उत्कृष्ट |
अधिक उपयुक्त, सरल कार्यों के लिए सर्वाधिक उपयुक्त |
|
विभिन्न कार्यों में बेहतर सटीकता और प्रदर्शन |
विशेषीकृत अनुप्रयोगों और डोमेन-विशिष्ट कार्यों में उत्कृष्ट |
|
लंबे पाठ में संदर्भ बनाए रखने और सुसंगत उत्तर देने में सक्षम |
जटिल भाषा कार्यों और लंबी दूरी के संदर्भ समझ में कठिनाई हो सकती है |
उदाहरण के लिए, यदि आप एक जनरल-पर्पज़ चैटबॉट विकसित कर रहे हैं जिसे अलग-अलग विषयों और जटिल क्वेरीज को संभालना है, तो LLM अधिक उपयुक्त होगा। लेकिन किसी विशेष प्रोडक्ट लाइन पर केंद्रित कस्टमर सर्विस बॉट के लिए, SLM पर्याप्त से अधिक हो सकता है और अपने केंद्रित प्रशिक्षण के कारण LLM से बेहतर प्रदर्शन भी कर सकता है।
संसाधन सीमाएँ
जब संसाधन सीमित हों, तब SLMs जीतते हैं। इन्हें प्रशिक्षित और डिप्लॉय करने के लिए कहीं कम कंप्यूटिंग शक्ति चाहिए। संसाधन-सीमित वातावरण में काम करते समय ये बेहतरीन विकल्प हैं।
|
LLMs |
SLMs |
|
काफ़ी अधिक कंप्यूटिंग शक्ति और मेमोरी की आवश्यकता |
संसाधन खपत के लिहाज़ से अधिक किफायती |
|
अक्सर इन्फ़रेंस के लिए GPUs जैसे विशेष हार्डवेयर की ज़रूरत |
मानक हार्डवेयर पर, यहाँ तक कि Raspberry Pi या स्मार्टफ़ोन जैसे डिवाइसेज़ पर भी चल सकते हैं |
|
संसाधन मांग के कारण अधिक परिचालन लागत |
कम प्रशिक्षण समय, जिससे त्वरित डिप्लॉयमेंट के लिए अधिक सुलभ |
जहाँ कंप्यूटिंग शक्ति सीमित हो—जैसे मोबाइल डिवाइसेज़ या एज कंप्यूटिंग में—SLMs अक्सर बेहतर विकल्प होते हैं क्योंकि वे प्रदर्शन और कुशलता का अच्छा मिश्रण प्रदान करते हैं।
डिप्लॉयमेंट पर्यावरण
यदि आप क्लाउड सर्वर पर AI डिप्लॉय कर रहे हैं जहाँ संसाधन समस्या नहीं हैं, तो खासकर तब LLM सही रहेगा जब उत्तरों में उच्च सटीकता और प्रवाह चाहिए। लेकिन यदि आप सीमित CPU या GPU शक्ति वाले डिवाइसेज़—जैसे IoT डिवाइसेज़ या मोबाइल ऐप्लिकेशन्स—पर काम कर रहे हैं, तो SLMs एकदम उपयुक्त हैं।
|
LLMs |
SLMs |
|
क्लाउड वातावरण के लिए सर्वोत्तम, जहाँ पर्याप्त कंप्यूटिंग शक्ति उपलब्ध हो |
क्लाउड में भी उपयोगी, लेकिन छोटा आकार उन्हें सीमित संसाधनों वाले स्थानों के लिए बेहतर बनाता है। छोटे कार्यों को संभालने में अधिक कुशल |
|
ऑन-डिवाइस AI के लिए आदर्श नहीं, क्योंकि इसे बहुत कंप्यूटिंग शक्ति चाहिए और इंटरनेट कनेक्शन पर निर्भर रहता है |
ऑन-डिवाइस AI के लिए उत्कृष्ट—ऑफ़लाइन उपयोग और तेज़ प्रतिक्रियाएँ संभव। मोबाइल असिस्टेंट, वॉइस रिकग्निशन और अन्य रियल-टाइम ऐप्स इंटरनेट कनेक्शन के बिना भी चल सकते हैं |
|
एज कंप्यूटिंग के लिए उपयुक्त नहीं, क्योंकि इसमें अधिक कंप्यूटिंग शक्ति लगती है और प्रतिक्रिया धीमी हो सकती है |
एज कंप्यूटिंग के लिए बेहतरीन, जहाँ तेज़ प्रतिक्रिया और संसाधनों का कुशल उपयोग आवश्यक है। ये IoT डिवाइसेज़, स्मार्ट होम्स और अन्य एज एप्लिकेशनों में AI सक्षम करते हैं |
डिप्लॉयमेंट पर्यावरण पर विचार करते समय, इंटरनेट कनेक्टिविटी, लेटेंसी आवश्यकताएँ, और गोपनीयता संबंधी चिंताओं जैसे कारकों का आकलन करना आवश्यक है। जिन एप्लिकेशनों को ऑफ़लाइन या न्यूनतम लेटेंसी के साथ काम करना हो, उनके लिए ऑन-डिवाइस या एज पर डिप्लॉय किए गए SLMs अक्सर बेहतर विकल्प होते हैं।
LLMs और SLMs के बीच चुनाव कार्य की जटिलता, उपलब्ध संसाधनों और डिप्लॉयमेंट स्थान पर निर्भर करता है। LLMs उच्च सटीकता की ज़रूरत वाले जटिल कार्यों के लिए अच्छे हैं, जबकि SLMs कुशल हैं और अधिक स्थानों पर काम कर सकते हैं।
निष्कर्ष
SLMs AI को काफी अधिक सुलभ बना रहे हैं। बड़े भाषा मॉडलों के विपरीत जिन्हें भारी कंप्यूटिंग शक्ति चाहिए, SLMs कम संसाधनों पर चलते हैं। इसका मतलब है कि छोटी कंपनियाँ, व्यक्तिगत डेवलपर्स और स्टार्टअप्स भी बिना बड़े सर्वर या भारी बजट के इन्हें अपना सकते हैं।
स्मॉल लैंग्वेज मॉडल्स के बारे में अधिक जानने के लिए मैं ये दो संसाधन सुझाता/सुझाती हूँ:
FAQs
एक सामान्य एंटरप्राइज़ एप्लिकेशन के लिए SLM चलाने और LLM चलाने में ऊर्जा खपत में क्या विशेष अंतर होते हैं?
SLMs और LLMs के बीच ऊर्जा खपत का अंतर काफ़ी हो सकता है। एक सामान्य एंटरप्राइज़ एप्लिकेशन के लिए, SLM को LLM की तुलना में केवल 10–20% ऊर्जा की आवश्यकता हो सकती है। उदाहरण के लिए, कस्टमर सर्विस चैटबॉट के लिए SLM चलाने में लगभग 50–100 kWh प्रति माह लग सकते हैं, जबकि उसी कार्य के लिए LLM में 500–1000 kWh लग सकते हैं। हालांकि, सटीक आँकड़े मॉडल के आकार, उपयोग पैटर्न, और हार्डवेयर कुशलता पर निर्भर करते हैं। Google और OpenAI जैसी कंपनियों ने रिपोर्ट किया है कि उनके सबसे बड़े मॉडलों को चलाने में कई सौ घरों के बराबर ऊर्जा लग सकती है, जबकि SLMs अक्सर मानक सर्वर्स या यहाँ तक कि एज डिवाइसेज़ पर भी काफी कम बिजली की माँग के साथ चल सकते हैं।
विशेषीकृत कार्यों के लिए कस्टम SLMs बनाने की तुलना में मौजूदा LLMs को फाइन-ट्यून करने में विकास समय-सीमा कैसे तुलना करती है?
कस्टम SLMs विकसित करने और मौजूदा LLMs को फाइन-ट्यून करने की समय-सीमा में काफ़ी अंतर हो सकता है। शून्य से कस्टम SLM बनाना आमतौर पर अधिक समय लेता है—अनुभवी डेटा वैज्ञानिकों की टीम के लिए अक्सर 3–6 महीने—क्योंकि इसमें डेटा संग्रह, मॉडल आर्किटेक्चर डिज़ाइन, प्रशिक्षण, और विस्तृत परीक्षण शामिल होते हैं। किसी मौजूदा LLM को किसी विशेष कार्य के लिए फाइन-ट्यून करना इससे कहीं तेज़ हो सकता है—संभावित रूप से कुछ हफ्तों में। हालाँकि, समझौता यह है कि फाइन-ट्यून किया गया LLM, कस्टम-निर्मित SLM जितनी कुशलता या विशेषीकृत प्रदर्शन प्राप्त न कर पाए। चुनाव अक्सर उपयोग-केस, उपलब्ध संसाधनों, और वांछित प्रदर्शन विशेषताओं पर निर्भर करता है।
SLMs बनाम LLMs को डिप्लॉय करते समय, खासकर डेटा गोपनीयता और बौद्धिक संपदा के संदर्भ में, कानूनी और नैतिक पहलू क्या हैं?
डेटा गोपनीयता एक बड़ा मुद्दा है—LLMs में अक्सर बहुत अधिक प्रशिक्षण डेटा होता है, जिससे व्यक्तिगत जानकारी के उजागर होने का जोखिम बढ़ सकता है। SLMs, अधिक केंद्रित होने के कारण, छोटे और नियंत्रित डेटा सेट्स का उपयोग कर सकते हैं, जिससे गोपनीयता जोखिम घट सकते हैं। बौद्धिक संपदा भी महत्वपूर्ण है, क्योंकि विविध इंटरनेट डेटा पर प्रशिक्षित LLMs कॉपीराइट वाले कंटेंट को पुनरुत्पादित कर सकते हैं। अधिक विशिष्ट डेटा पर प्रशिक्षित SLMs में ऐसे जोखिम कम हो सकते हैं, पर प्रशिक्षण डेटा पर निर्भर करते हुए मुद्दे फिर भी पैदा हो सकते हैं। साथ ही, मॉडल निर्णयों की व्याख्यात्मकता और स्पष्टीकरण क्षमता SLMs में अक्सर आसान होती है, जो विनियमित उद्योगों में बहुत महत्वपूर्ण हो सकती है।
बहुभाषीय क्षमताओं के मामले में, खासकर कम प्रचलित भाषाओं के लिए, SLMs और LLMs की तुलना कैसे होती है?
SLMs और LLMs बहुभाषीयता को अलग तरह से संभालते हैं, खासकर कम प्रचलित भाषाओं के लिए। LLMs, अपने विशाल प्रशिक्षण डेटा के कारण, कई भाषाओं—दुर्लभ भाषाओं सहित—में अच्छा काम करते हैं, पर वे बड़े और जटिल भी होते हैं। SLMs, भले छोटे हों, विशिष्ट भाषाओं या भाषा-समूहों के लिए कस्टमाइज़ किए जा सकते हैं और कभी-कभी उन क्षेत्रों में LLMs से बेहतर प्रदर्शन करते हैं। कम प्रचलित भाषाओं के लिए, विशेष रूप से प्रशिक्षित SLMs अधिक सटीक और सांस्कृतिक रूप से संवेदनशील अनुवाद या टेक्स्ट दे सकते हैं, क्योंकि वे उच्च-गुणवत्ता, भाषा-विशिष्ट डेटा पर केंद्रित होते हैं—जबकि LLMs व्यापक लेकिन संभवतः कम सटीक डेटा पर निर्भर हो सकते हैं।
प्रोडक्शन वातावरण में SLMs बनाम LLMs के साथ काम करते समय वर्ज़न कंट्रोल और मॉडल गवर्नेंस की सर्वोत्तम प्रथाएँ क्या हैं?
प्रोडक्शन वातावरण में SLMs और LLMs के लिए वर्ज़न कंट्रोल और गवर्नेंस की सर्वोत्तम प्रथाएँ कुछ हद तक समान हैं, लेकिन महत्वपूर्ण अंतर भी हैं। दोनों के लिए मॉडलों, प्रशिक्षण डेटा, और सेटिंग्स का अच्छा वर्ज़निंग सिस्टम रखना ज़रूरी है। पर LLMs, अपने आकार और फाइन-ट्यूनिंग के प्रति संवेदनशीलता के कारण, वर्ज़न कंट्रोल के लिए अधिक जटिल इन्फ्रास्ट्रक्चर माँगते हैं। SLMs छोटे होने के कारण विभिन्न वर्ज़न्स को मैनेज और डिप्लॉय करना आसान बनाते हैं। गवर्नेंस के मामले में, LLMs को आमतौर पर सख़्त निगरानी चाहिए क्योंकि उनकी क्षमताएँ व्यापक हैं और अनपेक्षित व्यवहार की संभावना अधिक होती है। SLMs, अधिक विशिष्ट उपयोगों के साथ, कम व्यापक लेकिन अधिक लक्षित गवर्नेंस चाह सकते हैं। दोनों के लिए नियमित ऑडिट, प्रदर्शन ट्रैकिंग, और सीमाओं व अभिप्रेत उपयोग की स्पष्ट डॉक्यूमेंटेशन जिम्मेदार AI उपयोग के लिए बहुत महत्वपूर्ण हैं।

एना रोजो एचेबुरúa एप्लाइड मैथमेटिक्स में पीएचडी के साथ एआई और डेटा विशेषज्ञ हैं। वह डेटा को उपयोगी अंतर्दृष्टि में बदलना पसंद करती हैं और तकनीकी टीमों का नेतृत्व करने का व्यापक अनुभव रखती हैं। एना क्लाइंट्स के साथ निकटता से काम करके उनके व्यावसायिक समस्याओं को हल करने और नवीन एआई समाधान बनाने का आनंद लेती हैं। समस्या-समाधान कौशल और स्पष्ट संचार के लिए जानी जाने वाली, वह एआई—विशेषकर जेनरेटिव एआई—के प्रति उत्साही हैं। एना निरंतर सीखने और नैतिक एआई विकास के लिए समर्पित हैं, साथ ही जटिल समस्याओं को सरल बनाने और तकनीक को सहज तरीके से समझाने पर भी ध्यान देती हैं।
स्मॉल लैंग्वेज मॉडल्स (SLMs) छोटे, तेज़, और बड़े पैमाने पर अनुकूलित होने योग्य होने के कारण कम संसाधनों वाले लोगों के लिए AI को अधिक सुलभ और कुशल बनाते हैं—जो लार्ज लैंग्वेज मॉडल्स (LLMs) की तुलना में अधिक व्यावहारिक हैं।
SLMs में पैरामीटर कम होते हैं (आमतौर पर 10 बिलियन से कम), जिससे संगणनात्मक लागत और ऊर्जा खपत में भारी कमी आती है। वे विशिष्ट कार्यों पर केंद्रित होते हैं और छोटे डेटा सेट पर प्रशिक्षित किए जाते हैं। इससे प्रदर्शन और संसाधन-कुशलता के बीच संतुलन बना रहता है।