
6. 优化 WHERE 子句
WHERE 子句在 SQL 查询中至关重要,因为它允许我们根据特定条件筛选数据,确保只返回相关记录。它通过减少处理的数据量来提高查询效率,这在处理大型数据集时尤为重要。
因此,正确使用 WHERE 子句是优化 SQL 查询性能的有力手段。以下是一些可加以利用的方法:
- 尽早添加合适的过滤条件。 有时仅有
WHERE子句还不够,我们还要注意其位置。尽可能在早期过滤掉更多行有助于优化查询。 - 避免在
WHERE子句中的列上使用函数。 当对列应用函数时,数据库必须先对表中每一行应用该函数再进行过滤,这会阻碍索引的有效利用。
例如,不要这样:
SELECT *
FROM employees WHERE
YEAR(hire_date) = 2020;应改为:
SELECT *
FROM employees
WHERE hire_date >= '2020-01-01' AND hire_date < '2021-01-01';- 使用合适的运算符。 我们应选择最能满足需求且最高效的运算符。例如,
=通常比LIKE更快,使用明确的日期范围也通常比使用MONTH(order_date)之类的函数更快。
因此,例如与其执行如下查询:
SELECT *
FROM orders
WHERE MONTH(order_date) = 12 AND YEAR(order_date) = 2023;可以改为:
SELECT *
FROM orders
WHERE order_date >= '2023-12-01' AND order_date < '2024-01-01';7. 优化子查询
在某些情况下,我们在编写查询时希望动态地进行过滤、聚合或连接数据。我们不想写多条查询,而是希望保持为一条查询。
这时可以使用 子查询。SQL 中的子查询是嵌套在另一条查询中的查询,通常出现在 SELECT、INSERT、UPDATE 或 DELETE 语句中。
子查询既强大又可能很快,但若使用不当也会引发性能问题。一般应尽量减少子查询的使用,并遵循以下最佳实践:
- 能用连接就不要用子查询。 连接通常比子查询更快、更高效。
- 改用公用表表达式(CTE)。CTE 可以将代码拆分为多个较小的查询,而不是一个大查询,更易于阅读。
WITH SalesCTE AS (
SELECT salesperson_id, SUM(sales_amount) AS total_sales
FROM sales GROUP BY salesperson_id )
SELECT salesperson_id, total_sales
FROM SalesCTE WHERE total_sales > 5000;- 使用非相关子查询。 非相关子查询独立于外层查询,只需执行一次;而相关子查询会对外层查询的每一行执行一次。
8. 在子查询中用 EXISTS 替代 IN
在使用子查询时,我们经常需要检查某个值是否存在于结果集中。可以使用 IN 或 EXISTS 来实现,但 EXISTS 通常更高效,尤其在大数据集上。
IN 子句会先将整个子查询结果集读入内存再进行比较。相反,EXISTS 子句一旦发现匹配就会停止处理子查询。
以下是该子句的用法示例:
SELECT *
FROM orders o
WHERE EXISTS (SELECT 1 FROM customers c WHERE c.customer_id = o.customer_id AND c.country = 'USA');9. 限制 DISTINCT 的使用
设想我们要进行一次分析,向来自唯一城市的客户发送促销优惠。数据库中同一客户可能有多笔订单。我们首先想到的可能是使用 DISTINCT 子句。
此功能在某些场景下很方便,但在大型数据集上会消耗较多资源。以下是 DISTINCT 的一些替代方案:
- 在数据清洗过程中识别并移除重复数据。这可从源头防止重复数据进入数据库。
- 尽可能用
GROUP BY替代DISTINCT。GROUP BY在与聚合函数结合时通常更高效。
因此,与其执行:
SELECT DISTINCT city FROM customers;我们可以使用:
SELECT city FROM customers GROUP BY city;- 使用窗口函数。诸如
ROW_NUMBER等窗口函数可以帮助我们识别并过滤重复项,而无需使用DISTINCT。
10. 利用数据库特定功能
在处理数据时,我们通过数据库管理系统(DBMS)使用 SQL 与其交互。DBMS 负责处理 SQL 命令、管理数据库,并确保数据的完整性与安全性。不同的数据库系统提供独特功能,可帮助我们优化查询。
数据库 Hint 是我们可以添加到查询中的特殊指令,用于更高效地执行查询。它们很有用,但应谨慎使用。
例如,在 MySQL 中,USE INDEX Hint 可以强制使用特定索引:
SELECT * FROM employees USE INDEX (idx_salary) WHERE salary > 50000;在 SQL Server 中,OPTION (LOOP JOIN) Hint 指定连接方式:
SELECT *
FROM orders
INNER JOIN customers ON orders.customer_id = customers.id OPTION (LOOP JOIN); 这些 Hint 会覆盖默认的查询优化策略,在特定场景下提升性能。
另一方面,分区与分片是两种在云中分布数据的技术。
- 通过分区,我们将一张大表按某个分区键划分为多张更小的表。分区键通常基于行创建的时间戳或其包含的整数值。当在该表上执行查询时,服务器会自动将我们路由到与查询匹配的分区表。
- 分片与此类似,但不是把一张大表拆成多张小表,而是把一个大数据库拆成多个小数据库。每个小数据库位于不同服务器上。分片键会将查询重定向到合适的数据库。分片可提升处理速度,因为负载分散到不同服务器。
11. 监控并优化数据库统计信息
保持数据库统计信息的最新状态很重要,这样查询优化器才能基于准确的信息做出关于如何以最高效方式执行查询的决策。
统计信息描述了表中数据的分布(例如行数、取值频率、各列取值的分布范围),优化器依赖这些信息来估算查询执行成本。如果统计信息过时,优化器可能会选择低效的执行计划,比如使用错误的索引,或选择全表扫描而非更高效的索引扫描,从而导致较差的查询性能。
数据库通常支持自动更新以维护统计信息的准确性。例如,在 SQL Server 中,默认配置会在大量数据发生变化时自动更新统计信息。类似地,PostgreSQL 具有自动分析(auto-analyze)功能,会在达到特定的数据修改阈值后更新统计信息。
不过,在自动更新不足或需要人工干预的情况下,我们也可以手动更新统计信息。在 SQL Server 中,可以使用 UPDATE STATISTICS 命令刷新特定表或索引的统计信息;在 PostgreSQL 中,可以运行 ANALYZE 命令更新一个或多个表的统计信息。
-- Update statistics for all tables in the current database
ANALYZE;
-- Update statistics for a specific table
ANALYZE my_table;12. 使用存储过程
存储过程是一组保存在数据库中的 SQL 命令,这样我们就不用反复编写相同的 SQL。可以把它看作可复用的脚本。
当需要执行某项任务(如更新记录或计算值)时,我们只需调用存储过程。它可以接收输入、执行诸如查询或修改数据的操作,甚至返回结果。存储过程有助于提速,因为 SQL 是预编译的,同时也使代码更简洁、更易管理。
我们可以在 PostgreSQL 中按如下方式创建存储过程:
CREATE OR REPLACE PROCEDURE insert_employee(
emp_id INT,
emp_first_name VARCHAR,
emp_last_name VARCHAR
)
LANGUAGE plpgsql
AS $
BEGIN
-- Insert a new employee into the employees table
INSERT INTO employees (employee_id, first_name, last_name)
VALUES (emp_id, emp_first_name, emp_last_name);
END;
$;
-- call the procedure
CALL insert_employee(101, 'John', 'Doe');13. 避免不必要的排序与分组
作为数据从业者,我们常希望数据经过排序与分组以便更易获得洞见。我们通常会在 SQL 查询中使用 ORDER BY 和 GROUP BY。
然而,这两个子句的计算成本都可能很高,尤其是在处理大型数据集时。对数据进行排序或聚合时,数据库引擎通常需要对数据进行全面扫描,再进行组织、识别分组并/或应用聚合函数,往往使用资源密集型算法。
为优化查询,我们可以参考以下建议:
- 尽量减少排序。仅在必要时使用
ORDER BY。如果排序并非必需,省略该子句可显著减少处理时间。 - 使用索引。 尽可能确保参与
ORDER BY和GROUP BY的列已建立索引。 - 将排序下放到应用层。如果可行,应将排序操作放在应用层而非数据库中完成。
- 预聚合数据。对于涉及
GROUP BY的复杂查询,我们可以在更早的阶段或在物化视图中进行预聚合,避免数据库反复计算相同聚合。
14. 使用 UNION ALL 替代 UNION
当我们想将多条查询的结果合并为一个列表时,可以使用 UNION 和 UNION ALL 子句。两者都可在列名一致时合并两条或多条 SELECT 语句的结果。但它们并不相同,差异使其适用于不同用例。
UNION 会去重,这需要更多处理时间。
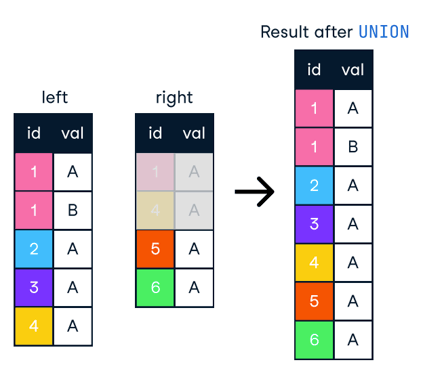
图:SQL 中的 Union。图片来源:DataCamp SQL-Join 速查表。
另一方面,UNION ALL 会合并结果但保留所有行(包括重复)。因此,如果不需要去重,应使用 UNION ALL 以获得更好的性能。
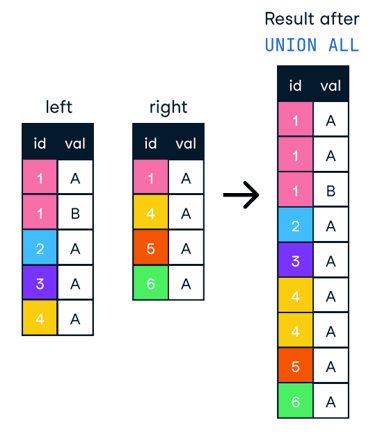
图:SQL 中的 UNION ALL。图片来源:DataCamp SQL-Join 速查表。
-- Potentially slower
SELECT product_id FROM products WHERE category = 'Electronics'
UNION
SELECT product_id FROM products WHERE category = 'Books';
-- Potentially faster
SELECT product_id FROM products WHERE category = 'Electronics'
UNION ALL
SELECT product_id FROM products WHERE category = 'Books';15. 拆解复杂查询
处理大型数据集意味着我们经常会遇到难以理解和优化的复杂查询。我们可以尝试将其拆解为更小、更简单的查询,从而更容易识别性能瓶颈并应用优化技术。
拆解查询最常用的策略之一是使用物化视图。物化视图是预计算并存储的查询结果,访问速度快于每次引用时重新计算。当底层数据发生变化时,需要手动或自动刷新物化视图。
以下是创建并查询物化视图的示例:
-- Create a materialized view
CREATE MATERIALIZED VIEW daily_sales AS
SELECT product_id, SUM(quantity) AS total_quantity
FROM order_items
GROUP BY product_id;
-- Query the materialized view
SELECT * FROM daily_sales;结语
本文探讨了从索引与连接到子查询和数据库特定功能等多种 SQL 查询优化策略与最佳实践。通过应用这些技巧,您可以显著提升查询性能,使数据库运行更高效。
请记住,SQL 查询优化是一个持续的过程。随着数据增长与应用演进,您需要不断监控并优化查询,以确保其保持最佳性能。
若想进一步提升您对 SQL 的理解,建议查阅 DataCamp 上的以下资源:

作者
Maria Eugenia Inzaugarat
SQL 是管理和处理关系型数据库中数据的重要工具。它使我们能够与数据库交互并高效完成关键任务。随着可用数据量日益增长,我们面临着编写复杂查询以提取数据的挑战。
慢查询会成为真正的瓶颈,影响从应用性能到用户体验的一切。优化 SQL 查询可以提升性能、减少资源消耗,并确保可扩展性。
本文将探讨一些优化 SQL 查询的高效技巧。我们将深入分析每种技巧的优缺点,以理解其对 SQL 查询性能的影响。让我们开始吧!
1. 使用合适的索引
想象一下在没有目录的图书馆找书。我们得检查每个书架的每一排,直到最终找到。数据库中的索引就像目录,它们帮助我们快速定位所需数据,而无需扫描整张表。
索引的工作原理
索引是一种用于加速数据检索的数据结构。它通过为被索引的列创建排序副本,使数据库能够快速定位与查询匹配的行,从而为我们节省大量时间。
数据库中主要有三种类型的索引:
那么,如何利用索引来提升 SQL 查询性能?以下是一些最佳实践:
customer_id或item_id查询某张表,为这些列建立索引会显著提升速度。如下所示创建索引:SELECT查询非常有用,但它们可能会略微降低INSERT、UPDATE和DELETE操作的速度。这是因为每次修改数据时都需要更新索引。因此,索引过多会增加数据修改的开销,从而拖慢系统。2. 避免使用 SELECT *
有时我们会图方便使用
SELECT *获取所有列,即便其中很多与分析无关。虽然看似省事,但这会导致非常低效的查询并拖慢性能。数据库必须读取并传输超出必要的数据,导致更高的内存占用,因为服务器需要处理和存储不需要的信息。
作为通用最佳实践,我们应只选择所需的具体列。尽量减少不必要的数据不仅能使代码更简洁易懂,还能帮助优化性能。
因此,与其写:
我们应写:
3. 避免冗余或不必要的数据提取
我们刚提到,仅选择相关列是优化 SQL 查询的最佳实践之一。不过,限制返回的行数同样重要,而不仅仅是列。当返回的行数增加时,查询通常会变慢。
我们可以使用
LIMIT来减少返回的行数。这样可以避免在只需要少量数据时无意中检索成千上万行数据。LIMIT尤其适合用于验证性查询或检查我们正在进行的数据转换的输出。它非常适合实验并理解代码的运行方式。但在需要返回完整数据集的自动化数据模型中,它可能并不适用。下面是
LIMIT的用法示例:4. 高效使用连接(JOIN)
在关系型数据库中,数据通常被组织到不同的表中以避免冗余并提升效率。但这也意味着我们需要从不同位置检索数据并将其拼接在一起以获得所需的全部信息。
连接允许我们在单个查询中基于相关列将两张或多张表的行组合起来,从而执行更复杂的分析。
连接有不同类型,需要理解如何使用。错误的连接方式可能会在数据集中产生重复并使其变慢。
图:内连接。图片来源:DataCamp SQL-Join 速查表。
图:外连接或全连接。图片来源:DataCamp SQL-Join 速查表。
图:左连接与右连接。图片来源:DataCamp SQL-Join 速查表。
高效连接的小贴士:
5. 分析查询执行计划
多数时候,我们运行 SQL 查询只关心结果是否符合预期,但很少思考执行查询时幕后发生了什么。
大多数数据库提供
EXPLAIN或EXPLAIN PLAN等功能来可视化这一过程。执行计划会逐步展示数据库如何检索数据。我们可以利用这一功能找出性能瓶颈,从而就查询优化做出明智决策。下面看看如何使用
EXPLAIN来识别瓶颈。我们将运行以下代码:然后我们可以检查结果:
图:查询执行计划示例。图片来源:CloudDBeaver 网站。
以下是解读结果的一般指导:
WHERE子句不够高效。