
6. WHERE क्लॉज़ को ऑप्टिमाइज़ करें
SQL क्वेरियों में WHERE क्लॉज़ आवश्यक है क्योंकि यह हमें विशिष्ट शर्तों के आधार पर डेटा फ़िल्टर करने देता है, जिससे केवल प्रासंगिक रिकॉर्ड लौटते हैं। यह प्रोसेस किए जाने वाले डेटा की मात्रा कम करके क्वेरी की दक्षता बढ़ाता है, जो बड़े डेटासेट के साथ काम करते समय बहुत महत्वपूर्ण है।
इसलिए, सही WHERE क्लॉज़ SQL क्वेरी के परफॉर्मेंस को ऑप्टिमाइज़ करते समय एक शक्तिशाली सहायक हो सकता है। आइए देखें कि हम इस क्लॉज़ का कैसे लाभ उठा सकते हैं:
- उचित फ़िल्टरिंग शर्तें शुरू में ही जोड़ें। कभी-कभी
WHEREक्लॉज़ होना पर्याप्त नहीं होता। हमें यह भी देखना चाहिए कि क्लॉज़ कहाँ रखा गया है।WHEREक्लॉज़ में जितनी जल्दी हो सके अधिक से अधिक पंक्तियों को फ़िल्टर करना क्वेरी को ऑप्टिमाइज़ करने में मदद करता है। WHEREक्लॉज़ में कॉलम्स पर फ़ंक्शन्स के उपयोग से बचें। जब हम किसी कॉलम पर फ़ंक्शन लगाते हैं, तो डेटाबेस को परिणाम फ़िल्टर करने से पहले टेबल की हर पंक्ति पर वह फ़ंक्शन लगाना पड़ता है। इससे डेटाबेस इंडेक्स का प्रभावी उपयोग नहीं कर पाता।
उदाहरण के लिए, इसके बजाय:
SELECT *
FROM employees WHERE
YEAR(hire_date) = 2020;हमें यह उपयोग करना चाहिए:
SELECT *
FROM employees
WHERE hire_date >= '2020-01-01' AND hire_date < '2021-01-01';- उपयुक्त ऑपरेटर्स का उपयोग करें। हमें अपनी आवश्यकता के अनुरूप सबसे कुशल ऑपरेटर्स चुनने चाहिए। उदाहरण के लिए,
=आम तौर परLIKEसे तेज होता है, और विशिष्ट दिनांक रेंज का उपयोग करनाMONTH(order_date)जैसे फ़ंक्शन्स की तुलना में तेज होता है।
तो, उदाहरण के लिए, यह क्वेरी करने के बजाय:
SELECT *
FROM orders
WHERE MONTH(order_date) = 12 AND YEAR(order_date) = 2023;हम निम्न का उपयोग कर सकते हैं:
SELECT *
FROM orders
WHERE order_date >= '2023-12-01' AND order_date < '2024-01-01';7. सबक्वेरियों को ऑप्टिमाइज़ करें
कुछ मामलों में, हम कोई क्वेरी लिख रहे होते हैं और महसूस करते हैं कि हमें कुछ फ़िल्टरिंग, एग्रीगेशन या जोइन्स को डायनेमिक रूप से करना है। हम कई क्वेरियाँ नहीं करना चाहते; बल्कि हम इसे एक ही क्वेरी में रखना चाहते हैं।
ऐसे मामलों में, हम सबक्वेरियों का उपयोग कर सकते हैं। SQL में सबक्वेरियाँ वे क्वेरियाँ हैं जो किसी दूसरी क्वेरी के भीतर नेस्टेड होती हैं, आमतौर पर SELECT, INSERT, UPDATE या DELETE स्टेटमेंट्स में।
सबक्वेरियाँ शक्तिशाली और तेज हो सकती हैं, लेकिन यदि सावधानी से उपयोग न हों तो वे परफॉर्मेंस समस्याएँ पैदा कर सकती हैं। नियम के तौर पर, हमें सबक्वेरियों के उपयोग को कम करना चाहिए और कुछ सर्वोत्तम अभ्यास अपनाने चाहिए:
- जहाँ संभव हो, सबक्वेरियों को जोइन्स से बदलें। जोइन्स आम तौर पर सबक्वेरियों से तेज और अधिक कुशल होते हैं।
- इसके बजाय कॉमन टेबल एक्सप्रेशन्स (CTEs) का उपयोग करें। CTEs हमारे कोड को एक बड़े क्वेरी के बजाय कुछ छोटे भागों में बाँट देते हैं, जो पढ़ने में अधिक आसान होता है।
WITH SalesCTE AS (
SELECT salesperson_id, SUM(sales_amount) AS total_sales
FROM sales GROUP BY salesperson_id )
SELECT salesperson_id, total_sales
FROM SalesCTE WHERE total_sales > 5000;- अनकोरिलेटेड सबक्वेरियों का उपयोग करें। अनकोरिलेटेड सबक्वेरियाँ बाहरी क्वेरी से स्वतंत्र होती हैं और एक बार चलाई जा सकती हैं, जबकि कोरिलेटेड सबक्वेरियाँ बाहरी क्वेरी की हर पंक्ति के लिए चलाई जाती हैं।
8. सबक्वेरियों के लिए IN की बजाय EXISTS का उपयोग करें
सबक्वेरियों के साथ काम करते समय, हमें अक्सर यह जाँचना होता है कि कोई वैल्यू किसी परिणाम-समुच्चय में मौजूद है या नहीं। हम यह IN या EXISTS से कर सकते हैं, लेकिन बड़े डेटासेट्स के लिए EXISTS आम तौर पर अधिक कुशल होता है।
IN क्लॉज़ तुलना से पहले पूरी सबक्वेरी के परिणाम-समुच्चय को मेमोरी में पढ़ता है। दूसरी ओर, EXISTS मिलान मिलते ही सबक्वेरी का प्रोसेसिंग रोक देता है।
यहाँ इस क्लॉज़ का उपयोग करने का एक उदाहरण है:
SELECT *
FROM orders o
WHERE EXISTS (SELECT 1 FROM customers c WHERE c.customer_id = o.customer_id AND c.country = 'USA');9. DISTINCT के उपयोग को सीमित करें
कल्पना कीजिए कि हम उन ग्राहकों के लिए विश्लेषण कर रहे हैं जिन्हें अनोखे शहरों से प्रमोशनल ऑफर भेजना है। डेटाबेस में उन्हीं ग्राहकों के कई ऑर्डर्स हैं। हमारे दिमाग में सबसे पहले DISTINCT क्लॉज़ का उपयोग आता है।
यह फ़ंक्शन कुछ मामलों में उपयोगी है, लेकिन बड़े डेटासेट्स पर यह संसाधन-गहन हो सकता है। DISTINCT के कुछ विकल्प हैं:
- डेटा क्लीनिंग प्रक्रियाओं के दौरान डुप्लिकेट डेटा की पहचान करें और हटाएँ। इससे शुरुआत में ही डुप्लिकेट्स डेटाबेस में घुसने से रुकते हैं।
- जहाँ संभव हो,
DISTINCTकी बजायGROUP BYका उपयोग करें।GROUP BYविशेषकर एग्रीगेट फ़ंक्शन्स के साथ मिलकर अधिक कुशल हो सकता है।
तो, यह करने के बजाय:
SELECT DISTINCT city FROM customers;हम यह कर सकते हैं:
SELECT city FROM customers GROUP BY city;- विंडो फ़ंक्शन्स का उपयोग करें।
ROW_NUMBERजैसी विंडो फ़ंक्शन्स हमें डुप्लिकेट्स पहचानने और उन्हेंDISTINCTका उपयोग किए बिना फ़िल्टर करने में मदद कर सकती हैं।
10. डेटाबेस-विशिष्ट फीचर्स का लाभ उठाएँ
डेटा के साथ काम करते समय, हम SQL के माध्यम से डेटाबेस मैनेजमेंट सिस्टम (DBMS) का उपयोग करके इंटरैक्ट करते हैं। DBMS SQL कमांड्स को प्रोसेस करता है, डेटाबेस को मैनेज करता है और डेटा की अखंडता व सुरक्षा सुनिश्चित करता है। विभिन्न डेटाबेस सिस्टम ऐसी अनूठी सुविधाएँ प्रदान करते हैं जो क्वेरियों को ऑप्टिमाइज़ करने में मदद कर सकती हैं।
डेटाबेस हिंट्स विशेष निर्देश होते हैं जिन्हें हम अपनी क्वेरियों में जोड़ सकते हैं ताकि क्वेरी अधिक कुशलता से चले। ये सहायक टूल हैं, लेकिन इनका उपयोग सावधानी से करना चाहिए।
उदाहरण के लिए, MySQL में USE INDEX हिंट किसी विशिष्ट इंडेक्स के उपयोग को बाध्य कर सकता है:
SELECT * FROM employees USE INDEX (idx_salary) WHERE salary > 50000;SQL Server में, OPTION (LOOP JOIN) हिंट जॉइन मेथड निर्दिष्ट करता है:
SELECT *
FROM orders
INNER JOIN customers ON orders.customer_id = customers.id OPTION (LOOP JOIN); ये हिंट्स डिफॉल्ट क्वेरी ऑप्टिमाइज़ेशन को ओवरराइड करते हैं और विशिष्ट परिस्थितियों में परफॉर्मेंस में सुधार कर सकते हैं।
दूसरी ओर, पार्टिशनिंग और शार्डिंग क्लाउड में डेटा वितरित करने की दो तकनीकें हैं।
- पार्टिशनिंग में, हम एक बड़ी टेबल को कई छोटी टेबल्स में बाँटते हैं, प्रत्येक का अपना पार्टिशन की होता है। पार्टिशन की आमतौर पर पंक्तियों के बनाए जाने के टाइमस्टैम्प्स या उनमें मौजूद पूर्णांक मानों पर आधारित होते हैं। जब हम इस टेबल पर क्वेरी चलाते हैं, तो सर्वर हमें स्वचालित रूप से हमारी क्वेरी के अनुरूप पार्टिशनड टेबल पर रूट कर देता है।
- शार्डिंग काफी समान है, सिवाय इसके कि एक बड़ी टेबल को छोटी टेबल्स में बाँटने के बजाय, यह एक बड़े डेटाबेस को छोटे डेटाबेसेज़ में बाँटता है। ये प्रत्येक डेटाबेस अलग सर्वर पर होते हैं। पार्टिशन की के बजाय, शार्डिंग की क्वेरियों को उपयुक्त डेटाबेस पर चलाने के लिए रीडायरेक्ट करता है। शार्डिंग प्रोसेसिंग स्पीड बढ़ाता है क्योंकि लोड अलग-अलग सर्वर्स में बाँटा जाता है।
11. डेटाबेस स्टैटिस्टिक्स की निगरानी और ऑप्टिमाइज़ करें
क्वेरी ऑप्टिमाइज़र को क्वेरियों को सबसे कुशल तरीके से चलाने के लिए सूचित और सटीक निर्णय लेने में सक्षम बनाने के लिए डेटाबेस स्टैटिस्टिक्स को अद्यतन रखना महत्वपूर्ण है।
स्टैटिस्टिक्स किसी टेबल में डेटा वितरण का वर्णन करते हैं (जैसे, पंक्तियों की संख्या, मानों की आवृत्ति, और कॉलम्स में मानों का फैलाव), और ऑप्टिमाइज़र क्वेरी एक्सीक्यूशन कॉस्ट का अनुमान लगाने के लिए इस जानकारी पर निर्भर करता है। यदि स्टैटिस्टिक्स पुराने हैं, तो ऑप्टिमाइज़र अक्षम एक्सीक्यूशन प्लान चुन सकता है, जैसे गलत इंडेक्स का उपयोग करना या अधिक कुशल इंडेक्स स्कैन की बजाय फुल टेबल स्कैन चुनना, जिससे क्वेरी परफॉर्मेंस खराब हो सकती है।
डेटाबेस आमतौर पर स्टैटिस्टिक्स को सटीक बनाए रखने के लिए ऑटोमैटिक अपडेट का समर्थन करते हैं। उदाहरण के लिए, SQL Server में डिफॉल्ट कॉन्फ़िगरेशन महत्वपूर्ण डेटा बदलाव पर स्टैटिस्टिक्स को स्वचालित रूप से अपडेट करता है। इसी तरह, PostgreSQL में ऑटो-एनालाइज़ फीचर है, जो डेटा मॉडिफिकेशन की निर्धारित सीमा पार होने पर स्टैटिस्टिक्स को अपडेट करता है।
हालाँकि, जहाँ ऑटोमैटिक अपडेट पर्याप्त नहीं होते या मैनुअल हस्तक्षेप चाहिए होता है, वहाँ हम स्टैटिस्टिक्स को मैन्युअल रूप से अपडेट कर सकते हैं। SQL Server में, हम किसी विशिष्ट टेबल या इंडेक्स के लिए स्टैटिस्टिक्स को रिफ्रेश करने के लिए UPDATE STATISTICS कमांड का उपयोग कर सकते हैं, जबकि PostgreSQL में एक या अधिक टेबल्स के लिए स्टैटिस्टिक्स अपडेट करने हेतु ANALYZE कमांड चलाया जा सकता है।
-- Update statistics for all tables in the current database
ANALYZE;
-- Update statistics for a specific table
ANALYZE my_table;12. स्टोर्ड प्रोसिजर्स का उपयोग करें
स्टोर्ड प्रोसिजर SQL कमांड्स का ऐसा सेट है जिसे हम अपने डेटाबेस में सेव कर लेते हैं ताकि हमें वही SQL बार-बार न लिखना पड़े। इसे एक पुन: प्रयोज्य स्क्रिप्ट की तरह समझें।
जब हमें कोई विशेष कार्य करना हो, जैसे रिकॉर्ड अपडेट करना या मानों की गणना करना, तो हम बस स्टोर्ड प्रोसिजर को कॉल कर लेते हैं। यह इनपुट ले सकता है, कुछ काम कर सकता है—जैसे डेटा क्वेरी करना या संशोधित करना—और परिणाम भी लौटा सकता है। स्टोर्ड प्रोसिजर्स चीज़ों को तेज बनाते हैं क्योंकि SQL पहले से ही प्रीकम्पाइल्ड होता है, जिससे आपका कोड साफ़ और मैनेज करना आसान हो जाता है।
हम PostgreSQL में इस प्रकार स्टोर्ड प्रोसिजर बना सकते हैं:
CREATE OR REPLACE PROCEDURE insert_employee(
emp_id INT,
emp_first_name VARCHAR,
emp_last_name VARCHAR
)
LANGUAGE plpgsql
AS $
BEGIN
-- Insert a new employee into the employees table
INSERT INTO employees (employee_id, first_name, last_name)
VALUES (emp_id, emp_first_name, emp_last_name);
END;
$;
-- call the procedure
CALL insert_employee(101, 'John', 'Doe');13. अनावश्यक सॉर्टिंग और ग्रुपिंग से बचें
डेटा प्रैक्टिशनर्स के रूप में, हमें अंतर्दृष्टि आसानी से पाने के लिए डेटा को ऑर्डर और ग्रुप करना पसंद है। हम आमतौर पर अपनी SQL क्वेरियों में ORDER BY और GROUP BY का उपयोग करते हैं।
हालाँकि, दोनों क्लॉज़ कम्प्यूटेशनल रूप से महँगे हो सकते हैं, खासकर बड़े डेटासेट्स के साथ काम करते समय। डेटा को सॉर्ट या एग्रीगेट करते समय, डेटाबेस इंजन को अक्सर डेटा का फुल स्कैन करना पड़ता है और फिर उसे व्यवस्थित करना, समूहों की पहचान करना और/या एग्रीगेट फ़ंक्शन्स लागू करना पड़ता है, जो आमतौर पर संसाधन-गहन एल्गोरिद्म का उपयोग करता है।
क्वेरियों को ऑप्टिमाइज़ करने के लिए, हम ये सुझाव अपना सकते हैं:
- सॉर्टिंग को न्यूनतम रखें। हमें केवल तभी
ORDER BYका उपयोग करना चाहिए जब आवश्यक हो। यदि सॉर्टिंग आवश्यक नहीं है, तो इस क्लॉज़ को हटाने से प्रोसेसिंग समय में बहुत कमी आ सकती है। - इंडेक्स का उपयोग करें। जहाँ संभव हो, हमें सुनिश्चित करना चाहिए कि
ORDER BYऔरGROUP BYमें शामिल कॉलम्स इंडेक्स्ड हों। - सॉर्टिंग को एप्लिकेशन लेयर में धकेलें। यदि संभव हो, तो हमें सॉर्टिंग ऑपरेशन को डेटाबेस की बजाय एप्लिकेशन लेयर में करना चाहिए।
- डेटा को पूर्व-एग्रीगेट करें। जटिल क्वेरियों में जहाँ
GROUP BYशामिल हो, हम डेटा को पहले के चरण में या मैटीरियलाइज़्ड व्यू में प्री-एग्रीगेट कर सकते हैं, ताकि डेटाबेस को एक ही एग्रीगेट्स बार-बार नहीं गिनने पड़ें।
14. UNION की बजाय UNION ALL का उपयोग करें
जब हम कई क्वेरियों के परिणामों को एक सूची में संयोजित करना चाहते हैं, तो हम UNION और UNION ALL क्लॉज़ का उपयोग कर सकते हैं। दोनों उन दो या अधिक SELECT स्टेटमेंट्स के परिणामों को मिलाते हैं जिनके कॉलम नाम समान होते हैं। हालाँकि, वे एक जैसे नहीं हैं, और उनका अंतर उन्हें अलग-अलग उपयोग मामलों के लिए उपयुक्त बनाता है।
UNION क्लॉज़ डुप्लिकेट पंक्तियों को हटाता है, जिसके लिए अधिक प्रोसेसिंग समय लगता है।
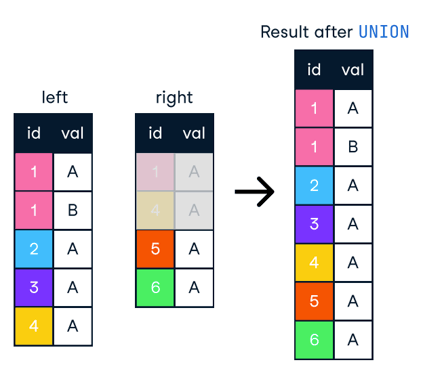
आकृति: SQL में यूनियन। छवि स्रोत: DataCamp SQL-Join चीट शीट।
दूसरी ओर, UNION ALL परिणामों को मिलाता है लेकिन सभी पंक्तियों—डुप्लिकेट्स सहित—को रखता है। इसलिए, यदि हमें डुप्लिकेट्स हटाने की आवश्यकता नहीं है, तो बेहतर परफॉर्मेंस के लिए UNION ALL का उपयोग करना चाहिए।
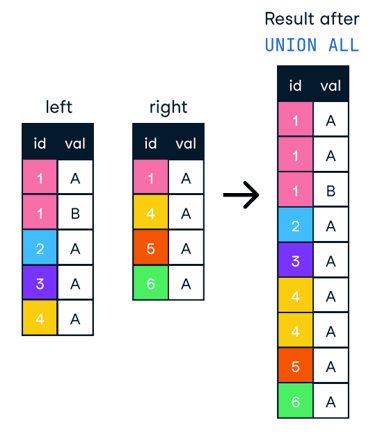
आकृति: SQL में UNION ALL। छवि स्रोत: DataCamp SQL-Join चीट शीट।
-- Potentially slower
SELECT product_id FROM products WHERE category = 'Electronics'
UNION
SELECT product_id FROM products WHERE category = 'Books';
-- Potentially faster
SELECT product_id FROM products WHERE category = 'Electronics'
UNION ALL
SELECT product_id FROM products WHERE category = 'Books';15. जटिल क्वेरियों को तोड़ें
बड़े डेटासेट्स के साथ काम करने का अर्थ है कि हम अक्सर जटिल क्वेरियों का सामना करेंगे जिन्हें समझना और ऑप्टिमाइज़ करना कठिन होता है। हम इन्हें छोटे, सरल क्वेरियों में बाँटकर सुलझाने की कोशिश कर सकते हैं। इससे हम परफॉर्मेंस बॉटलनेक्स को आसानी से पहचान सकते हैं और ऑप्टिमाइज़ेशन तकनीकें लागू कर सकते हैं।
जटिल क्वेरियों को तोड़ने की सबसे आम रणनीतियों में से एक है मैटीरियलाइज़्ड व्यूज़। ये पूर्व-गणना किए गए और संग्रहीत क्वेरी परिणाम होते हैं जिन्हें हर बार क्वेरी दोबारा गणना करने की बजाय जल्दी एक्सेस किया जा सकता है। जब अंतर्निहित डेटा बदलता है, तो मैटीरियलाइज़्ड व्यू को मैनुअल या ऑटोमैटिक रूप से रिफ्रेश करना पड़ता है।
यहाँ मैटीरियलाइज़्ड व्यू बनाने और क्वेरी करने का एक उदाहरण है:
-- Create a materialized view
CREATE MATERIALIZED VIEW daily_sales AS
SELECT product_id, SUM(quantity) AS total_quantity
FROM order_items
GROUP BY product_id;
-- Query the materialized view
SELECT * FROM daily_sales;निष्कर्ष
इस लेख में, हमने SQL क्वेरियों को ऑप्टिमाइज़ करने के लिए विभिन्न रणनीतियों और सर्वोत्तम अभ्यासों का अन्वेषण किया है—इंडेक्सिंग और जोइन्स से लेकर सबक्वेरियों और डेटाबेस-विशिष्ट फीचर्स तक। इन तकनीकों को लागू करके, आप अपनी क्वेरियों के परफॉर्मेंस में उल्लेखनीय सुधार कर सकते हैं और हमारे डेटाबेस को अधिक कुशलता से चला सकते हैं।
याद रखें, SQL क्वेरियों का ऑप्टिमाइज़ेशन एक सतत प्रक्रिया है। जैसे-जैसे आपका डेटा बढ़ता है और आपका एप्लिकेशन विकसित होता है, आपको यह सुनिश्चित करने के लिए अपनी क्वेरियों की लगातार निगरानी और ऑप्टिमाइज़ करना होगा कि वे सर्वोत्तम परफॉर्मेंस पर चल रही हों।
SQL की समझ को और बढ़ाने के लिए, हम आपको DataCamp पर निम्न संसाधन देखने के लिए प्रोत्साहित करते हैं:

लेखक
Maria Eugenia Inzaugarat
SQL संबंधपरक डेटाबेस में डेटा प्रबंधन और हेरफेर करने वाले किसी भी व्यक्ति के लिए एक महत्वपूर्ण टूल है। यह हमें डेटाबेस के साथ इंटरैक्ट करने और आवश्यक कार्यों को कुशलतापूर्वक पूरा करने में सक्षम बनाता है। हर दिन उपलब्ध डेटा की मात्रा बढ़ रही है, इसलिए उस डेटा को प्राप्त करने के लिए हमें जटिल क्वेरियाँ लिखने की चुनौती का सामना करना पड़ता है।
धीमी क्वेरियाँ वास्तविक बाधा बन सकती हैं, जो एप्लिकेशन परफॉर्मेंस से लेकर उपयोगकर्ता अनुभव तक सब कुछ प्रभावित करती हैं। SQL क्वेरियों का ऑप्टिमाइज़ेशन परफॉर्मेंस में सुधार करता है, संसाधन खपत को कम करता है और स्केलेबिलिटी सुनिश्चित करता है।
इस लेख में, हम SQL क्वेरियों को ऑप्टिमाइज़ करने की कुछ सबसे प्रभावी तकनीकों पर नज़र डालेंगे। हम प्रत्येक तकनीक के लाभ और सीमाएँ समझेंगे ताकि SQL क्वेरी परफॉर्मेंस पर उनके प्रभाव को समझा जा सके। आइए शुरू करें!
1. उचित इंडेक्सिंग का उपयोग करें
सोचिए कि हम बिना कैटलॉग के किसी लाइब्रेरी में किताब खोज रहे हैं। हमें उसे ढूंढने तक हर शेल्फ और हर पंक्ति देखनी पड़ेगी। डेटाबेस में इंडेक्स कैटलॉग जैसे ही होते हैं। वे हमें पूरी टेबल स्कैन किए बिना ज़रूरी डेटा जल्दी से ढूंढने में मदद करते हैं।
इंडेक्स कैसे काम करते हैं
इंडेक्स वे डेटा स्ट्रक्चर हैं जो डेटा को प्राप्त करने की गति में सुधार करते हैं। वे इंडेक्स की गई कॉलम्स की एक सॉर्टेड कॉपी बनाकर काम करते हैं, जिससे डेटाबेस हमारी क्वेरी से मेल खाने वाली पंक्तियों को जल्दी पहचान सके और हमारा काफी समय बचे।
डेटाबेस में इंडेक्स के तीन प्रमुख प्रकार होते हैं:
तो, हम SQL क्वेरियों के परफॉर्मेंस को बेहतर करने के लिए इंडेक्स का उपयोग कैसे कर सकते हैं? आइए कुछ सर्वोत्तम तरीकों को देखें:
customer_idयाitem_idसे किसी टेबल में खोज करते हैं, तो उन कॉलम्स पर इंडेक्सिंग करने से गति पर बड़ा प्रभाव पड़ेगा। नीचे देखें कि इंडेक्स कैसे बनाते हैं:SELECTक्वेरियों को तेज करते हैं, वहीं वेINSERT,UPDATEऔरDELETEऑपरेशन्स को थोड़ा धीमा कर सकते हैं। ऐसा इसलिए होता है क्योंकि हर बार डेटा में बदलाव पर इंडेक्स को अपडेट करना पड़ता है। इसलिए बहुत अधिक इंडेक्स डेटा मॉडिफिकेशन के ओवरहेड को बढ़ाकर चीज़ों को धीमा कर सकते हैं।2. SELECT * से बचें
कभी-कभी हम
SELECT *का उपयोग कर सभी कॉलम्स ले लेते हैं, भले ही वे हमारे विश्लेषण से संबंधित न हों। यह सुविधाजनक लगे, लेकिन यह बहुत अक्षम क्वेरियाँ बनाता है जो परफॉर्मेंस को धीमा कर सकती हैं।डेटाबेस को ज़रूरत से ज़्यादा डेटा पढ़ना और ट्रांसफर करना पड़ता है, जिससे अधिक मेमोरी की आवश्यकता होती है क्योंकि सर्वर को आवश्यक से अधिक जानकारी प्रोसेस और स्टोर करनी पड़ती है।
सामान्य सर्वोत्तम अभ्यास के रूप में, हमें केवल वही विशिष्ट कॉलम्स चुनने चाहिए जिनकी हमें आवश्यकता है। अनावश्यक डेटा को न्यूनतम करना न केवल हमारे कोड को साफ और समझने में आसान रखेगा बल्कि परफॉर्मेंस को भी बेहतर करेगा।
तो, यह लिखने के बजाय:
हमें यह लिखना चाहिए:
3. अनावश्यक या दोहराए गए डेटा पुनर्प्राप्ति से बचें
हमने अभी चर्चा की कि केवल प्रासंगिक कॉलम्स चुनना SQL क्वेरियों को ऑप्टिमाइज़ करने का सर्वोत्तम अभ्यास है। हालाँकि, केवल कॉलम्स ही नहीं, बल्कि हम जितनी पंक्तियाँ ला रहे हैं उनकी संख्या को सीमित करना भी महत्वपूर्ण है। जब पंक्तियों की संख्या बढ़ती है तो क्वेरियाँ अक्सर धीमी हो जाती हैं।
हम लौटाई जाने वाली पंक्तियों की संख्या कम करने के लिए
LIMITका उपयोग कर सकते हैं। यह सुविधा तब उपयोगी होती है जब हमें वास्तव में कुछ ही पंक्तियों पर काम करना है, लेकिन अनजाने में हम हज़ारों पंक्तियाँ खींच लाते हैं—यह इससे बचाती है।LIMITफ़ंक्शन खासकर वैलिडेशन क्वेरियों या उस ट्रांसफॉर्मेशन के आउटपुट को देखने के लिए सहायक है जिस पर हम काम कर रहे हैं। यह प्रयोग और हमारे कोड के बर्ताव को समझने के लिए आदर्श है। हालाँकि, यह स्वचालित डेटा मॉडलों के लिए उपयुक्त नहीं हो सकता, जहाँ हमें पूरा डेटासेट लौटाना होता है।यहाँ
LIMITकैसे काम करता है, उसका एक उदाहरण है:4. जोइन्स का कुशल उपयोग करें
जब हम संबंधपरक डेटाबेस के साथ काम करते हैं, तो डेटा को अक्सर दोहराव से बचने और दक्षता बढ़ाने के लिए अलग-अलग टेबल्स में व्यवस्थित किया जाता है। इसका मतलब है कि हमें अलग-अलग जगहों से डेटा लाना होता है और उसे जोड़ना होता है ताकि हमें आवश्यक सभी प्रासंगिक जानकारी मिल सके।
जोइन्स हमें संबंधित कॉलम के आधार पर दो या अधिक टेबल्स की पंक्तियों को एक ही क्वेरी में संयोजित करने देते हैं, जिससे अधिक जटिल विश्लेषण संभव हो पाते हैं।
जोइन्स के अलग-अलग प्रकार होते हैं, और हमें उनका उपयोग समझदारी से करना चाहिए। गलत जॉइन हमारे डेटासेट में डुप्लिकेट्स बना सकता है और उसे धीमा कर सकता है।
आकृति: इनर जॉइन। छवि स्रोत: DataCamp SQL-Join चीट शीट।
आकृति: आउटर या फुल जॉइन। छवि स्रोत: DataCamp SQL-Join चीट शीट।
आकृति: लेफ्ट और राइट जॉइन। छवि स्रोत: DataCamp SQL-Join चीट शीट।
कुशल जोइन्स के लिए सुझाव:
5. क्वेरी एक्सीक्यूशन प्लान का विश्लेषण करें
अक्सर हम SQL क्वेरियाँ चलाते हैं और केवल यह देखते हैं कि आउटपुट हमारी अपेक्षा के अनुरूप है या नहीं। लेकिन हम शायद ही यह सोचते हैं कि जब हम SQL क्वेरी चलाते हैं तो पर्दे के पीछे क्या होता है।
अधिकांश डेटाबेस इस प्रक्रिया को दर्शाने के लिए
EXPLAINयाEXPLAIN PLANजैसी सुविधाएँ प्रदान करते हैं। ये प्लान बताते हैं कि डेटाबेस डेटा कैसे प्राप्त करेगा, उसका चरण-दर-चरण खाका। हम इस सुविधा का उपयोग परफॉर्मेंस बाधाओं की पहचान करने और अपनी क्वेरियों को ऑप्टिमाइज़ करने के लिए सूचित निर्णय लेने में कर सकते हैं।आइए देखें कि हम
EXPLAINका उपयोग करके बॉटलनेक्स कैसे पहचान सकते हैं। हम निम्न कोड चलाएँगे:फिर हम परिणामों की जाँच कर सकते हैं:
आकृति: क्वेरी एक्सीक्यूशन प्लान का उदाहरण। छवि स्रोत: CloudDBeaver वेबसाइट।
परिणामों की व्याख्या के लिए सामान्य दिशानिर्देश:
WHEREक्लॉज़ का संकेत देता है।