
संक्षेप में
- वेक्टर डेटाबेस उच्च-आयामी डेटा (एंबेडिंग्स) को संग्रहीत और खोजते हैं, और वे समानता के आधार पर काम करते हैं, न कि सटीक मिलान पर—इसीलिए वे RAG, रिकमेंडेशन इंजन, और अनोमली डिटेक्शन जैसे AI अनुप्रयोगों के लिए अनिवार्य हैं
- 2026 के शीर्ष 7 वेक्टर डेटाबेस हैं: Chroma, Pinecone, Weaviate, Faiss, Qdrant, Milvus, और pgvector
- चयन के प्रमुख कारक हैं: स्केल आवश्यकताएँ, managed बनाम self-hosted वरीयता, मौजूदा टेक स्टैक, और बजट
- RAG (Retrieval-Augmented Generation) 2026 में वेक्टर डेटाबेस अपनाने का प्रमुख उपयोग मामला बन गया है
- Chroma और Faiss जैसे ओपन-सोर्स विकल्प प्रोटोटाइपिंग के लिए आदर्श हैं, जबकि Pinecone और Milvus बड़े पैमाने पर प्रोडक्शन वर्कलोड को लक्षित करते हैं
वेक्टर डेटाबेस क्या है?
वेक्टर डेटाबेस एक विशेष प्रकार का डेटाबेस है जो जानकारी को बहु-आयामी वेक्टरों के रूप में सहेजता है, जो कुछ विशेषताओं या गुणों का प्रतिनिधित्व करते हैं।
प्रत्येक वेक्टर में आयामों की संख्या डेटा की जटिलता और विवरण के आधार पर कुछ से लेकर कई हज़ार तक हो सकती है। इस डेटा—जैसे पाठ, चित्र, ऑडियो और वीडियो—को मशीन लर्निंग मॉडल, वर्ड एंबेडिंग्स, या फीचर एक्सट्रैक्शन तकनीकों के माध्यम से वेक्टरों में बदला जाता है।
वेक्टर डेटाबेस का प्रमुख लाभ यह है कि यह वेक्टर की निकटता या समानता के आधार पर डेटा को तेज़ी और सटीकता से ढूंढ और प्राप्त कर सकता है। इससे खोजें सिमेंटिक या संदर्भगत प्रासंगिकता पर आधारित हो जाती हैं, न कि केवल सटीक मिलान या निर्धारित मानदंडों पर, जैसा कि पारंपरिक डेटाबेस में होता है।
उदाहरण के लिए, एक वेक्टर डेटाबेस के साथ, आप:
- धुन और ताल के आधार पर किसी खास धुन से मेल खाते गीत खोज सकते हैं।
- थीम और दृष्टिकोण में किसी अन्य विशेष लेख से मेल खाते लेख खोज सकते हैं।
- ऐसे गैजेट्स पहचान सकते हैं जिनकी विशेषताएँ और समीक्षाएँ किसी खास डिवाइस से मिलती-जुलती हों।
वेक्टर डेटाबेस कैसे काम करता है?
पारंपरिक डेटाबेस शब्दों और संख्याओं जैसे सरल डेटा को तालिका स्वरूप में संग्रहीत करते हैं। वहीं, वेक्टर डेटाबेस वेक्टर कहलाने वाले जटिल डेटा के साथ काम करते हैं और खोज के लिए विशिष्ट तरीकों का उपयोग करते हैं।
जहाँ सामान्य डेटाबेस सटीक मिलान खोजते हैं, वेक्टर डेटाबेस विशेष समानता मापों का उपयोग कर सबसे नज़दीकी मिलान तलाशते हैं।
वेक्टर डेटाबेस Approximate Nearest Neighbor (ANN) नामक विशेष खोज तकनीकों का उपयोग करते हैं, जिनमें हैशिंग और ग्राफ-आधारित खोज जैसी विधियाँ शामिल हैं।
वास्तव में समझने के लिए कि वेक्टर डेटाबेस कैसे काम करते हैं और वे पारंपरिक रिलेशनल डेटाबेस जैसे SQL से कैसे भिन्न हैं, हमें पहले एंबेडिंग्स की अवधारणा समझनी होगी।
असंरचित डेटा, जैसे पाठ, चित्र, और ऑडियो, का पूर्वनिर्धारित फ़ॉर्मेट नहीं होता, जिससे पारंपरिक डेटाबेस के लिए चुनौतियाँ पैदा होती हैं। इस डेटा का AI और मशीन लर्निंग में लाभ उठाने के लिए, इसे एंबेडिंग्स के माध्यम से संख्यात्मक प्रतिनिधित्व में बदला जाता है।
एंबेडिंग ऐसा है जैसे प्रत्येक वस्तु—चाहे वह शब्द हो, चित्र हो, या कुछ और—को एक अनोखा कोड दे दिया जाए जो उसके अर्थ या सार को समेटे। यह कोड कंप्यूटरों को इन वस्तुओं को अधिक कुशल और सार्थक तरीके से समझने और तुलना करने में मदद करता है। इसे ऐसे समझें जैसे किसी जटिल किताब को एक संक्षिप्त सार में बदल दिया जाए, जो फिर भी मुख्य बिंदुओं को पकड़े रखे।
यह एंबेडिंग प्रक्रिया आमतौर पर विशेष कार्य के लिए डिज़ाइन किए गए एक प्रकार के न्यूरल नेटवर्क से हासिल की जाती है। उदाहरण के लिए, वर्ड एंबेडिंग्स शब्दों को ऐसे वेक्टरों में बदलती हैं कि समान अर्थ वाले शब्द वेक्टर स्पेस में पास हों।
यह परिवर्तन एल्गोरिद्मों को वस्तुओं के बीच संबंध और समानताएँ समझने में सक्षम बनाता है।
मूल रूप से, एंबेडिंग्स एक सेतु का काम करती हैं, गैर-संख्यात्मक डेटा को ऐसे रूप में बदलती हैं जिस पर मशीन लर्निंग मॉडल काम कर सकें, जिससे वे डेटा में पैटर्न और संबंध अधिक प्रभावी ढंग से पहचान सकें।
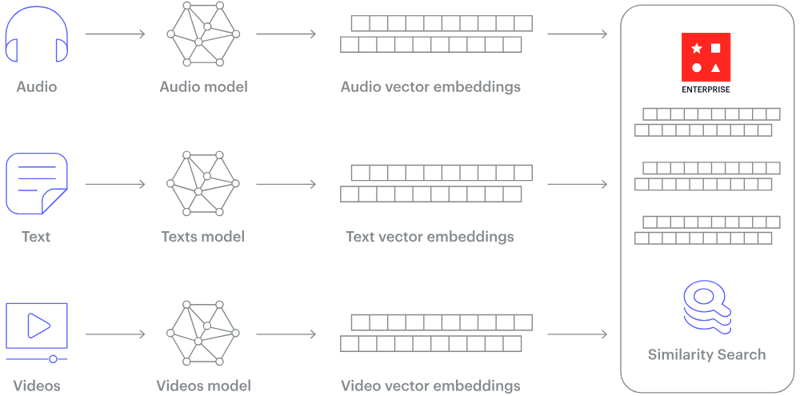
वेक्टर डेटाबेस कैसे काम करता है? (चित्र स्रोत)
वेक्टर डेटाबेस के अनुप्रयोग
अपनी विशिष्ट क्षमताओं के साथ, वेक्टर डेटाबेस "सिमिलैरिटी सर्च" को कुशलतापूर्वक लागू करने की क्षमता के कारण कई उद्योगों में अपना स्थान बना रहे हैं। इनके विविध उपयोगों पर एक नज़र:
1. रिटेल अनुभवों को बेहतर बनाना
तेज़ी से बदलते रिटेल सेक्टर में, वेक्टर डेटाबेस उपभोक्ताओं की खरीदारी के तरीके को बदल रहे हैं। वे उन्नत रिकमेंडेशन सिस्टम सक्षम करते हैं, जो व्यक्तिगत शॉपिंग अनुभव तैयार करते हैं। उदाहरण के लिए, ऑनलाइन खरीदार को केवल पिछले ख़रीदारी इतिहास पर नहीं, बल्कि उत्पाद विशेषताओं, उपयोगकर्ता व्यवहार, और पसंद-नापसंद में समानताओं का विश्लेषण करके भी सुझाव मिल सकते हैं।
2. वित्तीय डेटा विश्लेषण
वित्तीय क्षेत्र जटिल पैटर्न और रुझानों से भरा है। वेक्टर डेटाबेस इस घने डेटा का विश्लेषण करने में श्रेष्ठ हैं, जिससे विश्लेषकों को निवेश रणनीतियों के लिए महत्वपूर्ण पैटर्न ढूँढने में मदद मिलती है। सूक्ष्म समानताओं या विचलनों की पहचान कर वे बाज़ार की चाल का पूर्वानुमान लगा सकते हैं और अधिक सूचित निवेश रूपरेखा बना सकते हैं।
3. स्वास्थ्य सेवा
हेल्थकेयर में वैयक्तिकरण अत्यंत महत्वपूर्ण है। जीनोमिक अनुक्रमों का विश्लेषण करके, वेक्टर डेटाबेस अधिक व्यक्तिगत उपचार संभव बनाते हैं, ताकि चिकित्सा समाधान व्यक्ति की आनुवंशिक संरचना के और करीब हों।
4. नैचुरल लैंग्वेज प्रोसेसिंग (NLP) अनुप्रयोगों को सशक्त बनाना
डिजिटल दुनिया में चैटबॉट्स और वर्चुअल असिस्टेंट्स का तेज़ी से विस्तार हो रहा है। ये AI-संचालित सिस्टम मानव भाषा को समझने पर निर्भर हैं। विशाल टेक्स्ट डेटा को वेक्टर में बदलकर, ये सिस्टम मानव प्रश्नों को अधिक सटीकता से समझ और उत्तर दे सकते हैं। उदाहरण के लिए, Talkmap जैसी कंपनियाँ रीयल-टाइम नैचुरल लैंग्वेज अंडरस्टैंडिंग का उपयोग करती हैं, जिससे ग्राहक-एजेंट संवाद अधिक सुगम होते हैं।
5. मीडिया विश्लेषण
मेडिकल स्कैन से लेकर निगरानी फुटेज तक, छवियों की सटीक तुलना और समझ बेहद महत्वपूर्ण है। वेक्टर डेटाबेस छवियों की आवश्यक विशेषताओं पर ध्यान केंद्रित कर, शोर और विकृतियों को अलग कर, इस प्रक्रिया को सरल बनाते हैं। उदाहरण के लिए, यातायात प्रबंधन में वीडियो फीड की छवियों का त्वरित विश्लेषण कर ट्रैफ़िक प्रवाह का अनुकूलन और सार्वजनिक सुरक्षा में सुधार किया जा सकता है।
6. अनोमली डिटेक्शन
समानताओं को पहचानना जितना आवश्यक है, अपवादों को पकड़ना भी उतना ही ज़रूरी है। खासकर वित्त और सुरक्षा जैसे क्षेत्रों में, अनियमितताओं का पता लगाना धोखाधड़ी रोकने या संभावित सुरक्षा उल्लंघन से पहले चेतावनी देने का काम कर सकता है। वेक्टर डेटाबेस इस क्षेत्र में बेहतर क्षमताएँ प्रदान करते हैं, जिससे पहचान प्रक्रिया तेज़ और अधिक सटीक होती है।
7. RAG पाइपलाइनों को सशक्त बनाना
2026 में वेक्टर डेटाबेस का सबसे प्रभावशाली अनुप्रयोगों में से एक है Retrieval-Augmented Generation (RAG)। RAG सिस्टम में, वेक्टर डेटाबेस दस्तावेज़ एंबेडिंग्स संग्रहीत करते हैं जिन्हें LLMs इन्फरेंस के समय क्वेरी करते हैं, ताकि अधिक सटीक और आधारभूत उत्तर उत्पन्न किए जा सकें। यह दृष्टिकोण ग्राहक सहायता चैटबॉट्स से लेकर एंटरप्राइज़ नॉलेज मैनेजमेंट सिस्टम तक, AI अनुप्रयोगों के लिए मानक इन्फ्रास्ट्रक्चर बन गया है, और यही वेक्टर डेटाबेस बाज़ार की तीव्र वृद्धि के पीछे एक प्रमुख कारण है।
एक अच्छे वेक्टर डेटाबेस की विशेषताएँ
वेक्टर डेटाबेस असंरचित डेटा—जैसे छवियाँ, वीडियो, और टेक्स्ट—के विशाल परिदृश्य में बिना मानव-निर्मित लेबल या टैग पर अत्यधिक निर्भर हुए नेविगेट करने के शक्तिशाली उपकरण के रूप में उभरे हैं। उन्नत मशीन लर्निंग मॉडलों के साथ एकीकृत होने पर, उनकी क्षमताएँ ई-कॉमर्स से फार्मास्यूटिकल्स तक कई क्षेत्रों में क्रांति ला सकती हैं। यहाँ कुछ प्रमुख विशेषताएँ हैं जो वेक्टर डेटाबेस को गेम-चेंजर बनाती हैं:
1. स्केलेबिलिटी और अनुकूलनशीलता
एक मज़बूत वेक्टर डेटाबेस यह सुनिश्चित करता है कि जैसे-जैसे डेटा बढ़ता है—लाखों से लेकर अरबों तत्वों तक—वह कई नोड्स में सहजता से स्केल कर सके। सर्वश्रेष्ठ वेक्टर डेटाबेस अनुकूलनशीलता प्रदान करते हैं, जिससे उपयोगकर्ता इंसर्शन रेट, क्वेरी रेट, और हार्डवेयर में बदलाव के अनुरूप सिस्टम को ट्यून कर सकें।
2. बहु-उपयोगकर्ता समर्थन और डेटा गोपनीयता
कई उपयोगकर्ताओं को समायोजित करना डेटाबेस से अपेक्षित मानक है। हालाँकि, प्रत्येक उपयोगकर्ता के लिए अलग वेक्टर डेटाबेस बनाना कुशल नहीं है। वेक्टर डेटाबेस डेटा आइसोलेशन को प्राथमिकता देते हैं, जिससे किसी एक कलेक्शन में किए गए परिवर्तन बाकी से तब तक छिपे रहते हैं जब तक कि मालिक उन्हें जानबूझकर साझा न करे। यह न केवल मल्टी-टेनेन्सी को समर्थन देता है बल्कि डेटा की गोपनीयता और सुरक्षा भी सुनिश्चित करता है।
3. व्यापक API सूट
एक वास्तविक और प्रभावी डेटाबेस पूर्ण API और SDK सेट प्रदान करता है। इससे सिस्टम विविध अनुप्रयोगों से संवाद कर सकता है और प्रभावी तरीके से प्रबंधित किया जा सकता है। प्रमुख वेक्टर डेटाबेस, जैसे Pinecone, Python, Node, Go, और Java जैसी कई भाषाओं में SDKs प्रदान करते हैं, जिससे विकास और प्रबंधन में लचीलापन मिलता है।
4. उपयोगकर्ता-अनुकूल इंटरफेस
नई तकनीकों से जुड़े कठिन सीखने-घुमाव को कम करने में, वेक्टर डेटाबेस के उपयोगकर्ता-अनुकूल इंटरफेस महत्वपूर्ण भूमिका निभाते हैं। ये इंटरफेस विज़ुअल ओवरव्यू, आसान नेविगेशन, और उन फीचर्स तक पहुँच प्रदान करते हैं जो अन्यथा छिपे रह सकते हैं।
2026 के 7 सर्वश्रेष्ठ वेक्टर डेटाबेस
यह सूची किसी विशेष क्रम में नहीं है—इनमें से प्रत्येक में ऊपर बताई गई कई खूबियाँ मौजूद हैं।
1. Chroma
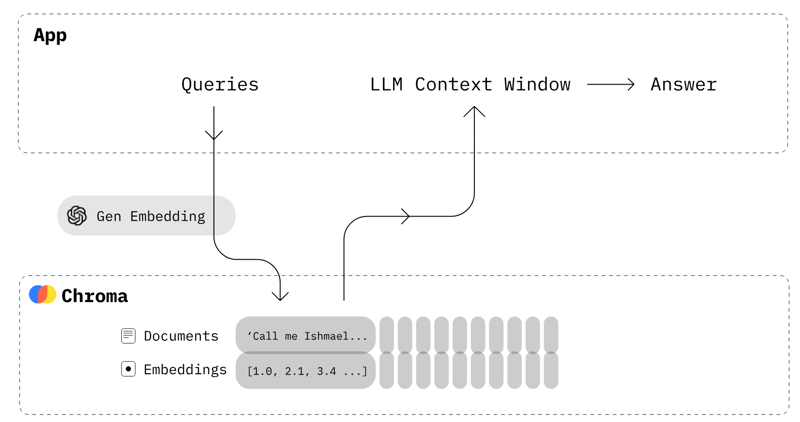
ChromaDB का उपयोग करके LLM ऐप्स बनाना (चित्र स्रोत)
Chroma एक ओपन-सोर्स एंबेडिंग डेटाबेस है। Chroma LLMs के लिए ज्ञान, तथ्य, और कौशल को प्लग करने योग्य बनाकर LLM ऐप्स बनाना आसान बनाता है। हमारे Chroma DB ट्यूटोरियल में, आप आसानी से टेक्स्ट दस्तावेज़ प्रबंधित कर सकते हैं, टेक्स्ट को एंबेडिंग्स में बदल सकते हैं, और सिमिलैरिटी सर्च कर सकते हैं।
ChromaDB की विशेषताएँ:
- LangChain (Python और JavaScript) और LlamaIndex का समर्थन
- वही API जो Python नोटबुक में चलता है, प्रोडक्शन क्लस्टर तक स्केल होता है
- वेक्टर, फुल-टेक्स्ट, regex, और मेटाडेटा सर्च का आउट-ऑफ-द-बॉक्स समर्थन
- ऑब्जेक्ट स्टोरेज पर निर्मित, लागत दक्षता के लिए स्वचालित डेटा टियरिंग के साथ
2. Pinecone
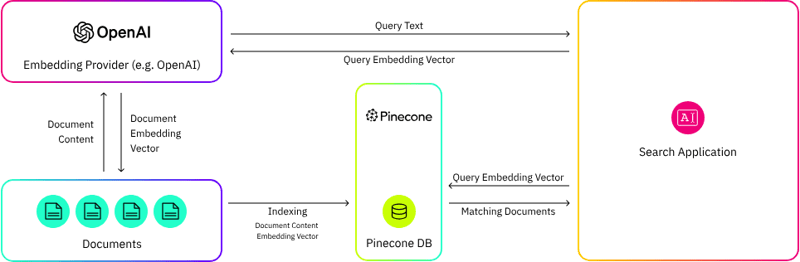
Pinecone वेक्टर डेटाबेस
Pinecone एक managed वेक्टर डेटाबेस प्लेटफ़ॉर्म है, जिसे उच्च-आयामी डेटा से जुड़ी विशिष्ट चुनौतियों का समाधान करने के लिए बनाया गया है। अत्याधुनिक इंडेक्सिंग और सर्च क्षमताओं से लैस, Pinecone डेटा इंजीनियरों और डेटा वैज्ञानिकों को बड़े पैमाने के मशीन लर्निंग अनुप्रयोगों के निर्माण और परिनियोजन में सक्षम बनाता है, जो उच्च-आयामी डेटा को प्रभावी ढंग से प्रोसेस और विश्लेषित करते हैं।
Pinecone की प्रमुख विशेषताएँ:
- पूरी तरह से managed, serverless आर्किटेक्चर—इन्फ्रास्ट्रक्चर प्रबंधन की आवश्यकता नहीं
- अरबों वेक्टर तक अत्यधिक स्केलेबल, पूर्वानुमेय परफॉर्मेंस के साथ
- लाइव इंडेक्सिंग के साथ रीयल-टाइम डेटा ingestion
- प्रोडक्शन वर्कलोड के लिए अनुकूलित लो-लेटेंसी सिमिलैरिटी सर्च
- डेंस और स्पार्स वेक्टर के साथ मेटाडेटा फ़िल्टरिंग को मिलाकर हाइब्रिड सर्च
- LangChain, LlamaIndex, और Hugging Face के साथ एकीकरण
Pinecone BYOC (Bring Your Own Cloud) डिप्लॉयमेंट का भी समर्थन करता है, जिससे एंटरप्राइज़ ग्राहकों को डेटा रेज़िडेंसी नियंत्रण मिलता है, और Pinecone Inference के माध्यम से बिल्ट-इन एंबेडिंग और रीरैंकिंग मॉडल प्रदान करता है।
Pinecone के बारे में और जानने के लिए Mastering Vector Databases with Pinecone ट्यूटोरियल देखें।
3. Weaviate
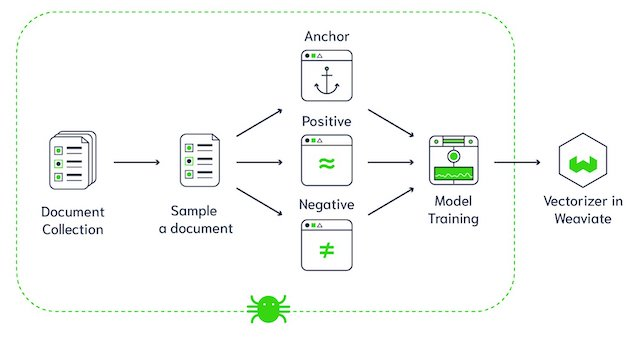
Weaviate वेक्टर डेटाबेस आर्किटेक्चर (चित्र स्रोत)
Weaviate एक ओपन-सोर्स, AI-नेटिव वेक्टर डेटाबेस है। हमारे Weaviate ट्यूटोरियल में, यह आपको अपने पसंदीदा ML मॉडलों से डेटा ऑब्जेक्ट्स और वेक्टर एंबेडिंग्स स्टोर करने देता है और अरबों डेटा ऑब्जेक्ट्स तक सहजता से स्केल करता है। Weaviate की कुछ प्रमुख विशेषताएँ:
- Weaviate लाखों ऑब्जेक्ट्स में से निकटतम पड़ोसियों को कुछ मिलीसेकंड में खोज सकता है।
- Weaviate के साथ, आप इम्पोर्ट के दौरान डेटा को वेक्टराइज़ कर सकते हैं या अपना स्वयं का अपलोड कर सकते हैं, और OpenAI, Cohere, HuggingFace जैसी प्लेटफ़ॉर्म्स के साथ एकीकृत मॉड्यूल्स का लाभ ले सकते हैं।
- प्रोटोटाइप से लेकर बड़े पैमाने के प्रोडक्शन तक, Weaviate स्केलेबिलिटी, प्रतिकृति, और सुरक्षा पर ज़ोर देता है।
- तेज़ वेक्टर सर्च के अलावा, Weaviate रिकमेंडेशन, समरीकरण, और न्यूरल सर्च फ़्रेमवर्क इंटीग्रेशन प्रदान करता है।
4. Faiss
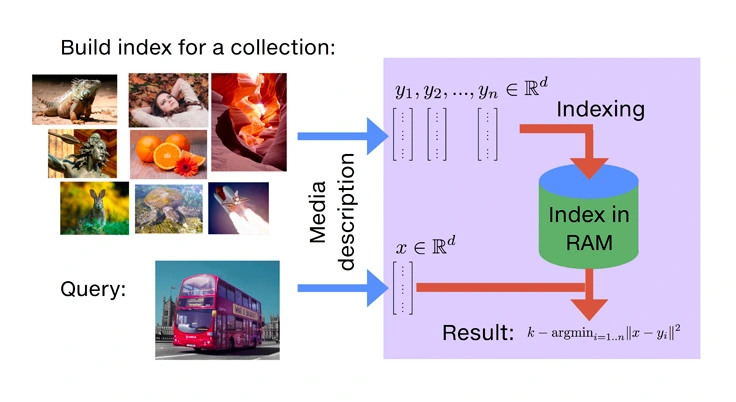
Faiss वेक्टर सर्च के लिए Meta द्वारा बनाया गया एक ओपन-सोर्स लाइब्रेरी है (चित्र स्रोत)
Faiss समानताओं की तेज़ खोज और डेंस वेक्टरों के क्लस्टरिंग के लिए एक ओपन-सोर्स लाइब्रेरी है। इसमें ऐसे एल्गोरिद्म हैं जो विभिन्न आकारों के वेक्टर सेट्स में खोज कर सकते हैं, यहाँ तक कि वे भी जो RAM क्षमता से अधिक हों। इसके अलावा, Faiss आकलन और पैरामीटर ट्यूनिंग के लिए सहायक कोड भी प्रदान करता है।
हालाँकि इसका अधिकांश कोड C++ में है, यह Python/NumPy इंटीग्रेशन को पूरी तरह सपोर्ट करता है। इसके कुछ प्रमुख एल्गोरिद्म GPU पर भी चलाए जा सकते हैं। Faiss का प्राथमिक विकास Meta के Fundamental AI Research समूह द्वारा किया जाता है।
5. Qdrant
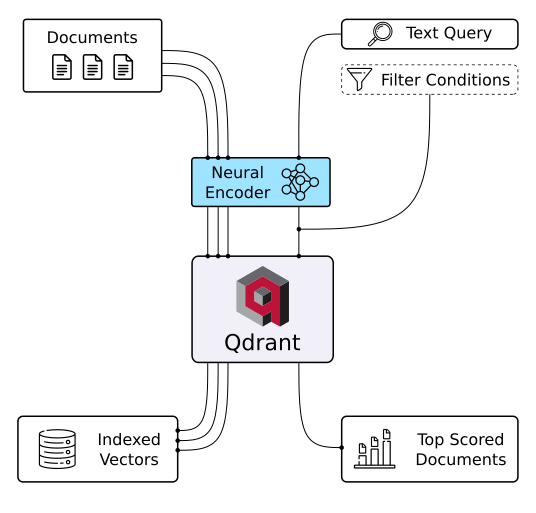
Qdrant वेक्टर डेटाबेस (चित्र स्रोत)
Qdrant एक वेक्टर डेटाबेस और वेक्टर सिमिलैरिटी सर्च करने का टूल है। यह API सेवा के रूप में काम करता है, उच्च-आयामी वेक्टरों के सबसे नज़दीकी मिलानों की खोज सक्षम करता है। Qdrant का उपयोग करके, आप एंबेडिंग्स या न्यूरल नेटवर्क एन्कोडर्स को मैचिंग, सर्चिंग, रिकमेंडेशन आदि कार्यों के लिए संपूर्ण अनुप्रयोगों में बदल सकते हैं। Qdrant की कुछ प्रमुख विशेषताएँ:
- OpenAPI v3 स्पेसिफिकेशन और विभिन्न भाषाओं के लिए तैयार क्लाइंट्स।
- तेज़ और सटीक खोज के लिए कस्टम HNSW एल्गोरिद्म।
- संबद्ध वेक्टर पेलोड्स के आधार पर परिणामों का फ़िल्टरिंग।
- स्ट्रिंग मैचिंग, संख्यात्मक रेंज, जियो-लोकेशंस आदि का समर्थन।
- क्लाउड-नेटिव डिज़ाइन, हॉरिजॉन्टल स्केलिंग क्षमताओं के साथ।
- Rust में निर्मित, डायनेमिक क्वेरी प्लानिंग के साथ संसाधनों का अनुकूलन।
6. Milvus
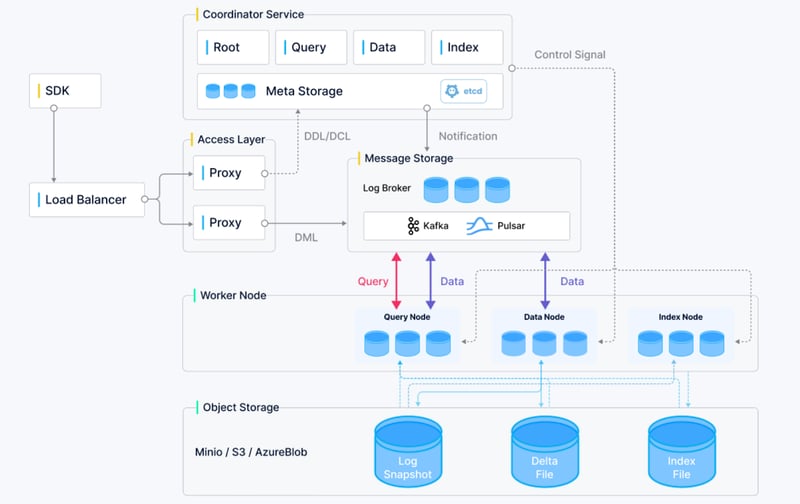
Milvus आर्किटेक्चर का अवलोकन। (चित्र स्रोत)
Milvus एक ओपन-सोर्स वेक्टर डेटाबेस है, जिसने अपनी स्केलेबिलिटी, विश्वसनीयता, और परफॉर्मेंस के कारण तेज़ी से लोकप्रियता हासिल की है। सिमिलैरिटी सर्च और AI-चालित अनुप्रयोगों के लिए डिज़ाइन किया गया, यह डीप न्यूरल नेटवर्क द्वारा जनरेट की गई विशाल एंबेडिंग वेक्टरों को संग्रहीत और क्वेरी करने का समर्थन करता है। Milvus ये विशेषताएँ प्रदान करता है:
- डिस्ट्रीब्यूटेड आर्किटेक्चर के साथ अरबों वेक्टर संभालने में सक्षम।
- लो-लेटेंसी के साथ हाई-स्पीड सिमिलैरिटी सर्च के लिए ऑप्टिमाइज़्ड।
- TensorFlow, PyTorch, और Hugging Face जैसे लोकप्रिय डीप लर्निंग फ़्रेमवर्क का समर्थन।
- Kubernetes, Docker, और क्लाउड परिवेश सहित कई डिप्लॉयमेंट विकल्प।
- बढ़ते ओपन-सोर्स समुदाय और व्यापक डॉक्यूमेंटेशन का समर्थन।
Milvus रिकमेंडेशन सिस्टम, वीडियो विश्लेषण, और पर्सनलाइज़्ड सर्च अनुभवों के लिए आदर्श है।
7. pgvector
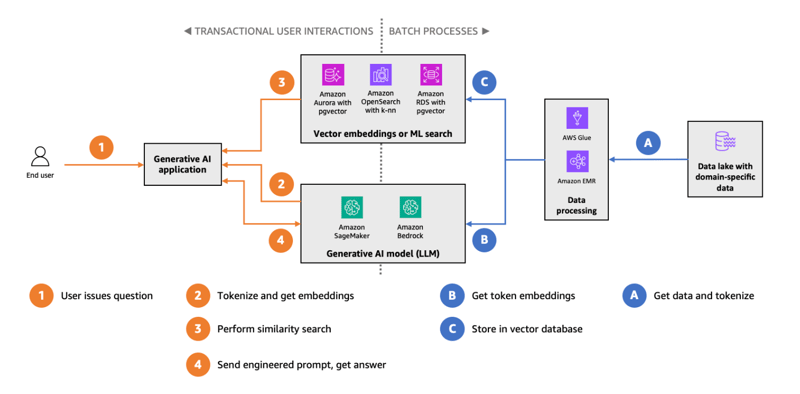
Amazon Aurora आर्किटेक्चर डायग्राम पर pgvector के साथ HNSW इंडेक्सिंग और सर्चिंग। (चित्र स्रोत)
pgvector PostgreSQL के लिए एक एक्सटेंशन है, जो व्यापक रूप से उपयोग किए जाने वाले रिलेशनल डेटाबेस में वेक्टर डेटा टाइप्स और सिमिलैरिटी सर्च क्षमताएँ जोड़ता है। PostgreSQL में सीधे वेक्टर सर्च जोड़कर, pgvector उन टीमों के लिए सहज समाधान प्रदान करता है जो पहले से पारंपरिक डेटाबेस का उपयोग कर रही हैं, पर वेक्टर सर्च क्षमताएँ जोड़ना चाहती हैं। pgvector की प्रमुख विशेषताएँ:
- परिचित डेटाबेस सिस्टम में वेक्टर-आधारित कार्यक्षमता जोड़ता है, अलग वेक्टर डेटाबेस की ज़रूरत समाप्त करता है।
- उन टूल्स और इकोसिस्टम के साथ संगत जो पहले से PostgreSQL पर निर्भर हैं।
- उच्च-आयामी वेक्टरों की कुशल क्वेरी के लिए Approximate Nearest Neighbor (ANN) सर्च का समर्थन।
- SQL से परिचित उपयोगकर्ताओं के लिए अपनाना आसान, जिससे डेवलपर्स और डेटा इंजीनियरों दोनों के लिए सुलभ।
pgvector विशेष रूप से छोटे पैमाने के वेक्टर सर्च उपयोग मामलों के लिए उपयुक्त है, या ऐसे परिवेशों के लिए जहाँ रिलेशनल और वेक्टर-आधारित दोनों वर्कलोड के लिए एक ही डेटाबेस सिस्टम वांछित हो। शुरुआत करने के लिए, हमारा pgvector पर विस्तृत ट्यूटोरियल देखें।
शीर्ष वेक्टर डेटाबेस तुलना
नीचे पहले चर्चा किए गए शीर्ष वेक्टर डेटाबेस की विशेषताओं को उजागर करती एक तुलना तालिका दी गई है:
| Feature | Chroma | Pinecone | Weaviate | Faiss | Qdrant | Milvus | PGVector |
|---|---|---|---|---|---|---|---|
| Open-source | ✅ | ❎ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Primary Use Case | LLM Apps Development | Managed Vector Database for ML | Scalable Vector Storage and Search | High-Speed Similarity Search and Clustering | Vector Similarity Search | High-Performance AI Search | Adding Vector Search to PostgreSQL |
| Integration | LangChain, LlamaIndex | LangChain | OpenAI, Cohere, HuggingFace | Python/NumPy, GPU Execution | OpenAPI v3, Various Language Clients | TensorFlow, PyTorch, HuggingFace | Built into PostgreSQL ecosystem |
| Scalability | Scales from Python notebooks to clusters | Highly scalable | Seamless scaling to billions of objects | Capable of handling sets larger than RAM | Cloud-native with horizontal scaling | Scales to billions of vectors | Depends on PostgreSQL setup |
| Search Speed | Fast similarity searches | Low-latency search | Milliseconds for millions of objects | Fast, supports GPU | Custom HNSW algorithm for rapid search | Optimized for low-latency search | Approximate Nearest Neighbor (ANN) |
| Data Privacy | Supports multi-user with data isolation | Fully managed service | Emphasizes security and replication | Primarily for research and development | Advanced filtering on vector payloads | Secure multi-tenant architecture | Inherits PostgreSQL’s security |
| Programming Language | Python, JavaScript | Python | Python, Java, Go, others | C++, Python | Rust | C++, Python, Go | PostgreSQL extension (SQL-based) |
AI का उभार और वेक्टर डेटाबेस का प्रभाव
वेक्टर डेटाबेस उच्च-आयामी वेक्टरों को संग्रहीत करने में विशेषज्ञ होते हैं, जिससे तेज़ और सटीक सिमिलैरिटी सर्च संभव हो पाती है। जैसे-जैसे AI मॉडल—विशेषकर प्राकृतिक भाषा संसाधन और कंप्यूटर विज़न के क्षेत्र के—इन वेक्टरों को जनरेट और उपयोग करते हैं, कुशल स्टोरेज और रिट्रीवल सिस्टम की आवश्यकता सर्वोपरि हो गई है। यहीं वेक्टर डेटाबेस अत्यधिक अनुकूलित वातावरण प्रदान करते हैं।
इस संबंध का एक प्रमुख उदाहरण है Retrieval-Augmented Generation (RAG) का उदय, जहाँ बड़े भाषा मॉडल (GPT जैसे LLMs) उत्तर जनरेट करने से पहले प्रासंगिक संदर्भ प्राप्त करने के लिए वेक्टर डेटाबेस का उपयोग करते हैं। 2026 में RAG AI अनुप्रयोगों के लिए मानक इन्फ्रास्ट्रक्चर बन चुका है।
ये मॉडल विशाल डेटा को प्रोसेस कर उसे उच्च-आयामी वेक्टरों में बदलते हुए मानव-सदृश टेक्स्ट समझने और जनरेट करने के लिए डिज़ाइन किए गए हैं। LLMs पर निर्मित अनुप्रयोग इन वेक्टरों के कुशल प्रबंधन और क्वेरी के लिए वेक्टर डेटाबेस पर काफी निर्भर करते हैं। जैसे-जैसे मॉडल अधिक सक्षम होते जा रहे हैं और एजेंटिक AI वर्कफ़्लो मुख्यधारा में आ रहे हैं, वेक्टराइज़्ड डेटा की मात्रा में भारी वृद्धि हो रही है, जिससे प्रोडक्शन AI सिस्टम के लिए विशिष्ट वेक्टर डेटाबेस आवश्यक हो गए हैं।
उचित वेक्टर डेटाबेस कैसे चुनें
सही वेक्टर डेटाबेस का चयन आपकी विशिष्ट आवश्यकताओं पर निर्भर करता है। आम उपयोग मामलों के आधार पर ये सिफारिशें हैं:
| Use Case | Recommendation |
|---|---|
| तेज़ प्रोटोटाइपिंग | Chroma (हल्का, न्यूनतम सेटअप, मुफ्त और ओपन-सोर्स) |
| बड़े पैमाने पर प्रोडक्शन | Pinecone (managed, serverless) या Milvus (self-hosted, अरबों वेक्टर) |
| मौजूदा PostgreSQL स्टैक | pgvector (नई इन्फ्रास्ट्रक्चर की आवश्यकता नहीं) |
| हाइब्रिड सर्च की ज़रूरत | Weaviate (वेक्टर + BM25 कीवर्ड सर्च) या Qdrant (उन्नत फ़िल्टरिंग) |
| रिसर्च और बेंचमार्किंग | Faiss (GPU सपोर्ट वाला ऑप्टिमाइज़्ड C++ लाइब्रेरी) |
| RAG पाइपलाइंस | Pinecone, Weaviate, या Qdrant (LangChain और LlamaIndex के साथ मज़बूत इंटीग्रेशन) |
निष्कर्ष
कृत्रिम बुद्धिमत्ता और मशीन लर्निंग का लगातार विकसित होता परिदृश्य आज की डेटा-केंद्रित दुनिया में वेक्टर डेटाबेस की अनिवार्यता पर बल देता है। बहु-आयामी डेटा वेक्टरों को संग्रहीत, खोजने, और विश्लेषित करने की अपनी विशिष्ट क्षमता के साथ, ये डेटाबेस रिकमेंडेशन सिस्टम से लेकर जीनोमिक विश्लेषण तक AI-चालित अनुप्रयोगों को शक्ति प्रदान करने में महत्वपूर्ण सिद्ध हो रहे हैं।
हाल ही में हमने Chroma, Pinecone, Weaviate, Faiss, Qdrant, Milvus, और pgvector जैसे प्रभावशाली वेक्टर डेटाबेस देखे हैं, जिनमें से प्रत्येक अलग-अलग क्षमताएँ और नवाचार प्रदान करता है। जैसे-जैसे AI आगे बढ़ता जाएगा, डेटा रिट्रीवल, प्रोसेसिंग, और विश्लेषण के भविष्य को आकार देने में वेक्टर डेटाबेस की भूमिका निश्चित रूप से बढ़ेगी, जो विभिन्न क्षेत्रों में अधिक परिष्कृत, कुशल, और व्यक्तिगत समाधान लाने का वादा करती है।
वेक्टर डेटाबेस में महारत हासिल करें हमारे Pinecone ट्यूटोरियल के साथ, Vector Databases for Embeddings with Pinecone कोर्स करें, या Introduction to Embeddings with the OpenAI API कोर्स एक्सप्लोर करें, ताकि वेक्टर सर्च और AI अनुप्रयोगों की समझ गहरी हो सके।
FAQs
वेक्टर डेटाबेस MySQL या PostgreSQL जैसे पारंपरिक रिलेशनल डेटाबेस से कैसे अलग हैं?
वेक्टर डेटाबेस उच्च-आयामी डेटा, जैसे AI मॉडलों द्वारा उत्पन्न एंबेडिंग्स, को संभालने के लिए डिज़ाइन किए गए हैं। रिलेशनल डेटाबेस संरचित टेबल्स और सटीक मिलान पर निर्भर होते हैं, जबकि वेक्टर डेटाबेस सिमिलैरिटी सर्च पर फोकस करते हैं, जिससे वे सिमेंटिक या संदर्भगत रूप से संबंधित डेटा पॉइंट्स पुनर्प्राप्त कर सकें।
क्या वेक्टर डेटाबेस पारंपरिक डेटाबेस की जगह ले सकते हैं?
नहीं, वेक्टर डेटाबेस पारंपरिक डेटाबेस का स्थान नहीं लेते, बल्कि उन्हें पूरक करते हैं। जहाँ पारंपरिक डेटाबेस संरचित डेटा प्रबंधन और लेनदेन संचालन में उत्कृष्ट हैं, वहीं वेक्टर डेटाबेस असंरचित, उच्च-आयामी डेटा—जैसे टेक्स्ट एंबेडिंग्स, छवियाँ, या ऑडियो—को संभालने और खोजने के लिए विशेष उपकरण हैं।
Approximate Nearest Neighbor (ANN) एल्गोरिद्म क्या हैं, और वे वेक्टर डेटाबेस में क्यों आवश्यक हैं?
ANN एल्गोरिद्म उच्च-आयामी स्पेस में दिए गए क्वेरी वेक्टर के सबसे नज़दीकी वेक्टरों को तेज़ी से खोजने के विशेष तरीके हैं। वे गति और सटीकता के बीच संतुलन बनाते हैं, जिससे वे उन बड़े डेटासेट्स के लिए आदर्श हो जाते हैं जहाँ सटीक निकटतम पड़ोसी खोज कम्प्यूटेशनल रूप से महँगी होती।
क्या वेक्टर डेटाबेस छोटे पैमाने की परियोजनाओं के लिए उपयुक्त हैं या केवल बड़े एंटरप्राइज़ के लिए?
वेक्टर डेटाबेस बहुमुखी हैं और छोटे तथा बड़े दोनों प्रकार की परियोजनाओं में उपयोग किए जा सकते हैं। छोटे पैमाने की परियोजनाओं के लिए Chroma, Faiss, और Weaviate जैसे ओपन-सोर्स समाधान मज़बूत क्षमताएँ प्रदान करते हैं। एंटरप्राइज़-स्तरीय परियोजनाओं के लिए Pinecone जैसे managed प्लेटफ़ॉर्म स्केलेबिलिटी और परफॉर्मेंस ऑप्टिमाइज़ेशन प्रदान करते हैं।
डेटा आकार बढ़ने के साथ वेक्टर डेटाबेस का प्रदर्शन कैसे स्केल करता है?
परफॉर्मेंस स्केलेबिलिटी अंतर्निहित आर्किटेक्चर और इंडेक्सिंग तकनीकों, जैसे HNSW या IVF, पर निर्भर करती है। अधिकांश आधुनिक वेक्टर डेटाबेस, जिनमें Milvus और Qdrant शामिल हैं, डिस्ट्रीब्यूटेड आर्किटेक्चर के लिए ऑप्टिमाइज़्ड हैं, जिससे वे अरबों वेक्टर तक सहजता से स्केल हो सकें।
क्या मैं मशीन लर्निंग का गहरा ज्ञान बिना वेक्टर डेटाबेस का उपयोग कर सकता/सकती हूँ?
हाँ, Pinecone और Chroma जैसे कई वेक्टर डेटाबेस उपयोगकर्ता-अनुकूल APIs, SDKs, और लोकप्रिय फ़्रेमवर्क्स (जैसे LangChain, Hugging Face) के साथ इंटीग्रेशन प्रदान करते हैं, जिससे गैर-विशेषज्ञ भी न्यूनतम सीखने-घुमाव के साथ उनकी क्षमताओं का लाभ उठा सकें।
वेक्टर डेटाबेस के लिए स्टोरेज आवश्यकताएँ क्या हैं?
वेक्टर डेटाबेस एंबेडिंग्स संग्रहीत करते हैं, जो विशेषकर उच्च-आयामी डेटा के साथ मेमोरी-इंटेंसिव हो सकते हैं। स्टोरेज आवश्यकताएँ वेक्टर आकार, डेटासेट वॉल्यूम, और इंडेक्सिंग संरचना जैसे कारकों पर निर्भर करती हैं। Faiss और Milvus जैसे समाधान बड़े डेटासेट्स को कुशलतापूर्वक संभालने के लिए ऑप्टिमाइज़ेशन प्रदान करते हैं, यहाँ तक कि उपलब्ध RAM से अधिक होने पर भी।
क्या वेक्टर डेटाबेस क्लाउड-नेटिव एप्लिकेशनों के साथ संगत हैं?
हाँ, Milvus और Qdrant जैसे कई आधुनिक वेक्टर डेटाबेस क्लाउड-नेटिव आर्किटेक्चर के साथ डिज़ाइन किए गए हैं और Kubernetes, Docker, तथा AWS और GCP जैसी क्लाउड प्लेटफ़ॉर्म्स के साथ सहज इंटीग्रेशन प्रदान करते हैं।

कृत्रिम बुद्धिमत्ता (AI) की दुनिया में विशाल डेटा का कुशल प्रबंधन और प्रोसेसिंग आवश्यक है। जैसे-जैसे हम AI के उन्नत अनुप्रयोगों—जैसे इमेज रिकग्निशन, वॉइस सर्च, या रिकमेंडेशन इंजन—की तरफ बढ़ते हैं, डेटा का स्वरूप और जटिल होता जाता है। यहीं वेक्टर डेटाबेस काम आते हैं। पारंपरिक डेटाबेस, जो स्केलर मान संग्रहीत करते हैं, के विपरीत, वेक्टर डेटाबेस बहु-आयामी डेटा पॉइंट्स (वेक्टर) को संभालने के लिए विशेष रूप से डिज़ाइन किए गए हैं। ये वेक्टर, जो अनेक आयामों में डेटा का प्रतिनिधित्व करते हैं, अंतरिक्ष में किसी विशिष्ट दिशा और परिमाण की ओर संकेत करने वाले तीरों की तरह समझे जा सकते हैं।
डिजिटल युग हमें AI और मशीन लर्निंग से संचालित समय में ले जा रहा है, ऐसे में वेक्टर डेटाबेस उच्च-आयामी डेटा वेक्टरों को संग्रहीत करने, खोजने, और विश्लेषण करने के लिए अपरिहार्य उपकरण बन गए हैं। इस ब्लॉग का उद्देश्य वेक्टर डेटाबेस का समग्र परिचय देना, AI में उनकी बढ़ती महत्ता समझाना, और 2026 में उपलब्ध सर्वश्रेष्ठ वेक्टर डेटाबेस पर गहराई से चर्चा करना है।