传统的统计建模规律认为:模型越复杂,训练误差会下降,但由于过拟合,测试误差会升高。保持简单则可能欠拟合。这就是我们被教授数十年的经典偏差-方差权衡。
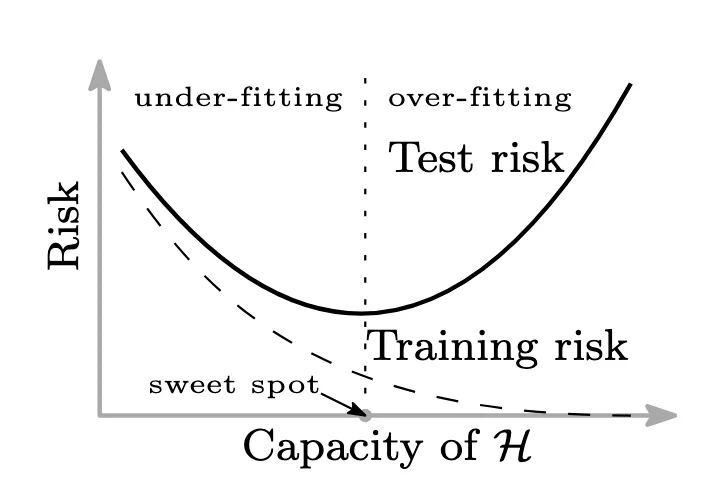
经典的偏差-方差权衡。来源:改编自 Belkin 等,2019 的图 1(a)
但现代机器学习,尤其是深度学习,对这一优雅理念提出了挑战。如果您近几年从事过深度学习,可能注意到一个奇怪的现象:拥有数百万参数的模型依然能出人意料地很好泛化。
按传统观念,这不该发生。真是这样吗?
这就引出了双降:一种奇特却引人入胜的现象——在测试误差突然上升之后,随着模型复杂度继续提高,再次带来性能提升。
这并非古怪的学术噱头,它的确帮助我理解了在真实机器学习项目中观察到的一些反直觉趋势。多年来,我在大型系统中主导过预测、流失预警和 NLP 项目,亲眼见证了这一现象如何挑战传统认知,并重塑我们处理模型复杂度的方式。
本文将介绍什么是双降、它的阶段、何时及为何发生,最重要的是,我们该如何应对。
双降简史
双降或许看起来是个新概念,但很多人不知道,它其实很早就被提出,只是被深度学习重新带入聚光灯下。
早期观察:非单调误差之谜
“在过拟合之后,进一步增加模型复杂度反而提升泛化”并非全新观点。事实上,经典统计学在数十年前就暗示过这种奇特行为。比如,在线性回归中拟合高次多项式时,常能看到先过拟合、继而泛化变好的模式。但人们往往把这些现象归因于过拟合或数值不稳定的“假象”,而非真实行为。
现代再发现:深度学习迫使我们反思
转折点来自深度神经网络的成功——模型参数动辄上百万甚至上十亿,远多于训练样本量。
按经典观念,复杂模型应当严重过拟合训练数据。然而出人意料的是,事实并非如此。实际上,这些模型往往比小模型泛化更好。
这一意外发现促使 Belkin 等(2019)等研究者回溯旧理论。他们的发现颇为迷人:当模型复杂到可以完美拟合训练数据后,随着模型继续变大,测试误差竟然又开始下降。深度学习不仅“揭示”了这一被称为“双降”的现象,更将其上升为我们理解当代泛化的基础概念。
什么是双降?定义、直觉与风险曲线
双降指的是这样一种观察:相对于模型复杂度,测试误差曲线并不总是 U 形。在初始下降(偏差降低)后,测试误差会上升(过拟合),但随后却又意外地再次下降,从而形成“双降”形状。
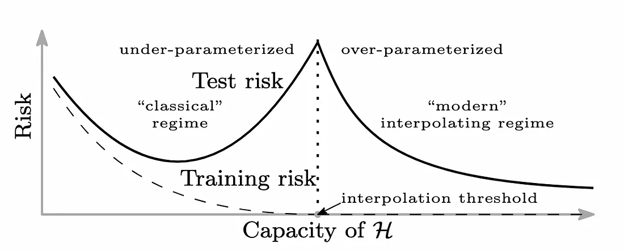
双降风险曲线。来源:改编自 Belkin 等,2019 的图 1(b)
在我的实践中,尤其是在部署基于深度学习的文本分类系统和为供应链企业做时间序列预测时,我观察到了测试误差的第二次下探。这并非理论假说,而是清晰可见于我们的验证曲线中。
这有助于解释为何像 ResNet 这样的大家伙,以及总体上严重过参数化的架构,仍能很好泛化。尽管 GPT 等模型的缩放规律显示的是更平滑的改进,而非肉眼可见的双降曲线,但其背后原则——“更大不一定更差”——依旧成立。
双降的基本原理与阶段
双降主要包含以下三个阶段。
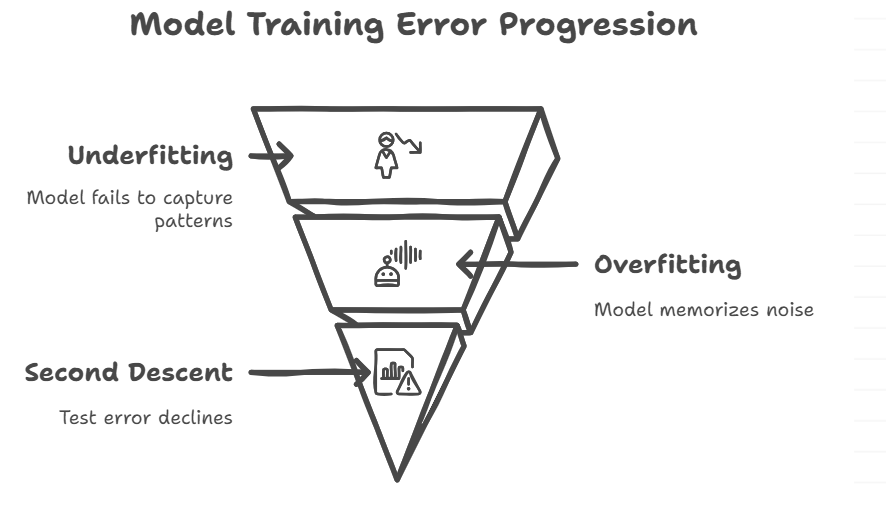
双降的阶段。图片来源:Napkin AI
欠拟合阶段
- 特征:模型过于弱小,无法捕捉模式(例如用线性回归处理图像数据)。
- 行为:增加参数能降低偏差,但只到某个程度为止。
我的经验:从简单起步,但不必惧怕复杂性。
过拟合阶段(危险区)
- 特征:模型记住噪声,导致测试误差出现尖锐飙升。
- 转折:大多数人会在此停止训练——但这不是终点。
实用建议:若验证损失在中途飙升,请暂缓——但别直接终止。
第二次下降阶段
- 特征:尽管训练拟合完美,测试误差却在下降。
- 机制:过参数化让优化(如 SGD)更易找到“更简单”的解。
关键洞见:大模型并非天生混乱——它们存在隐式正则化。
一个主流解释是,像 SGD 这样的优化器天然偏好更平坦的极小值(曲率更低),而这类解往往泛化更好。即便在极度过参数化模型中,随着优化地形的改变,这些更平坦的区域也更容易被找到。
双降在不同维度上的体现
双降最迷人的一面在于,它不仅出现在扩大模型规模时,还会体现在训练轮次(epoch)与训练数据规模上——在我进行不同训练时长和数据切分实验时也屡见不鲜。
按模型规模的双降
这是研究最充分的一类。随着加入更多参数,我们会从欠拟合走向插值,再到过参数化。双降认为,超过插值阈值继续加参数,反而可能有益。这一反直觉观点已在深度神经网络和多项式回归中被观察到。
按模型规模的双降提醒我们:只要训练得当,无需惧怕大模型。它也提示,过早“瘦身”模型,可能会无端牺牲性能。
按训练轮次的双降
另一类双降发生在训练时间更长时。起初,更多训练带来更好性能;随后测试误差上升(过拟合);但继续训练后,它可能再次下降。这在采用学习率衰减或权重平均等方法时尤为常见,因为这些方法有助于在训练后期找到更平坦的极小值。
因此,在某些情形下,过了过拟合点继续训练,可能提升泛化。然而这高度依赖情境,应由严谨的验证加以指导——在许多实际案例中,盲目延长训练会加剧过拟合。
按样本规模的双降
更让人意外的是,双降也会随训练数据量而出现。起初,增加数据会提升效果。但在某些时候,尤其当数据噪声较大时,模型可能“吃力”,导致测试误差上升。最终,随着更多有用数据加入,泛化又会改善。这类双降表明:更多数据并非立刻更好,但通常最终会带来收益。
理论机制与数学基础
要理解双降为何发生,我们需要深入优化动力学、几何与学习理论等概念。
谱分析
我们可以用奇异值分解(SVD)考察损失面的曲率。靠近插值阈值时,模型对那些奇异值很小(信噪比较低)的输入方向非常敏感。这会引发测试误差的飙升——这些基本上是“薄弱方向”,噪声在此对过拟合的影响尤为显著。
隐式正则化
广为接受的一种观点是,随机梯度下降(SGD)会隐式地令解更稳定。SGD 在众多权重配置中倾向选择范数更低或曲率更小、能最小化损失的配置。这些是在高维空间里更“简单”的解。此类平坦极小值对扰动更不敏感,通常与更好的泛化相关,尤其体现在第二次下降中。
噪声的作用
噪声很棘手。在插值阈值处,哪怕少量标签噪声也可能被模型拟合,从而导致泛化“大跳水”。但如果优化器工作得当、参数量充足,模型就有能力将信号与噪声分离。这进一步印证:只要优化得当,过参数化未必是问题。
替代理论
“彩票假说”认为,大网络中存在可训练且表现良好的小型子网络;更大的模型更容易找到它们。“锋利 vs. 平坦极小值”理论则认为,损失面的形状对泛化的影响大于模型规模本身。
这些视角共同丰富了我们对双降缘起的理解。
经验证据与示例
基准实验
Belkin 等(2019)率先通过实验展示了双降。他们在多项式回归和神经网络上进行了尝试,发现测试误差不只是上升后趋于平坦;它还会再次下降。这些基准验证了深度学习社区长期以来的零星观察。
深度学习案例研究
当ResNet在 CIFAR-10 和 ImageNet 上加深层数时,会出现双降表现。即便数据固定,Transformer(如 GPT-2/3/4)也会随着模型规模变大而提升泛化能力。扩大滤波器、层或单元数量时,CNN在视觉数据集上往往也遵循双降曲线。
对模型开发的实践启示
了解双降不只是学术练习,它能帮助组织在真实 ML 项目中做出更优决策。
模型扩展
该概念告诉我们,更大不一定更差。事实上,将模型容量提升到过拟合点之后,若优化与正则化得当,反而可能更好泛化。当然,我们仍应权衡性能提升与算力成本及环境影响。
训练方案
例如,在插值阈值之后使用 dropout,可在第二次下降阶段稳定学习。还可以尝试更长的训练计划、循环学习率,甚至将正则化延后到插值峰值之后,以提升第二次下降时的稳定性。
数据管理
双降也有助于规划数据采集。当您撞上难看的插值峰(训练准确率完美却测试误差飙升)时,本能反应是往模型里倒入更多原始数据。别这么做。因为按样本规模的双降意味着,更多数据最初可能会放大对噪声的敏感性,暂时无益。
不如考虑使用主动学习、数据增广与分层抽样等方法,而非一味加数据。这些办法能更顺利地跨越插值峰。您可以借助DataCamp 数据质量维度速查表来监测数据影响。
缓解与诊断
为降低插值阈值附近的过拟合,可考虑 dropout、批归一化与权重衰减等工具。它们有助于判断您是否处于危险区,或已接近第二次下降的甜蜜点。我个人在多项建模项目中都曾使用这些技术,尤其是在处理不平衡或含噪数据集时。
未解之问与未来研究方向
尽管相关研究不断增多,双降提出的问题仍多于其解答。即使研究在推进,依旧存在一些亟待回答的问题,以及这一令人兴奋领域的潜在走向。
理论空白
能否以数学或统计方式准确预测双降何时出现?数据集特征、架构类型或优化器选择的哪些方面决定了测试误差曲线的形状?这些都是未来研究可大有可为之处。
架构与优化
我们能否设计神经网络或训练日程,以更好地利用第二次下降?是否应将过参数化视为一种战略性的设计层?这与神经切线核、预训练动力学及架构搜索等方向一脉相承。
理念转变
双降促使我们重思学习的基础。它暗示复杂度与泛化不总是此消彼长,过拟合也未必是最糟糕的事。这对许多经典实践者而言是观念上的巨大转变,也表明我们的学习理论仍在演进。
结语
双降不只是机器学习中的新花样;它为我们理解泛化提供了新方式。与其回避或放弃复杂模型,我们或许应当有策略地加以利用。这意味着信任优化、了解数据,并愿意尝试非常规做法。
下次当您的模型开始过拟合时,不必立刻惊慌。也许您正要遇见第二次下降。
现在您已了解双降,不妨查阅下方资源与链接,继续拓展学习。


传统的统计建模规律认为:模型越复杂,训练误差会下降,但由于过拟合,测试误差会升高。保持简单则可能欠拟合。这就是我们被教授数十年的经典偏差-方差权衡。
经典的偏差-方差权衡。来源:改编自 Belkin 等,2019 的图 1(a)
但现代机器学习,尤其是深度学习,对这一优雅理念提出了挑战。如果您近几年从事过深度学习,可能注意到一个奇怪的现象:拥有数百万参数的模型依然能出人意料地很好泛化。
按传统观念,这不该发生。真是这样吗?
这就引出了双降:一种奇特却引人入胜的现象——在测试误差突然上升之后,随着模型复杂度继续提高,再次带来性能提升。
这并非古怪的学术噱头,它的确帮助我理解了在真实机器学习项目中观察到的一些反直觉趋势。多年来,我在大型系统中主导过预测、流失预警和 NLP 项目,亲眼见证了这一现象如何挑战传统认知,并重塑我们处理模型复杂度的方式。
本文将介绍什么是双降、它的阶段、何时及为何发生,最重要的是,我们该如何应对。
双降简史
双降或许看起来是个新概念,但很多人不知道,它其实很早就被提出,只是被深度学习重新带入聚光灯下。
早期观察:非单调误差之谜
“在过拟合之后,进一步增加模型复杂度反而提升泛化”并非全新观点。事实上,经典统计学在数十年前就暗示过这种奇特行为。比如,在线性回归中拟合高次多项式时,常能看到先过拟合、继而泛化变好的模式。但人们往往把这些现象归因于过拟合或数值不稳定的“假象”,而非真实行为。
现代再发现:深度学习迫使我们反思
转折点来自深度神经网络的成功——模型参数动辄上百万甚至上十亿,远多于训练样本量。
按经典观念,复杂模型应当严重过拟合训练数据。然而出人意料的是,事实并非如此。实际上,这些模型往往比小模型泛化更好。
这一意外发现促使 Belkin 等(2019)等研究者回溯旧理论。他们的发现颇为迷人:当模型复杂到可以完美拟合训练数据后,随着模型继续变大,测试误差竟然又开始下降。深度学习不仅“揭示”了这一被称为“双降”的现象,更将其上升为我们理解当代泛化的基础概念。
什么是双降?定义、直觉与风险曲线
双降指的是这样一种观察:相对于模型复杂度,测试误差曲线并不总是 U 形。在初始下降(偏差降低)后,测试误差会上升(过拟合),但随后却又意外地再次下降,从而形成“双降”形状。
双降风险曲线。来源:改编自 Belkin 等,2019 的图 1(b)
在我的实践中,尤其是在部署基于深度学习的文本分类系统和为供应链企业做时间序列预测时,我观察到了测试误差的第二次下探。这并非理论假说,而是清晰可见于我们的验证曲线中。
这有助于解释为何像 ResNet 这样的大家伙,以及总体上严重过参数化的架构,仍能很好泛化。尽管 GPT 等模型的缩放规律显示的是更平滑的改进,而非肉眼可见的双降曲线,但其背后原则——“更大不一定更差”——依旧成立。
双降的基本原理与阶段
双降主要包含以下三个阶段。
双降的阶段。图片来源:Napkin AI
欠拟合阶段
我的经验:从简单起步,但不必惧怕复杂性。
过拟合阶段(危险区)
实用建议:若验证损失在中途飙升,请暂缓——但别直接终止。
第二次下降阶段
关键洞见:大模型并非天生混乱——它们存在隐式正则化。
一个主流解释是,像 SGD 这样的优化器天然偏好更平坦的极小值(曲率更低),而这类解往往泛化更好。即便在极度过参数化模型中,随着优化地形的改变,这些更平坦的区域也更容易被找到。
双降在不同维度上的体现
双降最迷人的一面在于,它不仅出现在扩大模型规模时,还会体现在训练轮次(epoch)与训练数据规模上——在我进行不同训练时长和数据切分实验时也屡见不鲜。
按模型规模的双降
这是研究最充分的一类。随着加入更多参数,我们会从欠拟合走向插值,再到过参数化。双降认为,超过插值阈值继续加参数,反而可能有益。这一反直觉观点已在深度神经网络和多项式回归中被观察到。
按模型规模的双降提醒我们:只要训练得当,无需惧怕大模型。它也提示,过早“瘦身”模型,可能会无端牺牲性能。
按训练轮次的双降
另一类双降发生在训练时间更长时。起初,更多训练带来更好性能;随后测试误差上升(过拟合);但继续训练后,它可能再次下降。这在采用学习率衰减或权重平均等方法时尤为常见,因为这些方法有助于在训练后期找到更平坦的极小值。
因此,在某些情形下,过了过拟合点继续训练,可能提升泛化。然而这高度依赖情境,应由严谨的验证加以指导——在许多实际案例中,盲目延长训练会加剧过拟合。
按样本规模的双降
更让人意外的是,双降也会随训练数据量而出现。起初,增加数据会提升效果。但在某些时候,尤其当数据噪声较大时,模型可能“吃力”,导致测试误差上升。最终,随着更多有用数据加入,泛化又会改善。这类双降表明:更多数据并非立刻更好,但通常最终会带来收益。
理论机制与数学基础
要理解双降为何发生,我们需要深入优化动力学、几何与学习理论等概念。
谱分析
我们可以用奇异值分解(SVD)考察损失面的曲率。靠近插值阈值时,模型对那些奇异值很小(信噪比较低)的输入方向非常敏感。这会引发测试误差的飙升——这些基本上是“薄弱方向”,噪声在此对过拟合的影响尤为显著。
隐式正则化
广为接受的一种观点是,随机梯度下降(SGD)会隐式地令解更稳定。SGD 在众多权重配置中倾向选择范数更低或曲率更小、能最小化损失的配置。这些是在高维空间里更“简单”的解。此类平坦极小值对扰动更不敏感,通常与更好的泛化相关,尤其体现在第二次下降中。
噪声的作用
噪声很棘手。在插值阈值处,哪怕少量标签噪声也可能被模型拟合,从而导致泛化“大跳水”。但如果优化器工作得当、参数量充足,模型就有能力将信号与噪声分离。这进一步印证:只要优化得当,过参数化未必是问题。
替代理论
“彩票假说”认为,大网络中存在可训练且表现良好的小型子网络;更大的模型更容易找到它们。“锋利 vs. 平坦极小值”理论则认为,损失面的形状对泛化的影响大于模型规模本身。
这些视角共同丰富了我们对双降缘起的理解。
经验证据与示例
基准实验
Belkin 等(2019)率先通过实验展示了双降。他们在多项式回归和神经网络上进行了尝试,发现测试误差不只是上升后趋于平坦;它还会再次下降。这些基准验证了深度学习社区长期以来的零星观察。
深度学习案例研究
当ResNet在 CIFAR-10 和 ImageNet 上加深层数时,会出现双降表现。即便数据固定,Transformer(如 GPT-2/3/4)也会随着模型规模变大而提升泛化能力。扩大滤波器、层或单元数量时,CNN在视觉数据集上往往也遵循双降曲线。
对模型开发的实践启示
了解双降不只是学术练习,它能帮助组织在真实 ML 项目中做出更优决策。
模型扩展
该概念告诉我们,更大不一定更差。事实上,将模型容量提升到过拟合点之后,若优化与正则化得当,反而可能更好泛化。当然,我们仍应权衡性能提升与算力成本及环境影响。
训练方案
例如,在插值阈值之后使用 dropout,可在第二次下降阶段稳定学习。还可以尝试更长的训练计划、循环学习率,甚至将正则化延后到插值峰值之后,以提升第二次下降时的稳定性。
数据管理
双降也有助于规划数据采集。当您撞上难看的插值峰(训练准确率完美却测试误差飙升)时,本能反应是往模型里倒入更多原始数据。别这么做。因为按样本规模的双降意味着,更多数据最初可能会放大对噪声的敏感性,暂时无益。
不如考虑使用主动学习、数据增广与分层抽样等方法,而非一味加数据。这些办法能更顺利地跨越插值峰。您可以借助DataCamp 数据质量维度速查表来监测数据影响。
缓解与诊断
为降低插值阈值附近的过拟合,可考虑 dropout、批归一化与权重衰减等工具。它们有助于判断您是否处于危险区,或已接近第二次下降的甜蜜点。我个人在多项建模项目中都曾使用这些技术,尤其是在处理不平衡或含噪数据集时。
未解之问与未来研究方向
尽管相关研究不断增多,双降提出的问题仍多于其解答。即使研究在推进,依旧存在一些亟待回答的问题,以及这一令人兴奋领域的潜在走向。
理论空白
能否以数学或统计方式准确预测双降何时出现?数据集特征、架构类型或优化器选择的哪些方面决定了测试误差曲线的形状?这些都是未来研究可大有可为之处。
架构与优化
我们能否设计神经网络或训练日程,以更好地利用第二次下降?是否应将过参数化视为一种战略性的设计层?这与神经切线核、预训练动力学及架构搜索等方向一脉相承。
理念转变
双降促使我们重思学习的基础。它暗示复杂度与泛化不总是此消彼长,过拟合也未必是最糟糕的事。这对许多经典实践者而言是观念上的巨大转变,也表明我们的学习理论仍在演进。
结语
双降不只是机器学习中的新花样;它为我们理解泛化提供了新方式。与其回避或放弃复杂模型,我们或许应当有策略地加以利用。这意味着信任优化、了解数据,并愿意尝试非常规做法。
下次当您的模型开始过拟合时,不必立刻惊慌。也许您正要遇见第二次下降。
现在您已了解双降,不妨查阅下方资源与链接,继续拓展学习。