
Program
Dasar-Dasar Pembelajaran Mesin dalam Python
16 jam
Aturan tradisional dalam pemodelan statistik menyatakan bahwa ketika model makin rumit, error pelatihan turun, tetapi error pengujian naik karena overfitting. Jika terlalu sederhana, Anda bisa mengalami underfitting. Itulah trade-off bias-varian klasik yang diajarkan selama bertahun-tahun.
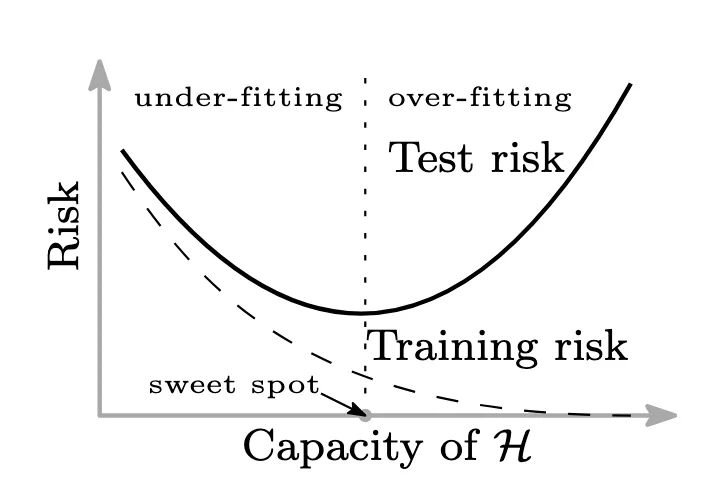
Trade-off bias-varian klasik. Sumber: Diadaptasi dari Gambar 1(a) pada Belkin et al., 2019
Namun machine learning modern, terutama deep learning, menantang gagasan elegan ini. Jika Anda bekerja di deep learning dalam beberapa tahun terakhir, Anda mungkin melihat sesuatu yang aneh: model dengan jutaan parameter tetap saja mampu melakukan generalisasi dengan sangat baik.
Menurut kebijaksanaan konvensional, itu seharusnya tidak terjadi. Atau sebaliknya?
Inilah double descent: fenomena yang aneh namun menarik di mana peningkatan kompleksitas model kembali meningkatkan kinerja setelah lonjakan mendadak pada error pengujian.
Ini bukan sekadar konsep akademis yang unik; fenomena ini benar-benar membantu saya memahami tren kontra-intuitif yang saya lihat dalam proyek machine learning dunia nyata. Sebagai seseorang yang bertahun-tahun memimpin inisiatif peramalan, prediksi churn, dan NLP untuk sistem berskala besar, saya melihat langsung bagaimana fenomena ini menantang kebijaksanaan tradisional dan membentuk ulang cara kita mendekati kompleksitas model.
Dalam artikel ini, kita akan membahas apa itu double descent, tahapannya, kapan dan mengapa itu terjadi, dan yang terpenting, apa yang perlu dilakukan karenanya.
Double descent mungkin terdengar seperti gagasan baru, tetapi banyak orang tidak menyadari bahwa ini adalah konsep lama yang dibawa kembali menjadi sorotan oleh deep learning.
Gagasan bahwa peningkatan kompleksitas model dapat menghasilkan generalisasi yang lebih baik setelah overfitting bukanlah hal baru. Faktanya, statistik klasik sudah menyinggung perilaku aneh ini beberapa dekade lalu. Misalnya, saat memasangkan polinomial berderajat tinggi pada data dalam regresi linear, Anda dapat melihat pola overfitting yang diikuti oleh generalisasi yang lebih baik. Namun orang sering mengatakan bahwa pola-pola tersebut hanyalah artefak overfitting atau ketidakstabilan numerik, bukan perilaku nyata.
Tititk baliknya hadir dengan keberhasilan jaringan saraf dalam, di mana model sering memiliki jutaan bahkan miliaran parameter—jauh lebih banyak daripada jumlah contoh pelatihan.
Kebijaksanaan klasik menyarankan bahwa model yang kompleks akan sangat overfit terhadap data pelatihan. Namun yang mengejutkan, hal itu tidak selalu terjadi. Bahkan, model-model ini sering kali melakukan generalisasi lebih baik daripada model yang lebih kecil.
Temuan tak terduga ini mendorong peneliti seperti Belkin et al. (2019) untuk mengeksplorasi teori-teori lama. Penemuan mereka yang menarik menunjukkan bahwa ketika model menjadi cukup kompleks untuk memuat data pelatihan dengan sempurna, error pengujian justru mulai membaik lagi seiring bertambahnya ukuran model. Deep learning tidak hanya mengungkap fenomena yang dikenal sebagai 'double descent'—tetapi juga mengubahnya menjadi konsep fundamental dalam pemahaman kita tentang generalisasi saat ini.
Double descent merujuk pada pengamatan bahwa kurva error pengujian tidak selalu berbentuk U terhadap kompleksitas model. Setelah penurunan awal (karena bias menurun), error pengujian meningkat (akibat overfitting), namun kemudian, secara tak terduga, mulai menurun lagi. Inilah bentuk “double descent”.
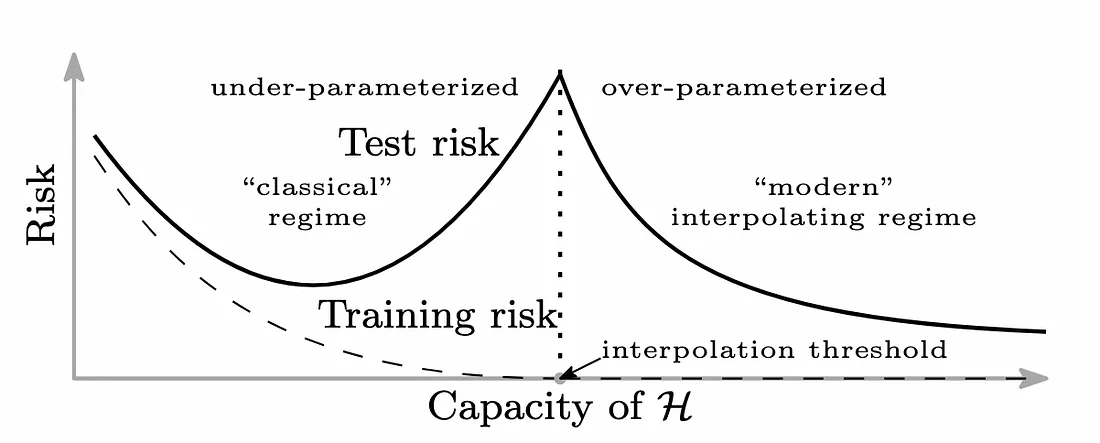
Kurva risiko double descent. Sumber: Diadaptasi dari Gambar 1(b) pada Belkin et al., 2019
Dalam praktik saya, terutama saat menerapkan sistem klasifikasi teks berbasis deep learning dan melakukan peramalan deret waktu untuk perusahaan rantai pasok, saya mengamati penurunan kedua pada error pengujian ini. Itu bukan teoretis; terlihat jelas pada kurva validasi kami.
Hal ini membantu menjelaskan mengapa model besar seperti ResNet, dan secara umum arsitektur yang sangat overparameterisasi, tetap dapat melakukan generalisasi dengan baik. Sementara hukum penskalaan untuk model seperti GPT menunjukkan peningkatan yang lebih mulus ketimbang kurva double descent yang terlihat jelas, prinsip dasarnya—bahwa lebih besar tidak selalu lebih buruk—tetap relevan.
Ada tiga tahap utama double descent yang dibahas di bawah ini.
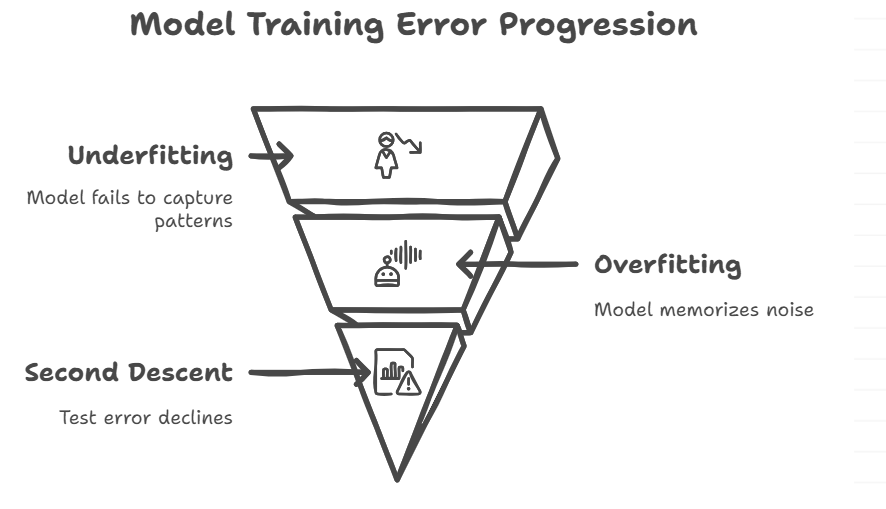
Tahapan Double Descent. Sumber Gambar: Napkin AI
Dari pengalaman saya: Mulailah secara sederhana, tetapi jangan takut pada kompleksitas.
Tips praktis: Jika loss validasi Anda melonjak di tengah pelatihan, jeda—tetapi jangan hentikan.
Wawasan kunci: Model besar tidak selalu kacau—mereka teratur secara implisit.
Salah satu penjelasan utama adalah bahwa optimizer seperti SGD secara inheren lebih menyukai minima yang lebih datar, yakni yang berkekurvaturan lebih rendah, dan cenderung melakukan generalisasi lebih baik. Bahkan pada model yang sangat overparameterisasi, wilayah yang lebih datar ini menjadi lebih mudah ditemukan seiring perubahan lanskap optimisasi.
Salah satu aspek paling menarik dari double descent adalah bahwa ini tidak hanya muncul saat penskalaan ukuran model. Ini juga muncul pada jumlah epoch dan ukuran data pelatihan—sesuatu yang saya amati saat menjalankan eksperimen dengan durasi pelatihan dan pembagian data yang bervariasi.
Ini adalah bentuk yang paling sering dipelajari. Saat kita menambah parameter, kita bergerak dari underfitting ke interpolasi lalu ke overparameterisasi. Menambah parameter melampaui ambang interpolasi justru dapat membantu, menurut double descent. Gagasan yang berlawanan dengan intuisi ini telah terlihat pada jaringan saraf dalam dan regresi polinomial.
Model-wise double descent memungkinkan kita untuk tidak takut pada model besar selama dilatih dengan benar. Ini juga menjadi pengingat bahwa memangkas model terlalu dini bisa berarti mengorbankan kinerja tanpa alasan.
Jenis penurunan lainnya terjadi ketika Anda melatih lebih lama. Pada awalnya, pelatihan lebih banyak meningkatkan kinerja. Kemudian error pengujian naik (overfitting). Namun bisa turun lagi dengan pelatihan berlanjut. Ini sering terjadi ketika Anda menggunakan metode seperti penurunan laju pembelajaran atau perata-rataan bobot, yang memfasilitasi pencarian minima yang lebih datar di tahap akhir pelatihan.
Jadi, dalam beberapa kasus, melanjutkan pelatihan melampaui titik overfitting dapat menghasilkan generalisasi yang lebih baik. Namun, ini sangat bergantung konteks dan harus dibimbing oleh validasi yang cermat—memperpanjang pelatihan secara membabi buta dapat memperburuk overfitting dalam banyak kasus praktis.
Aspek paling mengejutkan adalah double descent juga bisa terjadi pada jumlah data pelatihan. Pada awalnya, menambah data membuat kinerja lebih baik. Namun ada kalanya, terutama ketika banyak noise dalam data, model bisa kesulitan sehingga error pengujian naik. Akhirnya, generalisasi membaik lagi seiring bertambahnya data yang berguna. Jenis double descent ini menunjukkan bahwa lebih banyak data tidak selalu langsung lebih baik, tetapi biasanya berbuah pada akhirnya.
Untuk memahami mengapa double descent terjadi, kita perlu menyelami konsep seperti dinamika optimisasi, geometri, dan teori pembelajaran.
Kita dapat melihat kelengkungan permukaan loss menggunakan singular value decomposition (SVD). Di sekitar ambang interpolasi, model sangat sensitif terhadap arah input dengan nilai singular kecil, yakni arah dengan rasio signal-to-noise rendah. Hal ini memicu lonjakan error pengujian model—pada dasarnya merupakan "arah lemah" di mana noise sangat memengaruhi overfitting.
Salah satu gagasan yang paling diterima luas adalah bahwa stochastic gradient descent (SGD) secara implisit membuat solusi lebih stabil. SGD lebih menyukai konfigurasi bobot dengan norma rendah atau kelengkungan rendah, di antara banyak konfigurasi, untuk meminimalkan loss. Ini adalah solusi yang lebih sederhana dalam ruang berdimensi tinggi. Minima yang datar kurang terpengaruh oleh perubahan dan sering dikaitkan dengan generalisasi yang lebih baik, terutama pada descent kedua.
Noise itu rumit. Pada ambang interpolasi, sedikit saja noise pada label dapat membuat model memuatnya, yang dapat menimbulkan kesenjangan generalisasi yang besar. Namun jika optimizer bekerja dengan baik, dan Anda memiliki jumlah parameter yang signifikan, model akan mampu memisahkan sinyal dari noise. Ini mendukung gagasan bahwa overparameterisasi bukan masalah jika optimisasi dilakukan dengan benar.
Lottery Ticket Hypothesis menyatakan bahwa jaringan besar memiliki sub-jaringan kecil yang dapat dilatih dan bekerja baik; dan model yang lebih besar memudahkan menemukannya. Teori minima tajam vs. datar menyatakan bahwa bentuk permukaan loss berpengaruh lebih besar pada generalisasi daripada ukuran model.
Bersama-sama, perspektif ini menciptakan pemahaman yang lebih kaya tentang mengapa double descent muncul.
Beberapa studi awal yang menunjukkan double descent dilakukan oleh Belkin et al. (2019). Mereka mencoba regresi polinomial dan model jaringan saraf; dan menemukan bahwa error pengujian tidak hanya naik lalu mendatar; ia bisa turun lagi. Benchmark ini memformalkan fenomena yang sebelumnya banyak diamati secara anekdotal di komunitas deep learning.
Saat kedalaman lapisan pada ResNet di CIFAR-10 dan ImageNet meningkat, kinerja double descent muncul. Bahkan dengan data tetap, transformer seperti GPT-2/3/4 menjadi lebih baik dalam generalisasi seiring pertumbuhan ukuran model. Saat filter, lapisan, atau unit dibesarkan, CNN yang dilatih pada dataset visi sering mengikuti kurva double descent.
Mempelajari double descent bukan sekadar latihan akademis; ini dapat membantu organisasi membuat pilihan yang lebih baik dalam proyek ML nyata.
Konsep ini memberi tahu kita bahwa lebih besar tidak selalu lebih buruk. Faktanya, meningkatkan kapasitas model melampaui titik overfitting dapat membantu generalisasi, terutama jika Anda melakukan optimisasi dan regularisasi dengan benar. Meski demikian, kita tetap harus menimbang manfaat kinerja yang lebih baik terhadap biaya komputasi dan dampaknya pada lingkungan.
Misalnya, menggunakan dropout setelah ambang interpolasi dapat menstabilkan pembelajaran pada fase descent kedua. Anda bisa mencoba jadwal pelatihan yang lebih panjang, laju pembelajaran siklik, atau bahkan menunda regularisasi hingga setelah puncak interpolasi. Ini dapat membuat pembelajaran lebih stabil selama fase descent kedua.
Double descent juga membantu dalam merencanakan cara mengumpulkan data. Saat Anda mencapai puncak interpolasi yang buruk itu (di mana error melonjak meski akurasi pelatihan sempurna), reaksi spontan adalah memasukkan lebih banyak data mentah ke model. Jangan. Karena sample-wise double descent berarti lebih banyak data pada awalnya dapat memperbesar sensitivitas terhadap noise sebelum akhirnya membantu.
Sebagai gantinya, pertimbangkan menggunakan metode seperti active learning, augmentasi data, dan sampling berstrata alih-alih sekadar menambah data. Ini dapat membantu model melewati puncak interpolasi dengan lebih mudah. Pantau dampak data dengan Cheat Sheet Dimensi Kualitas Data DataCamp.
Untuk membantu mengurangi overfitting di dekat ambang interpolasi, pertimbangkan alat seperti dropout, batch norm, dan weight decay. Ini dapat membantu Anda mengetahui apakah Anda berada di zona bahaya atau mendekati sweet spot descent kedua. Saya pribadi telah menggunakan teknik-teknik ini di beberapa proyek pemodelan, terutama saat bekerja dengan dataset yang tidak seimbang atau berisik.
Terlepas dari semakin banyaknya karya, double descent memunculkan lebih banyak pertanyaan daripada jawaban. Meski riset tentang double descent terus bertambah, masih ada sejumlah pertanyaan yang perlu dijawab beserta arah perkembangan bidang menarik ini.
Mungkinkah kita dapat memprediksi secara matematis atau statistik kapan tepatnya double descent akan terjadi? Fitur apa dari dataset, jenis arsitektur, atau pilihan optimizer yang akan menentukan bentuk kurva error pengujian? Ini adalah pertanyaan yang bisa lebih banyak digarap riset di masa depan.
Bisakah kita merancang jaringan saraf atau jadwal pelatihan sedemikian rupa sehingga memanfaatkan descent kedua dengan lebih baik? Haruskah kita melihat overparameterisasi sebagai lapisan desain strategis? Ini menjadi titik awal yang baik untuk kernel tangen neural, dinamika pretraining, dan pencarian arsitektur.
Double descent membuat kita meninjau kembali dasar-dasar pembelajaran. Ini menyiratkan bahwa kompleksitas dan generalisasi tidak selalu berlawanan, dan bahwa overfitting mungkin bukan hal terburuk yang bisa terjadi. Itu perubahan besar dalam cara berpikir banyak praktisi klasik, dan menunjukkan bahwa teori kita tentang pembelajaran masih terus berkembang.
Double descent lebih dari sekadar twist baru dalam machine learning; ini adalah cara baru memikirkan generalisasi. Alih-alih menghindari atau meninggalkan model kompleks, kita mungkin perlu menggunakannya secara strategis. Ini berarti mempercayai proses optimisasi, memahami data Anda, dan terbuka untuk mencoba hal-hal baru yang tidak biasa dilakukan.
Jangan cepat panik saat model Anda mulai overfit. Bisa jadi Anda sedang mendekati descent kedua.
Kini setelah Anda memahami double descent, Anda juga dapat meninjau beberapa sumber dan tautan di bawah ini untuk memperdalam pembelajaran ini.
Kursus Terbaik di DataCamp
Program
Program
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



