
Cursus
Principes fondamentaux de l'apprentissage automatique en Python
16 h
La règle traditionnelle en modélisation statistique veut que plus un modèle est complexe, plus l’erreur d’entraînement baisse, mais plus l’erreur de test augmente à cause du surapprentissage. Restez simple, et vous risquez le sous-apprentissage. C’est le compromis biais-variance classique enseigné depuis des décennies.
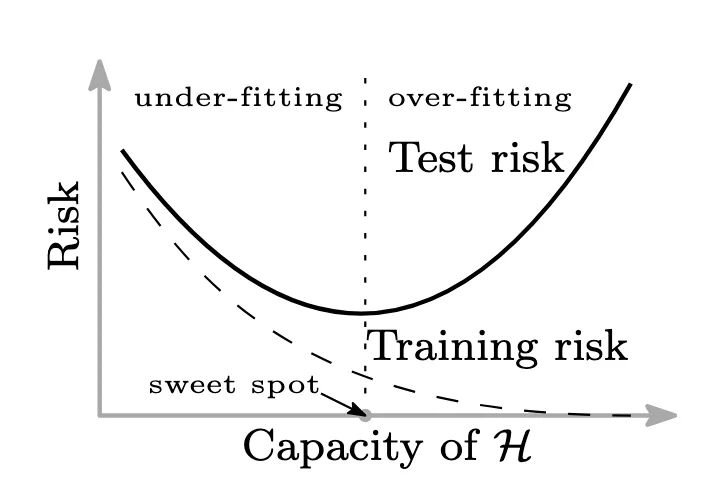
Le compromis biais-variance classique. Source : adapté de la figure 1(a) dans Belkin et al., 2019
Mais l’apprentissage automatique moderne, en particulier l’apprentissage profond, bouscule cette belle idée. Si vous avez travaillé en deep learning ces dernières années, vous avez peut‑être remarqué quelque chose d’étrange : des modèles avec des millions de paramètres généralisent pourtant très bien.
Ce n’est pas censé arriver selon la sagesse conventionnelle. Ou bien si ?
Bienvenue dans le double descent : un phénomène aussi étrange que fascinant où l’augmentation de la complexité du modèle améliore à nouveau les performances après une hausse brutale de l’erreur de test.
Ce n’est pas qu’un concept académique curieux, il m’a réellement aidé à interpréter des tendances contre‑intuitives observées sur des projets concrets de machine learning. Après des années à piloter des initiatives de prévision, de churn et de NLP pour des systèmes à grande échelle, j’ai vu de mes yeux comment ce phénomène remet en question les idées reçues et transforme notre approche de la complexité des modèles.
Dans cet article, nous verrons ce qu’est le double descent, ses phases, quand et pourquoi il survient, et surtout quoi faire en pratique.
Le double descent peut sembler nouveau, mais c’est en réalité une idée ancienne, remise au premier plan par le deep learning.
L’idée qu’une complexification du modèle puisse mener à une meilleure généralisation après du surapprentissage n’est pas totalement nouvelle. La statistique classique laissait déjà entrevoir ce comportement étrange il y a des décennies. Par exemple, en ajustant des polynômes de haut degré en régression linéaire, on observe une phase d’overfitting suivie d’une meilleure généralisation. On a toutefois souvent attribué ces motifs à des artefacts de surapprentissage ou d’instabilité numérique, pas à un comportement réel.
Le point de bascule est venu avec le succès des réseaux neuronaux profonds, dont les modèles comptent souvent des millions, voire des milliards de paramètres, bien davantage que le nombre d’exemples d’entraînement.
Selon la sagesse classique, des modèles complexes devraient massivement surapprendre les données d’entraînement. Or, surprise, ce n’est pas ce qu’on constate. En fait, ces modèles généralisent souvent mieux que des modèles plus petits.
Cette observation inattendue a poussé des chercheurs comme Belkin et al. (2019) à revisiter d’anciennes théories. Leur découverte majeure montre qu’une fois le modèle assez complexe pour parfaitement ajuster les données d’entraînement, l’erreur de test recommence à baisser à mesure que le modèle grossit. Le deep learning n’a pas seulement mis en lumière ce phénomène, appelé « double descent » : il en a fait un concept clé pour comprendre la généralisation aujourd’hui.
Le double descent décrit l’observation selon laquelle la courbe d’erreur de test n’est pas toujours en U en fonction de la complexité du modèle. Après une première descente (diminution du biais), l’erreur de test augmente (surapprentissage), puis, de façon inattendue, elle redescend. D’où la forme en « double descente ».
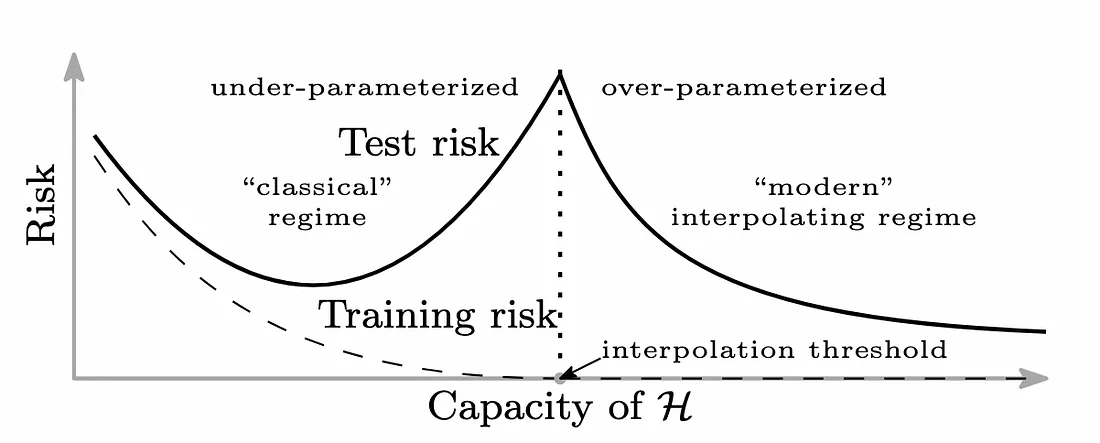
La courbe de risque en double descent. Source : adapté de la figure 1(b) dans Belkin et al., 2019
Dans ma pratique, notamment lors du déploiement de systèmes de classification de texte par deep learning et de prévisions de séries temporelles pour des chaînes d’approvisionnement, j’ai observé ce second creux de l’erreur de test. Ce n’était pas théorique : il apparaissait dans nos courbes de validation.
Cela aide à expliquer pourquoi de grands modèles comme les ResNets, et plus généralement des architectures massivement surparamétrées, peuvent tout de même bien généraliser. Même si les lois d’échelle pour des modèles comme GPT suggèrent des améliorations plus régulières qu’une courbe de double descent marquée, le principe sous-jacent — plus grand n’est pas forcément pire — reste valable.
On distingue trois grandes étapes du double descent, décrites ci‑dessous.
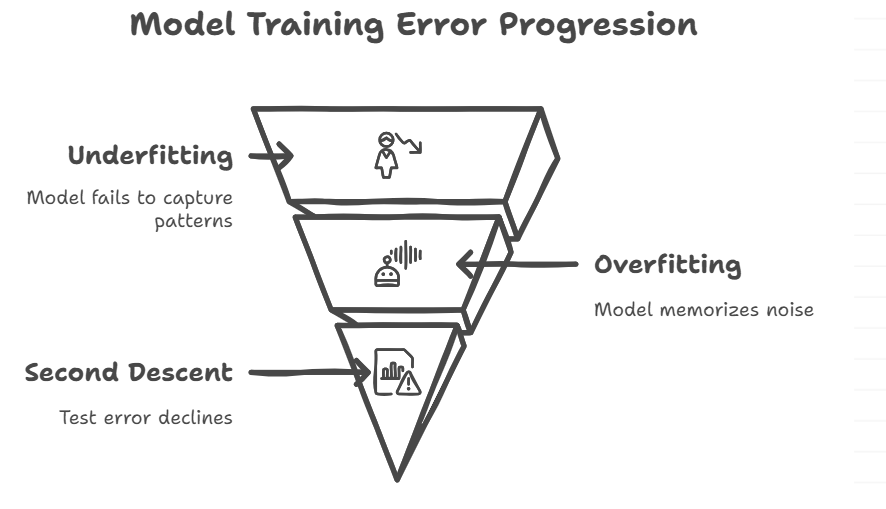
Phases du double descent. Source de l’image : Napkin AI
Retour d’expérience : commencez simple, mais n’ayez pas peur de la complexité.
Conseil pratique : si votre perte de validation explose en milieu d’entraînement, mettez en pause — mais ne stoppez pas tout.
Point clé : les gros modèles ne sont pas intrinsèquement chaotiques — ils sont régularisés implicitement.
L’une des explications majeures est que des optimiseurs comme SGD privilégient des minima plus plats, à plus faible courbure, qui tendent à mieux généraliser. Même dans des modèles massivement surparamétrés, ces régions plus plates deviennent plus accessibles à mesure que le paysage d’optimisation évolue.
L’un des aspects les plus fascinants du double descent est qu’il n’apparaît pas qu’en faisant croître la taille du modèle. On l’observe aussi au fil des époques d’entraînement et selon la taille des données — un phénomène que j’ai constaté en variant les durées d’entraînement et les découpages de données.
C’est la forme la plus étudiée. En ajoutant des paramètres, on passe du sous‑apprentissage à l’interpolation, puis à la surparamétrisation. Au‑delà du seuil d’interpolation, en ajouter davantage peut en réalité aider, selon le double descent. Cette idée contre‑intuitive a été observée dans les réseaux neuronaux profonds et la régression polynomiale.
Le double descent lié au modèle nous invite à ne pas craindre les grands modèles, pourvu qu’ils soient correctement entraînés. C’est aussi un rappel que réduire trop tôt la taille du modèle peut faire perdre des performances sans raison.
Une autre forme apparaît lorsqu’on entraîne plus longtemps. Au début, prolonger l’entraînement améliore les performances. Puis l’erreur de test remonte (surapprentissage). Mais elle peut redescendre avec un entraînement poursuivi. Cela arrive souvent quand on utilise des méthodes comme la décroissance du taux d’apprentissage ou le lissage/average des poids, qui facilitent la recherche de minima plus plats en fin d’entraînement.
Ainsi, dans certains cas, continuer l’entraînement au‑delà du point de surapprentissage peut améliorer la généralisation. Toutefois, c’est très dépendant du contexte et doit être guidé par une validation rigoureuse — prolonger aveuglément l’entraînement peut aggraver le surapprentissage dans bien des cas.
Plus surprenant, le double descent peut aussi concerner la quantité de données d’entraînement. Au départ, ajouter des données améliore les résultats. Mais il arrive, notamment en présence de beaucoup de bruit, que le modèle peine, faisant grimper l’erreur de test. Finalement, la généralisation s’améliore à nouveau à mesure que l’on ajoute des données plus pertinentes. Cette forme de double descent nous rappelle que « plus de données » n’est pas immédiatement synonyme de « mieux », même si cela paie généralement à terme.
Pour comprendre pourquoi le double descent survient, il faut plonger dans la dynamique d’optimisation, la géométrie et la théorie de l’apprentissage.
On peut étudier la courbure de la surface de perte via la décomposition en valeurs singulières (SVD). Autour du seuil d’interpolation, les modèles sont très sensibles aux directions d’entrée associées à de petites valeurs singulières, c’est‑à‑dire à faible rapport signal/bruit. Cela fait grimper l’erreur de test, car ce sont les « directions faibles » où le bruit favorise le surapprentissage.
L’une des idées les plus acceptées est que la descente de gradient stochastique (SGD) stabilise implicitement la solution. SGD préfère, parmi de multiples configurations, des poids de faible norme ou faible courbure pour minimiser la perte. Ce sont des solutions plus simples dans un espace de grande dimension. Ces minima plats sont moins sensibles aux variations et souvent liés à une meilleure généralisation, surtout lors de la seconde descente.
Le bruit est délicat. Au seuil d’interpolation, même un peu de bruit d’étiquetage peut être appris par le modèle, entraînant de gros écarts de généralisation. Mais si l’optimiseur fait bien son travail, et si le nombre de paramètres est suffisant, le modèle parvient à séparer le signal du bruit. Cela conforte l’idée que la surparamétrisation n’est pas un problème si l’optimisation est bien menée.
L’hypothèse du « Lottery Ticket » suggère que les grands réseaux contiennent de petits sous‑réseaux entraînables et performants, plus faciles à trouver dans des modèles de grande taille. La théorie des minima aigus vs. plats affirme que la forme de la surface de perte influence davantage la généralisation que la seule taille du modèle.
Ensemble, ces perspectives enrichissent la compréhension des raisons d’apparition du double descent.
Parmi les premières études à mettre en évidence le double descent, on trouve Belkin et al. (2019). Ils ont testé la régression polynomiale et des réseaux neuronaux, et montré que l’erreur de test ne fait pas que monter puis se stabiliser : elle peut redescendre. Ces benchmarks ont confirmé un phénomène que beaucoup de praticiens du deep learning avaient remarqué de manière anecdotique.
Quand on augmente la profondeur des couches des ResNets sur CIFAR‑10 et ImageNet, les performances suivent la dynamique du double descent. Même avec des données fixes, les transformers comme GPT‑2/3/4 généralisent mieux à mesure que la taille du modèle augmente. En élargissant filtres, couches ou unités, les CNN entraînés sur des jeux de données en vision suivent souvent la courbe du double descent.
Comprendre le double descent n’est pas qu’un exercice théorique : cela aide les organisations à faire de meilleurs choix sur des projets de ML réels.
Ce concept montre que plus grand n’est pas toujours pire. En fait, accroître la capacité au‑delà du point de surapprentissage peut améliorer la généralisation, surtout si l’on optimise et régularise correctement. Cela dit, il faut mettre en balance les gains de performance avec les coûts de calcul et l’impact environnemental.
Par exemple, utiliser le dropout après le seuil d’interpolation peut stabiliser l’apprentissage lors de la seconde descente. Vous pouvez tester des plans d’entraînement plus longs, des taux d’apprentissage cycliques, ou même retarder la régularisation jusqu’après le pic d’interpolation. Cela peut rendre l’apprentissage plus stable durant la seconde descente.
Le double descent éclaire aussi la stratégie de collecte de données. Lorsque vous atteignez ce vilain pic d’interpolation (où l’erreur explose malgré une précision parfaite à l’entraînement), le réflexe est d’injecter davantage de données brutes. Évitez. Car le double descent « sample‑wise » signifie qu’ajouter des données peut d’abord amplifier la sensibilité au bruit avant d’aider.
Privilégiez plutôt l’apprentissage actif, l’augmentation de données et l’échantillonnage stratifié, au lieu d’ajouter mécaniquement des données. Ces approches aident le modèle à franchir plus sereinement le pic d’interpolation. Suivez l’impact des données avec la Data Quality Dimensions Cheat Sheet de DataCamp.
Pour réduire le surapprentissage près du seuil d’interpolation, pensez au dropout, à la batch norm et au weight decay. Ces outils aident à déterminer si vous êtes dans la zone à risques ou sur le point d’atteindre le « sweet spot » de la seconde descente. Je les ai personnellement utilisés sur plusieurs projets, notamment avec des jeux de données déséquilibrés ou bruités.
Malgré une littérature croissante, le double descent suscite plus de questions qu’il n’apporte de réponses. Même si la recherche progresse, des zones d’ombre subsistent et dessinent des pistes prometteuses pour ce champ passionnant.
Peut‑on prédire mathématiquement ou statistiquement quand le double descent surviendra exactement ? Quelles caractéristiques du jeu de données, du type d’architecture ou du choix d’optimiseur déterminent la forme de la courbe d’erreur de test ? Autant de questions qui appellent de futurs travaux.
Pourrait‑on concevoir des réseaux neuronaux ou des plannings d’entraînement exploitant mieux la seconde descente ? Faut‑il considérer la surparamétrisation comme un levier stratégique de conception ? Les travaux sur les neural tangent kernels, les dynamiques de pré‑entraînement et la recherche d’architectures offrent un bon point de départ.
Le double descent nous amène à reconsidérer les fondements de l’apprentissage. Il suggère que complexité et généralisation ne s’opposent pas toujours, et que le surapprentissage n’est pas nécessairement une fatalité. C’est un changement de perspective majeur pour nombre de praticiens classiques, et la preuve que nos théories de l’apprentissage évoluent encore.
Le double descent est plus qu’une curiosité en machine learning : c’est une nouvelle façon de penser la généralisation. Plutôt que d’éviter ou d’abandonner les modèles complexes, il s’agit peut‑être de les utiliser avec discernement. Cela implique de faire confiance à l’optimisation, de bien connaître vos données et de rester ouvert à des pratiques moins conventionnelles.
Ne cédez pas à la panique la prochaine fois que votre modèle commence à surapprendre. Vous êtes peut‑être aux portes de la seconde descente.
Maintenant que vous comprenez le double descent, découvrez aussi les ressources ci‑dessous pour approfondir.
Top DataCamp Courses
Cursus
Cursus
Cours