Programa
Fundamentos de machine learning Em Python
16 h
A regra tradicional de modelagem estatística diz que, conforme o modelo fica mais complexo, o erro de treino cai, mas o erro de teste sobe por causa de overfitting. Se você simplifica demais, acaba em underfitting. Esse é o clássico trade-off viés–variância que aprendemos por décadas.
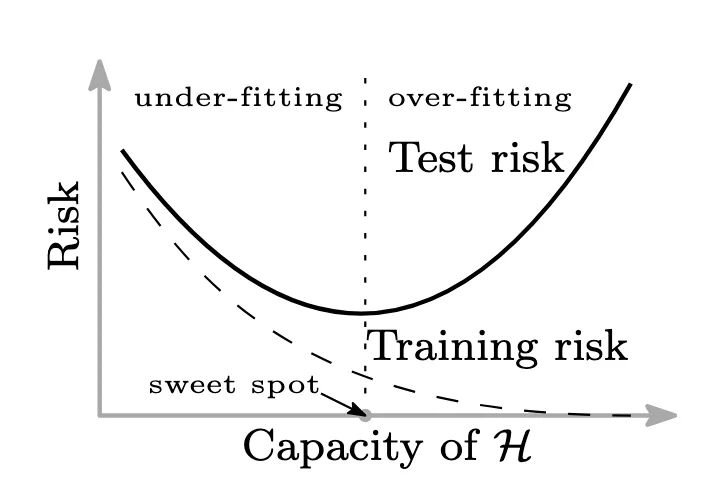
O clássico trade-off viés–variância. Fonte: adaptado da Figura 1(a) em Belkin et al., 2019
Mas o machine learning moderno, especialmente o deep learning, desafia essa ideia elegante. Se você trabalha com deep learning nos últimos anos, talvez tenha notado algo estranho: modelos com milhões de parâmetros ainda assim generalizam muito bem.
Pela sabedoria convencional, isso não deveria acontecer. Ou deveria?
Entra em cena o double descent: um fenômeno curioso e fascinante em que aumentar a complexidade do modelo volta a melhorar o desempenho depois de uma alta repentina no erro de teste.
Não é só um conceito acadêmico curioso; ele realmente me ajudou a entender tendências contraintuitivas que observei em projetos reais de machine learning. Como alguém que passou anos liderando iniciativas de previsão, churn e NLP em sistemas de larga escala, vi de perto como esse fenômeno desafia a sabedoria tradicional e muda nossa abordagem à complexidade de modelos.
Neste artigo, vamos falar o que é o double descent, suas fases, quando e por que acontece e, o mais importante, o que fazer a respeito.
Double descent pode parecer uma novidade, mas pouca gente sabe que é um conceito antigo, trazido de volta ao centro do debate pelo deep learning.
A ideia de que aumentar a complexidade do modelo pode levar a uma melhor generalização depois do overfitting não é totalmente nova. Estatística clássica já sugeria esse comportamento estranho décadas atrás. Por exemplo, ao ajustar polinômios de grau alto em regressão linear, dá para ver o padrão de overfitting seguido de melhor generalização. Mas muitos diziam que esses padrões eram artefatos de overfitting ou instabilidade numérica, não um comportamento real.
A virada veio com o sucesso das redes neurais profundas, em que os modelos costumam ter milhões ou até bilhões de parâmetros, muito mais do que a quantidade de exemplos de treino.
A sabedoria clássica sugere que modelos complexos deveriam fazer overfit de forma significativa. Surpreendentemente, não é o que acontece. Na prática, esses modelos muitas vezes generalizam melhor do que os menores.
Essa descoberta inesperada levou pesquisadores como Belkin et al. (2019) a revisitar teorias antigas. A conclusão fascinante foi: quando um modelo fica complexo o suficiente para ajustar perfeitamente os dados de treino, o erro de teste volta a cair conforme o modelo cresce. O deep learning não apenas revelou esse fenômeno, conhecido como "double descent" — ele o transformou em um conceito fundamental para entendermos generalização hoje.
Double descent descreve a observação de que a curva de erro de teste nem sempre é em U em função da complexidade do modelo. Após a primeira queda (com a redução do viés), o erro de teste aumenta (por overfitting), mas então, de forma inesperada, volta a diminuir. Isso forma o "double descent".
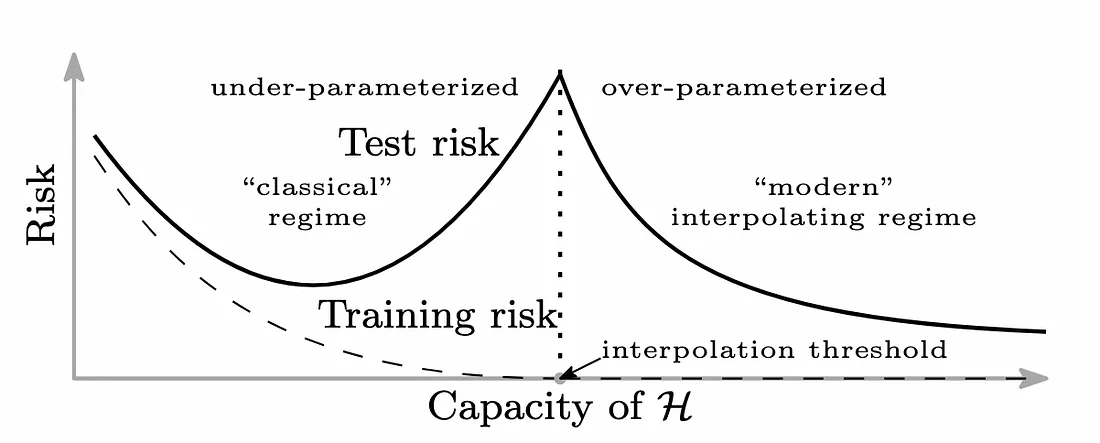
A curva de risco do double descent. Fonte: adaptado da Figura 1(b) em Belkin et al., 2019
Na minha prática, especialmente ao implantar sistemas de classificação de texto com deep learning e fazer previsão de séries temporais para cadeias de suprimentos, observei esse segundo vale no erro de teste. Não era teoria; estava visível nas curvas de validação.
Isso ajuda a explicar por que modelos grandes como ResNets e, no geral, arquiteturas massivamente superparametrizadas ainda podem generalizar bem. Embora as scaling laws para modelos como GPT sugiram melhorias mais suaves, sem um double descent tão evidente, o princípio subjacente — de que maior nem sempre é pior — continua valendo.
Há três estágios principais do double descent, discutidos abaixo.
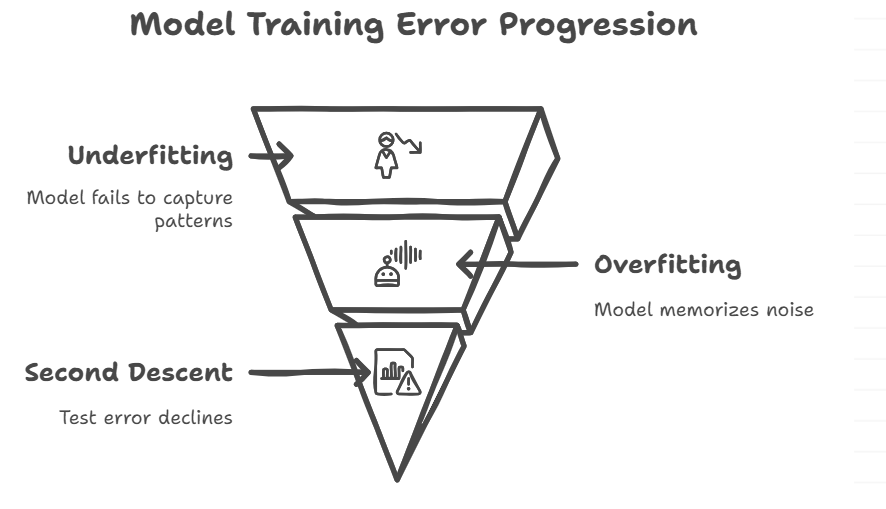
Fases do double descent. Fonte da imagem: Napkin AI
Da minha experiência: comece simples, mas não tenha medo da complexidade.
Dica prática: se sua loss de validação dispara no meio do treino, faça uma pausa — mas não encerre.
Insight-chave: modelos grandes não são inerentemente caóticos — eles têm regularização implícita.
Uma explicação forte é que otimizadores como SGD tendem a preferir mínimos mais planos, com menor curvatura, que costumam generalizar melhor. Mesmo em modelos massivamente superparametrizados, essas regiões planas ficam mais fáceis de encontrar à medida que o landscape de otimização muda.
Um dos aspectos mais interessantes do double descent é que ele não aparece só ao escalar o tamanho do modelo. Também surge ao longo de épocas e tamanho de dados de treino — algo que notei ao rodar experimentos com durações de treino e divisões de dados variadas.
Esta é a forma mais estudada. Ao adicionar mais parâmetros, passamos de underfitting para interpolação e depois para superparametrização. Adicionar ainda mais parâmetros além do limiar de interpolação pode, na verdade, ajudar, segundo o double descent. Essa ideia, contraintuitiva, já foi observada em redes neurais profundas e em regressão polinomial.
O double descent por modelo nos permite não temer modelos grandes, desde que bem treinados. Também lembra que cortar a complexidade cedo demais pode significar abrir mão de desempenho à toa.
Outra forma aparece quando você treina por mais tempo. No início, mais treino melhora o desempenho. Depois, o erro de teste sobe (overfitting). Mas pode voltar a cair com o treino contínuo. Isso é comum quando se usam métodos como decaimento de learning rate ou weight averaging, que facilitam a busca por mínimos mais planos nas fases finais do treino.
Então, em alguns casos, continuar treinando além do ponto de overfitting pode levar a melhor generalização. Porém, isso é altamente dependente do contexto e deve ser guiado por validação cuidadosa — estender o treino às cegas pode piorar o overfitting em muitos casos práticos.
O ponto mais surpreendente é que o double descent também pode ocorrer com a quantidade de dados de treino. Primeiro, adicionar mais dados ajuda. Mas há momentos, especialmente quando há muito ruído, em que o modelo pode ter dificuldades, elevando o erro de teste. Com o tempo, a generalização volta a melhorar conforme dados mais úteis são adicionados. Esse tipo de double descent mostra que mais dados nem sempre ajudam de imediato, mas tendem a valer a pena no fim.
Para entender por que o double descent acontece, precisamos explorar conceitos como dinâmica de otimização, geometria e teoria do aprendizado.
Podemos observar a curvatura da superfície de loss usando decomposição em valores singulares (SVD). Perto do limiar de interpolação, os modelos são muito sensíveis a direções de entrada com valores singulares pequenos, que têm baixa relação sinal–ruído. Isso eleva o erro de teste — são as "direções fracas" onde o ruído influencia bastante o overfitting.
Uma das ideias mais aceitas é que o stochastic gradient descent (SGD) torna a solução implicitamente mais estável. O SGD prefere configurações de pesos com norma ou curvatura baixas, entre múltiplas configurações que minimizam a loss. São soluções mais simples em espaço de alta dimensão. Esses mínimos planos sofrem menos com variações e costumam estar ligados a melhor generalização, especialmente na segunda descida.
Ruído é traiçoeiro. No limiar de interpolação, até um pouco de ruído nos rótulos pode ser ajustado pelo modelo, gerando grandes lacunas de generalização. Mas se o otimizador faz um bom trabalho e você tem parâmetros em abundância, o modelo consegue separar sinal de ruído. Isso reforça a ideia de que superparametrização não é problema se a otimização for bem conduzida.
A Lottery Ticket Hypothesis diz que redes grandes contêm pequenos sub-redes treináveis que funcionam muito bem; modelos maiores facilitam encontrá-las. A teoria de mínimos agudos vs. planos afirma que o formato da superfície de loss impacta mais a generalização do que o tamanho do modelo.
Em conjunto, essas perspectivas enriquecem o entendimento sobre por que o double descent surge.
Alguns dos primeiros estudos que mostraram o double descent foram de Belkin et al. (2019). Eles testaram regressão polinomial e modelos de redes neurais e descobriram que o erro de teste não só sobe e estabiliza; ele pode voltar a cair. Esses benchmarks deram forma a um fenômeno que muitos na comunidade de deep learning já notavam empiricamente.
Quando a profundidade das camadas em ResNets aumenta no CIFAR-10 e no ImageNet, o desempenho segue o double descent. Mesmo com dados fixos, transformers como GPT-2/3/4 ficam melhores em generalizar conforme o tamanho do modelo cresce. Ao ampliar filtros, camadas ou unidades, CNNs treinadas em datasets de visão frequentemente seguem a curva de double descent.
Aprender sobre double descent não é só exercício acadêmico; ajuda as organizações a tomarem decisões melhores em projetos de ML do dia a dia.
Esse conceito mostra que maior nem sempre é pior. Na verdade, aumentar a capacidade do modelo além do ponto de overfitting pode melhorar a generalização, especialmente se você otimizar e regularizar corretamente. Dito isso, ainda é preciso ponderar os ganhos de desempenho contra os custos computacionais e o impacto ambiental.
Por exemplo, usar dropout depois do limiar de interpolação pode estabilizar o aprendizado na segunda fase de descida. Você pode tentar agendas de treino mais longas, learning rates cíclicas ou até adiar a regularização para depois do pico de interpolação. Isso pode tornar o aprendizado mais estável na segunda descida.
O double descent também orienta o planejamento de coleta de dados. Ao chegar naquele pico feio de interpolação (onde o erro dispara apesar da acurácia perfeita no treino), a reação instintiva é jogar mais dados brutos no modelo. Não faça isso. Porque, no double descent por amostra, mais dados podem inicialmente amplificar a sensibilidade ao ruído antes de ajudar.
Em vez disso, considere usar técnicas como active learning, aumento de dados e amostragem estratificada, em vez de apenas aumentar o volume. Isso ajuda o modelo a atravessar o pico de interpolação com mais facilidade. Monitore o impacto dos dados com a cheat sheet de dimensões de qualidade de dados da DataCamp.
Para reduzir o overfitting perto do limiar de interpolação, pense em ferramentas como dropout, batch norm e weight decay. Elas ajudam a identificar se você está na zona de risco ou chegando ao ponto ideal da segunda descida. Eu, pessoalmente, usei essas técnicas em vários projetos de modelagem, especialmente com datasets desbalanceados ou ruidosos.
Apesar do volume crescente de estudos, o double descent levanta mais perguntas do que responde. Mesmo com a pesquisa avançando, ainda há questões em aberto e caminhos promissores para esta área empolgante.
É possível prever matemática ou estatisticamente quando exatamente o double descent vai ocorrer? Quais características do dataset, do tipo de arquitetura ou da escolha do otimizador determinam o formato da curva de erro de teste? São perguntas que pedem mais investigação no futuro.
Conseguimos projetar redes neurais ou agendas de treino para tirar melhor proveito da segunda descida? Devemos enxergar a superparametrização como uma camada estratégica de design? Esse é um bom ponto de partida envolvendo neural tangent kernels, dinâmicas de pré-treino e busca de arquiteturas.
O double descent nos faz repensar os fundamentos do aprendizado. Sugere que complexidade e generalização nem sempre estão em conflito, e que overfitting pode não ser o pior cenário. É uma mudança grande na mentalidade de muitos praticantes clássicos e mostra que nossas teorias sobre aprendizado ainda estão evoluindo.
Double descent é mais do que um novo enredo em machine learning; é uma nova forma de pensar generalização. Em vez de evitar ou abandonar modelos complexos, talvez precisemos usá-los de forma estratégica. Isso significa confiar na otimização, conhecer seus dados e estar aberto a abordagens fora do feijão com arroz.
Da próxima vez que seu modelo começar a fazer overfit, não entre em pânico tão rápido. Você pode estar prestes a encontrar a segunda descida.
Agora que você entendeu o double descent, confira também alguns recursos e links abaixo para aprofundar esse aprendizado.
Principais cursos da DataCamp
Programa
Programa
Curso
blog
Abid Ali Awan
7 min
blog
Natassha Selvaraj
15 min
blog
Abid Ali Awan
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
9 min
Tutorial
Sejal Jaiswal
15 min