Geleneksel istatistiksel modelleme kuralı, model karmaşıklaştıkça eğitim hatasının düştüğünü, ancak aşırı uyum nedeniyle test hatasının arttığını söyler. Basit tutarsanız, bu kez eksik uyum riski doğar. Bu, onlarca yıldır bize öğretilen klasik önyargı-varyans ödünleşimidir.
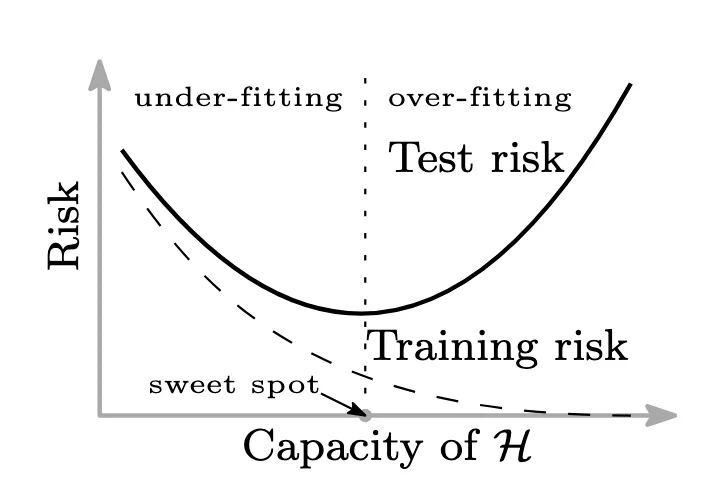
Klasik önyargı-varyans ödünleşimi. Kaynak: Belkin ve diğ., 2019, Şekil 1(a)’dan uyarlanmıştır
Ancak modern makine öğrenimi, özellikle derin öğrenme, bu şık fikre meydan okuyor. Son yıllarda derin öğrenme ile çalıştıysanız, tuhaf bir şey fark etmiş olabilirsiniz: milyonlarca parametreye sahip modeller yine de şaşırtıcı derecede iyi genelleme yapabiliyor.
Bu, geleneksel bilgelik açısından beklenmez. Yoksa beklenir mi?
Karşınızda çift düşüş: model karmaşıklığını artırmanın, test hatasındaki ani bir yükselişten sonra performansı yeniden iyileştirdiği garip ama büyüleyici bir olgu.
Bu sadece garip bir akademik kavram değil; gerçek dünya makine öğrenimi projelerinde gözlemlediğim sezgilere aykırı eğilimleri anlamlandırmama gerçekten yardımcı oldu. Büyük ölçekli sistemlerde tahminleme, müşteri kaybı öngörüsü ve NLP girişimlerine yıllarımı vermiş biri olarak, bu olgunun geleneksel bilgeliği nasıl zorladığına ve model karmaşıklığına yaklaşımımızı nasıl yeniden şekillendirdiğine bizzat tanık oldum.
Bu yazıda çift düşüşün ne olduğunu, aşamalarını, ne zaman ve neden ortaya çıktığını ve en önemlisi buna karşı ne yapılabileceğini konuşacağız.
Çift Düşüşün Kısa Tarihi
Çift düşüş yeni bir fikir gibi görünebilir, ancak çoğu kişi bunun derin öğrenmeyle yeniden odak noktasına taşınan eski bir kavram olduğunun farkında değildir.
Erken gözlemler: Tekdüze olmayan hata gizemi
Model karmaşıklığının artırılmasının, aşırı uyumdan sonra daha iyi genelleme ile sonuçlanabileceği fikri tamamen yeni değildir. Aslında klasik istatistikler, onlarca yıl önce bu garip davranışa işaret etmişti. Örneğin, doğrusal regresyonda verilere yüksek dereceli polinomlar uydururken, aşırı uyumun ardından gelen daha iyi genelleme örüntüsünü görebilirsiniz. Ancak çoğu zaman bu örüntülerin gerçek bir davranış değil, aşırı uyumun veya sayısal kararsızlığın eserleri olduğu söylendi.
Modern yeniden keşif: Derin öğrenme yeniden düşünmeyi zorladı
Kırılma noktası, modellerin çoğu zaman eğitim örneklerinin sayısından çok daha fazla, milyonlarca hatta milyarlarca parametreye sahip olduğu derin sinir ağlarının başarısıyla geldi.
Klasik görüş, karmaşık modellerin eğitim verilerine belirgin şekilde aşırı uyum göstermesi gerektiğini öne sürer. Ne var ki, şaşırtıcı biçimde durum her zaman böyle değildir. Hatta bu modeller çoğu zaman daha küçük olanlardan daha iyi genelleme yapar.
Bu beklenmedik bulgu, Belkin ve diğ. (2019) gibi araştırmacıları daha eski teorileri incelemeye yöneltti. Onların ilgi çekici keşfi, bir model eğitim verilerini mükemmel biçimde uyduracak kadar karmaşık hale geldiğinde, model büyüdükçe test hatasının aslında tekrar azalmaya başladığını ortaya koydu. Derin öğrenme, 'çift düşüş' olarak bilinen bu olguyu yalnızca gün yüzüne çıkarmakla kalmadı—bugün genelleme anlayışımızda temel bir kavrama dönüştürdü.
Çift Düşüş Nedir? Tanım, Sezgi ve Risk Eğrisi
Çift düşüş, test hatası eğrisinin model karmaşıklığına göre her zaman U şeklinde olmamasını ifade eder. İlk düşüşten (önyargı azalırken) sonra test hatası artar (aşırı uyum nedeniyle), ancak ardından, beklenmedik şekilde yeniden azalmaya başlar. Bu da “çift düşüş” şeklini oluşturur.
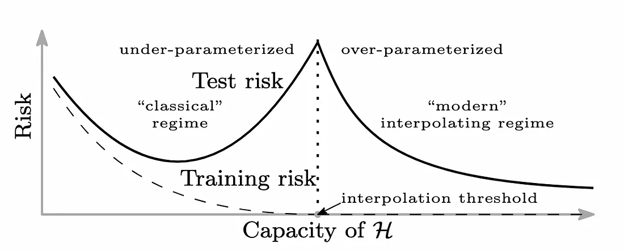
Çift düşüş risk eğrisi. Kaynak: Belkin ve diğ., 2019, Şekil 1(b)’den uyarlanmıştır
Kendi pratiğimde, özellikle derin öğrenme tabanlı metin sınıflandırma sistemleri devreye alırken ve tedarik zinciri şirketleri için zaman serisi tahminleri yaparken test hatasındaki bu ikinci düşüşü gözlemledim. Bu teorik değildi; doğrulama eğrilerimizde görünürdü.
Bu durum, ResNet’ler gibi büyük modellerin ve genel olarak aşırı parametreli mimarilerin nasıl olup da iyi genelleme yapabildiğini açıklamaya yardımcı olur. GPT benzeri modeller için ölçekleme yasaları görünür bir çift düşüş eğrisi yerine daha pürüzsüz iyileşmeler önerse de, altta yatan ilke—büyüğün her zaman daha kötü olmadığı—geçerliliğini korur.
Çift Düşüşün Temel İlkeleri ve Aşamaları
Aşağıda tartışılan çift düşüşün üç ana aşaması vardır.
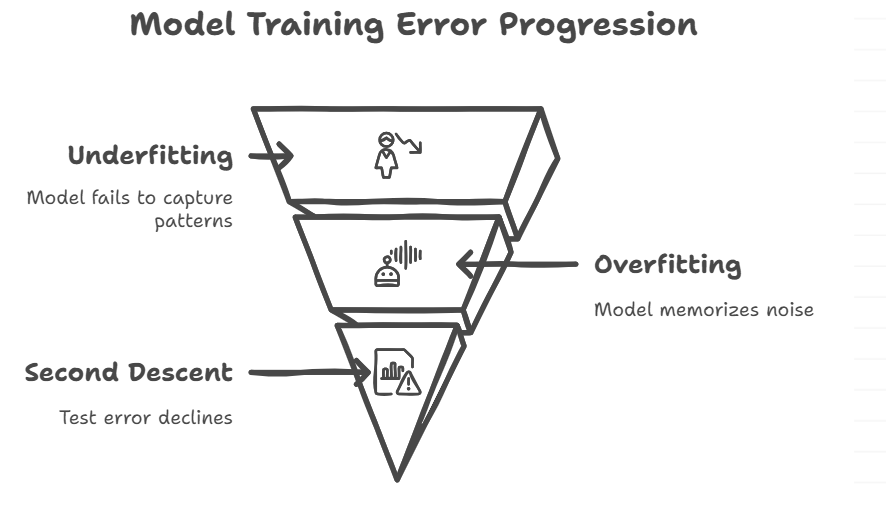
Çift Düşüşün Aşamaları. Görselin Kaynağı: Napkin AI
Eksik Uyum Aşaması
- Özellikler: Modeller örüntüleri yakalamak için çok zayıftır (ör. görüntü verisinde doğrusal regresyon).
- Davranış: Parametre eklemek önyargıyı azaltır, ancak belirli bir noktaya kadar.
Deneyimime göre: Basit başlayın, ancak karmaşıklıktan korkmayın.
Aşırı Uyum Aşaması (Tehlike Bölgesi)
- Özellikler: Modeller gürültüyü ezberler, bu da test hatasında keskin sıçramalara yol açar.
- İşin püf noktası: Çoğu kişi eğitimi burada durdurur—oysa bu son nokta değildir.
Pratik ipucu: Doğrulama kaybınız eğitim ortasında sıçrarsa duraklatın—ancak sonlandırmayın.
İkinci Düşüş Aşaması
- Özellikler: Mükemmel eğitim uyumuna rağmen test hatası düşer.
- Mekanizma: Aşırı parametreleme, optimizasyonun (SGD gibi) "daha basit" çözümleri bulmasına imkân verir.
Temel içgörü: Büyük modeller doğası gereği kaotik değildir—örtük olarak düzenlenirler.
Önde gelen açıklamalardan biri, SGD gibi optimize edicilerin doğası gereği daha iyi genelleyen daha düz minimayı, yani eğriliği düşük bölgeleri tercih etmesidir. Optimizasyon manzarası değiştikçe, bu düz bölgeler, aşırı parametreli modellerde bile, bulunması daha kolay hale gelir.
Çift Düşüşün Boyutsal Görünümleri
Çift düşüşün en ilgi çekici yönlerinden biri, yalnızca model boyutunu ölçeklerken ortaya çıkmamasıdır. Aynı zamanda epoklar ve eğitim verisi miktarı boyunca da görünür—bu durumu farklı eğitim süreleri ve veri bölüşümleriyle deneyler yaparken fark ettim.
Modele bağlı çift düşüş
Bu en yaygın çalışılan biçimdir. Daha fazla parametre eklediğimizde, eksik uyumdan interpolasyona, oradan da aşırı parametrelemeye geçeriz. Çift düşüşe göre, interpolasyon eşiğinin ötesine geçip daha fazla parametre eklemek aslında yardımcı olabilir. Sezgilere aykırı olan bu fikir, derin sinir ağlarında ve polinom regresyonda gözlemlenmiştir.
Modele bağlı çift düşüş, uygun şekilde eğitildikleri sürece büyük modellerden korkmamamız gerektiğini gösterir. Ayrıca, modelleri çok erken kısmamızın, nedensiz yere performanstan feragat anlamına gelebileceğini hatırlatır.
Epoka bağlı çift düşüş
Bir diğer düşüş türü, daha uzun süre eğitim yaptığınızda meydana gelir. Başlangıçta daha fazla eğitim performansı iyileştirir. Ardından test hatası yükselir (aşırı uyum). Ancak eğitim sürdükçe yeniden düşebilir. Bu durum, öğrenme oranı azalışı veya ağırlık ortalaması gibi, eğitimin ilerleyen safhalarında daha düz minimayı bulmayı kolaylaştıran yöntemler kullanıldığında sık görülür.
Dolayısıyla bazı durumlarda, aşırı uyum noktasının ötesinde eğitimi sürdürmek daha iyi genelleme sağlayabilir. Ancak bu son derece bağlama bağlıdır ve dikkatli bir doğrulama ile yönlendirilmelidir—düşünmeden eğitimi uzatmak, pratikte birçok durumda aşırı uyumu daha da kötüleştirebilir.
Örnek sayısına bağlı çift düşüş
En şaşırtıcı yönü ise çift düşüşün eğitim verisi miktarıyla da ortaya çıkabilmesidir. Başlangıçta daha fazla veri eklemek işleri iyileştirir. Ancak özellikle veride çok gürültü olduğunda, model zorlanabilir ve bu da test hatasını artırır. Sonunda, daha faydalı veri eklendikçe genelleme yine iyileşir. Bu tür çift düşüş, daha fazla verinin her zaman anında daha iyi olmadığını, ancak sonunda genellikle karşılığını verdiğini gösterir.
Kuramsal Mekanizmalar ve Matematiksel Temeller
Çift düşüşün neden gerçekleştiğini anlamak için optimizasyon dinamikleri, geometri ve öğrenme teorisi gibi kavramlara dalmamız gerekir.
Spektral analiz
Kayıp yüzeyinin eğriliğine tekil değer ayrışımı (SVD) kullanarak bakabiliriz. İnterpolasyon eşiği civarında, modeller küçük tekil değerlere sahip giriş yönlerine, yani sinyal-gürültü oranı düşük yönlere karşı çok hassastır. Bu durum, modelin test hatasını sıçratır; bunlar, gürültünün aşırı uyumu büyük ölçüde etkileyebildiği "zayıf yönler"dir.
Örtük düzenleme
En yaygın kabul gören fikirlerden biri, stokastik gradyan inişinin (SGD) çözümü örtük olarak daha kararlı hale getirmesidir. SGD, kaybı en aza indirmek için birden fazla yapılandırma arasında, düşük norma veya düşük eğriliğe sahip ağırlık yapılandırmalarını tercih eder. Bunlar, yüksek boyutlu uzayda daha basit çözümlerdir. Bu düz minimâlar, değişimlerden daha az etkilenir ve özellikle ikinci düşüşte daha iyi genelleme ile sıklıkla ilişkilendirilir.
Gürültünün rolü
Gürültü aldatıcıdır. İnterpolasyon eşiğinde, az miktarda etiket gürültüsü bile modelin onu uydurmasına neden olabilir ve bu da genellemede büyük boşluklara yol açabilir. Ancak optimize edici iyi iş çıkarır ve hatırı sayılır sayıda parametreye sahip olursanız, model sinyal ile gürültüyü ayırt edebilir. Bu da, optimizasyon doğru yapıldığı sürece aşırı parametrelemenin sorun olmadığı fikrini destekler.
Alternatif kuramlar
Piyango Bileti Hipotezi, büyük ağların iyi çalışan küçük, eğitilebilir alt ağlar içerdiğini; daha büyük modellerin bunları bulmayı kolaylaştırdığını söyler. Keskin ve düz minimâ kuramı ise kayıp yüzeyinin şeklinin, model boyutundan daha fazla, genelleme üzerinde etkili olduğunu öne sürer.
Birlikte ele alındığında, bu bakış açıları çift düşüşün neden ortaya çıktığına dair daha zengin bir anlayış sunar.
Ampirik Örnekler ve Kanıtlar
Kıyaslama deneyleri
Çift düşüşü gösteren en erken çalışmalardan bazıları Belkin ve diğ. (2019) tarafından yapıldı. Polinom regresyon ve sinir ağı modellerini denediler; ve test hatasının yalnızca yükselip yataylaşmadığını; aynı zamanda yeniden düşebildiğini buldular. Bu kıyaslamalar, derin öğrenme topluluğunda pek çok kişinin anekdotsal olarak fark ettiği bir olguyu görünür kıldı.
Derin öğrenme vaka çalışmaları
CIFAR-10 ve ImageNet üzerinde ResNet katman derinliği arttıkça, çift düşüş performansı sergilenir. Veri sabit kalsa bile, dönüştürücüler (transformer’lar) GPT-2/3/4 gibi modeller, model boyutu büyüdükçe genellemede daha iyi hale gelir. Filtreler, katmanlar veya birimler büyütüldüğünde, CNN’ler görsel veri kümeleri üzerinde sıklıkla çift düşüş eğrisini izler.
Model Geliştirme İçin Pratik Yansımalar
Çift düşüş hakkında bilgi edinmek sadece akademik bir egzersiz değildir; kurumların gerçek hayattaki ML projelerinde daha iyi seçimler yapmasına yardımcı olabilir.
Model ölçekleme
Bu kavram bize büyüğün her zaman daha kötü olmadığını söyler. Hatta, modelin kapasitesini aşırı uyum noktasının ötesine taşımak, özellikle doğru şekilde optimize ve düzenlerseniz, daha iyi genelleme sağlayabilir. Bununla birlikte, daha iyi performansın faydalarını hesaplama maliyetleri ve çevresel etkilerle tartmayı sürdürmeliyiz.
Eğitim protokolleri
Örneğin, interpolasyon eşiğinden sonra dropout kullanmak, ikinci düşüş aşamasında öğrenmeyi dengeli hale getirebilir. Daha uzun eğitim takvimleri, döngüsel öğrenme oranları deneyebilir veya düzenlemeyi interpolasyon zirvesinden sonraya erteleyebilirsiniz. Bu, ikinci düşüş aşamasında öğrenmeyi daha stabil hale getirebilir.
Veri yönetimi
Çift düşüş, veri toplama planlamasına da yardımcı olur. O çirkin interpolasyon zirvesine ulaştığınızda (eğitim doğruluğu mükemmel olmasına rağmen hatanın sıçradığı yer), refleks olarak modele daha fazla ham veri yüklemek isteyebilirsiniz. Yapmayın. Çünkü örnek sayısına bağlı çift düşüş, daha fazla verinin başlangıçta gürültü duyarlılığını artırabileceği anlamına gelir.
Bunun yerine, modele daha fazla veri vermek yerine aktif öğrenme, veri çoğaltma ve tabakalı örnekleme gibi yöntemleri düşünün. Bunlar, modelin interpolasyon zirvesini daha kolay aşmasına yardımcı olabilir. Verinin etkisini DataCamp’in Veri Kalitesi Boyutları Cheat Sheet’i ile izleyin.
Azaltma ve tanılama
Interpolasyon eşiği civarındaki aşırı uyumu azaltmaya yardımcı olmak için dropout, batch norm ve ağırlık bozunumu (weight decay) gibi araçları düşünün. Bunlar, tehlike bölgesinde olup olmadığınızı veya ikinci düşüşün tatlı noktasına yaklaşıp yaklaşmadığınızı anlamanıza yardımcı olabilir. Özellikle dengesiz veya gürültülü veri kümeleriyle çalışırken, bu teknikleri birçok modelleme projemde bizzat kullandım.
Çözülmemiş Sorular ve Gelecek Araştırma Yönleri
Artan çalışmalarına rağmen, çift düşüş cevapladığından daha fazla soru gündeme getiriyor. Çift düşüş üzerine daha fazla araştırma yapılsa da, yanıt bekleyen bazı sorular ve bu heyecan verici alanın gittiği yön hâlâ mevcut.
Kuramsal boşluklar
Çift düşüşün tam olarak ne zaman ortaya çıkacağını matematiksel veya istatistiksel olarak öngörmek mümkün mü? Veri kümesinin hangi özellikleri, mimari türü veya optimize edici seçimi test hatası eğrisinin şeklini belirler? Gelecekte araştırmanın daha çok çalışabileceği sorular bunlar.
Mimari ve optimizasyon
İkinci düşüşten daha iyi yararlanacak şekilde sinir ağları veya eğitim takvimleri tasarlayabilir miyiz? Aşırı parametrelemeye stratejik bir tasarım katmanı olarak mı bakmalıyız? Bu, sinir tanjant çekirdekleri, ön eğitim dinamikleri ve mimari arama için iyi bir başlangıçtır.
Felsefi değişimler
Çift düşüş, öğrenmenin temellerini yeniden düşünmemizi sağlar. Karmaşıklık ile genellemenin her zaman birbirine karşı çalışmadığını ve aşırı uyumun en kötü olasılık olmayabileceğini öne sürer. Bu, birçok klasik uygulayıcının düşünce biçiminde büyük bir değişimdir ve öğrenmeye dair kuramlarımızın hâlâ evrildiğini gösterir.
Sonuç
Çift düşüş, makine öğreniminde yalnızca yeni bir kıvrım değil; genelleme hakkında düşünme biçimimize yeni bir yaklaşımdır. Karmaşık modellerden kaçınmak veya onları terk etmek yerine, onları stratejik olarak kullanmamız gerekebilir. Bu da optimizasyona güvenmeyi, verinizi tanımayı ve genellikle yapılmayan yeni şeylere açık olmayı gerektirir.
Modeliniz bir sonraki kez aşırı uyum göstermeye başladığında hemen paniğe kapılmayın. Belki de ikinci düşüşle tanışmak üzeresiniz.
Artık çift düşüşü anladığınıza göre, bu öğrenimi pekiştirmek için aşağıda verilen bazı kaynak ve bağlantılara da göz atabilirsiniz.







Geleneksel istatistiksel modelleme kuralı, model karmaşıklaştıkça eğitim hatasının düştüğünü, ancak aşırı uyum nedeniyle test hatasının arttığını söyler. Basit tutarsanız, bu kez eksik uyum riski doğar. Bu, onlarca yıldır bize öğretilen klasik önyargı-varyans ödünleşimidir.
Klasik önyargı-varyans ödünleşimi. Kaynak: Belkin ve diğ., 2019, Şekil 1(a)’dan uyarlanmıştır
Ancak modern makine öğrenimi, özellikle derin öğrenme, bu şık fikre meydan okuyor. Son yıllarda derin öğrenme ile çalıştıysanız, tuhaf bir şey fark etmiş olabilirsiniz: milyonlarca parametreye sahip modeller yine de şaşırtıcı derecede iyi genelleme yapabiliyor.
Bu, geleneksel bilgelik açısından beklenmez. Yoksa beklenir mi?
Karşınızda çift düşüş: model karmaşıklığını artırmanın, test hatasındaki ani bir yükselişten sonra performansı yeniden iyileştirdiği garip ama büyüleyici bir olgu.
Bu sadece garip bir akademik kavram değil; gerçek dünya makine öğrenimi projelerinde gözlemlediğim sezgilere aykırı eğilimleri anlamlandırmama gerçekten yardımcı oldu. Büyük ölçekli sistemlerde tahminleme, müşteri kaybı öngörüsü ve NLP girişimlerine yıllarımı vermiş biri olarak, bu olgunun geleneksel bilgeliği nasıl zorladığına ve model karmaşıklığına yaklaşımımızı nasıl yeniden şekillendirdiğine bizzat tanık oldum.
Bu yazıda çift düşüşün ne olduğunu, aşamalarını, ne zaman ve neden ortaya çıktığını ve en önemlisi buna karşı ne yapılabileceğini konuşacağız.
Çift Düşüşün Kısa Tarihi
Çift düşüş yeni bir fikir gibi görünebilir, ancak çoğu kişi bunun derin öğrenmeyle yeniden odak noktasına taşınan eski bir kavram olduğunun farkında değildir.
Erken gözlemler: Tekdüze olmayan hata gizemi
Model karmaşıklığının artırılmasının, aşırı uyumdan sonra daha iyi genelleme ile sonuçlanabileceği fikri tamamen yeni değildir. Aslında klasik istatistikler, onlarca yıl önce bu garip davranışa işaret etmişti. Örneğin, doğrusal regresyonda verilere yüksek dereceli polinomlar uydururken, aşırı uyumun ardından gelen daha iyi genelleme örüntüsünü görebilirsiniz. Ancak çoğu zaman bu örüntülerin gerçek bir davranış değil, aşırı uyumun veya sayısal kararsızlığın eserleri olduğu söylendi.
Modern yeniden keşif: Derin öğrenme yeniden düşünmeyi zorladı
Kırılma noktası, modellerin çoğu zaman eğitim örneklerinin sayısından çok daha fazla, milyonlarca hatta milyarlarca parametreye sahip olduğu derin sinir ağlarının başarısıyla geldi.
Klasik görüş, karmaşık modellerin eğitim verilerine belirgin şekilde aşırı uyum göstermesi gerektiğini öne sürer. Ne var ki, şaşırtıcı biçimde durum her zaman böyle değildir. Hatta bu modeller çoğu zaman daha küçük olanlardan daha iyi genelleme yapar.
Bu beklenmedik bulgu, Belkin ve diğ. (2019) gibi araştırmacıları daha eski teorileri incelemeye yöneltti. Onların ilgi çekici keşfi, bir model eğitim verilerini mükemmel biçimde uyduracak kadar karmaşık hale geldiğinde, model büyüdükçe test hatasının aslında tekrar azalmaya başladığını ortaya koydu. Derin öğrenme, 'çift düşüş' olarak bilinen bu olguyu yalnızca gün yüzüne çıkarmakla kalmadı—bugün genelleme anlayışımızda temel bir kavrama dönüştürdü.
Çift Düşüş Nedir? Tanım, Sezgi ve Risk Eğrisi
Çift düşüş, test hatası eğrisinin model karmaşıklığına göre her zaman U şeklinde olmamasını ifade eder. İlk düşüşten (önyargı azalırken) sonra test hatası artar (aşırı uyum nedeniyle), ancak ardından, beklenmedik şekilde yeniden azalmaya başlar. Bu da “çift düşüş” şeklini oluşturur.
Çift düşüş risk eğrisi. Kaynak: Belkin ve diğ., 2019, Şekil 1(b)’den uyarlanmıştır
Kendi pratiğimde, özellikle derin öğrenme tabanlı metin sınıflandırma sistemleri devreye alırken ve tedarik zinciri şirketleri için zaman serisi tahminleri yaparken test hatasındaki bu ikinci düşüşü gözlemledim. Bu teorik değildi; doğrulama eğrilerimizde görünürdü.
Bu durum, ResNet’ler gibi büyük modellerin ve genel olarak aşırı parametreli mimarilerin nasıl olup da iyi genelleme yapabildiğini açıklamaya yardımcı olur. GPT benzeri modeller için ölçekleme yasaları görünür bir çift düşüş eğrisi yerine daha pürüzsüz iyileşmeler önerse de, altta yatan ilke—büyüğün her zaman daha kötü olmadığı—geçerliliğini korur.
Çift Düşüşün Temel İlkeleri ve Aşamaları
Aşağıda tartışılan çift düşüşün üç ana aşaması vardır.
Çift Düşüşün Aşamaları. Görselin Kaynağı: Napkin AI
Eksik Uyum Aşaması
Deneyimime göre: Basit başlayın, ancak karmaşıklıktan korkmayın.
Aşırı Uyum Aşaması (Tehlike Bölgesi)
Pratik ipucu: Doğrulama kaybınız eğitim ortasında sıçrarsa duraklatın—ancak sonlandırmayın.
İkinci Düşüş Aşaması
Temel içgörü: Büyük modeller doğası gereği kaotik değildir—örtük olarak düzenlenirler.
Önde gelen açıklamalardan biri, SGD gibi optimize edicilerin doğası gereği daha iyi genelleyen daha düz minimayı, yani eğriliği düşük bölgeleri tercih etmesidir. Optimizasyon manzarası değiştikçe, bu düz bölgeler, aşırı parametreli modellerde bile, bulunması daha kolay hale gelir.
Çift Düşüşün Boyutsal Görünümleri
Çift düşüşün en ilgi çekici yönlerinden biri, yalnızca model boyutunu ölçeklerken ortaya çıkmamasıdır. Aynı zamanda epoklar ve eğitim verisi miktarı boyunca da görünür—bu durumu farklı eğitim süreleri ve veri bölüşümleriyle deneyler yaparken fark ettim.
Modele bağlı çift düşüş
Bu en yaygın çalışılan biçimdir. Daha fazla parametre eklediğimizde, eksik uyumdan interpolasyona, oradan da aşırı parametrelemeye geçeriz. Çift düşüşe göre, interpolasyon eşiğinin ötesine geçip daha fazla parametre eklemek aslında yardımcı olabilir. Sezgilere aykırı olan bu fikir, derin sinir ağlarında ve polinom regresyonda gözlemlenmiştir.
Modele bağlı çift düşüş, uygun şekilde eğitildikleri sürece büyük modellerden korkmamamız gerektiğini gösterir. Ayrıca, modelleri çok erken kısmamızın, nedensiz yere performanstan feragat anlamına gelebileceğini hatırlatır.
Epoka bağlı çift düşüş
Bir diğer düşüş türü, daha uzun süre eğitim yaptığınızda meydana gelir. Başlangıçta daha fazla eğitim performansı iyileştirir. Ardından test hatası yükselir (aşırı uyum). Ancak eğitim sürdükçe yeniden düşebilir. Bu durum, öğrenme oranı azalışı veya ağırlık ortalaması gibi, eğitimin ilerleyen safhalarında daha düz minimayı bulmayı kolaylaştıran yöntemler kullanıldığında sık görülür.
Dolayısıyla bazı durumlarda, aşırı uyum noktasının ötesinde eğitimi sürdürmek daha iyi genelleme sağlayabilir. Ancak bu son derece bağlama bağlıdır ve dikkatli bir doğrulama ile yönlendirilmelidir—düşünmeden eğitimi uzatmak, pratikte birçok durumda aşırı uyumu daha da kötüleştirebilir.
Örnek sayısına bağlı çift düşüş
En şaşırtıcı yönü ise çift düşüşün eğitim verisi miktarıyla da ortaya çıkabilmesidir. Başlangıçta daha fazla veri eklemek işleri iyileştirir. Ancak özellikle veride çok gürültü olduğunda, model zorlanabilir ve bu da test hatasını artırır. Sonunda, daha faydalı veri eklendikçe genelleme yine iyileşir. Bu tür çift düşüş, daha fazla verinin her zaman anında daha iyi olmadığını, ancak sonunda genellikle karşılığını verdiğini gösterir.
Kuramsal Mekanizmalar ve Matematiksel Temeller
Çift düşüşün neden gerçekleştiğini anlamak için optimizasyon dinamikleri, geometri ve öğrenme teorisi gibi kavramlara dalmamız gerekir.
Spektral analiz
Kayıp yüzeyinin eğriliğine tekil değer ayrışımı (SVD) kullanarak bakabiliriz. İnterpolasyon eşiği civarında, modeller küçük tekil değerlere sahip giriş yönlerine, yani sinyal-gürültü oranı düşük yönlere karşı çok hassastır. Bu durum, modelin test hatasını sıçratır; bunlar, gürültünün aşırı uyumu büyük ölçüde etkileyebildiği "zayıf yönler"dir.
Örtük düzenleme
En yaygın kabul gören fikirlerden biri, stokastik gradyan inişinin (SGD) çözümü örtük olarak daha kararlı hale getirmesidir. SGD, kaybı en aza indirmek için birden fazla yapılandırma arasında, düşük norma veya düşük eğriliğe sahip ağırlık yapılandırmalarını tercih eder. Bunlar, yüksek boyutlu uzayda daha basit çözümlerdir. Bu düz minimâlar, değişimlerden daha az etkilenir ve özellikle ikinci düşüşte daha iyi genelleme ile sıklıkla ilişkilendirilir.
Gürültünün rolü
Gürültü aldatıcıdır. İnterpolasyon eşiğinde, az miktarda etiket gürültüsü bile modelin onu uydurmasına neden olabilir ve bu da genellemede büyük boşluklara yol açabilir. Ancak optimize edici iyi iş çıkarır ve hatırı sayılır sayıda parametreye sahip olursanız, model sinyal ile gürültüyü ayırt edebilir. Bu da, optimizasyon doğru yapıldığı sürece aşırı parametrelemenin sorun olmadığı fikrini destekler.
Alternatif kuramlar
Piyango Bileti Hipotezi, büyük ağların iyi çalışan küçük, eğitilebilir alt ağlar içerdiğini; daha büyük modellerin bunları bulmayı kolaylaştırdığını söyler. Keskin ve düz minimâ kuramı ise kayıp yüzeyinin şeklinin, model boyutundan daha fazla, genelleme üzerinde etkili olduğunu öne sürer.
Birlikte ele alındığında, bu bakış açıları çift düşüşün neden ortaya çıktığına dair daha zengin bir anlayış sunar.
Ampirik Örnekler ve Kanıtlar
Kıyaslama deneyleri
Çift düşüşü gösteren en erken çalışmalardan bazıları Belkin ve diğ. (2019) tarafından yapıldı. Polinom regresyon ve sinir ağı modellerini denediler; ve test hatasının yalnızca yükselip yataylaşmadığını; aynı zamanda yeniden düşebildiğini buldular. Bu kıyaslamalar, derin öğrenme topluluğunda pek çok kişinin anekdotsal olarak fark ettiği bir olguyu görünür kıldı.
Derin öğrenme vaka çalışmaları
CIFAR-10 ve ImageNet üzerinde ResNet katman derinliği arttıkça, çift düşüş performansı sergilenir. Veri sabit kalsa bile, dönüştürücüler (transformer’lar) GPT-2/3/4 gibi modeller, model boyutu büyüdükçe genellemede daha iyi hale gelir. Filtreler, katmanlar veya birimler büyütüldüğünde, CNN’ler görsel veri kümeleri üzerinde sıklıkla çift düşüş eğrisini izler.
Model Geliştirme İçin Pratik Yansımalar
Çift düşüş hakkında bilgi edinmek sadece akademik bir egzersiz değildir; kurumların gerçek hayattaki ML projelerinde daha iyi seçimler yapmasına yardımcı olabilir.
Model ölçekleme
Bu kavram bize büyüğün her zaman daha kötü olmadığını söyler. Hatta, modelin kapasitesini aşırı uyum noktasının ötesine taşımak, özellikle doğru şekilde optimize ve düzenlerseniz, daha iyi genelleme sağlayabilir. Bununla birlikte, daha iyi performansın faydalarını hesaplama maliyetleri ve çevresel etkilerle tartmayı sürdürmeliyiz.
Eğitim protokolleri
Örneğin, interpolasyon eşiğinden sonra dropout kullanmak, ikinci düşüş aşamasında öğrenmeyi dengeli hale getirebilir. Daha uzun eğitim takvimleri, döngüsel öğrenme oranları deneyebilir veya düzenlemeyi interpolasyon zirvesinden sonraya erteleyebilirsiniz. Bu, ikinci düşüş aşamasında öğrenmeyi daha stabil hale getirebilir.
Veri yönetimi
Çift düşüş, veri toplama planlamasına da yardımcı olur. O çirkin interpolasyon zirvesine ulaştığınızda (eğitim doğruluğu mükemmel olmasına rağmen hatanın sıçradığı yer), refleks olarak modele daha fazla ham veri yüklemek isteyebilirsiniz. Yapmayın. Çünkü örnek sayısına bağlı çift düşüş, daha fazla verinin başlangıçta gürültü duyarlılığını artırabileceği anlamına gelir.
Bunun yerine, modele daha fazla veri vermek yerine aktif öğrenme, veri çoğaltma ve tabakalı örnekleme gibi yöntemleri düşünün. Bunlar, modelin interpolasyon zirvesini daha kolay aşmasına yardımcı olabilir. Verinin etkisini DataCamp’in Veri Kalitesi Boyutları Cheat Sheet’i ile izleyin.
Azaltma ve tanılama
Interpolasyon eşiği civarındaki aşırı uyumu azaltmaya yardımcı olmak için dropout, batch norm ve ağırlık bozunumu (weight decay) gibi araçları düşünün. Bunlar, tehlike bölgesinde olup olmadığınızı veya ikinci düşüşün tatlı noktasına yaklaşıp yaklaşmadığınızı anlamanıza yardımcı olabilir. Özellikle dengesiz veya gürültülü veri kümeleriyle çalışırken, bu teknikleri birçok modelleme projemde bizzat kullandım.
Çözülmemiş Sorular ve Gelecek Araştırma Yönleri
Artan çalışmalarına rağmen, çift düşüş cevapladığından daha fazla soru gündeme getiriyor. Çift düşüş üzerine daha fazla araştırma yapılsa da, yanıt bekleyen bazı sorular ve bu heyecan verici alanın gittiği yön hâlâ mevcut.
Kuramsal boşluklar
Çift düşüşün tam olarak ne zaman ortaya çıkacağını matematiksel veya istatistiksel olarak öngörmek mümkün mü? Veri kümesinin hangi özellikleri, mimari türü veya optimize edici seçimi test hatası eğrisinin şeklini belirler? Gelecekte araştırmanın daha çok çalışabileceği sorular bunlar.
Mimari ve optimizasyon
İkinci düşüşten daha iyi yararlanacak şekilde sinir ağları veya eğitim takvimleri tasarlayabilir miyiz? Aşırı parametrelemeye stratejik bir tasarım katmanı olarak mı bakmalıyız? Bu, sinir tanjant çekirdekleri, ön eğitim dinamikleri ve mimari arama için iyi bir başlangıçtır.
Felsefi değişimler
Çift düşüş, öğrenmenin temellerini yeniden düşünmemizi sağlar. Karmaşıklık ile genellemenin her zaman birbirine karşı çalışmadığını ve aşırı uyumun en kötü olasılık olmayabileceğini öne sürer. Bu, birçok klasik uygulayıcının düşünce biçiminde büyük bir değişimdir ve öğrenmeye dair kuramlarımızın hâlâ evrildiğini gösterir.
Sonuç
Çift düşüş, makine öğreniminde yalnızca yeni bir kıvrım değil; genelleme hakkında düşünme biçimimize yeni bir yaklaşımdır. Karmaşık modellerden kaçınmak veya onları terk etmek yerine, onları stratejik olarak kullanmamız gerekebilir. Bu da optimizasyona güvenmeyi, verinizi tanımayı ve genellikle yapılmayan yeni şeylere açık olmayı gerektirir.
Modeliniz bir sonraki kez aşırı uyum göstermeye başladığında hemen paniğe kapılmayın. Belki de ikinci düşüşle tanışmak üzeresiniz.
Artık çift düşüşü anladığınıza göre, bu öğrenimi pekiştirmek için aşağıda verilen bazı kaynak ve bağlantılara da göz atabilirsiniz.