
{count, plural, one {Programma} other {Programmi}}
Fondamenti di apprendimento automatico in Python
{hours} ore
La regola tradizionale della modellazione statistica dice che se il modello si complica, l'errore di training diminuisce, ma l'errore sul test aumenta a causa dell'overfitting. Mantienilo semplice, e rischi l'underfitting. È il classico compromesso bias-varianza che ci insegnano da decenni.
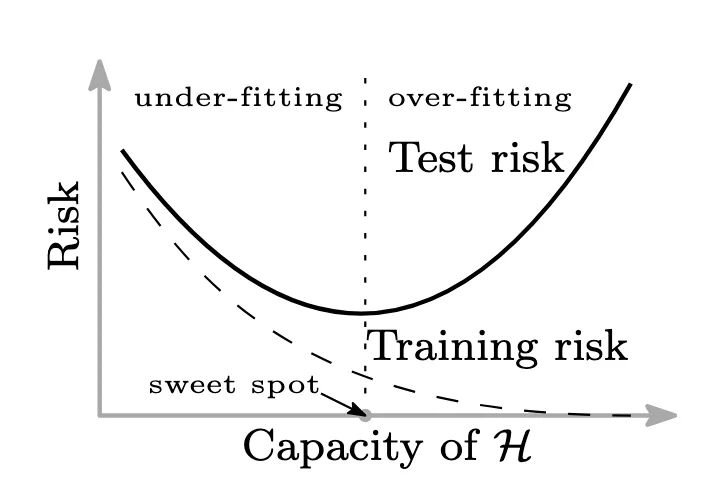
Il classico compromesso bias-varianza. Fonte: adattato dalla Figura 1(a) in Belkin et al., 2019
Ma il machine learning moderno, soprattutto il deep learning, mette in discussione questa elegante idea. Se negli ultimi anni hai lavorato nel deep learning, potresti aver notato qualcosa di strano: modelli con milioni di parametri generalizzano comunque sorprendentemente bene.
Secondo la saggezza convenzionale non dovrebbe succedere. O forse sì?
Entra in gioco il double descent: un fenomeno strano ma affascinante in cui aumentare la complessità del modello di nuovo migliora le prestazioni dopo un improvviso aumento dell'errore sul test.
Non è solo un concetto accademico bizzarro, mi ha davvero aiutato a dare un senso a tendenze controintuitive che ho osservato in progetti di machine learning reali. Avendo passato anni a guidare iniziative di forecasting, churn prediction e NLP per sistemi su larga scala, ho visto in prima persona come questo fenomeno sfidi la saggezza tradizionale e trasformi il nostro approccio alla complessità dei modelli.
In questo articolo parleremo di cos'è il double descent, delle sue fasi, di quando e perché si verifica e, soprattutto, di cosa farci.
Il double descent può sembrare un'idea nuova, ma molti non sanno che è un concetto antico, riportato in primo piano dal deep learning.
L'idea che aumentare la complessità del modello possa portare a una migliore generalizzazione dopo l'overfitting non è del tutto nuova. In effetti, la statistica classica accennava a questo strano comportamento decenni fa. Per esempio, adattando polinomi di alto grado ai dati nella regressione lineare, si può vedere lo schema dell'overfitting seguito da una migliore generalizzazione. Ma spesso si diceva che questi pattern fossero solo artefatti di overfitting o instabilità numerica, non un vero comportamento.
Il punto di svolta è arrivato con il successo delle reti neurali profonde, in cui i modelli avevano spesso milioni o addirittura miliardi di parametri, molti più degli esempi di training.
La saggezza classica suggerisce che i modelli complessi dovrebbero fare un forte overfit ai dati di training. Eppure, sorprendentemente, non è così. Anzi, questi modelli spesso generalizzano meglio di quelli più piccoli.
Questa scoperta inattesa ha spinto ricercatori come Belkin et al. (2019) a esplorare teorie più vecchie. La loro affascinante scoperta ha rivelato che, una volta che un modello diventa abbastanza complesso da adattarsi perfettamente ai dati di training, l'errore sul test in realtà ricomincia a migliorare man mano che il modello cresce. Il deep learning non ha solo svelato questo fenomeno noto come "double descent"—lo ha trasformato in un concetto fondamentale della nostra comprensione della generalizzazione oggi.
Il double descent si riferisce all'osservazione che la curva dell'errore sul test non è sempre a U rispetto alla complessità del modello. Dopo la discesa iniziale (man mano che il bias diminuisce), l'errore sul test aumenta (a causa dell'overfitting), ma poi, inaspettatamente, ricomincia a diminuire. Questo forma la caratteristica forma a "doppia discesa".
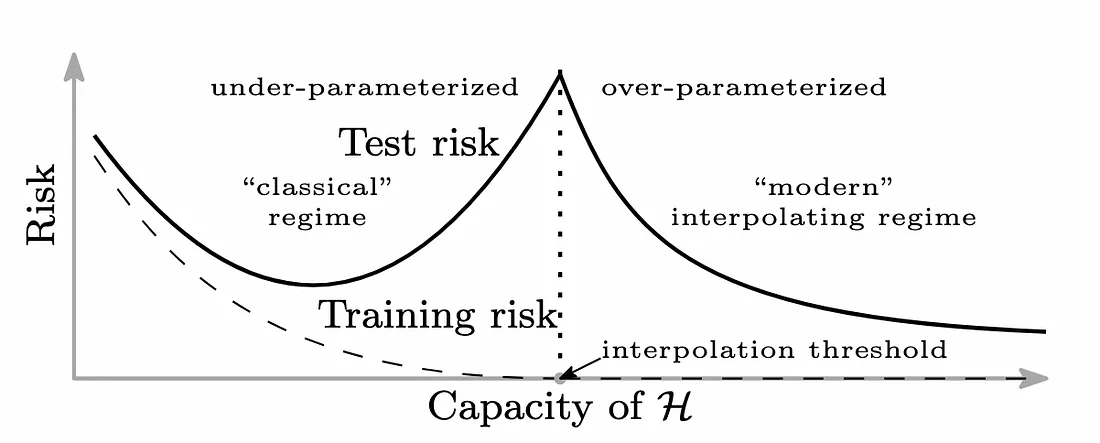
La curva di rischio del double descent. Fonte: adattato dalla Figura 1(b) in Belkin et al., 2019
Nella mia pratica, soprattutto distribuendo sistemi di classificazione del testo basati su deep learning ed eseguendo forecasting di serie temporali per aziende della supply chain, ho osservato questo secondo minimo dell'errore sul test. Non era teorico; era visibile nelle nostre curve di validazione.
Aiuta a spiegare perché modelli grandi come le ResNet e, in generale, architetture massicciamente sovraparametrizzate, possano comunque generalizzare bene. Sebbene le scaling law per modelli come GPT suggeriscano miglioramenti più regolari piuttosto che una visibile curva a doppia discesa, il principio di fondo—che più grande non è sempre peggio—rimane valido.
Ci sono tre fasi principali del double descent, discusse di seguito.
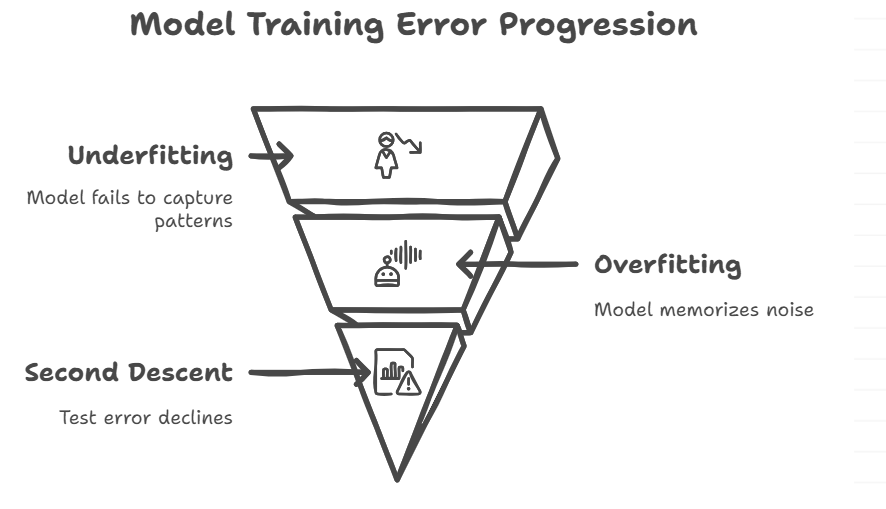
Fasi del Double Descent. Fonte immagine: Napkin AI
Dalla mia esperienza: parti semplice, ma non temere la complessità.
Suggerimento pratico: se la loss di validazione ha un picco a metà training, metti in pausa—ma non terminare.
Intuizione chiave: i modelli grandi non sono intrinsecamente caotici—sono implicitamente regolarizzati.
Una spiegazione diffusa è che ottimizzatori come SGD preferiscono intrinsecamente i minimi piatti, quelli con bassa curvatura, che tendono a generalizzare meglio. Anche in modelli massicciamente sovraparametrizzati, queste regioni più piatte diventano più facili da trovare man mano che il paesaggio di ottimizzazione cambia.
Uno degli aspetti più affascinanti del double descent è che non compare solo quando si scala la dimensione del modello. Appare anche lungo le epoche e la dimensione dei dati di training—qualcosa che ho notato eseguendo esperimenti con durate di training e split dei dati variabili.
Questa è la forma più studiata. Quando aggiungiamo più parametri, passiamo dall'underfitting all'interpolazione e poi alla sovraparametrizzazione. Aggiungere parametri oltre la soglia di interpolazione può in realtà aiutare, secondo il double descent. Questa idea, contro il senso comune, è stata osservata nelle reti neurali profonde e nella regressione polinomiale.
Il double descent model-wise ci permette di non temere i modelli grandi, purché siano addestrati correttamente. È anche un promemoria che ridurre i modelli troppo presto può significare sacrificare prestazioni senza motivo.
Un altro tipo di discesa si verifica quando alleni più a lungo. All'inizio, più training migliora le prestazioni. Poi l'errore sul test sale (overfitting). Ma può ridursi di nuovo con ulteriore addestramento. Questo accade spesso quando usi metodi come il decadimento del learning rate o la media dei pesi, che facilitano la ricerca di minimi più piatti nelle fasi successive del training.
Quindi, in alcuni casi, proseguire l'addestramento oltre il punto di overfitting può portare a una migliore generalizzazione. Tuttavia, questo è fortemente dipendente dal contesto e dovrebbe essere guidato da un'attenta validazione—prolungare ciecamente il training può peggiorare l'overfitting in molti casi pratici.
L'aspetto più sorprendente è che il double descent può verificarsi anche con la quantità di dati di training. All'inizio, aggiungere più dati migliora le cose. Ma ci sono momenti, soprattutto quando c'è molto rumore nei dati, in cui il modello può andare in difficoltà, facendo aumentare l'errore sul test. Col tempo, la generalizzazione migliora di nuovo man mano che si aggiungono dati più utili. Questo tipo di double descent ci mostra che più dati non sono sempre subito meglio, ma di solito ripagano alla fine.
Per capire perché avviene il double descent, dobbiamo approfondire concetti come dinamiche dell'ottimizzazione, geometria e teoria dell'apprendimento.
Possiamo osservare la curvatura della superficie di loss usando la decomposizione ai valori singolari (SVD). Attorno alla soglia di interpolazione, i modelli sono molto sensibili alle direzioni di input con piccoli valori singolari, cioè direzioni con basso rapporto segnale-rumore. Questo fa impennare l'errore sul test, sostanzialmente le "direzioni deboli" in cui il rumore può avere un grande effetto sull'overfitting.
Una delle idee più accettate è che lo stochastic gradient descent (SGD) renda implicitamente la soluzione più stabile. SGD preferisce configurazioni di pesi a norma bassa o bassa curvatura, tra più configurazioni, per minimizzare la loss. Sono soluzioni più semplici in uno spazio ad alta dimensionalità. Questi minimi piatti sono meno sensibili ai cambiamenti e sono spesso associati a una migliore generalizzazione, soprattutto nella seconda discesa.
Il rumore è insidioso. Alla soglia di interpolazione, anche un po' di rumore nelle etichette può essere appreso dal modello, creando grandi gap di generalizzazione. Ma se l'ottimizzatore lavora bene e hai un numero significativo di parametri, il modello riesce a separare segnale e rumore. Questo rafforza l'idea che la sovraparametrizzazione non sia un problema se l'ottimizzazione è fatta correttamente.
La Lottery Ticket Hypothesis sostiene che reti grandi contengono piccoli subnetworks addestrabili che funzionano bene; e modelli più grandi rendono più facile trovarli. La teoria dei minimi affilati vs. piatti afferma che la forma della superficie di loss influisce sulla generalizzazione più della dimensione del modello.
Insieme, queste prospettive offrono una comprensione più ricca del perché emerge il double descent.
Alcuni dei primi studi che hanno mostrato il double descent sono stati condotti da Belkin et al. (2019). Hanno provato la regressione polinomiale e modelli di reti neurali; e hanno riscontrato che l'errore sul test non solo aumenta e si appiattisce; può anche diminuire di nuovo. Questi benchmark hanno reso evidente un fenomeno che molti nella comunità del deep learning avevano notato in modo aneddotico.
Quando la profondità dei layer nelle ResNet aumenta su CIFAR-10 e ImageNet, si osserva la prestazione a doppia discesa. Anche con dati fissi, i transformer come GPT-2/3/4 migliorano nella generalizzazione man mano che cresce la dimensione del modello. Quando si aumentano filtri, layer o unità, le CNN addestrate su dataset di visione spesso seguono la curva del double descent.
Studiare il double descent non è solo un esercizio accademico, può aiutare le organizzazioni a fare scelte migliori in progetti ML reali.
Questo concetto ci dice che più grande non è sempre peggio. Anzi, aumentare la capacità del modello oltre il punto di overfitting potrebbe aiutarlo a generalizzare meglio, soprattutto se lo ottimizzi e regolarizzi correttamente. Detto ciò, dovremmo comunque valutare i benefici in termini di prestazioni rispetto ai costi computazionali e all'impatto ambientale.
Per esempio, usare il dropout dopo la soglia di interpolazione può stabilizzare l'apprendimento nella seconda fase di discesa. Puoi provare piani di training più lunghi, learning rate ciclici o persino ritardare la regolarizzazione fino a dopo il picco di interpolazione. Questo può rendere l'apprendimento più stabile durante la seconda discesa.
Il double descent aiuta anche a pianificare la raccolta dei dati. Quando raggiungi quel brutto picco di interpolazione (dove l'errore esplode nonostante l'accuratezza perfetta sul training), la reazione istintiva è riversare più dati grezzi nel modello. Non farlo. Perché il double descent rispetto ai campioni significa che più dati possono inizialmente amplificare la sensibilità al rumore prima di aiutare.
Meglio considerare metodi come active learning, data augmentation e campionamento stratificato invece di dare al modello più dati. Questi possono aiutare il modello a superare più agevolmente il picco di interpolazione. Monitora l'impatto dei dati con la cheat sheet sulle dimensioni della qualità dei dati di DataCamp.
Per ridurre l'overfitting vicino alla soglia di interpolazione, pensa a strumenti come dropout, batch norm e weight decay. Possono aiutarti a capire se sei nella zona di pericolo o se ti stai avvicinando al punto ideale della seconda discesa. Personalmente ho usato queste tecniche in diversi progetti di modellazione, soprattutto lavorando con dataset sbilanciati o rumorosi.
Nonostante il crescente numero di lavori, il double descent solleva più domande di quante ne risolva. Anche se la ricerca su questo tema è in espansione, restano questioni da chiarire e direzioni promettenti per questo campo entusiasmante.
È possibile prevedere matematicamente o statisticamente quando esattamente si verificherà il double descent? Quali caratteristiche del dataset, del tipo di architettura o della scelta dell'ottimizzatore determineranno la forma della curva dell'errore sul test? Sono domande su cui la ricerca può lavorare ancora molto.
Possiamo progettare reti neurali o programmi di training in modo da sfruttare meglio la seconda discesa? Dovremmo considerare la sovraparametrizzazione come un livello strategico di design? Questo si collega bene ai neural tangent kernel, alle dinamiche del pretraining e alla ricerca di architetture.
Il double descent ci porta a ripensare le basi dell'apprendimento. Suggerisce che complessità e generalizzazione non siano sempre in conflitto e che l'overfitting potrebbe non essere il peggiore dei mali. È un grande cambio di prospettiva per molti praticanti classici e mostra che le nostre teorie sull'apprendimento sono ancora in evoluzione.
Il double descent è più di una nuova curiosità nel machine learning; è un nuovo modo di pensare alla generalizzazione. Invece di evitare o abbandonare i modelli complessi, potremmo doverli usare in modo strategico. Questo significa fidarsi dell'ottimizzazione, conoscere i propri dati ed essere aperti a tentativi non convenzionali.
Non farti prendere dal panico la prossima volta che il tuo modello inizia a fare overfit. Potresti essere sul punto di incontrare la seconda discesa.
Ora che hai capito il double descent, puoi anche consultare alcune delle risorse e dei link qui sotto per approfondire.
I migliori corsi DataCamp
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



