
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
De klassieke regel van statistische modellering stelt dat wanneer het model complexer wordt, de trainingsfout daalt, maar de testfout stijgt door overfitting. Houd het simpel en je loopt kans op underfitting. Dat is de klassieke bias-variance-afweging die we al decennia leren.
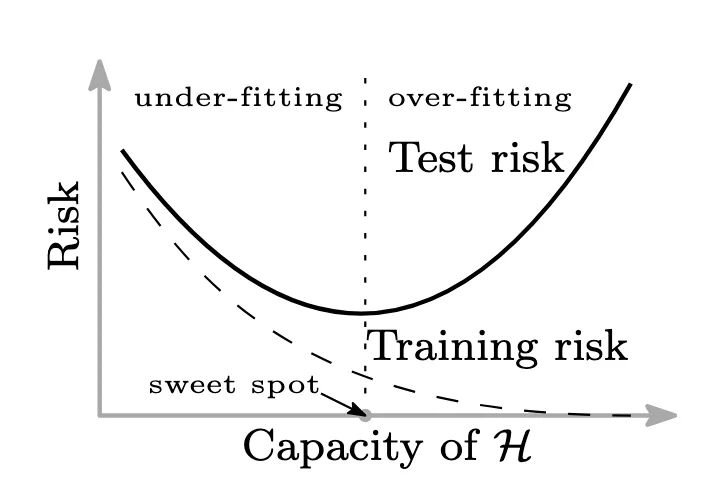
De klassieke bias-variance-afweging. Bron: Aangepast van Figuur 1(a) in Belkin et al., 2019
Maar moderne machine learning, vooral deep learning, daagt dit elegante idee uit. Als je de afgelopen jaren met deep learning hebt gewerkt, is je misschien iets opgevallen: modellen met miljoenen parameters generaliseren nog steeds verrassend goed.
Volgens de gangbare wijsheid zou dat niet moeten gebeuren. Of toch wel?
Maak kennis met double descent: een vreemd maar fascinerend fenomeen waarbij het vergroten van de modelcomplexiteit opnieuw de prestaties verbetert na een plotselinge toename van de testfout.
Dit is niet zomaar een academische curiositeit, het heeft me echt geholpen om contra-intuïtieve trends te begrijpen die ik in ML-projecten in de praktijk zag. Als iemand die jarenlang forecasting-, churn-predictie- en NLP-initiatieven voor grootschalige systemen heeft geleid, heb ik van dichtbij gezien hoe dit fenomeen de traditionele wijsheid uitdaagt en onze aanpak van modelcomplexiteit verandert.
In dit artikel bespreken we wat double descent is, de fasen, wanneer en waarom het gebeurt en vooral: wat je ermee kunt doen.
Double descent lijkt misschien een nieuw idee, maar de meesten weten niet dat het een oud concept is dat door deep learning weer scherper in beeld kwam.
Het idee dat toenemende modelcomplexiteit kan leiden tot betere generalisatie na overfitting is niet helemaal nieuw. Klassieke statistiek hintte decennia geleden al op dit vreemde gedrag. Bijv. bij het fitten van hoogdimensionale polynomen in lineaire regressie zie je een patroon van overfitting gevolgd door betere generalisatie. Vaak werd echter gezegd dat dit slechts artefacten waren van overfitting of numerieke instabiliteit, geen echt gedrag.
Het kantelpunt kwam met het succes van diepe neurale netwerken, waarbij modellen vaak miljoenen of zelfs miljarden parameters hadden, aanzienlijk meer dan het aantal trainingsvoorbeelden.
Volgens de klassieke wijsheid zouden complexe modellen de trainingsdata sterk moeten overfitten. Verrassend genoeg is dat vaak niet zo. Sterker nog, deze modellen generaliseren vaak beter dan kleinere.
Deze onverwachte bevinding leidde onderzoekers zoals Belkin et al. (2019) ertoe om oudere theorieën opnieuw te verkennen. Hun fascinerende ontdekking liet zien dat zodra een model complex genoeg wordt om de trainingsdata perfect te passen, de testfout juist weer begint te dalen naarmate het model groter wordt. Deep learning heeft dit fenomeen, bekend als ‘double descent’, niet alleen blootgelegd—het heeft het veranderd in een fundamenteel concept in ons huidige begrip van generalisatie.
Double descent verwijst naar de observatie dat de testfout-curve niet altijd U-vormig is ten opzichte van modelcomplexiteit. Na de eerste daling (als bias afneemt) stijgt de testfout (door overfitting), maar begint vervolgens onverwacht weer te dalen. Zo ontstaat de “double descent”-vorm.
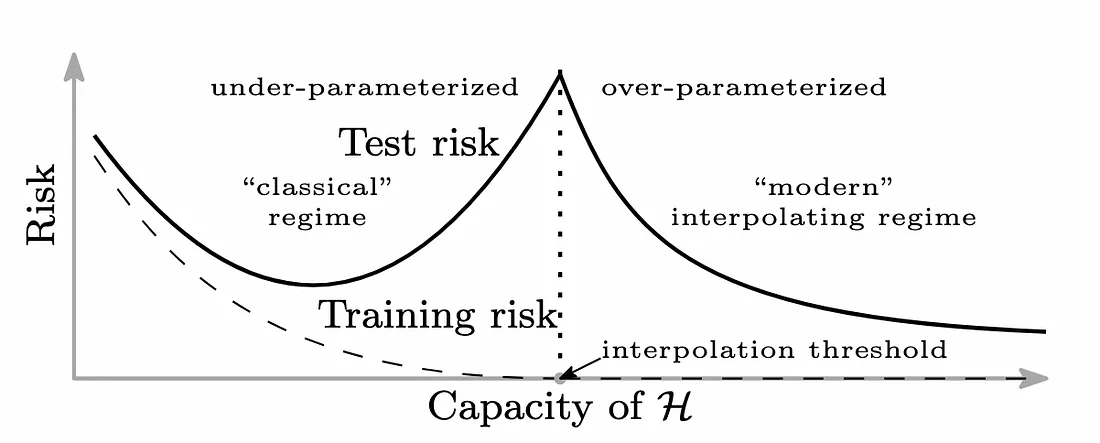
De double descent-risicocurve. Bron: Aangepast van Figuur 1(b) in Belkin et al., 2019
In mijn eigen praktijk, vooral bij het uitrollen van deep-learninggebaseerde tekstclassificatiesystemen en het uitvoeren van tijdreeksforecasting voor supplychainbedrijven, zag ik die tweede dip in testfout. Het was niet theoretisch; het was zichtbaar in onze validatiecurves.
Het helpt te verklaren waarom grote modellen zoals ResNets, en in het algemeen sterk overgeparametriseerde architecturen, toch goed kunnen generaliseren. Hoewel schaalwetten voor modellen zoals GPT soepelere verbeteringen suggereren in plaats van een duidelijke double-descent-curve, blijft het onderliggende principe—dat groter niet per se slechter is—relevant.
Er zijn drie hoofdfasen van double descent, hieronder besproken.
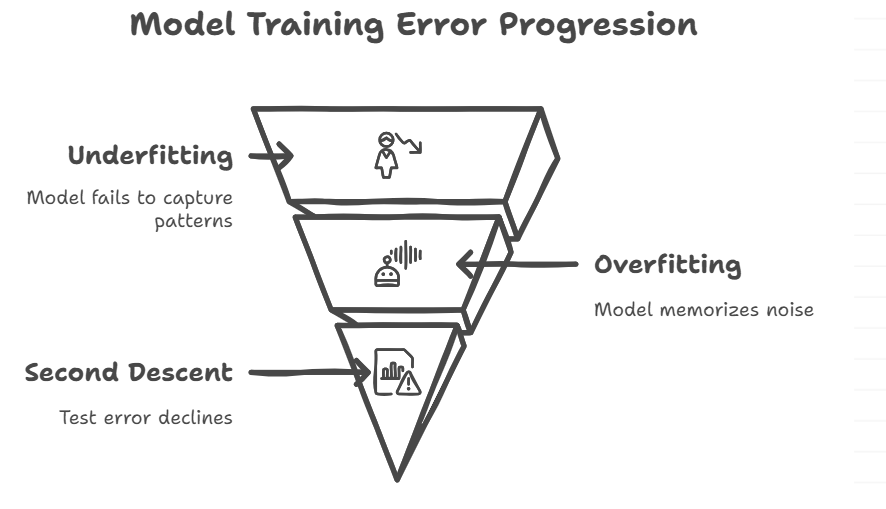
Fasen van double descent. Bron van de afbeelding: Napkin AI
Uit mijn ervaring: Begin simpel, maar wees niet bang voor complexiteit.
Praktische tip: Als je validatieverlies halverwege de training piekt, pauzeer—maar stop niet definitief.
Belangrijk inzicht: Grote modellen zijn niet van nature chaotisch—ze worden impliciet geregulariseerd.
Een leidende verklaring is dat optimalisatoren zoals SGD van nature de voorkeur geven aan vlakkere minima, met lagere kromming, die beter generaliseren. Zelfs in sterk overgeparametriseerde modellen worden deze vlakkere regio’s makkelijker te vinden naarmate het optimalisatielandschap verandert.
Een van de meest fascinerende aspecten van double descent is dat het niet alleen optreedt bij het opschalen van modelgrootte. Het verschijnt ook over epochs en trainingsdatasets—iets wat ik merkte bij experimenten met variërende trainingslengtes en datasplits.
Dit is de meest bestudeerde vorm. Als we meer parameters toevoegen, gaan we van underfitting naar interpolatie en dan naar overparameterisatie. Nog meer parameters toevoegen voorbij de interpolatiedrempel kan juist helpen, volgens double descent. Dit idee, dat indruist tegen het gezonde verstand, is gezien in diepe neurale netwerken en polynomiale regressie.
Model-gebaseerde double descent zorgt ervoor dat we niet bang hoeven te zijn voor grote modellen zolang ze goed getraind worden. Het herinnert er ook aan dat te vroeg terugschakelen naar kleinere modellen kan betekenen dat je onnodig prestaties inlevert.
Een andere vorm treedt op wanneer je langer traint. Aanvankelijk verbetert meer training de prestaties. Dan loopt de testfout op (overfitting). Maar met doorgaan kan die weer dalen. Dit gebeurt vaak wanneer je methoden gebruikt zoals learning rate decay of gewichts-averaging, die het zoeken naar vlakkere minima later in de training bevorderen.
Dus kan in sommige gevallen doorgaan met trainen voorbij het overfittingpunt leiden tot betere generalisatie. Dit is echter sterk contextafhankelijk en moet worden gestuurd door zorgvuldige validatie—blind langer trainen kan in veel praktische gevallen overfitting verergeren.
Het meest verrassend is dat double descent ook kan optreden met de hoeveelheid trainingsdata. In het begin maakt meer data dingen beter. Maar soms, vooral wanneer er veel ruis in de data zit, kan het model moeite krijgen, waardoor de testfout oploopt. Uiteindelijk verbetert de generalisatie weer naarmate er meer bruikbare data wordt toegevoegd. Dit soort double descent laat zien dat meer data niet altijd meteen beter is, maar het zich meestal uiteindelijk uitbetaalt.
Om te begrijpen waarom double descent optreedt, moeten we ingaan op concepten als optimalisatiedynamiek, geometrie en leertheorie.
We kunnen de kromming van het verliesoppervlak bekijken met singular value decomposition (SVD). Rond de interpolatiedrempel zijn modellen zeer gevoelig voor invoerrichtingen met kleine singuliere waarden, richtingen met lage signaal-ruisverhouding. Dit jaagt de testfout omhoog—dat zijn in feite de "zwakke richtingen" waar ruis sterk kan bijdragen aan overfitting.
Een van de breedst geaccepteerde ideeën is dat stochastic gradient descent (SGD) de oplossing impliciet stabieler maakt. SGD verkiest, uit meerdere configuraties, gewichtsinstellingen met lage norm of lage kromming om het verlies te minimaliseren. Dit zijn eenvoudigere oplossingen in een hoog-dimensionale ruimte. Deze vlakke minima zijn minder gevoelig voor veranderingen en worden vaak in verband gebracht met betere generalisatie, vooral in de tweede descent.
Ruis is verraderlijk. Bij de interpolatiedrempel kan zelfs een beetje labelruis door het model worden gefit, wat kan leiden tot grote generalisatiekloven. Maar als de optimizer zijn werk goed doet en je veel parameters hebt, kan het model het signaal van de ruis scheiden. Dit ondersteunt het idee dat overparameterisatie geen probleem is als de optimalisatie goed gebeurt.
De Lottery Ticket Hypothesis stelt dat grote netwerken kleine, trainbare subnetwerken bevatten die goed werken; en dat grotere modellen het makkelijker maken om die te vinden. De theorie over scherpe vs. vlakke minima stelt dat de vorm van het verliesoppervlak meer invloed heeft op generalisatie dan de modelgrootte.
Samen geven deze perspectieven een rijker begrip van waarom double descent ontstaat.
Enkele van de vroegste studies die double descent aantoonden, zijn uitgevoerd door Belkin et al. (2019). Ze testten polynomiale regressie en neurale-netwerkmodellen en ontdekten dat de testfout niet alleen oploopt en afvlakt; hij kan ook weer dalen. Deze benchmarks maakten een fenomeen tastbaar dat veel mensen in de deep-learninggemeenschap anekdotisch al hadden opgemerkt.
Wanneer de diepte van de lagen in ResNets op CIFAR-10 en ImageNet toeneemt, treedt het double-descentgedrag op. Zelfs met vaste data gaan transformers zoals GPT-2/3/4 beter generaliseren naarmate de modelgrootte groeit. Wanneer filters, lagen of units groter worden, volgen CNN’s die op visiedatasets zijn getraind vaak de double-descent-curve.
Leren over double descent is niet alleen academisch; het kan organisaties helpen betere keuzes te maken in ML-projecten in de praktijk.
Dit concept leert ons dat groter niet altijd slechter is. Sterker nog, het vergroten van de modelcapaciteit voorbij het punt van overfitting kan de generalisatie verbeteren, vooral als je correct optimaliseert en regulariseert. Dat gezegd hebbende, moeten we de baten van betere prestaties nog steeds afwegen tegen rekenkosten en milieu-impact.
Zo kan het gebruiken van dropout na de interpolatiedrempel het leren stabiliseren in de tweede descent-fase. Je kunt langere trainingsschema’s proberen, cyclische learning rates, of zelfs regularisatie uitstellen tot na de interpolatiepiek. Dit kan het leren stabieler maken tijdens de tweede descent-fase.
Double descent helpt ook bij het plannen van dataverzameling. Wanneer je die lelijke interpolatiepiek raakt (waar de fout piekt ondanks perfecte trainingsnauwkeurigheid), is de reflex om meer ruwe data in het model te gooien. Niet doen. Want steekproef-gebaseerde double descent betekent dat meer data aanvankelijk de gevoeligheid voor ruis kan vergroten voordat het helpt.
Overweeg in plaats daarvan methoden zoals active learning, data-augmentatie en gestratificeerde sampling in plaats van het model simpelweg meer data te geven. Deze kunnen het model helpen gemakkelijker door de interpolatiepiek heen te komen. Monitor de impact van data met DataCamp’s Data Quality Dimensions Cheat Sheet.
Om overfitting rond de interpolatiedrempel te beperken, denk aan tools zoals dropout, batchnorm en weight decay. Deze kunnen helpen bepalen of je in de gevarenzone zit of dicht bij de sweet spot van de tweede descent. Ik heb deze technieken zelf in meerdere modelleringsprojecten gebruikt, vooral bij onevenwichtige of rumoerige datasets.
Ondanks de groeiende hoeveelheid werk roept double descent meer vragen op dan het beantwoordt. Hoewel er steeds meer onderzoek naar wordt gedaan, blijven er vragen bestaan en wordt duidelijk welke richting dit spannende veld uitgaat.
Is het mogelijk om wiskundig of statistisch te voorspellen wanneer double descent precies zal optreden? Welke kenmerken van de dataset, het type architectuur of de keuze van de optimizer bepalen de vorm van de testfout-curve? Dit zijn vragen waar toekomstig onderzoek meer kan bijdragen.
Kunnen we neurale netwerken of trainingsschema’s ontwerpen die beter gebruikmaken van de tweede descent? Moeten we overparameterisatie zien als een strategische ontwerplaag? Dit sluit aan bij werk rond neural tangent kernels, pretrainingdynamiek en architectuurzoektocht.
Double descent dwingt ons om opnieuw na te denken over de fundamenten van leren. Het suggereert dat complexiteit en generalisatie niet altijd tegengesteld zijn en dat overfitting misschien niet het ergste is wat kan gebeuren. Dat is een grote omslag voor veel klassieke beoefenaars en laat zien dat onze leertheorieën nog steeds evolueren.
Double descent is meer dan alleen een nieuwe wending in machine learning; het is een nieuwe manier van denken over generalisatie. In plaats van complexe modellen te vermijden of op te geven, moeten we ze mogelijk strategisch inzetten. Dat betekent vertrouwen hebben in optimalisatie, je data kennen en openstaan voor onconventionele aanpakken.
Raak de volgende keer niet meteen in paniek als je model begint te overfitten. Misschien sta je op het punt de tweede descent te ontmoeten.
Nu je double descent begrijpt, kun je ook de onderstaande resources en links bekijken om hierop voort te bouwen.
Topcursussen op DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


