
Track
मशीन लर्निंग फंडामेंटल्स में Python
16 घंटा
पारंपरिक सांख्यिकीय मॉडलिंग का नियम कहता है कि जैसे-जैसे मॉडल जटिल होता जाता है, ट्रेनिंग त्रुटि घटती है, लेकिन ओवरफिटिंग की वजह से टेस्ट त्रुटि बढ़ती है। इसे सरल रखें, तो अंडरफिटिंग हो सकती है। यही वह क्लासिक बायस-वैरिएंस ट्रेड-ऑफ है जो हमें दशकों से सिखाया गया है।
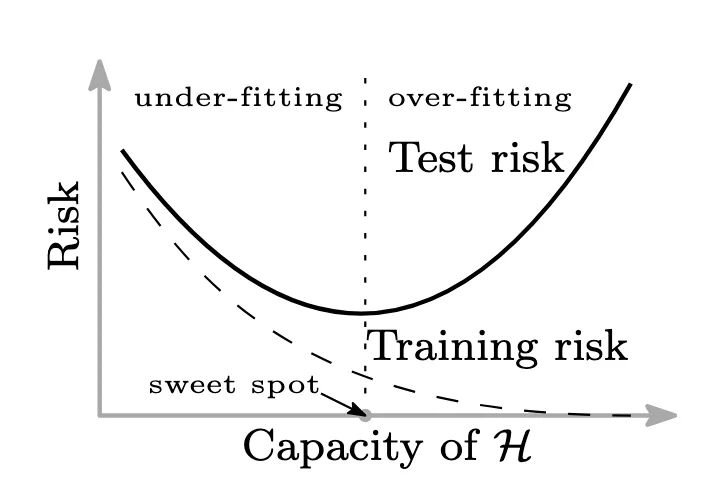
क्लासिकल बायस-वैरिएंस ट्रेड-ऑफ। स्रोत: Belkin et al., 2019 के चित्र 1(a) से अनुकूलित
लेकिन आधुनिक मशीन लर्निंग, खासकर डीप लर्निंग, इस सुंदर धारणा को चुनौती देती है। यदि आप पिछले कुछ वर्षों में डीप लर्निंग पर काम कर रहे हैं, तो आपने कुछ अजीब बात नोटिस की होगी: लाखों पैरामीटर वाले मॉडल भी चौंकाने वाली तरह से अच्छी जनरलाइज़ेशन दिखाते हैं।
पारंपरिक समझ के अनुसार ऐसा नहीं होना चाहिए। या होना चाहिए?
यहीं आता है डबल डिसेंट: एक अजीब लेकिन रोचक घटना, जिसमें मॉडल की जटिलता बढ़ाने पर फिर से प्रदर्शन बेहतर होता है, टेस्ट त्रुटि में अचानक उछाल के बाद।
यह सिर्फ एक अकादमिक विचित्रता नहीं है, इसने वास्तव में मुझे उन प्रतिअंतर्ज्ञान प्रवृत्तियों को समझने में मदद की है जो मैंने वास्तविक दुनिया की मशीन लर्निंग परियोजनाओं में देखी हैं। बड़े पैमाने की प्रणालियों के लिए फोरकास्टिंग, चर्न प्रेडिक्शन और NLP पहलों का वर्षों तक नेतृत्व करने के नाते, मैंने प्रत्यक्ष रूप से देखा है कि यह घटना पारंपरिक समझ को कैसे चुनौती देती है और मॉडल जटिलता के प्रति हमारे दृष्टिकोण को कैसे बदलती है।
इस लेख में, हम देखेंगे कि डबल डिसेंट क्या है, इसके चरण क्या हैं, यह कब और क्यों होता है, और सबसे महत्वपूर्ण, इसके बारे में क्या करना चाहिए।
डबल डिसेंट भले ही नया लगे, लेकिन ज्यादातर लोग नहीं जानते कि यह एक पुराना विचार है, जिसे डीप लर्निंग ने फिर से स्पष्ट फोकस में ला दिया।
यह विचार कि ओवरफिटिंग के बाद मॉडल की जटिलता बढ़ाने से बेहतर जनरलाइज़ेशन हो सकता है, बिल्कुल नया नहीं है। दरअसल, क्लासिकल सांख्यिकी ने दशकों पहले इस अजीब व्यवहार की ओर संकेत किया था। उदाहरण के लिए, लीनियर रिग्रेशन में डेटा पर उच्च-डिग्री बहुपद फिट करते समय, आप ओवरफिटिंग के बाद बेहतर जनरलाइज़ेशन का पैटर्न देख सकते हैं। लेकिन अक्सर कहा गया कि ये पैटर्न ओवरफिटिंग या संख्यात्मक अस्थिरता की कलाकृतियाँ हैं, वास्तविक व्यवहार नहीं।
टर्निंग पॉइंट डीप न्यूरल नेटवर्क्स की सफलता के साथ आया, जहाँ मॉडलों में अक्सर लाखों या अरबों पैरामीटर होते थे—जो ट्रेनिंग उदाहरणों की संख्या से कहीं ज्यादा थे।
क्लासिकल समझ कहती है कि जटिल मॉडल ट्रेनिंग डेटा पर काफी ओवरफिट करेंगे। लेकिन चौंकाने वाली बात यह है कि ऐसा हमेशा नहीं होता। वास्तव में, ये मॉडल अक्सर छोटे मॉडलों की तुलना में बेहतर जनरलाइज़ करते हैं।
इस अप्रत्याशित खोज ने Belkin et al. (2019) जैसे शोधकर्ताओं को पुराने सिद्धांतों की पड़ताल करने के लिए प्रेरित किया। उनके दिलचस्प निष्कर्षों से पता चला कि जैसे ही कोई मॉडल इतना जटिल हो जाता है कि वह ट्रेनिंग डेटा को पूरी तरह फिट कर सके, मॉडल के आकार में और वृद्धि के साथ टेस्ट त्रुटि वास्तव में फिर से घटने लगती है। डीप लर्निंग ने केवल 'डबल डिसेंट' नामक इस घटना को उजागर ही नहीं किया—इसे आज हमारी जनरलाइज़ेशन की समझ का एक बुनियादी सिद्धांत बना दिया।
डबल डिसेंट उस अवलोकन को संदर्भित करता है कि टेस्ट त्रुटि वक्र हमेशा मॉडल जटिलता के संबंध में U-आकार का नहीं होता। प्रारंभिक अवरोह (जब बायस घटता है) के बाद टेस्ट त्रुटि बढ़ती है (ओवरफिटिंग के कारण), लेकिन फिर, अप्रत्याशित रूप से, यह फिर घटने लगती है। यही “डबल डिसेंट” का आकार बनाता है।
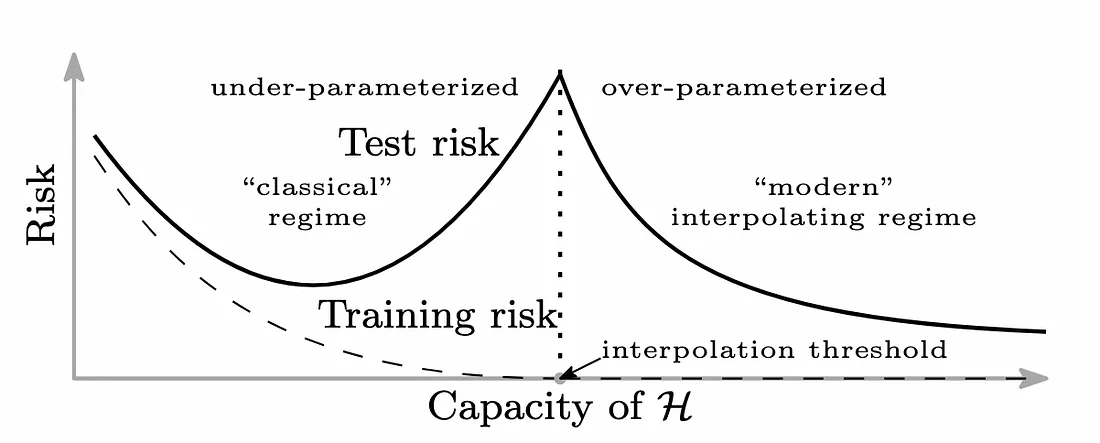
डबल डिसेंट जोखिम वक्र। स्रोत: Belkin et al., 2019 के चित्र 1(b) से अनुकूलित
अपने अभ्यास में, खासकर डीप लर्निंग-आधारित टेक्स्ट वर्गीकरण प्रणालियाँ तैनात करते समय और सप्लाई चेन कंपनियों के लिए टाइम सीरीज़ फोरकास्टिंग करते समय, मैंने टेस्ट त्रुटि में यह दूसरी गिरावट देखी है। यह सैद्धांतिक नहीं था; यह हमारे वैलिडेशन कर्व्स में दिखाई दे रहा था।
यह समझाने में मदद करता है कि ResNets जैसे बड़े मॉडल, और सामान्य तौर पर, अत्यधिक ओवरपैरामीटराइज्ड आर्किटेक्चर, फिर भी अच्छे से जनरलाइज़ कैसे कर सकते हैं। GPT जैसे मॉडलों के लिए स्केलिंग लॉज़ भले ही एक दिखाई देने वाले डबल डिसेंट कर्व के बजाय अधिक स्मूद सुधार का संकेत दें, लेकिन आधारभूत सिद्धांत—कि बड़ा होना हमेशा बुरा नहीं होता—प्रासंगिक बना रहता है।
नीचे चर्चा किए गए डबल डिसेंट के तीन मुख्य चरण हैं।
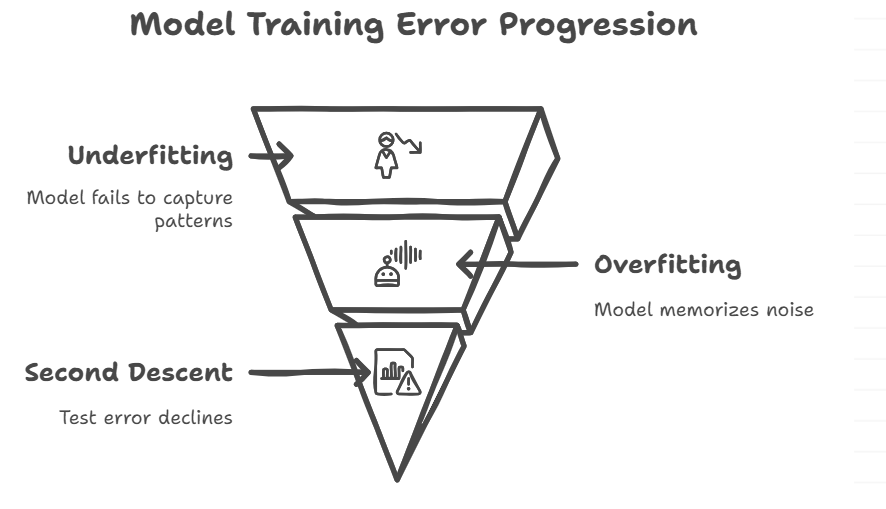
डबल डिसेंट के चरण। छवि का स्रोत: Napkin AI
मेरे अनुभव में: सरल से शुरू करें, लेकिन जटिलता से डरें नहीं।
व्यावहारिक सुझाव: यदि आपके वैलिडेशन लॉस में ट्रेनिंग के बीच में उछाल आए, तो रुकेँ—पर तुरंत समाप्त न करें।
मुख्य अंतर्दृष्टि: बड़े मॉडल स्वभावतः अराजक नहीं होते—वे निहित रूप से नियमितीकृत होते हैं।
एक प्रमुख व्याख्या यह है कि SGD जैसे ऑप्टिमाइज़र स्वाभाविक रूप से फ्लैटर मिनिमा को प्राथमिकता देते हैं—कम वक्रता वाले वे क्षेत्र—जो बेहतर जनरलाइज़ करते हैं। यहाँ तक कि अत्यधिक ओवरपैरामीटराइज्ड मॉडलों में भी, जैसे-जैसे ऑप्टिमाइज़ेशन लैंडस्केप बदलता है, ये फ्लैट क्षेत्र ढूँढ़ना आसान होता जाता है।
डबल डिसेंट का सबसे रोचक पहलू यह है कि यह केवल मॉडल आकार स्केल करने पर ही नहीं दिखता। यह एपोच और ट्रेनिंग डेटा आकार में भी दिखाई देता है—कुछ ऐसा जिसे मैंने अलग-अलग ट्रेनिंग लंबाइयों और डेटा स्प्लिट्स के साथ प्रयोग चलाते समय नोट किया है।
यह सबसे अधिक अध्ययन किया गया रूप है। जब हम अधिक पैरामीटर जोड़ते हैं, तो हम अंडरफिटिंग से इंटरपोलेशन और फिर ओवरपैरामीटराइजेशन तक जाते हैं। इंटरपोलेशन थ्रेशहोल्ड से आगे और पैरामीटर जोड़ना वास्तव में मददगार हो सकता है, डबल डिसेंट के अनुसार। यह सामान्य बुद्धि के विरुद्ध विचार डीप न्यूरल नेटवर्क्स और पॉलीनोमियल रिग्रेशन में देखा गया है।
मॉडल-वार डबल डिसेंट हमें आश्वस्त करता है कि यदि बड़े मॉडलों को सही तरीके से प्रशिक्षित किया जाए तो उनसे डरने की जरूरत नहीं है। यह यह भी याद दिलाता है कि मॉडलों को बहुत जल्दी छोटा करना बिना वजह प्रदर्शन की कुर्बानी हो सकता है।
एक अन्य प्रकार का अवरोह तब होता है जब आप अधिक समय तक ट्रेनिंग करते हैं। शुरुआत में, अधिक ट्रेनिंग प्रदर्शन को बेहतर बनाती है। फिर टेस्ट त्रुटि बढ़ती है (ओवरफिटिंग)। लेकिन लगातार ट्रेनिंग से यह फिर गिर सकती है। यह अक्सर तब होता है जब आप लर्निंग रेट डिके या वेट एवरेजिंग जैसी विधियों का उपयोग करते हैं, जो ट्रेनिंग के बाद के चरणों में फ्लैटर मिनिमा खोजने में सहायता करती हैं।
तो, कुछ मामलों में, ओवरफिटिंग बिंदु से आगे भी ट्रेनिंग जारी रखने से जनरलाइज़ेशन में सुधार हो सकता है। हालाँकि, यह काफी हद तक संदर्भ-निर्भर है और सावधान वैलिडेशन द्वारा निर्देशित होना चाहिए—बिना सोचे-समझे ट्रेनिंग बढ़ाना व्यावहारिक मामलों में ओवरफिटिंग को और खराब कर सकता है।
सबसे चौंकाने वाला पहलू यह है कि डबल डिसेंट ट्रेनिंग डेटा की मात्रा के साथ भी हो सकता है। शुरुआत में, अधिक डेटा जोड़ने से चीजें बेहतर होती हैं। लेकिन कुछ समय ऐसे भी होते हैं, विशेषकर जब डेटा में बहुत शोर हो, जब मॉडल को कठिनाई हो सकती है, जिससे टेस्ट त्रुटि बढ़ जाती है। अंततः, अधिक उपयोगी डेटा जोड़ने पर जनरलाइज़ेशन फिर बेहतर हो जाता है। डबल डिसेंट का यह प्रकार दिखाता है कि अधिक डेटा हमेशा तुरंत बेहतर नहीं होता, लेकिन अंततः इसका फायदा आमतौर पर मिलता है।
यह समझने के लिए कि डबल डिसेंट क्यों होता है, हमें ऑप्टिमाइज़ेशन डायनैमिक्स, ज्यामिति और लर्निंग थ्योरी जैसे अवधारणाओं में गहराई तक जाना होगा।
हम सिंगुलर वैल्यू डिकंपोज़िशन (SVD) का उपयोग करके लॉस सरफेस की वक्रता देख सकते हैं। इंटरपोलेशन थ्रेशहोल्ड के आसपास, मॉडल छोटे सिंगुलर वैल्यू वाली इनपुट दिशाओं के प्रति बहुत संवेदनशील होते हैं, जो कम सिग्नल-टू-नॉइज़ अनुपात वाली दिशाएँ होती हैं। इससे मॉडल की टेस्ट त्रुटि बढ़ती है—ये मूलतः "कमज़ोर दिशाएँ" हैं जहाँ शोर ओवरफिटिंग पर बड़ा प्रभाव डाल सकता है।
सबसे व्यापक रूप से स्वीकृत विचारों में से एक यह है कि स्टोकेस्टिक ग्रेडिएंट डिसेंट (SGD) समाधान को निहित रूप से अधिक स्थिर बनाता है। SGD, हानि को न्यूनतम करने के लिए, कई कॉन्फ़िगरेशन में कम नॉर्म या कम वक्रता वाले वेट कॉन्फ़िगरेशन को प्राथमिकता देता है। ये उच्च-आयामी स्थान में सरल समाधान हैं। ये फ्लैट मिनिमा परिवर्तनों से कम प्रभावित होते हैं और अक्सर बेहतर जनरलाइज़ेशन से जुड़े होते हैं, खासकर दूसरे अवरोह में।
शोर पेचीदा चीज़ है। इंटरपोलेशन थ्रेशहोल्ड पर, थोड़ी सी लेबल नॉइज़ भी मॉडल को उसे फिट करने पर मजबूर कर सकती है, जिससे जनरलाइज़ेशन में बड़े अंतर आ सकते हैं। लेकिन यदि ऑप्टिमाइज़र अच्छा काम करता है, और आपके पास पर्याप्त पैरामीटर हैं, तो मॉडल सिग्नल और शोर को अलग कर पाएगा। यह इस विचार का समर्थन करता है कि यदि ऑप्टिमाइज़ेशन ठीक से किया जाए तो ओवरपैरामीटराइजेशन कोई समस्या नहीं है।
लॉटरी टिकट हाइपोथेसिस कहता है कि बड़े नेटवर्क्स में छोटे, प्रशिक्षित किए जा सकने वाले सबनेटवर्क होते हैं जो अच्छा काम करते हैं; और बड़े मॉडल उन्हें ढूँढ़ना आसान बना देते हैं। शार्प बनाम फ्लैट मिनिमा थ्योरी कहती है कि लॉस सरफेस का आकार मॉडल के आकार से अधिक जनरलाइज़ेशन को प्रभावित करता है।
मिलकर, ये दृष्टिकोण यह समझने को और समृद्ध बनाते हैं कि डबल डिसेंट क्यों उत्पन्न होता है।
डबल डिसेंट दिखाने वाले शुरुआती अध्ययनों में से कुछ Belkin et al. (2019) द्वारा किए गए थे। उन्होंने पॉलीनोमियल रिग्रेशन और न्यूरल नेटवर्क मॉडलों का परीक्षण किया; और पाया कि टेस्ट त्रुटि केवल बढ़कर समतल नहीं होती; यह फिर से घट भी सकती है। इन बेंचमार्क्स ने उस घटना को औपचारिक रूप दिया जिसे डीप लर्निंग समुदाय के कई लोगों ने अनुभवजन्य रूप से नोट किया था।
जब ResNets की परतों की गहराई CIFAR-10 और ImageNet पर बढ़ती है, तो डबल डिसेंट प्रदर्शन दिखाई देता है। यहाँ तक कि फिक्स्ड डेटा के साथ भी, ट्रांसफॉर्मर्स जैसे GPT-2/3/4, मॉडल आकार बढ़ने के साथ बेहतर जनरलाइज़ करते हैं। जब फ़िल्टर्स, लेयर्स, या यूनिट्स बड़े किए जाते हैं, तो CNNs जो विज़न डेटासेट्स पर प्रशिक्षित हैं, अक्सर डबल डिसेंट कर्व का अनुसरण करते हैं।
डबल डिसेंट के बारे में सीखना सिर्फ अकादमिक अभ्यास नहीं है, यह संगठनों को वास्तविक जीवन की ML परियोजनाओं में बेहतर निर्णय लेने में मदद कर सकता है।
यह अवधारणा हमें बताती है कि बड़ा होना हमेशा बुरा नहीं है। वास्तव में, ओवरफिटिंग के बिंदु से परे मॉडल की क्षमता बढ़ाना, खासकर यदि आप उसे ठीक से ऑप्टिमाइज़ और रेग्युलराइज़ करें, तो जनरलाइज़ेशन बेहतर कर सकता है। यह कहते हुए भी, हमें बेहतर प्रदर्शन के लाभों को कंप्यूटिंग लागत और पर्यावरणीय प्रभावों के साथ तोलना चाहिए।
उदाहरण के लिए, इंटरपोलेशन थ्रेशहोल्ड के बाद ड्रॉपआउट का उपयोग करना दूसरे अवरोह चरण में लर्निंग को स्थिर कर सकता है। आप लंबी ट्रेनिंग शेड्यूल्स, साइकलिक लर्निंग रेट्स, या यहाँ तक कि रेग्युलराइज़ेशन को इंटरपोलेशन पीक के बाद तक टालने की कोशिश कर सकते हैं। इससे दूसरे अवरोह चरण के दौरान लर्निंग अधिक स्थिर हो सकती है।
डबल डिसेंट डेटा संग्रह की योजना बनाने में भी मदद करता है। जब आप उस बदसूरत इंटरपोलेशन पीक पर पहुँचते हैं (जहाँ ट्रेनिंग एक्यूरेसी परफेक्ट होने के बावजूद त्रुटि बढ़ती है), तो तत्काल प्रतिक्रिया अक्सर यह होती है कि मॉडल में और कच्चा डेटा डाल दें। ऐसा न करें। क्योंकि सैंपल-वार डबल डिसेंट का मतलब है कि अधिक डेटा प्रारंभ में शोर संवेदनशीलता को बढ़ा सकता है, उससे पहले कि वह मदद करे।
इसके बजाय, मॉडल को और डेटा देने की जगह एक्टिव लर्निंग, डेटा ऑग्मेंटेशन और स्ट्रैटिफाइड सैंपलिंग जैसी विधियों पर विचार करें। ये मॉडल को इंटरपोलेशन पीक से अधिक आसानी से गुजरने में मदद कर सकती हैं। DataCamp के Data Quality Dimensions चीट शीट के साथ डेटा प्रभाव की निगरानी करें।
इंटरपोलेशन थ्रेशहोल्ड के पास ओवरफिटिंग को कम करने में मदद के लिए, ड्रॉपआउट, बैच नॉर्म, और वेट डिके जैसे टूल्स पर विचार करें। ये आपको यह समझने में मदद कर सकते हैं कि आप डेंजर ज़ोन में हैं या दूसरे अवरोह की स्वीट स्पॉट के करीब पहुँच रहे हैं। मैंने व्यक्तिगत रूप से इन तकनीकों का कई मॉडलिंग परियोजनाओं में उपयोग किया है, खासकर असंतुलित या शोरयुक्त डेटासेट्स पर काम करते समय।
बढ़ते शोध के बावजूद, डबल डिसेंट जितने उत्तर देता है, उससे अधिक प्रश्न उठाता है। डबल डिसेंट पर अधिक शोध होने के बावजूद, अब भी कुछ प्रश्न हैं जिनके उत्तर चाहिए और जिन दिशाओं में यह रोमांचक क्षेत्र आगे बढ़ रहा है।
क्या यह गणितीय या सांख्यिकीय रूप से भविष्यवाणी करना संभव है कि डबल डिसेंट ठीक कब होगा? डेटासेट की कौन-सी विशेषताएँ, आर्किटेक्चर का प्रकार, या ऑप्टिमाइज़र का चयन टेस्ट त्रुटि वक्र का आकार निर्धारित करेगा? ये ऐसे प्रश्न हैं जहाँ भविष्य में और काम किया जा सकता है।
क्या हम ऐसे न्यूरल नेटवर्क्स या ट्रेनिंग शेड्यूल डिज़ाइन कर सकते हैं जो दूसरे अवरोह का बेहतर उपयोग करें? क्या हमें ओवरपैरामीटराइजेशन को एक रणनीतिक डिज़ाइन लेयर के रूप में देखना चाहिए? यह न्यूरल टैन्जेंट कर्नेल्स, प्रीट्रेनिंग डायनैमिक्स और आर्किटेक्चर सर्च पर एक अच्छी शुरुआत है।
डबल डिसेंट हमें लर्निंग की बुनियादों पर फिर से सोचने पर मजबूर करता है। यह सुझाता है कि जटिलता और जनरलाइज़ेशन हमेशा एक-दूसरे के खिलाफ नहीं जाते, और ओवरफिटिंग शायद सबसे बुरी चीज़ न हो। यह कई क्लासिकल प्रैक्टिशनर्स की सोच में बड़ा बदलाव है, और दर्शाता है कि लर्निंग के बारे में हमारी थ्योरीज़ अब भी विकसित हो रही हैं।
डबल डिसेंट सिर्फ मशीन लर्निंग में नया मोड़ नहीं है; यह जनरलाइज़ेशन के बारे में सोचने का एक नया तरीका है। जटिल मॉडलों से बचने या उन्हें छोड़ देने के बजाय, हमें उनका रणनीतिक रूप से उपयोग करना पड़ सकता है। इसका मतलब है ऑप्टिमाइज़ेशन पर भरोसा करना, अपने डेटा को समझना, और अनोखी, प्रचलित धारा के विपरीत चीज़ें आज़माने के लिए तैयार रहना।
अगली बार जब आपका मॉडल ओवरफिट होने लगे, तो घबराइए नहीं। आप शायद दूसरे अवरोह से मिलने वाले हों।
अब जब आपको डबल डिसेंट की समझ है, तो सीख को आगे बढ़ाने के लिए नीचे दिए गए कुछ संसाधन और लिंक भी देख सकते हैं।
शीर्ष DataCamp पाठ्यक्रम
Track
Track
course