Quy tắc cổ điển của mô hình thống kê cho rằng khi mô hình càng phức tạp, lỗi huấn luyện giảm, nhưng lỗi kiểm tra tăng do overfitting. Giữ mô hình đơn giản quá thì có thể underfit. Đó là sự đánh đổi độ chệch–phương sai kinh điển mà chúng ta được dạy trong nhiều thập kỷ.
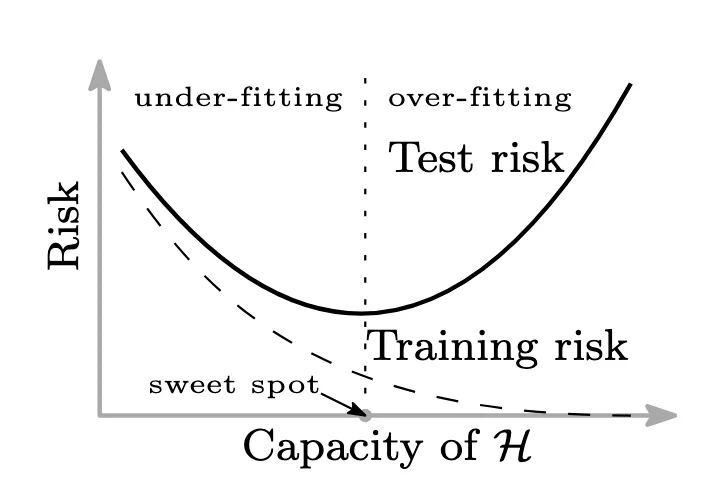
Sự đánh đổi độ chệch–phương sai cổ điển. Nguồn: Phỏng theo Hình 1(a) trong Belkin et al., 2019
Nhưng machine learning hiện đại, đặc biệt là deep learning, lại thách thức ý niệm tao nhã này. Nếu bạn làm deep learning vài năm gần đây, có thể bạn đã thấy điều lạ: những mô hình với hàng triệu tham số vẫn khái quát hóa rất tốt.
Theo lẽ thường thì điều đó không nên xảy ra. Hay là nên?
Hãy gặp double descent: một hiện tượng kỳ lạ mà hấp dẫn, nơi việc tăng độ phức tạp của mô hình lại cải thiện hiệu năng sau một cú vọt tăng đột ngột của lỗi kiểm tra.
Đây không chỉ là một khái niệm học thuật kỳ quặc; nó thực sự giúp tôi hiểu những xu hướng phản trực giác mà tôi quan sát được trong các dự án machine learning thực tế. Là người đã nhiều năm dẫn dắt các sáng kiến dự báo, dự đoán rời bỏ và NLP cho các hệ thống quy mô lớn, tôi đã tận mắt thấy hiện tượng này thách thức lối nghĩ truyền thống và định hình lại cách chúng ta tiếp cận độ phức tạp mô hình.
Trong bài viết này, chúng ta sẽ bàn về double descent là gì, các giai đoạn, khi nào và vì sao nó xảy ra, và quan trọng nhất là cần làm gì.
Lược sử ngắn về Double Descent
Double descent có vẻ mới mẻ, nhưng phần lớn mọi người không biết rằng đây là một ý niệm cũ, được deep learning đưa trở lại dưới tiêu điểm sắc nét hơn.
Quan sát sớm: Bí ẩn lỗi phi đơn điệu
Ý tưởng rằng tăng độ phức tạp mô hình có thể dẫn đến khái quát hóa tốt hơn sau khi overfit không hoàn toàn mới. Thực tế, thống kê cổ điển đã gợi ý hành vi kỳ lạ này từ nhiều thập kỷ trước. Ví dụ, khi khớp đa thức bậc cao vào dữ liệu trong hồi quy tuyến tính, bạn có thể thấy mô hình overfit rồi sau đó lại khái quát tốt hơn. Nhưng người ta thường cho rằng những mẫu hình này chỉ là tạo tác của overfitting hoặc bất ổn số học, chứ không phải hành vi thực.
Tìm lại trong thời hiện đại: Deep learning buộc phải nghĩ lại
Bước ngoặt đến với thành công của mạng nơ-ron sâu, nơi các mô hình thường có hàng triệu thậm chí hàng tỷ tham số, nhiều hơn rất nhiều so với số lượng mẫu huấn luyện.
Theo lối nghĩ cổ điển, các mô hình phức tạp phải overfit dữ liệu huấn luyện đáng kể. Tuy nhiên, điều đáng ngạc nhiên là không phải vậy. Thực tế, những mô hình này thường khái quát tốt hơn mô hình nhỏ.
Phát hiện bất ngờ này khiến các nhà nghiên cứu như Belkin et al. (2019) đào sâu lại các lý thuyết cũ. Khám phá thú vị của họ cho thấy khi mô hình đủ phức tạp để khớp hoàn hảo dữ liệu huấn luyện, lỗi kiểm tra thực sự bắt đầu giảm lại khi mô hình tiếp tục lớn hơn. Deep learning không chỉ phát hiện hiện tượng gọi là “double descent” này—mà còn biến nó thành một khái niệm nền tảng trong hiểu biết của chúng ta về khả năng khái quát ngày nay.
Double Descent là gì? Định nghĩa, Trực giác và Đường cong Rủi ro
Double descent ám chỉ quan sát rằng đường cong lỗi kiểm tra không phải lúc nào cũng có dạng chữ U theo độ phức tạp mô hình. Sau đợt giảm ban đầu (khi độ chệch giảm), lỗi kiểm tra tăng (do overfitting), nhưng rồi bất ngờ lại giảm lần nữa. Điều này tạo nên hình “double descent”.
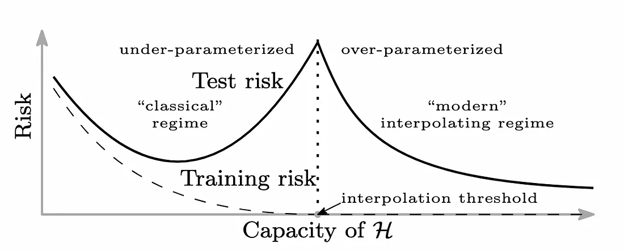
Đường cong rủi ro double descent. Nguồn: Phỏng theo Hình 1(b) trong Belkin et al., 2019
Trong thực hành của riêng tôi, đặc biệt khi triển khai hệ thống phân loại văn bản dựa trên deep learning và dự báo chuỗi thời gian cho các doanh nghiệp chuỗi cung ứng, tôi đã quan sát thấy nhịp giảm thứ hai của lỗi kiểm tra. Nó không hề lý thuyết; chúng tôi thấy rõ trên các đường cong xác thực.
Điều này giúp giải thích vì sao các mô hình lớn như ResNet, và nói chung là các kiến trúc dư tham số khổng lồ, vẫn có thể khái quát tốt. Dù các định luật mở rộng cho mô hình như GPT gợi ý những cải thiện mượt mà hơn thay vì một đường double descent thấy rõ, nguyên lý cốt lõi—rằng mô hình lớn hơn không phải lúc nào cũng tệ hơn—vẫn đúng.
Nguyên lý nền tảng và các giai đoạn của Double Descent
Có ba giai đoạn chính của double descent được thảo luận dưới đây.
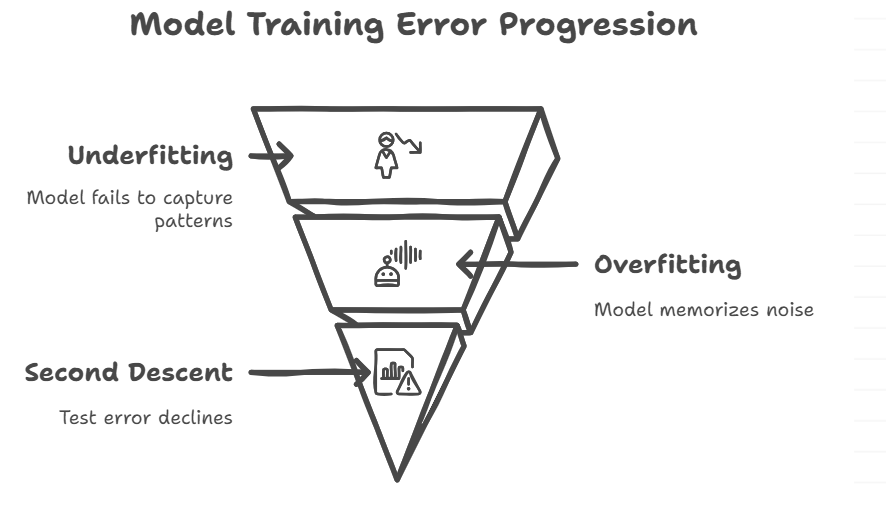
Các giai đoạn của Double Descent. Nguồn ảnh: Napkin AI
Giai đoạn Underfitting
- Đặc điểm: Mô hình quá yếu để bắt được mẫu hình (ví dụ, hồi quy tuyến tính cho dữ liệu ảnh).
- Hành vi: Thêm tham số giúp giảm độ chệch, nhưng chỉ đến một mức nào đó.
Từ kinh nghiệm của tôi: Hãy bắt đầu đơn giản, nhưng đừng sợ độ phức tạp.
Giai đoạn Overfitting (Vùng Nguy hiểm)
- Đặc điểm: Mô hình ghi nhớ nhiễu dẫn đến những đỉnh lỗi kiểm tra tăng vọt.
- Điểm xoay chiều: Đây là lúc nhiều người dừng huấn luyện—nhưng không phải điểm kết thúc.
Mẹo thực tiễn: Nếu loss xác thực tăng vọt giữa chừng, hãy tạm dừng—nhưng đừng dừng hẳn.
Giai đoạn Giảm lần hai (Second Descent)
- Đặc điểm: Lỗi kiểm tra giảm dù khớp hoàn hảo dữ liệu huấn luyện.
- Cơ chế: Dư tham số giúp tối ưu (như SGD) tìm các nghiệm “đơn giản” hơn.
Điểm mấu chốt: Mô hình lớn không tự thân hỗn loạn—chúng được chuẩn hóa ngầm.
Một lời giải thích hàng đầu là các bộ tối ưu như SGD vốn ưa thích cực tiểu phẳng, những vùng có độ cong thấp, vốn có xu hướng khái quát tốt hơn. Ngay cả trong các mô hình dư tham số khổng lồ, các vùng phẳng này trở nên dễ tìm hơn khi địa hình tối ưu hóa thay đổi.
Biểu hiện theo các “chiều” của Double Descent
Một khía cạnh hấp dẫn của double descent là nó không chỉ xuất hiện khi mở rộng kích thước mô hình. Nó còn xuất hiện theo số epoch và kích thước dữ liệu huấn luyện—điều tôi nhận thấy khi chạy thí nghiệm với độ dài huấn luyện và cách chia dữ liệu khác nhau.
Double descent theo mô hình
Đây là dạng được nghiên cứu nhiều nhất. Khi thêm tham số, ta đi từ underfitting đến nội suy rồi sang dư tham số. Thêm tham số vượt quá ngưỡng nội suy thực ra có thể giúp ích, theo double descent. Ý tưởng đi ngược trực giác này đã được thấy ở mạng nơ-ron sâu và hồi quy đa thức.
Double descent theo mô hình cho phép chúng ta bớt sợ các mô hình lớn miễn là được huấn luyện đúng cách. Nó cũng nhắc rằng cắt giảm mô hình quá sớm có thể đồng nghĩa hy sinh hiệu năng một cách vô cớ.
Double descent theo epoch
Một dạng giảm khác xảy ra khi bạn huấn luyện lâu hơn. Ban đầu, huấn luyện thêm giúp cải thiện hiệu năng. Sau đó lỗi kiểm tra tăng (overfitting). Nhưng với việc tiếp tục huấn luyện, lỗi có thể lại giảm. Điều này thường xảy ra khi dùng các phương pháp như giảm tốc độ học hoặc trung bình trọng số, vốn tạo điều kiện tìm cực tiểu phẳng hơn về cuối quá trình huấn luyện.
Vì vậy, trong một số trường hợp, tiếp tục huấn luyện vượt qua điểm overfitting có thể dẫn đến khái quát hóa tốt hơn. Tuy nhiên, điều này phụ thuộc rất nhiều vào ngữ cảnh và nên được dẫn dắt bởi xác thực cẩn trọng—kéo dài huấn luyện một cách mù quáng có thể làm overfitting nặng hơn trong nhiều trường hợp thực tế.
Double descent theo mẫu dữ liệu
Điều gây ngạc nhiên nhất là double descent cũng có thể xảy ra với lượng dữ liệu huấn luyện. Ban đầu, thêm dữ liệu giúp mọi thứ vận hành tốt hơn. Nhưng đôi khi, đặc biệt khi dữ liệu nhiều nhiễu, mô hình có thể gặp khó, khiến lỗi kiểm tra tăng. Cuối cùng, khả năng khái quát lại cải thiện khi bổ sung thêm dữ liệu hữu ích. Dạng double descent này cho thấy thêm dữ liệu không phải lúc nào cũng tốt ngay lập tức, nhưng thường mang lại lợi ích về sau.
Cơ chế lý thuyết và nền tảng toán học
Để hiểu vì sao double descent xảy ra, chúng ta cần đi sâu vào các khái niệm như động học tối ưu, hình học và lý thuyết học.
Phân tích phổ
Ta có thể xem độ cong của bề mặt loss bằng phân rã giá trị kỳ dị (SVD). Ở gần ngưỡng nội suy, mô hình rất nhạy với các hướng đầu vào có giá trị kỳ dị nhỏ, tức các hướng có tỷ lệ tín hiệu–nhiễu thấp. Điều này làm lỗi kiểm tra tăng vọt—về cơ bản là những “hướng yếu” nơi nhiễu có thể tác động mạnh đến overfitting.
Chuẩn hóa ngầm
Một ý tưởng được chấp nhận rộng rãi là stochastic gradient descent (SGD) ngầm khiến nghiệm ổn định hơn. SGD ưu tiên các cấu hình trọng số có chuẩn thấp hoặc độ cong thấp, giữa nhiều cấu hình khác nhau, để tối thiểu hóa loss. Đây là các nghiệm đơn giản hơn trong không gian chiều cao. Những cực tiểu phẳng này ít bị ảnh hưởng bởi biến động và thường gắn với khả năng khái quát tốt hơn, đặc biệt ở lần giảm thứ hai.
Vai trò của nhiễu
Nhiễu là thứ rắc rối. Ở ngưỡng nội suy, chỉ một chút nhiễu nhãn cũng có thể khiến mô hình khớp theo nó, dẫn đến khoảng cách khái quát hóa lớn. Nhưng nếu bộ tối ưu làm tốt và bạn có số lượng tham số đáng kể, mô hình có thể tách tín hiệu khỏi nhiễu. Điều này củng cố ý tưởng rằng dư tham số không phải vấn đề nếu tối ưu hóa đúng đắn.
Các lý thuyết thay thế
Giả thuyết Vé số (Lottery Ticket) cho rằng mạng lớn chứa các mạng con nhỏ, huấn luyện được và hoạt động tốt; mô hình càng lớn càng dễ tìm ra chúng. Lý thuyết cực tiểu nhọn so với phẳng cho rằng hình dạng bề mặt loss ảnh hưởng đến khái quát hóa nhiều hơn kích thước mô hình.
Kết hợp lại, các góc nhìn này tạo nên hiểu biết phong phú hơn về vì sao double descent xuất hiện.
Ví dụ và bằng chứng thực nghiệm
Thực nghiệm chuẩn
Một số nghiên cứu sớm nhất chứng minh double descent do Belkin et al. (2019) thực hiện. Họ thử nghiệm hồi quy đa thức và mô hình mạng nơ-ron; và phát hiện lỗi kiểm tra không chỉ tăng rồi phẳng; nó còn có thể giảm trở lại. Những benchmark này đã làm sáng tỏ một hiện tượng mà nhiều người trong cộng đồng deep learning trước đó chỉ quan sát giai thoại.
Nghiên cứu tình huống deep learning
Khi tăng độ sâu tầng trong ResNet trên CIFAR-10 và ImageNet, hiệu năng double descent xuất hiện. Ngay cả với dữ liệu cố định, transformer như GPT-2/3/4 khái quát tốt hơn khi kích thước mô hình tăng. Khi tăng số lượng bộ lọc, tầng, hoặc đơn vị, CNN huấn luyện trên bộ dữ liệu thị giác thường tuân theo đường cong double descent.
Hệ quả thực tiễn cho phát triển mô hình
Tìm hiểu về double descent không chỉ mang tính học thuật, nó có thể giúp các tổ chức đưa ra lựa chọn tốt hơn trong các dự án ML đời thực.
Mở rộng mô hình
Khái niệm này cho chúng ta thấy lớn hơn không phải lúc nào cũng tệ hơn. Thực tế, tăng dung lượng mô hình vượt qua điểm overfitting có thể giúp khái quát tốt hơn, đặc biệt nếu tối ưu và chuẩn hóa đúng. Nói vậy, ta vẫn nên cân nhắc lợi ích hiệu năng so với chi phí tính toán và tác động môi trường.
Quy trình huấn luyện
Chẳng hạn, dùng dropout sau ngưỡng nội suy có thể ổn định việc học trong giai đoạn giảm thứ hai. Bạn có thể thử lịch huấn luyện dài hơn, tốc độ học chu kỳ, hoặc thậm chí trì hoãn chuẩn hóa cho đến sau đỉnh nội suy. Điều này có thể giúp ổn định việc học trong giai đoạn giảm thứ hai.
Quản lý dữ liệu
Double descent cũng giúp lên kế hoạch thu thập dữ liệu. Khi bạn chạm tới đỉnh nội suy xấu xí (nơi lỗi tăng vọt dù độ chính xác huấn luyện hoàn hảo), phản xạ tự nhiên là đổ thêm dữ liệu thô vào mô hình. Đừng làm vậy. Vì double descent theo mẫu cho thấy thêm dữ liệu ban đầu có thể làm tăng nhạy cảm với nhiễu trước khi có ích.
Thay vào đó, hãy cân nhắc các phương pháp như active learning, tăng cường dữ liệu và lấy mẫu phân tầng thay vì chỉ cho mô hình thêm dữ liệu. Những cách này giúp mô hình vượt qua đỉnh nội suy dễ dàng hơn. Theo dõi tác động dữ liệu với Cheat Sheet về các Khía cạnh Chất lượng Dữ liệu của DataCamp.
Giảm thiểu và chẩn đoán
Để giúp cắt giảm overfitting gần ngưỡng nội suy, hãy cân nhắc các công cụ như dropout, batch norm và weight decay. Chúng có thể giúp bạn xác định liệu mình đang ở vùng nguy hiểm hay sắp đến “điểm ngọt” của lần giảm thứ hai. Cá nhân tôi đã dùng các kỹ thuật này trong nhiều dự án mô hình hóa, đặc biệt khi làm việc với bộ dữ liệu mất cân bằng hoặc nhiễu.
Câu hỏi còn bỏ ngỏ và hướng nghiên cứu tương lai
Bất chấp số lượng nghiên cứu ngày càng tăng, double descent nêu ra nhiều câu hỏi hơn là câu trả lời. Dù đang có thêm nhiều nghiên cứu, vẫn còn những câu hỏi cần lời giải cùng với định hướng của lĩnh vực thú vị này.
Khoảng trống lý thuyết
Liệu có thể dự đoán một cách toán học hoặc thống kê chính xác khi nào double descent sẽ xảy ra không? Đặc trưng nào của bộ dữ liệu, loại kiến trúc hay lựa chọn bộ tối ưu sẽ quyết định hình dạng đường cong lỗi kiểm tra? Đây là những câu hỏi mà nghiên cứu trong tương lai có thể làm được nhiều hơn.
Kiến trúc và tối ưu hóa
Chúng ta có thể thiết kế mạng nơ-ron hoặc lịch huấn luyện theo cách khai thác tốt hơn lần giảm thứ hai không? Có nên xem dư tham số như một lớp thiết kế mang tính chiến lược? Đây là điểm khởi đầu tốt cho nhân tiếp tuyến nơ-ron, động lực tiền huấn luyện và tìm kiếm kiến trúc.
Dịch chuyển triết học
Double descent khiến chúng ta suy nghĩ lại về nền tảng của học máy. Nó gợi ý rằng độ phức tạp và khả năng khái quát không phải lúc nào cũng đối nghịch, và overfitting có thể không phải điều tệ hại nhất. Đây là thay đổi lớn trong cách nghĩ của nhiều người theo trường phái cổ điển, và cho thấy các lý thuyết về học máy của chúng ta vẫn đang tiến hóa.
Kết luận
Double descent không chỉ là một “cú xoay” mới trong machine learning; nó là một cách mới để nghĩ về khả năng khái quát. Thay vì né tránh hay bỏ rơi các mô hình phức tạp, chúng ta có thể cần dùng chúng một cách chiến lược. Điều này đòi hỏi tin tưởng vào tối ưu hóa, hiểu dữ liệu của bạn và sẵn sàng thử những điều khác thông lệ.
Đừng vội hoảng khi mô hình bắt đầu overfit. Có thể bạn sắp chạm tới lần giảm thứ hai.
Giờ bạn đã hiểu double descent, bạn cũng có thể xem thêm một số tài nguyên và liên kết dưới đây để đào sâu kiến thức.


Quy tắc cổ điển của mô hình thống kê cho rằng khi mô hình càng phức tạp, lỗi huấn luyện giảm, nhưng lỗi kiểm tra tăng do overfitting. Giữ mô hình đơn giản quá thì có thể underfit. Đó là sự đánh đổi độ chệch–phương sai kinh điển mà chúng ta được dạy trong nhiều thập kỷ.
Sự đánh đổi độ chệch–phương sai cổ điển. Nguồn: Phỏng theo Hình 1(a) trong Belkin et al., 2019
Nhưng machine learning hiện đại, đặc biệt là deep learning, lại thách thức ý niệm tao nhã này. Nếu bạn làm deep learning vài năm gần đây, có thể bạn đã thấy điều lạ: những mô hình với hàng triệu tham số vẫn khái quát hóa rất tốt.
Theo lẽ thường thì điều đó không nên xảy ra. Hay là nên?
Hãy gặp double descent: một hiện tượng kỳ lạ mà hấp dẫn, nơi việc tăng độ phức tạp của mô hình lại cải thiện hiệu năng sau một cú vọt tăng đột ngột của lỗi kiểm tra.
Đây không chỉ là một khái niệm học thuật kỳ quặc; nó thực sự giúp tôi hiểu những xu hướng phản trực giác mà tôi quan sát được trong các dự án machine learning thực tế. Là người đã nhiều năm dẫn dắt các sáng kiến dự báo, dự đoán rời bỏ và NLP cho các hệ thống quy mô lớn, tôi đã tận mắt thấy hiện tượng này thách thức lối nghĩ truyền thống và định hình lại cách chúng ta tiếp cận độ phức tạp mô hình.
Trong bài viết này, chúng ta sẽ bàn về double descent là gì, các giai đoạn, khi nào và vì sao nó xảy ra, và quan trọng nhất là cần làm gì.
Lược sử ngắn về Double Descent
Double descent có vẻ mới mẻ, nhưng phần lớn mọi người không biết rằng đây là một ý niệm cũ, được deep learning đưa trở lại dưới tiêu điểm sắc nét hơn.
Quan sát sớm: Bí ẩn lỗi phi đơn điệu
Ý tưởng rằng tăng độ phức tạp mô hình có thể dẫn đến khái quát hóa tốt hơn sau khi overfit không hoàn toàn mới. Thực tế, thống kê cổ điển đã gợi ý hành vi kỳ lạ này từ nhiều thập kỷ trước. Ví dụ, khi khớp đa thức bậc cao vào dữ liệu trong hồi quy tuyến tính, bạn có thể thấy mô hình overfit rồi sau đó lại khái quát tốt hơn. Nhưng người ta thường cho rằng những mẫu hình này chỉ là tạo tác của overfitting hoặc bất ổn số học, chứ không phải hành vi thực.
Tìm lại trong thời hiện đại: Deep learning buộc phải nghĩ lại
Bước ngoặt đến với thành công của mạng nơ-ron sâu, nơi các mô hình thường có hàng triệu thậm chí hàng tỷ tham số, nhiều hơn rất nhiều so với số lượng mẫu huấn luyện.
Theo lối nghĩ cổ điển, các mô hình phức tạp phải overfit dữ liệu huấn luyện đáng kể. Tuy nhiên, điều đáng ngạc nhiên là không phải vậy. Thực tế, những mô hình này thường khái quát tốt hơn mô hình nhỏ.
Phát hiện bất ngờ này khiến các nhà nghiên cứu như Belkin et al. (2019) đào sâu lại các lý thuyết cũ. Khám phá thú vị của họ cho thấy khi mô hình đủ phức tạp để khớp hoàn hảo dữ liệu huấn luyện, lỗi kiểm tra thực sự bắt đầu giảm lại khi mô hình tiếp tục lớn hơn. Deep learning không chỉ phát hiện hiện tượng gọi là “double descent” này—mà còn biến nó thành một khái niệm nền tảng trong hiểu biết của chúng ta về khả năng khái quát ngày nay.
Double Descent là gì? Định nghĩa, Trực giác và Đường cong Rủi ro
Double descent ám chỉ quan sát rằng đường cong lỗi kiểm tra không phải lúc nào cũng có dạng chữ U theo độ phức tạp mô hình. Sau đợt giảm ban đầu (khi độ chệch giảm), lỗi kiểm tra tăng (do overfitting), nhưng rồi bất ngờ lại giảm lần nữa. Điều này tạo nên hình “double descent”.
Đường cong rủi ro double descent. Nguồn: Phỏng theo Hình 1(b) trong Belkin et al., 2019
Trong thực hành của riêng tôi, đặc biệt khi triển khai hệ thống phân loại văn bản dựa trên deep learning và dự báo chuỗi thời gian cho các doanh nghiệp chuỗi cung ứng, tôi đã quan sát thấy nhịp giảm thứ hai của lỗi kiểm tra. Nó không hề lý thuyết; chúng tôi thấy rõ trên các đường cong xác thực.
Điều này giúp giải thích vì sao các mô hình lớn như ResNet, và nói chung là các kiến trúc dư tham số khổng lồ, vẫn có thể khái quát tốt. Dù các định luật mở rộng cho mô hình như GPT gợi ý những cải thiện mượt mà hơn thay vì một đường double descent thấy rõ, nguyên lý cốt lõi—rằng mô hình lớn hơn không phải lúc nào cũng tệ hơn—vẫn đúng.
Nguyên lý nền tảng và các giai đoạn của Double Descent
Có ba giai đoạn chính của double descent được thảo luận dưới đây.
Các giai đoạn của Double Descent. Nguồn ảnh: Napkin AI
Giai đoạn Underfitting
Từ kinh nghiệm của tôi: Hãy bắt đầu đơn giản, nhưng đừng sợ độ phức tạp.
Giai đoạn Overfitting (Vùng Nguy hiểm)
Mẹo thực tiễn: Nếu loss xác thực tăng vọt giữa chừng, hãy tạm dừng—nhưng đừng dừng hẳn.
Giai đoạn Giảm lần hai (Second Descent)
Điểm mấu chốt: Mô hình lớn không tự thân hỗn loạn—chúng được chuẩn hóa ngầm.
Một lời giải thích hàng đầu là các bộ tối ưu như SGD vốn ưa thích cực tiểu phẳng, những vùng có độ cong thấp, vốn có xu hướng khái quát tốt hơn. Ngay cả trong các mô hình dư tham số khổng lồ, các vùng phẳng này trở nên dễ tìm hơn khi địa hình tối ưu hóa thay đổi.
Biểu hiện theo các “chiều” của Double Descent
Một khía cạnh hấp dẫn của double descent là nó không chỉ xuất hiện khi mở rộng kích thước mô hình. Nó còn xuất hiện theo số epoch và kích thước dữ liệu huấn luyện—điều tôi nhận thấy khi chạy thí nghiệm với độ dài huấn luyện và cách chia dữ liệu khác nhau.
Double descent theo mô hình
Đây là dạng được nghiên cứu nhiều nhất. Khi thêm tham số, ta đi từ underfitting đến nội suy rồi sang dư tham số. Thêm tham số vượt quá ngưỡng nội suy thực ra có thể giúp ích, theo double descent. Ý tưởng đi ngược trực giác này đã được thấy ở mạng nơ-ron sâu và hồi quy đa thức.
Double descent theo mô hình cho phép chúng ta bớt sợ các mô hình lớn miễn là được huấn luyện đúng cách. Nó cũng nhắc rằng cắt giảm mô hình quá sớm có thể đồng nghĩa hy sinh hiệu năng một cách vô cớ.
Double descent theo epoch
Một dạng giảm khác xảy ra khi bạn huấn luyện lâu hơn. Ban đầu, huấn luyện thêm giúp cải thiện hiệu năng. Sau đó lỗi kiểm tra tăng (overfitting). Nhưng với việc tiếp tục huấn luyện, lỗi có thể lại giảm. Điều này thường xảy ra khi dùng các phương pháp như giảm tốc độ học hoặc trung bình trọng số, vốn tạo điều kiện tìm cực tiểu phẳng hơn về cuối quá trình huấn luyện.
Vì vậy, trong một số trường hợp, tiếp tục huấn luyện vượt qua điểm overfitting có thể dẫn đến khái quát hóa tốt hơn. Tuy nhiên, điều này phụ thuộc rất nhiều vào ngữ cảnh và nên được dẫn dắt bởi xác thực cẩn trọng—kéo dài huấn luyện một cách mù quáng có thể làm overfitting nặng hơn trong nhiều trường hợp thực tế.
Double descent theo mẫu dữ liệu
Điều gây ngạc nhiên nhất là double descent cũng có thể xảy ra với lượng dữ liệu huấn luyện. Ban đầu, thêm dữ liệu giúp mọi thứ vận hành tốt hơn. Nhưng đôi khi, đặc biệt khi dữ liệu nhiều nhiễu, mô hình có thể gặp khó, khiến lỗi kiểm tra tăng. Cuối cùng, khả năng khái quát lại cải thiện khi bổ sung thêm dữ liệu hữu ích. Dạng double descent này cho thấy thêm dữ liệu không phải lúc nào cũng tốt ngay lập tức, nhưng thường mang lại lợi ích về sau.
Cơ chế lý thuyết và nền tảng toán học
Để hiểu vì sao double descent xảy ra, chúng ta cần đi sâu vào các khái niệm như động học tối ưu, hình học và lý thuyết học.
Phân tích phổ
Ta có thể xem độ cong của bề mặt loss bằng phân rã giá trị kỳ dị (SVD). Ở gần ngưỡng nội suy, mô hình rất nhạy với các hướng đầu vào có giá trị kỳ dị nhỏ, tức các hướng có tỷ lệ tín hiệu–nhiễu thấp. Điều này làm lỗi kiểm tra tăng vọt—về cơ bản là những “hướng yếu” nơi nhiễu có thể tác động mạnh đến overfitting.
Chuẩn hóa ngầm
Một ý tưởng được chấp nhận rộng rãi là stochastic gradient descent (SGD) ngầm khiến nghiệm ổn định hơn. SGD ưu tiên các cấu hình trọng số có chuẩn thấp hoặc độ cong thấp, giữa nhiều cấu hình khác nhau, để tối thiểu hóa loss. Đây là các nghiệm đơn giản hơn trong không gian chiều cao. Những cực tiểu phẳng này ít bị ảnh hưởng bởi biến động và thường gắn với khả năng khái quát tốt hơn, đặc biệt ở lần giảm thứ hai.
Vai trò của nhiễu
Nhiễu là thứ rắc rối. Ở ngưỡng nội suy, chỉ một chút nhiễu nhãn cũng có thể khiến mô hình khớp theo nó, dẫn đến khoảng cách khái quát hóa lớn. Nhưng nếu bộ tối ưu làm tốt và bạn có số lượng tham số đáng kể, mô hình có thể tách tín hiệu khỏi nhiễu. Điều này củng cố ý tưởng rằng dư tham số không phải vấn đề nếu tối ưu hóa đúng đắn.
Các lý thuyết thay thế
Giả thuyết Vé số (Lottery Ticket) cho rằng mạng lớn chứa các mạng con nhỏ, huấn luyện được và hoạt động tốt; mô hình càng lớn càng dễ tìm ra chúng. Lý thuyết cực tiểu nhọn so với phẳng cho rằng hình dạng bề mặt loss ảnh hưởng đến khái quát hóa nhiều hơn kích thước mô hình.
Kết hợp lại, các góc nhìn này tạo nên hiểu biết phong phú hơn về vì sao double descent xuất hiện.
Ví dụ và bằng chứng thực nghiệm
Thực nghiệm chuẩn
Một số nghiên cứu sớm nhất chứng minh double descent do Belkin et al. (2019) thực hiện. Họ thử nghiệm hồi quy đa thức và mô hình mạng nơ-ron; và phát hiện lỗi kiểm tra không chỉ tăng rồi phẳng; nó còn có thể giảm trở lại. Những benchmark này đã làm sáng tỏ một hiện tượng mà nhiều người trong cộng đồng deep learning trước đó chỉ quan sát giai thoại.
Nghiên cứu tình huống deep learning
Khi tăng độ sâu tầng trong ResNet trên CIFAR-10 và ImageNet, hiệu năng double descent xuất hiện. Ngay cả với dữ liệu cố định, transformer như GPT-2/3/4 khái quát tốt hơn khi kích thước mô hình tăng. Khi tăng số lượng bộ lọc, tầng, hoặc đơn vị, CNN huấn luyện trên bộ dữ liệu thị giác thường tuân theo đường cong double descent.
Hệ quả thực tiễn cho phát triển mô hình
Tìm hiểu về double descent không chỉ mang tính học thuật, nó có thể giúp các tổ chức đưa ra lựa chọn tốt hơn trong các dự án ML đời thực.
Mở rộng mô hình
Khái niệm này cho chúng ta thấy lớn hơn không phải lúc nào cũng tệ hơn. Thực tế, tăng dung lượng mô hình vượt qua điểm overfitting có thể giúp khái quát tốt hơn, đặc biệt nếu tối ưu và chuẩn hóa đúng. Nói vậy, ta vẫn nên cân nhắc lợi ích hiệu năng so với chi phí tính toán và tác động môi trường.
Quy trình huấn luyện
Chẳng hạn, dùng dropout sau ngưỡng nội suy có thể ổn định việc học trong giai đoạn giảm thứ hai. Bạn có thể thử lịch huấn luyện dài hơn, tốc độ học chu kỳ, hoặc thậm chí trì hoãn chuẩn hóa cho đến sau đỉnh nội suy. Điều này có thể giúp ổn định việc học trong giai đoạn giảm thứ hai.
Quản lý dữ liệu
Double descent cũng giúp lên kế hoạch thu thập dữ liệu. Khi bạn chạm tới đỉnh nội suy xấu xí (nơi lỗi tăng vọt dù độ chính xác huấn luyện hoàn hảo), phản xạ tự nhiên là đổ thêm dữ liệu thô vào mô hình. Đừng làm vậy. Vì double descent theo mẫu cho thấy thêm dữ liệu ban đầu có thể làm tăng nhạy cảm với nhiễu trước khi có ích.
Thay vào đó, hãy cân nhắc các phương pháp như active learning, tăng cường dữ liệu và lấy mẫu phân tầng thay vì chỉ cho mô hình thêm dữ liệu. Những cách này giúp mô hình vượt qua đỉnh nội suy dễ dàng hơn. Theo dõi tác động dữ liệu với Cheat Sheet về các Khía cạnh Chất lượng Dữ liệu của DataCamp.
Giảm thiểu và chẩn đoán
Để giúp cắt giảm overfitting gần ngưỡng nội suy, hãy cân nhắc các công cụ như dropout, batch norm và weight decay. Chúng có thể giúp bạn xác định liệu mình đang ở vùng nguy hiểm hay sắp đến “điểm ngọt” của lần giảm thứ hai. Cá nhân tôi đã dùng các kỹ thuật này trong nhiều dự án mô hình hóa, đặc biệt khi làm việc với bộ dữ liệu mất cân bằng hoặc nhiễu.
Câu hỏi còn bỏ ngỏ và hướng nghiên cứu tương lai
Bất chấp số lượng nghiên cứu ngày càng tăng, double descent nêu ra nhiều câu hỏi hơn là câu trả lời. Dù đang có thêm nhiều nghiên cứu, vẫn còn những câu hỏi cần lời giải cùng với định hướng của lĩnh vực thú vị này.
Khoảng trống lý thuyết
Liệu có thể dự đoán một cách toán học hoặc thống kê chính xác khi nào double descent sẽ xảy ra không? Đặc trưng nào của bộ dữ liệu, loại kiến trúc hay lựa chọn bộ tối ưu sẽ quyết định hình dạng đường cong lỗi kiểm tra? Đây là những câu hỏi mà nghiên cứu trong tương lai có thể làm được nhiều hơn.
Kiến trúc và tối ưu hóa
Chúng ta có thể thiết kế mạng nơ-ron hoặc lịch huấn luyện theo cách khai thác tốt hơn lần giảm thứ hai không? Có nên xem dư tham số như một lớp thiết kế mang tính chiến lược? Đây là điểm khởi đầu tốt cho nhân tiếp tuyến nơ-ron, động lực tiền huấn luyện và tìm kiếm kiến trúc.
Dịch chuyển triết học
Double descent khiến chúng ta suy nghĩ lại về nền tảng của học máy. Nó gợi ý rằng độ phức tạp và khả năng khái quát không phải lúc nào cũng đối nghịch, và overfitting có thể không phải điều tệ hại nhất. Đây là thay đổi lớn trong cách nghĩ của nhiều người theo trường phái cổ điển, và cho thấy các lý thuyết về học máy của chúng ta vẫn đang tiến hóa.
Kết luận
Double descent không chỉ là một “cú xoay” mới trong machine learning; nó là một cách mới để nghĩ về khả năng khái quát. Thay vì né tránh hay bỏ rơi các mô hình phức tạp, chúng ta có thể cần dùng chúng một cách chiến lược. Điều này đòi hỏi tin tưởng vào tối ưu hóa, hiểu dữ liệu của bạn và sẵn sàng thử những điều khác thông lệ.
Đừng vội hoảng khi mô hình bắt đầu overfit. Có thể bạn sắp chạm tới lần giảm thứ hai.
Giờ bạn đã hiểu double descent, bạn cũng có thể xem thêm một số tài nguyên và liên kết dưới đây để đào sâu kiến thức.