
Lernpfad
Grundlagen des maschinellen Lernens in Python
16 Std.
Die klassische Faustregel im statistischen Modellieren lautet: Wird ein Modell komplexer, sinkt der Trainingsfehler, aber der Testfehler steigt wegen Overfitting. Hältst du es zu simpel, droht Underfitting. Das ist der bekannte Bias-Variance-Trade-off, den wir seit Jahrzehnten lernen.
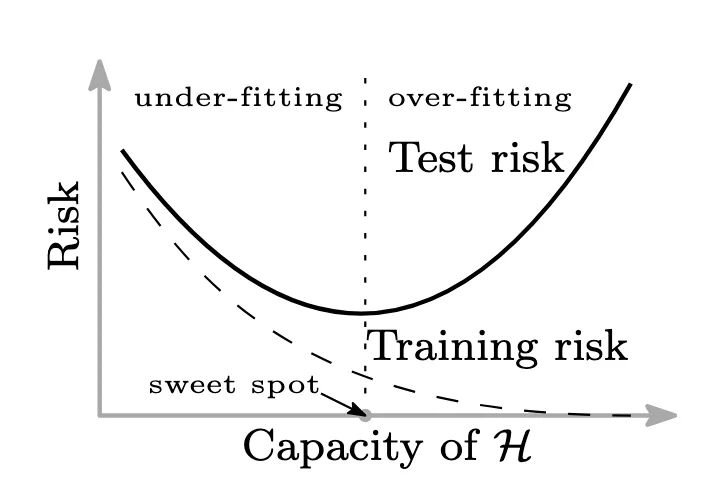
Der klassische Bias-Variance-Trade-off. Quelle: Adaptiert nach Abbildung 1(a) in Belkin et al., 2019
Modernes Machine Learning, vor allem Deep Learning, stellt diese elegante Idee jedoch infrage. Wenn du in den letzten Jahren mit Deep Learning gearbeitet hast, ist dir vielleicht etwas Merkwürdiges aufgefallen: Modelle mit Millionen Parametern generalisieren erstaunlich gut.
Das widerspricht der gängigen Lehrmeinung. Oder doch nicht?
Hier kommt Double Descent ins Spiel: ein seltsames, aber faszinierendes Phänomen, bei dem steigende Modellkomplexität erneut die Leistung verbessert, nachdem der Testfehler zuvor sprunghaft angestiegen ist.
Das ist nicht nur eine akademische Kuriosität, sondern hat mir geholfen, kontraintuitive Trends in realen ML-Projekten zu verstehen. Als jemand, der jahrelang Forecasting-, Churn- und NLP-Initiativen in großskaligen Systemen geleitet hat, habe ich aus erster Hand erlebt, wie dieses Phänomen die traditionelle Sicht auf Modellkomplexität auf den Kopf stellt.
In diesem Artikel schauen wir uns an, was Double Descent ist, welche Phasen es gibt, wann und warum es auftritt und vor allem, wie du damit umgehen solltest.
Double Descent wirkt neu, ist aber tatsächlich ein älteres Konzept, das durch Deep Learning wieder in den Fokus gerückt wurde.
Die Idee, dass steigende Modellkomplexität nach Overfitting wieder zu besserer Generalisierung führen kann, ist nicht ganz neu. Klassische Statistik deutete dieses Verhalten bereits vor Jahrzehnten an. Etwa beim Fitten hochgradiger Polynome in der linearen Regression zeigt sich oft erst Overfitting und anschließend wieder bessere Generalisierung. Häufig wurden diese Muster jedoch als Artefakte von Overfitting oder numerischer Instabilität abgetan.
Der Wendepunkt kam mit dem Erfolg tiefer neuronaler Netze, deren Modelle oft Millionen oder sogar Milliarden Parameter hatten—weit mehr als Trainingsbeispiele.
Nach klassischer Lehre sollten derart komplexe Modelle stark überfitten. Überraschenderweise ist das oft nicht der Fall. Tatsächlich generalisieren diese Modelle häufig besser als kleinere.
Diese unerwartete Beobachtung führte Forschende wie Belkin et al. (2019) zurück zu älteren Theorien. Ihr zentrales Ergebnis: Sobald ein Modell komplex genug ist, um die Trainingsdaten perfekt zu fitten, beginnt der Testfehler beim weiteren Vergrößern des Modells wieder zu sinken. Deep Learning hat dieses als "Double Descent" bekannte Phänomen nicht nur sichtbar gemacht—es hat es zu einem Grundpfeiler unseres heutigen Verständnisses von Generalisierung gemacht.
Double Descent beschreibt die Beobachtung, dass die Testfehlerkurve nicht immer U-förmig in Abhängigkeit von der Modellkomplexität ist. Nach einem ersten Abstieg (sinkender Bias) steigt der Testfehler an (Overfitting), fällt dann aber überraschend wieder. Dadurch entsteht die typische „Double-Descent“-Form.
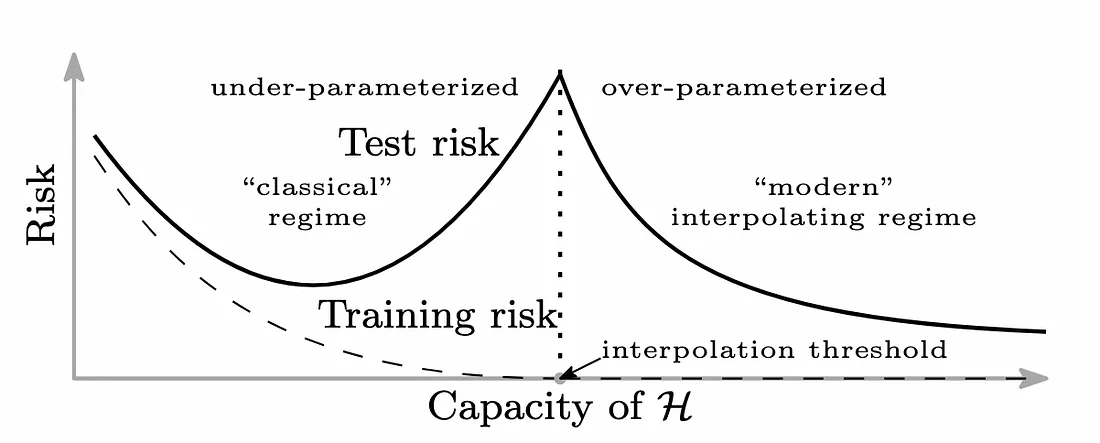
Die Double-Descent-Risikokurve. Quelle: Adaptiert nach Abbildung 1(b) in Belkin et al., 2019
In meiner Praxis—insbesondere beim Einsatz von Deep-Learning-basierten Textklassifikationssystemen und bei Zeitreihenprognosen für Lieferketten—habe ich diesen zweiten Dip im Testfehler gesehen. Nicht nur theoretisch, sondern klar in den Validierungskurven.
Das erklärt, warum große Modelle wie ResNets und generell stark überparametrisierte Architekturen dennoch gut generalisieren. Auch wenn Skalierungsgesetze für Modelle wie GPT eher glattere Verbesserungen als eine sichtbar ausgeprägte Double-Descent-Kurve nahelegen, bleibt das Grundprinzip—größer ist nicht automatisch schlechter—relevant.
Es gibt drei zentrale Phasen, die unten beschrieben sind.
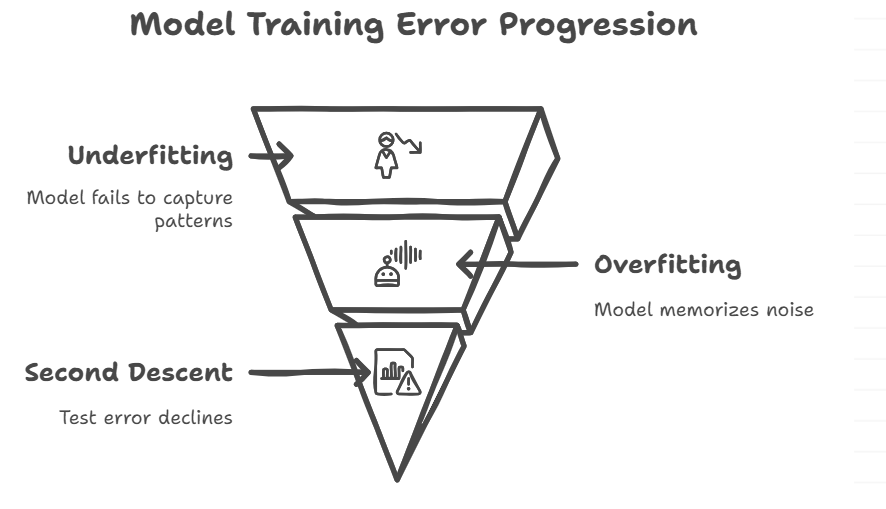
Phasen von Double Descent. Bildquelle: Napkin AI
Aus meiner Erfahrung: Starte einfach, aber hab keine Angst vor Komplexität.
Praxis-Tipp: Wenn deine Validierungsverlustkurve mitten im Training hochschießt, pausiere—aber brich nicht sofort ab.
Zentrale Einsicht: Große Modelle sind nicht per se chaotisch—sie werden implizit regularisiert.
Eine der führenden Erklärungen ist, dass Optimierer wie SGD bevorzugt flache Minima mit geringer Krümmung finden, die tendenziell besser generalisieren. Selbst in stark überparametrisierten Modellen werden diese flacheren Regionen durch die veränderte Optimierungslandschaft leichter auffindbar.
Faszinierend ist, dass Double Descent nicht nur beim Skalieren der Modellgröße auftritt. Es zeigt sich auch über Epochen und die Trainingsdatengröße—etwas, das ich bei Experimenten mit variablen Trainingslängen und -splits häufig beobachtet habe.
Das ist die am häufigsten untersuchte Form. Mit mehr Parametern gehen wir von Underfitting über Interpolation hin zu Überparametrisierung. Mehr Parameter jenseits der Interpolationsschwelle können laut Double Descent tatsächlich helfen. Dieses dem Bauchgefühl widersprechende Verhalten wurde in tiefen neuronalen Netzen und in der Polynomialregression beobachtet.
Modellbasiertes Double Descent nimmt die Angst vor großen Modellen—sofern sie richtig trainiert werden. Es erinnert auch daran, dass ein zu frühes Kürzen der Modellkapazität ohne Not Leistung kosten kann.
Eine weitere Variante tritt auf, wenn du länger trainierst. Zunächst verbessert mehr Training die Performance. Dann steigt der Testfehler (Overfitting). Mit weiterem Training kann er jedoch wieder fallen. Das passiert oft, wenn Techniken wie Learning-Rate-Decays oder Weight Averaging eingesetzt werden, die später im Training die Suche nach flacheren Minima erleichtern.
In manchen Fällen führt also Training über den Overfitting-Punkt hinaus zu besserer Generalisierung. Das ist jedoch stark kontextabhängig und sollte sorgfältig validiert werden—blindes Verlängern des Trainings kann in der Praxis oft Overfitting verstärken.
Überraschend ist, dass Double Descent auch in Abhängigkeit von der Menge der Trainingsdaten auftreten kann. Zunächst hilft mehr Datenmenge. In Situationen mit viel Rauschen kann das Modell jedoch ins Straucheln geraten, wodurch der Testfehler steigt. Mit weiter wachsendem, nützlichem Datenvolumen verbessert sich die Generalisierung wieder. Dieses Double Descent zeigt: Mehr Daten sind nicht sofort besser—auf lange Sicht aber meist doch.
Um zu verstehen, warum Double Descent auftritt, müssen wir in Themen wie Optimierungsdynamik, Geometrie und Lerntheorie eintauchen.
Die Krümmung der Loss-Landschaft lässt sich mit Singulärwertzerlegung (SVD) betrachten. Rund um die Interpolationsschwelle sind Modelle besonders empfindlich gegenüber Eingaberichtungen mit kleinen Singulärwerten—Richtungen mit niedrigem Signal-Rausch-Verhältnis. Das treibt den Testfehler hoch: Es sind die „schwachen Richtungen“, in denen Rauschen Overfitting stark begünstigen kann.
Eine weit verbreitete Erklärung ist, dass stochastischer Gradientenabstieg (SGD) die Lösung implizit stabilisiert. Unter vielen Konfigurationen bevorzugt SGD Gewichte mit kleinem Normwert oder geringer Krümmung, um den Loss zu minimieren. Das sind „einfachere“ Lösungen im hochdimensionalen Raum. Solche flachen Minima reagieren weniger empfindlich auf Änderungen und korrelieren oft mit besserer Generalisierung—insbesondere in der zweiten Descent-Phase.
Rauschen ist tückisch. An der Interpolationsschwelle kann schon wenig Labelrauschen dazu führen, dass das Modell es mitlernt—mit großen Generalisierungslücken als Folge. Gelingt die Optimierung und stehen ausreichend viele Parameter zur Verfügung, trennt das Modell Signal von Rauschen. Das stützt die Sicht, dass Überparametrisierung kein Problem sein muss, wenn die Optimierung funktioniert.
Die Lottery-Ticket-Hypothese besagt, dass große Netzwerke kleine, gut trainierbare Unternetze enthalten und größere Modelle deren Auffinden erleichtern. Die Theorie scharfer vs. flacher Minima argumentiert, dass die Form der Loss-Landschaft die Generalisierung stärker beeinflusst als die reine Modellgröße.
Zusammen liefern diese Perspektiven ein umfassenderes Verständnis dafür, warum Double Descent entsteht.
Zu den frühesten Arbeiten, die Double Descent zeigten, gehören Belkin et al. (2019). Sie testeten Polynomialregression und neuronale Netze und fanden: Der Testfehler steigt nicht nur und flacht ab—er kann auch wieder sinken. Diese Benchmarks bestätigten ein Phänomen, das viele in der Deep-Learning-Community bereits anekdotisch beobachtet hatten.
Wenn die Tiefe der Schichten in ResNets auf CIFAR-10 und ImageNet zunimmt, zeigt sich Double Descent. Selbst bei fixer Datenmenge verbessern sich Transformer wie GPT-2/3/4 mit wachsender Modellgröße in der Generalisierung. Werden Filter, Schichten oder Units vergrößert, folgen CNNs auf Vision-Datensätzen häufig der Double-Descent-Kurve.
Double Descent zu verstehen, ist kein reines Theorie-Thema—es hilft Organisationen, in echten ML-Projekten bessere Entscheidungen zu treffen.
Die Kernaussage lautet: Größer ist nicht automatisch schlechter. Die Kapazität über den Overfitting-Punkt hinaus zu erhöhen, kann die Generalisierung verbessern—vorausgesetzt, Optimierung und Regularisierung sitzen. Trotzdem sollten Nutzen, Rechenkosten und Umweltauswirkungen gegeneinander abgewogen werden.
Beispielsweise kann der Einsatz von Dropout nach der Interpolationsschwelle das Lernen in der zweiten Descent-Phase stabilisieren. Probiere längere Trainingspläne, zyklische Lernraten oder verzögere Regularisierung bis nach dem Interpolationspeak. Das kann die Stabilität während der zweiten Descent-Phase erhöhen.
Double Descent hilft auch bei der Datenerhebung. Wenn du am unschönen Interpolationspeak landest (Fehler steigt trotz perfekter Trainingsgenauigkeit), ist der Reflex oft, einfach mehr Rohdaten ins Modell zu kippen. Tu das nicht. Denn stichprobenbasiertes Double Descent bedeutet, dass mehr Daten anfangs die Rauschsensitivität verstärken können, bevor sie helfen.
Setze stattdessen auf Active Learning, Data Augmentation und stratifiziertes Sampling, statt blind mehr Daten zu sammeln. So kommt das Modell leichter über den Interpolationspeak. Überwache den Dateneinfluss mit DataCamps Spickzettel zu Datenqualitätsdimensionen.
Um Overfitting nahe der Interpolationsschwelle zu reduzieren, nutze Tools wie Dropout, Batch-Normalisierung und Weight Decay. Sie helfen dir einzuschätzen, ob du in der Gefahrenzone bist oder bereits Richtung zweitem Descent kommst. Ich setze diese Techniken regelmäßig ein, besonders bei unausgewogenen oder verrauschten Datensätzen.
Trotz wachsender Forschung wirft Double Descent mehr Fragen auf, als es beantwortet. Es bleiben Themen offen—und spannende Richtungen, in die sich das Feld bewegt.
Lässt sich mathematisch oder statistisch vorhersagen, wann genau Double Descent auftritt? Welche Eigenschaften von Datensatz, Architektur oder Optimierer bestimmen die Form der Testfehlerkurve? Hier gibt es viel Raum für weitere Forschung.
Können wir Netzwerke oder Trainingspläne so entwerfen, dass sie die zweite Descent-Phase besser ausnutzen? Sollten wir Überparametrisierung als strategische Designebene betrachten? Ansatzpunkte sind Neural Tangent Kernels, Pretraining-Dynamiken und Architektursuche.
Double Descent zwingt uns, die Grundlagen des Lernens neu zu denken. Es zeigt, dass Komplexität und Generalisierung nicht zwingend Gegenspieler sind—und dass Overfitting nicht immer das Schlimmste ist. Das ist ein bedeutender Perspektivwechsel und zeigt, dass unsere Lerntheorien weiter in Bewegung sind.
Double Descent ist mehr als nur eine neue Wendung im Machine Learning; es verändert, wie wir über Generalisierung denken. Statt komplexe Modelle zu meiden, sollten wir sie gezielt einsetzen: mit Vertrauen in die Optimierung, gutem Datenverständnis und der Offenheit, unkonventionelle Wege zu gehen.
Gerate also nicht sofort in Panik, wenn dein Modell zu überfitten scheint. Vielleicht steht dir gerade die zweite Descent-Phase bevor.
Wenn du Double Descent verstanden hast, lohnt sich ein Blick in die folgenden Ressourcen, um dein Wissen zu vertiefen.
Top-DataCamp-Kurse
Lernpfad
Lernpfad
Kurs
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
Tutorial
Allan Ouko
7 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.




