programa
Fundamentos del aprendizaje automático en Python
16 h
La regla clásica del modelado estadístico dice que, si el modelo se complica, el error de entrenamiento baja, pero el de prueba sube por sobreajuste. Si lo simplificas demasiado, aparece el infraajuste. Es el equilibrio sesgo-varianza de toda la vida.
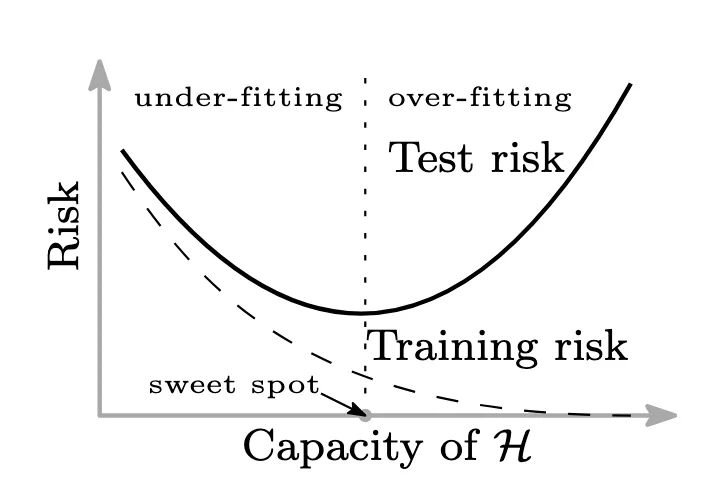
El equilibrio clásico entre sesgo y varianza. Fuente: adaptado de la Figura 1(a) en Belkin et al., 2019
Pero el machine learning moderno, y en especial el deep learning, cuestiona esta idea tan elegante. Si has trabajado con deep learning en los últimos años, quizá te haya sorprendido algo: modelos con millones de parámetros que aun así generalizan muy bien.
Según la sabiduría convencional, eso no debería pasar. ¿O sí?
Aquí entra en juego el double descent: un fenómeno tan extraño como fascinante en el que aumentar la complejidad del modelo vuelve a mejorar el rendimiento después de un pico repentino en el error de prueba.
No es solo una curiosidad académica: a mí me ha ayudado a entender tendencias contraintuitivas que he visto en proyectos reales de machine learning. Tras años liderando iniciativas de forecasting, predicción de churn y NLP en sistemas a gran escala, he comprobado de primera mano cómo este fenómeno cuestiona la sabiduría tradicional y cambia nuestra forma de abordar la complejidad de los modelos.
En este artículo veremos qué es el double descent, sus fases, cuándo y por qué ocurre y, sobre todo, qué puedes hacer al respecto.
Puede sonar a novedad, pero en realidad es un concepto antiguo que el deep learning ha vuelto a poner en primer plano.
La idea de que aumentar la complejidad de un modelo podría llevar a una mejor generalización tras el sobreajuste no es completamente nueva. De hecho, la estadística clásica ya insinuaba este comportamiento hace décadas. Por ejemplo, al ajustar polinomios de alto grado en regresión lineal, se observa un patrón de sobreajuste seguido de una mejor generalización. Aun así, solía achacarse a artefactos de sobreajuste o inestabilidad numérica, no a un comportamiento real.
El punto de inflexión llegó con el éxito de las redes neuronales profundas, con millones o incluso miles de millones de parámetros, muy por encima del número de ejemplos de entrenamiento.
La visión clásica sugiere que los modelos complejos deberían sobreajustar de forma severa. Sin embargo, sorprendentemente, no siempre es así. De hecho, a menudo generalizan mejor que los modelos pequeños.
Este hallazgo llevó a investigadores como Belkin et al. (2019) a revisitar teorías previas. Su descubrimiento mostró que, cuando un modelo es lo bastante complejo para ajustar perfectamente los datos de entrenamiento, el error de prueba vuelve a mejorar al seguir aumentando el tamaño. El deep learning no solo redescubrió este fenómeno llamado "double descent", sino que lo convirtió en una pieza clave para entender la generalización hoy.
Double descent describe la observación de que la curva de error de prueba no siempre es en forma de U con respecto a la complejidad del modelo. Tras un primer descenso (al reducirse el sesgo), el error de prueba sube (por sobreajuste), pero luego, de forma inesperada, vuelve a bajar. De ahí la forma de "doble descenso".
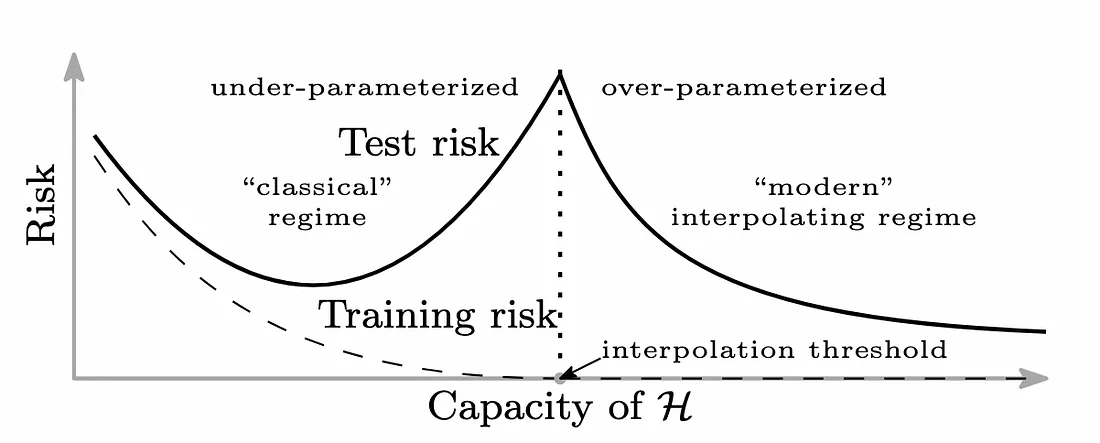
La curva de riesgo del double descent. Fuente: adaptado de la Figura 1(b) en Belkin et al., 2019
En mi experiencia, especialmente al desplegar sistemas de clasificación de texto con deep learning y al hacer forecasting de series temporales para cadenas de suministro, he observado este segundo valle en el error de prueba. No era teoría: se veía en las curvas de validación.
Ayuda a explicar por qué modelos grandes como ResNets y, en general, arquitecturas fuertemente sobreparametrizadas pueden generalizar bien. Aunque las scaling laws de modelos como GPT apunten a mejoras más suaves en lugar de una curva de double descent marcada, el principio subyacente —que más grande no siempre es peor— sigue vigente.
Se suelen distinguir tres etapas principales.
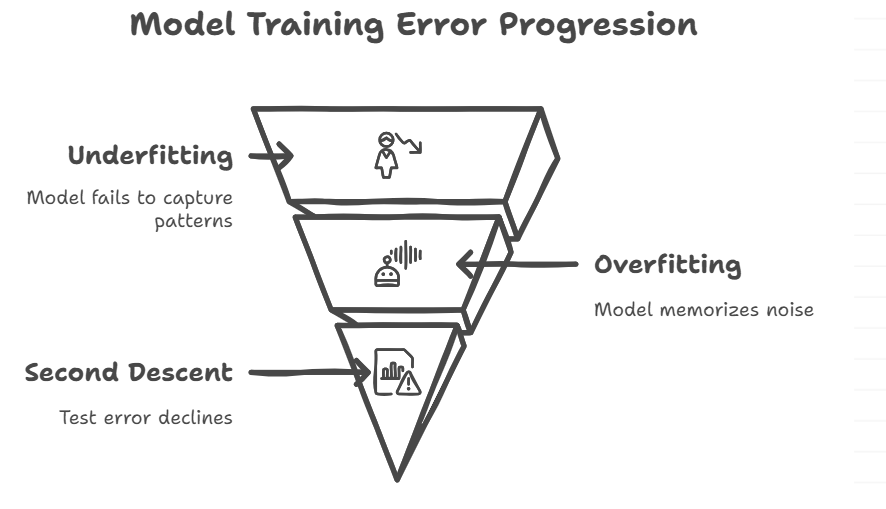
Fases del double descent. Fuente de la imagen: Napkin AI
En mi experiencia: empieza simple, pero no le temas a la complejidad.
Consejo práctico: si la pérdida de validación pega un pico a mitad de entrenamiento, haz una pausa, pero no lo des por terminado.
Idea clave: los modelos grandes no son caóticos por naturaleza: están regularizados de forma implícita.
Una explicación destacada es que optimizadores como SGD tienden a preferir mínimos más planos, con menor curvatura, que suelen generalizar mejor. Incluso en modelos muy sobreparametrizados, estas regiones planas se vuelven más accesibles a medida que cambia el paisaje de optimización.
Lo más llamativo es que no solo aparece al escalar el tamaño del modelo. También surge en función de las épocas y del tamaño del conjunto de entrenamiento, algo que he visto al variar duraciones de entrenamiento y particiones de datos.
Es la forma más estudiada. Al añadir parámetros pasamos de infraajuste a interpolación y luego a sobreparametrización. Superar el umbral de interpolación con más parámetros puede ayudar, según el double descent. Esta idea, contraintuitiva, se ha observado en redes profundas y en regresión polinómica.
Este patrón nos anima a no temer a los modelos grandes, siempre que se entrenen bien. También recuerda que recortar demasiado pronto puede hacerte perder rendimiento sin necesidad.
Otra variante aparece al entrenar más tiempo. Al principio, entrenar más mejora el rendimiento. Luego, el error de prueba sube (sobreajuste). Pero puede volver a bajar si continúas. Sucede a menudo cuando aplicas decay de la tasa de aprendizaje o promedios de pesos, que facilitan encontrar mínimos más planos en fases tardías.
Así, en algunos casos, seguir entrenando más allá del punto de sobreajuste mejora la generalización. Sin embargo, esto depende mucho del contexto y debe guiarse con una validación cuidadosa: prolongar el entrenamiento a ciegas puede empeorar el sobreajuste.
Quizá lo más sorprendente es que también puede darse con la cantidad de datos de entrenamiento. Al principio, añadir más datos ayuda. Pero a veces, sobre todo con mucho ruido, el modelo se resiente y el error de prueba sube. Con más datos útiles, la generalización vuelve a mejorar. Esta variante nos recuerda que más datos no siempre son mejores de inmediato, aunque a la larga suelen compensar.
Para entender por qué ocurre el double descent, conviene profundizar en dinámica de optimización, geometría y teoría del aprendizaje.
Podemos estudiar la curvatura de la superficie de pérdida con descomposición en valores singulares (SVD). Cerca del umbral de interpolación, los modelos son muy sensibles a direcciones con valores singulares pequeños, es decir, con baja relación señal-ruido. Esto dispara el error de prueba: son las "direcciones débiles" donde el ruido favorece el sobreajuste.
Una de las ideas más aceptadas es que el stochastic gradient descent (SGD) estabiliza implícitamente la solución. Entre múltiples configuraciones que minimizan la pérdida, SGD prefiere pesos con norma o curvatura bajas. Son soluciones más simples en espacios de alta dimensión. Estos mínimos planos son menos sensibles a perturbaciones y suelen asociarse a mejor generalización, especialmente en el segundo descenso.
El ruido es delicado. En el umbral de interpolación, incluso un poco de ruido en las etiquetas puede ser memorizado, abriendo grandes brechas de generalización. Pero si la optimización funciona bien y hay suficientes parámetros, el modelo separa señal de ruido. Esto respalda que la sobreparametrización no es un problema si optimizas adecuadamente.
La Lottery Ticket Hypothesis plantea que las redes grandes contienen subredes pequeñas entrenables que funcionan muy bien, y que los modelos más grandes facilitan encontrarlas. La teoría de mínimos agudos vs. planos sostiene que la forma de la superficie de pérdida influye más en la generalización que el tamaño del modelo.
En conjunto, estas perspectivas enriquecen la comprensión de por qué surge el double descent.
Algunos de los primeros trabajos que mostraron el double descent fueron los de Belkin et al. (2019). Probaron con regresión polinómica y redes neuronales y vieron que el error de prueba no solo sube y se aplana: también puede volver a bajar. Estos benchmarks dieron forma rigurosa a un fenómeno que mucha gente en la comunidad de deep learning ya comentaba de forma anecdótica.
Al aumentar la profundidad de las capas en las ResNets en CIFAR-10 e ImageNet, aparece el comportamiento de double descent. Incluso con datos fijos, los transformers como GPT-2/3/4 mejoran su generalización al crecer. Al ampliar filtros, capas o unidades, las CNN entrenadas en visión suelen seguir la curva de double descent.
Entender el double descent no es un ejercicio teórico: ayuda a tomar mejores decisiones en proyectos reales de ML.
Este concepto nos dice que más grande no siempre es peor. De hecho, aumentar la capacidad más allá del punto de sobreajuste puede mejorar la generalización, especialmente si optimizas y regularizas bien. Dicho esto, conviene sopesar las ganancias frente al coste computacional y el impacto ambiental.
Por ejemplo, aplicar dropout después del umbral de interpolación puede estabilizar el aprendizaje en la segunda fase de descenso. Puedes probar calendarios de entrenamiento más largos, tasas de aprendizaje cíclicas o incluso retrasar la regularización hasta después del pico de interpolación para ganar estabilidad.
El double descent también ayuda a planificar la recogida de datos. Al llegar al feo pico de interpolación (cuando el error se dispara pese a acertar todo en entrenamiento), la reacción instintiva es volcar más datos en bruto. No lo hagas. El double descent según muestras implica que más datos pueden amplificar primero la sensibilidad al ruido antes de ayudar.
Mejor, valora métodos como active learning, data augmentation y muestreo estratificado en lugar de añadir datos sin más. Ayudan a superar el pico de interpolación. Controla el impacto en los datos con la chuleta de dimensiones de calidad de datos de DataCamp.
Para reducir el sobreajuste cerca del umbral de interpolación, piensa en herramientas como dropout, batch norm y weight decay. Te ayudarán a detectar si estás en la zona de peligro o ya cerca del punto dulce del segundo descenso. Personalmente he usado estas técnicas en varios proyectos, especialmente con datos desbalanceados o ruidosos.
Pese al creciente cuerpo de trabajo, el double descent plantea más preguntas de las que responde. Aunque avanza la investigación, aún quedan cuestiones por resolver y un campo apasionante por explorar.
¿Podemos predecir matemática o estadísticamente cuándo ocurrirá exactamente el double descent? ¿Qué rasgos del conjunto de datos, de la arquitectura o del optimizador determinan la forma de la curva de error de prueba? Son preguntas que requieren más trabajo futuro.
¿Podemos diseñar redes o calendarios de entrenamiento que aprovechen mejor el segundo descenso? ¿Deberíamos ver la sobreparametrización como una capa estratégica de diseño? Buen punto de partida: neural tangent kernels, dinámica de preentrenamiento y búsqueda de arquitecturas.
El double descent nos hace repensar los fundamentos del aprendizaje. Sugiere que complejidad y generalización no siempre se oponen, y que el sobreajuste quizá no sea el peor escenario. Es un cambio importante para muchos practicantes clásicos y muestra que nuestras teorías siguen evolucionando.
El double descent es más que un giro nuevo en machine learning; es una nueva forma de pensar la generalización. En vez de evitar o abandonar modelos complejos, quizá debamos usarlos con estrategia. Esto implica confiar en la optimización, conocer tus datos y estar abierto a probar enfoques poco habituales.
La próxima vez que tu modelo empiece a sobreajustar, no entres en pánico. Puede que estés a punto de encontrarte con el segundo descenso.
Ahora que entiendes el double descent, echa un vistazo a estos recursos para seguir aprendiendo.
Los mejores cursos de DataCamp
programa
programa
Curso
blog
Abid Ali Awan
7 min
blog
Zoumana Keita
14 min
blog
Natassha Selvaraj
15 min
blog
Moez Ali
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
9 min