您可能对在大学或学院参加考试的经历记忆犹新,考后还会讨论自己拿到的题目是否比同学的更难。或者,您也许记得重考时觉得试卷比上一次容易。那么,分数更高是因为试卷更简单,还是因为您学得更多了?
这正触及如何衡量一个人在某个领域的知识、技能和能力的核心问题。设计考试的典型做法,是拟定一组题目,发给学生作答,将每题判定为对/错,然后统计所有题目中答对的数量。最终分数就被视为学生知识水平的量化指标,用来决定是否通过考试。
在 DataCamp,我们也提供类似的体验。用户可以通过我们的测评来评估自己在特定领域(例如 SQL 的数据管理)的表现——登录并在此处试一试!同样,在DataCamp 认证中,用户需要先通过一系列考试,才能获得认证。
经典测验理论
测验开发的核心是一个名为经典测验理论(CTT)的测量框架。其基础等式如下:
X = T + E
其中 X 为观测到的测验分数,T 为真实分数,E 为误差项。这个等式的含义是,任何观测分数都是一个人的真实分数与某种非系统性误差的混合。这种方法很适合于这样的场景:您希望在同一时间点,用同一套固定题目来测量一组人(例如您班上的所有学生)在某一领域的水平。举例来说,如果您开发了一套用于考察 SQL 技能的试题,CTT 是分析该测验质量的良好框架。
然而,DataCamp 可以被视为一个全球性的巨大课堂,学习者可以 24/7 随时在自己感兴趣的领域进行自我测评或尝试获得认证。
在我们的环境中,若仅依赖 CTT 来保证测验质量,很快就会遇到问题。
鉴于我们同时提供测评和 DataCamp 认证,目标是在特定领域量化用户的知识、技能与能力,我们不可能对所有人反复使用相同的 15 道题。这会让测验极易受到题目泄露与重考记忆的影响,分数也会随着时间推移而失去意义。
使用项目反应理论
一个简单的修正方法是增加可展示给用户的题目数量,和/或持续更新抽题池。然而,CTT 只考虑个体的真实分数,对题目本身却只字未提!当我们无法确定连续两次测试中的题目难度是否可比时,如何估计一个人的得分呢?
引入:项目反应理论(IRT)。IRT 是一种测量框架,其中对单道题的观测分数(例如对/错)被假定为个体能力与题目难度之间概率性相互作用的结果。形式化地表示为:
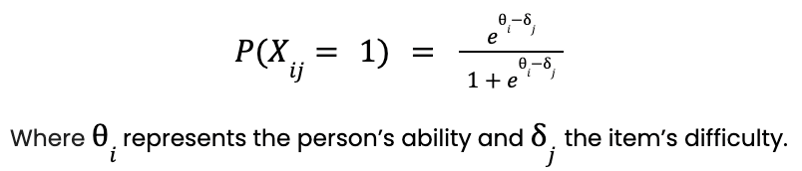
该模型也称为一参数逻辑模型(1-PL)或 Rasch 模型。出于估计的考虑,通常假设能力服从以 0 为中心、标准差为 1 的正态分布。由此得到的量表以标准差为单位,通常在 -4 到 4 之间变化(因为正态分布在此范围内覆盖了 99.99% 以上的概率质量)。别担心,这个范围可以按需转换!例如,在 DataCamp 中,-3.33 对应 0 分,0 对应 100 分,3.33 对应 200 分。将该等式固定在某道题(此处设为 0),并将能力在 -4 到 4 之间变化,可以得到如下曲线:
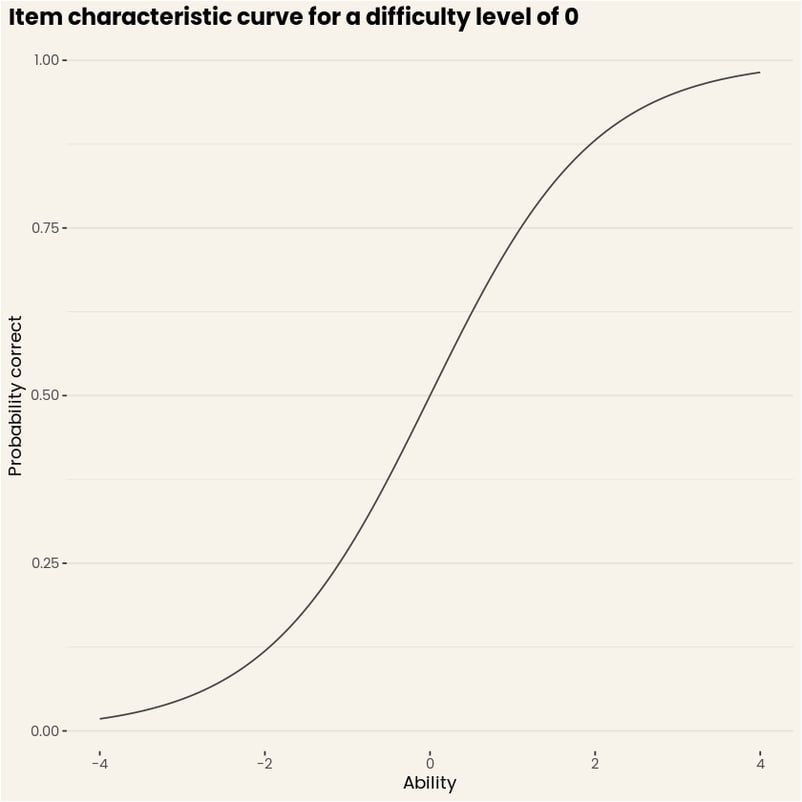
图 1:难度为 0 的题目的项目特征曲线。(来源:DataCamp Workspace)
这条曲线也称为项目特征曲线,表示在各个能力水平下,预计能正确作答该题的概率。题库中的每道题都由这样一条曲线表征,所有曲线的集合能够完整表达任何人的预期测验表现。项目特征曲线的妙处在于:给定不同的个体能力,您可以直观把握在某道题上的预期表现!
DataCamp 中的 IRT 实践
现在让我们来验证最初的动机!IRT 对 DataCamp 有何用处?下图展示了一个包含 7 道难度不同的假设题集。假设我们在两次不同的测验中,分别向同一人(能力为平均水平)展示最容易的三道题与最难的三道题。沿着曲线可以看出,简单试卷上预计答对题数约为 2.5(即将各题的正确概率相加),而困难试卷上预计仅约为 0.875!直白地说,如果只看答对数,在简单试卷上的表现几乎是困难试卷的三倍。但关键在于,IRT 允许我们基于作答是否正确及相应的题目难度来估计能力得分。这样,我们在两种情况下都能较为准确地还原出 0 的能力分(当然,具体会随测验长度产生一定测量误差)。
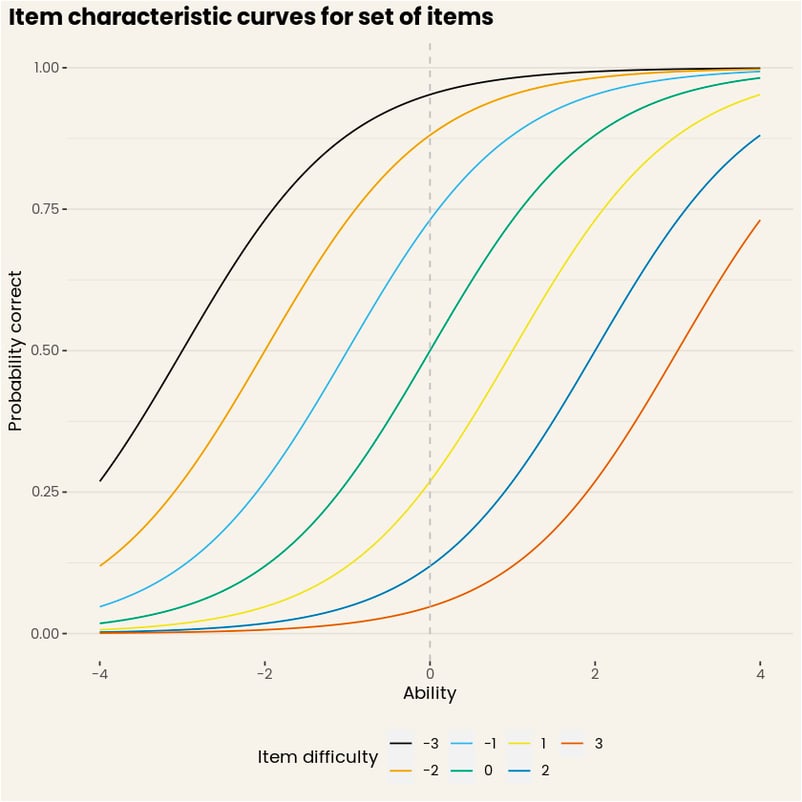
图 2:一组题目的项目特征曲线。(来源:DataCamp Workspace)
我们做一个小型模拟来展示这确实成立。为保证分数分布平滑,我们将题目扩展到总计 61 道,难度仍在 -3 到 3 之间。令 1000 名(假设的)真实能力为 0 的用户,要么作答 30 道难度在 -3 到 0 之间的题(“简单”测验),要么作答 30 道难度在 0 到 3 之间的题(“困难”测验)。我们可以用两种方式汇总结果:30 题中答对的总数,或基于 IRT 模型估计的能力水平。不出所料,模拟结果显示,简单测验的平均正确题数为 24,而困难测验仅为 6(见图 3)。尽管这个例子略显理想化,但设想您把这两套试卷发给班上的学生,并以答对数来量化表现。其实没有任何学生比其他人更好,但显然,按答对数划分会产生两组截然不同的“学生”!
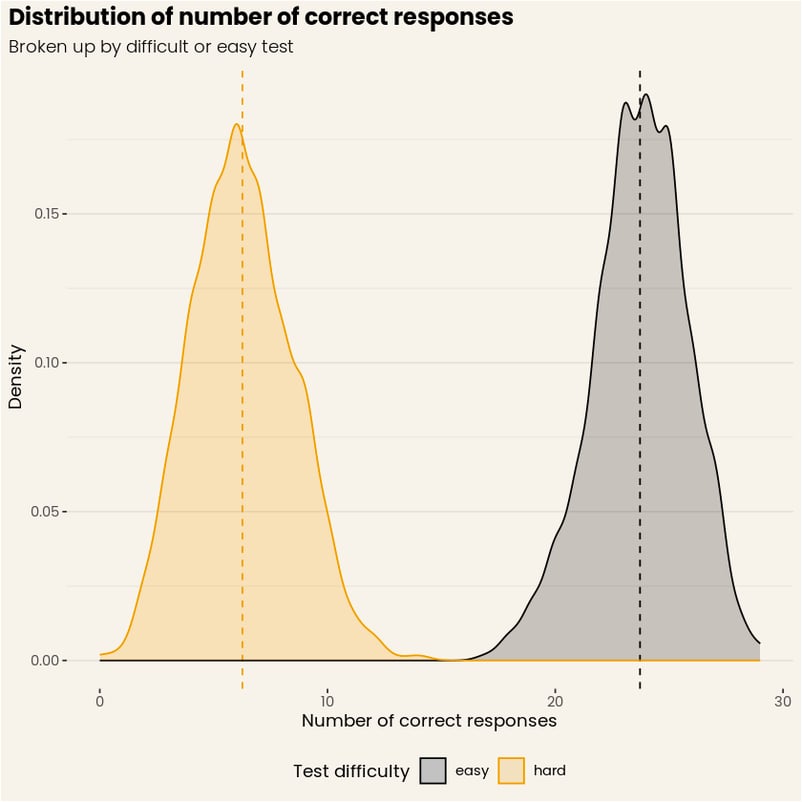
图 3:模拟的简单与困难测验的答对题数分布。(来源:DataCamp Workspace)
图 3 与图 4 形成鲜明对比:图 4 中估计能力的分布高度重叠,且各自均值几乎完美地居于零点!其主要原因在于,我们在计算能力时考虑了题目的难度。再次强调,这个例子略为理想化,但它展示了 IRT 的威力,以及其将个体与题目对作答结果的贡献加以区分的能力。应用到您的课堂上,这种方法当然仍会呈现表现差异,但至少不会再人为地分成两组学生!
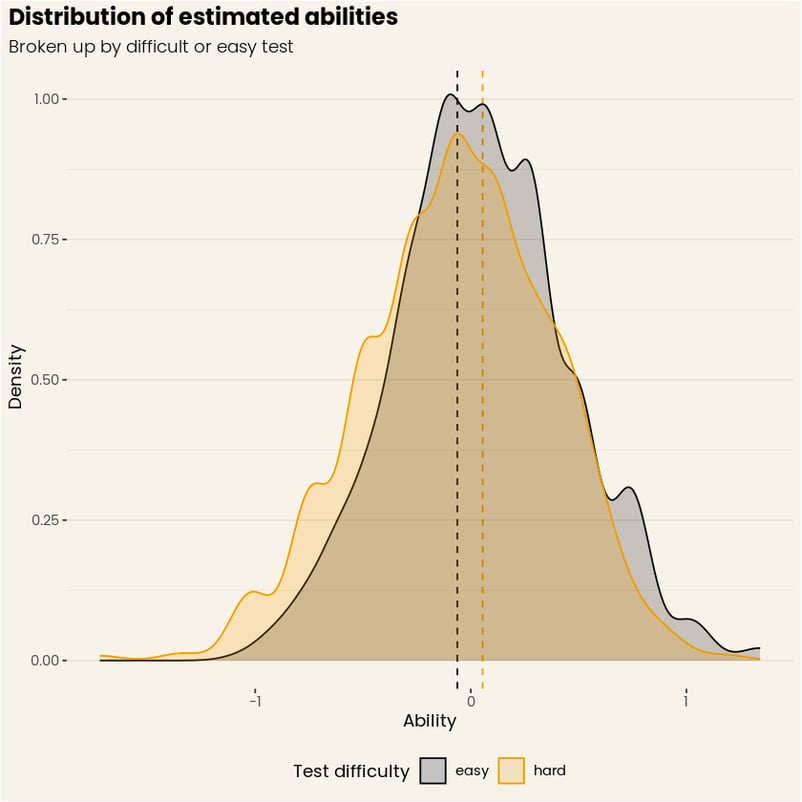
图 4:模拟的简单与困难测验的估计能力分布。(来源:DataCamp Workspace)
结语
总之,IRT 使我们能够创建大量不同的题目,并向您呈现其中的子集,同时仍能准确计算您的分数,而不会牺牲测验的安全性与质量!更进一步,IRT 还允许我们根据您在测试中的表现,量身定制呈现题目的方式。没错,每份测试都不同,因为我们会自适应地决定您接下来应该拿到哪道题!这让我们可以在不降低精度的前提下缩短测试时间。至于更多细节,请关注下一篇博文!现在就去参加一次测评或获取认证吧!;)
[本文中的图形由 DataCamp Workspace 生成——我们的云端笔记本,开箱即用。在这里查看 Workspace,欢迎评论或亲自试用!]
您可能对在大学或学院参加考试的经历记忆犹新,考后还会讨论自己拿到的题目是否比同学的更难。或者,您也许记得重考时觉得试卷比上一次容易。那么,分数更高是因为试卷更简单,还是因为您学得更多了?
这正触及如何衡量一个人在某个领域的知识、技能和能力的核心问题。设计考试的典型做法,是拟定一组题目,发给学生作答,将每题判定为对/错,然后统计所有题目中答对的数量。最终分数就被视为学生知识水平的量化指标,用来决定是否通过考试。
在 DataCamp,我们也提供类似的体验。用户可以通过我们的测评来评估自己在特定领域(例如 SQL 的数据管理)的表现——登录并在此处试一试!同样,在DataCamp 认证中,用户需要先通过一系列考试,才能获得认证。
经典测验理论
测验开发的核心是一个名为经典测验理论(CTT)的测量框架。其基础等式如下:
X = T + E
其中 X 为观测到的测验分数,T 为真实分数,E 为误差项。这个等式的含义是,任何观测分数都是一个人的真实分数与某种非系统性误差的混合。这种方法很适合于这样的场景:您希望在同一时间点,用同一套固定题目来测量一组人(例如您班上的所有学生)在某一领域的水平。举例来说,如果您开发了一套用于考察 SQL 技能的试题,CTT 是分析该测验质量的良好框架。
然而,DataCamp 可以被视为一个全球性的巨大课堂,学习者可以 24/7 随时在自己感兴趣的领域进行自我测评或尝试获得认证。
在我们的环境中,若仅依赖 CTT 来保证测验质量,很快就会遇到问题。
鉴于我们同时提供测评和 DataCamp 认证,目标是在特定领域量化用户的知识、技能与能力,我们不可能对所有人反复使用相同的 15 道题。这会让测验极易受到题目泄露与重考记忆的影响,分数也会随着时间推移而失去意义。
使用项目反应理论
一个简单的修正方法是增加可展示给用户的题目数量,和/或持续更新抽题池。然而,CTT 只考虑个体的真实分数,对题目本身却只字未提!当我们无法确定连续两次测试中的题目难度是否可比时,如何估计一个人的得分呢?
引入:项目反应理论(IRT)。IRT 是一种测量框架,其中对单道题的观测分数(例如对/错)被假定为个体能力与题目难度之间概率性相互作用的结果。形式化地表示为:
该模型也称为一参数逻辑模型(1-PL)或 Rasch 模型。出于估计的考虑,通常假设能力服从以 0 为中心、标准差为 1 的正态分布。由此得到的量表以标准差为单位,通常在 -4 到 4 之间变化(因为正态分布在此范围内覆盖了 99.99% 以上的概率质量)。别担心,这个范围可以按需转换!例如,在 DataCamp 中,-3.33 对应 0 分,0 对应 100 分,3.33 对应 200 分。将该等式固定在某道题(此处设为 0),并将能力在 -4 到 4 之间变化,可以得到如下曲线:
图 1:难度为 0 的题目的项目特征曲线。(来源:DataCamp Workspace)
这条曲线也称为项目特征曲线,表示在各个能力水平下,预计能正确作答该题的概率。题库中的每道题都由这样一条曲线表征,所有曲线的集合能够完整表达任何人的预期测验表现。项目特征曲线的妙处在于:给定不同的个体能力,您可以直观把握在某道题上的预期表现!
DataCamp 中的 IRT 实践
现在让我们来验证最初的动机!IRT 对 DataCamp 有何用处?下图展示了一个包含 7 道难度不同的假设题集。假设我们在两次不同的测验中,分别向同一人(能力为平均水平)展示最容易的三道题与最难的三道题。沿着曲线可以看出,简单试卷上预计答对题数约为 2.5(即将各题的正确概率相加),而困难试卷上预计仅约为 0.875!直白地说,如果只看答对数,在简单试卷上的表现几乎是困难试卷的三倍。但关键在于,IRT 允许我们基于作答是否正确及相应的题目难度来估计能力得分。这样,我们在两种情况下都能较为准确地还原出 0 的能力分(当然,具体会随测验长度产生一定测量误差)。
图 2:一组题目的项目特征曲线。(来源:DataCamp Workspace)
我们做一个小型模拟来展示这确实成立。为保证分数分布平滑,我们将题目扩展到总计 61 道,难度仍在 -3 到 3 之间。令 1000 名(假设的)真实能力为 0 的用户,要么作答 30 道难度在 -3 到 0 之间的题(“简单”测验),要么作答 30 道难度在 0 到 3 之间的题(“困难”测验)。我们可以用两种方式汇总结果:30 题中答对的总数,或基于 IRT 模型估计的能力水平。不出所料,模拟结果显示,简单测验的平均正确题数为 24,而困难测验仅为 6(见图 3)。尽管这个例子略显理想化,但设想您把这两套试卷发给班上的学生,并以答对数来量化表现。其实没有任何学生比其他人更好,但显然,按答对数划分会产生两组截然不同的“学生”!
图 3:模拟的简单与困难测验的答对题数分布。(来源:DataCamp Workspace)
图 3 与图 4 形成鲜明对比:图 4 中估计能力的分布高度重叠,且各自均值几乎完美地居于零点!其主要原因在于,我们在计算能力时考虑了题目的难度。再次强调,这个例子略为理想化,但它展示了 IRT 的威力,以及其将个体与题目对作答结果的贡献加以区分的能力。应用到您的课堂上,这种方法当然仍会呈现表现差异,但至少不会再人为地分成两组学生!
图 4:模拟的简单与困难测验的估计能力分布。(来源:DataCamp Workspace)
结语
总之,IRT 使我们能够创建大量不同的题目,并向您呈现其中的子集,同时仍能准确计算您的分数,而不会牺牲测验的安全性与质量!更进一步,IRT 还允许我们根据您在测试中的表现,量身定制呈现题目的方式。没错,每份测试都不同,因为我们会自适应地决定您接下来应该拿到哪道题!这让我们可以在不降低精度的前提下缩短测试时间。至于更多细节,请关注下一篇博文!现在就去参加一次测评或获取认证吧!;)
[本文中的图形由 DataCamp Workspace 生成——我们的云端笔记本,开箱即用。在这里查看 Workspace,欢迎评论或亲自试用!]