Du erinnerst dich vielleicht noch gut an Uni-Klausuren und daran, dass man danach diskutiert hat, ob die eigenen Aufgaben schwerer waren als die der anderen. Oder du hast eine Wiederholungsprüfung geschrieben und sie als einfacher empfunden. War die bessere Note dem leichteren Test geschuldet oder hast du einfach mehr gelernt?
Genau hier zeigt sich die Herausforderung, Wissen, Kompetenzen und Fähigkeiten in einem Fachgebiet zu messen. Ein typischer Ansatz für Prüfungen: Man erstellt einen Fragenkatalog, legt ihn den Lernenden vor, bewertet jede Frage als richtig/falsch und zählt die richtigen Antworten. Diese Endpunktzahl soll dann das Wissen einer Person quantifizieren und darüber entscheiden, ob sie besteht oder durchfällt.
Bei DataCamp bieten wir etwas Ähnliches an. Nutzerinnen und Nutzer können mit unseren Assessments messen, wie gut sie in einem bestimmten Bereich sind (z. B. Data Management in SQL) – melde dich an und probiere eines hier aus! Auch für die DataCamp Certification gilt: Zuerst müssen mehrere Prüfungen bestanden werden, um ein Zertifikat zu erhalten.
Klassische Testtheorie
Im Kern der Testentwicklung steht die sogenannte klassische Testtheorie (CTT). Die grundlegende Gleichung lautet:
X = T + E
Dabei ist X der beobachtete Testwert, T der wahre Wert und E die Fehlerkomponente. Diese Gleichung besagt, dass jeder beobachtete Score eine Mischung aus dem wahren Wert einer Person und einem nicht-systematischen Fehler ist. Dieser Ansatz eignet sich gut, wenn man eine Gruppe von Personen (z. B. alle Studierenden in einem Kurs) zu einem Zeitpunkt mit demselben festen Fragenkatalog prüfen möchte. Hast du zum Beispiel einen Test zu SQL-Kompetenzen entwickelt, ist CTT ein gutes Rahmenwerk, um die Testqualität zu analysieren.
DataCamp lässt sich jedoch als ein riesiges, weltweites Klassenzimmer verstehen, in dem Lernende rund um die Uhr ihre Kompetenzen in einem Fach ihrer Wahl prüfen oder eine Zertifizierung anstreben können.
In diesem Umfeld stoßen wir schnell an Grenzen, wenn wir uns allein auf CTT verlassen wollen, um die Testqualität sicherzustellen.
Da wir sowohl Assessments als auch DataCamp Certifications anbieten und dabei Wissen, Kompetenzen und Fähigkeiten in einem bestimmten Bereich quantifizieren wollen, können wir nicht allen immer wieder dieselben 15 Fragen stellen. Das würde Tests anfällig machen für geleakte Inhalte und reines Auswendiglernen bei Wiederholungen. Die Scores würden mit der Zeit an Aussagekraft verlieren.
Einsatz der Item-Response-Theory
Eine einfache Lösung wäre, die Anzahl potenzieller Fragen zu erhöhen und/oder den Fragenpool kontinuierlich zu erneuern. Allerdings betrachtet CTT nur den wahren Wert einer Person und sagt nichts über die Eigenschaften der Fragen aus! Wie können wir die Fähigkeit einer Person schätzen, wenn wir nicht wissen, ob die Fragen zwischen zwei Tests gleich schwer waren?
Hier kommt die Item-Response-Theory (IRT) ins Spiel. IRT ist ein Messrahmen, bei dem der beobachtete Score auf einer einzelnen Frage (z. B. richtig/falsch) als Ergebnis eines probabilistischen Zusammenspiels zwischen der Fähigkeit einer Person und der Schwierigkeit eines Items angenommen wird. Formal ausgedrückt:
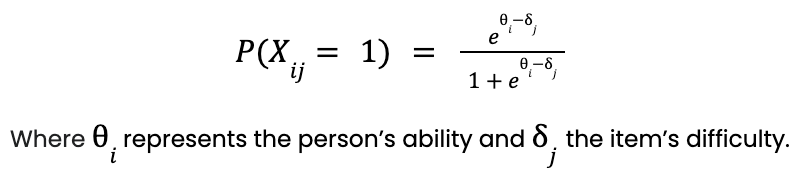
Dieses Modell ist auch als Ein-Parameter-Logistikmodell (1-PL) oder Rasch-Modell bekannt. Aus Gründen der Schätzung werden Fähigkeiten als normalverteilt mit Mittelwert 0 und Standardabweichung 1 angenommen. Dadurch entsteht eine Skala in Standardabweichungen, die typischerweise zwischen -4 und 4 liegt (weil mehr als 99,99% der Normalverteilung in diesem Bereich liegen). Keine Sorge, diese Skala lässt sich beliebig transformieren! Bei DataCamp entspricht zum Beispiel -3,33 einem Score von 0, 0 einem Score von 100 und 3,33 einem Score von 200. Fixiert man die Gleichung für ein bestimmtes Item (hier bei 0) und variiert die Fähigkeit zwischen -4 und 4, erhält man folgende Kurve:
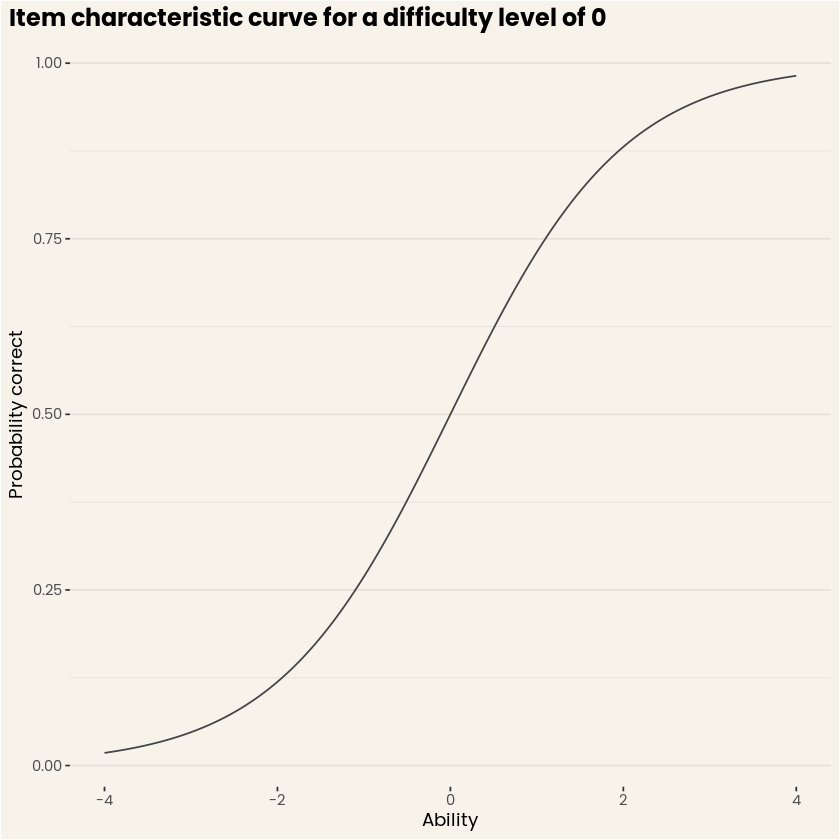
Abbildung 1. Item-Charakteristik-Kurve für ein Item mit Schwierigkeitsgrad 0. (Quelle: DataCamp Workspace)
Diese Kurve, die sogenannte Item-Charakteristik-Kurve, zeigt für jedes Fähigkeitsniveau die erwartete Wahrscheinlichkeit, das Item korrekt zu beantworten. Jedes Item im Pool wird durch eine solche Kurve beschrieben, und das Set aller Kurven lässt die erwartete Testleistung für jede Person vollständig abbilden. Das Schöne daran: Man erhält ein gutes Gefühl dafür, welche Performance auf einem Item bei unterschiedlichen Fähigkeiten zu erwarten ist.
So nutzen wir IRT bei DataCamp
Kehren wir zu unserer Ausgangsfrage zurück: Welchen Nutzen hat IRT für DataCamp? Die folgende Abbildung zeigt ein hypothetisches Set von 7 Fragen mit unterschiedlichen Schwierigkeitsgraden. Nehmen wir an, wir zeigen derselben Person in zwei Sitzungen einmal die drei einfachsten und einmal die drei schwierigsten Fragen – bei durchschnittlicher Fähigkeit. Aus den Kurven lässt sich ablesen: Im einfachen Test wäre die erwartete Anzahl richtiger Antworten etwa 2,5 (Summe der Einzelwahrscheinlichkeiten), im schweren Test dagegen nur rund 0,875! Mit Blick auf die reinen Trefferzahlen wäre das im leichten Test fast dreimal so gut. Der Clou: IRT ermöglicht es, eine Fähigkeit basierend auf Richtigkeit der Antwort und dem zugehörigen Schwierigkeitsgrad zu schätzen. So können wir in beiden Fällen korrekt eine Fähigkeit von 0 rekonstruieren (mit etwas Messfehler je nach Testlänge).
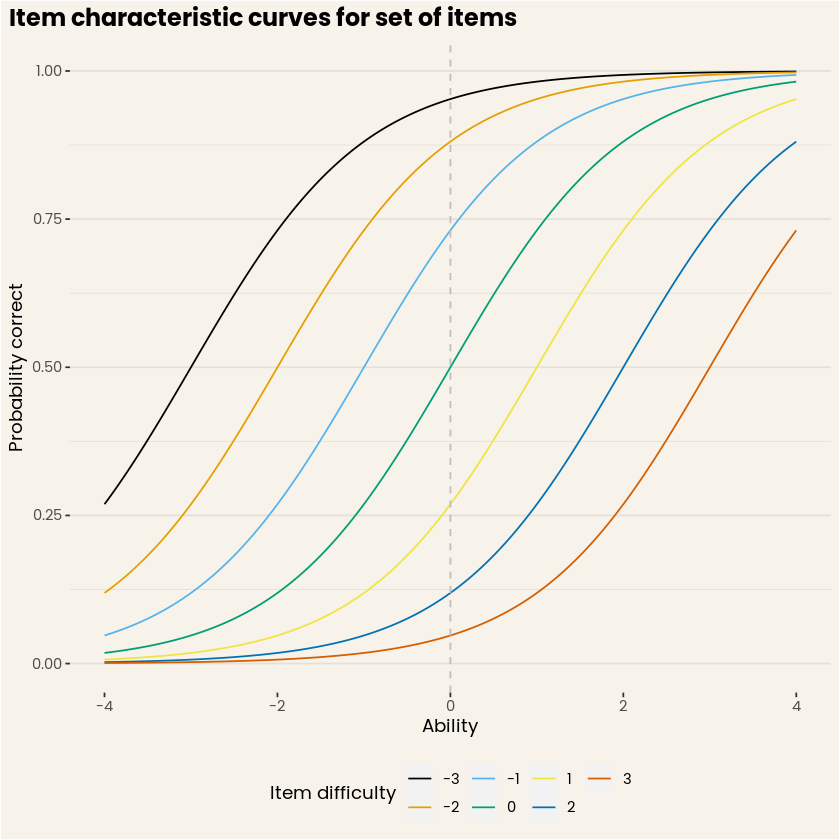
Abbildung 2. Item-Charakteristik-Kurven für eine Gruppe von Items. (Quelle: DataCamp Workspace)
Lass uns eine kleine Simulation durchspielen, um das zu veranschaulichen. Für eine glatte Score-Verteilung erweitern wir den Item-Pool auf insgesamt 61 Items, weiterhin mit Schwierigkeitsgraden von -3 bis 3. Wir lassen 1000 (hypothetische) Nutzerinnen und Nutzer mit einem wahren Wert von 0 entweder 30 Items von -3 bis 0 (der „einfache“ Test) oder 30 Items von 0 bis 3 (der „schwere“ Test) beantworten. Die Ergebnisse lassen sich auf zwei Arten zusammenfassen: über die Anzahl richtiger Antworten von 30 oder über die geschätzte Fähigkeit auf Basis des IRT-Modells. Wenig überraschend liefert die Simulation im einfachen Test im Mittel 24 richtige Fragen und im schweren Test nur 6 (siehe Abbildung 3). Überträgst du diese beiden Testformen in dein Klassenzimmer und nutzt die Zahl der richtigen Antworten als Leistungsmaß, entstehen zwei vollkommen unterschiedliche Gruppen – obwohl niemand objektiv besser ist als der andere.
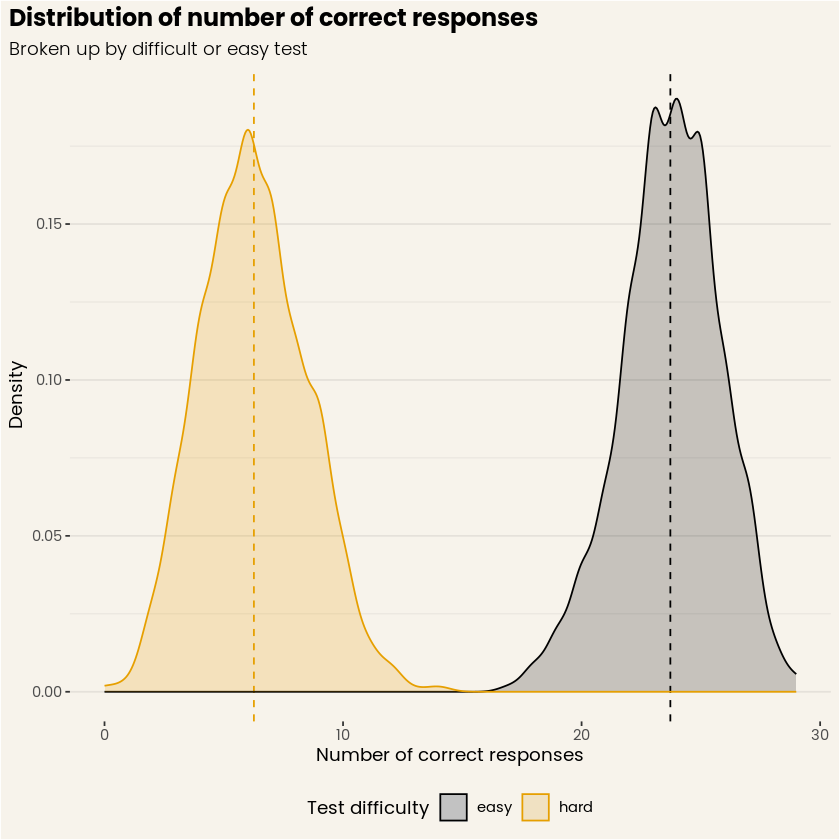
Abbildung 3. Verteilung der Anzahl richtiger Antworten in simulierten einfachen und schweren Tests. (Quelle: DataCamp Workspace)
Abbildung 3 steht im deutlichen Gegensatz zu Abbildung 4: Dort überlappen sich die Verteilungen der geschätzten Fähigkeiten stark, und beide Mittelwerte liegen nahezu perfekt bei null! Der Hauptgrund: Bei der Fähigkeitsschätzung berücksichtigen wir die Schwierigkeit der Fragen. Auch wenn das Beispiel konstruiert ist, zeigt es die Stärke von IRT und die Fähigkeit, den Einfluss von Person und Item auf die Antworten zu entflechten. Auf dein Klassenzimmer übertragen würde es weiterhin Leistungsunterschiede geben, aber die künstliche Teilung in zwei Gruppen verschwindet.
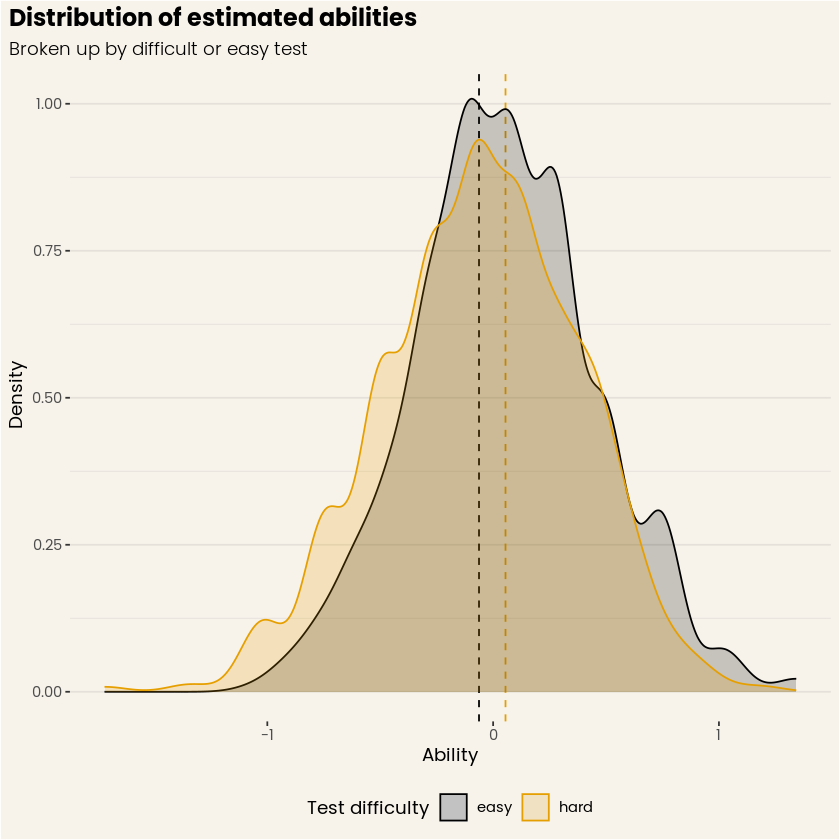
Abbildung 4. Verteilung der geschätzten Fähigkeiten für beide simulierten Testvarianten. (Quelle: DataCamp Workspace)
Fazit
Kurz gesagt: IRT ermöglicht es uns, sehr viele unterschiedliche Fragen zu erstellen und dir jeweils nur einen Teil davon zu zeigen – während wir deinen Score trotzdem präzise berechnen, ohne Sicherheit und Qualität unserer Tests zu gefährden. Mehr noch: IRT erlaubt es, Fragen passend zu deinem aktuellen Leistungsniveau zu präsentieren. Ja, jedes Assessment fällt etwas anders aus, weil wir die nächste Frage adaptiv auswählen! So werden Tests kürzer, ohne an Präzision zu verlieren. Mehr dazu im nächsten Blogpost. Starte jetzt ein Assessment oder hol dir dein Zertifikat! ;)
[Die Abbildungen in diesem Blogpost wurden mit DataCamp Workspace erstellt, unserem Cloud-Notebook, das einfach funktioniert. Schau es dir hier an, kommentiere es gern oder experimentiere selbst damit!]



