Je herinnert je vast nog hoe je na een tentamen op de universiteit of hogeschool met anderen besprak of jouw vragen moeilijker waren dan die van je medestudenten. Of misschien deed je een herkansing die makkelijker aanvoelde dan het vorige examen. Was je hogere cijfer te danken aan een makkelijker examen, of had je gewoon beter gestudeerd?
Dit raakt de kern van wat het betekent om iemands kennis, vaardigheden en competenties binnen een domein te meten. Een typische aanpak bij het ontwerpen van een examen is: bedenk een set vragen, leg ze voor aan je studenten, scoor elke vraag als goed/fout en tel vervolgens het aantal goed beantwoorde vragen. Deze eindscore zou dan een kwantificatie van de kennis van de student moeten zijn, op basis waarvan je bepaalt of iemand slaagt of zakt.
Bij DataCamp bieden we een vergelijkbare ervaring. Gebruikers kunnen met onze assessments meten hoe goed ze het doen in een bepaald domein (bijv. Data Management in SQL) – log in en probeer er hier een! Evenzo moeten gebruikers binnen DataCamp Certification eerst een reeks examens halen om een certificaat te behalen.
Classical Test Theory
De kern van toetsontwikkeling is een meetkader dat classical test theory (CTT) heet. De klassieke vergelijking achter CTT is de volgende:
X = T + E
waarbij X de geobserveerde testscore is, T de ware score en E een foutcomponent. Deze vergelijking zegt dat elke geobserveerde score een mix is van iemands ware score en een niet-systematische foutcomponent. Deze aanpak werkt goed wanneer je een groep mensen (bijv. alle studenten in je klas) op een domein wilt meten met dezelfde, vaste set vragen op één moment in de tijd. Stel dat je een set vragen ontwikkelt om iemands SQL-vaardigheden te peilen, dan is CTT een goed kader om de kwaliteit van die toets te analyseren.
DataCamp kun je echter zien als één groot wereldwijd klaslokaal, waar studenten zichzelf 24/7 kunnen toetsen op een domein dat hen interesseert of een certificering kunnen proberen te behalen.
In onze omgeving lopen we al snel tegen problemen aan als we op CTT vertrouwen om de kwaliteit van onze toetsen te garanderen.
Omdat we zowel assessments als DataCamp Certifications aanbieden, waarbij we de kennis, vaardigheden en competenties van een gebruiker in een specifiek domein willen kwantificeren, kunnen we niet simpelweg iedereen steeds dezelfde 15 vragen stellen. Dat zou onze toetsen erg kwetsbaar maken voor uitgelekte vragen en voor het uit het hoofd leren van vragen bij een herkanstoets. Scores zouden na verloop van tijd betekenisloos worden.
Item Response Theory gebruiken
Een eenvoudige oplossing is om het aantal vragen dat we aan een gebruiker kunnen tonen te vergroten en/of de pool van vragen waaruit we kunnen samplen continu te vernieuwen. Maar CTT kijkt alleen naar iemands ware score en zegt helemaal niets over de vragen zelf! Hoe kunnen we iemands score schatten als we niet weten of de vragen in opeenvolgende toetsen vergelijkbaar moeilijk waren?
Enter: Item response theory (IRT). IRT is een meetkader waarin de geobserveerde score op een enkele vraag (bijv. goed/fout) wordt gezien als het resultaat van een probabilistische wisselwerking tussen iemands vaardigheid en de moeilijkheid van een item. Formeel gesteld:
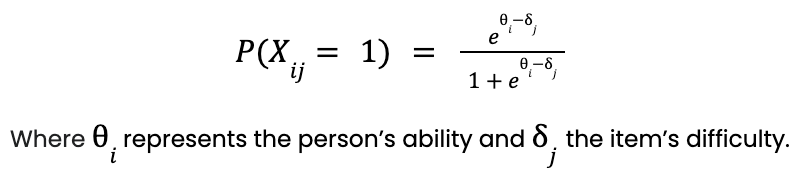
Dit model staat ook bekend als het one-parameter logistic model (1-PL) of Rasch-model. Voor schattingsdoeleinden wordt aangenomen dat vaardigheden normaal verdeeld zijn met gemiddelde 0 en standaarddeviatie 1. Dit levert een schaal op in standaarddeviaties die typisch varieert tussen -4 en 4 (omdat meer dan 99,99% van de normale verdeling binnen dit bereik valt). Geen zorgen, je kunt dit bereik naar wens transformeren! Bij DataCamp komt -3,33 bijvoorbeeld overeen met een score van 0, 0 met 100 en 3,33 met 200. Als je deze vergelijking fixeert voor een specifiek item (in dit geval op 0) en de vaardigheid laat variëren tussen -4 en 4, krijg je de volgende curve:
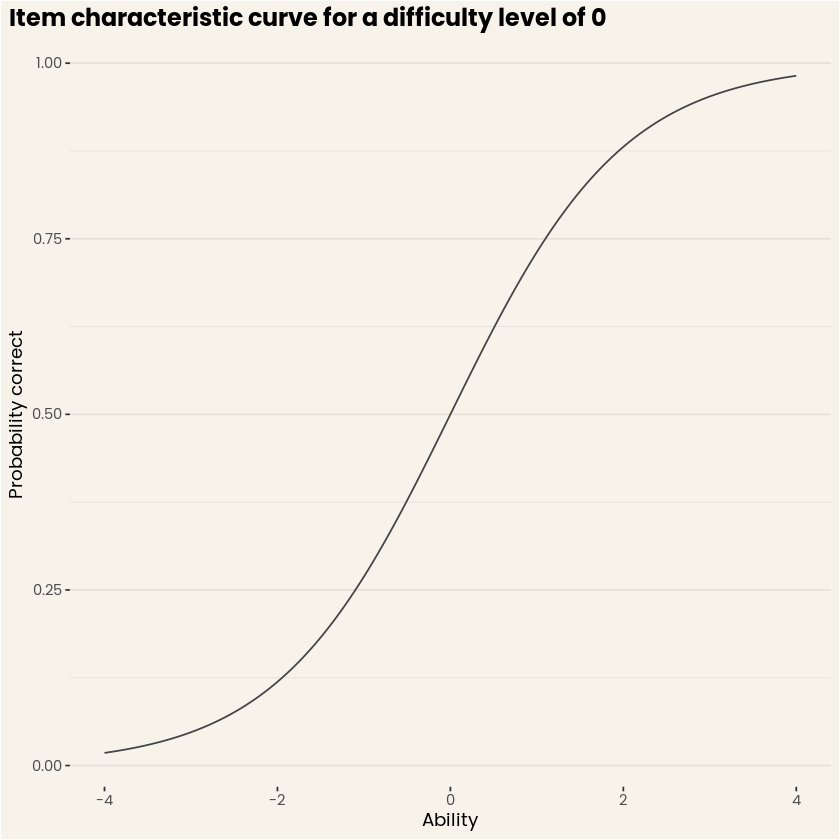
Figuur 1. Itemkenmerkencurve voor een item met moeilijkheidsniveau 0. (Bron: DataCamp Workspace)
Deze curve heet ook wel de itemkenmerkencurve en geeft voor elk vaardigheidsniveau de verwachte kans weer om dat item correct te beantwoorden. Elk item in een pool wordt gekarakteriseerd door zo’n curve, en de verzameling van alle curves beschrijft volledig de verwachte testprestatie voor elke persoon. Het mooie van itemkenmerkencurves is dat je een intuïtie krijgt over welke prestatie je op een item mag verwachten, gegeven verschillende vaardigheidsniveaus!
IRT bij DataCamp
Laten we onze oorspronkelijke motivatie toetsen! Wat heeft IRT DataCamp te bieden? De figuur hieronder toont een hypothetische set van 7 vragen met verschillende moeilijkheidsniveaus. Stel dat we dezelfde persoon in twee verschillende testsessies de drie makkelijkste en de drie moeilijkste vragen tonen, in dit geval iemand met een gemiddelde vaardigheid. Het is duidelijk uit de curves af te leiden dat het verwachte aantal goede antwoorden in de makkelijke test ongeveer 2,5 zou zijn (de som van de individuele kansen), terwijl dit voor de moeilijke test neerkomt op ongeveer 0,875! Met andere woorden: bijna drie keer beter op de makkelijke test als je alleen naar het aantal goede antwoorden kijkt. Maar hier zit de kracht: IRT stelt ons in staat een vaardigheidsscore te schatten op basis van de juistheid van het antwoord en het bijbehorende moeilijkheidsniveau. Zo kunnen we in beide gevallen correct een vaardigheidsscore van 0 terugvinden (met enige meetfout afhankelijk van de testlengte).
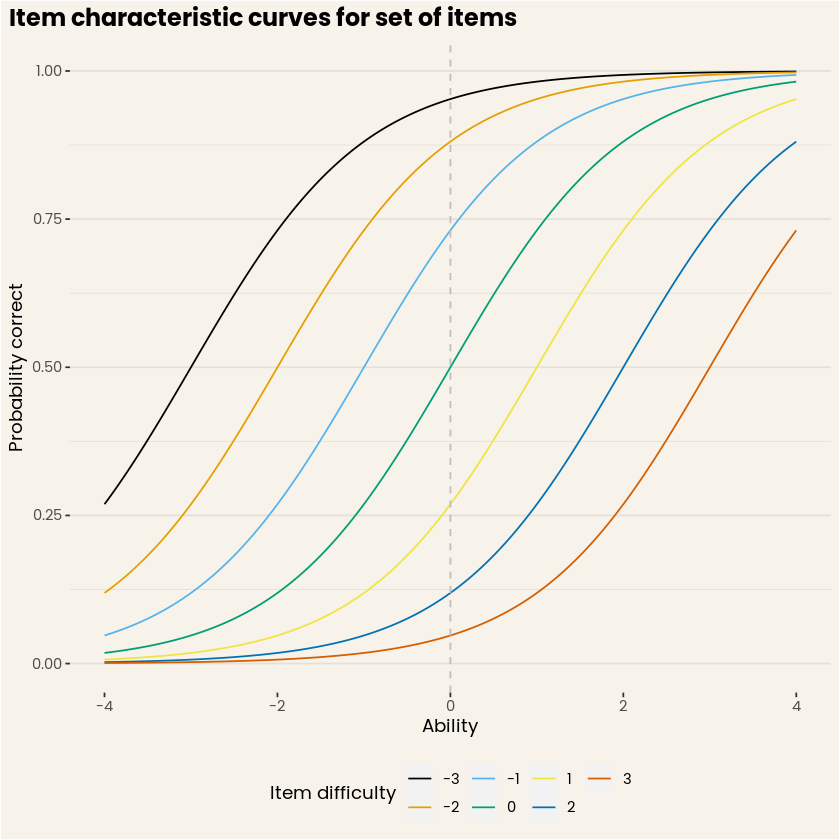
Figuur 2. Itemkenmerkencurves voor een set items. (Bron: DataCamp Workspace)
Laten we een kleine simulatie doen om te laten zien dat dit inderdaad zo werkt. Om een vloeiende verdeling van testscores te verzekeren, breiden we de set items uit tot in totaal 61, nog steeds variërend in moeilijkheid van -3 tot 3. We laten 1000 (hypothetische) gebruikers met een ware score van 0 óf 30 items beantwoorden die variëren van -3 tot 0 (de “makkelijke” test), óf 30 items van 0 tot 3 (de “moeilijke” test). We kunnen de resultaten op twee manieren samenvatten: met het totale aantal goede items van 30, of met het geschatte vaardigheidsniveau op basis van het IRT-model. Niet verrassend levert de simulatie gemiddeld 24 goede vragen op in de makkelijke test en slechts 6 goed in de moeilijke test (zie Figuur 3). Hoewel dit voorbeeld wat geconstrueerd is, kun je je voorstellen dat je deze twee testvormen aan studenten in je klas geeft en hun prestatie kwantificeert met het aantal goede antwoorden. Geen van je studenten is daadwerkelijk beter dan de ander, maar het is duidelijk dat het aantal goede antwoorden twee totaal verschillende groepen zou opleveren!
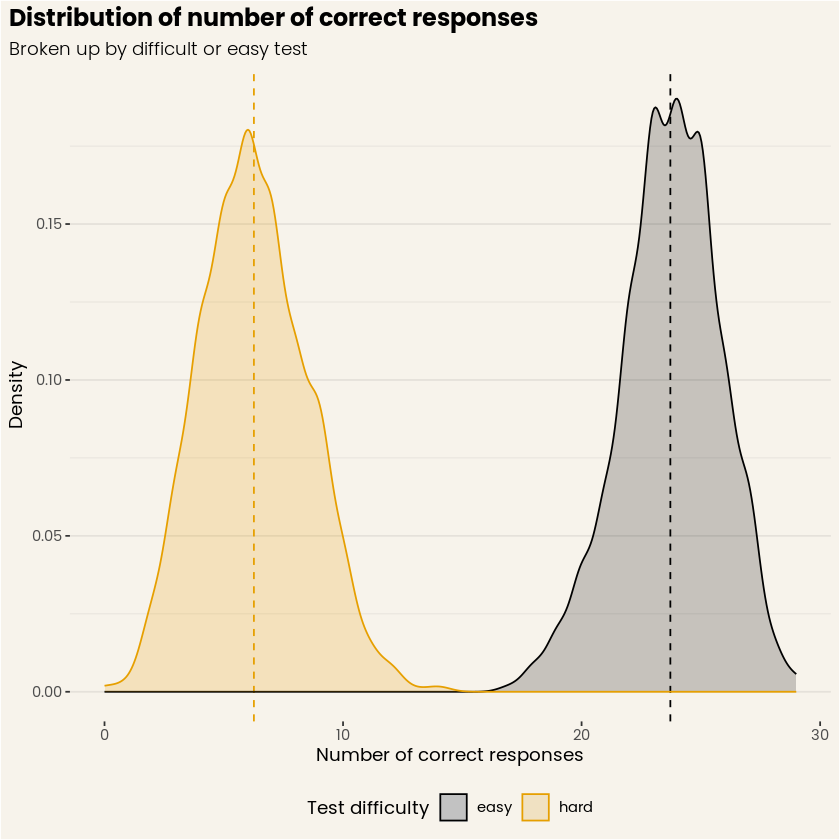
Figuur 3. Verdeling van het aantal goede antwoorden, voor gesimuleerde makkelijke en moeilijke tests. (Bron: DataCamp Workspace)
Figuur 3 staat in schril contrast met Figuur 4, waar de verdelingen van geschatte vaardigheden sterk overlappen en hun respectieve gemiddelden bijna perfect rond nul liggen! De belangrijkste reden is dat we rekening houden met de moeilijkheid van de vragen bij het berekenen van de vaardigheid. Opnieuw: dit is een wat geconstrueerd voorbeeld, maar het toont de kracht van IRT en het vermogen om bijdragen van persoon en item aan itemresponsen uit elkaar te halen. Toegepast op je klas studenten levert deze aanpak natuurlijk nog steeds variatie in prestaties op, maar in elk geval verdwijnen die twee kunstmatige groepen studenten!
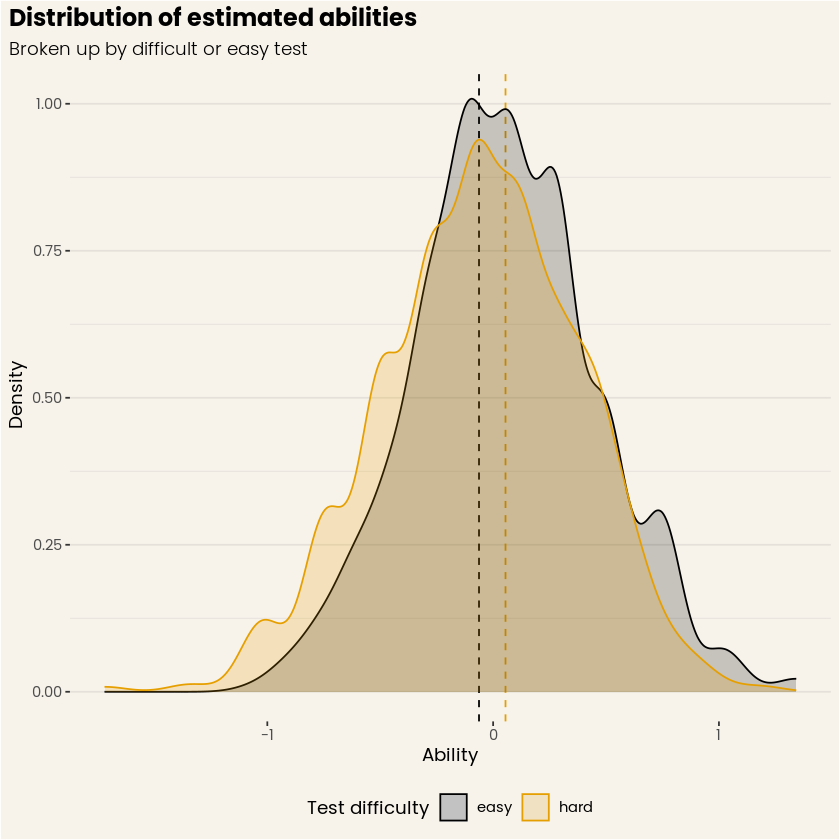
Figuur 4. Verdeling van geschatte vaardigheden, voor zowel gesimuleerde makkelijke als moeilijke tests. (Bron: DataCamp Workspace)
Tot slot
Kortom, IRT stelt ons in staat om heel veel verschillende vragen te maken en daar subsets van aan je te presenteren, terwijl we je score toch nauwkeurig berekenen en zonder de veiligheid en kwaliteit van onze toetsen in gevaar te brengen! Sterker nog, met IRT kunnen we vragen aanbieden die zijn afgestemd op hoe goed je het in de test doet. Ja, inderdaad: elke test is anders, omdat we adaptief bepalen welke vraag je krijgt! Zo kunnen we de test korter maken zonder in te leveren op nauwkeurigheid. Maar daarover meer in een volgende blogpost! Ga nu een assessment doen of haal je certificaat! ;)
[De figuren in deze blogpost zijn gegenereerd met DataCamp Workspace, onze cloud-notebook die gewoon werkt. Bekijk Workspace hier, laat gerust een reactie achter of experimenteer er zelf mee!]

