Üniversite ya da yüksekokulda sınavlara girdiğinizi ve sonrasında sizin sorularınızın diğer öğrencilerin sorularından daha zor olup olmadığını tartıştığınızı canlı biçimde hatırlıyor olabilirsiniz. Ya da bir bütünleme/gözetim sınavına girip onun öncekinden daha kolay olduğunu fark etmiş olabilirsiniz. Daha yüksek notunuz daha kolay bir sınavdan mı kaynaklandı, yoksa sadece daha çok mu çalıştınız?
Bu, bir kişinin bir alandaki bilgi, beceri ve yeteneklerini ölçmenin ne anlama geldiğinin özüne dokunur. Tipik bir sınav tasarlama yaklaşımı, bir dizi soru hazırlamak, bunları öğrencilerinize yöneltmek, her soruyu doğru/yanlış olarak puanlamak ve tüm sorular içinden doğru yanıtlananların sayısını saymaktır. Bu nihai puanın öğrencinin bilgisinin nicel bir ifadesi olduğu ve sınavı geçip geçmediğine karar vermek için kullanılacağı varsayılır.
DataCamp’te benzer bir deneyim sunuyoruz. Kullanıcılar, belirli bir alanda (ör. SQL’de Veri Yönetimi) ne kadar iyi olduklarını değerlendirmelerimizle ölçebilir—oturum açın ve bir tanesini buradan deneyin! Benzer şekilde, DataCamp Certification kapsamında kullanıcıların sertifika alabilmeleri için önce bir dizi sınavı geçmeleri gerekir.
Klasik Test Kuramı
Test geliştirme sürecinin merkezinde klasik test kuramı (CTT) adı verilen bir ölçme çerçevesi yer alır. CTT’nin temelindeki klasik denklem şöyledir:
X = T + E
Burada X gözlenen test puanı, T gerçek puan, E ise hata bileşenidir. Bu denklem, gözlenen her puanın bir kişinin gerçek puanının ve bazı sistematik olmayan hata bileşenlerinin bir karışımı olduğunu söyler. Bu yaklaşım, aynı, sabit bir soru setiyle ve tek bir zamanda bir grup insanı (ör. sınıfınızdaki tüm öğrenciler) bir alanda ölçmek istediğiniz durumlar için uygundur. Örneğin bir kişinin SQL becerilerini yoklayan bir soru seti geliştirdiğinizi varsayalım; CTT, o testin kalitesini analiz etmek için iyi bir çerçevedir.
Buna karşın DataCamp, öğrencilerin ilgi duydukları bir alanda kendilerini değerlendirebildikleri veya günün 24 saati, haftanın 7 günü sertifika almaya çalışabildikleri devasa, dünya çapında bir sınıf olarak düşünülebilir.
Bizim ortamımızda, testlerimizin kalitesini garanti altına almak için CTT’ye güvenmeye çalıştığımızda hızla sorunlarla karşılaşırız.
Belirli bir alanda kullanıcıların bilgi, beceri ve yeteneklerini nicelendirmeyi hedeflediğimiz hem değerlendirmeler hem de DataCamp Certification sunduğumuza göre, herkese aynı 15 soruyu tekrar tekrar soramayız. Bu, sızdırılan sorulara ve bir testi yeniden denerken soruları ezberlemeye karşı testlerimizi çok kırılgan hale getirir. Puanlar zamanla anlamını yitirir.
Madde Tepki Kuramını Kullanmak
Bunun basit bir çözümü, bir kullanıcıya gösterilebilecek soru sayısını artırmak ve/veya örneklenecek soru havuzunu sürekli yenilemektir. Ancak CTT yalnızca bir kişinin gerçek puanını dikkate alır ve sorular hakkında hiçbir şey söylemez! Ardışık testlerde soruların karşılaştırılabilir zorlukta olup olmadığını bilmediğimizde, bir kişinin puanına ilişkin bir tahmini nasıl elde edebiliriz?
İşte burada Madde Tepki Kuramı (IRT) devreye girer. IRT, tek bir sorudaki gözlenen puanın (ör. doğru/yanlış), bir kişinin yeteneği ile bir maddenin zorluğu arasındaki olasılıksal bir etkileşimin sonucu olduğunu varsayan bir ölçme çerçevesidir. Resmi olarak ifade edersek:
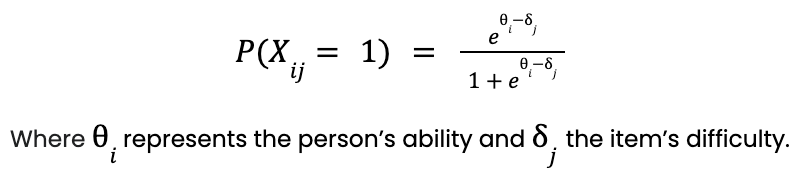
Bu model tek parametreli lojistik model (1-PL) ya da Rasch modeli olarak da bilinir. Tahmin nedenleriyle, yeteneklerin ortalaması 0 ve standart sapması 1 olan normal bir dağılıma uyduğu varsayılır. Bu, standart sapmalar cinsinden ifade edilen ve genellikle -4 ile 4 arasında değişen bir ölçekle sonuçlanır (normal dağılımın yüzde 99,99’undan fazlası bu aralıkta yer alır). Endişe etmeyin, bu aralığı istediğiniz herhangi bir şeye dönüştürebilirsiniz! Örneğin DataCamp’te -3,33, 0 puanına; 0, 100 puanına; 3,33 ise 200 puanına karşılık gelir. Bu denklemi belirli bir madde için (bu durumda 0’da) sabitleyip yeteneği -4 ile 4 arasında değiştirirseniz aşağıdaki eğriyi elde edersiniz:
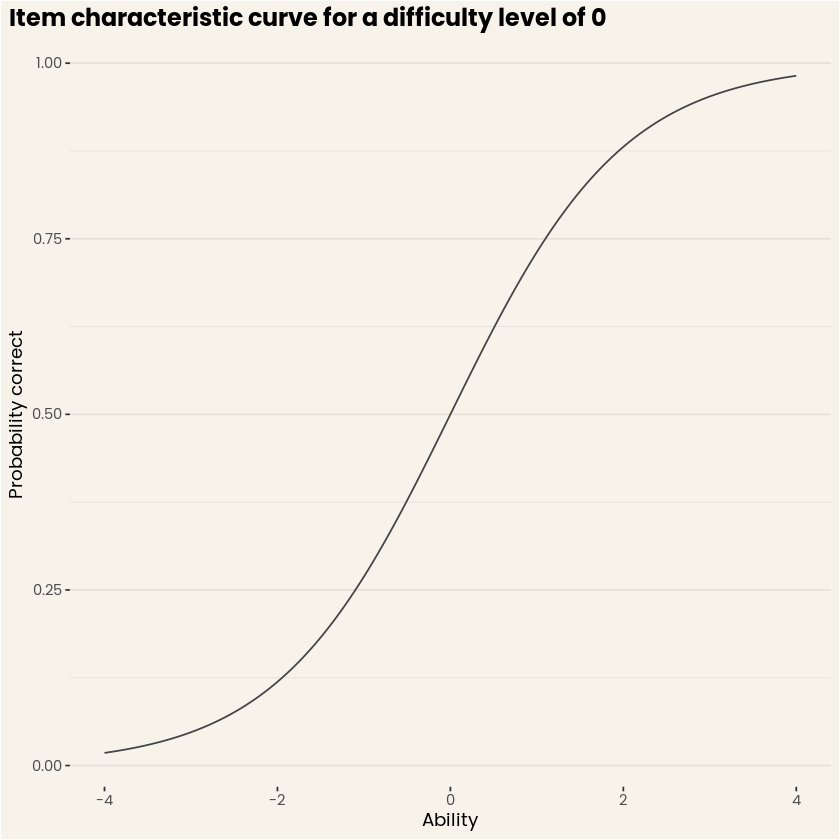
Şekil 1. Zorluk düzeyi 0 olan bir madde için madde karakteristik eğrisi. (Kaynak: DataCamp Workspace)
Bu eğri, madde karakteristik eğrisi olarak da bilinir ve her yetenek düzeyi için o maddeye doğru yanıt verme beklenen olasılığını ifade eder. Havuzdaki her madde böyle bir eğri ile tanımlanır ve tüm eğrilerin kümesi, herhangi bir kişi için beklenen test performansını bütünüyle ifade eder. Madde karakteristik eğrilerinin güzel yanı, farklı kişi yeteneklerine bağlı olarak bir maddede nasıl bir performans beklemeniz gerektiğine dair sezgi sağlamasıdır!
DataCamp’te IRT Kullanımı
Şimdi başlangıçtaki motivasyonumuzu teste tabi tutalım! IRT’nin DataCamp için ne faydası var? Aşağıdaki şekil, farklı zorluk düzeylerine sahip varsayımsal 7 soruluk bir seti gösteriyor. Diyelim ki aynı kişiye iki farklı oturumda en kolay üç soruyu ve en zor üç soruyu gösteriyoruz—bu kişi ortalama bir yetenek düzeyine sahip. Eğrileri izlemekten açıkça görüldüğü üzere, kolay testte beklenen doğru cevap sayısı yaklaşık 2,5 (tek tek olasılıkların toplamı) iken, zor testte bu yaklaşık 0,875’e karşılık gelir! Başka bir deyişle, yalnızca doğru tepkilere bakıldığında kolay testte performans neredeyse üç kat daha iyidir. Ama işin püf noktası şu: IRT, yanıtın doğruluğu ve buna karşılık gelen zorluk düzeyi temelinde bir yetenek puanı tahmin etmemize olanak tanır. Bu sayede, her iki durumda da doğru biçimde 0’lık bir yetenek puanını geri kazanabiliriz (test uzunluğuna bağlı bir miktar ölçme hatasıyla).
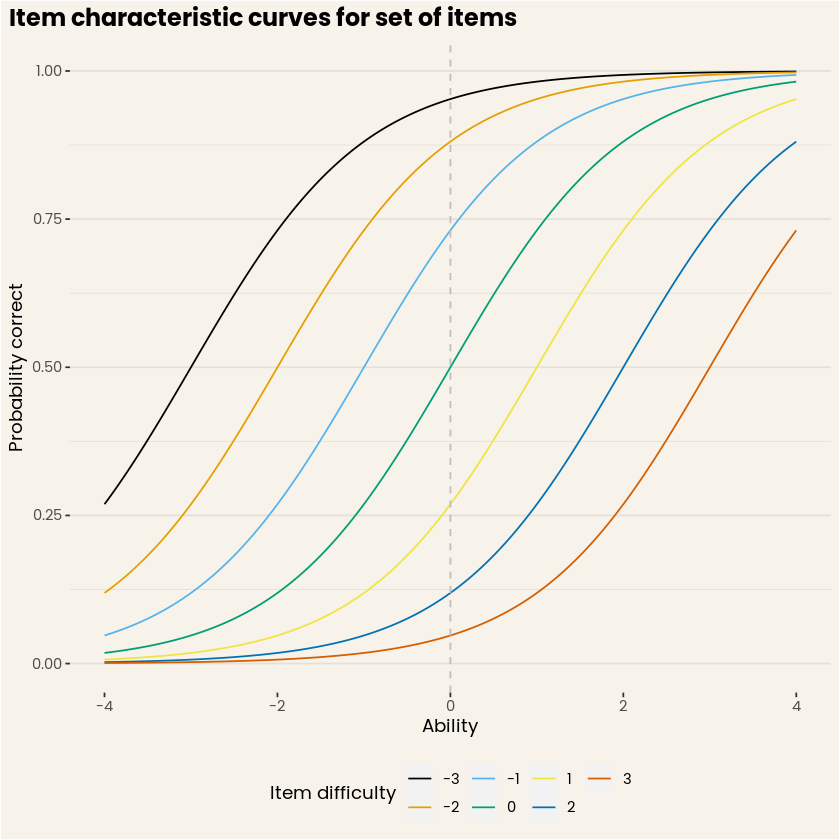
Şekil 2. Bir madde kümesi için madde karakteristik eğrileri. (Kaynak: DataCamp Workspace)
Bunun gerçekten böyle olduğunu göstermek için küçük bir benzetim (simülasyon) yapalım. Test puanlarının düzgün bir dağılımını sağlamak için madde setini toplam 61’e genişletiyoruz; zorluklar yine -3 ile 3 arasında. Gerçek puanları 0 olan 1000 (varsayımsal) kullanıcının, ya -3 ile 0 arasından seçilen 30 maddeye ("kolay" test) ya da 0 ile 3 arasından seçilen 30 maddeye ("zor" test) yanıt vermesini sağlıyoruz. Sonuçları iki şekilde özetleyebiliriz: 30 maddeden doğru yanıtlanan toplam madde sayısı ya da IRT modeline dayalı tahmini yetenek düzeyi. Şaşırtıcı olmayan biçimde, benzetim kolay testte ortalama 24 doğru, zor testte ise yalnızca 6 doğru üretir (bkz. Şekil 3). Bu örnek biraz yapay olmakla birlikte, sınıfınızdaki öğrencilere bu iki test formunu uyguladığınızı ve performansı nicelendirmek için doğru yanıt sayısını kullandığınızı hayal edin. Öğrencilerinizden hiçbiri gerçekte diğerinden daha iyi değildir, ancak doğru yanıt sayısının iki bütünüyle farklı öğrenci grubu ortaya çıkaracağı açıktır!
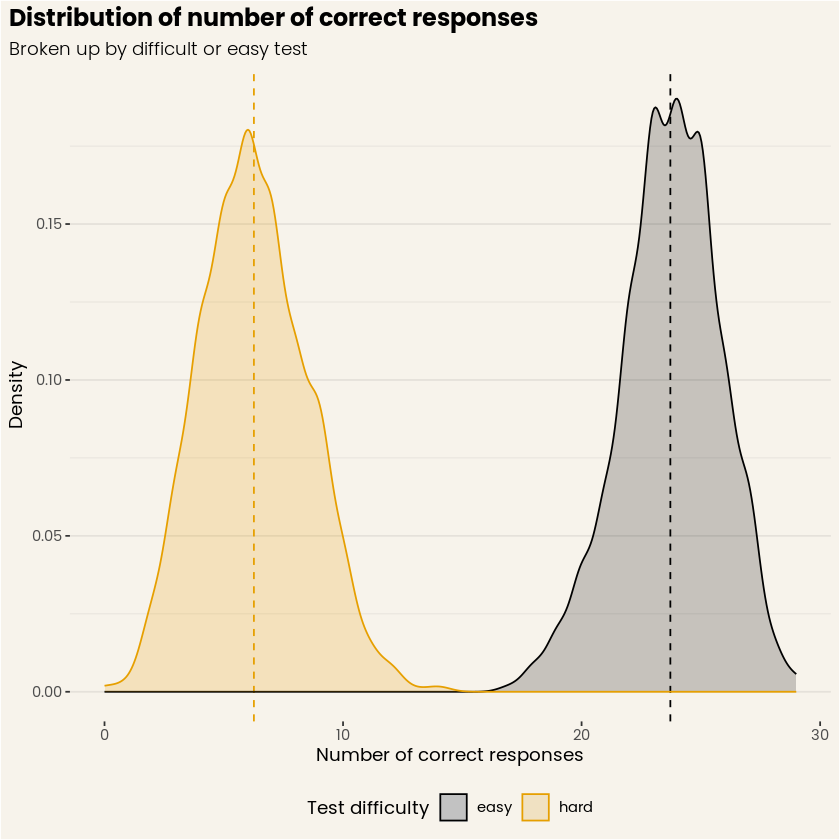
Şekil 3. Benzetimle oluşturulmuş kolay ve zor testlerde doğru yanıt sayısının dağılımı. (Kaynak: DataCamp Workspace)
Şekil 3, Şekil 4 ile çarpıcı bir tezat oluşturur; zira tahmini yeteneklerin dağılımları büyük ölçüde çakışır ve ortalamaları neredeyse kusursuz biçimde sıfırın etrafında toplanır! Bunun başlıca nedeni, yeteneği hesaplarken soruların zorluk düzeyini hesaba katmamızdır. Yine, bu bir miktar yapay bir örnektir; ancak IRT’nin gücünü ve madde tepkilerinde kişi ve madde katkılarını birbirinden ayırabilme kabiliyetini gösterir. Bunu sınıfınızdaki öğrencilere uyguladığınızda da elbette performansta bir varyasyon gözlenir; fakat en azından o iki öğrenci grubuna ayrışma ortadan kalkar!
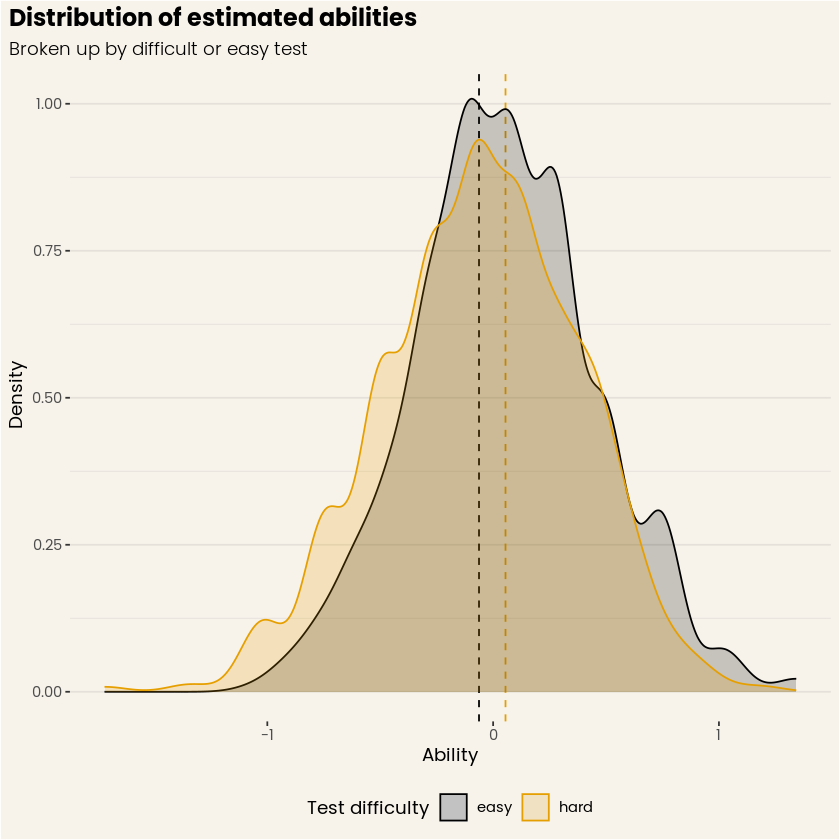
Şekil 4. Hem benzetimle oluşturulmuş kolay hem de zor testler için tahmini yeteneklerin dağılımı. (Kaynak: DataCamp Workspace)
Son Düşünceler
Özetle, IRT bize çok sayıda farklı soru oluşturma ve bunların alt kümelerini size sunma olanağı verirken, puanınızı yine de doğru biçimde hesaplamamıza ve testlerimizin güvenliğini ve kalitesini korumamıza imkân tanır! Dahası, IRT soruları testteki performansınıza göre uyarlayarak sunmanıza olanak sağlar. Evet, gerçekten de her test farklıdır; çünkü hangi soruyu almanız gerektiğini uyarlamalı olarak belirliyoruz! Bu sayede testi daha kısa tutabilir, ancak onu daha az hassas yapmayız. Ama bunun detayları bir sonraki blog yazısında! Şimdi bir değerlendirme çözün ya da sertifika alın! ;)
[Bu blog yazısındaki şekiller, bulutta çalışan ve hemen çalışan defterimiz DataCamp Workspace kullanılarak üretildi. Workspace’i buradan inceleyin, yorum yapmaktan çekinmeyin ya da kendiniz deneyin!]



