Forse ricordi bene gli esami all’università o al college e il confronto dopo, chiedendoti se le domande che hai ricevuto fossero più difficili di quelle degli altri. Oppure ti è capitato di rifare un esame e trovarlo più facile del precedente. Il voto più alto è dovuto a un esame più semplice o al fatto che hai studiato di più?
Qui arriviamo al cuore di cosa significhi misurare le conoscenze, le competenze e le abilità di una persona in un determinato ambito. Un approccio tipico alla progettazione di un esame è ideare un set di domande, proporle agli studenti, valutare ogni domanda come corretta/errata e contare il numero di risposte corrette sul totale. Questo punteggio finale dovrebbe quantificare le conoscenze dello studente ed è usato per decidere se l’esame è superato o meno.
Su DataCamp offriamo un’esperienza simile. Gli utenti possono misurare come stanno andando in un determinato ambito (per esempio, Data Management in SQL) usando le nostre valutazioni: accedi e provane una qui! Allo stesso modo, nella Certificazione DataCamp, gli utenti devono prima superare una serie di esami per ottenere la certificazione.
Teoria Classica dei Test
Alla base dello sviluppo dei test c’è un quadro di misurazione chiamato teoria classica dei test (CTT). L’equazione classica alla base della CTT è la seguente:
X = T + E
dove X è il punteggio osservato, T il punteggio vero ed E una componente di errore. Questa equazione afferma che ogni punteggio osservato è un mix tra il punteggio vero di una persona e una componente di errore non sistematica. Questo approccio è adatto quando vuoi misurare un insieme di persone (per esempio, tutti gli studenti della tua classe) su un dominio con lo stesso set fisso di domande in un’unica occasione. Per esempio, se hai sviluppato un set di domande per sondare le competenze SQL di una persona, la CTT è un buon quadro per analizzare la qualità di quel test.
DataCamp, però, può essere visto come una grande aula globale, dove gli studenti possono autovalutarsi su un dominio di interesse o tentare di ottenere una certificazione 24/7.
Nel nostro contesto, incontriamo presto dei problemi se proviamo a basarci sulla CTT per garantire la qualità dei nostri test.
Dato che offriamo sia valutazioni sia Certificazioni DataCamp con l’obiettivo di quantificare le conoscenze, le competenze e le abilità di un utente in un determinato ambito, non possiamo semplicemente porre a tutti sempre le stesse 15 domande. I nostri test sarebbero troppo vulnerabili a fughe di domande e alla memorizzazione in caso di rifacimento. Col tempo, i punteggi perderebbero significato.
Usare l’Item Response Theory
Una soluzione semplice è aumentare il numero di domande che possono essere mostrate a un utente e/o aggiornare continuamente il pool di domande da cui campionare. Tuttavia, la CTT considera solo il punteggio vero di una persona e non dice nulla sulle domande! Come possiamo stimare il punteggio di una persona quando non sappiamo se le domande avevano difficoltà comparabile in test consecutivi?
Ecco l’Item Response Theory (IRT). L’IRT è un quadro di misurazione in cui il punteggio osservato su una singola domanda (per esempio, corretto/errato) è il risultato di un’interazione probabilistica tra l’abilità della persona e la difficoltà dell’item. Formalmente:
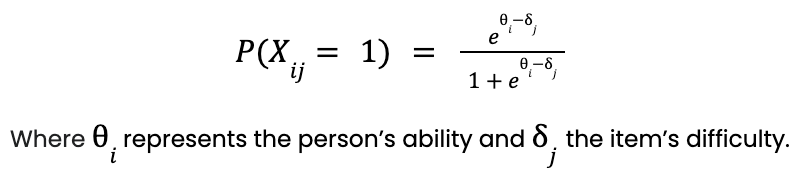
Questo modello è noto anche come modello logistico a un parametro (1-PL) o modello di Rasch. Per motivi di stima, si assume che le abilità seguano una distribuzione normale centrata in 0 con deviazione standard 1. Ne risulta una scala espressa in deviazioni standard che tipicamente varia tra -4 e 4 (dato che oltre il 99,99% della distribuzione normale ricade in questo intervallo). Niente paura: puoi trasformare questo intervallo come preferisci! Per esempio, su DataCamp -3,33 corrisponde a un punteggio di 0, 0 a un punteggio di 100 e 3,33 a un punteggio di 200. Fissando l’equazione per un item specifico (in questo caso a 0) e variando l’abilità tra -4 e 4, si ottiene la seguente curva:
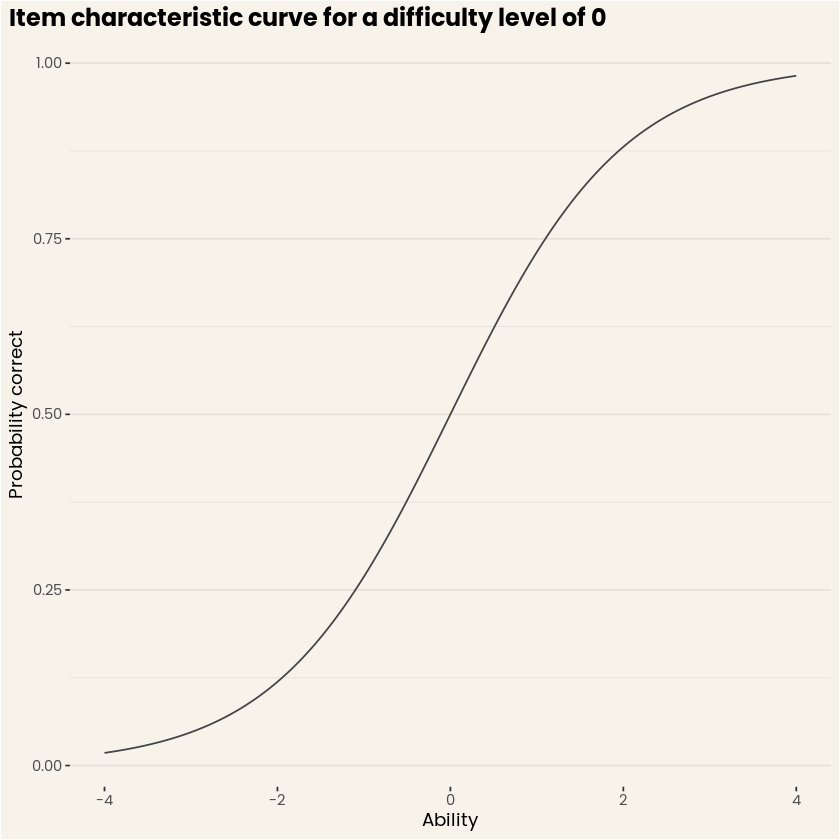
Figura 1. Curva caratteristica dell’item per un item con difficoltà 0. (Fonte: DataCamp Workspace)
Questa curva è nota anche come curva caratteristica dell’item e, per ciascun livello di abilità, esprime la probabilità attesa di rispondere correttamente a quell’item. Ogni item nel pool è caratterizzato da una curva di questo tipo e l’insieme di tutte le curve descrive completamente la prestazione attesa in un test per qualsiasi persona. Il bello delle curve caratteristiche degli item è che offrono un’intuizione su quale prestazione aspettarsi su un item dato un certo livello di abilità!
Uso dell’IRT su DataCamp
Mettiamo ora alla prova la nostra motivazione iniziale! A cosa serve l’IRT per DataCamp? La figura qui sotto mostra un set ipotetico di 7 domande con livelli di difficoltà diversi. Supponiamo di mostrare le tre più facili e le tre più difficili alla stessa persona in due sessioni diverse, in questo caso una persona con abilità media. Dalle curve è chiaro che il numero atteso di risposte corrette nel test facile sarebbe circa 2,5 (la somma delle singole probabilità), mentre nel test difficile sarebbe circa 0,875! Detto in modo netto, è quasi tre volte meglio nel test facile se ci basiamo solo sulle risposte corrette. Ma ecco il punto: l’IRT ci permette di stimare un punteggio di abilità sulla base della correttezza della risposta e del livello di difficoltà associato. In questo modo, saremmo in grado di recuperare correttamente un’abilità pari a 0 in entrambi i casi (al netto di un certo errore di misura che dipende dalla lunghezza del test).
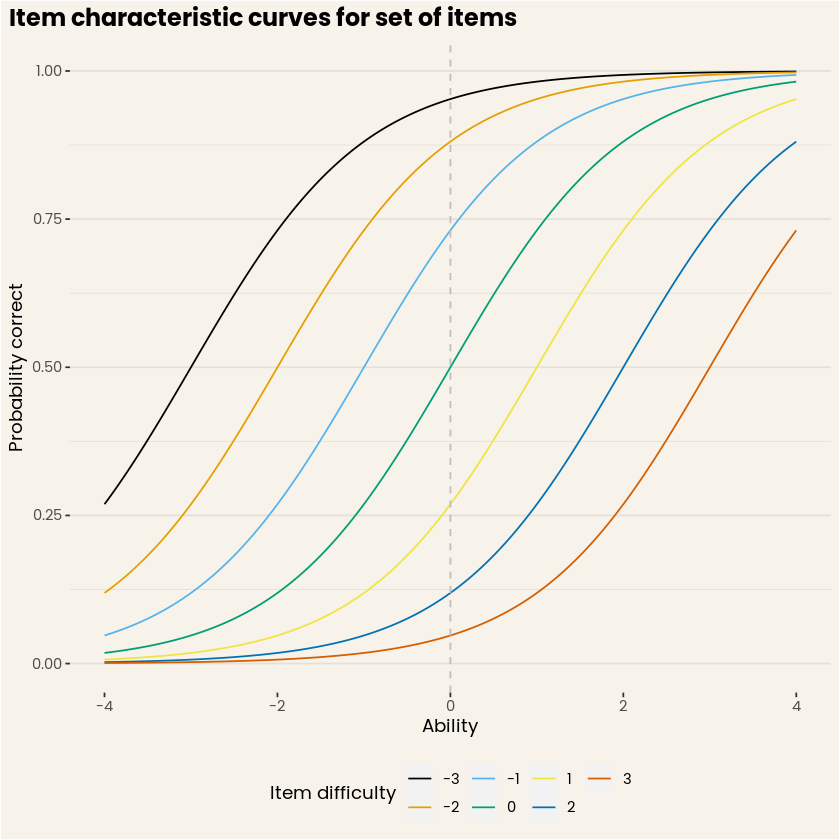
Figura 2. Curve caratteristiche degli item per un set di item. (Fonte: DataCamp Workspace)
Facciamo una piccola simulazione per mostrare che è davvero così. Per ottenere una distribuzione fluida dei punteggi, espandiamo il set di item a 61 in totale, sempre con difficoltà compresa tra -3 e 3. Facciamo rispondere a 1000 (ipotetici) utenti con punteggio vero pari a 0 a 30 item compresi tra -3 e 0 (il test “facile”) oppure a 30 item tra 0 e 3 (il test “difficile”). Possiamo riassumere i risultati in due modi: usando il numero totale di item corretti su 30 oppure il livello di abilità stimato in base al modello IRT. Non sorprende che la simulazione produca in media 24 risposte corrette nel test facile e solo 6 nel test difficile (vedi Figura 3). Anche se l’esempio è un po’ forzato, immagina di proporre queste due forme di test agli studenti in classe e di usare il numero di risposte corrette per quantificare la loro prestazione. Nessuno dei tuoi studenti è effettivamente migliore degli altri, ma è chiaro che il numero di risposte corrette genererebbe due gruppi completamente diversi!
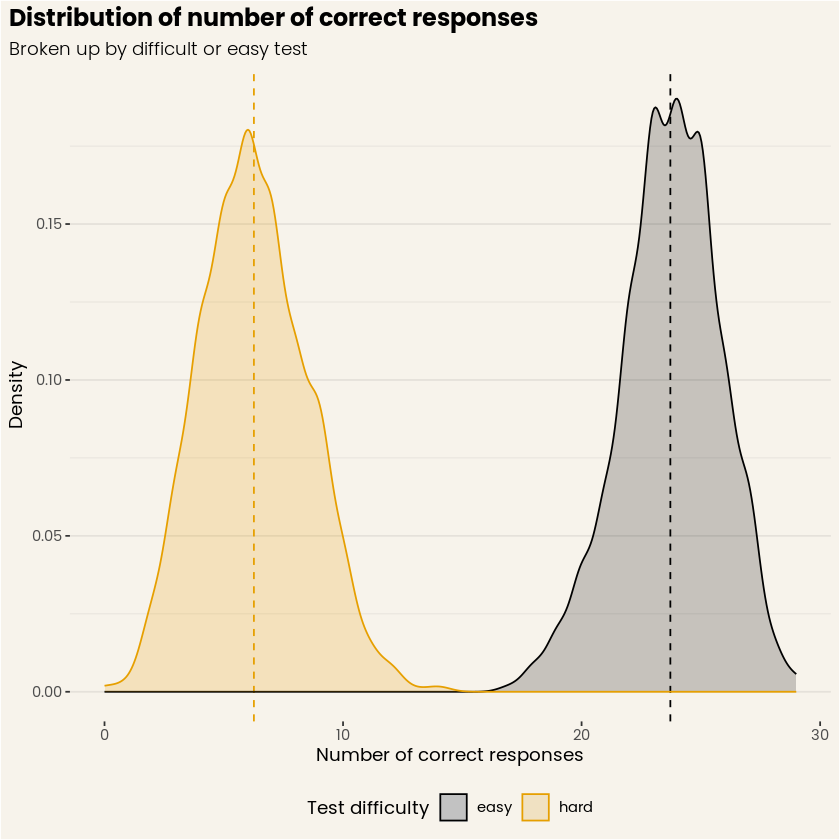
Figura 3. Distribuzione del numero di risposte corrette per test simulati facile e difficile. (Fonte: DataCamp Workspace)
La Figura 3 contrasta nettamente con la Figura 4, dove le distribuzioni delle abilità stimate si sovrappongono fortemente e le rispettive medie sono entrambe quasi perfettamente centrate su zero! Il motivo principale è che teniamo conto della difficoltà delle domande quando calcoliamo l’abilità. Di nuovo, è un esempio un po’ forzato, ma mostra la potenza dell’IRT e la sua capacità di separare i contributi della persona e dell’item alle risposte. Applicato alla tua classe, questo approccio produrrebbe comunque una certa variabilità nelle prestazioni, ma almeno sparirebbero quei due gruppi di studenti!
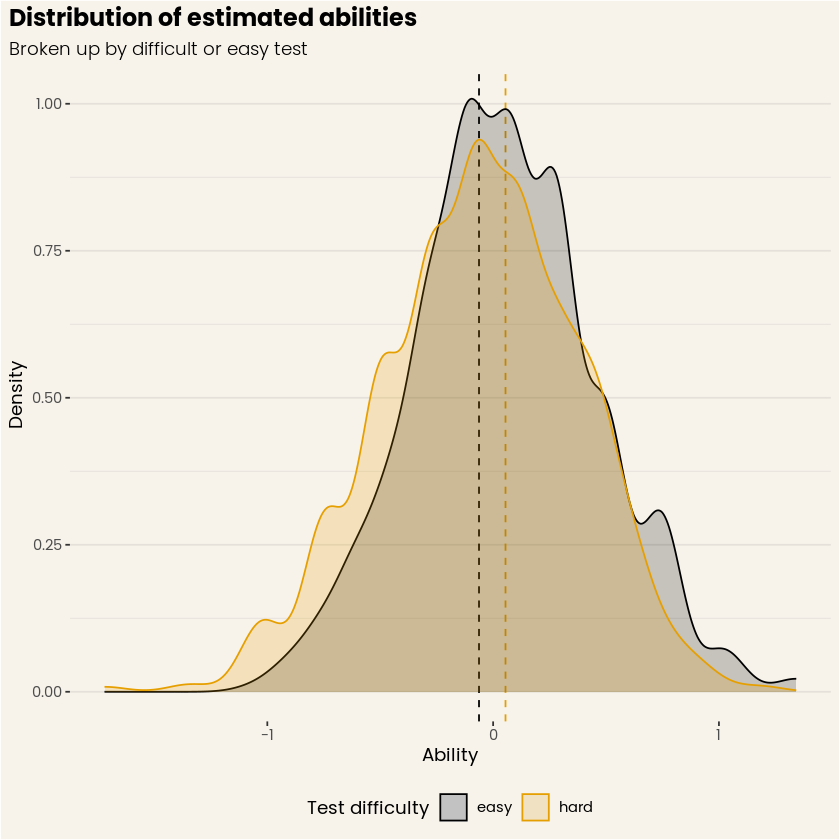
Figura 4. Distribuzione delle abilità stimate per entrambi i test simulati, facile e difficile. (Fonte: DataCamp Workspace)
Considerazioni finali
In sintesi, l’IRT ci permette di creare molte domande diverse e mostrartene dei sottoinsiemi, calcolando comunque il tuo punteggio con precisione e senza compromettere la sicurezza e la qualità dei nostri test! Inoltre, l’IRT consente di presentare le domande in modo adattivo, in base a come stai andando nel test. Sì, esatto: ogni test è diverso perché determiniamo in modo adattivo quali domande proporre! Questo ci permette di rendere il test più corto senza perderne in precisione. Ma di questo parleremo meglio in un prossimo post! Ora vai a fare una valutazione o ottieni la certificazione! ;)
[Le figure in questo post sono state generate con DataCamp Workspace, il nostro notebook in cloud che funziona e basta. Dai un’occhiata a Workspace qui, lascia pure un commento o sperimenta in prima persona!]



