Bạn có thể vẫn nhớ như in những lần thi ở đại học hoặc cao đẳng và sau đó bàn tán xem liệu đề bạn nhận được có khó hơn đề của những sinh viên khác không. Hoặc bạn có thể nhớ lần thi lại thấy đề dễ hơn lần trước. Điểm cao hơn là do đề dễ hơn hay đơn giản là bạn đã học nhiều hơn?
Điều này chạm đến cốt lõi của việc đo lường kiến thức, kỹ năng và năng lực của một người trong một lĩnh vực. Cách tiếp cận điển hình để thiết kế một bài thi là nghĩ ra một bộ câu hỏi, đưa cho học viên, chấm điểm từng câu là đúng/sai và đếm số câu đúng trên tổng số câu. Điểm cuối cùng này được xem là lượng hóa kiến thức của học viên, dùng để quyết định bạn đậu hay rớt.
Tại DataCamp, chúng tôi mang đến trải nghiệm tương tự. Người dùng có thể đo lường mức độ thành thạo trong một lĩnh vực cụ thể (ví dụ: Quản lý dữ liệu trong SQL) bằng các bài đánh giá của chúng tôi - đăng nhập và thử một bài tại đây! Tương tự, trong Chứng chỉ DataCamp, người dùng trước tiên phải vượt qua một bộ bài thi để đạt chứng chỉ.
Lý thuyết Kiểm tra Cổ điển
Trung tâm của phát triển bài kiểm tra là một khung đo lường gọi là lý thuyết kiểm tra cổ điển (CTT). Phương trình kinh điển nền tảng của CTT như sau:
X = T + E
trong đó X là điểm quan sát được, T là điểm thực, và E là thành phần sai số. Phương trình này nói rằng bất kỳ điểm số quan sát được nào cũng là sự pha trộn giữa điểm thực của một người và một thành phần sai số không có tính hệ thống. Cách tiếp cận này phù hợp khi bạn muốn đo lường một nhóm người (ví dụ: tất cả sinh viên trong lớp) về một lĩnh vực bằng cùng một bộ câu hỏi cố định tại một thời điểm. Chẳng hạn, giả sử bạn xây dựng một bộ câu hỏi đánh giá kỹ năng SQL của một người, CTT là khung phù hợp để phân tích chất lượng của bài kiểm tra đó.
Tuy nhiên, DataCamp có thể được xem như một lớp học toàn cầu khổng lồ, nơi học viên có thể tự đánh giá trong lĩnh vực họ quan tâm hoặc nỗ lực đạt chứng chỉ 24/7.
Trong môi trường của chúng tôi, khi cố dựa vào CTT để đảm bảo chất lượng bài kiểm tra, chúng tôi nhanh chóng gặp vấn đề.
Vì chúng tôi cung cấp cả các bài đánh giá và Chứng chỉ DataCamp nhằm lượng hóa kiến thức, kỹ năng và năng lực của người dùng trong một lĩnh vực cụ thể, chúng tôi không thể chỉ hỏi đi hỏi lại cùng 15 câu cho tất cả mọi người. Làm vậy sẽ khiến bài thi rất dễ bị lộ đề cũng như học thuộc lòng khi thi lại. Theo thời gian, điểm số sẽ mất ý nghĩa.
Sử dụng Lý thuyết Ứng đáp Câu hỏi
Một cách khắc phục đơn giản là tăng số lượng câu hỏi có thể hiển thị cho người dùng và/hoặc liên tục làm mới ngân hàng câu hỏi để rút mẫu. Tuy nhiên, CTT chỉ xét đến điểm thực của một người và hoàn toàn không đề cập đến câu hỏi! Làm thế nào để ước tính điểm của một người khi chúng ta không biết các câu hỏi ở những lần thi liên tiếp có độ khó tương đương không?
Xin giới thiệu: Lý thuyết ứng đáp câu hỏi (IRT). IRT là một khung đo lường trong đó điểm số quan sát được trên từng câu hỏi (ví dụ: đúng/sai) được giả định là kết quả của sự tương tác mang tính xác suất giữa năng lực của người làm và độ khó của câu hỏi. Diễn đạt chính thức:
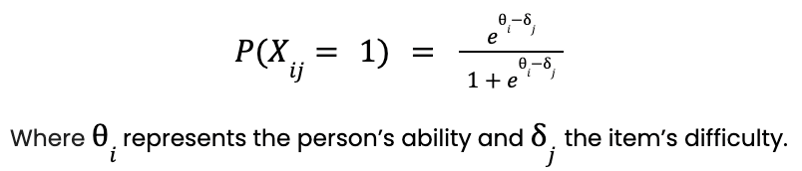
Mô hình này còn được gọi là mô hình logistic một tham số (1-PL) hay mô hình Rasch. Vì lý do ước lượng, năng lực được giả định tuân theo phân phối chuẩn có trung bình 0 và độ lệch chuẩn 1. Kết quả là một thang đo biểu diễn theo đơn vị độ lệch chuẩn và thường dao động từ -4 đến 4 (vì hơn 99,99% phân phối chuẩn nằm trong khoảng này). Đừng lo, bạn có thể biến đổi thang này thành bất kỳ thang nào bạn muốn! Chẳng hạn, tại DataCamp, -3,33 tương ứng với điểm 0, 0 tương ứng với 100, và 3,33 tương ứng với 200. Khi cố định phương trình này cho một câu hỏi cụ thể (trong trường hợp này ở mức 0) và cho năng lực biến thiên từ -4 đến 4, bạn sẽ nhận được đường cong sau:
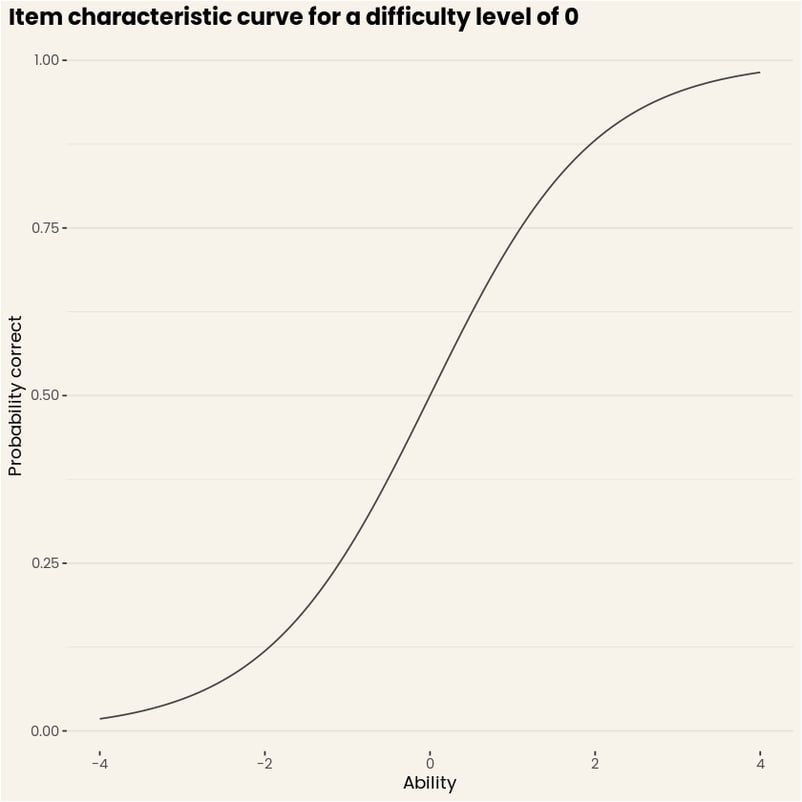
Hình 1. Đường cong đặc trưng của câu hỏi với mức độ khó 0. (Nguồn: DataCamp Workspace)
Đường cong này còn gọi là đường cong đặc trưng của câu hỏi, biểu diễn với mỗi mức năng lực, xác suất kỳ vọng trả lời đúng câu hỏi đó là bao nhiêu. Mỗi câu hỏi trong ngân hàng đều được đặc trưng bởi một đường cong như vậy, và tập hợp tất cả các đường cong biểu đạt đầy đủ hiệu suất làm bài dự kiến cho bất kỳ người nào. Điều hay ở các đường cong đặc trưng câu hỏi là bạn có được trực giác về hiệu suất kỳ vọng trên một câu hỏi, với các mức năng lực khác nhau của người làm!
Ứng dụng IRT tại DataCamp
Giờ hãy đem động lực ban đầu của chúng ta ra thử nghiệm! IRT hữu ích thế nào với DataCamp? Hình dưới đây minh họa một bộ 7 câu hỏi giả định với các mức độ khó khác nhau. Giả sử chúng ta hiển thị ba câu dễ nhất và ba câu khó nhất cho cùng một người ở hai phiên làm bài khác nhau, ở đây là người có mức năng lực trung bình. Rõ ràng khi dò theo các đường cong, số câu đúng kỳ vọng trong bài dễ sẽ khoảng 2,5 (tổng các xác suất riêng lẻ), trong khi ở bài khó con số này khoảng 0,875! Nói mạnh hơn, chỉ xét số câu đúng thì làm bài dễ gần như tốt gấp ba lần. Nhưng mấu chốt là, IRT cho phép chúng ta ước tính điểm năng lực dựa trên tính đúng sai của câu trả lời và mức độ khó tương ứng. Bằng cách này, chúng ta có thể khôi phục chính xác điểm năng lực bằng 0 trong cả hai trường hợp (dù vẫn có sai số đo lường phụ thuộc vào độ dài bài thi).
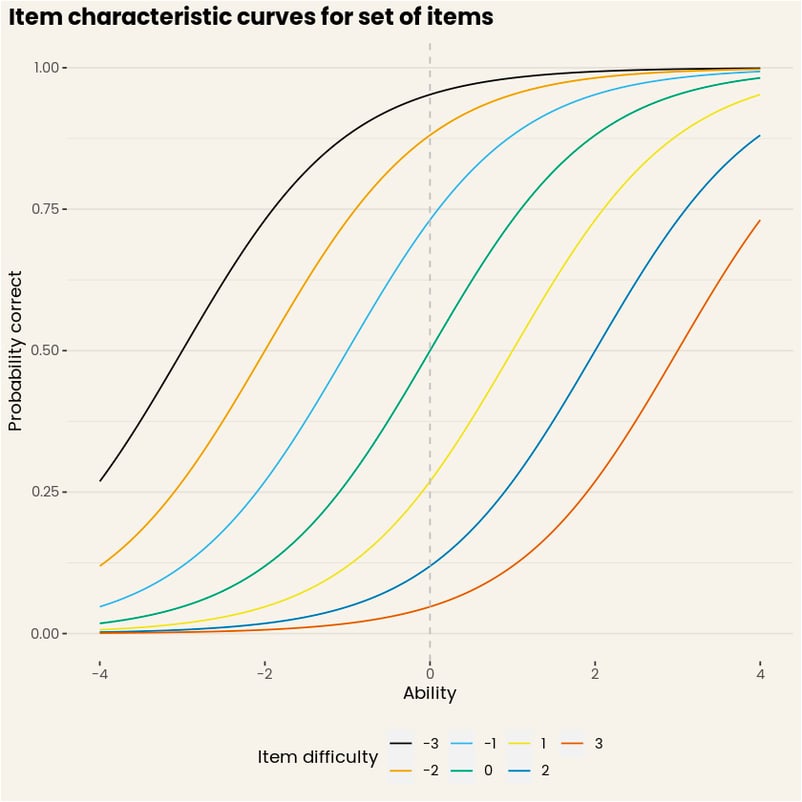
Hình 2. Các đường cong đặc trưng cho một tập câu hỏi. (Nguồn: DataCamp Workspace)
Hãy chạy một mô phỏng nhỏ để cho thấy điều này thực sự đúng. Để đảm bảo phân phối điểm mượt, chúng ta mở rộng tập câu hỏi lên tổng cộng 61 câu, vẫn trong khoảng độ khó từ -3 đến 3. Chúng ta để 1000 người dùng (giả định) có điểm thực bằng 0 lần lượt trả lời 30 câu trong khoảng từ -3 đến 0 (bài “dễ”), hoặc 30 câu trong khoảng từ 0 đến 3 (bài “khó”). Chúng ta có thể tóm tắt kết quả theo hai cách: dùng tổng số câu đúng trên 30, hoặc mức năng lực ước tính dựa trên mô hình IRT. Không ngạc nhiên, mô phỏng cho ra trung bình 24 câu đúng ở bài dễ, và chỉ 6 câu đúng ở bài khó (xem Hình 3). Dù ví dụ này hơi gượng, hãy tưởng tượng bạn đưa hai đề này cho học viên trong lớp và dùng số câu đúng để lượng hóa hiệu suất. Không học viên nào thực sự giỏi hơn học viên khác, nhưng rõ ràng số câu đúng sẽ tạo ra hai nhóm hoàn toàn khác nhau!
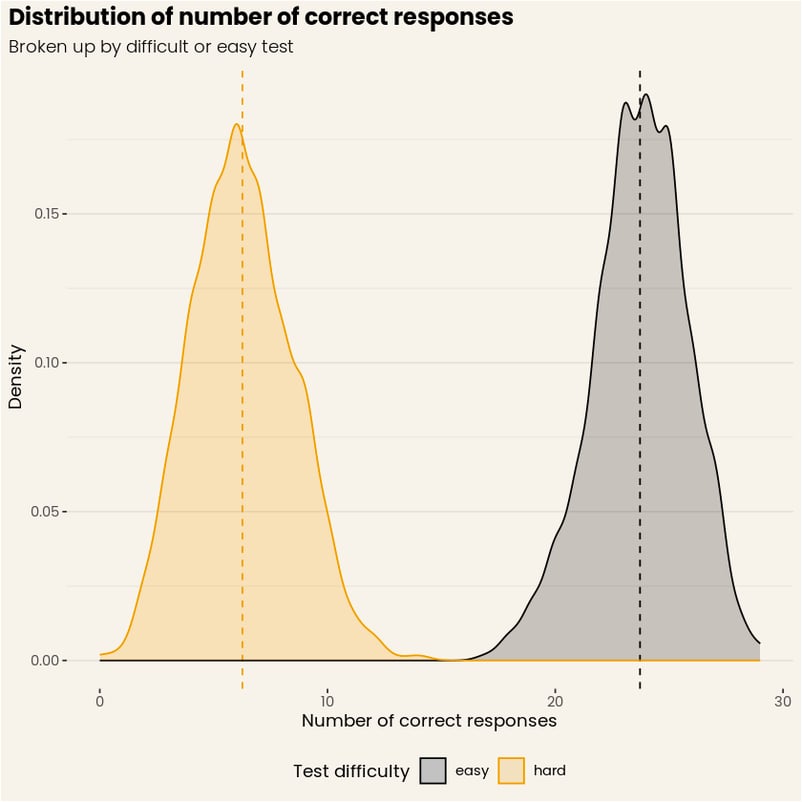
Hình 3. Phân phối số câu trả lời đúng cho các bài thi dễ và khó được mô phỏng. (Nguồn: DataCamp Workspace)
Hình 3 tương phản rõ rệt với Hình 4, nơi các phân phối năng lực ước tính chồng lấn mạnh, và trung bình của cả hai gần như nằm chính giữa ở mức không! Lý do chính là chúng ta tính đến độ khó của câu hỏi khi tính năng lực. Một lần nữa, đây là ví dụ hơi gượng, nhưng nó cho thấy sức mạnh của IRT và khả năng tách bạch đóng góp của người làm và của câu hỏi đối với phản hồi. Áp dụng cho lớp học của bạn, cách tiếp cận này dĩ nhiên vẫn tạo ra sự khác biệt về hiệu suất, nhưng ít nhất hai nhóm “giả” kia không còn nữa!
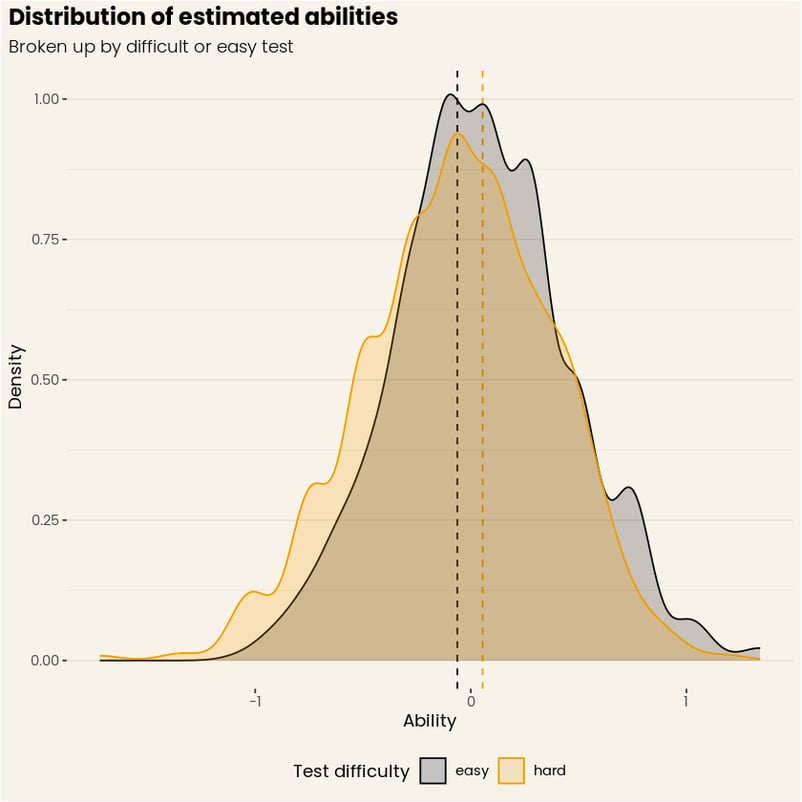
Hình 4. Phân phối năng lực ước tính cho cả bài thi dễ và khó được mô phỏng. (Nguồn: DataCamp Workspace)
Lời kết
Tóm lại, IRT cho phép chúng tôi tạo ra rất nhiều câu hỏi khác nhau và hiển thị các tập con cho bạn mà vẫn tính toán chính xác điểm số, đồng thời không làm ảnh hưởng đến tính bảo mật và chất lượng bài thi! Hơn nữa, IRT cho phép hiển thị câu hỏi theo cách phù hợp với mức độ bạn đang thể hiện trong bài. Đúng vậy, mỗi bài thi đều khác nhau vì chúng tôi xác định câu hỏi bạn nhận được một cách thích ứng! Điều này giúp chúng tôi rút ngắn bài thi mà không làm giảm độ chính xác. Nhưng về điều đó, hẹn bạn ở bài viết tiếp theo! Giờ thì hãy làm một bài đánh giá hoặc đăng ký chứng chỉ nhé! ;)
[Các hình minh họa trong bài viết này được tạo bằng DataCamp Workspace, sổ tay đám mây của chúng tôi hoạt động mượt mà. Xem Workspace tại đây, thoải mái bình luận hoặc tự mình thử nghiệm!]

 Matt Crabtree · 10 min
Bạn có thể vẫn nhớ như in những lần thi ở đại học hoặc cao đẳng và sau đó bàn tán xem liệu đề bạn nhận được có khó hơn đề của những sinh viên khác không. Hoặc bạn có thể nhớ lần thi lại thấy đề dễ hơn lần trước. Điểm cao hơn là do đề dễ hơn hay đơn giản là bạn đã học nhiều hơn?
Điều này chạm đến cốt lõi của việc đo lường kiến thức, kỹ năng và năng lực của một người trong một lĩnh vực. Cách tiếp cận điển hình để thiết kế một bài thi là nghĩ ra một bộ câu hỏi, đưa cho học viên, chấm điểm từng câu là đúng/sai và đếm số câu đúng trên tổng số câu. Điểm cuối cùng này được xem là lượng hóa kiến thức của học viên, dùng để quyết định bạn đậu hay rớt.
Tại DataCamp, chúng tôi mang đến trải nghiệm tương tự. Người dùng có thể đo lường mức độ thành thạo trong một lĩnh vực cụ thể (ví dụ: Quản lý dữ liệu trong SQL) bằng các bài đánh giá của chúng tôi - đăng nhập và thử một bài tại đây! Tương tự, trong Chứng chỉ DataCamp, người dùng trước tiên phải vượt qua một bộ bài thi để đạt chứng chỉ.
Lý thuyết Kiểm tra Cổ điển
Trung tâm của phát triển bài kiểm tra là một khung đo lường gọi là lý thuyết kiểm tra cổ điển (CTT). Phương trình kinh điển nền tảng của CTT như sau:
X = T + E
trong đó X là điểm quan sát được, T là điểm thực, và E là thành phần sai số. Phương trình này nói rằng bất kỳ điểm số quan sát được nào cũng là sự pha trộn giữa điểm thực của một người và một thành phần sai số không có tính hệ thống. Cách tiếp cận này phù hợp khi bạn muốn đo lường một nhóm người (ví dụ: tất cả sinh viên trong lớp) về một lĩnh vực bằng cùng một bộ câu hỏi cố định tại một thời điểm. Chẳng hạn, giả sử bạn xây dựng một bộ câu hỏi đánh giá kỹ năng SQL của một người, CTT là khung phù hợp để phân tích chất lượng của bài kiểm tra đó.
Tuy nhiên, DataCamp có thể được xem như một lớp học toàn cầu khổng lồ, nơi học viên có thể tự đánh giá trong lĩnh vực họ quan tâm hoặc nỗ lực đạt chứng chỉ 24/7.
Trong môi trường của chúng tôi, khi cố dựa vào CTT để đảm bảo chất lượng bài kiểm tra, chúng tôi nhanh chóng gặp vấn đề.
Vì chúng tôi cung cấp cả các bài đánh giá và Chứng chỉ DataCamp nhằm lượng hóa kiến thức, kỹ năng và năng lực của người dùng trong một lĩnh vực cụ thể, chúng tôi không thể chỉ hỏi đi hỏi lại cùng 15 câu cho tất cả mọi người. Làm vậy sẽ khiến bài thi rất dễ bị lộ đề cũng như học thuộc lòng khi thi lại. Theo thời gian, điểm số sẽ mất ý nghĩa.
Sử dụng Lý thuyết Ứng đáp Câu hỏi
Một cách khắc phục đơn giản là tăng số lượng câu hỏi có thể hiển thị cho người dùng và/hoặc liên tục làm mới ngân hàng câu hỏi để rút mẫu. Tuy nhiên, CTT chỉ xét đến điểm thực của một người và hoàn toàn không đề cập đến câu hỏi! Làm thế nào để ước tính điểm của một người khi chúng ta không biết các câu hỏi ở những lần thi liên tiếp có độ khó tương đương không?
Xin giới thiệu: Lý thuyết ứng đáp câu hỏi (IRT). IRT là một khung đo lường trong đó điểm số quan sát được trên từng câu hỏi (ví dụ: đúng/sai) được giả định là kết quả của sự tương tác mang tính xác suất giữa năng lực của người làm và độ khó của câu hỏi. Diễn đạt chính thức:
Mô hình này còn được gọi là mô hình logistic một tham số (1-PL) hay mô hình Rasch. Vì lý do ước lượng, năng lực được giả định tuân theo phân phối chuẩn có trung bình 0 và độ lệch chuẩn 1. Kết quả là một thang đo biểu diễn theo đơn vị độ lệch chuẩn và thường dao động từ -4 đến 4 (vì hơn 99,99% phân phối chuẩn nằm trong khoảng này). Đừng lo, bạn có thể biến đổi thang này thành bất kỳ thang nào bạn muốn! Chẳng hạn, tại DataCamp, -3,33 tương ứng với điểm 0, 0 tương ứng với 100, và 3,33 tương ứng với 200. Khi cố định phương trình này cho một câu hỏi cụ thể (trong trường hợp này ở mức 0) và cho năng lực biến thiên từ -4 đến 4, bạn sẽ nhận được đường cong sau:
Hình 1. Đường cong đặc trưng của câu hỏi với mức độ khó 0. (Nguồn: DataCamp Workspace)
Đường cong này còn gọi là đường cong đặc trưng của câu hỏi, biểu diễn với mỗi mức năng lực, xác suất kỳ vọng trả lời đúng câu hỏi đó là bao nhiêu. Mỗi câu hỏi trong ngân hàng đều được đặc trưng bởi một đường cong như vậy, và tập hợp tất cả các đường cong biểu đạt đầy đủ hiệu suất làm bài dự kiến cho bất kỳ người nào. Điều hay ở các đường cong đặc trưng câu hỏi là bạn có được trực giác về hiệu suất kỳ vọng trên một câu hỏi, với các mức năng lực khác nhau của người làm!
Ứng dụng IRT tại DataCamp
Giờ hãy đem động lực ban đầu của chúng ta ra thử nghiệm! IRT hữu ích thế nào với DataCamp? Hình dưới đây minh họa một bộ 7 câu hỏi giả định với các mức độ khó khác nhau. Giả sử chúng ta hiển thị ba câu dễ nhất và ba câu khó nhất cho cùng một người ở hai phiên làm bài khác nhau, ở đây là người có mức năng lực trung bình. Rõ ràng khi dò theo các đường cong, số câu đúng kỳ vọng trong bài dễ sẽ khoảng 2,5 (tổng các xác suất riêng lẻ), trong khi ở bài khó con số này khoảng 0,875! Nói mạnh hơn, chỉ xét số câu đúng thì làm bài dễ gần như tốt gấp ba lần. Nhưng mấu chốt là, IRT cho phép chúng ta ước tính điểm năng lực dựa trên tính đúng sai của câu trả lời và mức độ khó tương ứng. Bằng cách này, chúng ta có thể khôi phục chính xác điểm năng lực bằng 0 trong cả hai trường hợp (dù vẫn có sai số đo lường phụ thuộc vào độ dài bài thi).
Hình 2. Các đường cong đặc trưng cho một tập câu hỏi. (Nguồn: DataCamp Workspace)
Hãy chạy một mô phỏng nhỏ để cho thấy điều này thực sự đúng. Để đảm bảo phân phối điểm mượt, chúng ta mở rộng tập câu hỏi lên tổng cộng 61 câu, vẫn trong khoảng độ khó từ -3 đến 3. Chúng ta để 1000 người dùng (giả định) có điểm thực bằng 0 lần lượt trả lời 30 câu trong khoảng từ -3 đến 0 (bài “dễ”), hoặc 30 câu trong khoảng từ 0 đến 3 (bài “khó”). Chúng ta có thể tóm tắt kết quả theo hai cách: dùng tổng số câu đúng trên 30, hoặc mức năng lực ước tính dựa trên mô hình IRT. Không ngạc nhiên, mô phỏng cho ra trung bình 24 câu đúng ở bài dễ, và chỉ 6 câu đúng ở bài khó (xem Hình 3). Dù ví dụ này hơi gượng, hãy tưởng tượng bạn đưa hai đề này cho học viên trong lớp và dùng số câu đúng để lượng hóa hiệu suất. Không học viên nào thực sự giỏi hơn học viên khác, nhưng rõ ràng số câu đúng sẽ tạo ra hai nhóm hoàn toàn khác nhau!
Hình 3. Phân phối số câu trả lời đúng cho các bài thi dễ và khó được mô phỏng. (Nguồn: DataCamp Workspace)
Hình 3 tương phản rõ rệt với Hình 4, nơi các phân phối năng lực ước tính chồng lấn mạnh, và trung bình của cả hai gần như nằm chính giữa ở mức không! Lý do chính là chúng ta tính đến độ khó của câu hỏi khi tính năng lực. Một lần nữa, đây là ví dụ hơi gượng, nhưng nó cho thấy sức mạnh của IRT và khả năng tách bạch đóng góp của người làm và của câu hỏi đối với phản hồi. Áp dụng cho lớp học của bạn, cách tiếp cận này dĩ nhiên vẫn tạo ra sự khác biệt về hiệu suất, nhưng ít nhất hai nhóm “giả” kia không còn nữa!
Hình 4. Phân phối năng lực ước tính cho cả bài thi dễ và khó được mô phỏng. (Nguồn: DataCamp Workspace)
Lời kết
Tóm lại, IRT cho phép chúng tôi tạo ra rất nhiều câu hỏi khác nhau và hiển thị các tập con cho bạn mà vẫn tính toán chính xác điểm số, đồng thời không làm ảnh hưởng đến tính bảo mật và chất lượng bài thi! Hơn nữa, IRT cho phép hiển thị câu hỏi theo cách phù hợp với mức độ bạn đang thể hiện trong bài. Đúng vậy, mỗi bài thi đều khác nhau vì chúng tôi xác định câu hỏi bạn nhận được một cách thích ứng! Điều này giúp chúng tôi rút ngắn bài thi mà không làm giảm độ chính xác. Nhưng về điều đó, hẹn bạn ở bài viết tiếp theo! Giờ thì hãy làm một bài đánh giá hoặc đăng ký chứng chỉ nhé! ;)
[Các hình minh họa trong bài viết này được tạo bằng DataCamp Workspace, sổ tay đám mây của chúng tôi hoạt động mượt mà. Xem Workspace tại đây, thoải mái bình luận hoặc tự mình thử nghiệm!]