Vous vous souvenez peut-être d’avoir passé des examens à l’université ou en école, puis d’avoir débattu ensuite pour savoir si les questions que vous aviez eues étaient plus difficiles que celles de vos camarades. Ou vous avez peut-être repassé un examen et trouvé la seconde version plus facile que la première. Votre meilleure note venait-elle d’un examen plus simple, ou aviez-vous simplement davantage révisé ?
C’est le cœur même de la mesure des connaissances, des compétences et des aptitudes d’une personne sur un domaine donné. Une façon classique de concevoir un examen consiste à élaborer un ensemble de questions, à les soumettre aux étudiants, à noter chaque réponse comme correcte/incorrecte, puis à compter le nombre de bonnes réponses sur l’ensemble. Ce score final est alors censé quantifier le niveau de connaissance de l’étudiant et sert à décider de sa réussite ou non à l’examen.
Chez DataCamp, nous proposons une expérience similaire. Les utilisateurs peuvent évaluer leur niveau dans un domaine particulier (par exemple, data management en SQL) grâce à nos évaluations – connectez-vous et essayez-en une ici ! De même, dans la DataCamp Certification, les utilisateurs doivent d’abord réussir une série d’examens pour obtenir leur certification.
La théorie classique des tests
Au cœur de la conception des tests se trouve un cadre de mesure appelé théorie classique des tests (TCT). L’équation de base qui sous-tend la TCT est la suivante :
X = T + E
où X est le score observé, T le score vrai et E un terme d’erreur. Cette équation exprime que tout score observé résulte d’un mélange entre le score vrai d’une personne et une composante d’erreur non systématique. Cette approche convient bien lorsqu’il s’agit de mesurer un ensemble de personnes (par exemple, tous les étudiants d’une classe) sur un domaine, avec le même lot fixe de questions et à un moment donné. Si, par exemple, vous avez conçu une série de questions pour sonder les compétences SQL d’une personne, la TCT est un bon cadre pour analyser la qualité de ce test.
DataCamp, toutefois, peut être vu comme une immense salle de classe mondiale, où les apprenants peuvent s’autoévaluer dans le domaine de leur choix ou tenter d’obtenir une certification 24 h/24 et 7 j/7.
Dans cet environnement, nous nous heurtons rapidement à des limites si nous comptons uniquement sur la TCT pour garantir la qualité de nos tests.
Puisque nous proposons à la fois des évaluations et des certifications DataCamp visant à quantifier les connaissances, compétences et aptitudes d’un utilisateur sur un domaine donné, nous ne pouvons pas poser les mêmes 15 questions à tout le monde en boucle. Nos tests deviendraient vulnérables aux fuites d’items et au bachotage lors des repassages. Avec le temps, les scores perdraient leur sens.
Passer à la théorie de la réponse aux items
Une solution simple consiste à augmenter le nombre de questions susceptibles d’être présentées à un utilisateur et/ou à renouveler en continu le vivier d’items. Mais la TCT ne considère que le score vrai d’une personne et ne dit rien des questions elles-mêmes ! Comment estimer le score d’une personne si l’on ne sait pas si la difficulté des questions est comparable d’un test à l’autre ?
C’est là qu’intervient la théorie de la réponse aux items (TRI). La TRI est un cadre de mesure où le score observé à une question (par exemple, correcte/incorrecte) est supposé résulter d’une interaction probabiliste entre l’aptitude d’une personne et la difficulté de l’item. Formellement :
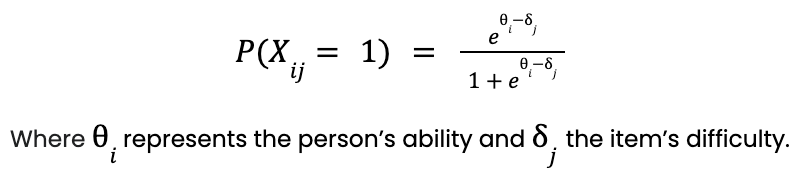
Ce modèle est aussi appelé modèle logistique à un paramètre (1-PL) ou modèle de Rasch. Pour des raisons d’estimation, on suppose que les aptitudes suivent une loi normale centrée en 0 avec un écart type de 1. L’échelle est donc exprimée en écarts types et varie typiquement entre -4 et 4 (puisque plus de 99,99 % de la distribution normale est couverte dans cet intervalle). Rassurez-vous, on peut transformer cette échelle comme on le souhaite ! Par exemple, chez DataCamp, -3,33 correspond à un score de 0, 0 à un score de 100 et 3,33 à un score de 200. En fixant cette équation pour un item précis (ici à 0) et en faisant varier l’aptitude entre -4 et 4, on obtient la courbe suivante :
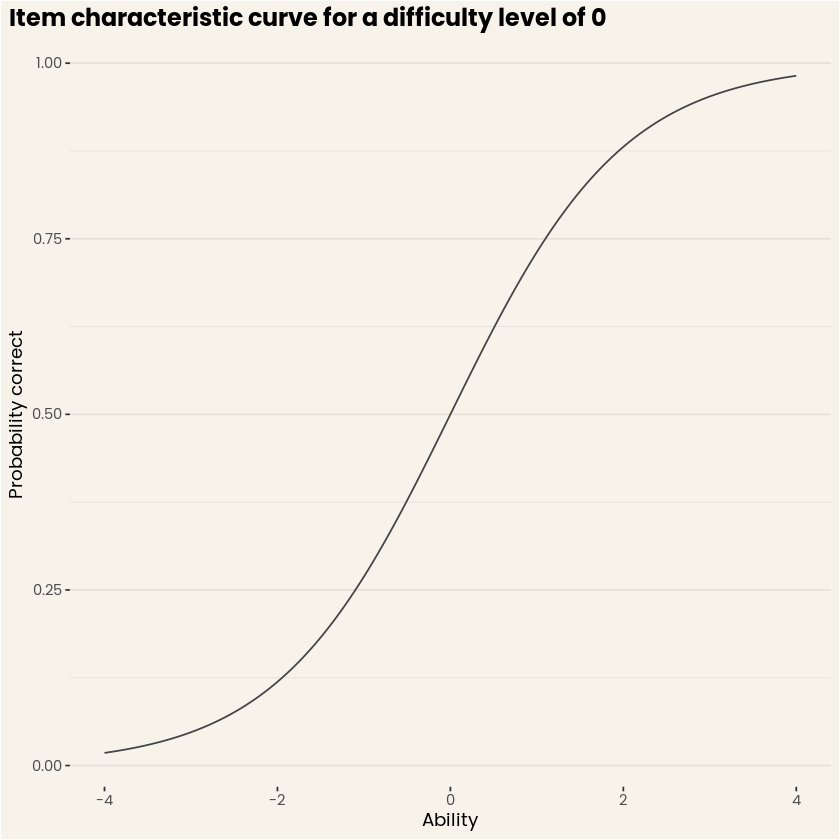
Figure 1. Courbe caractéristique d’un item de difficulté 0. (Source : DataCamp Workspace)
Cette courbe, dite courbe caractéristique d’item, indique pour chaque niveau d’aptitude la probabilité attendue de répondre correctement à cet item. Chaque item du vivier est caractérisé par une telle courbe, et l’ensemble de ces courbes décrit entièrement la performance attendue à un test pour toute personne. L’avantage, c’est qu’elles offrent une intuition claire de la performance attendue sur un item en fonction de différents niveaux d’aptitude !
Comment nous utilisons la TRI chez DataCamp
Mettons maintenant notre motivation initiale à l’épreuve ! À quoi sert la TRI pour DataCamp ? La figure ci-dessous présente un ensemble hypothétique de 7 questions de difficultés variées. Supposons que nous montrions à la même personne les trois questions les plus faciles puis, lors d’une autre session, les trois plus difficiles – dans notre exemple, une personne d’aptitude moyenne. En suivant les courbes, on voit clairement que le nombre attendu de bonnes réponses au test « facile » serait d’environ 2,5 (somme des probabilités individuelles), contre environ 0,875 au test « difficile ». Dit autrement, c’est presque trois fois mieux au test facile si l’on regarde seulement les réponses correctes. Mais voici l’astuce : la TRI permet d’estimer un score d’aptitude en tenant compte de la justesse de la réponse et du niveau de difficulté associé. Ainsi, on retrouverait correctement un score d’aptitude de 0 dans les deux cas (à une erreur de mesure près selon la longueur du test).
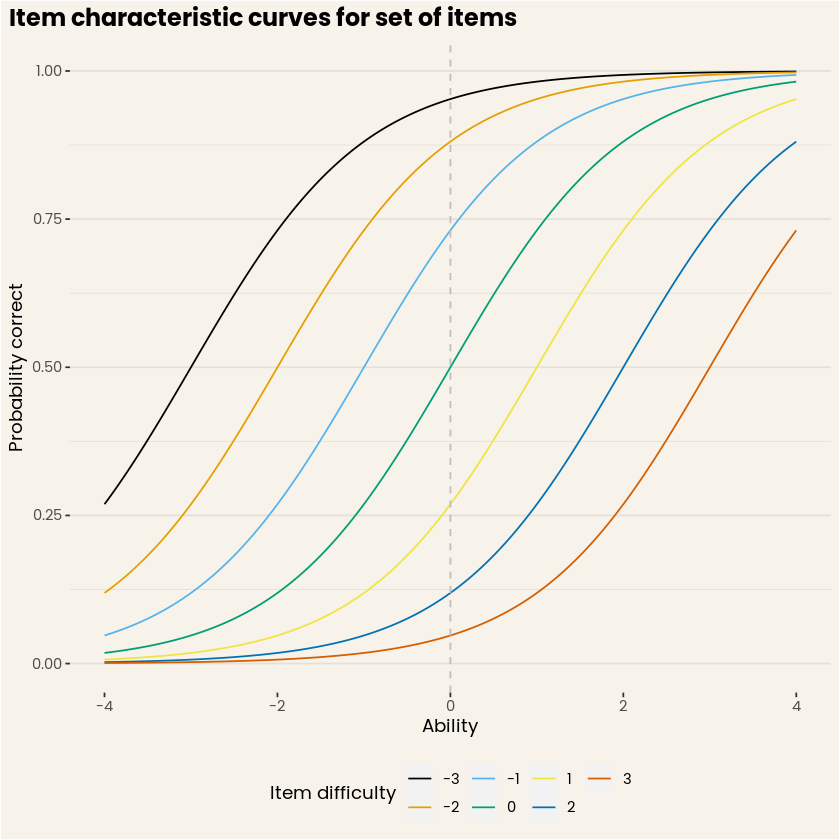
Figure 2. Courbes caractéristiques d’items pour un ensemble d’items. (Source : DataCamp Workspace)
Faisons une petite simulation pour le démontrer. Pour obtenir une distribution de scores plus lisse, nous étendons l’ensemble à 61 items au total, toujours répartis de -3 à 3 en difficulté. Nous faisons répondre 1 000 utilisateurs (hypothétiques) dont le score vrai est 0, soit à 30 items compris entre -3 et 0 (test « facile »), soit à 30 items compris entre 0 et 3 (test « difficile »). Nous résumons les résultats de deux façons : le nombre total de bonnes réponses sur 30, et le niveau d’aptitude estimé via le modèle de TRI. Sans surprise, la simulation donne en moyenne 24 bonnes réponses au test facile, et seulement 6 au test difficile (voir Figure 3). Même si l’exemple est un peu artificiel, imaginez proposer ces deux formes d’examen à vos étudiants et utiliser le nombre de bonnes réponses pour quantifier leur performance. Aucun étudiant n’est réellement meilleur qu’un autre, mais le simple comptage des réponses correctes créerait deux groupes totalement distincts !
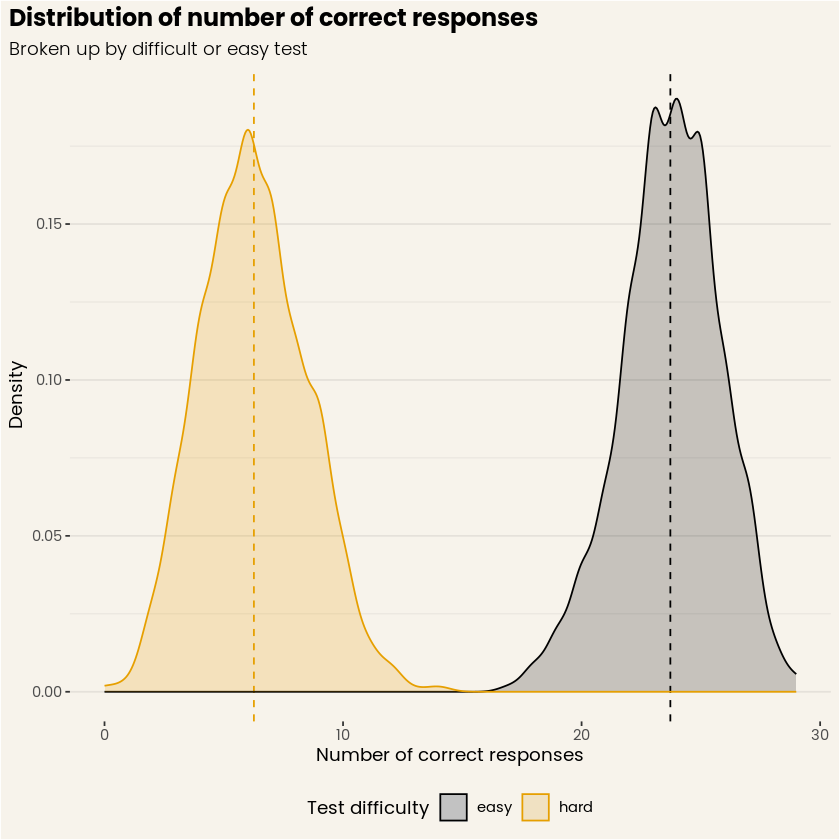
Figure 3. Répartition du nombre de bonnes réponses pour les tests « facile » et « difficile » simulés. (Source : DataCamp Workspace)
La Figure 3 contraste fortement avec la Figure 4, où les distributions des aptitudes estimées se recouvrent largement et dont les moyennes respectives sont presque parfaitement centrées sur zéro ! La raison principale : nous tenons compte de la difficulté des questions lors du calcul de l’aptitude. Là encore, l’exemple est un peu artificiel, mais il illustre la puissance de la TRI et sa capacité à démêler les contributions de la personne et de l’item dans les réponses. Appliquée à votre classe, cette approche ferait évidemment apparaître une variabilité des performances, mais au moins, fini les deux groupes artificiels !
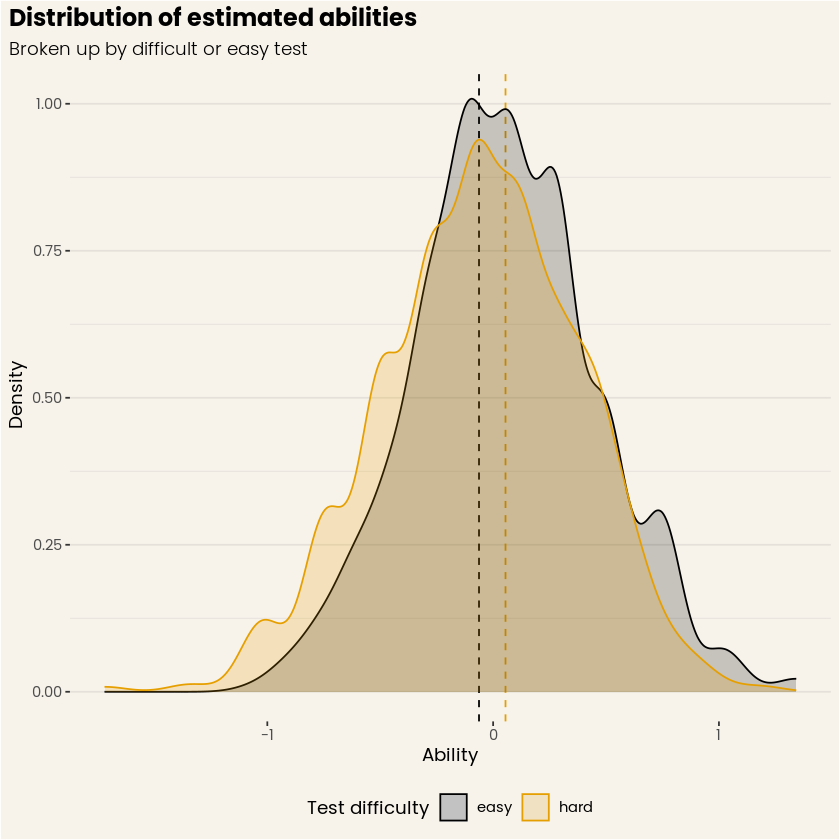
Figure 4. Répartition des aptitudes estimées, pour les tests « facile » et « difficile » simulés. (Source : DataCamp Workspace)
En conclusion
En résumé, la TRI nous permet de créer de nombreuses questions et de ne vous en présenter qu’un sous-ensemble tout en calculant votre score avec précision, sans compromettre la sécurité ni la qualité de nos tests ! Mieux encore, la TRI permet d’adapter les questions à votre niveau en temps réel. Oui, chaque test est différent, car nous déterminons de façon adaptative les questions que vous recevez ! Cela nous autorise à raccourcir les tests sans perdre en précision. Mais nous en reparlerons dans un prochain article. En attendant, lancez une évaluation ou obtenez votre certification ! ;)
[Les figures de cet article ont été générées avec DataCamp Workspace, notre notebook cloud qui fonctionne tout simplement. Découvrez Workspace ici, laissez un commentaire ou expérimentez par vous-même !]