Quizá recuerdes muy bien aquellos exámenes de la universidad y las conversaciones de después: ¿eran más difíciles tus preguntas que las de tus compañeros? O tal vez recuerdes un segundo intento que te pareció más fácil que el primero. Si sacaste mejor nota, ¿fue porque el examen era más sencillo o porque estudiaste más?
Esta es la cuestión clave cuando queremos medir los conocimientos, habilidades y competencias de una persona en un área concreta. Un enfoque típico para diseñar un examen es crear un conjunto de preguntas, presentárselas al alumnado, puntuar cada una como correcta/incorrecta y contar cuántas respuestas correctas hay sobre el total. Esa puntuación final pretende cuantificar el nivel de conocimientos del alumno y se usa para decidir si aprueba o suspende.
En DataCamp ofrecemos una experiencia similar. Puedes medir cómo te desenvuelves en un ámbito concreto (por ejemplo, Data Management en SQL) con nuestras evaluaciones: inicia sesión y prueba una aquí. Del mismo modo, en la DataCamp Certification, primero hay que aprobar una serie de exámenes para obtener la certificación.
Teoría clásica de los tests
En el centro del desarrollo de tests está un marco de medición llamado teoría clásica de los tests (CTT). La ecuación clásica de la CTT es la siguiente:
X = T + E
donde X es la puntuación observada, T la puntuación verdadera y E un componente de error. Esta ecuación indica que cualquier puntuación observada es una mezcla entre la puntuación verdadera de la persona y un error no sistemático. Este enfoque funciona bien cuando quieres medir a un conjunto de personas (por ejemplo, toda tu clase) sobre un mismo dominio con el mismo conjunto fijo de preguntas en un único momento. Si, por ejemplo, has desarrollado un conjunto de preguntas para evaluar habilidades en SQL, la CTT es un buen marco para analizar la calidad de ese test.
Sin embargo, DataCamp puede entenderse como un aula mundial gigante, donde los estudiantes pueden autoevaluarse en el área que les interesa u optar a una certificación 24/7.
En este entorno, pronto surgen problemas si intentamos basarnos en la CTT para garantizar la calidad de nuestros tests.
Dado que ofrecemos tanto evaluaciones como DataCamp Certifications con el objetivo de cuantificar los conocimientos, habilidades y competencias de los usuarios en un dominio concreto, no podemos hacer siempre las mismas 15 preguntas a todo el mundo. Nuestros tests serían muy vulnerables a filtraciones y a la memorización en reintentos. Con el tiempo, las puntuaciones perderían sentido.
Uso de la teoría de respuesta al ítem
Una solución sencilla es aumentar el número de preguntas que se pueden mostrar a cada usuario y/o renovar de forma continua el banco de preguntas del que se extraen. Pero la CTT solo considera la puntuación verdadera de la persona y ¡no dice nada de las preguntas! ¿Cómo estimamos la puntuación de alguien si no sabemos si las preguntas de tests consecutivos tenían una dificultad comparable?
Aquí entra la teoría de respuesta al ítem (IRT). La IRT es un marco de medición en el que la puntuación observada en una única pregunta (p. ej., correcto/incorrecto) se asume como el resultado de la interacción probabilística entre la habilidad de la persona y la dificultad del ítem. Formalmente:
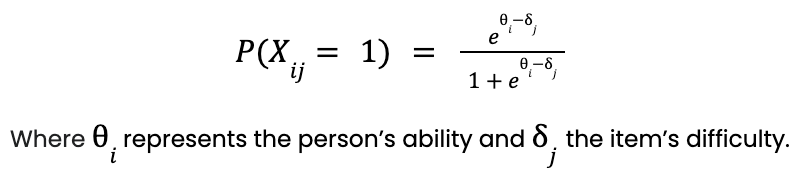
Este modelo también se conoce como modelo logístico de un parámetro (1-PL) o modelo de Rasch. Por motivos de estimación, se asume que las habilidades siguen una distribución normal centrada en 0 con desviación estándar 1. Esto da lugar a una escala expresada en desviaciones estándar que normalmente va de -4 a 4 (más del 99,99% de la distribución normal cae en ese rango). Tranquilo, ¡puedes transformar esta escala como quieras! Por ejemplo, en DataCamp, -3,33 coincide con una puntuación de 0, 0 con 100 y 3,33 con 200. Si fijamos la ecuación para un ítem específico (en este caso en 0) y variamos la habilidad entre -4 y 4, obtenemos la siguiente curva:
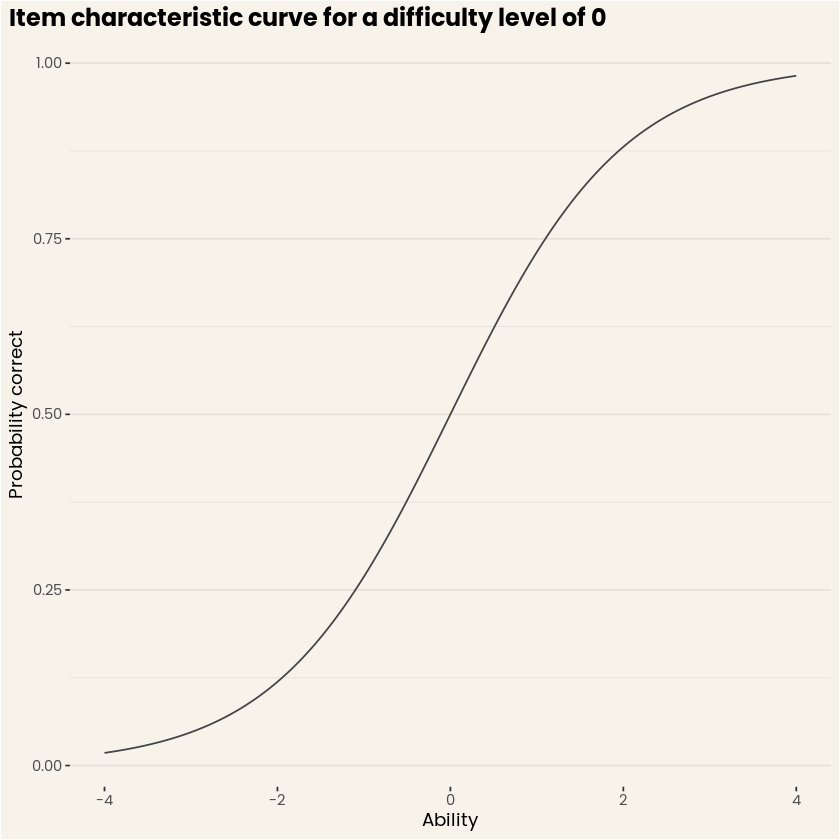
Figura 1. Curva característica de un ítem con nivel de dificultad 0. (Fuente: DataCamp Workspace)
Esta curva, llamada curva característica del ítem, expresa para cada nivel de habilidad la probabilidad esperada de responder correctamente a ese ítem. Cada ítem del banco se caracteriza por una curva así, y el conjunto de todas ellas describe por completo el rendimiento esperado en el test para cualquier persona. Lo mejor de estas curvas es que ofrecen una intuición clara de qué rendimiento esperar en un ítem según varía la habilidad.
Cómo usamos la IRT en DataCamp
Volvamos a nuestra motivación inicial. ¿Para qué nos sirve la IRT en DataCamp? La figura siguiente muestra un conjunto hipotético de 7 preguntas con distintos niveles de dificultad. Supongamos que mostramos las tres más fáciles y las tres más difíciles a la misma persona en dos sesiones distintas, en este caso con una habilidad media. Siguiendo las curvas, se ve claramente que el número esperado de aciertos en el test fácil sería de aproximadamente 2,5 (la suma de las probabilidades individuales), mientras que en el test difícil sería de unos 0,875. Dicho de forma contundente: si miramos solo aciertos, el resultado es casi tres veces mejor en el test fácil. Pero aquí está la clave: la IRT nos permite estimar una puntuación de habilidad en función de si la respuesta es correcta y del nivel de dificultad asociado. Así, seríamos capaces de recuperar correctamente una habilidad de 0 en ambos casos (con cierto error de medida según la longitud del test).
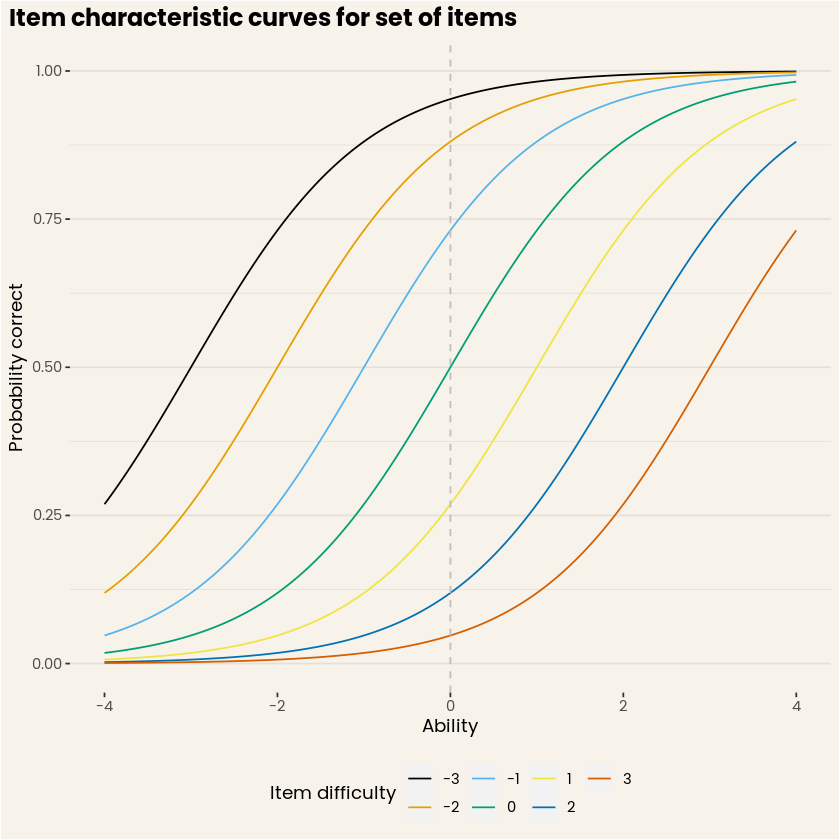
Figura 2. Curvas características de ítems para un conjunto de preguntas. (Fuente: DataCamp Workspace)
Hagamos una pequeña simulación para demostrarlo. Para asegurar una distribución suave de las puntuaciones, ampliamos el conjunto a 61 ítems, con dificultades de -3 a 3. Hacemos que 1000 usuarios hipotéticos, cuya habilidad verdadera es 0, respondan a 30 ítems entre -3 y 0 (test «fácil») o a 30 ítems entre 0 y 3 (test «difícil»). Podemos resumir los resultados de dos formas: con el número total de aciertos sobre 30 o con la habilidad estimada según el modelo IRT. Como era de esperar, la simulación da una media de 24 aciertos en el test fácil y solo 6 en el test difícil (véase la Figura 3). Aunque el ejemplo es un poco forzado, imagina que pones estas dos versiones a tu clase y cuantificas su rendimiento por número de aciertos. Ninguno es realmente mejor que otro, pero el recuento de aciertos generaría dos grupos totalmente distintos.
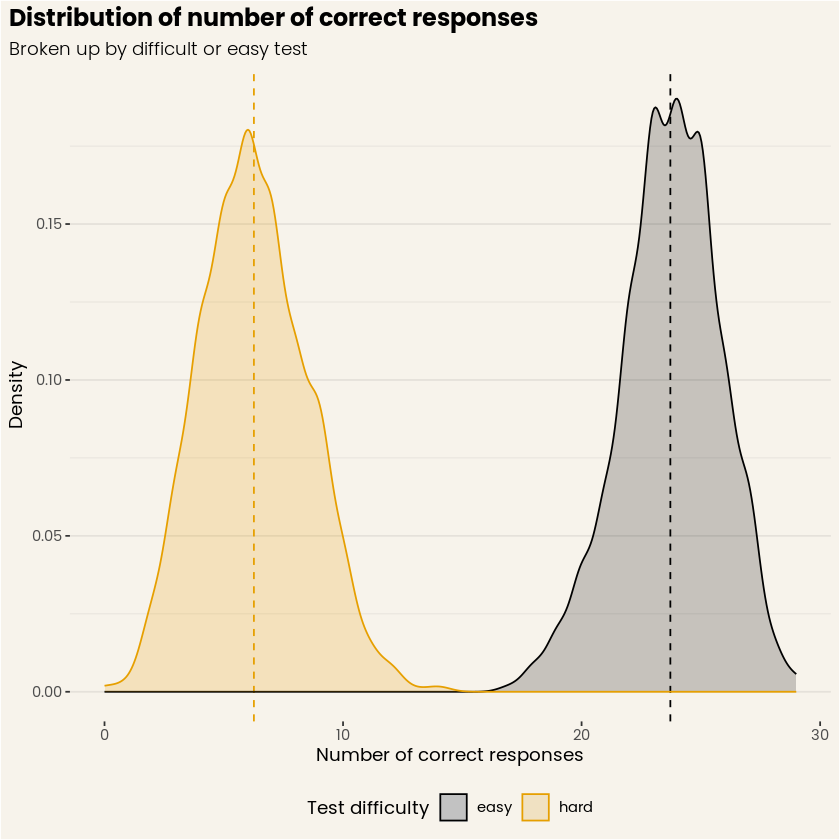
Figura 3. Distribución del número de aciertos en los tests fácil y difícil simulados. (Fuente: DataCamp Workspace)
La Figura 3 contrasta claramente con la Figura 4, donde las distribuciones de habilidades estimadas se superponen en gran medida y sus medias están casi perfectamente centradas en cero. La razón principal es que, al calcular la habilidad, tenemos en cuenta la dificultad de las preguntas. De nuevo, es un ejemplo un tanto artificial, pero muestra la potencia de la IRT y su capacidad para separar la contribución de la persona y la del ítem a las respuestas. Aplicado a tu clase, este enfoque seguiría mostrando variación en el rendimiento, pero al menos desaparecerían esos dos grupos artificiales.
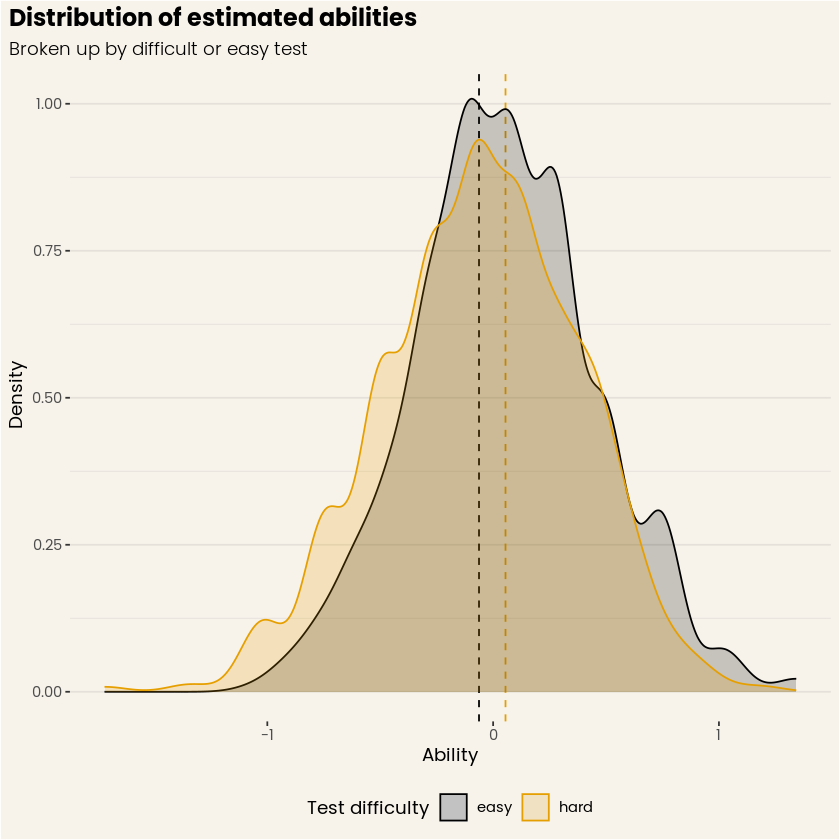
Figura 4. Distribución de habilidades estimadas para los tests fácil y difícil simulados. (Fuente: DataCamp Workspace)
Reflexiones finales
En resumen, la IRT nos permite crear muchas preguntas distintas y mostrarte subconjuntos sin dejar de calcular tu puntuación con precisión y sin comprometer la seguridad ni la calidad de nuestros tests. Aún hay más: la IRT permite presentar preguntas adaptadas a cómo lo estás haciendo durante el test. Sí, cada test es diferente porque determinamos de forma adaptativa qué pregunta debes ver. Esto nos permite acortar la duración sin perder precisión. Pero hablaremos más de ello en el próximo artículo. Ahora, haz una evaluación o consigue tu certificación. ;)
[Las figuras de este artículo se generaron con DataCamp Workspace, nuestro cuaderno en la nube que simplemente funciona. Échale un vistazo aquí, déjanos tus comentarios o ¡experimenta tú mismo!]