
Last chance! 50% off DataCamp Premium
Sale ends in
Anda mungkin masih ingat jelas saat mengikuti ujian di universitas atau sekolah tinggi dan kemudian berdiskusi apakah soal yang Anda dapatkan lebih sulit dibanding soal yang didapatkan mahasiswa lain. Atau Anda ingat mengikuti ujian ulang dan merasa ujian itu lebih mudah daripada yang sebelumnya. Apakah nilai Anda yang lebih tinggi disebabkan oleh ujian yang lebih mudah atau karena Anda belajar lebih giat?
Inilah inti dari mengukur pengetahuan, keterampilan, dan kemampuan seseorang dalam suatu domain. Pendekatan umum dalam merancang ujian adalah menyusun seperangkat pertanyaan, memberikannya kepada mahasiswa, menilai setiap pertanyaan sebagai benar/salah, lalu menghitung jumlah jawaban benar dari seluruh pertanyaan. Skor akhir ini kemudian dianggap sebagai kuantifikasi pengetahuan mahasiswa yang digunakan untuk menentukan lulus atau tidaknya ujian.
Di DataCamp, kami menyediakan pengalaman serupa. Pengguna dapat mengukur performa mereka pada domain tertentu (misalnya, Manajemen Data di SQL) menggunakan asesmen kami - masuk dan coba salah satunya di sini! Demikian pula, dalam Sertifikasi DataCamp, pengguna harus lulus serangkaian ujian untuk memperoleh sertifikasi.
Di jantung pengembangan tes terdapat kerangka pengukuran yang disebut teori tes klasik (classical test theory/CTT). Persamaan klasik yang mendasari CTT adalah sebagai berikut:
X = T + E
di mana X adalah skor tes yang teramati, T skor sebenarnya, dan E komponen galat. Persamaan ini menyatakan bahwa skor yang teramati adalah campuran antara skor sejati seseorang dan komponen galat yang tidak sistematis. Pendekatan ini cocok saat Anda ingin mengukur sekelompok orang (misalnya, semua mahasiswa di kelas Anda) pada suatu domain dengan seperangkat pertanyaan yang sama dan tetap dalam satu waktu. Sebagai contoh, jika Anda menyusun seperangkat pertanyaan untuk menilai keterampilan SQL seseorang, CTT adalah kerangka yang baik untuk menganalisis kualitas tes tersebut.
Namun, DataCamp dapat dipandang sebagai satu ruang kelas raksasa di seluruh dunia, tempat para pelajar dapat menilai diri mereka pada domain yang diminati atau berupaya memperoleh sertifikasi 24/7.
Dalam lingkungan kami, kami cepat menemui kendala jika hanya mengandalkan CTT untuk menjamin kualitas tes.
Karena kami menyediakan asesmen dan Sertifikasi DataCamp yang bertujuan mengkuantifikasi pengetahuan, keterampilan, dan kemampuan pengguna pada domain tertentu, kami tidak bisa menanyakan 15 pertanyaan yang sama berulang kali kepada semua orang. Tes kami akan sangat rentan terhadap kebocoran soal dan penghafalan soal saat mengulang tes. Seiring waktu, skor akan menjadi tidak bermakna.
Solusi sederhananya adalah meningkatkan jumlah pertanyaan yang dapat ditampilkan kepada pengguna dan/atau terus-menerus menyegarkan kumpulan pertanyaan yang dapat diambil sampelnya. Namun, CTT hanya mempertimbangkan skor sejati seseorang dan sama sekali tidak membahas pertanyaan! Bagaimana kita dapat memperkirakan skor seseorang ketika kita tidak tahu apakah pertanyaannya memiliki tingkat kesulitan yang sebanding pada tes-tes berurutan?
Di sinilah Item Response Theory (IRT) berperan. IRT adalah kerangka pengukuran di mana skor teramati pada satu pertanyaan (misalnya, benar/salah) diasumsikan sebagai hasil interaksi probabilistik antara kemampuan seseorang dan kesulitan suatu butir soal. Secara formal:
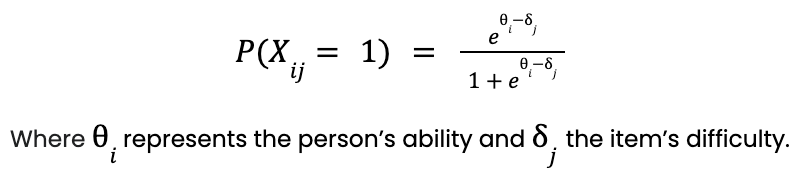
Model ini juga dikenal sebagai model logistik satu parameter (1-PL) atau model Rasch. Demi kemudahan estimasi, kemampuan diasumsikan mengikuti distribusi normal berpusat di 0 dengan simpangan baku 1. Ini menghasilkan skala yang dinyatakan dalam simpangan baku dan umumnya berkisar antara -4 hingga 4 (karena lebih dari 99,99% distribusi normal tercakup dalam rentang ini). Jangan khawatir, Anda dapat mentransformasikan rentang ini menjadi skala apa pun yang Anda mau! Misalnya, di DataCamp -3,33 berkorespondensi dengan skor 0, 0 dengan skor 100, dan 3,33 dengan skor 200. Ketika persamaan ini ditetapkan untuk satu butir tertentu (dalam hal ini di 0) dan kemampuan divariasikan antara -4 hingga 4, Anda mendapatkan kurva berikut:
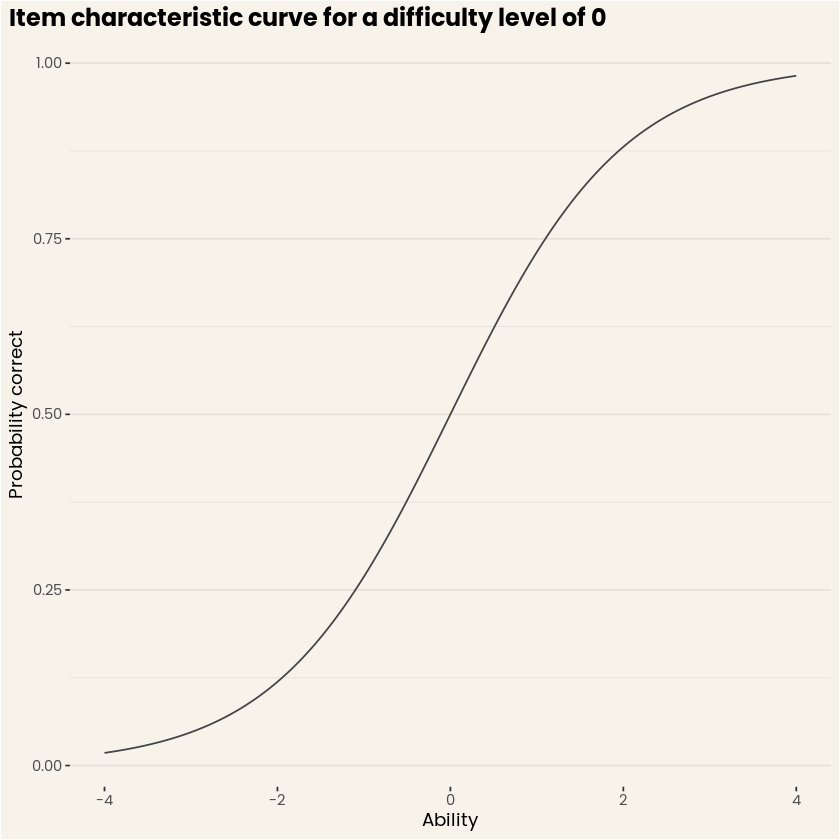
Gambar 1. Kurva karakteristik butir untuk sebuah butir dengan tingkat kesulitan 0. (Sumber: DataCamp Workspace)
Kurva ini juga dikenal sebagai kurva karakteristik butir dan menyatakan, untuk setiap tingkat kemampuan, berapa probabilitas yang diharapkan untuk menjawab benar pada butir tersebut. Setiap butir dalam suatu kumpulan dicirikan oleh kurva seperti ini, dan himpunan seluruh kurva sepenuhnya menyatakan performa tes yang diharapkan untuk siapa pun. Hal menarik dari kurva karakteristik butir adalah Anda mendapatkan intuisi tentang performa yang diharapkan pada suatu butir, dengan berbagai tingkat kemampuan peserta!
Sekarang mari kita uji motivasi awal kita! Apa kegunaan IRT bagi DataCamp? Gambar di bawah menunjukkan seperangkat hipotetis berisi 7 pertanyaan dengan tingkat kesulitan berbeda. Misalkan kita menampilkan tiga pertanyaan termudah dan tiga tersulit kepada orang yang sama dalam dua sesi tes berbeda, dalam hal ini seseorang dengan tingkat kemampuan rata-rata. Terlihat jelas dari penelusuran kurva bahwa jumlah jawaban benar yang diharapkan pada tes mudah sekitar 2,5 (probabilitas individual dijumlahkan), sedangkan pada tes sulit jumlahnya sekitar 0,875! Dengan kata lain, hasilnya hampir tiga kali lebih baik pada tes mudah jika hanya melihat jawaban benar. Namun, inilah kuncinya: IRT memungkinkan kita memperkirakan skor kemampuan berdasarkan kebenaran respons dan tingkat kesulitan terkait. Dengan cara ini, kita dapat memulihkan skor kemampuan 0 pada kedua kasus (dengan catatan ada galat pengukuran tergantung panjang tes).
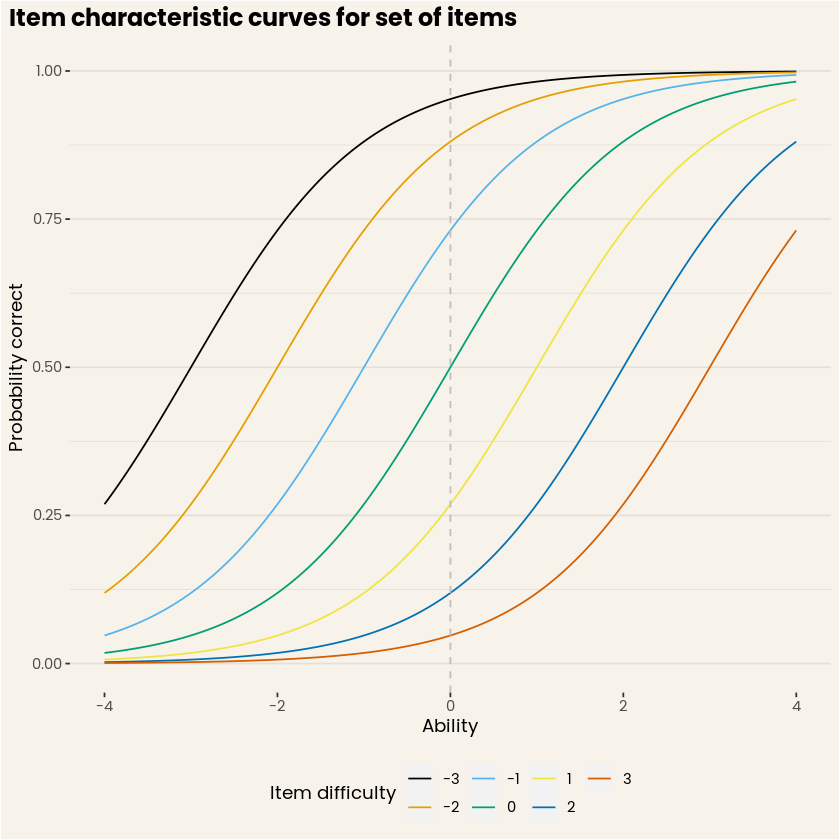
Gambar 2. Kurva karakteristik butir untuk satu set butir. (Sumber: DataCamp Workspace)
Mari kita jalankan simulasi kecil untuk menunjukkan bahwa hal ini memang terjadi. Untuk memastikan distribusi skor tes yang mulus, kami memperluas himpunan butir menjadi total 61, tetap berkisar dari -3 hingga 3 dalam kesulitan. Kami membuat 1000 pengguna (hipotetis) dengan skor sejati 0 merespons 30 butir yang berkisar dari -3 hingga 0 (tes “mudah”), atau 30 butir yang berkisar dari 0 hingga 3 (tes “sulit”). Kita dapat meringkas hasilnya dengan dua cara, menggunakan jumlah total butir benar dari 30, atau tingkat kemampuan yang diestimasi berdasarkan model IRT. Tidak mengherankan, simulasi menghasilkan rata-rata 24 pertanyaan benar pada tes mudah, dan hanya 6 benar pada tes sulit (lihat Gambar 3). Meski contoh ini agak dibuat-buat, bayangkan Anda memberikan dua bentuk tes ini kepada mahasiswa di kelas dan menggunakan jumlah jawaban benar untuk mengukur performa mereka. Tidak ada satu pun mahasiswa yang sebenarnya lebih baik daripada yang lain, tetapi jelas bahwa jumlah jawaban benar akan menghasilkan dua kelompok mahasiswa yang sama sekali berbeda!
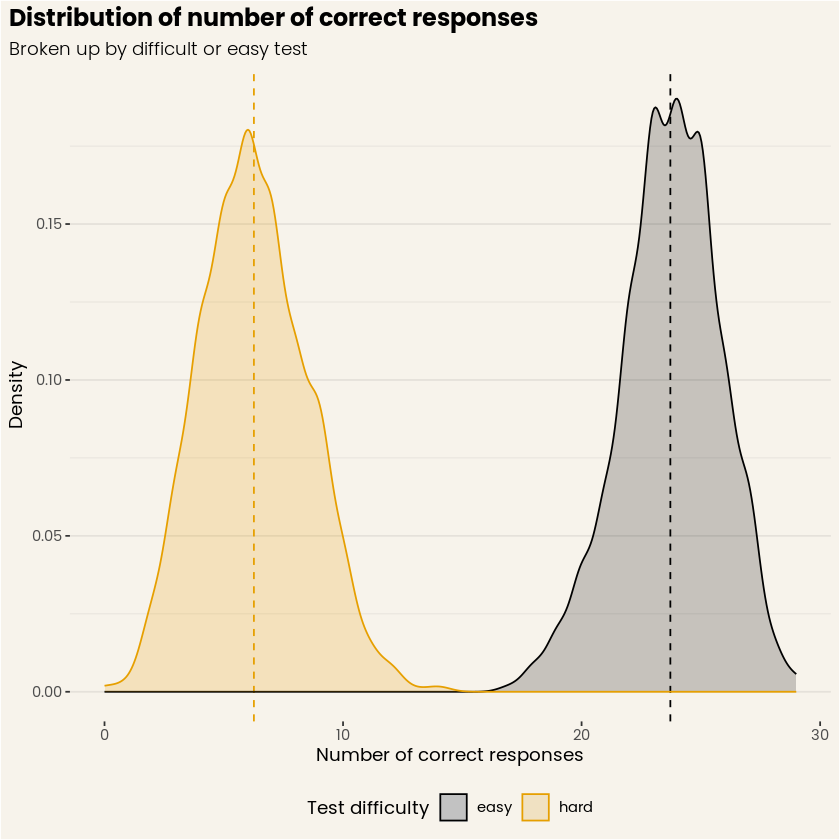
Gambar 3. Distribusi jumlah respons benar, untuk tes mudah dan sulit yang disimulasikan. (Sumber: DataCamp Workspace)
Gambar 3 sangat kontras dengan Gambar 4, di mana distribusi kemampuan yang diestimasi saling tumpang tindih kuat, dan rata-ratanya masing-masing hampir tepat terpusat di nol! Alasan utamanya adalah kami memperhitungkan kesulitan pertanyaan saat kemampuan dihitung. Sekali lagi, ini memang contoh yang agak dibuat-buat, tetapi ini menunjukkan kekuatan IRT dan kemampuannya memisahkan kontribusi peserta dan butir terhadap respons butir. Diterapkan pada kelas Anda, pendekatan ini tentu masih akan menghasilkan variasi performa, tetapi setidaknya dua kelompok mahasiswa tadi tidak lagi muncul!
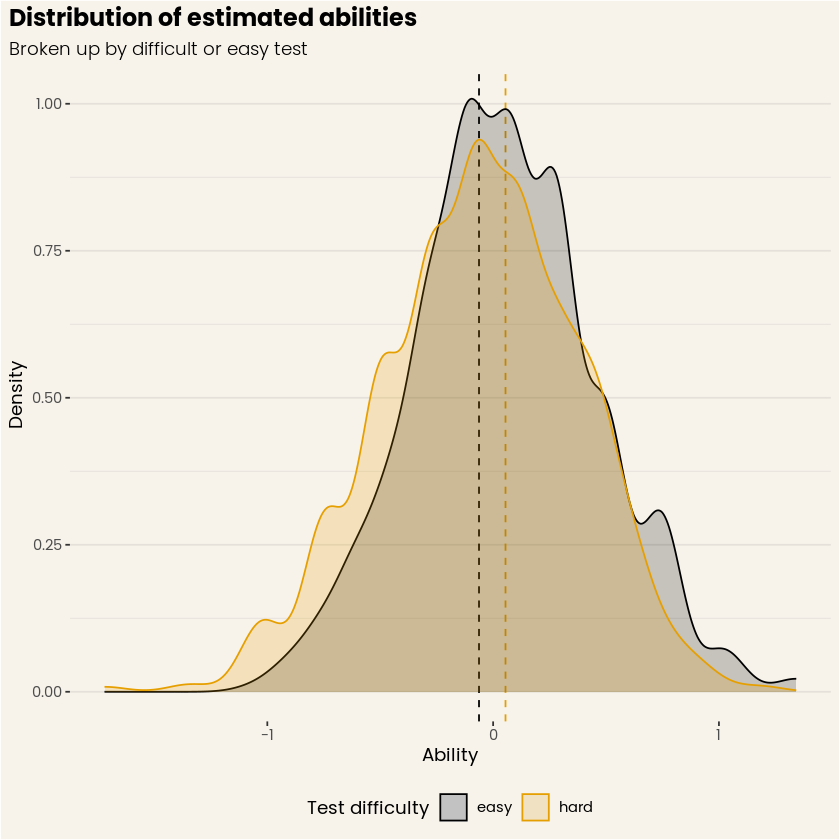
Gambar 4. Distribusi kemampuan yang diestimasi, untuk tes mudah dan sulit yang disimulasikan. (Sumber: DataCamp Workspace)
Singkatnya, IRT memungkinkan kami membuat banyak pertanyaan berbeda dan menyajikan subset kepada Anda sambil tetap menghitung skor Anda secara akurat tanpa mengorbankan keamanan dan kualitas tes! Lebih dari itu, IRT memungkinkan penyajian pertanyaan yang disesuaikan dengan performa Anda saat mengerjakan tes. Benar, setiap tes berbeda karena kami menentukan pertanyaan yang Anda dapatkan secara adaptif! Ini memungkinkan kami mempersingkat tes tanpa mengurangi ketelitian. Namun lebih lanjut tentang itu akan dibahas dalam postingan blog berikutnya! Sekarang, silakan ikuti sebuah asesmen atau dapatkan sertifikasi! ;)
[Gambar-gambar dalam postingan blog ini dibuat menggunakan DataCamp Workspace, notebook berbasis cloud kami yang langsung siap pakai. Coba Workspace di sini, silakan beri komentar, atau bereksperimen sendiri!]
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



