Você provavelmente se lembra bem das provas na faculdade e das conversas depois, tentando entender se as perguntas que você pegou eram mais difíceis do que as dos seus colegas. Ou talvez tenha feito uma segunda chamada e achado a prova mais fácil do que a anterior. Sua nota maior veio porque a avaliação estava mais fácil ou porque você simplesmente estudou mais?
Essa é a essência do desafio de medir o conhecimento, as habilidades e as competências de uma pessoa em um determinado domínio. Uma forma típica de criar uma prova é definir um conjunto de perguntas, aplicá-las aos alunos, marcar cada questão como certa/errada e contar quantas foram respondidas corretamente. Essa pontuação final deveria quantificar o conhecimento do aluno e, com base nela, decidir se ele foi aprovado ou reprovado.
Na DataCamp, oferecemos uma experiência semelhante. Usuários podem medir seu desempenho em um domínio específico (por exemplo, Data Management em SQL) usando nossas avaliações — faça login e experimente uma aqui! Da mesma forma, na DataCamp Certification, os usuários precisam primeiro ser aprovados em um conjunto de exames para obter a certificação.
Teoria clássica dos testes
No centro do desenvolvimento de avaliações está um arcabouço de mensuração chamado teoria clássica dos testes (TCT). A equação clássica por trás da TCT é a seguinte:
X = T + E
em que X é a pontuação observada, T é a pontuação verdadeira e E é um componente de erro. Essa equação diz que toda pontuação observada é uma mistura da pontuação verdadeira da pessoa com um componente de erro não sistemático. Essa abordagem funciona bem quando você quer medir um grupo de pessoas (por exemplo, todos os alunos da sua turma) em um domínio usando o mesmo conjunto fixo de questões em um único momento. Se você desenvolveu um conjunto de perguntas para avaliar habilidades em SQL, por exemplo, a TCT é um bom referencial para analisar a qualidade dessa prova.
A DataCamp, porém, pode ser vista como uma grande sala de aula global, onde alunos podem se autoavaliar no domínio de interesse ou buscar uma certificação 24 horas por dia, 7 dias por semana.
Nesse contexto, rapidamente esbarramos em limitações ao depender da TCT para garantir a qualidade das nossas avaliações.
Como oferecemos tanto avaliações quanto certificações DataCamp, nas quais queremos quantificar o conhecimento, as habilidades e as competências do usuário em um domínio específico, não podemos fazer sempre as mesmas 15 perguntas para todo mundo. Isso deixaria nossas provas vulneráveis a vazamentos de questões e à memorização em retentativas. Com o tempo, as notas perderiam o sentido.
Usando a teoria de resposta ao item
Uma solução simples seria aumentar o número de perguntas que podem ser exibidas a um usuário e/ou atualizar continuamente o banco de itens do qual amostramos. No entanto, a TCT considera apenas a pontuação verdadeira da pessoa e não diz nada sobre as perguntas em si! Como estimar a pontuação de alguém quando não sabemos se as questões tinham dificuldade comparável entre provas consecutivas?
Entra em cena: a teoria de resposta ao item (TRI). A TRI é um arcabouço de mensuração em que a resposta observada a uma única pergunta (por exemplo, certa/errada) é resultado de uma interação probabilística entre a habilidade da pessoa e a dificuldade do item. Formalmente:
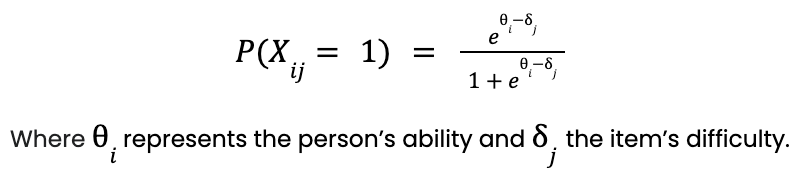
Esse modelo também é conhecido como modelo logístico de um parâmetro (1-PL) ou modelo de Rasch. Por conveniência de estimação, assume-se que as habilidades seguem uma distribuição normal centrada em 0, com desvio-padrão 1. Isso gera uma escala em desvios-padrão que geralmente varia de -4 a 4 (já que mais de 99,99% da distribuição normal está nesse intervalo). Sem problemas: dá para transformar essa escala no que você quiser! Na DataCamp, por exemplo, -3,33 corresponde a nota 0, 0 corresponde a 100 e 3,33 a 200. Fixando a equação para um item específico (neste caso em 0) e variando a habilidade entre -4 e 4, obtemos a seguinte curva:
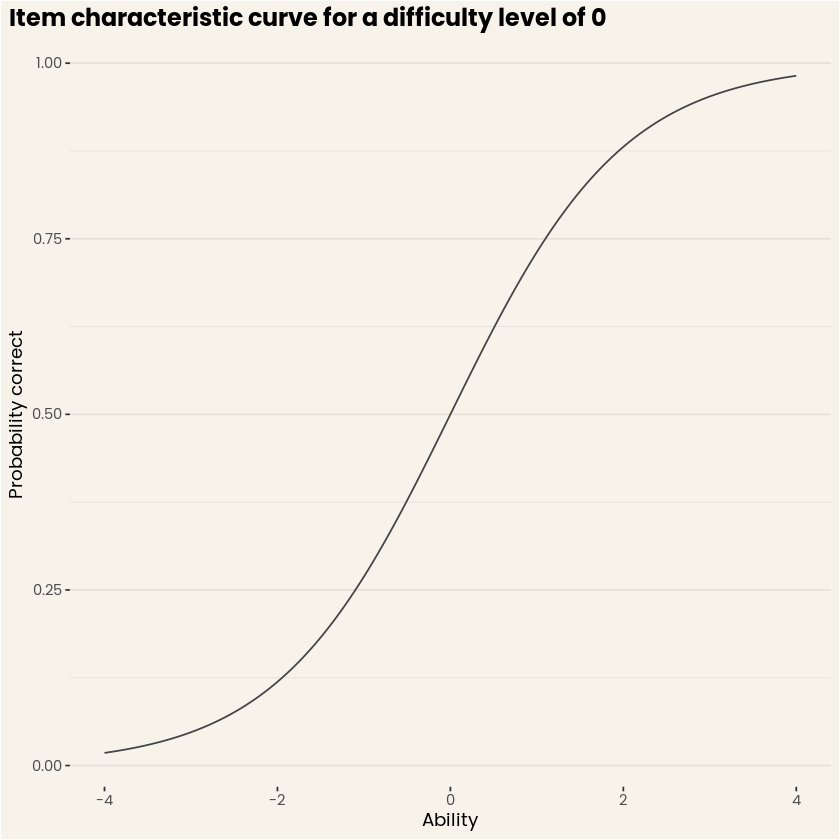
Figura 1. Curva característica do item para um item com nível de dificuldade 0. (Fonte: DataCamp Workspace)
Essa curva, chamada de curva característica do item, expressa, para cada nível de habilidade, a probabilidade esperada de acertar aquele item. Cada item do banco é caracterizado por uma curva como essa, e o conjunto de todas elas descreve completamente o desempenho esperado em teste para qualquer pessoa. O bom das curvas características é que elas ajudam a entender o desempenho que se pode esperar em um item, dado um nível de habilidade!
Como usamos a TRI na DataCamp
Vamos colocar nossa motivação inicial à prova! Como a TRI ajuda na DataCamp? A figura abaixo mostra um conjunto hipotético com 7 perguntas de diferentes dificuldades. Suponha que mostramos as três mais fáceis e, em outra sessão, as três mais difíceis para a mesma pessoa, com habilidade média. Seguindo as curvas, fica claro que o número esperado de acertos no teste fácil seria aproximadamente 2,5 (a soma das probabilidades individuais), enquanto no teste difícil seria cerca de 0,875! Em outras palavras, quase três vezes melhor no teste fácil se olharmos apenas para acertos. Mas aqui está o pulo do gato: a TRI permite estimar uma habilidade com base no acerto/erro e no nível de dificuldade associado. Assim, conseguimos recuperar corretamente uma habilidade igual a 0 nos dois casos (considerando um erro de medida que depende do tamanho do teste).
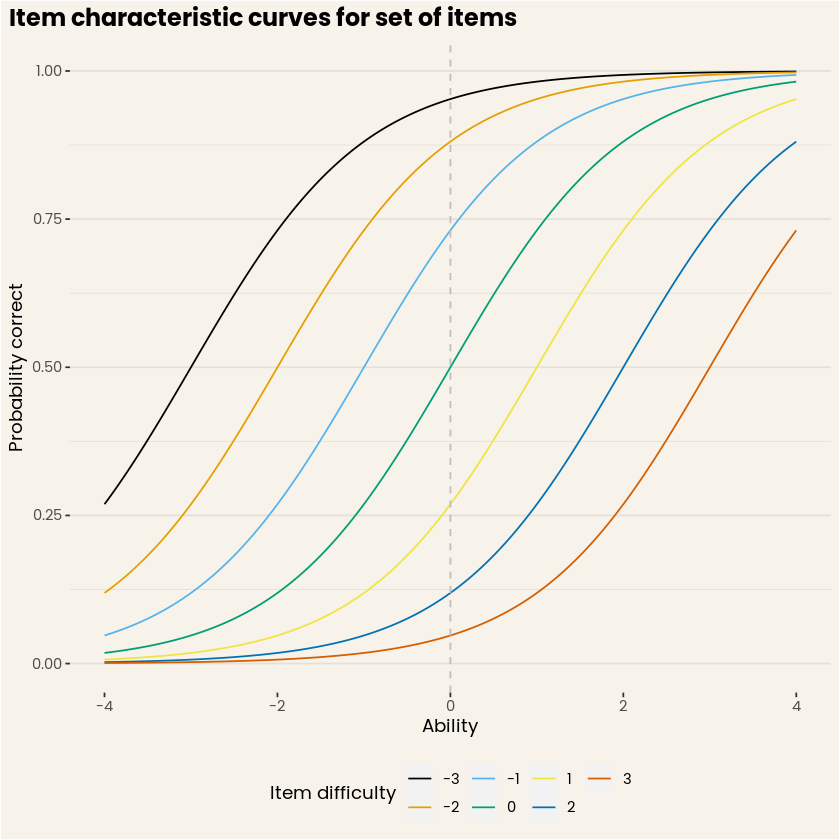
Figura 2. Curvas características para um conjunto de itens. (Fonte: DataCamp Workspace)
Vamos rodar uma pequena simulação para mostrar que isso de fato acontece. Para garantir uma distribuição mais suave das pontuações, ampliamos o conjunto para 61 itens, ainda variando de -3 a 3 em dificuldade. Consideramos 1000 usuários (hipotéticos) com pontuação verdadeira igual a 0 respondendo a 30 itens entre -3 e 0 (o teste “fácil”) ou a 30 itens entre 0 e 3 (o teste “difícil”). Resumimos os resultados de duas formas: pelo total de acertos em 30 itens ou pelo nível de habilidade estimado via modelo de TRI. Sem surpresa, a simulação resulta em média de 24 acertos no teste fácil e apenas 6 no teste difícil (veja a Figura 3). Embora o exemplo seja um pouco artificial, imagine aplicar essas duas versões de prova na sua turma e usar só o número de acertos para medir o desempenho. Ninguém é realmente melhor do que o outro, mas é claro que o número de acertos formaria dois grupos totalmente diferentes!
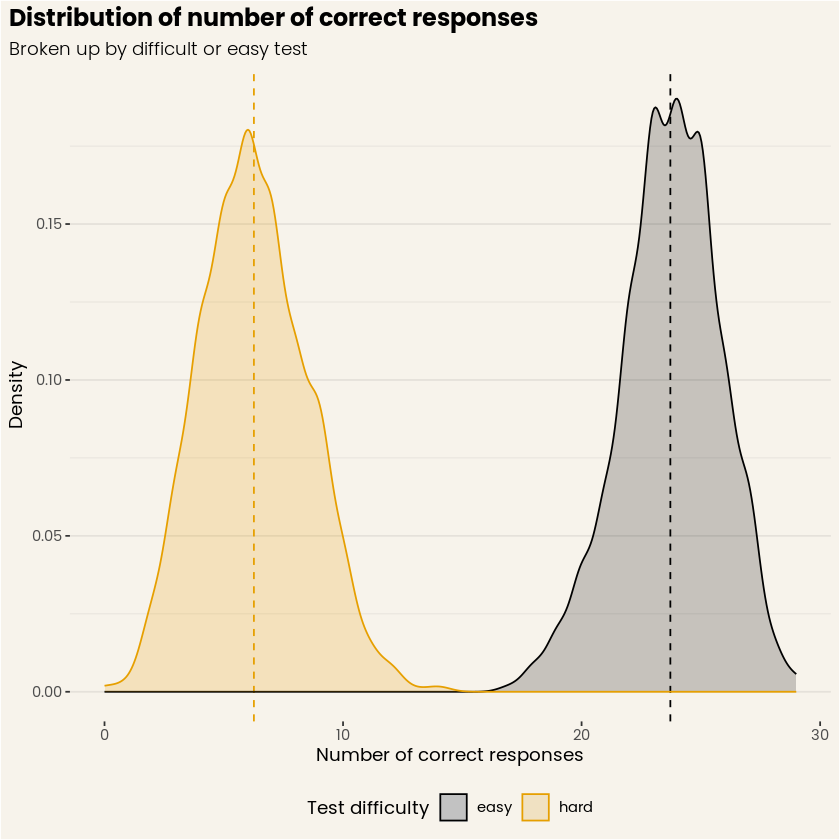
Figura 3. Distribuição do número de acertos, para testes simulados fácil e difícil. (Fonte: DataCamp Workspace)
A Figura 3 contrasta fortemente com a Figura 4, em que as distribuições das habilidades estimadas se sobrepõem bastante, e suas médias estão quase perfeitamente centradas em zero! O principal motivo é que consideramos a dificuldade das questões no cálculo da habilidade. De novo, é um exemplo um tanto artificial, mas mostra a força da TRI e sua capacidade de separar as contribuições da pessoa e do item nas respostas. Aplicado à sua turma, esse método ainda mostraria variação de desempenho, mas pelo menos aqueles dois “grupos” deixariam de existir!
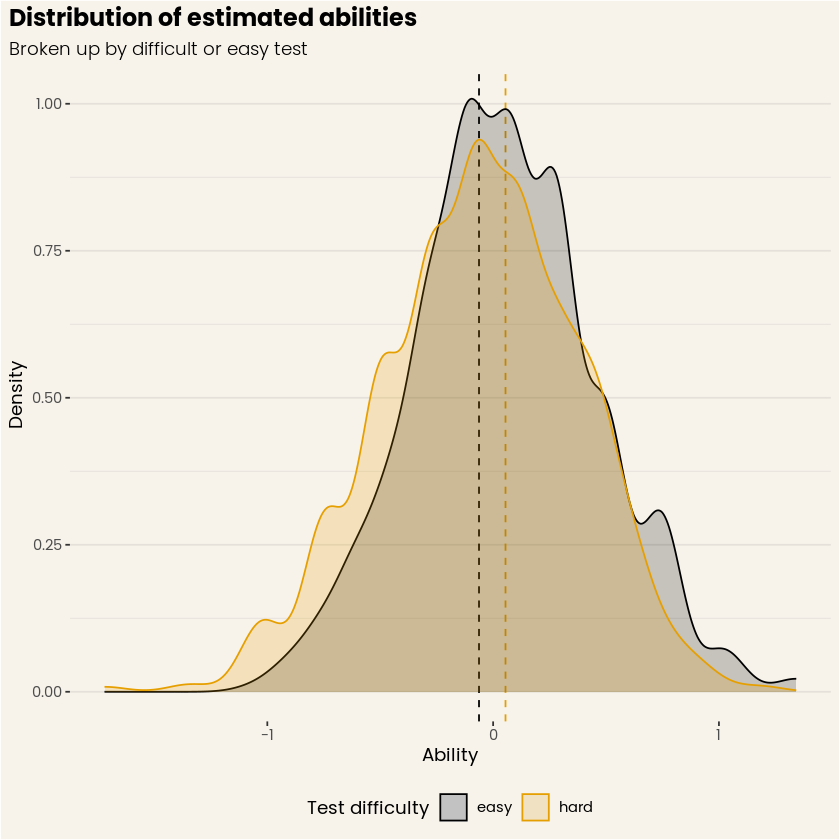
Figura 4. Distribuição das habilidades estimadas, para os testes simulados fácil e difícil. (Fonte: DataCamp Workspace)
Considerações finais
Em resumo, a TRI permite criar muitas perguntas diferentes e apresentar subconjuntos para você, calculando sua pontuação com precisão e sem comprometer a segurança e a qualidade das nossas avaliações! Mais do que isso, a TRI possibilita apresentar questões adaptadas ao seu desempenho durante o teste. Sim, cada prova é diferente porque definimos de forma adaptativa quais perguntas você vai receber! Isso nos permite encurtar o teste sem perder precisão. Mas falaremos mais sobre isso em um próximo post! Agora, faça uma avaliação ou conquiste sua certificação! ;)
[As figuras deste post foram geradas com o DataCamp Workspace, nosso notebook em nuvem que simplesmente funciona. Confira o Workspace aqui, deixe um comentário ou experimente você mesmo!]