आपको शायद विश्वविद्यालय या कॉलेज में परीक्षाएँ देने का अनुभव याद हो और बाद में यह चर्चा करना भी कि क्या आपके प्रश्न अन्य छात्रों के प्रश्नों से अधिक कठिन थे। या फिर आपको यह याद हो कि पुनर्परीक्षा में बैठने पर वह पिछली बार से आसान लगी। आपका ऊंचा ग्रेड आसान परीक्षा की वजह से था या आपने बस ज्यादा अध्ययन किया था?
यही बात किसी व्यक्ति के किसी क्षेत्र में ज्ञान, कौशल, और क्षमताओं को मापने के मूल में है। परीक्षा डिजाइन करने का एक सामान्य तरीका यह है कि प्रश्नों का एक सेट तैयार किया जाए, उन्हें छात्रों के सामने रखा जाए, प्रत्येक प्रश्न का सही/गलत के रूप में अंकन किया जाए, और सभी प्रश्नों में से सही उत्तरों की संख्या गिनी जाए। यह अंतिम स्कोर तब छात्र के ज्ञान का परिमाण माना जाता है, जिसके आधार पर यह तय किया जाता है कि आप परीक्षा पास करते हैं या असफल होते हैं।
DataCamp पर हम इसी तरह का अनुभव प्रदान करते हैं। उपयोगकर्ता हमारे आकलनों का उपयोग करके किसी विशिष्ट क्षेत्र (जैसे, SQL में डेटा प्रबंधन) में अपना प्रदर्शन माप सकते हैं — साइन इन करें और एक यहाँ आज़माएँ! इसी तरह, DataCamp Certification में, उपयोगकर्ताओं को प्रमाणन प्राप्त करने के लिए पहले परीक्षाओं के एक सेट को पास करना होता है।
Classical Test Theory
परीक्षा विकास के केंद्र में एक मापन रूपरेखा होती है जिसे classical test theory (CTT) कहा जाता है। CTT का आधारभूत शास्त्रीय समीकरण इस प्रकार है:
X = T + E
जहाँ X प्रेक्षित टेस्ट स्कोर है, T वास्तविक स्कोर है, और E त्रुटि घटक है। यह समीकरण कहता है कि कोई भी प्रेक्षित स्कोर, व्यक्ति के वास्तविक स्कोर और कुछ गैर-प्रणालीगत त्रुटि का मिश्रण होता है। यह तरीका तब उपयुक्त है जब आप एक ही समय पर, समान और स्थिर प्रश्नों के सेट के साथ, लोगों के एक समूह (जैसे कक्षा के सभी छात्र) को किसी डोमेन पर मापना चाहते हैं। उदाहरण के लिए, मान लें आपने ऐसे प्रश्नों का सेट विकसित किया है जो किसी व्यक्ति के SQL कौशल को परखते हैं, तो CTT उस टेस्ट की गुणवत्ता का विश्लेषण करने के लिए एक अच्छा ढांचा है।
हालाँकि, DataCamp को एक विशाल वैश्विक कक्षा की तरह समझा जा सकता है जहाँ छात्र 24/7 अपनी रुचि के किसी भी क्षेत्र का आकलन कर सकते हैं या प्रमाणन प्राप्त करने का प्रयास कर सकते हैं।
हमारे परिवेश में, जब हम अपने टेस्ट की गुणवत्ता सुनिश्चित करने के लिए CTT पर निर्भर होने की कोशिश करते हैं, तो हमें जल्दी ही समस्याओं का सामना करना पड़ता है।
क्योंकि हम आकलन और DataCamp Certifications दोनों प्रदान करते हैं जहाँ हम किसी विशिष्ट क्षेत्र में उपयोगकर्ता के ज्ञान, कौशल, और क्षमताओं को परिमाणित करना चाहते हैं, हम सभी से बार-बार एक ही 15 प्रश्न नहीं पूछ सकते। ऐसा करने से हमारे टेस्ट लीक हुए प्रश्नों और पुनर्परीक्षा के समय प्रश्नों को रट लेने के प्रति बहुत संवेदनशील हो जाएंगे। समय के साथ स्कोर अर्थहीन हो जाएंगे।
Item Response Theory का उपयोग
इसका एक सरल समाधान यह है कि उपयोगकर्ता को दिखाए जा सकने वाले प्रश्नों की संख्या बढ़ा दी जाए और/या जिन प्रश्नों के पूल से सैंपल लिया जा सकता है, उसे निरंतर ताज़ा किया जाए। लेकिन, CTT केवल व्यक्ति के वास्तविक स्कोर पर विचार करता है, प्रश्नों के बारे में कुछ भी नहीं कहता! जब हमें यह न पता हो कि लगातार परीक्षाओं में प्रश्नों की कठिनाई तुलनीय थी या नहीं, तो हम किसी व्यक्ति के स्कोर का अनुमान कैसे लगाएँ?
यहीं आती है: आइटम रिस्पॉन्स थ्योरी (IRT)। IRT एक मापन रूपरेखा है जिसमें किसी एक प्रश्न पर प्रेक्षित स्कोर (जैसे, सही/गलत) को व्यक्ति की क्षमता और आइटम की कठिनाई के बीच प्रायिकतामूलक अंतःक्रिया का परिणाम माना जाता है। औपचारिक रूप से:
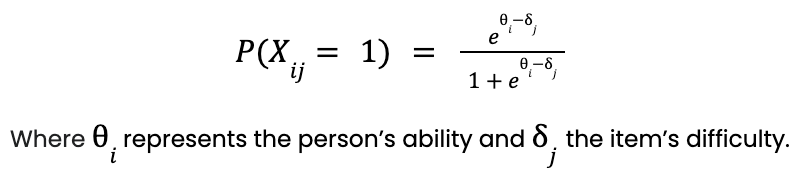
इस मॉडल को one-parameter logistic model (1-PL) या Rasch मॉडल भी कहा जाता है। आकलन के कारणों से, क्षमताओं को 0 केंद्रित और 1 मानक विचलन के साथ सामान्य वितरण का पालन करने वाला माना जाता है। इससे एक ऐसा पैमाना प्राप्त होता है जो मानक विचलनों में व्यक्त होता है और सामान्यतः -4 से 4 के बीच रहता है (क्योंकि सामान्य वितरण का 99.99% से अधिक हिस्सा इसी दायरे में आता है)। चिंता न करें, आप इस दायरे को किसी भी स्केल में बदल सकते हैं! उदाहरण के लिए, DataCamp पर -3.33 का मतलब 0 स्कोर, 0 का मतलब 100, और 3.33 का मतलब 200 स्कोर होगा। जब इस समीकरण में किसी विशिष्ट आइटम को निश्चित कर दिया जाए (इस मामले में 0 पर) और क्षमता को -4 से 4 तक बदला जाए, तो आपको निम्नलिखित वक्र मिलता है:
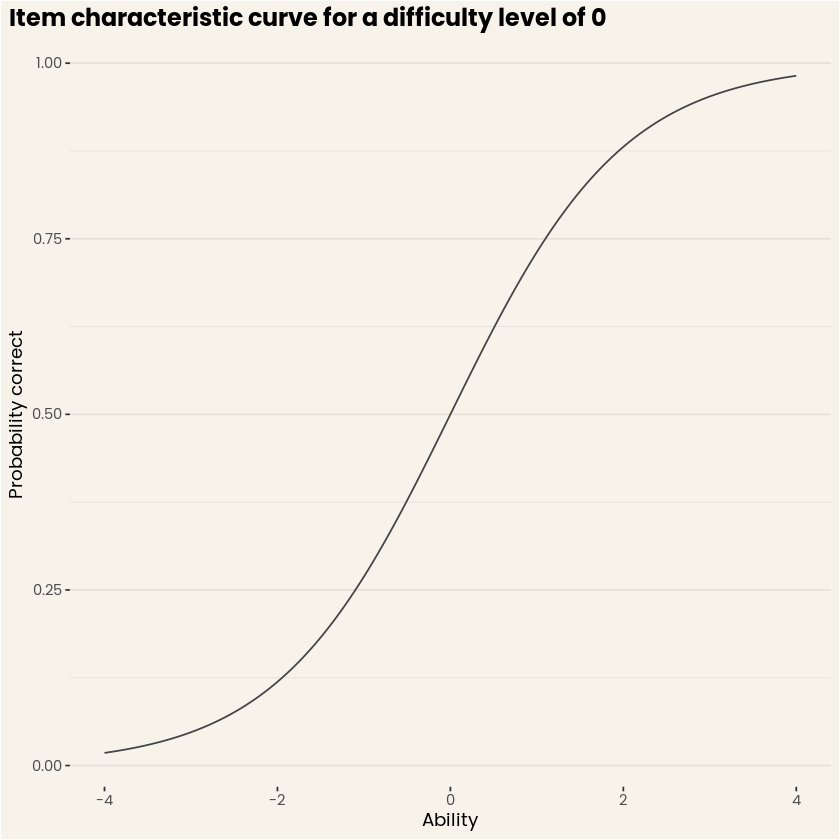
चित्र 1. कठिनाई स्तर 0 वाले आइटम के लिए आइटम कैरेक्टरिस्टिक कर्व। (स्रोत: DataCamp Workspace)
इस वक्र को आइटम कैरेक्टरिस्टिक कर्व भी कहा जाता है और यह प्रत्येक क्षमता स्तर के लिए उस आइटम का सही उत्तर देने की अपेक्षित प्रायिकता व्यक्त करता है। पूल में प्रत्येक आइटम की विशेषता ऐसे ही एक वक्र से होती है, और सभी वक्रों का समूह मिलकर किसी भी व्यक्ति के लिए अपेक्षित टेस्ट प्रदर्शन को पूर्ण रूप से दर्शाता है। आइटम कैरेक्टरिस्टिक कर्व की अच्छी बात यह है कि विभिन्न क्षमताओं के मद्देनज़र, आपको किसी आइटम पर किस तरह के प्रदर्शन की उम्मीद करनी चाहिए, इसका सहज बोध मिल जाता है!
DataCamp में IRT का उपयोग
अब अपनी प्रारंभिक प्रेरणा को परखते हैं! DataCamp के लिए IRT का क्या उपयोग है? नीचे दिया गया चित्र 7 काल्पनिक प्रश्नों का एक सेट दिखाता है जिनकी कठिनाई अलग-अलग है। मान लें हम दो अलग-अलग टेस्ट सत्रों में उसी व्यक्ति को तीन सबसे आसान और तीन सबसे कठिन प्रश्न दिखाते हैं, यहाँ व्यक्ति की क्षमता औसत स्तर की है। वक्रों का अनुगमन करने से स्पष्ट है कि आसान टेस्ट पर सही उत्तरों की अपेक्षित संख्या लगभग 2.5 होगी (व्यक्तिगत प्रायिकताओं का योग), जबकि कठिन टेस्ट पर यह लगभग 0.875 होगी! सीधी बात कहें तो, सिर्फ सही उत्तरों की संख्या देखें तो आसान टेस्ट पर प्रदर्शन लगभग तीन गुना बेहतर दिखेगा। लेकिन यहीं तरकीब है—IRT हमें उत्तर की शुद्धता और उससे जुड़ी कठिनाई के आधार पर क्षमता स्कोर का अनुमान लगाने देता है। इस तरह, हम दोनों ही मामलों में क्षमता स्कोर 0 को सही ढंग से पुनर्प्राप्त कर सकते हैं (टेस्ट की लंबाई पर निर्भर कुछ मापन त्रुटि के साथ)।
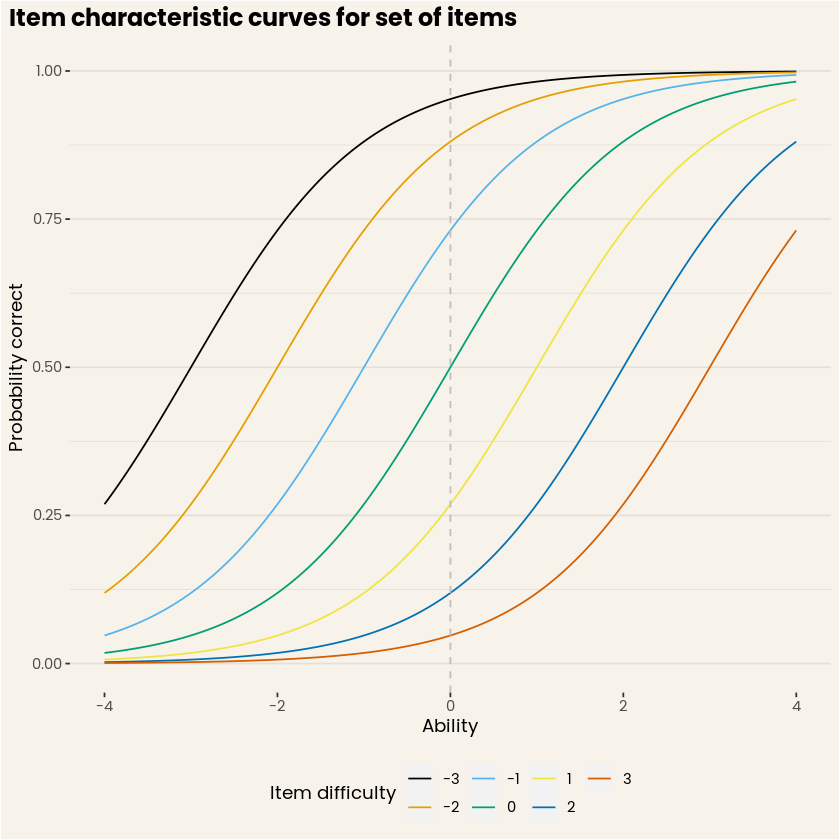
चित्र 2. आइटमों के एक सेट के लिए आइटम कैरेक्टरिस्टिक कर्व। (स्रोत: DataCamp Workspace)
आइए एक छोटा-सा सिमुलेशन चलाते हैं ताकि यह दिखाया जा सके कि वास्तव में ऐसा ही होता है। टेस्ट स्कोरों का एक स्मूथ वितरण सुनिश्चित करने के लिए, हम आइटमों के सेट को बढ़ाकर कुल 61 कर देते हैं, जिनकी कठिनाई अब भी -3 से 3 के बीच रहती है। हम 1000 (काल्पनिक) उपयोगकर्ताओं को, जिनका वास्तविक स्कोर 0 है, या तो -3 से 0 तक के 30 आइटमों का उत्तर देने देते हैं ("आसान" टेस्ट), या 0 से 3 तक के 30 आइटमों का ("कठिन" टेस्ट)। हम परिणामों को दो तरीकों से संक्षेपित कर सकते हैं: 30 में से सही आइटमों की कुल संख्या के आधार पर, या IRT मॉडल के आधार पर अनुमानित क्षमता स्तर के आधार पर। अपेक्षित रूप से, सिमुलेशन में आसान टेस्ट पर औसतन 24 प्रश्न सही आते हैं, जबकि कठिन टेस्ट पर केवल 6 सही आते हैं (चित्र 3 देखें)। यद्यपि यह उदाहरण थोड़ा कृत्रिम है, कल्पना करें कि आप अपनी कक्षा में छात्रों को ये दो टेस्ट फॉर्म देते हैं और उनके प्रदर्शन को सही उत्तरों की संख्या से मापते हैं। आपके किसी भी छात्र की क्षमता वास्तव में दूसरे से बेहतर नहीं है, लेकिन स्पष्ट है कि सही उत्तरों की संख्या उन्हें दो पूरी तरह अलग समूहों में बाँट देगी!
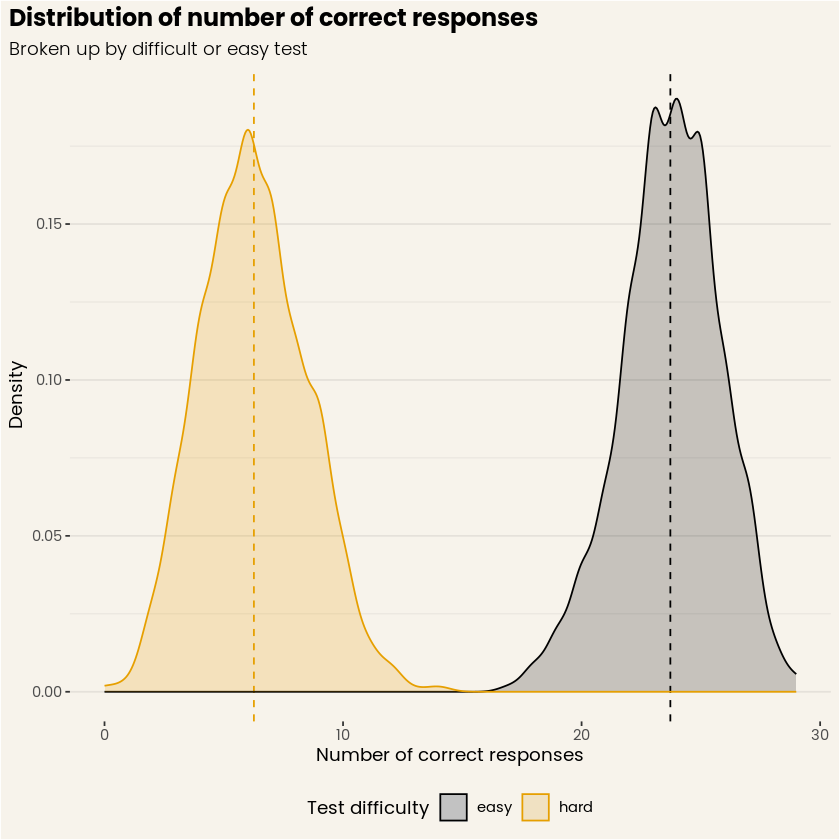
चित्र 3. सिमुलेटेड आसान और कठिन टेस्ट के लिए सही उत्तरों की संख्या का वितरण। (स्रोत: DataCamp Workspace)
चित्र 3 के बिल्कुल विपरीत, चित्र 4 में अनुमानित क्षमताओं के वितरण काफी हद तक ओवरलैप करते हैं, और उनके औसत लगभग पूर्णतः शून्य के आसपास केंद्रित हैं! इसका मुख्य कारण यह है कि क्षमता की गणना करते समय हम प्रश्नों की कठिनाई का हिसाब रखते हैं। फिर से, यह कुछ हद तक कृत्रिम उदाहरण है, पर यह IRT की शक्ति और आइटम प्रतिक्रियाओं में व्यक्ति तथा आइटम के योगदानों को अलग-अलग पहचानने की उसकी क्षमता दिखाता है। आपकी कक्षा में लागू करने पर, यह तरीका निश्चित ही प्रदर्शन में कुछ भिन्नता दिखाएगा, पर कम से कम वे दो अलग-अलग छात्रों के समूह तो नहीं बनेंगे!
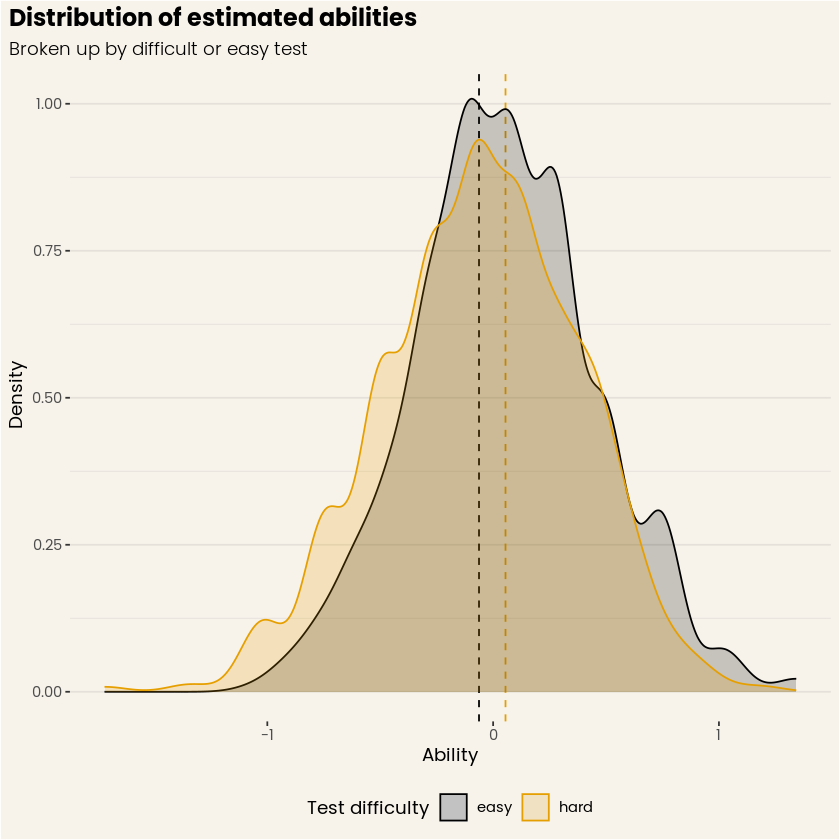
चित्र 4. सिमुलेटेड आसान और कठिन दोनों टेस्ट के लिए अनुमानित क्षमताओं का वितरण। (स्रोत: DataCamp Workspace)
अंतिम विचार
संक्षेप में, IRT हमें अनेक भिन्न प्रश्न बनाने और उनमें से उपसमुच्चय आपको प्रस्तुत करने की सुविधा देता है, जबकि आपका स्कोर अब भी सटीक रूप से निकाला जा सकता है और हमारे टेस्ट की सुरक्षा तथा गुणवत्ता से समझौता नहीं होता! इससे भी बढ़कर, IRT आपको ऐसे ढंग से प्रश्न प्रस्तुत करने की अनुमति देता है जो टेस्ट में आपके प्रदर्शन के अनुरूप हों। जी हाँ, प्रत्येक टेस्ट अलग होता है क्योंकि हम यह अनुकूलनीय तरीके से तय करते हैं कि आपको कौन-सा प्रश्न मिलना चाहिए! इससे हम टेस्ट को छोटा कर सकते हैं, बिना उसकी सटीकता घटाए। लेकिन इस पर और बात अगली ब्लॉग पोस्ट में! अब जाएँ और एक आकलन दें या प्रमाणित हों! ;)
[इस ब्लॉग पोस्ट के चित्र DataCamp Workspace का उपयोग करके बनाए गए हैं, हमारा क्लाउड-आधारित नोटबुक जो बस काम करता है। Workspace को यहाँ देखें, इस पर टिप्पणी करने या स्वयं प्रयोग करने के लिए स्वतंत्र महसूस करें!]