课程
在 R 中使用 caret 的机器学习
4 小时
61K
这是一个由三部分组成的教程系列的第一部分,您将使用 R 对传奇艺术家 Prince 的歌曲歌词案例进行多种分析任务。三篇教程涵盖如下内容:
音乐歌词可能代表艺术家的视角,但流行歌曲也揭示了社会想听到什么。歌词分析并不容易。由于其结构常与散文截然不同,因此在假设上需要谨慎,并需要独特而有区分度的分析技术选择。音乐歌词渗透于我们的生活,并以不露声色的方式影响我们的思考。关于“可预测的歌词”的概念正开始流行,并越来越多地成为论文与毕业研究的主题。本案例研究仅会触及这一新兴话题的部分内容。
为致敬 Prince 留下的富有启发性且风格多样的作品,您将探索他歌词中有时直白、却更多隐藏的讯息。不过,您不必喜欢 Prince 的音乐,也能理解他对全球多种音乐流派发展的影响。《滚石》杂志将 Prince 列为史上第18位最优秀的词曲作者,排在 Bob Dylan、John Lennon、Paul Simon、Joni Mitchell 与 Stevie Wonder 之后。随着“热门金曲”预测日渐接近现实,歌词分析正逐步进入数据科学社区。
Prince 是一个满溢着音乐的人——创作力旺盛的词曲作者,精通吉他、键盘与鼓,并且是放克、摇滚、R&B 与流行乐的大师级架构师,尽管他的音乐常常超越流派之界。——Jon Pareles(纽约时报)
在本教程(系列的第一部分)中,您将使用整洁文本框架对一组歌词应用文本挖掘技术。整洁数据集具有特定结构:每个变量为一列、每条观测为一行、每种观测单元为一张表。完成清洗与整形后,您将针对 Prince 歌词的不同侧面,创建描述性统计与探索性可视化。
本系列第一部分需要您对整洁数据有基本了解——特别是 dplyr(数据转换)、ggplot2(可视化)以及源自 magrittr 包的 %>% 管道运算符等包。每篇教程都会介绍可用于分析的工具,但未必对每一步骤都详述。您会注意到,多个步骤常通过 %>% 运算符组合在一起。作为案例研究,同样要牢记:您所做的一切推论都只是观察性的;因此,相关性并不意味着因果关系。
提示:关于所用工具的背景知识,可参考两本优秀资源——Garrett Grolemund 与 Hadley Wickham 的 R for Data Science;以及 Julia Silge 与 David Robinson 的 Text Mining with R。
第二、三部分
在另一篇教程(第二部分)中,您将讲解情感分析与主题建模,以捕捉 Prince 音乐的整体情绪与主题,并探讨其在社会视角中的应用。您将使用情感词典,评估二元与类别情感,绘制时间趋势,并查看 n-gram 与词语关联。同时,您还会使用自然语言处理(NLP)与聚类技术,如潜在狄利克雷分配(LDA)与 K-Means,来挖掘歌词中的母题。
在第三部分中,您将把工作闭环:利用探索性结果帮助预测歌曲发行的年代,更有趣的是,仅基于歌词预测一首歌是否会登上 Billboard 榜单。您将使用决策树(rpart 与 C50)、K 近邻(class)与朴素贝叶斯(e1071)等机器学习工具,构建一个可接受文本的分类器。
三部分都将使用同一数据集:Prince 的歌词、发行年份与 Billboard 排名。此研究中的技术也可应用于许多其他类型文本。事实上,对于标准散文,结果通常更易解释,因为歌词往往以间接表达与细微差别为设计目标。
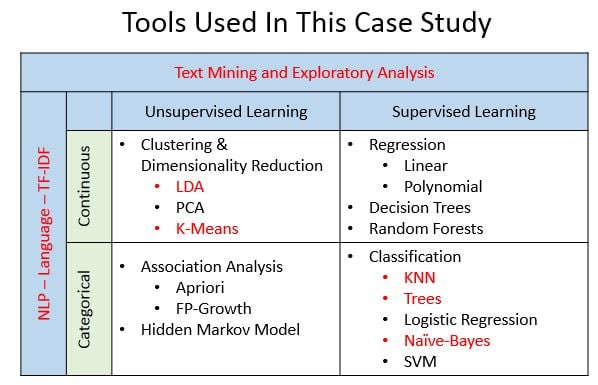
总之,分析歌词的方法很多。下图中以红色标注的是本系列涵盖的方法。请注意,此图仅是高度概括的“模糊”示意。当然,我不是说图像本身模糊!事实是,建模与机器学习技术的不同方面如今界限已十分模糊,并不一定能像下图那样装进一个单独的盒子里。所以,戴上 3D 眼镜看这张图,或许更有意义!
除了学习与实践新技能外,本教程还旨在探讨歌词分析这一概念的一些基本问题。近期研究显示,流行音乐中的“歌词智商”可能在下降。有研究甚至认为,冠军单曲中使用的词汇与美国小学三年级的阅读水平相当。是否可以利用文本挖掘、NLP、机器学习等数据科学方法来阐明此类话题?是否可以根据歌曲受欢迎程度来识别更能打动社会的主题?是否可能仅凭歌词分析就预测一首歌能否走红?在本第一篇教程中,您将以探索性练习的方式考察 Prince 音乐的歌词复杂度。
在深入之前,先想想您想发现什么。哪些问题值得关注?您将首先走通一遍对数据集的分析。它长什么样?共有多少歌曲?歌词如何编排?需要做多少清洗与整理?有哪些事实?词频如何,为什么这很重要?从技术角度看,您需要理解并为情感分析、NLP 与机器学习模型做好数据准备。
音乐一直是与大众沟通的有效方式,而歌词在传递这种沟通中发挥了巨大作用。然而,关于歌词对[社会]福祉影响的研究机会仍被严重低估。——Patricia Fox Ransom
获取文本挖掘数据的常见方法是使用 rvest 包从网页抓取内容。我通过不同网站抓取了 Billboard 榜单信息与 Prince 的歌词,并按歌曲标题进行合并。由于标题命名规范不一致,花了不少时间清洗整理。随后我主观决定移除所有非原版歌曲(如混音、加长版、俱乐部混音、重制版等)。我也移除了包含其热门金曲历史合集的专辑,以避免重复。完成一些小清理后,我将结果保存为一个可用于本教程的 csv 文件。
由于第一部分聚焦于文本挖掘,我未在本教程中包含相应代码,但数据集可在此处下载,方便您跟练。
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
从 csv 文件读入数据的方法有多种,但我选择使用 read.csv() 将歌词、发行年份与 Billboard 排名加载为一个数据框。注意,R 默认会将所有字符型字符串转换为因子。这会在后续引发问题,但您可以将 stringsAsFactors 参数设为 FALSE 以避免。现在来检查一下数据……
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
您可以用 names() 函数查看数据框中的列:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
因为这个文件是我创建的,我知道 X 只是行号,text 则是实际歌词。其他需要的字段包括 song、year 与 peak(其表示在 Billboard 榜单上的位置)。US.Pop 与 US.R.B 是美国(流行与 R&B 榜单)的峰值排名,因此也要保留;其余字段暂时丢弃。
通过将原始数据集 prince_orig 管道传入 select() 并使用 %>%,即可完成上述操作。这样可以自左向右阅读代码。
另外注意,select() 允许您在一步中重命名列。将 text 改为 lyrics,并将美国相关列按 tidyverse 风格重命名为使用“_”而非“.”。然后将结果存为 prince,后续教程都将使用它。dplyr 提供了 glimpse() 函数,可轻松以转置视图查看数据。
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
第一个显而易见的问题是:有多少条观测与多少列?
dim(prince)
[1] 824 7
通过 dim() 可见共有 7 列与 824 条观测。每条观测是一首歌。正如我所说……多产!
查看某首歌的 lyrics 列,您可以看到歌词的结构。
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
有大量可清理之处,现在开始动手吧。
您可以用不同方法对数据进行整形。一个选项是使用 tm 文本挖掘包将数据框转换为语料与文档-词条矩阵(Corpus 与 DTM),再通过 tm_map() 完成清洗,但本教程暂且坚持基础方法,使用 gsub() 与apply() 系列函数来“脏活儿”上阵。
首先,编写一个小函数,通过 gsub() 处理大多数情况,去掉恼人的缩写形式,然后将该函数应用到所有歌词。
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
您还会注意到有一些会干扰文本的特殊字符。可以用 gsub() 与一个简单正则表达式将其删除。注意,务必在此步骤前先展开缩写!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
为保持一致,使用便捷的 tolower() 函数将所有文本转换为小写。
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
此时再查看歌词,会发现原始文本已更为整洁。
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
文本挖掘整形中的另一常见步骤是“词干化”(stemming),即将词语还原至其词根含义。这本身是个独立话题,日后再谈。现在,先看下 prince 数据框的概况。
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
如您所见,歌曲跨越 37 年,且最低上榜位置(在本数据集中)为第 88 位。您也会发现 year 与 peak 有不少 NA。由于您将进行不同类型的分析,建议保留完整数据于 prince 数据框,按需过滤。
既然您的目标问题之一是跨时间观察歌曲趋势,而数据集中有单独的发行年份,您可以创建分箱,将年份按年代分组。使用 dplyr 的 mutate() 创建新字段 decade。一种方法是结合 ifelse() 与 %in% 运算符按年份过滤,并将歌曲按年代分箱。然后将结果回存至 prince(本质上是新增一个字段)。
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
您也可以为 chart_level 做同样的事,它表示歌曲峰值位于 Top 10、Top 100,或未上榜(即 Uncharted)。这三者互斥,因此 Top 100 不包含 Top 10 歌曲。
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
此外,创建名为 charted 的二元字段,指示歌曲是否上过 Billboard 榜(即是否为流行歌曲)。使用 write.csv() 保存,供后续教程使用。
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
为了自定义图表,我喜欢先创建一组独特颜色,以保持视觉一致。网上有很多地方可以按十六进制代码获取如下面这样的可区分色。如果您对图表有偏好,也可以创建自己的主题,按需应用于 ggplot()。
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
在进入文本挖掘之前,先从歌曲层面的基础视图开始。现在正适合看一眼 Prince 每个年代发布了多少歌曲。提醒一下,他的职业生涯从 1978 年开始,一直持续到 2015 年(见上方 summary() 统计)。但既然我们要看趋势,而数据集中 year 有大量空值,那么第一张图就需要过滤掉所有年份为 NA 的记录。
使用 dplyr 的 filter()、group_by() 与 summarise(),您可以按 decade 分组并统计歌曲数量。n() 是与 summarise() 配合用于分组数据的多个聚合函数之一。然后用 ggplot() 与 geom_bar() 创建柱状图,并用 charted 类别填充柱子。
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Released Songs") +
  labs(x = NULL, y = "Song Count")
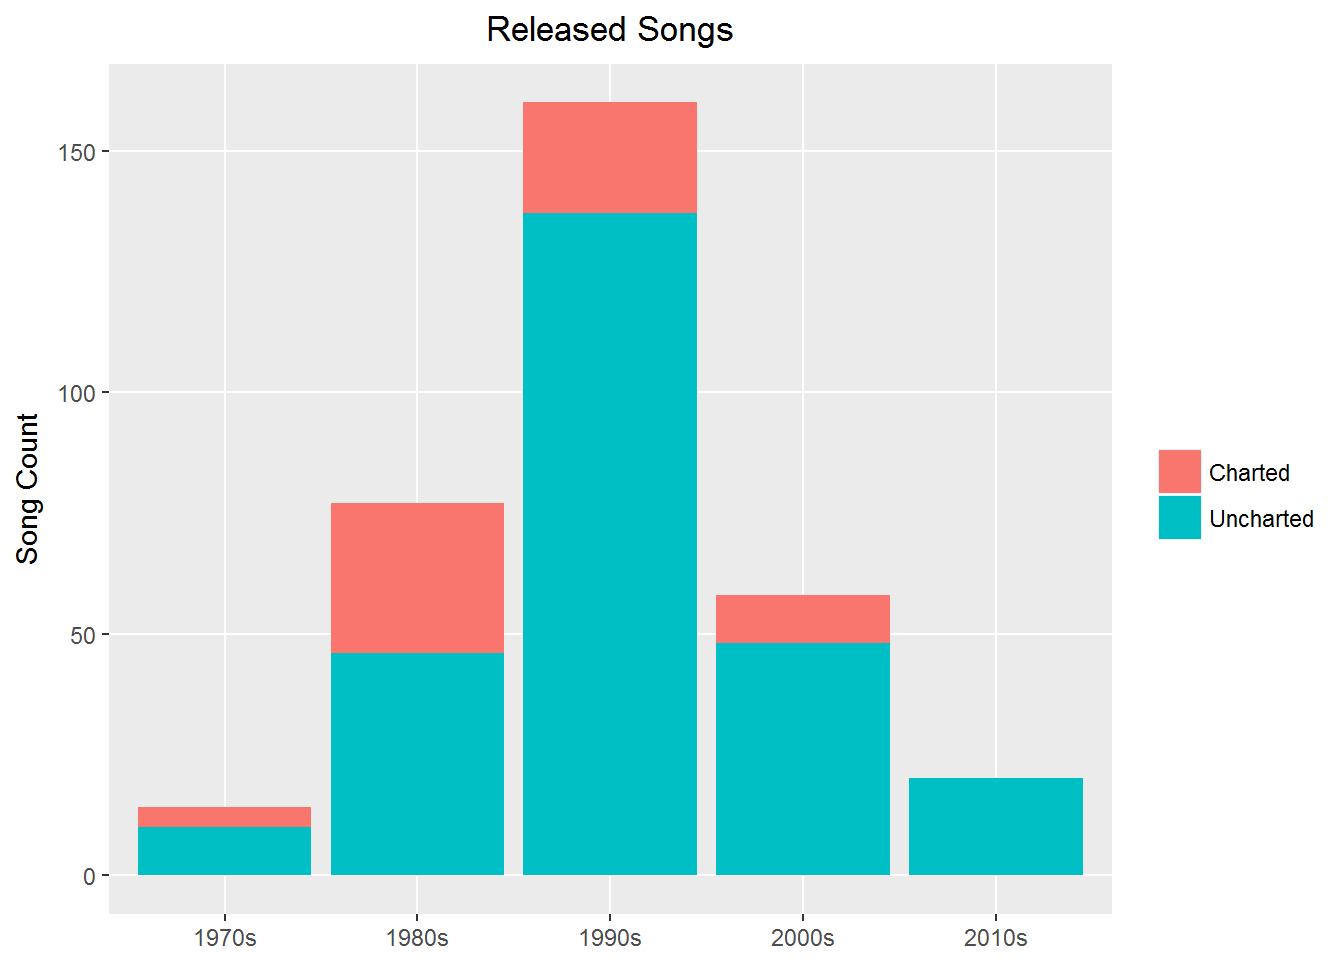
这清楚表明他最活跃的年代是 1990 年代。
现在用 chart_level 创建一张类似的图。
记得要同时 group_by() decade 与 chart_level 以便观察趋势。
在这张图中,您只看上榜歌曲,因此用 peak > 0 过滤掉其他。将 group_by 的结果传入 summarise(),用 n() 统计歌曲数量。将其存入变量后,再管道到 ggplot() 画出简单柱状图。
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("Charted Songs")
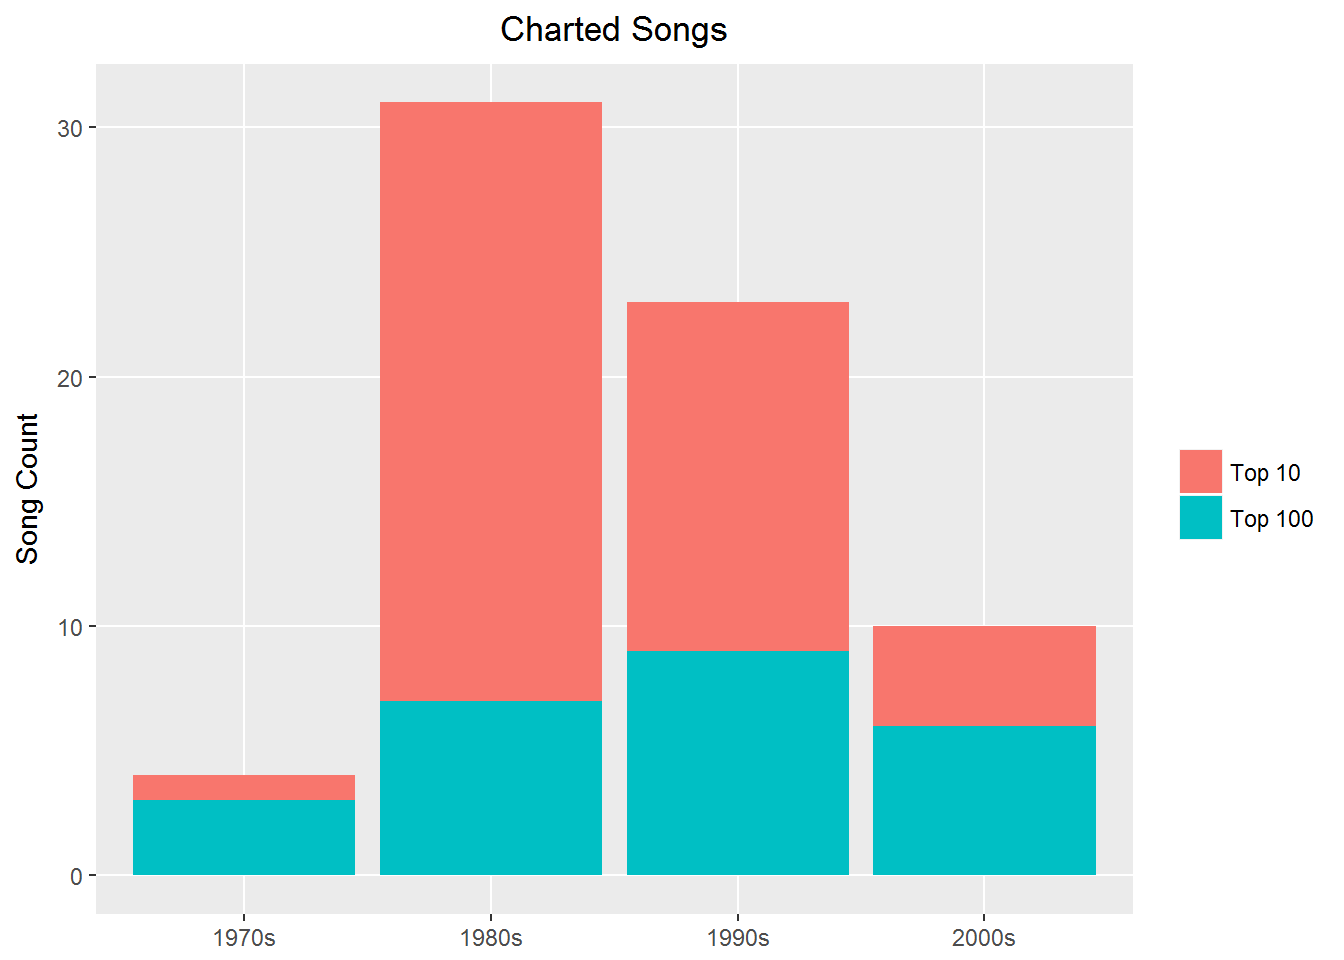
请注意,在所有上榜歌曲中,大多数进入了 Top 10。但更有趣的是,他在 1990 年代发布新歌最多,而更多上榜金曲出现在 1980 年代。为何如此?在后续的文本挖掘部分,请记住这个问题。
为了充分利用完整数据集进行歌词分析,您可以去除对榜单级别与发行年份的依赖,从而拥有更大的可挖掘歌曲集合。请看:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("All Songs in Data")
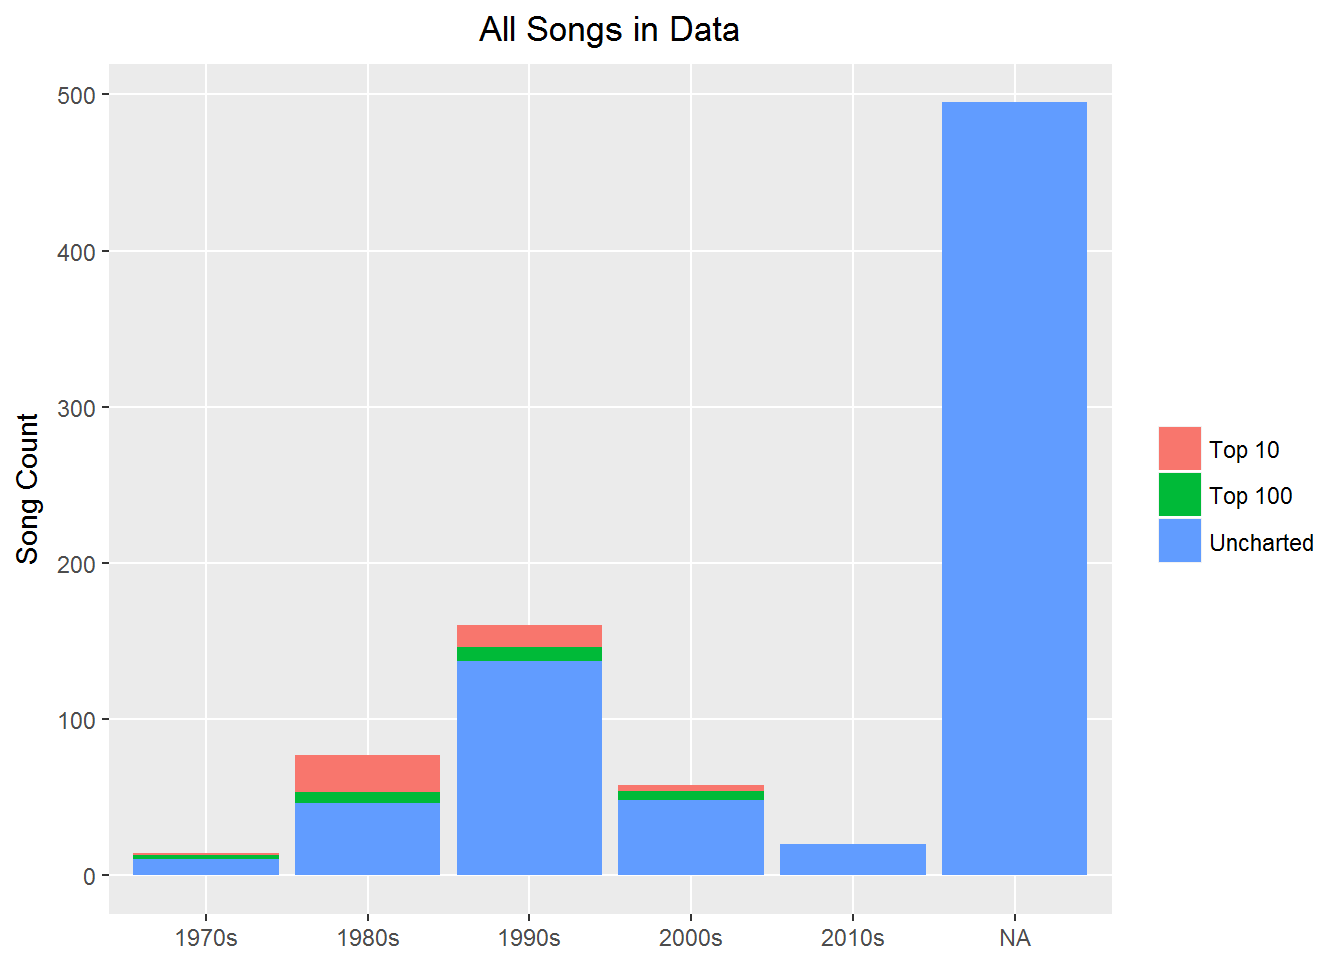
如您所见,有数百首 Prince 歌曲在数据中并无发行日期。对于情感分析或探索性分析,您可以使用全部数据;但进行时间趋势分析时,可用集合会小很多。这没问题——只需记在心上。
对于铁杆 Prince 粉丝,下面是快速浏览其登上榜首的歌曲。(注意,您可以使用 knitr 与 kableExtra 的 kable() 与 kable_styling(),以及 formattable 的 color_tile() 来创建格式精美的 HTML 输出。)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
文本挖掘也可视为文本分析。目标是发现那些可能未知或掩藏在表象之下的相关信息。自然语言处理(NLP)是进行文本挖掘的一种方法。它试图通过分词、聚类、实体与词语关系抽取,以及使用算法识别主题、量化主观信息,从而破译书面语言中的歧义。我们将先从词汇复杂度的概念入手。
词汇复杂度在不同语境中含义各异,但现在先假定它可由以下指标的组合来描述:
要开始分析,您需要将歌词拆分为单个词语,开始挖掘洞察。这个过程称为分词。
请记住,可用于文本挖掘的方法与数据格式多种多样:
但在分词之前,还有一步清洗。很多歌词在转录时包含诸如“Repeat Chorus”(重复副歌)这样的短语,或“Bridge”(桥段)与“Verse”(主歌)等标签。还有很多其它不希望出现的词会干扰结果。基于先前分析,我挑选了一些希望先行移除的词。
下面是需要手动移除的冗余词列表:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
要展开 token,请使用已加载的 tidytext 库。您现在可以充分利用 dplyr 的能力,将多个步骤串联起来。
在整洁文本框架中,您需要将文本拆分为单个 token(分词)并将其转换为整洁数据结构。为此,使用 tidytext 的 unnest_tokens() 函数。unnest_tokens() 至少需要两个参数:作为输出列名的“word”(将展开的文本填入其中),以及包含当前文本的输入列(即 lyrics)。
您可以将 prince 数据集管道进入 unnest_tokens(),然后移除停用词。什么是停用词?您再熟悉不过了。它们是那些过于常见、可能不会为结果增加意义的词。停用词列表多种多样,但此处我们将使用 tidytext 包提供的 stop_words 词典。
用 sample() 随机显示一些停用词,再用 head() 限制为 15 个词。
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
因此,在将歌词分词为词语后,您可以使用 dplyr 的 anti_join() 去除停用词。接着,使用 dplyr 的 filter() 与 %in% 运算符去除之前定义的冗余词。然后用 distinct() 移除重复记录。最后,移除所有长度少于四个字符的词。这是一个主观决定,但在歌词中,这些通常是“yea、hey”之类的感叹。将结果存为 prince_words_filtered。
注意:供后续参考,prince_words_filtered 是 prince 数据框的整洁文本版本,已去除 1)停用词,2)冗余词,3)1–3 个字符的词。您会在部分分析中使用它,但并非全部。
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
注意,stop_words 有一个 word 列,而 unnest_tokens() 创建了一个名为 word 的新列,因此 anti_join() 会自动在 word 列上连接。
现在可以查看新的整洁数据结构的类别与维度:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered 是一个包含 36916 个词(非唯一词)与 10 列的数据框。以下是快照:(我只挑了一个词,限制其出现在 10 首歌曲中,并使用 select() 以合适顺序打印感兴趣字段,并再次用 knitr 格式化)。这展示了分词后、未汇总的整洁数据结构。
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
您可以看到,每行包含一个单词,它会在其出现的每首歌中重复。
在音乐中,单词的个体频率非常重要——无论是重复还是稀有。两者都会影响整首歌的记忆点。词曲作者可能想知道:词频与热门金曲之间是否存在相关性。现在,您希望在整洁格式的基础上更进一步,得到每首歌的汇总词数。
要在 Prince 的歌词中考察这一点,创建直方图,按歌曲在 Billboard 榜单上的位置分组,展示每首歌的词数分布。再次对 prince 的歌词进行分词,这次不要过滤任何词,以获得跨歌曲的真实词频统计。仍旧使用 group_by() 与 summarise() 获取计数。再用 dplyr 的 arrange() 按计数排序。先看看最高的计数,然后用 ggplot() 绘制直方图。
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Song Count") +
    xlab("Word Count per Song") +
    ggtitle("Word Count Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
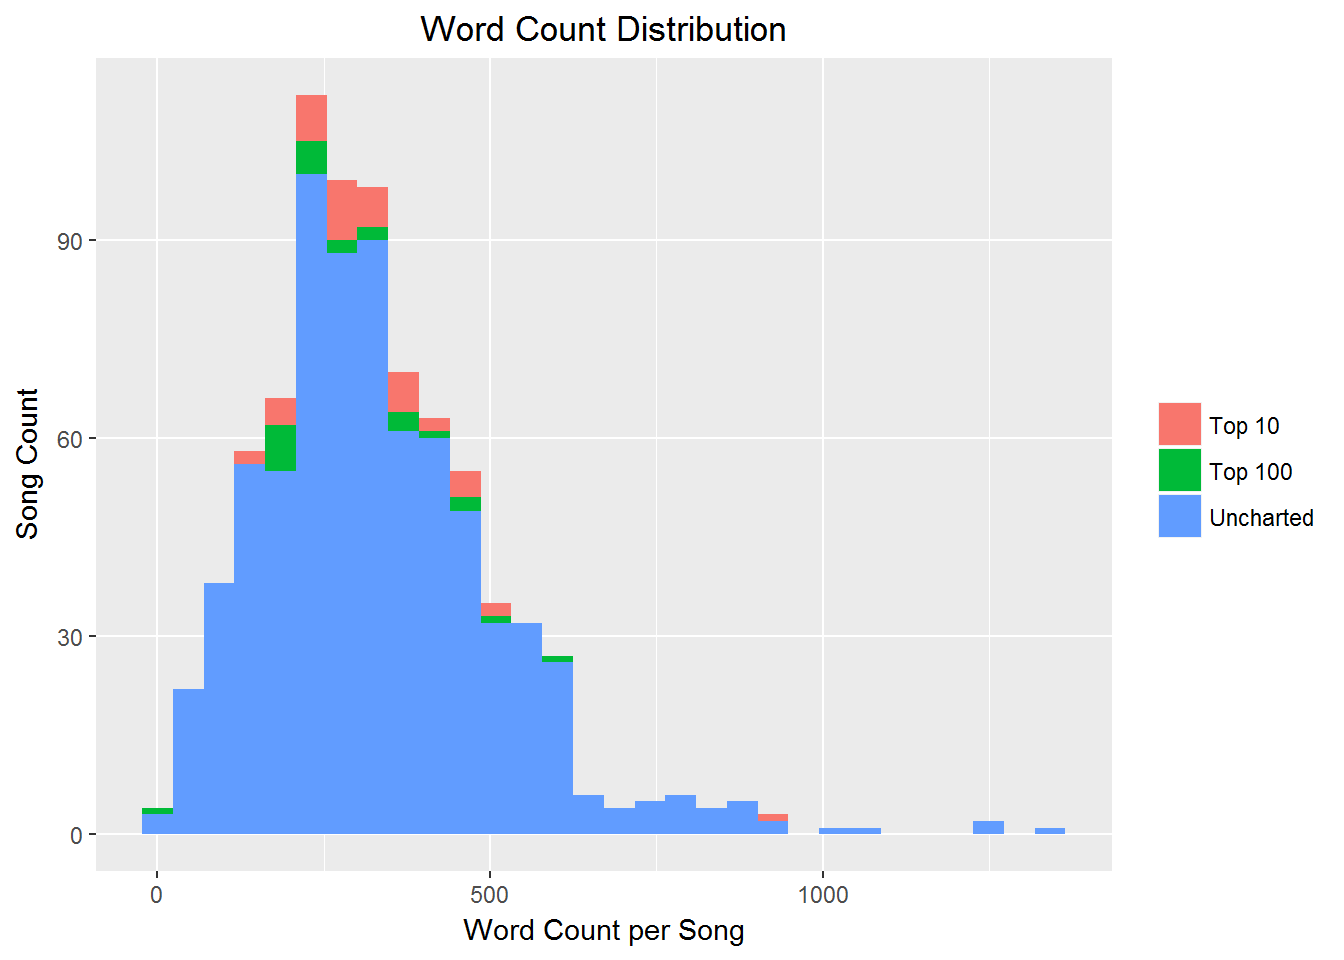
注意分布是右偏的。鉴于歌词转录的性质,我对数据录入错误持怀疑态度。因此,出于好奇,看看那首超过 800 个词的 Top 10 歌曲。
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
我做了一点调查,发现这首歌有一位客座艺人献上说唱段落。这确实解释得通!请记住,本数据集覆盖全球的流行与 R&B 榜单,因此流派与地域会极大影响您的假设。注意其美国流行榜名次远低于其他榜单,而在加拿大峰值为第 5。仅供参考。
挑战:如果您受到启发想自行分析音乐,不妨看看百万首歌曲数据集,其中包含近 5 万名艺术家的 50 多个特征(如节奏、响度、可舞性等)!将音乐特征与歌词结合,可以进行更为全面的分析。
要对全体歌词中最常用的词做一个简单评估,您可以使用 count() 与 top_n() 从清洁、过滤后的数据集中获取前 n 个高频词。然后用 reorder() 按计数对词排序,并用 dplyr 的 mutate() 将有序值重新赋给 word。这样 ggplot() 就能更美观地展示。
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Song Count") +
    ggtitle("Most Frequently Used Words in Prince Lyrics") +
    coord_flip()
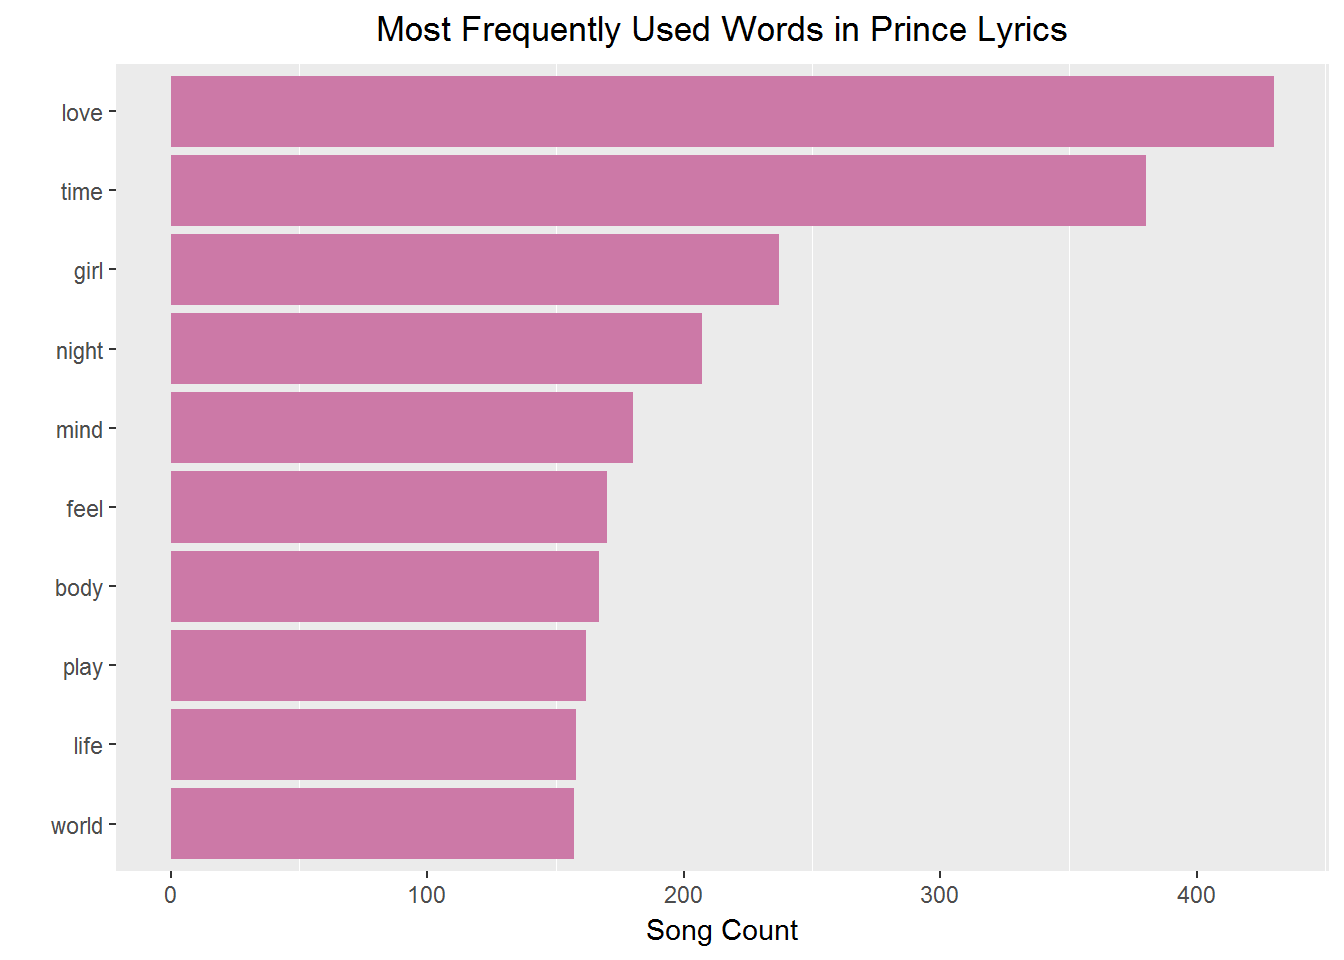
与大多数流行音乐一样,“love”似乎是常见主题。仅凭这些高频词我不会做太多假设,但您确实能窥见一些艺术家的视角,只是尚不全面。在深入研究前,先来点视觉小乐趣。
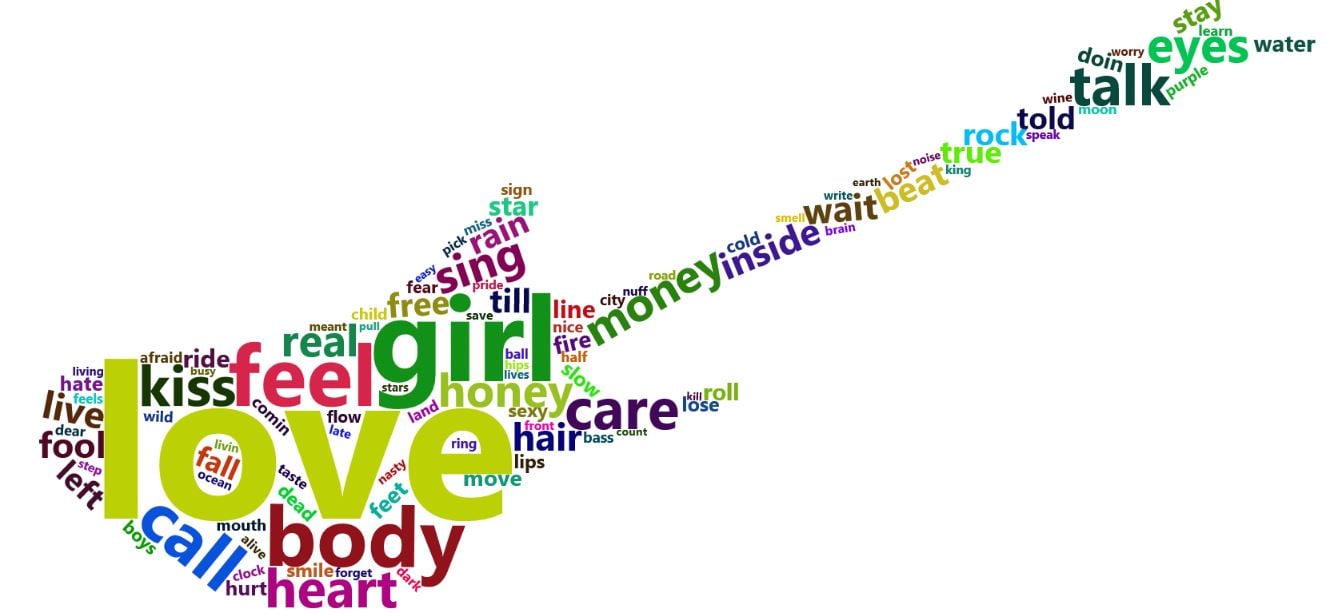
词云在不少圈子里名声不佳,如果使用不当,确实可能脱离语境、帮倒忙。不过,我们天生就是视觉动物,在某些场景下确实能获得洞察。可以看看 Sandy McKee 的一些示例,见此。使用时请持保留态度。
现在,试试名为 wordcloud2 的新包,看看一些酷炫效果。此包可以生成 HTML 小部件的创意词云。您甚至可以悬停查看词频。(该包在 rMarkdown 中渲染可能较慢,对浏览器也较挑剔。希望后续有所改进。)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
再来点更有趣的“数据艺术”……
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
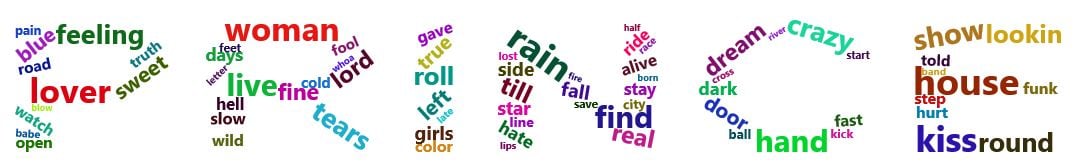
至此您只看了所有歌曲中的高频词。如果按榜单级别拆分会怎样?上榜歌曲与未上榜歌曲是否存在更常见的词?这些可以被视为社会层面的流行词。
注意下面代码中使用 slice(seq_len(n)) 来获取每个 chart_level 的前 n 个词。这与 top_n() 的工作方式不同,但在绘图分面时是一个不错的选择。(请记住,完成此类小技巧的方法不止一种。)您还可以使用 row_number() 确保能在图中按正确顺序列出词语。ggplot() 默认会按字母排序,因此在绘图前做好排序是良好习惯。
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Popular Words by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
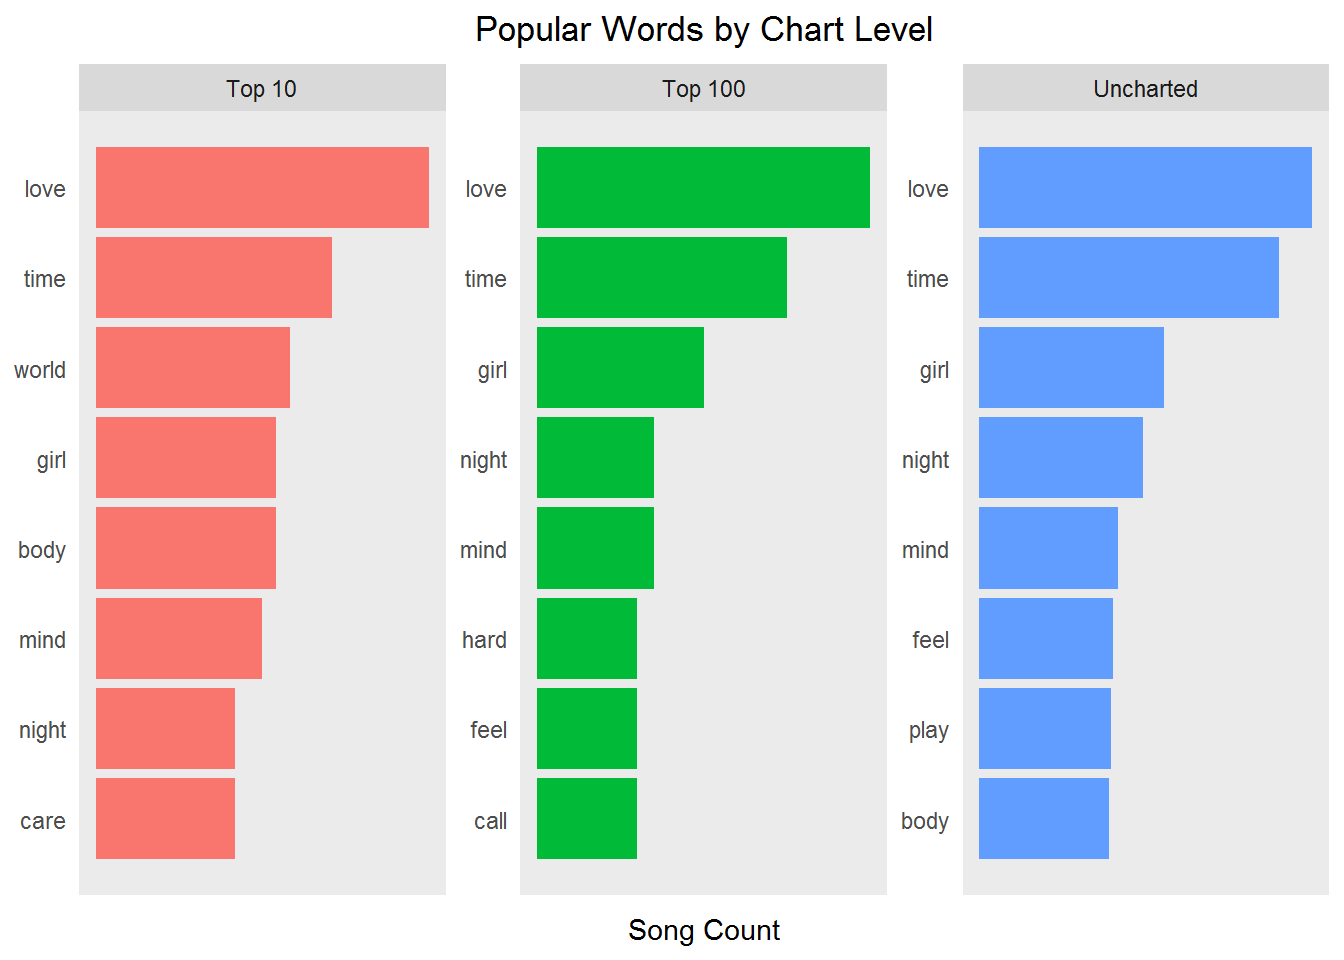
您从上图获得了哪些洞察?
各榜单级别的高频词非常、非常相似。仅凭歌词来预测歌曲是否成功的希望似乎不大!不过,您只是触及了文本挖掘、NLP 与预测建模可能性的表面。
音乐中有些词被视为“跨时代”。跨时代的词经久不衰,能打动广泛受众。如果跨年代进行分析,这些词会位居前列。从 Prince 的歌词中过滤、分组并聚合,获取各年代的高频词,看看哪些词可被视为跨时代或潮流。您可以用带 facet_wrap() 的 ggplot() 按年代查看。
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Timeless Words") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
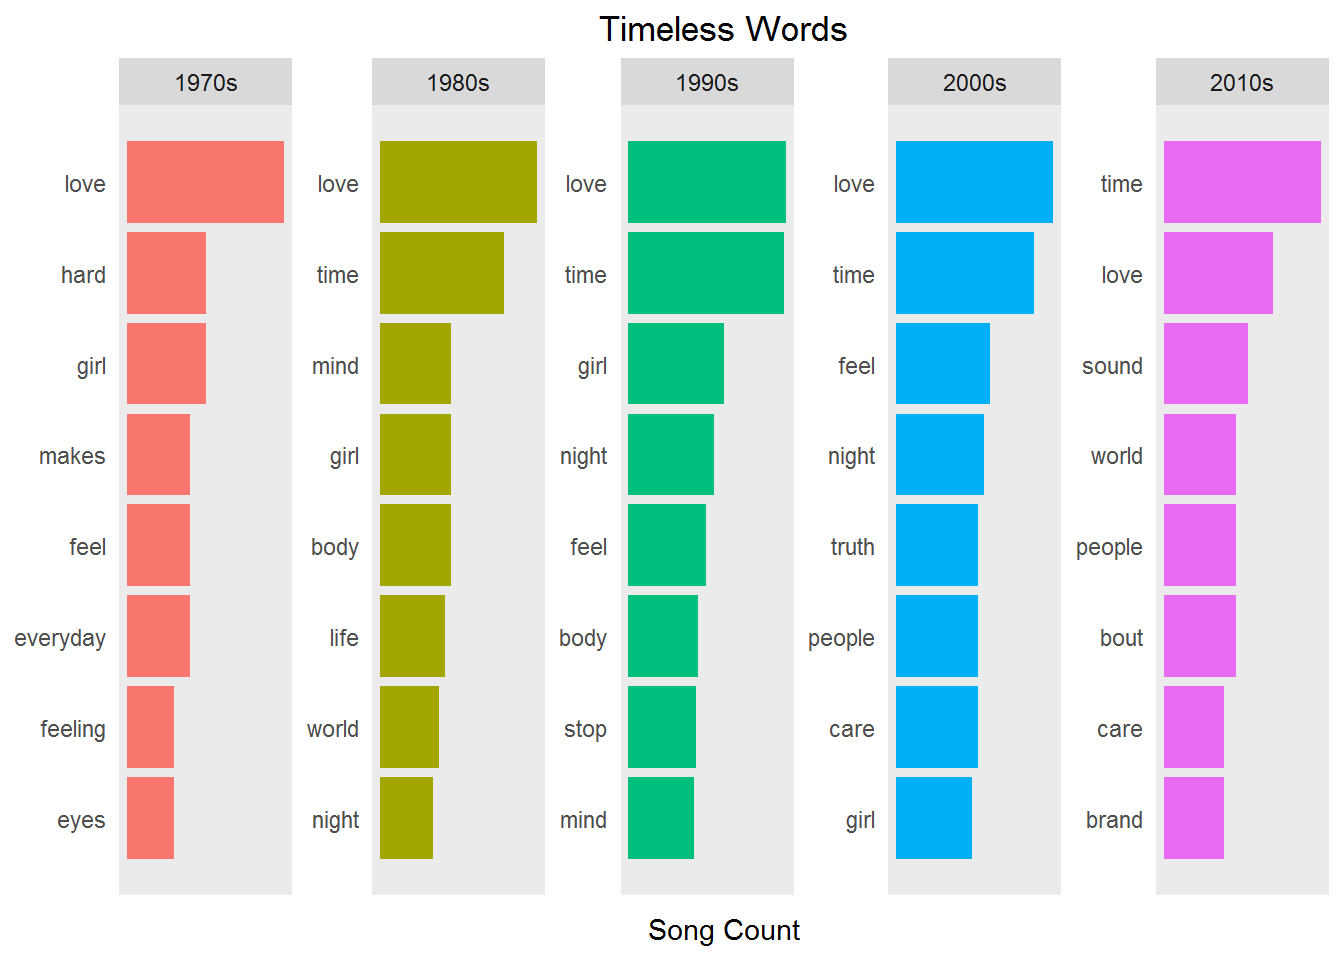
显然,“love”、“time”与“girl”是跨时代的。但要识别潮流词有多容易呢?“truth”是否在世纪之交成为潮流?还是说它在某些歌曲中只是高重复度的词?频率真的能识别主题吗?对于歌词,它是否像在其他文本挖掘任务(如分析国情咨文)中那样有效?
对于词曲作者而言,词长是个有趣话题。词越长,越难押韵并嵌入节奏。下面这个词长直方图与预期一致,但也有一些异常的超长词。
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Word Length") +
    ylab("Word Count") +
    ggtitle("Word Length Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
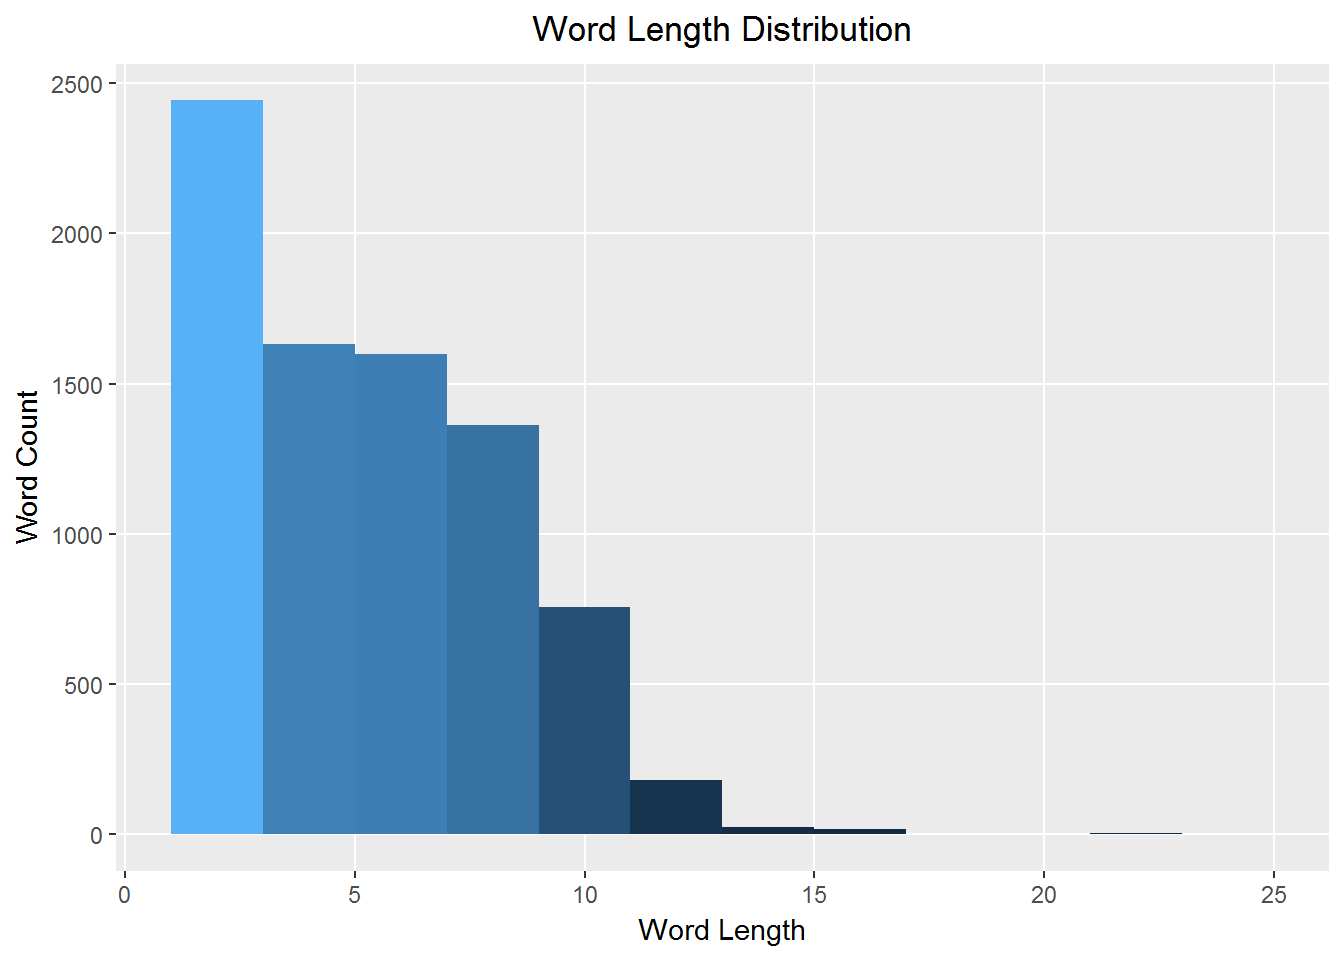
那些离谱的超长词是什么?这需要一个极具娱乐性的词云!这次按词长而非词频。来看:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
一篇文本的词汇越多样,其词汇多样性越高。歌曲词汇量反映了歌曲中使用的唯一词数量。可以用一张简单的图展示多年来每首歌的平均唯一词数。您需要再次对原始数据集进行分词,但这次保留所有停用词与短词,因为此图更偏重定量洞察。
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexical Diversity") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
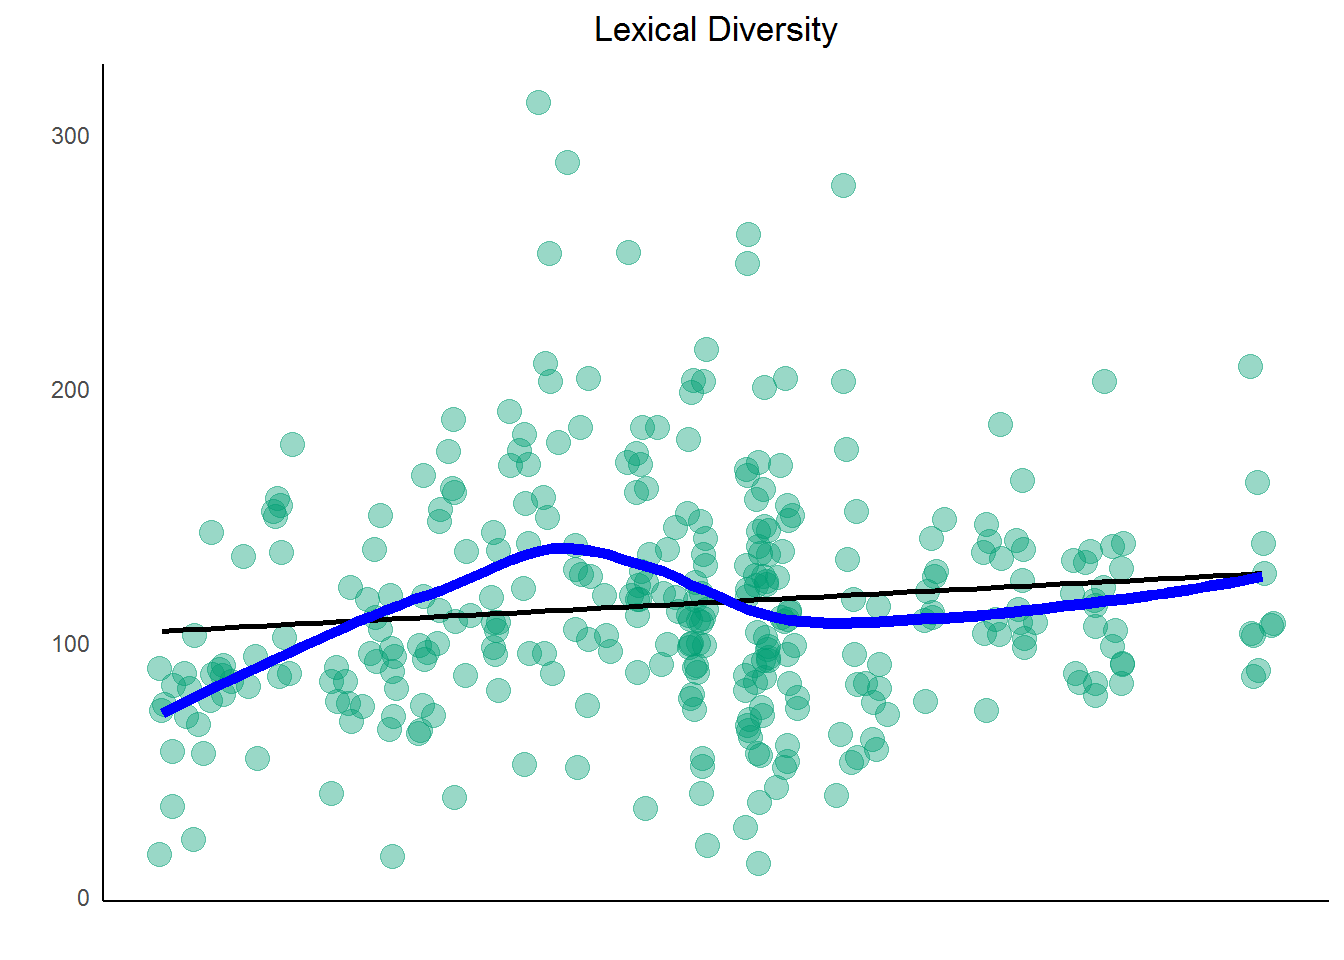
这意味着什么?在过去几十年间,Prince 歌词的多样性略有上升。这与上榜成功的相关性如何?很难断言,但我们不妨绘制密度与上榜历史进行进一步比较。
回顾一下,在本教程中,词汇密度定义为唯一词数量除以总词数。它是词语重复度的指标,而重复是词曲作者的重要工具。词汇密度越高,重复越少。(注意:这并不意味着序列性重复,这是另一种写歌技巧。)
看看 Prince 多年来的词汇密度。对密度来说,最好保留所有词,包括停用词。因此从原始数据集开始,对歌词分词。按歌曲与年份分组,使用 n_distinct() 与 n() 计算密度。将结果管道到 ggplot() 使用 geom_smooth()。再添加一个 method="lm" 的 stat_smooth() 进行线性平滑。
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexical Density") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
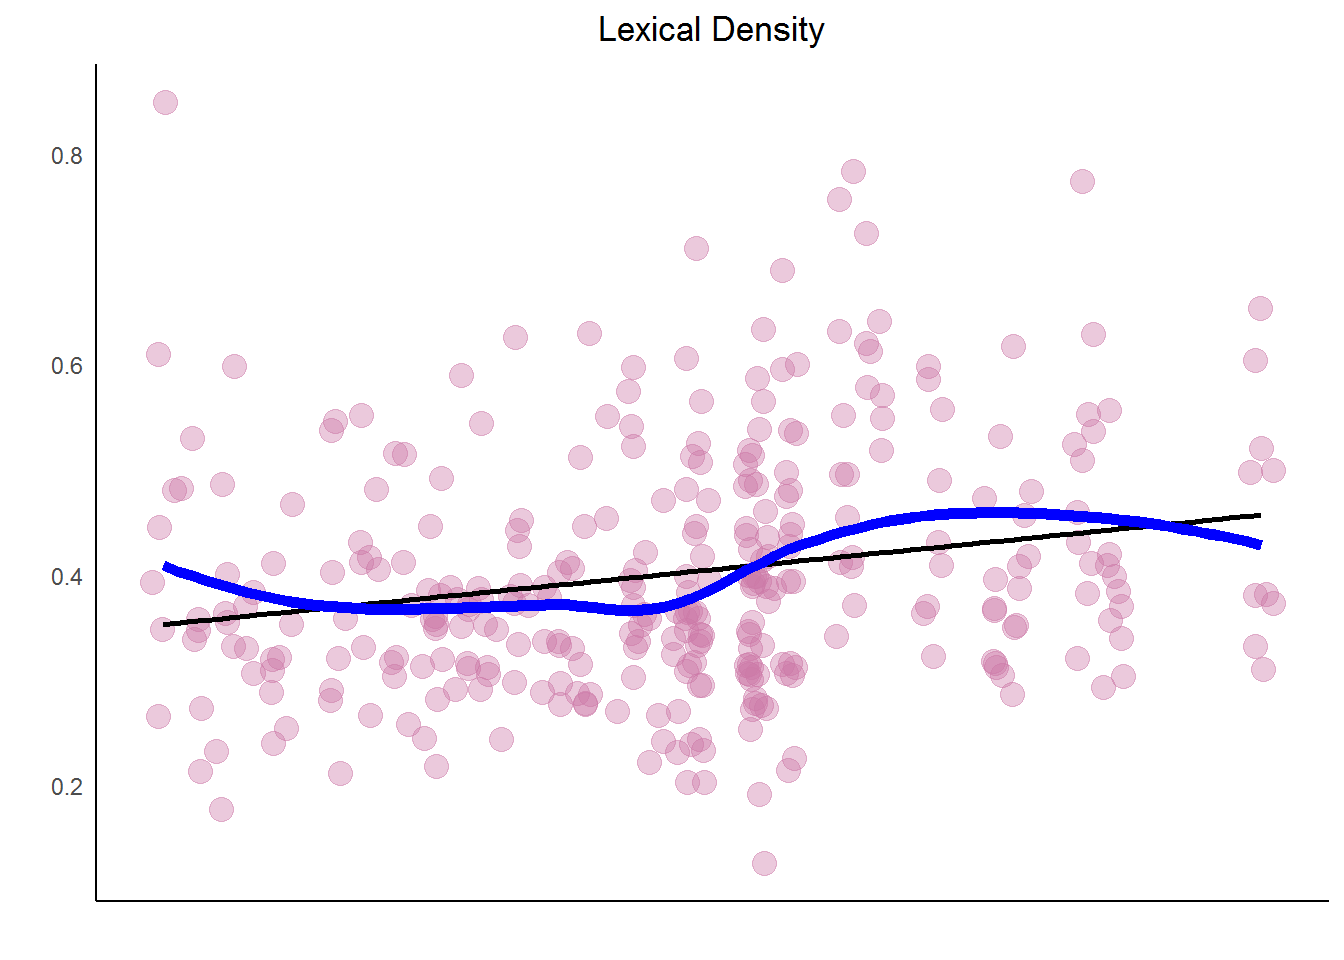
为对比趋势,创建一张他的上榜历史(即成功上榜的歌曲)的图,与多样性与密度并排比较。使用 gridExtra 的 grid.arrange() 将三者并列。
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Chart History") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
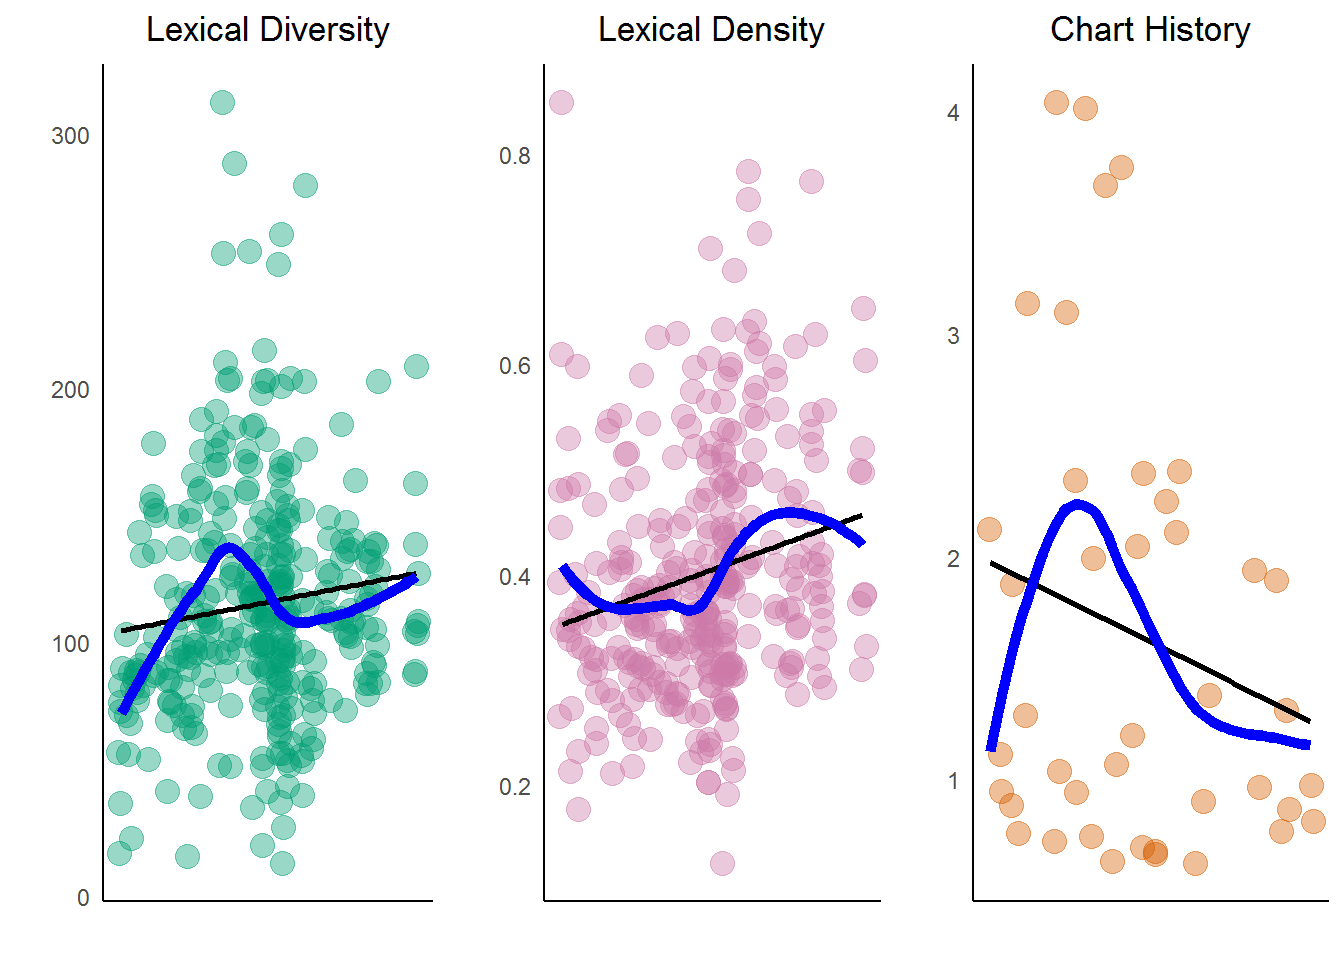
从上图可以看到,Prince 的词汇多样性与密度随时间略有上升。这一趋势与所有流行音乐相比如何?有一项研究显示,热门金曲的词汇密度出现下降,表明重复度升高(即“更多的词,表达更少的内容”)。这与 Prince 的歌曲并不相同。另有一项研究表明,在所有流行音乐中,词汇多样性(唯一词)随时间增加,这与 Prince 的音乐呈正相关。这或许与历史上榜单中流派的多样化提升相关。流派是本数据集中缺失的关键数据。是否可能他在流行榜的上榜历史下降,而在 R&B/说唱方面上升?
挑战:我把这些结果留给您思考,也鼓励您去寻找不同数据集,独立运用这些技能!请记住,相关性不代表因果性。
迄今为止您使用的方法是在整个数据集上观察,但尚未量化某些术语相对于整个文档集合在单一文档中的重要程度。您查看了词频并移除了停用词,但这可能不是最精细的方法。
引入 TF-IDF。TF 是“词频(term frequency)”。IDF 是“逆文档频率(inverse document frequency)”,它为常用词赋予较低权重,为在文本集合中较少出现的词赋予较高权重。当您将 TF 与 IDF 结合时,术语的重要性会因其稀有度得到调整。TF-IDF 背后的假设是:在单个文档中更频繁出现的词应该被赋予更高权重,除非它也在许多文档中出现。公式可概括如下:
因此,在集合中文档越少见到的词,其 IDF 就越高。您可以用这种新方法,通过 tidytext 提供的 bind_tf_idf() 函数,按榜单级别检视最重要的词。该函数会计算并绑定 TF 与 IDF,以及两者的乘积(TF*IDF)。它以整洁文本数据为输入,每行一个 token(词)、每个文档(歌)。结果会体现在新列中。
因此,取原始 Prince 数据框,将歌词分词为词,移除冗余词,但保留停用词。然后使用 bind_tf_idf() 运行公式并创建新列。
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
现在您可以看到,对于极其常见的词,IDF 与 TF-IDF 为 0。(严格说来,IDF 项将为 ln(1),因此为零。)将上述结果传入 arrange(),按 tf-idf 降序。再加几步,您就能以不同视角审视 Prince 歌词中的词语。
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %>
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
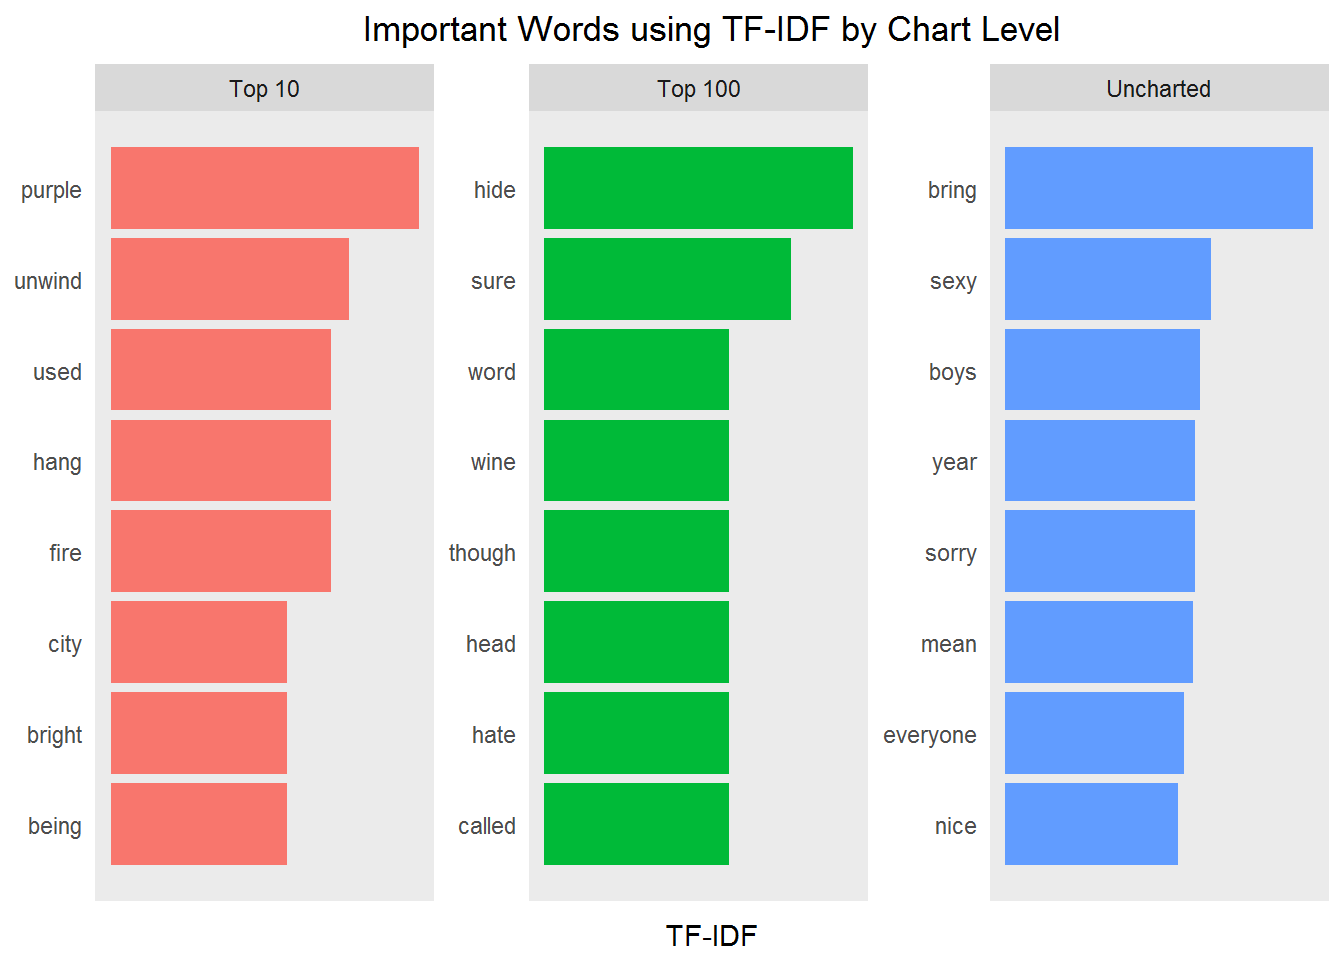
哇,使用 TF-IDF 的确带来了不同视角的潜在重要词。当然,解释仍带有主观性。您注意到什么模式了吗?
接下来,看看跨时间的 TF-IDF:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Decade") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
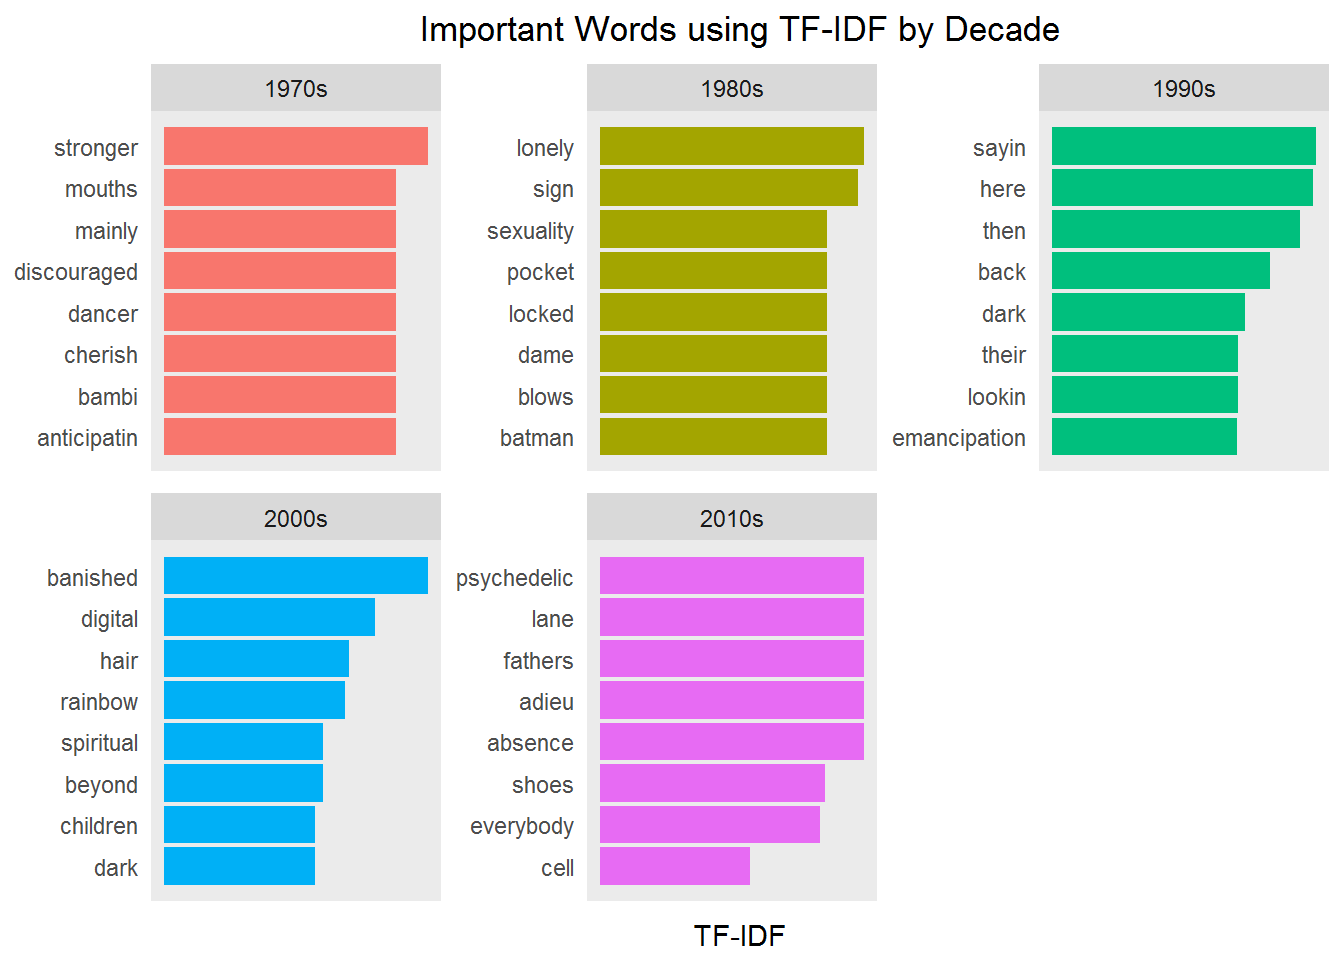
现在您无疑获得了更深层次的洞察。跨时代词不再占据前列。您是否开始看到话题或主题浮现?仅凭每组几个词,这真的可能吗?我们将在第二篇教程(第二部分:用 NLP 进行情感分析与主题建模)中进一步提升。
用这一方法快速做一张词云,会呈现 Prince 歌词中重要词的新视角,也更有意思……
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
在本案例研究中,您首先浏览了实际数据,只关注基础内容。经过一些整形操作(如数据清洗与去除非信息性词语)后,您开始在歌曲层面进行探索性分析。
随后,您更深入地开展了文本挖掘,将歌词分词为整洁的词语,以便观察歌词复杂度。其结果为接下来的情感分析与主题建模提供了关键洞察。
最后,您使用 TF-IDF 分析来刻画词语在与某个关注结果相关的文档中的信息量。或许您会认为这是识别音乐主题的好方法,但这仅是故事的一半。第二部分将介绍一种无监督学习方法——潜在狄利克雷分配(LDA)。与数据科学的各个方面一样,获取洞察的方法很多。在本案例研究的第二与第三部分中,您将接触更多选项。
希望您与我一样兴奋,继续从探索性分析迈向情感分析、主题建模与预测性洞察之旅。
感谢阅读,下一篇教程再见!
进一步学习 R 与机器学习
课程
课程
课程