Kursus
Machine Learning dengan caret di R
4 jam
61K
Ini adalah Bagian Satu dari seri tutorial tiga bagian di mana Anda akan menggunakan R untuk melakukan beragam tugas analitik pada studi kasus lirik musik dari artis legendaris, Prince. Ketiga tutorial membahas hal-hal berikut:
Lirik musik dapat mewakili sudut pandang seorang artis, tetapi lagu-lagu populer mengungkapkan apa yang ingin didengar masyarakat. Analisis lirik bukan tugas mudah. Karena sering kali strukturnya sangat berbeda dari prosa, hal ini memerlukan kehati-hatian terhadap asumsi dan pilihan teknik analitik yang khas dan diskriminatif. Lirik musik meresap ke dalam kehidupan kita dan memengaruhi pikiran kita dengan cara yang halus dan meluas. Konsep Predictive Lyrics mulai ramai dibicarakan dan semakin sering menjadi topik makalah riset serta tesis pascasarjana. Studi kasus ini hanya akan menyinggung beberapa bagian dari subjek yang sedang berkembang ini.
Untuk merayakan karya Prince yang menginspirasi dan beragam, Anda akan menelusuri pesan-pesan dalam liriknya yang kadang jelas namun sering tersembunyi. Namun, Anda tidak perlu menyukai musik Prince untuk menghargai pengaruhnya terhadap perkembangan banyak genre di seluruh dunia. Majalah Rolling Stone mencantumkan Prince sebagai penulis lagu terbaik ke-18 sepanjang masa, tepat di belakang nama-nama seperti Bob Dylan, John Lennon, Paul Simon, Joni Mitchell, dan Stevie Wonder. Analisis lirik perlahan menemukan jalannya ke komunitas data science seiring kemungkinan memprediksi "Hit Songs" kian mendekati kenyataan.
Prince adalah sosok yang meluap-luap dengan musik—penulis lagu yang sangat produktif, virtuoso pada gitar, kibor, dan drum, serta arsitek ulung funk, rock, R&B, dan pop, bahkan ketika musiknya menolak pengkotakan genre. - Jon Pareles (NY Times)
Dalam tutorial ini, Bagian Satu dari seri, Anda akan memanfaatkan teknik penambangan teks pada sekumpulan lirik menggunakan kerangka kerja tidy text. Dataset tidy memiliki struktur khusus di mana setiap variabel adalah kolom, setiap observasi adalah baris, dan setiap jenis unit observasi adalah sebuah tabel. Setelah membersihkan dan mengondisikan dataset, Anda akan membuat statistik deskriptif dan visualisasi eksploratori sambil melihat berbagai aspek lirik Prince.
Bagian Satu dari seri tutorial ini memerlukan pemahaman dasar tentang data tidy—khususnya paket seperti dplyr untuk transformasi data, ggplot2 untuk visualisasi, dan operator %>% pipe yang berasal dari paket magrittr. Setiap tutorial akan menjelaskan alat yang dapat Anda gunakan untuk analisis, namun mungkin tidak membahas detail setiap langkah. Anda akan melihat beberapa langkah biasanya dikombinasikan menggunakan operator %>%. Karena ini juga merupakan studi kasus, penting untuk diingat bahwa semua inferensi yang Anda buat murni observasional; maka, korelasi tidak menyiratkan kausalitas.
Tip: untuk latar belakang alat yang digunakan, dua sumber yang baik adalah R for Data Science oleh Garrett Grolemund dan Hadley Wickham; serta Text Mining with R oleh Julia Silge dan David Robinson.
Bagian Dua dan Tiga
Dalam tutorial terpisah, Bagian Dua, Anda akan membahas Analisis Sentimen dan Pemodelan Topik untuk menangkap suasana dan tema keseluruhan dalam musik Prince dan penerapannya pada perspektif sosial. Anda akan bekerja dengan leksikon sentimen, menilai sentimen biner dan kategorikal, memplot tren dari waktu ke waktu, serta melihat n-gram dan asosiasi kata. Anda juga akan menggunakan Natural Language Processing (NLP) dan teknik klastering seperti Latent Dirichlet Allocation (LDA) dan K-Means untuk mengungkap motif dalam lirik.
Dalam tutorial lainnya, Bagian Tiga, Anda akan menuntaskan rangkaian ini dengan menggunakan hasil eksploratori untuk membantu memprediksi dekade rilis sebuah lagu, dan yang lebih menarik, apakah sebuah lagu akan masuk tangga lagu Billboard berdasarkan liriknya. Anda akan menggunakan alat machine learning seperti Decision Trees (rpart dan C50), K-Nearest-Neighbors (class), dan Naive Bayes (e1071) untuk menghasilkan sebuah classifier yang dapat menerima teks.
Ketiga bagian akan menggunakan dataset yang sama berisi lirik Prince, tahun rilis, dan posisi tangga lagu Billboard. Teknik dalam studi ini juga dapat diterapkan pada banyak jenis teks lainnya. Faktanya, hasil untuk prosa standar lebih mudah ditafsirkan karena lirik, secara umum, sering dirancang dengan pesan tidak langsung dan nuansa halus.
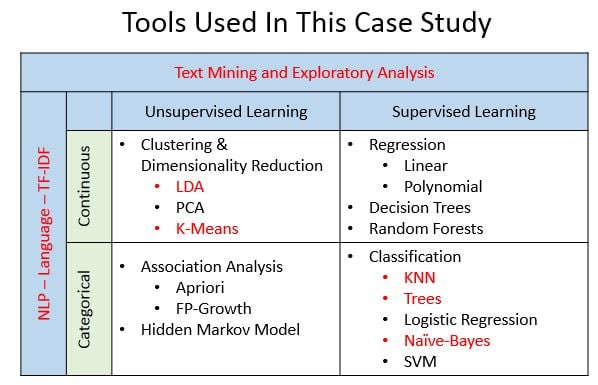
Singkatnya, ada banyak metode berbeda untuk menganalisis lirik. Tutorial ini membahas yang disorot merah pada grafik di bawah. Perhatikan bahwa grafik ini hanyalah representasi tingkat tinggi dari gambaran yang sangat "buram". Dan tidak, saya tidak bermaksud gambarnya! Kenyataannya, aspek berbeda dari pemodelan dan teknik machine learning kini saling kabur dan tidak selalu pas dalam satu kotak seperti di bawah. Jadi cobalah kenakan kacamata 3D saat melihat gambar itu—mungkin akan lebih masuk akal!
Selain mempelajari dan mempraktikkan keterampilan baru, tutorial ini bertujuan menjawab pertanyaan dasar tentang konsep analisis lirik. Studi terbaru menunjukkan bahwa "kecerdasan lirik" mungkin menurun dalam musik populer. Beberapa studi bahkan menyarankan bahwa kata-kata dalam Lagu No.1 sejalan dengan tingkat membaca siswa kelas 3 di AS. Mungkinkah memanfaatkan penambangan teks, NLP, machine learning, dan metode data science lainnya untuk memberi wawasan tentang topik seperti itu? Mungkinkah mengidentifikasi tema yang menarik bagi masyarakat berdasarkan seberapa baik sebuah lagu diterima? Mungkinkah memprediksi apakah sebuah lagu akan berhasil hanya berdasarkan analisis lirik? Dalam tutorial pertama ini, Anda akan menelaah kompleksitas lirik musik Prince sebagai latihan eksploratori.
Sebelum menyelam lebih jauh, pikirkan apa yang ingin Anda temukan. Pertanyaan apa yang menarik? Anda akan terlebih dahulu menelusuri analisis dataset. Seperti apa bentuknya? Ada berapa lagu? Bagaimana struktur liriknya? Seberapa banyak pembersihan dan penataan yang perlu dilakukan? Apa saja faktanya? Bagaimana frekuensi kata dan mengapa itu penting? Dari sisi teknis, Anda ingin memahami dan menyiapkan data untuk analisis sentimen, NLP, dan model machine learning.
Musik sejak lama menjadi cara efektif untuk berkomunikasi kepada khalayak luas, dan lirik berperan besar dalam menyampaikan komunikasi ini. Namun peluang penelitian mengenai peran lirik terhadap kesejahteraan [masyarakat] masih sangat kurang dimanfaatkan. - Patricia Fox Ransom
Metode populer untuk mendapatkan data penambangan teks adalah menggunakan paket rvest untuk men-scrape konten dari web. Saya dapat men-scrape informasi Billboard Chart dan lirik Prince dari berbagai situs dan menggabungkannya berdasarkan judul lagu. Ada sedikit penataan karena konvensi penamaan judul yang tidak konsisten. Saya lalu memutuskan secara subjektif untuk menghapus semua lagu yang bukan versi asli, yaitu remix, extended version, club mix, remake, dll. Saya juga menghapus album yang berisi kumpulan historis Hit Songs miliknya untuk menghindari pengulangan. Saya melakukan pembersihan kecil dan menyimpan hasilnya ke file csv yang bisa digunakan untuk tutorial ini.
Karena Bagian Satu berfokus pada penambangan teks, saya tidak menyertakan kode itu untuk tutorial ini, namun dataset tersedia untuk Anda unduh di sini jika Anda ingin mengikutinya.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Ada beberapa metode untuk membaca data dari file csv, tetapi saya memilih menggunakan read.csv() untuk memuat data frame berisi lirik, tahun rilis, dan posisi tangga lagu Billboard. Perhatikan bahwa secara bawaan, R mengonversi semua string karakter menjadi faktor. Ini dapat menyebabkan masalah di tahap selanjutnya, tetapi Anda bisa mengatasinya dengan mengatur parameter stringsAsFactors ke FALSE. Sekarang mari meninjau datanya...
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Anda dapat menggunakan fungsi names() untuk melihat kolom dalam data frame:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Karena saya membuat file ini, saya tahu bahwa X hanyalah nomor baris dan text adalah lirik sebenarnya. Field lain yang dibutuhkan termasuk song, year, dan peak (yang menunjukkan posisinya di tangga lagu Billboard). US.Pop dan US.R.B adalah posisi puncak tangga lagu untuk AS (Pop dan R&B), jadi pertahankan juga keduanya, dan hapus semua field lain untuk saat ini.
Lakukan ini dengan mengambil dataset asli, prince_orig, lalu piping ke select() menggunakan %>%. Dengan cara ini Anda dapat membaca kode dari kiri ke kanan.
Perhatikan juga bahwa select() memungkinkan Anda mengganti nama kolom dalam satu langkah. Jadi silakan atur text menjadi lyrics dan ganti nama kolom AS ke gaya tidyverse menggunakan "_" alih-alih ".". Lalu simpan hasilnya ke prince, yang akan Anda gunakan sepanjang tutorial. dplyr menyediakan fungsi bernama glimpse() yang memudahkan melihat data Anda dalam tampilan transpose.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
Pertanyaan jelas pertama: ada berapa observasi dan kolom?
dim(prince)
[1] 824 7
Menggunakan fungsi dim(), Anda melihat ada 7 kolom dan 824 observasi. Setiap observasi adalah sebuah lagu. Seperti yang saya bilang... produktif!
Melihat kolom lyrics untuk salah satu lagu, Anda bisa melihat bagaimana strukturnya.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Banyak peluang untuk merapikan, jadi mari mulai.
Ada berbagai metode yang dapat Anda gunakan untuk mengondisikan data. Satu opsi adalah mengonversi data frame menjadi Corpus dan Document Term Matrix menggunakan paket tm untuk penambangan teks lalu menggunakan fungsi tm_map() untuk pembersihan, tetapi tutorial ini akan berpegang pada dasar-dasarnya dan menggunakan gsub() dan fungsi apply() untuk pekerjaan kasarnya.
Pertama, hilangkan kontraksi yang mengganggu dengan membuat fungsi kecil yang menangani sebagian besar skenario menggunakan gsub(), lalu terapkan fungsi itu ke semua lirik.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
Anda juga akan melihat karakter khusus yang mengotori teks. Anda dapat menghapusnya dengan fungsi gsub() dan ekspresi reguler sederhana. Perhatikan pentingnya memperluas kontraksi sebelum langkah ini!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Untuk konsistensi, silakan konversi semuanya ke huruf kecil dengan fungsi tolower() yang praktis.
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Meninjau lirik sekarang menunjukkan versi yang lebih rapi dari teks mentah asli.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Langkah umum lainnya dalam pengondisian data untuk penambangan teks disebut stemming, atau memecah kata ke makna akarnya. Itu topik tersendiri yang dapat dibahas lain waktu. Untuk saat ini, lihat ringkasan data frame prince.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
Seperti terlihat, ada 37 tahun lagu, dan lagu dengan peringkat terendah (yang ada dalam dataset) berada di posisi 88. Anda juga melihat cukup banyak NA untuk year dan peak. Karena Anda akan melakukan berbagai jenis analisis, pertahankan dataset lengkap di data frame prince dan cukup lakukan filter saat dibutuhkan.
Karena salah satu pertanyaan target Anda adalah mencari tren lagu lintas waktu, dan dataset berisi tahun rilis individual, Anda dapat membuat bucket dan mengelompokkan tahun ke dalam dekade. Gunakan verba mutate() dari dplyr untuk membuat field decade baru. Salah satu cara membuat bucket adalah memanfaatkan ifelse() bersama operator %in% untuk memfilter berdasarkan year dan membagi lagu ke dalam dekade. Lalu simpan hasilnya kembali ke prince (pada dasarnya menambahkan field baru).
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Anda dapat melakukan hal yang sama untuk chart_level, yang merepresentasikan apakah sebuah lagu mencapai puncak Top 10, Top 100, atau tidak masuk tangga lagu (uncharted). Ini saling eksklusif, jadi Top 100 tidak termasuk lagu Top 10.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Selain itu, buat field biner bernama charted yang menunjukkan apakah sebuah lagu mencapai tangga lagu Billboard atau tidak (yakni lagu populer). Gunakan write.csv() untuk menyimpan untuk digunakan di tutorial selanjutnya.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Untuk menyesuaikan grafik, saya suka membuat daftar warna unik agar visual konsisten. Ada banyak tempat di web untuk mendapatkan warna berbeda melalui representasi kode heksadesimal seperti di bawah. Jika Anda memiliki preferensi untuk grafik Anda, Anda juga dapat membuat tema sendiri yang dapat diterapkan ke ggplot() saat diperlukan.
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Sebelum masuk ke penambangan teks, mulailah dengan tampilan dasar tentang apa yang dimiliki data Anda pada level lagu. Sekarang waktu yang tepat untuk memvisualisasikan berapa banyak lagu yang dirilis Prince per dekade. Sebagai pengingat, karier profesionalnya dimulai pada 1978 dan berlangsung hingga 2015 (seperti ditunjukkan dalam statistik summary() di atas). Namun karena kita melihat tren sekarang, dan dataset memiliki banyak nilai kosong untuk year, Anda ingin memfilter semua NA tahun rilis untuk grafik pertama.
Menggunakan fungsi filter(), group_by() dan summarise() dari dplyr, Anda dapat mengelompokkan berdasarkan dekade lalu menghitung jumlah lagu. Fungsi n() adalah salah satu dari beberapa fungsi agregat yang berguna digunakan bersama summarise() pada data yang dikelompokkan. Lalu menggunakan ggplot() dan geom_bar(), buat grafik batang dan isi batang dengan kategori charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Released Songs") +
  labs(x = NULL, y = "Song Count")
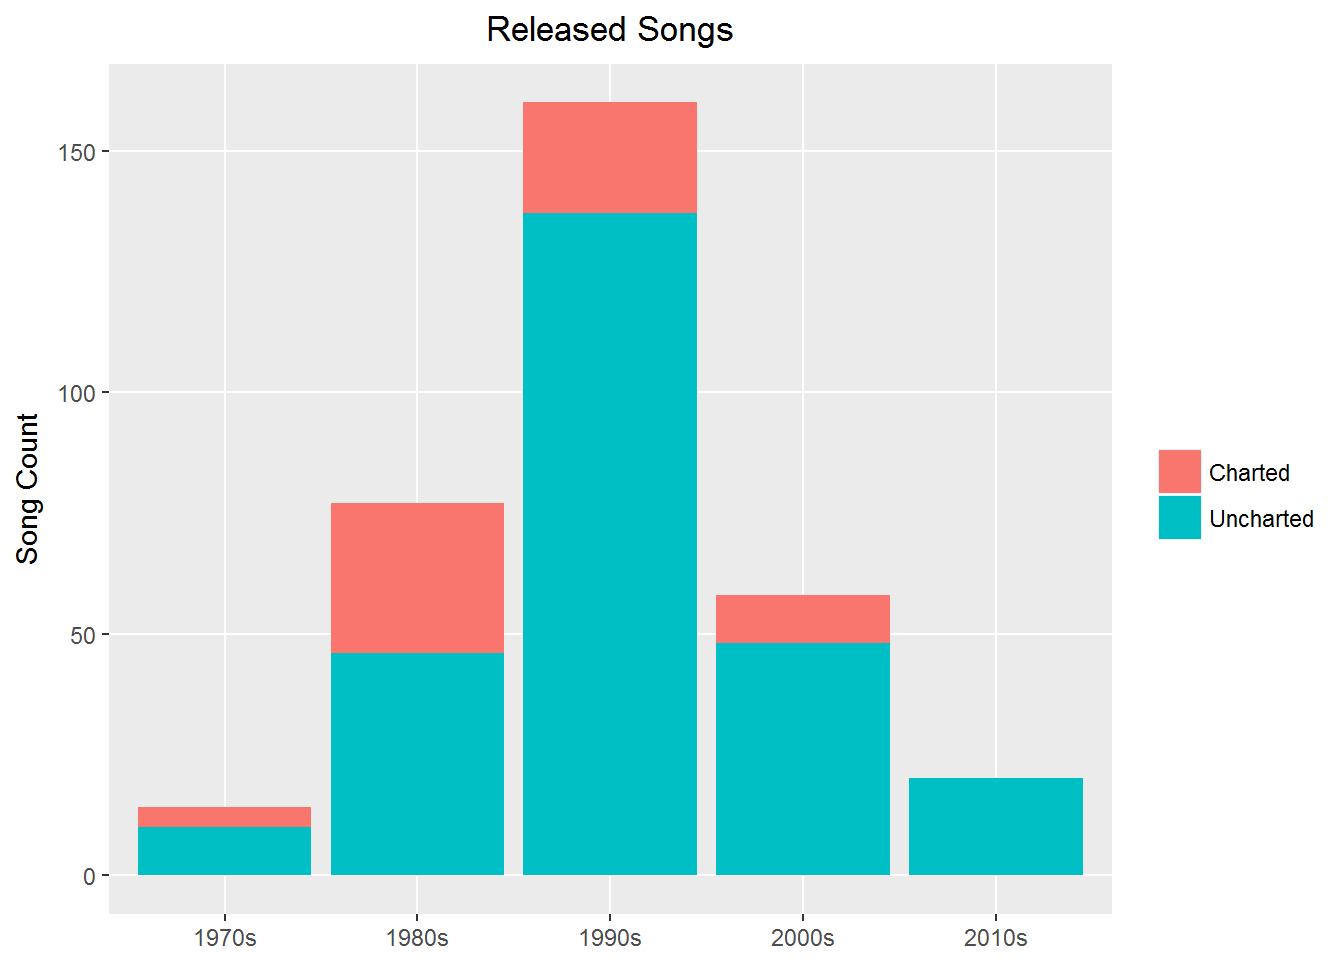
Ini jelas menunjukkan dekade paling aktifnya adalah 1990-an.
Sekarang buat grafik serupa dengan chart_level.
Ingatlah untuk group_by() baik decade maupun chart_level agar Anda dapat melihat trennya.
Pada grafik ini, Anda hanya akan melihat lagu yang masuk tangga lagu sehingga filter sisanya menggunakan peak > 0. Pipe objek group_by ke summarise() menggunakan n() untuk menghitung jumlah lagu. Saat Anda menyimpannya dalam sebuah variabel, Anda dapat mem-pipe itu ke ggplot() untuk grafik batang sederhana.
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("Charted Songs")
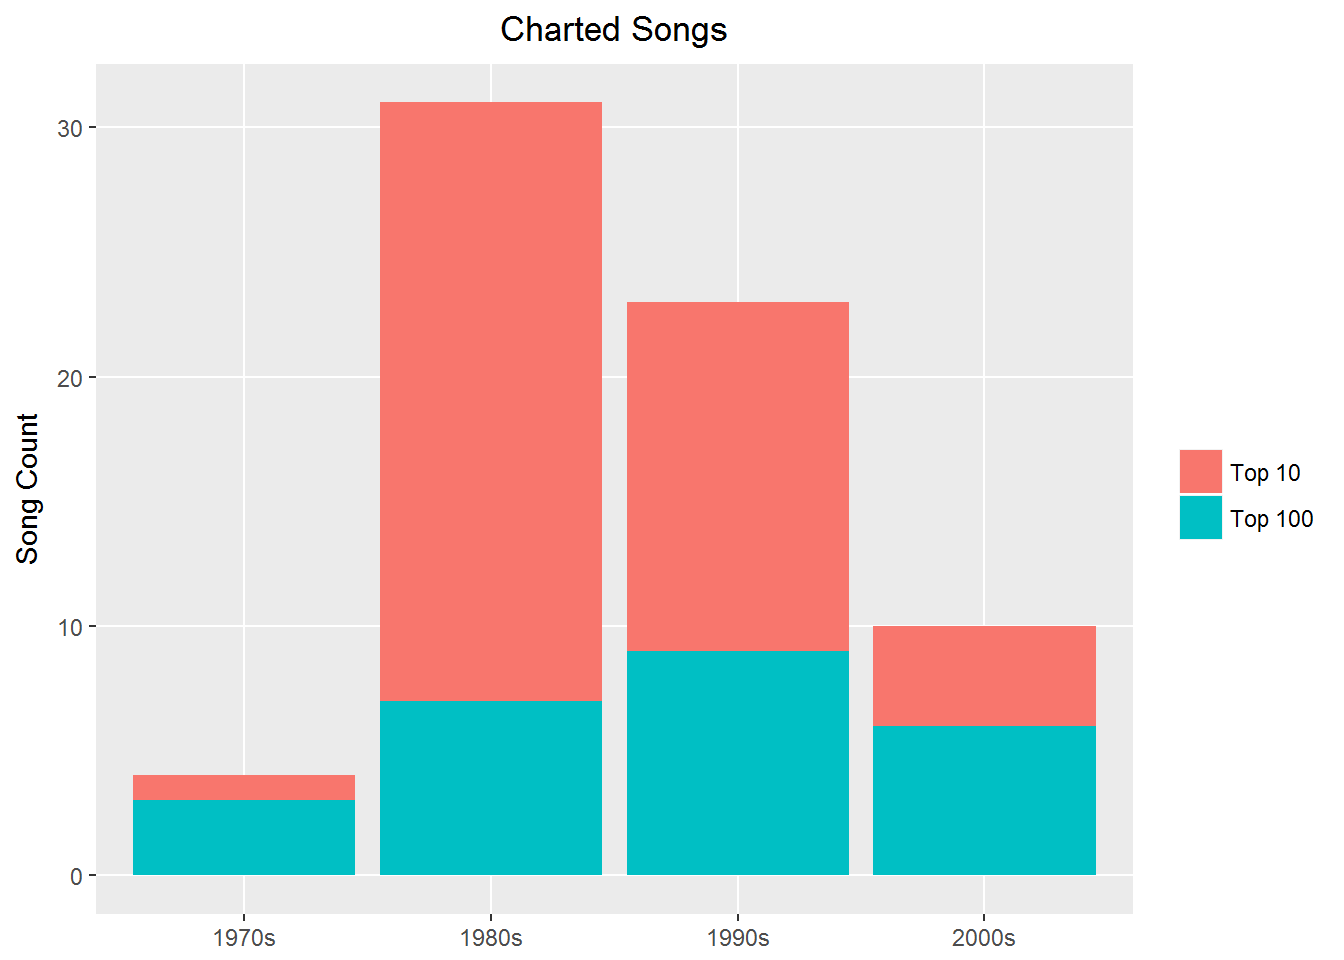
Perhatikan bahwa dari semua lagu Prince yang masuk tangga lagu, mayoritas mencapai Top 10. Tetapi yang lebih menarik adalah dekade paling produktif untuk lagu baru adalah 1990-an, namun lebih banyak hit tangga lagu terjadi di 1980-an. Mengapa demikian? Simpan pertanyaan ini saat Anda menelusuri bagian penambangan teks.
Untuk memanfaatkan kekuatan dataset penuh untuk analisis lirik, Anda dapat menghapus referensi ke chart level dan tahun rilis dan memiliki kumpulan lagu yang jauh lebih besar untuk ditambang. Lihat:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("All Songs in Data")
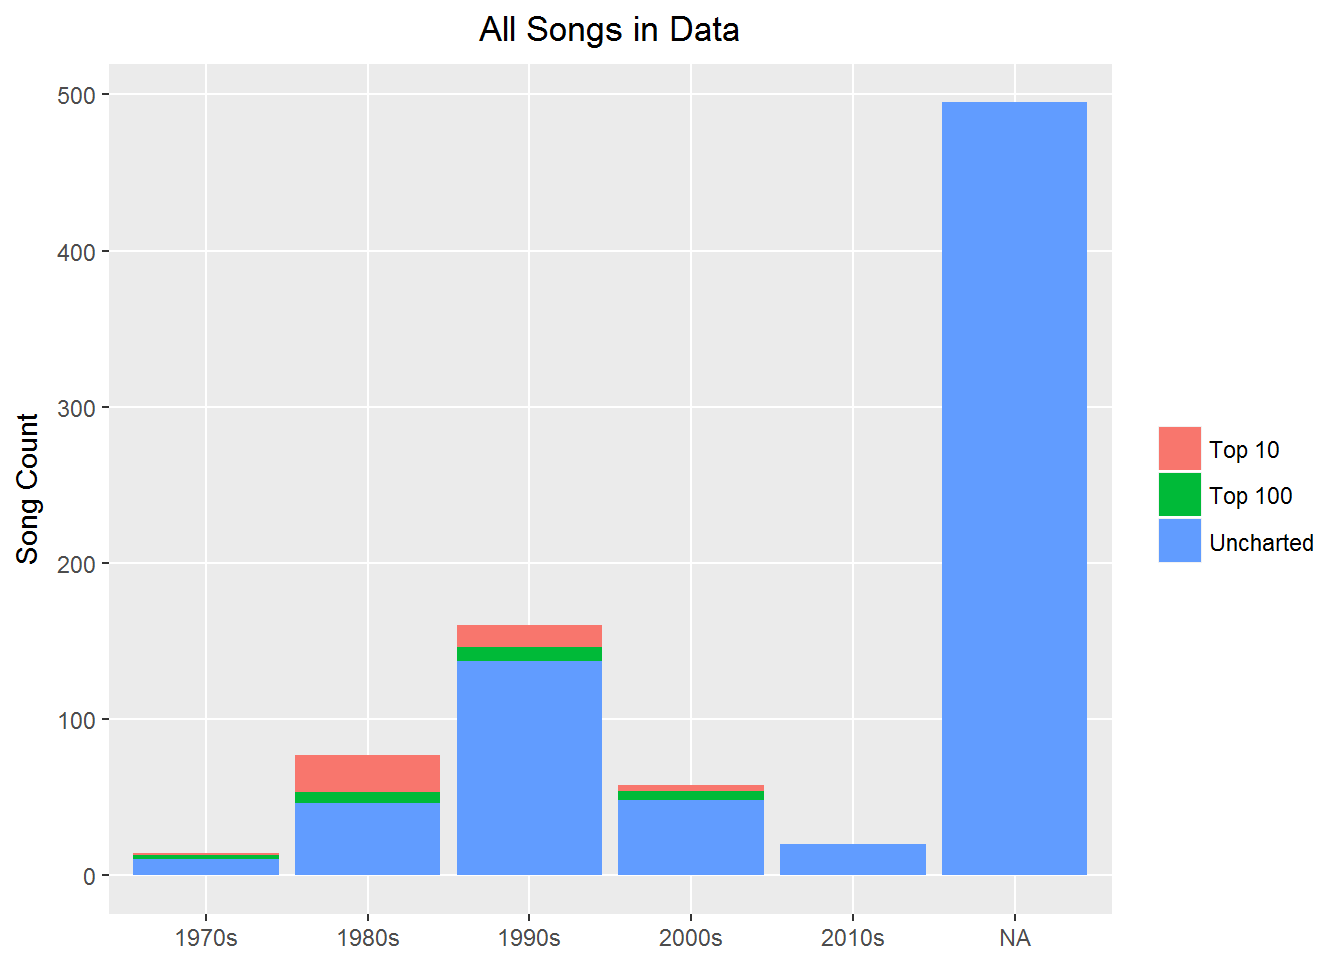
Seperti terlihat, Prince menulis ratusan lagu yang tidak memiliki tanggal rilis dalam data. Untuk analisis sentimen atau analisis eksploratori Anda dapat menggunakan semua data, tetapi untuk tren sepanjang waktu Anda memiliki set yang jauh lebih kecil untuk dikerjakan. Ini tidak masalah—hanya sesuatu yang perlu diingat.
Bagi para penggemar berat Prince, di bawah ini adalah sekilas lagu-lagu yang mencapai No. 1 di tangga lagu. (Perhatikan Anda dapat menggunakan kable() dan kable_styling() dari paket knitr dan kableExtra serta color_tile() dari formattable untuk membuat keluaran HTML yang tertata rapi.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
Penambangan teks juga dapat dianggap sebagai analitik teks. Tujuannya adalah menemukan informasi relevan yang mungkin tidak diketahui atau tersembunyi di balik hal-hal yang jelas. Natural Language Processing (NLP) adalah salah satu metodologi yang digunakan dalam menambang teks. Ia mencoba mengurai ambiguitas dalam bahasa tertulis dengan tokenisasi, klastering, mengekstraksi entitas dan hubungan kata, serta menggunakan algoritme untuk mengidentifikasi tema dan mengkuantifikasi informasi subjektif. Anda akan mulai dengan menguraikan konsep kompleksitas leksikal.
Kompleksitas leksikal dapat berarti berbeda dalam konteks berbeda, tetapi untuk saat ini, anggap dapat dijelaskan oleh kombinasi ukuran berikut:
Untuk memulai analisis, Anda perlu memecah lirik menjadi kata-kata individual dan mulai menambang wawasan. Proses ini disebut tokenisasi.
Ingat bahwa ada metode dan format data berbeda yang dapat digunakan untuk menambang teks:
Namun sebelum Anda melakukan tokenisasi apa pun, ada satu langkah lagi dalam pembersihan data. Banyak lirik, saat ditranskripsikan, menyertakan frasa seperti "Repeat Chorus", atau label seperti "Bridge" dan "Verse". Ada juga banyak kata lain yang tidak diinginkan yang dapat mengaburkan hasil. Setelah melakukan analisis sebelumnya, saya memilih beberapa yang ingin saya singkirkan.
Di bawah ini adalah daftar kata-kata berlebih yang perlu dihapus secara manual:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Untuk meng-unnest token, gunakan library tidytext, yang sudah dimuat. Sekarang Anda dapat memanfaatkan kemampuan dplyr dan menggabungkan beberapa langkah sekaligus.
Dari kerangka kerja tidy text, Anda perlu memecah teks menjadi token individual (tokenisasi) dan mentransformasikannya ke struktur data tidy. Untuk ini, gunakan fungsi unnest_tokens() dari tidytext. unnest_tokens() memerlukan setidaknya dua argumen: nama kolom keluaran yang akan dibuat saat teks di-unnest ke dalamnya ("word", dalam kasus ini), dan kolom masukan yang menampung teks saat ini (yaitu lyrics).
Anda dapat mengambil dataset prince dan mem-pipe-nya ke unnest_tokens() lalu menghapus stop words. Apa itu stop words? Anda pasti sudah sangat mengenalnya. Mereka adalah kata yang terlalu umum dan mungkin tidak menambah makna pada hasil. Ada berbagai daftar yang bisa dipilih, tetapi di sini Anda akan menggunakan leksikon bernama stop_words dari paket tidytext.
Gunakan sample() untuk menampilkan daftar acak stop words ini dan head() untuk membatasi ke 15 kata.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Jadi, setelah Anda melakukan tokenisasi lirik menjadi kata, Anda dapat menggunakan anti_join() dari dplyr untuk menghapus stop words. Selanjutnya, singkirkan kata-kata tidak diinginkan yang didefinisikan sebelumnya menggunakan verba filter() dplyr dengan operator %in%. Lalu gunakan distinct() untuk menghapus rekaman duplikat juga. Terakhir, Anda dapat menghapus semua kata dengan kurang dari empat karakter. Ini keputusan subjektif lainnya, tetapi dalam lirik, ini sering berupa interjeksi seperti "yea dan hey". Kemudian simpan hasilnya ke prince_words_filtered.
Catatan: untuk referensi mendatang, prince_words_filtered adalah versi tidy text dari data frame prince tanpa 1) stop words, 2) kata-kata tidak diinginkan, dan 3) kata 1–3 karakter. Anda akan menggunakan ini dalam beberapa, namun tidak semua, analisis.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Perhatikan bahwa stop_words memiliki kolom word, dan kolom baru bernama word dibuat oleh fungsi unnest_tokens(), sehingga anti_join() secara otomatis melakukan join pada kolom word.
Sekarang Anda dapat meninjau class dan dimensi dari struktur data tidy baru Anda:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered adalah data frame dengan total 36916 kata (bukan kata unik) dan 10 kolom. Berikut cuplikan: (Saya memilih satu kata dan membatasi kemunculannya di 10 lagu dan menggunakan select() untuk mencetak field menarik secara berurutan, menggunakan knitr untuk pemformatan lagi). Ini menunjukkan struktur data tidy yang telah ditokenisasi dan belum diringkas.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Anda dapat melihat bahwa setiap baris berisi sebuah kata individual yang akan diulang untuk setiap lagu tempat kata tersebut muncul.
Dalam musik, frekuensi kata individual sangat penting, baik itu pengulangan maupun kelangkaan. Keduanya memengaruhi daya ingat seluruh lagu. Satu pertanyaan yang mungkin ingin diketahui penulis lagu adalah apakah ada korelasi antara frekuensi kata dan lagu hit. Jadi sekarang Anda ingin membawa format tidy selangkah lebih jauh dan memperoleh hitungan kata yang diringkas per lagu.
Untuk menelaah format ini pada lirik Prince, buat histogram yang menampilkan distribusi jumlah kata, dikelompokkan berdasarkan lagu, per penempatan pada Billboard Charts. Unnest kembali lirik prince tanpa memfilter kata apa pun untuk mendapatkan hitungan sebenarnya dari frekuensi kata di seluruh lagu. Gunakan lagi group_by() dan summarise() untuk mendapatkan hitungan. Lalu gunakan verba arrange() dari dplyr untuk menyortir berdasarkan count. Pertama, lihat hitungan tertinggi, kemudian gunakan ggplot() untuk histogramnya.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Song Count") +
    xlab("Word Count per Song") +
    ggtitle("Word Count Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
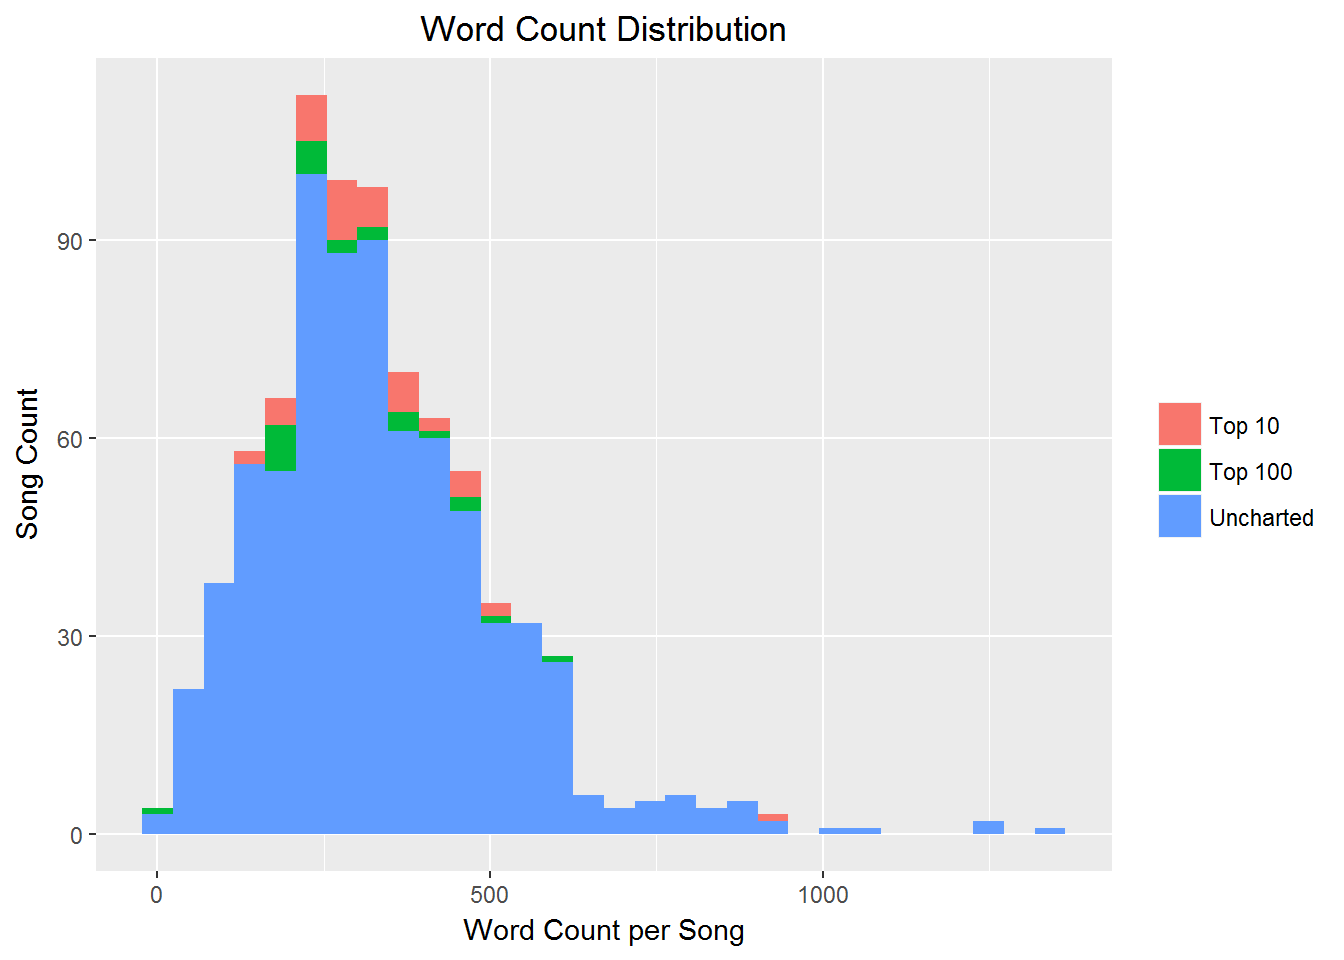
Perhatikan kemencengan ke kanan. Mengingat sifat transkripsi lirik, saya skeptis tentang kesalahan entri data. Jadi, dari rasa penasaran, lihat lagu Top 10 yang memiliki lebih dari 800 kata itu.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Saya melakukan sedikit riset dan menemukan bahwa lagu khusus ini memiliki artis tamu yang membawakan bagian rap. Itu jelas menjelaskannya! Ingat, dataset ini mencakup tangga lagu Pop dan R&B secara global, sehingga genre dan geografi sangat memengaruhi asumsi Anda. Perhatikan peringkat tangga lagu US Pop jauh lebih rendah daripada tangga lagu lain, misalnya memuncak di 5 di Kanada. Hanya sesuatu yang perlu diingat.
Tantangan: Jika Anda terdorong untuk menggarap analisis musik sendiri, Anda mungkin ingin melihat The Million Song Dataset yang memiliki lebih dari 50 fitur (mis. tempo, loudness, danceability, dll.) untuk hampir 50.000 artis! Menambahkan fitur musikal ke lirik menghasilkan analisis yang sangat komprehensif.
Untuk melakukan evaluasi sederhana terhadap kata yang paling sering digunakan pada seluruh set lirik, Anda dapat menggunakan count() dan top_n() untuk mendapatkan n kata teratas dari dataset bersih dan terfilter Anda. Lalu gunakan reorder() untuk mengurutkan kata menurut hitungan dan gunakan verba mutate() dari dplyr untuk menetapkan ulang nilai terurut ke word. Ini memungkinkan ggplot() menampilkannya dengan baik.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Song Count") +
    ggtitle("Most Frequently Used Words in Prince Lyrics") +
    coord_flip()
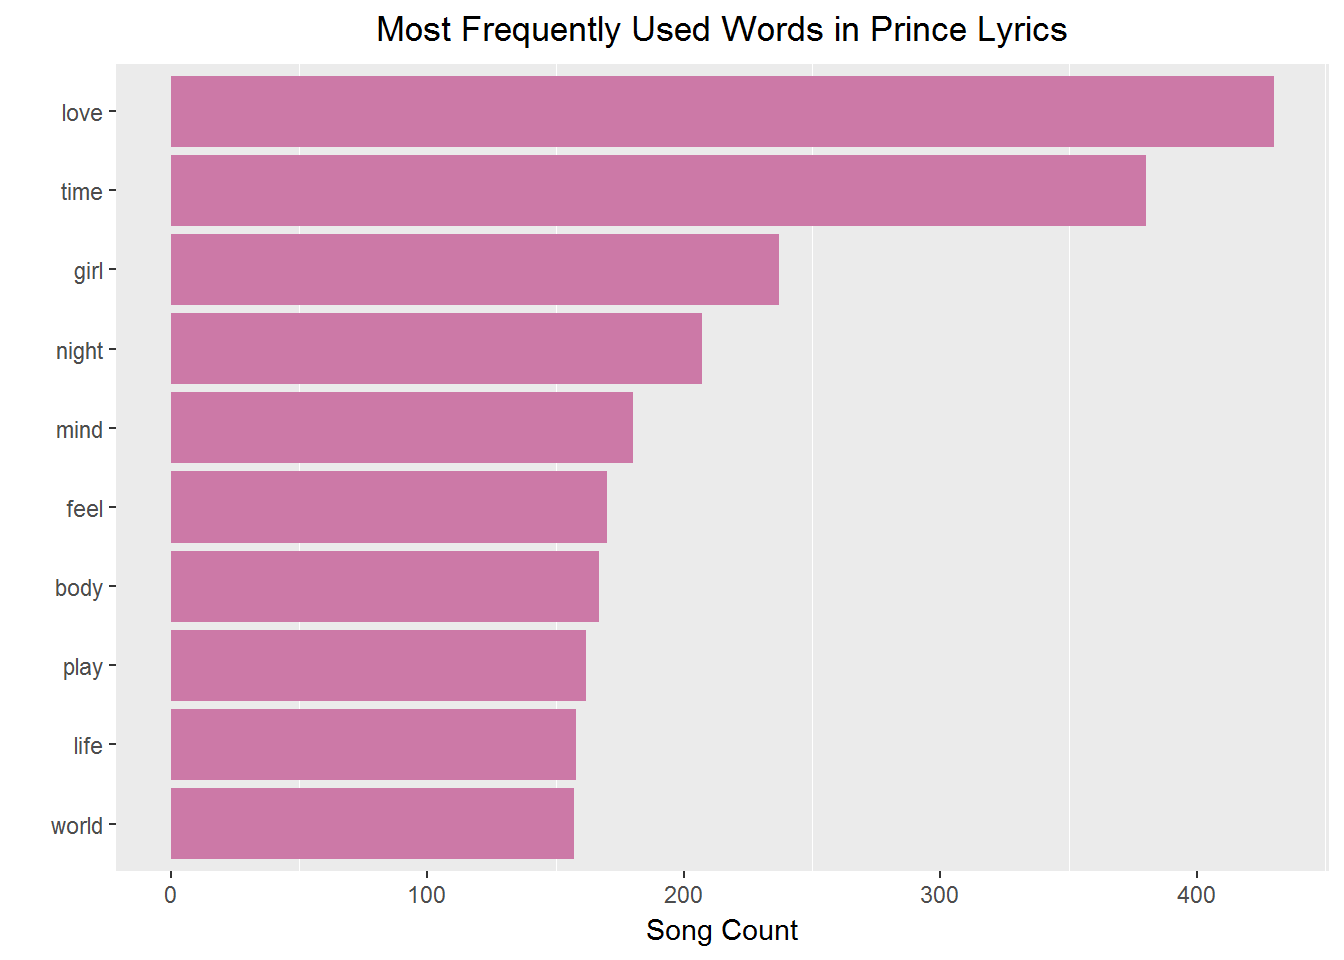
Seperti pada kebanyakan musik populer, love tampaknya menjadi topik umum. Saya tidak akan membuat banyak asumsi hanya dari kata-kata teratas ini, tetapi Anda tentu bisa mendapatkan sedikit wawasan tentang sudut pandang sang artis, meski belum gambaran utuh. Sebelum melanjutkan ke penyelidikan lebih dalam, luangkan sebentar untuk bersenang-senang secara visual.
Word cloud sering mendapat reputasi kurang baik di banyak kalangan, dan jika tidak hati-hati, dapat digunakan di luar konteks. Namun, secara naluriah, kita semua sangat visual, dan ada kasus di mana wawasan nyata bisa diperoleh. Lihat beberapa contoh oleh Sandy McKee di sini. Gunakan saja dengan bijak.
Namun untuk saat ini, lihat paket baru bernama wordcloud2 untuk beberapa hal menarik. Paket ini memberi Anda koleksi kreatif cloud yang menghasilkan widget html. Anda bahkan dapat mengarahkan kursor ke sebuah kata untuk melihat frekuensinya dalam teks. (Paket ini bisa lambat dirender di rMarkdown dan sering pilih-pilih peramban. Semoga ada perbaikan.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
Dan untuk lebih seru lagi, Anda bisa menambahkan sedikit data art ...
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

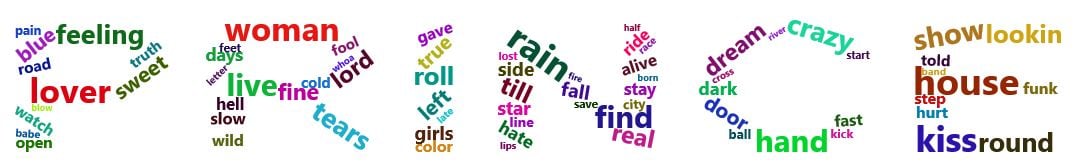
letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
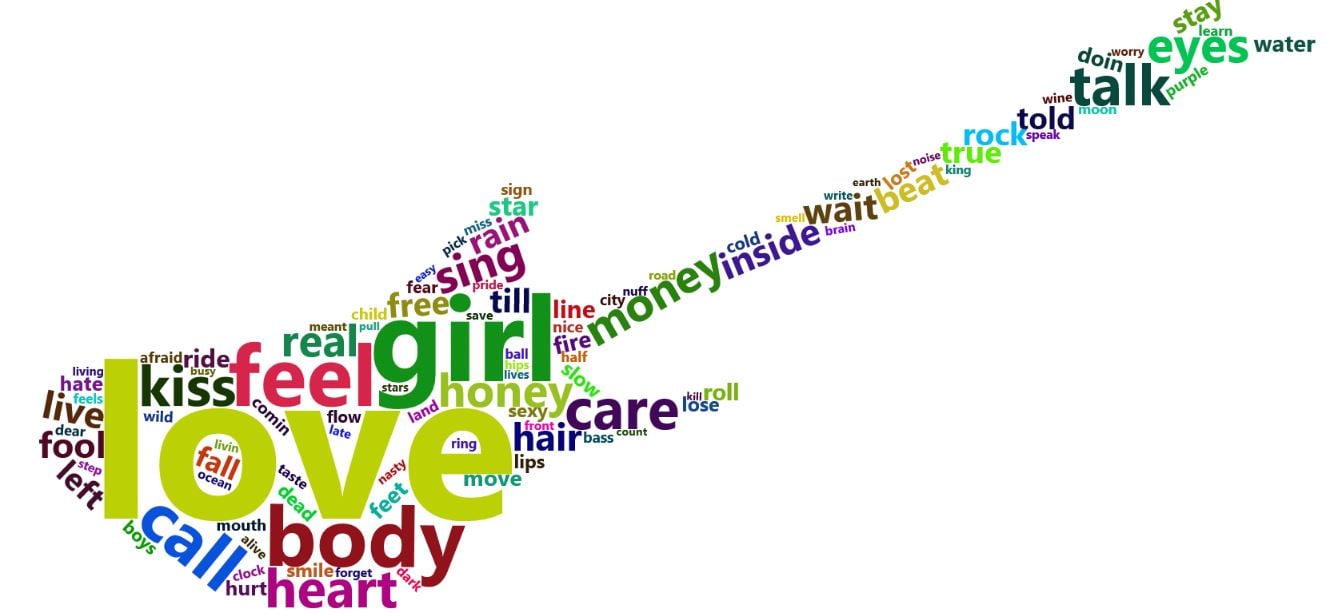
Sejauh ini Anda hanya melihat kata teratas di seluruh lagu. Bagaimana jika Anda memecahnya berdasarkan chart level? Apakah beberapa kata lebih dominan pada lagu yang masuk tangga lagu dibandingkan yang tidak? Ini dianggap sebagai kata populer di mata masyarakat.
Perhatikan dalam kode di bawah penggunaan slice(seq_len(n)) untuk mengambil n kata pertama di setiap chart_level. Ini bekerja berbeda dari top_n() dan ternyata pilihan yang baik saat menggunakan faceting dalam plot. (Selalu ingat ada berbagai cara untuk melakukan trik seperti ini.) Anda juga dapat menggunakan fungsi row_number() untuk memastikan Anda dapat mencantumkan kata dalam urutan yang tepat pada grafik. Secara bawaan, ggplot() akan mengurutkan kata secara alfabet dan praktik yang baik adalah melakukan pengurutan sebelum membuat grafik.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Popular Words by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
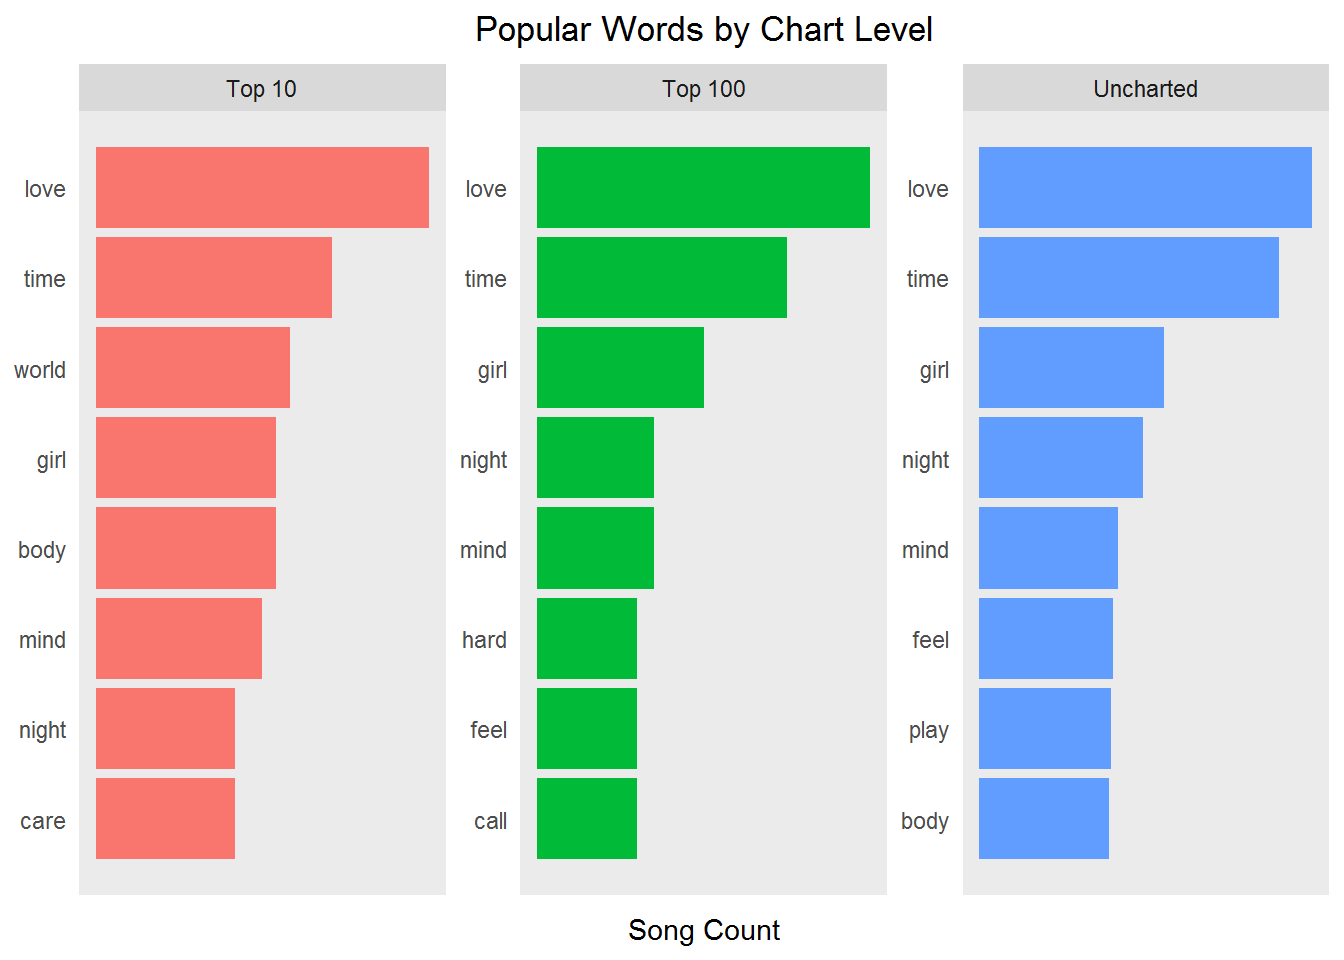
Apa wawasan yang kini Anda peroleh dari hal di atas?
Nah, kata-kata teratas di semua chart level sangat, sangat mirip. Ini tidak terlihat bagus untuk harapan kita memprediksi apakah sebuah lagu akan sukses berdasarkan lirik! Namun Anda baru menyentuh permukaan dari apa yang mungkin dilakukan dengan penambangan teks, dan pada akhirnya NLP dan pemodelan prediktif.
Beberapa kata dalam musik dianggap abadi. Kata abadi bertahan lintas waktu, menarik bagi audiens luas. Jika Anda mengurai analisis Anda per dekade, kata-kata ini akan naik ke puncak. Gunakan penyaringan, pengelompokan, dan agregasi untuk mendapatkan kata teratas per dekade dari lirik Prince dan lihat kata mana yang dapat dianggap abadi atau tren. Anda dapat menggunakan ggplot() dengan facet_wrap() untuk melihat per dekade.
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Timeless Words") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
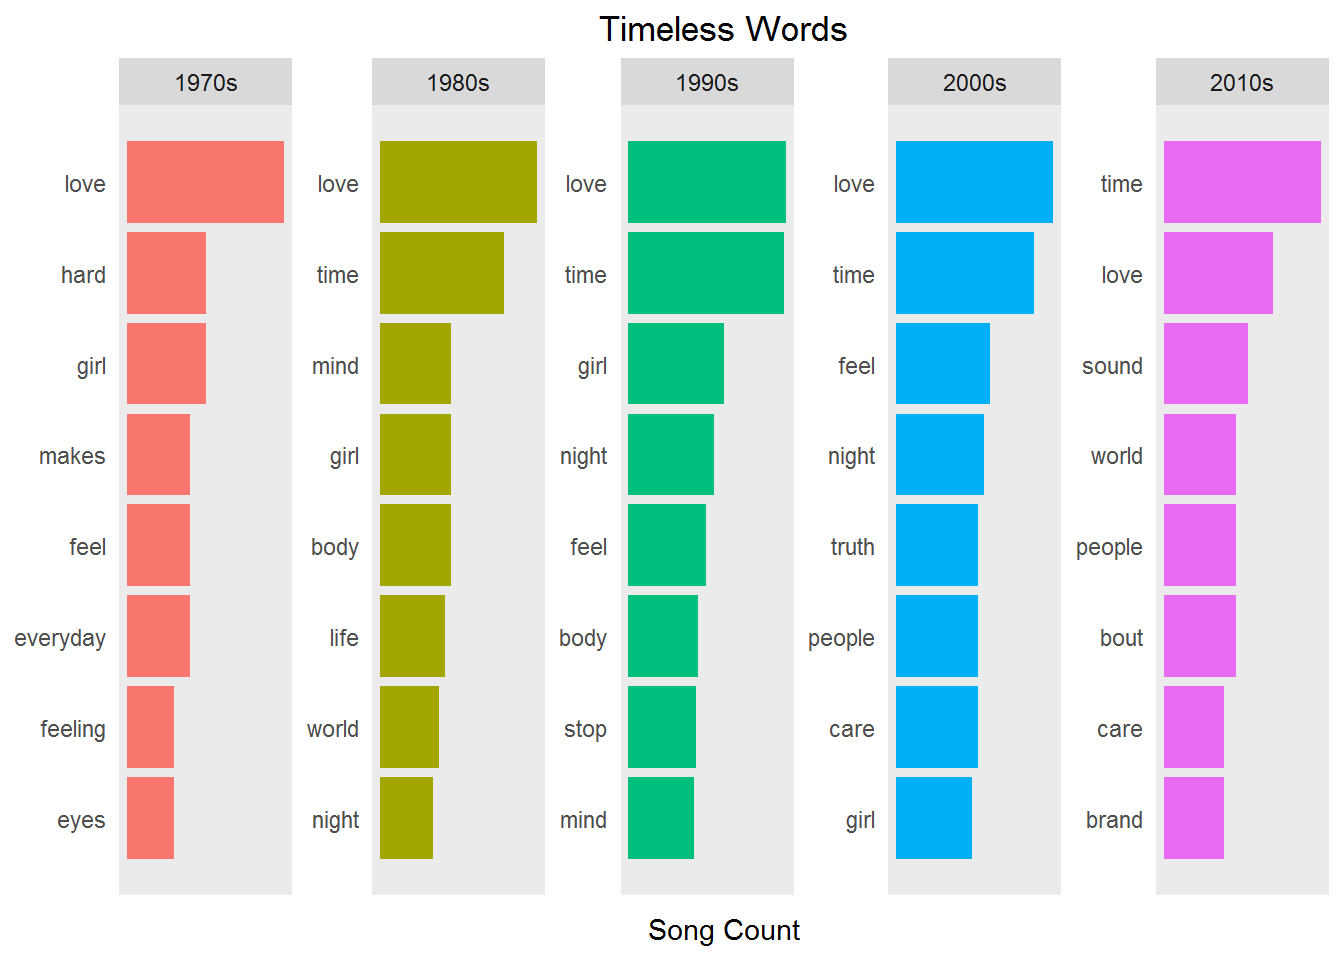
Jelas love, time, dan girl bersifat abadi. Namun seberapa mudah melihat kata tren? Apakah truth menjadi tren di pergantian abad? Bisakah jadi sesuatu seperti itu hanyalah kata yang sangat berulang di lagu tertentu? Apakah frekuensi benar-benar mengidentifikasi tema? Apakah ini bekerja untuk lirik dengan cara yang sama seperti tugas penambangan teks lain seperti menganalisis pidato State of the Union?
Panjang kata adalah topik menarik bagi penulis lagu. Semakin panjang kata, semakin sulit untuk berima dan masuk ke pola. Histogram panjang kata yang ditunjukkan di bawah ini sesuai harapan, dengan beberapa pengecualian yang sangat panjang.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Word Length") +
    ylab("Word Count") +
    ggtitle("Word Length Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
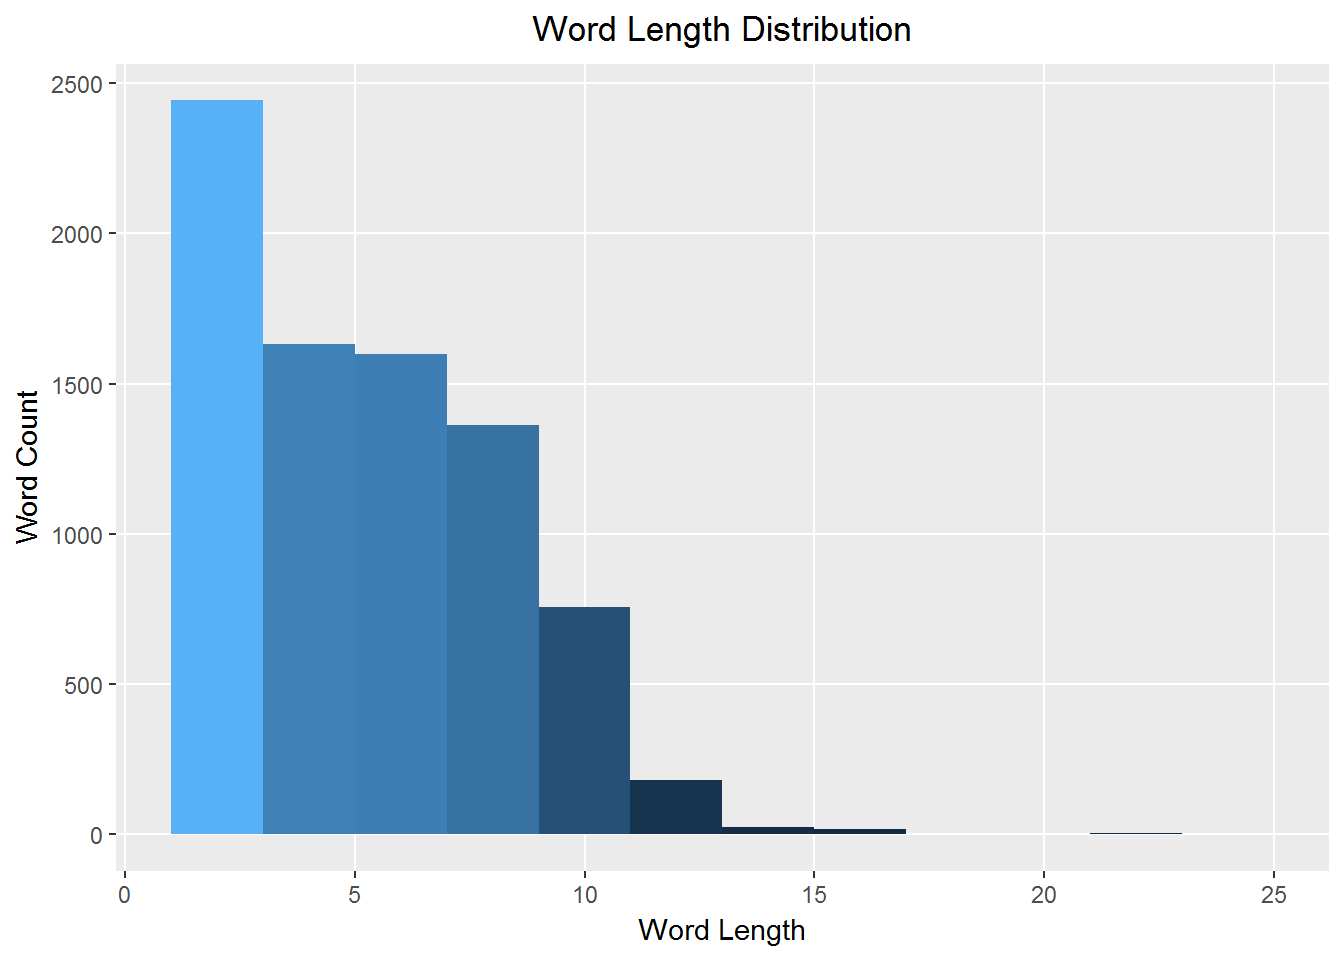
Apa saja kata-kata super panjang itu? Saya rasa ini saatnya untuk word cloud yang menghibur! Ini didasarkan pada panjang kata alih-alih frekuensi kata. Coba lihat:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Semakin beragam kosa kata yang dimiliki sebuah teks, semakin tinggi keanekaragaman leksikalnya. Kosa Kata Lagu merepresentasikan berapa banyak kata unik yang digunakan dalam sebuah lagu. Ini dapat ditunjukkan dengan grafik sederhana tentang rata-rata kata unik per lagu dari tahun ke tahun. Anda akan ingin melakukan tokenisasi dataset asli lagi tetapi biarkan semua stop dan kata pendek masuk karena Anda lebih melihat wawasan kuantitatif dalam plot ini.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexical Diversity") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
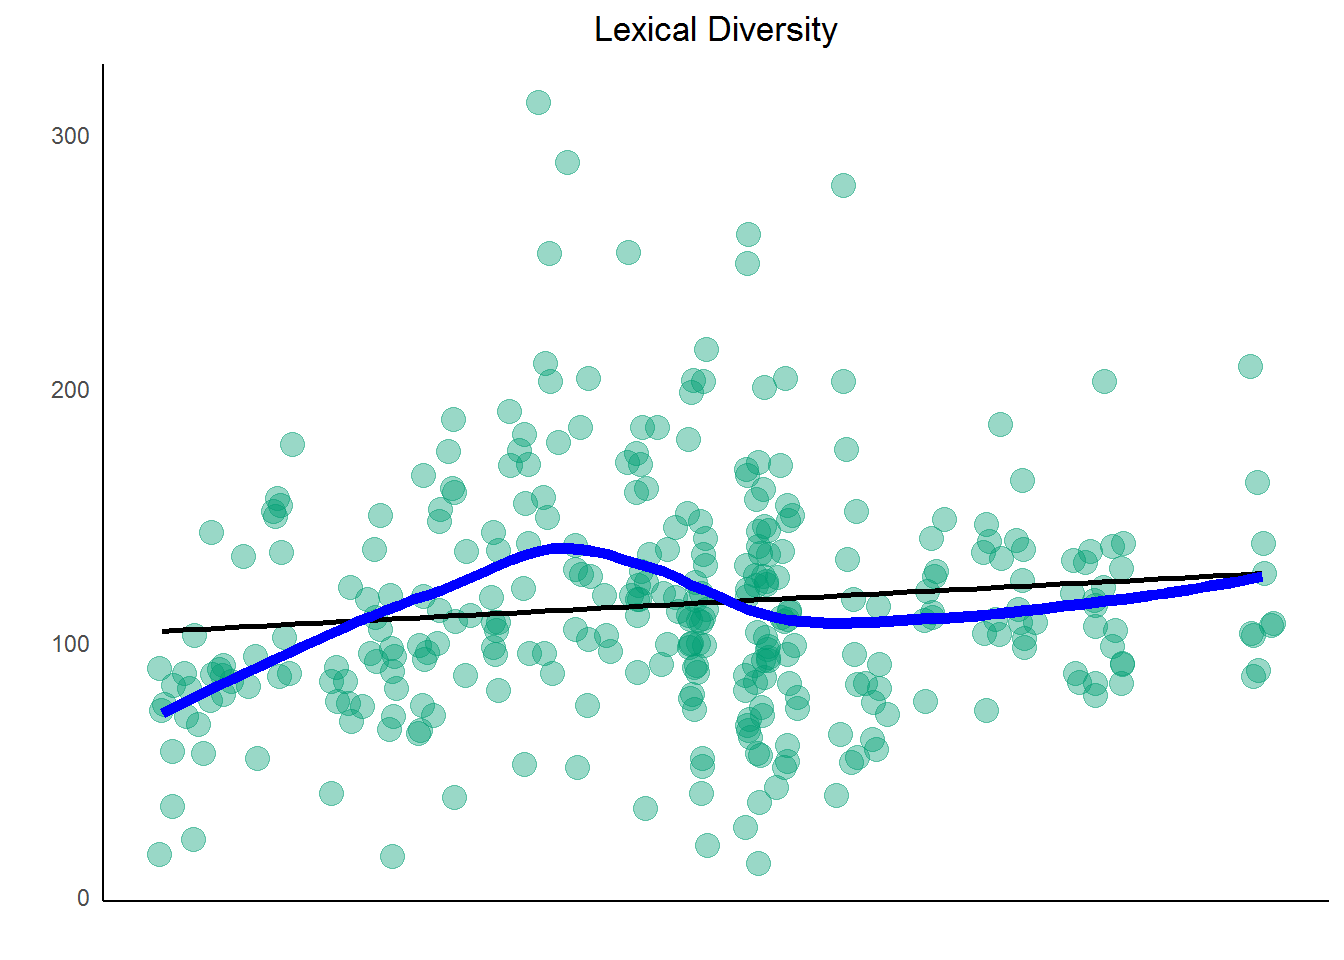
Apa artinya ini? Selama beberapa dekade terakhir, ada tren naik tipis pada keragaman lirik Prince. Bagaimana korelasinya dengan keberhasilan di tangga lagu? Sulit dikatakan, tetapi lanjutkan dan plot densitas dan riwayat tangga lagu untuk perbandingan lebih lanjut.
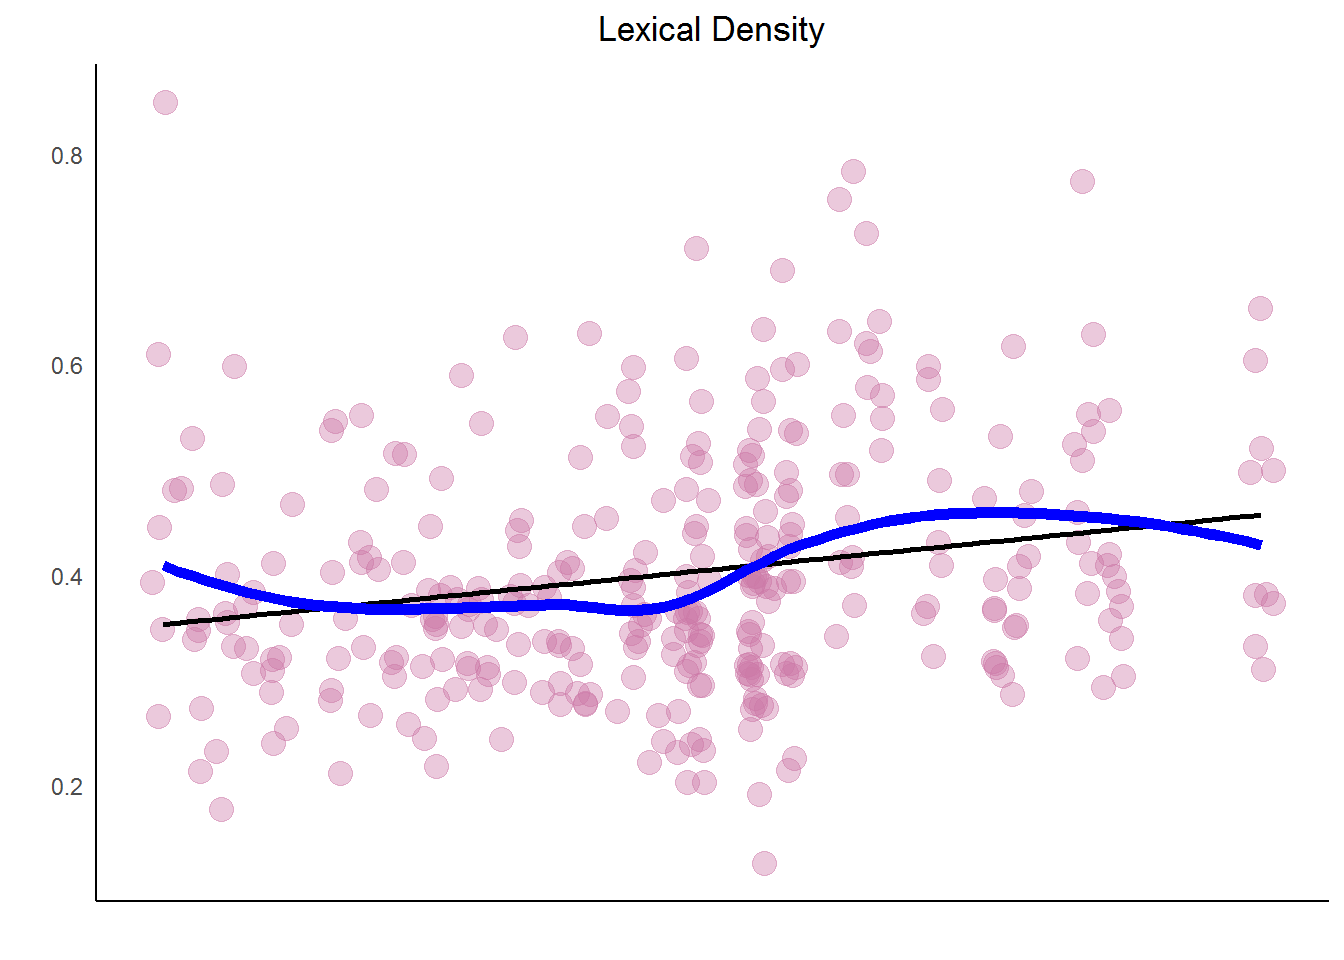
Ingat bahwa untuk tutorial ini, kepadatan leksikal didefinisikan sebagai jumlah kata unik dibagi jumlah total kata. Ini adalah indikator pengulangan kata, yang merupakan alat penting penulis lagu. Saat kepadatan leksikal meningkat, pengulangan menurun. (Catatan: ini tidak menyiratkan pengulangan berurutan, yang merupakan trik penulisan lagu lainnya.)
Lihat kepadatan leksikal Prince selama bertahun-tahun. Untuk densitas, paling baik membiarkan semua kata, termasuk stop words. Jadi mulai dari dataset asli dan unnest kata-kata. Kelompokkan berdasarkan song dan year dan gunakan n_distinct() dan n() untuk menghitung densitas. Pipe itu ke ggplot() dengan geom_smooth(). Tambahkan stat_smooth() tambahan dengan method="lm" untuk model halus linier.
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexical Density") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
Untuk membandingkan tren, buat plot untuk riwayat tangga lagunya (yaitu lagu sukses yang masuk tangga lagu) dan bandingkan dengan diversity dan density. Gunakan grid.arrange() dari gridExtra untuk memplotnya berdampingan.
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Chart History") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
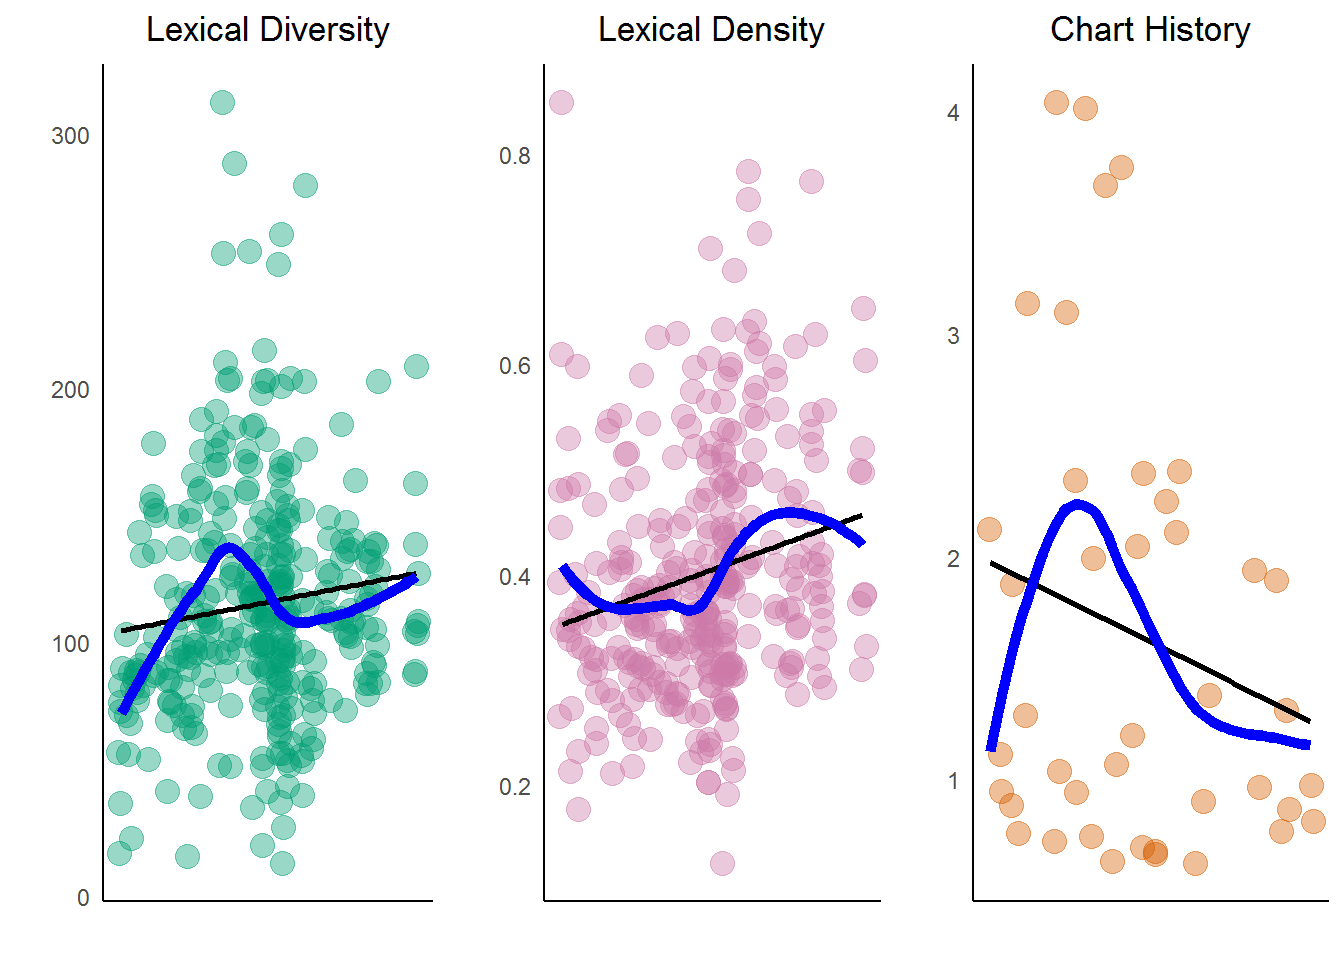
Dari atas, Anda melihat ada sedikit peningkatan pada keanekaragaman dan kepadatan leksikal Prince selama bertahun-tahun. Bagaimana tren ini dibandingkan dengan semua musik populer? Satu studi menunjukkan Lagu Hit mengalami penurunan kepadatan leksikal, yang mengindikasikan peningkatan pengulangan (yakni "lebih banyak kata dengan lebih sedikit yang disampaikan"). Itu bukan yang terjadi pada lagu-lagu Prince. Studi lain mengungkapkan bahwa di semua musik populer, keberagaman (kata unik) meningkat seiring waktu, yang berkorelasi positif dengan musik Prince. Ini mungkin terkait dengan keberagaman genre yang lebih besar dalam peringkat tangga lagu sepanjang sejarah. Genre adalah bagian data krusial yang tidak ada dalam dataset ini. Mungkinkah riwayat tangga lagunya menurun untuk musik populer namun meningkat untuk R&B/Rap?
Tantangan: Saya serahkan kepada Anda untuk mempertimbangkan hasil ini dan bahkan mendorong Anda mencari dataset berbeda di mana Anda dapat memanfaatkan keterampilan ini sendiri! Ingat, korelasi tidak menyiratkan kausalitas.
Metode yang Anda gunakan sejauh ini melihat seluruh dataset, tetapi belum membahas cara mengkuantifikasi seberapa penting berbagai istilah dalam sebuah dokumen terhadap keseluruhan koleksi. Anda telah melihat frekuensi istilah, dan menghapus stop words, tetapi ini mungkin bukan pendekatan paling canggih.
Masuk TF-IDF. TF adalah "term frequency". IDF adalah "inverse document frequency", yang memberikan bobot lebih rendah untuk kata yang umum digunakan dan bobot lebih tinggi untuk kata yang jarang digunakan dalam kumpulan teks. Ketika Anda menggabungkan TF dan IDF, kepentingan sebuah istilah disesuaikan berdasarkan seberapa jarang istilah itu digunakan. Asumsi di balik TF-IDF adalah istilah yang muncul lebih sering dalam sebuah dokumen harus diberi bobot lebih tinggi, kecuali istilah itu juga muncul di banyak dokumen. Rumusnya dapat diringkas di bawah:
IDF dari istilah apa pun karenanya bernilai lebih tinggi untuk kata yang muncul di lebih sedikit dokumen dalam koleksi. Anda dapat menggunakan pendekatan baru ini untuk menelaah kata paling penting per chart level dengan fungsi bind_tf_idf() yang disediakan oleh tidytext. Fungsi ini menghitung dan mengikat TF dan IDF, bersama dengan hasil kali TF*IDF. Fungsi ini menerima dataset teks tidy sebagai masukan dengan satu baris per token (kata), per dokumen (lagu). Anda akan melihat hasilnya pada kolom baru.
Jadi, ambil data frame Prince asli Anda dan unnest token menjadi kata, hapus kata tidak diinginkan, tetapi biarkan stop words masuk. Lalu gunakan bind_tf_idf() untuk menjalankan rumus dan membuat kolom baru.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Sekarang Anda dapat melihat bahwa IDF dan TF-IDF bernilai 0 untuk kata yang sangat umum. (Secara teknis, suku IDF adalah log natural dari 1 dan karenanya nol untuk kata-kata ini.) Pipe hasil di atas ke arrange() dan urutkan menurun berdasarkan tf-idf. Tambahkan beberapa langkah lagi dan Anda akan melihat cara berbeda untuk memandang kata-kata dalam lirik Prince.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %> %
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
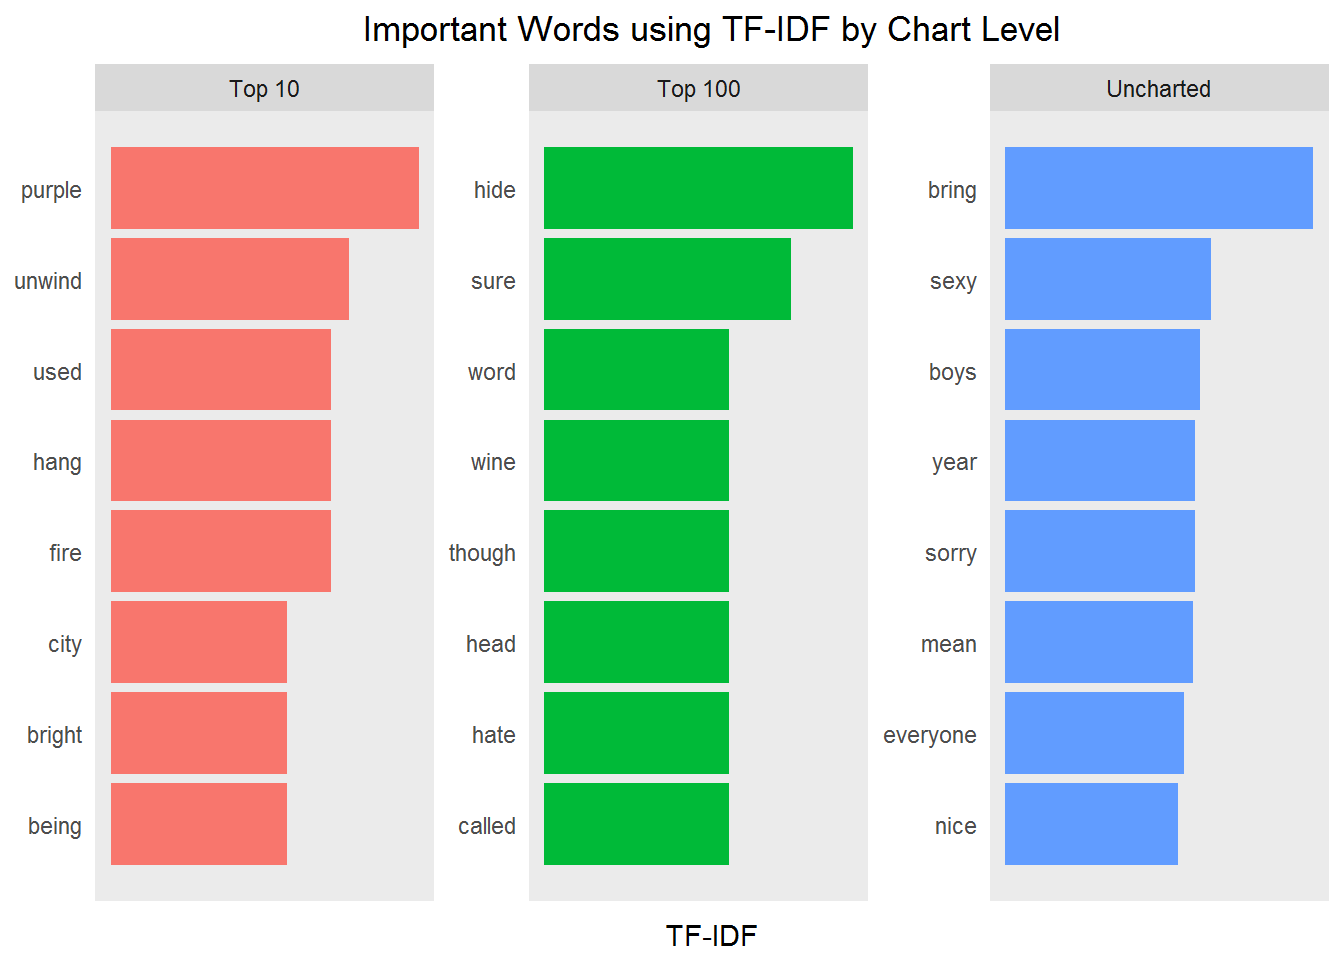
Wow, menggunakan TF-IDF jelas memberi kita perspektif berbeda tentang kata yang berpotensi penting. Tentu saja, interpretasinya murni subjektif. Melihat pola apa?
Selanjutnya, lihat TF-IDF lintas waktu:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Decade") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
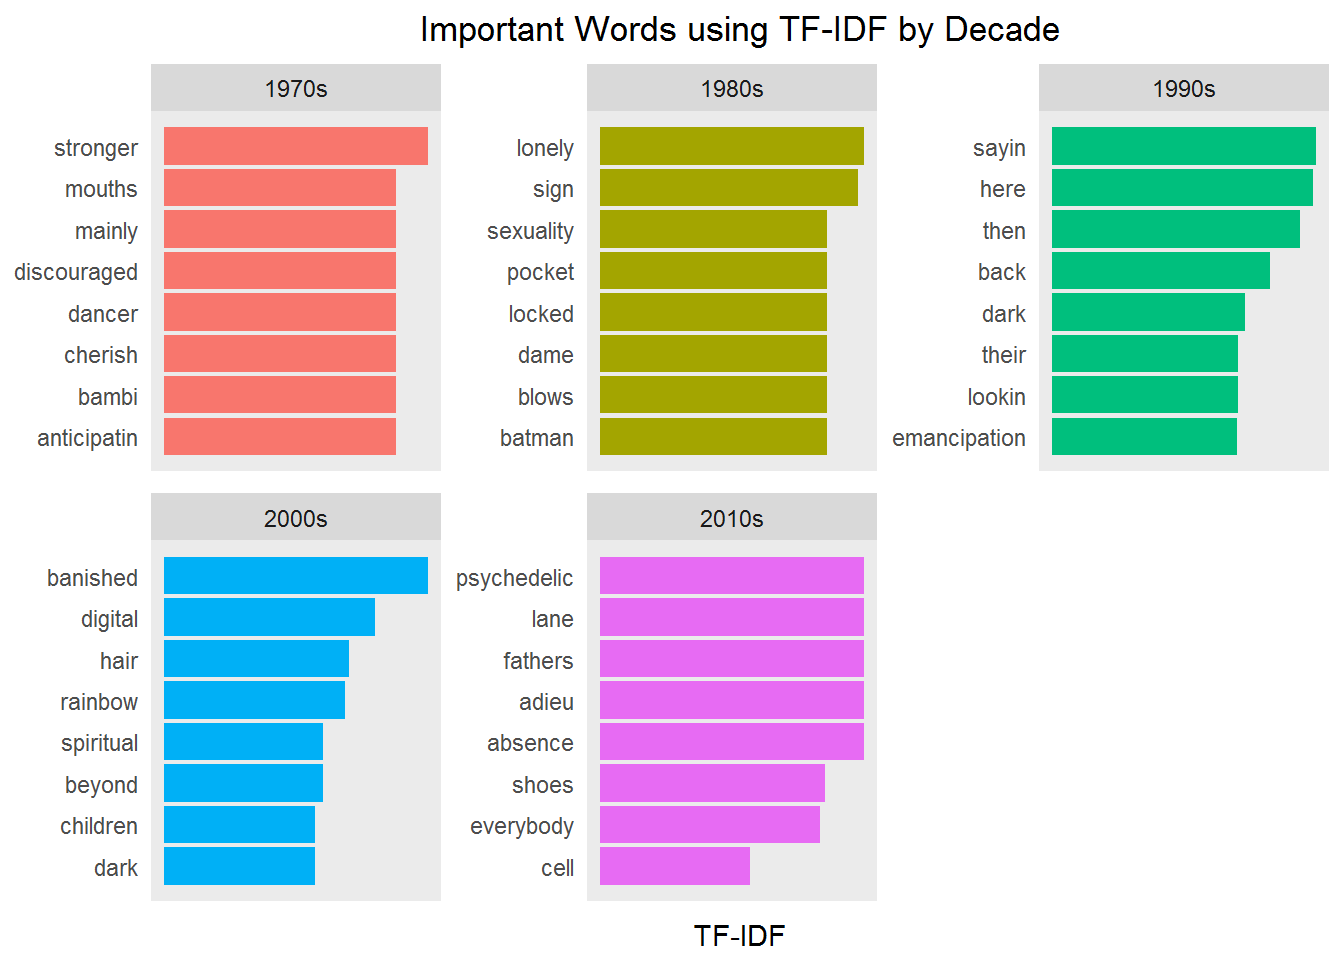
Anda jelas mendapatkan tingkat wawasan yang lebih dalam sekarang. Kata-kata abadi tak lagi dominan. Apakah Anda mulai melihat topik atau tema muncul? Apakah itu benar-benar mungkin hanya dengan beberapa kata per grup? Anda akan membawa ini ke level baru dalam tutorial kedua (Bagian Dua: Analisis Sentimen dan Pemodelan Topik dengan NLP).
Sebuah word cloud cepat dengan metode ini menunjukkan perspektif baru tentang kata penting dalam lirik Prince dan terasa lebih menarik...
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
Dalam studi kasus ini, Anda pertama kali menengok data aktual, melihat hanya hal-hal dasar. Setelah melakukan beberapa pengondisian seperti pembersihan data dan menghapus kata yang tidak informatif, Anda memulai analisis eksploratori pada level lagu.
Selanjutnya, Anda menyelami lebih dalam penambangan teks dengan meng-unnest lirik menjadi kata-kata ter-token agar dapat melihat kompleksitas lirik. Hasilnya memberikan wawasan penting untuk langkah berikutnya yaitu analisis sentimen dan pemodelan topik.
Akhirnya, Anda menggunakan analisis TF-IDF untuk merepresentasikan informasi di balik sebuah kata dalam dokumen terkait suatu hasil yang menarik. Anda mungkin menganggap ini cara yang baik untuk mengidentifikasi tema dalam musik, tetapi Anda baru memiliki setengah cerita. Bagian Dua membahas metode pembelajaran tanpa pengawasan bernama Latent Dirichlet Allocation (LDA). Seperti dalam semua aspek Data Science, ada banyak metode yang dapat dipilih untuk memperoleh wawasan. Dan dalam Bagian Dua dan Tiga dari studi kasus ini, Anda akan membahas lebih banyak opsi tersebut.
Semoga Anda sama bersemangatnya dengan saya untuk melanjutkan perjalanan dari analisis eksploratori menuju analisis sentimen, pemodelan topik, dan wawasan prediktif.
Terima kasih sudah membaca, dan semoga bertemu Anda di tutorial berikutnya!
Pelajari lebih lanjut tentang R dan Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



