Kurs
Maschinelles Lernen mit caret in R
4 Std.
60.8K
Dies ist Teil eins einer dreiteiligen Tutorial-Serie, in der du mit R verschiedene Analysen an einer Fallstudie zu Songtexten des legendären Künstlers Prince durchführst. Die drei Tutorials behandeln Folgendes:
Songtexte spiegeln oft die Perspektive eines Künstlers wider, doch Hits verraten, was die Gesellschaft hören will. Textanalyse von Liedern ist anspruchsvoll: Weil Lyrik anders funktioniert als Prosa, sind Annahmen mit Vorsicht zu genießen und die Wahl der Analysetechniken besonders wichtig. Musiktexte sind allgegenwärtig und prägen unsere Gedanken subtil. Das Konzept „Predictive Lyrics“ gewinnt an Fahrt und taucht zunehmend in Forschungsarbeiten und Abschlussarbeiten auf. Diese Fallstudie streift einige Facetten dieses jungen Themas.
Zur Würdigung des beeindruckenden und vielfältigen Werks von Prince untersuchst du offensichtliche und oft verborgene Botschaften in seinen Texten. Du musst seine Musik nicht mögen, um seinen Einfluss auf die Entwicklung zahlreicher Genres weltweit zu schätzen. Das Magazin Rolling Stone führte Prince als 18. der besten Songwriter aller Zeiten – knapp hinter Bob Dylan, John Lennon, Paul Simon, Joni Mitchell und Stevie Wonder. Textanalyse hält langsam Einzug in Data-Science-Communitys, während die Vorhersage von „Hits“ greifbarer wird.
Prince war ein Mann, der vor Musik nur so sprudelte – ein unglaublich produktiver Songwriter, ein Virtuose an Gitarre, Keyboards und Schlagzeug und ein Meisterarchitekt von Funk, Rock, R&B und Pop, auch wenn seine Musik sich jeder Schublade entzog. - Jon Pareles (NY Times)
In diesem Tutorial, Teil eins der Serie, nutzt du Text-Mining-Techniken auf einem Set von Songtexten mit dem Tidy-Text-Framework. Tidy-Datasets folgen einer Struktur, bei der jede Variable eine Spalte ist, jede Beobachtung eine Zeile und jede Beobachtungseinheit eine Tabelle. Nach dem Säubern und Aufbereiten des Datensatzes erstellst du beschreibende Statistiken und explorative Visualisierungen und beleuchtest verschiedene Aspekte von Princes Texten.
Teil eins setzt Grundwissen zu Tidy Data voraus – insbesondere zu Paketen wie dplyr für Transformationen, ggplot2 für Visualisierungen und dem %>% Pipe-Operator aus dem magrittr-Paket. Jedes Tutorial stellt die Werkzeuge vor, geht aber nicht jeden Schritt bis ins Detail. Du wirst sehen, dass oft mehrere Schritte mit dem %>%-Operator kombiniert werden. Da es sich um eine Fallstudie handelt, gilt: Alle Schlussfolgerungen sind rein beobachtend; Korrelation bedeutet nicht Kausalität.
Tipp: Zwei gute Einstiege zu den verwendeten Tools sind R for Data Science von Garrett Grolemund und Hadley Wickham sowie Text Mining with R von Julia Silge und David Robinson.
Teile zwei und drei
In einem separaten Tutorial, Teil zwei, behandelst du Sentimentanalyse und Topic Modeling, um Stimmung und Themen in Princes Musik zu erfassen und auf gesellschaftliche Perspektiven zu beziehen. Du arbeitest mit einem Sentimentlexikon, bewertest binäre und kategoriale Stimmungen, visualisierst Trends im Zeitverlauf und betrachtest N-Gramme und Wortassoziationen. Außerdem setzt du Natural Language Processing (NLP) und Clusterverfahren wie Latent Dirichlet Allocation (LDA) und K-Means ein, um Motive in den Texten herauszuarbeiten.
In Teil drei schließt du den Kreis: Du nutzt deine explorativen Ergebnisse, um vorherzusagen, in welchem Jahrzehnt ein Song veröffentlicht wurde und – spannender – ob er anhand seiner Texte die Billboard-Charts erreicht. Du verwendest Machine-Learning-Tools wie Entscheidungsbäume (rpart und C50), K-Nearest-Neighbors (class) und Naive Bayes (e1071), um einen Textklassifikator zu bauen.
Alle drei Teile nutzen denselben Datensatz mit Prince-Texten, Veröffentlichungsjahr und Billboard-Chartpositionen. Die Techniken lassen sich auch auf viele andere Textarten anwenden. Für Prosa sind Ergebnisse oft leichter zu deuten, da Songtexte häufig indirekte Botschaften und subtile Nuancen enthalten.
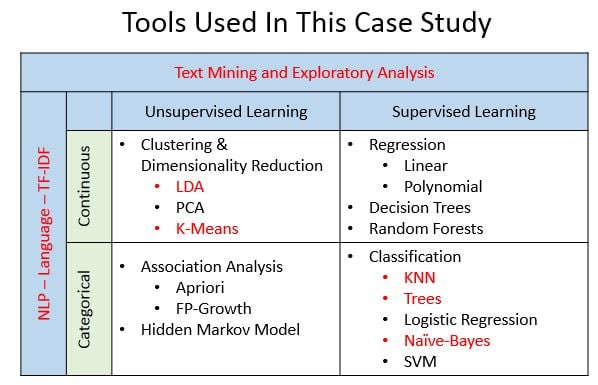
Zusammengefasst gibt es viele Ansätze zur Analyse von Songtexten. Diese Tutorials decken die im folgenden Schaubild rot markierten Methoden ab. Das Diagramm ist eine grobe Übersicht eines sehr „unscharfen“ Bildes. Und nein – nicht des Bildes selbst! Die Wahrheit ist: Die Grenzen zwischen Modellierungs- und ML-Techniken sind fließend und passen nicht immer in eine einzige Box. Setz dir beim Betrachten gedanklich 3D-Brillen auf – dann wirkt es schlüssiger!
Neben dem Üben neuer Kompetenzen will dieses Tutorial Grundfragen zur Liedtextanalyse adressieren. Aktuelle Studien deuten darauf hin, dass die „lyrische Intelligenz“ in der Popmusik sinken könnte. Manche Arbeiten legen nahe, dass die Texte von Nummer-1-Hits dem Leselevel von US-Schülerinnen und -Schülern der dritten Klasse entsprechen. Lässt sich mit Text Mining, NLP, Machine Learning und anderen Data-Science-Methoden Licht ins Dunkel bringen? Lassen sich Themen identifizieren, die gesellschaftlich ankommen – gemessen am Erfolg eines Songs? Ist es möglich, nur anhand der Texte zu prognostizieren, ob ein Song gut läuft? In diesem ersten Teil untersuchst du die lyrische Komplexität von Princes Musik explorativ.
Bevor du loslegst: Was willst du herausfinden? Welche Fragen sind spannend? Zunächst gehst du den Datensatz systematisch durch. Wie sieht er aus? Wie viele Songs sind enthalten? Wie sind die Texte strukturiert? Wie viel Cleaning und Aufbereitung sind nötig? Was sind die Fakten? Wie verteilen sich Wortfrequenzen – und warum ist das wichtig? Technisch geht es darum, die Daten für Sentimentanalyse, NLP und ML-Modelle zu verstehen und vorzubereiten.
Musik war schon immer ein wirksames Medium, um Massen zu erreichen, und Texte spielen dabei eine enorme Rolle. Dennoch wird die Forschung zu ihrem Einfluss auf das Wohlbefinden [der Gesellschaft] bei Weitem nicht ausgeschöpft. - Patricia Fox Ransom
Eine gängige Methode zur Datengewinnung fürs Text Mining ist das Scrapen von Webinhalten mit dem rvest-Paket. Ich konnte Billboard-Chart-Informationen und Prince-Texte von verschiedenen Seiten scrapen und über den Songtitel zusammenführen. Wegen uneinheitlicher Namenskonventionen war etwas Aufbereitung nötig. Subjektiv habe ich alle Songs entfernt, die keine Originalversionen sind, also Remixes, Extended Versions, Club Mixes, Remakes usw. Außerdem habe ich Alben mit historischen Sammlungen seiner Hits ausgeschlossen, um Dopplungen zu vermeiden. Nach etwas Cleaning habe ich das Ergebnis als CSV für dieses Tutorial gespeichert.
Da Teil eins den Fokus auf Text Mining legt, ist dieser Code hier nicht enthalten, aber den Datensatz kannst du dir hier herunterladen, wenn du mitarbeiten möchtest.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Es gibt mehrere Wege, CSV-Dateien einzulesen. Hier nutze ich read.csv(), um ein Data Frame mit Texten, Veröffentlichungsjahr und Billboard-Chartpositionen zu laden. Standardmäßig wandelt R Zeichenketten in Faktoren um, was später Probleme machen kann. Setze deshalb stringsAsFactors auf FALSE. Dann schauen wir uns die Daten an …
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Mit der Funktion names() siehst du die Spalten im Data Frame:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Da ich die Datei erstellt habe, weiß ich: X ist nur eine Zeilennummer, text enthält die eigentlichen Lyrics. Benötigt werden außerdem song, year und peak (die Chartplatzierung). US.Pop und US.R.B sind die Spitzenplatzierungen in den US-Pop- bzw. R&B-Charts; diese behalten wir, den Rest werfen wir vorerst raus.
Nimm dazu den Originaldatensatz prince_orig und pipe ihn mit %>% in select(). So liest sich der Code natürlich von links nach rechts.
select() erlaubt außerdem das Umbenennen von Spalten in einem Schritt. Benenne also text in lyrics um und verwandle die US-Spalten in den tidyverse-Stil mit „_“ statt „.“. Speichere das Ergebnis in prince, das du im weiteren Verlauf nutzt. Mit glimpse() aus dplyr bekommst du eine praktische transponierte Ansicht.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
Die erste naheliegende Frage: Wie viele Zeilen und Spalten gibt es?
dim(prince)
[1] 824 7
Mit dim() siehst du: 7 Spalten, 824 Beobachtungen. Jede Beobachtung ist ein Song. Wie gesagt … äußerst produktiv!
Ein Blick in die Spalte lyrics für einen Song zeigt die Struktur.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Hier gibt es einiges zu bereinigen. Legen wir los.
Für die Aufbereitung gibt es verschiedene Wege. Du könntest das Data Frame mit dem tm-Paket in ein Corpus und eine Document-Term-Matrix überführen und mit tm_map() säubern. Wir bleiben hier bei Basics und nutzen gsub() sowie apply()-Funktionen für die „Drecksarbeit“.
Entferne zunächst englische Kontraktionen, indem du eine kleine Funktion mit gsub() schreibst und sie auf alle Texte anwendest.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
Außerdem tauchen Sonderzeichen auf, die den Text stören. Entferne sie mit gsub() und einem einfachen regulären Ausdruck. Wichtig: Zuerst Kontraktionen expandieren!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Der Konsistenz halber wandelst du alles mit tolower() in Kleinbuchstaben um.
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Ein erneuter Blick zeigt eine deutlich sauberere Version des Rohtexts.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Ein weiterer Standard-Schritt ist Stemming, also das Zurückführen auf Wortstämme. Das ist ein eigenes Thema. Schau dir vorerst die Zusammenfassung des prince-Data-Frames an.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
Es sind 37 Jahre an Songs vertreten, und der niedrigste Rang im Datensatz ist Platz 88. Es gibt einige NAs bei year und peak. Da du unterschiedliche Analysen planst, behältst du den vollen Datensatz in prince und filterst bei Bedarf.
Da du Trends über die Zeit betrachten willst und der Datensatz einzelne Jahre enthält, kannst du Jahrzehnte-Buckets bilden. Mit mutate() aus dplyr erstellst du das Feld decade. Eine Möglichkeit sind verschachtelte ifelse() mit %in%, um Jahre zu binden. Schreibe das Ergebnis zurück in prince.
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Analog dazu erstellst du chart_level, das angibt, ob ein Song Top 10, Top 100 erreichte oder nicht chartete. Diese sind gegenseitig exklusiv, Top 100 schließt Top 10 nicht mit ein.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Zusätzlich erstellst du ein binäres Feld charted, das zeigt, ob ein Song überhaupt in die Billboard-Charts kam. Mit write.csv() speicherst du für spätere Teile.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Für konsistente Visuals definiere ich gern eine eigene Farbpalette. Im Web findest du viele Hex-Codes wie unten. Du kannst dir auch ein eigenes Theme für ggplot() erstellen.
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Bevor es ins Text Mining geht, starte mit einem Basisblick auf Songebene. Eine Visualisierung: Wie viele Songs veröffentlichte Prince pro Jahrzehnt? Da viele Jahre fehlen, filterst du für diesen Plot year-NA heraus.
Mit filter(), group_by() und summarise() gruppierst du nach decade und zählst die Songs. n() ist dabei praktisch. Mit ggplot() und geom_bar() erstellst du ein Balkendiagramm, gefärbt nach charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Released Songs") +
  labs(x = NULL, y = "Song Count")
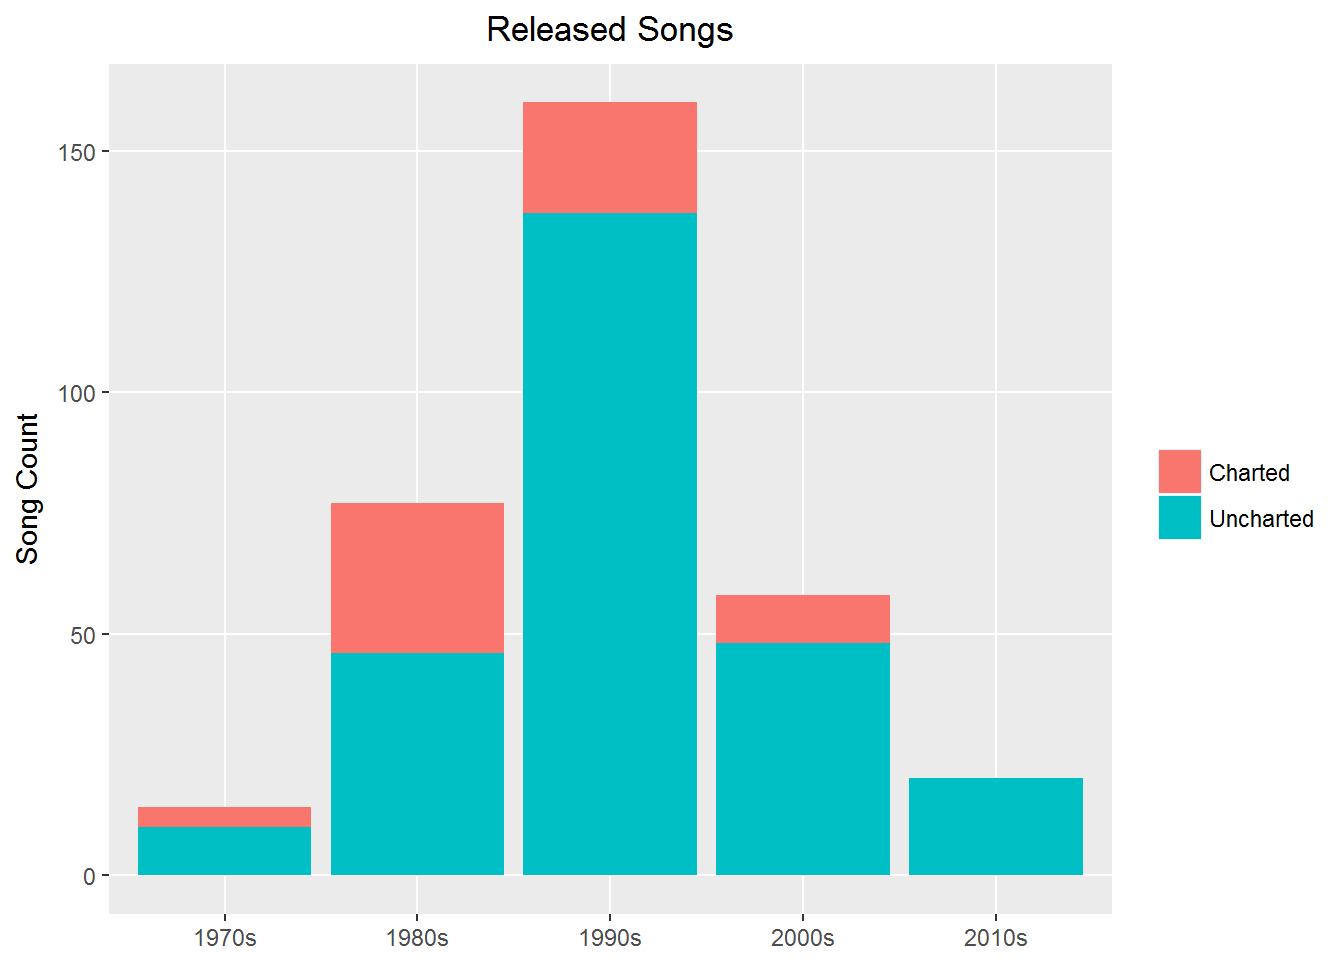
Deutlich erkennbar: Am aktivsten war er in den 1990ern.
Erstelle nun einen ähnlichen Plot mit chart_level.
Denk daran, nach decade und chart_level zu gruppieren, um den Trend zu sehen.
In diesem Plot betrachtest du nur gechartete Songs, also filtere peak > 0. Das gruppierte Objekt pipe’st du in summarise() und dann in ggplot().
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("Charted Songs")
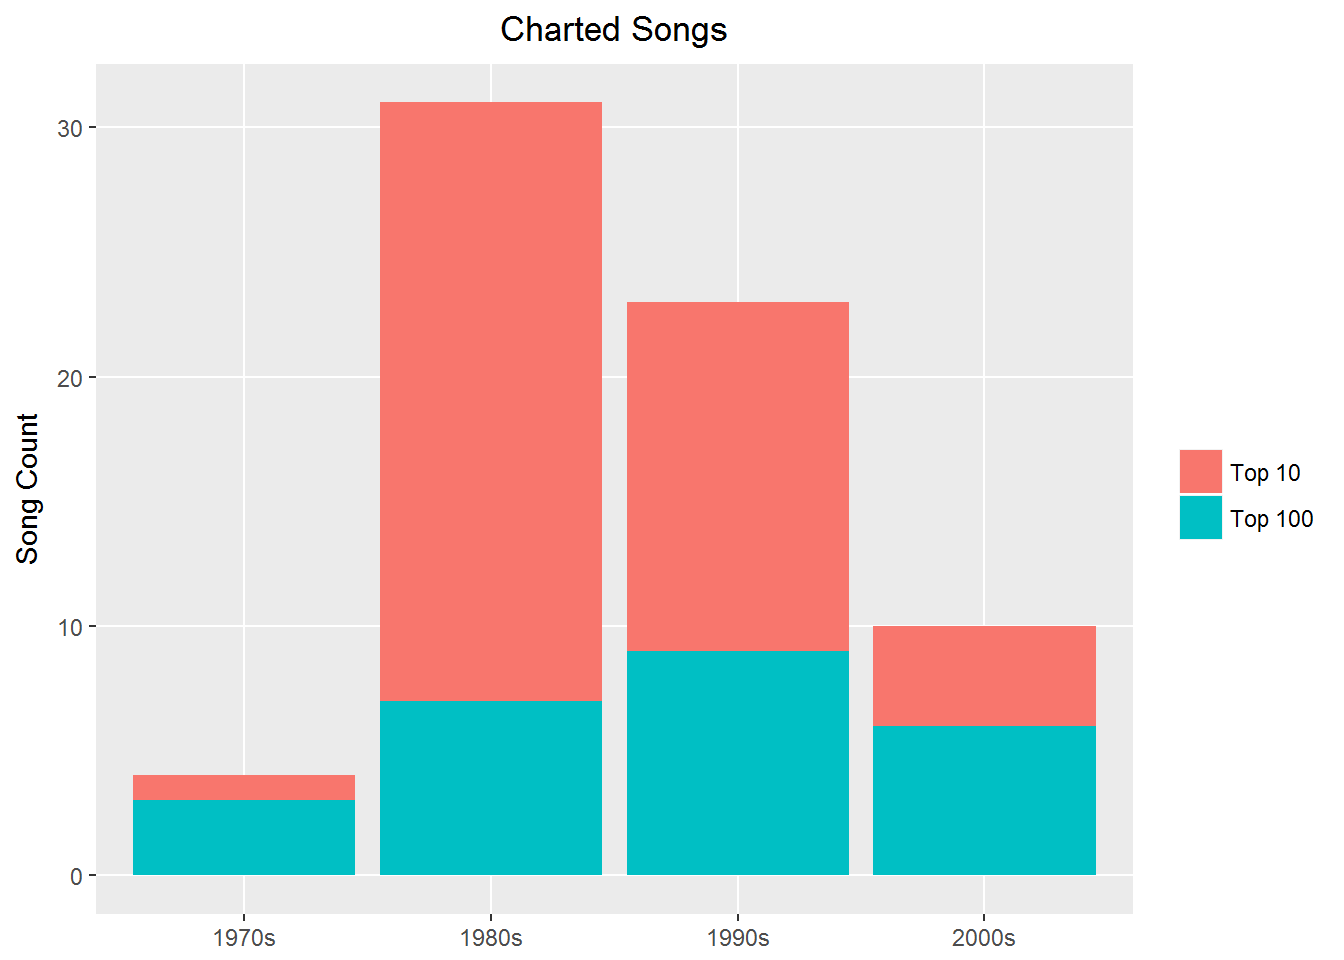
Von allen gecharteten Prince-Songs schaffte es die Mehrheit in die Top 10. Interessant: Seine produktivste Phase für neue Songs waren die 1990er, die meisten Chart-Hits hatte er jedoch in den 1980ern. Warum? Behalte diese Frage für die Text-Mining-Abschnitte im Hinterkopf.
Für die volle Power der Liedtextanalyse kannst du Verweise auf chart_level und year ignorieren und mit deutlich mehr Songs arbeiten. Schau dir das an:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("All Songs in Data")
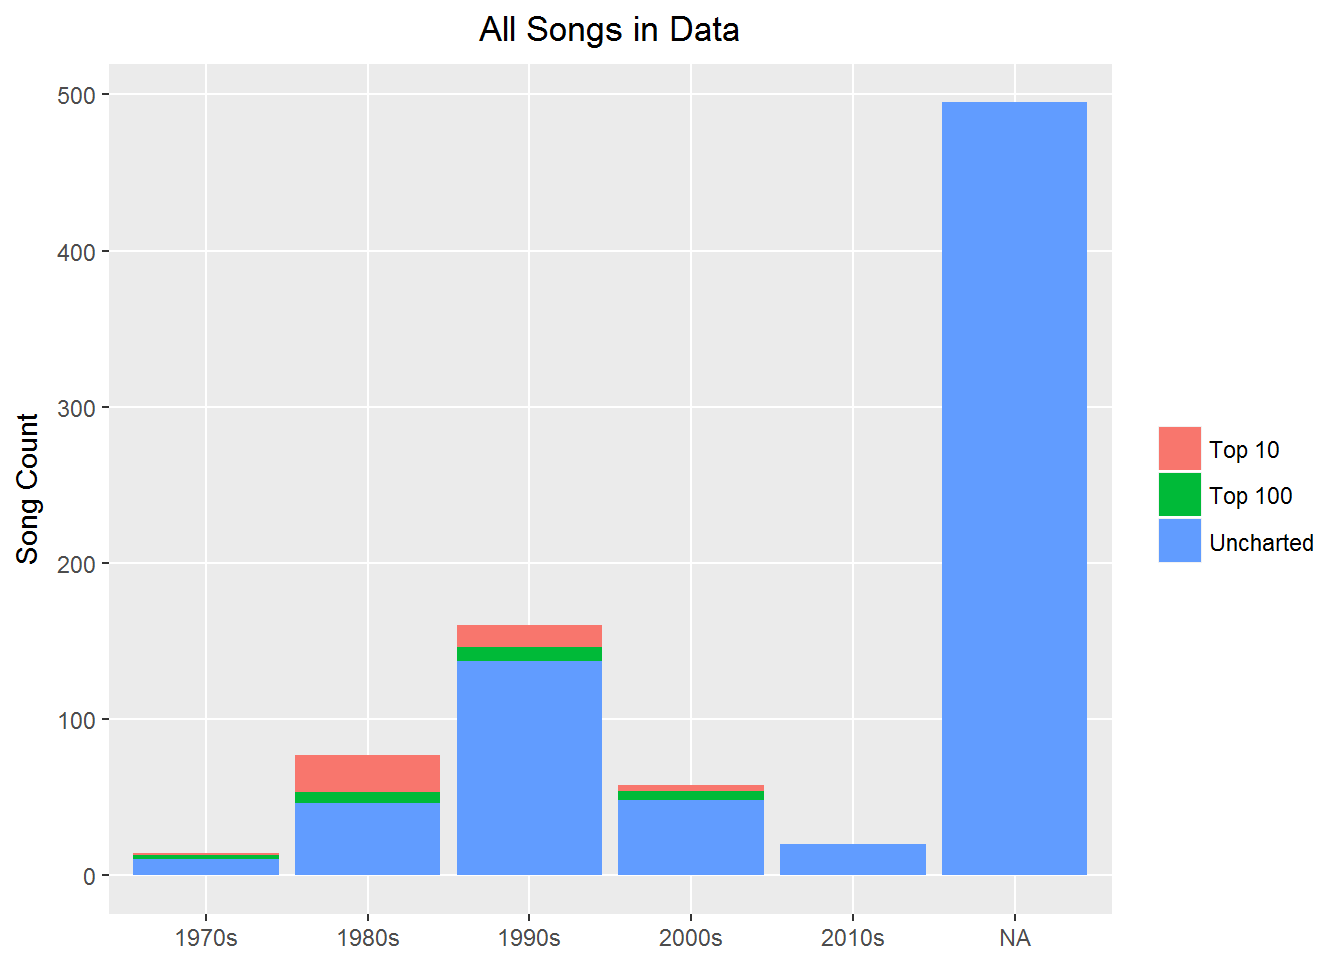
Offenbar gibt es Hunderte Songs ohne Veröffentlichungsjahr im Datensatz. Für Sentiment- oder Explorationsanalysen kannst du alle Songs nutzen; für Zeittrends bleibt die Basis kleiner. Das ist okay – nur im Kopf behalten.
Für alle Prince-Fans: Hier ein schneller Blick auf Songs, die Platz 1 erreichten. (Hinweis: Mit kable() und kable_styling() aus knitr und kableExtra sowie color_tile() aus formattable kannst du schön formatiertes HTML erzeugen.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
Text Mining ist im Kern Textanalyse. Ziel ist, relevante, teils verborgene Informationen zu entdecken. Natural Language Processing (NLP) ist eine Methode dafür. Sie versucht, Ambiguitäten in Sprache zu entschlüsseln – durch Tokenisierung, Clustering, Extraktion von Entitäten und Wortbeziehungen und Algorithmen, die Themen identifizieren und Subjektives quantifizieren. Du startest mit dem Konzept der lexikalischen Komplexität.
Lexikalische Komplexität kann je nach Kontext variieren. Hier betrachten wir eine Kombination aus:
Für die Analyse musst du die Lyrics in einzelne Wörter zerlegen und nach Erkenntnissen suchen. Dieser Prozess heißt Tokenisierung.
Es gibt verschiedene Methoden und Formate für Text Mining:
Vor der Tokenisierung folgt noch ein Cleaning-Schritt. Viele Transkriptionen enthalten Phrasen wie „Repeat Chorus“ oder Labels wie „Bridge“ und „Verse“. Es gibt auch weitere störende Wörter. Nach Voranalyse habe ich einige ausgewählt, die wir entfernen.
Unten steht eine Liste überflüssiger Wörter, die manuell entfernt werden sollen:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Zum Unnesten der Tokens nutzt du das bereits geladene tidytext. So kannst du mehrere dplyr-Schritte elegant verketten.
Aus dem Tidy-Text-Framework brauchst du die Zerlegung in Tokens und die Umwandlung in eine Tidy-Struktur. unnest_tokens() benötigt mindestens zwei Argumente: den Namen der Ausgabespalte („word“) und die Eingabespalte mit dem Text (lyrics).
Nimm den prince-Datensatz, pipe ihn in unnest_tokens() und entferne Stopwörter. Stopwörter kennst du: extrem häufige Wörter ohne Mehrwert. Es gibt verschiedene Listen; wir nutzen das stop_words-Lexikon aus tidytext.
Mit sample() kannst du eine zufällige Auswahl dieser Stopwörter zeigen und mit head() auf 15 begrenzen.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Nach der Tokenisierung entfernst du Stopwörter mit anti_join(). Danach entfernst du die oben definierten unerwünschten Wörter per filter() und %in%. Mit distinct() eliminierst du Duplikate. Schließlich entfernst du Wörter mit weniger als vier Zeichen – eine subjektive Entscheidung, aber in Lyrics sind das oft Interjektionen wie „yeah“ oder „hey“. Speichere in prince_words_filtered.
Hinweis: prince_words_filtered ist die Tidy-Version von prince ohne 1) Stopwörter, 2) unerwünschte Wörter und 3) 1–3‑Zeichen-Wörter. Du nutzt sie in einigen, aber nicht allen Analysen.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Stop_words hat eine Spalte word, und unnest_tokens() erzeugt ebenfalls word – anti_join() verbindet also automatisch auf word.
Prüfe nun Klasse und Dimensionen der neuen Tidy-Struktur:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered ist ein Data Frame mit 36.916 Wörtern (nicht eindeutig) und 10 Spalten. Hier ein Ausschnitt: (Ich habe ein Wort gewählt, es auf 10 Songs begrenzt und mit select() die relevanten Felder in Reihenfolge formatiert – wieder mit knitr). Das zeigt die tokenisierte, unaggregierte Tidy-Struktur.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Jede Zeile enthält ein einzelnes Wort, das für jeden Song wiederholt wird, in dem es vorkommt.
In Musik sind Wortfrequenzen wichtig: Wiederholung wie auch Seltenheit prägen die Memorierbarkeit. Spannend wäre die Korrelation zwischen Wortfrequenzen und Hits. Deshalb gehst du einen Schritt weiter und aggregierst Wortzählungen pro Song.
Zeige für Princes Texte eine Histogrammverteilung der Wortanzahl pro Song, gruppiert nach Chart-Level. Unneste die Lyrics erneut ohne Filter, um echte Häufigkeiten zu erhalten. Gruppiere und aggregiere mit group_by() und summarise(), sortiere mit arrange() und nutze ggplot() für das Histogramm.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Song Count") +
    xlab("Word Count per Song") +
    ggtitle("Word Count Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
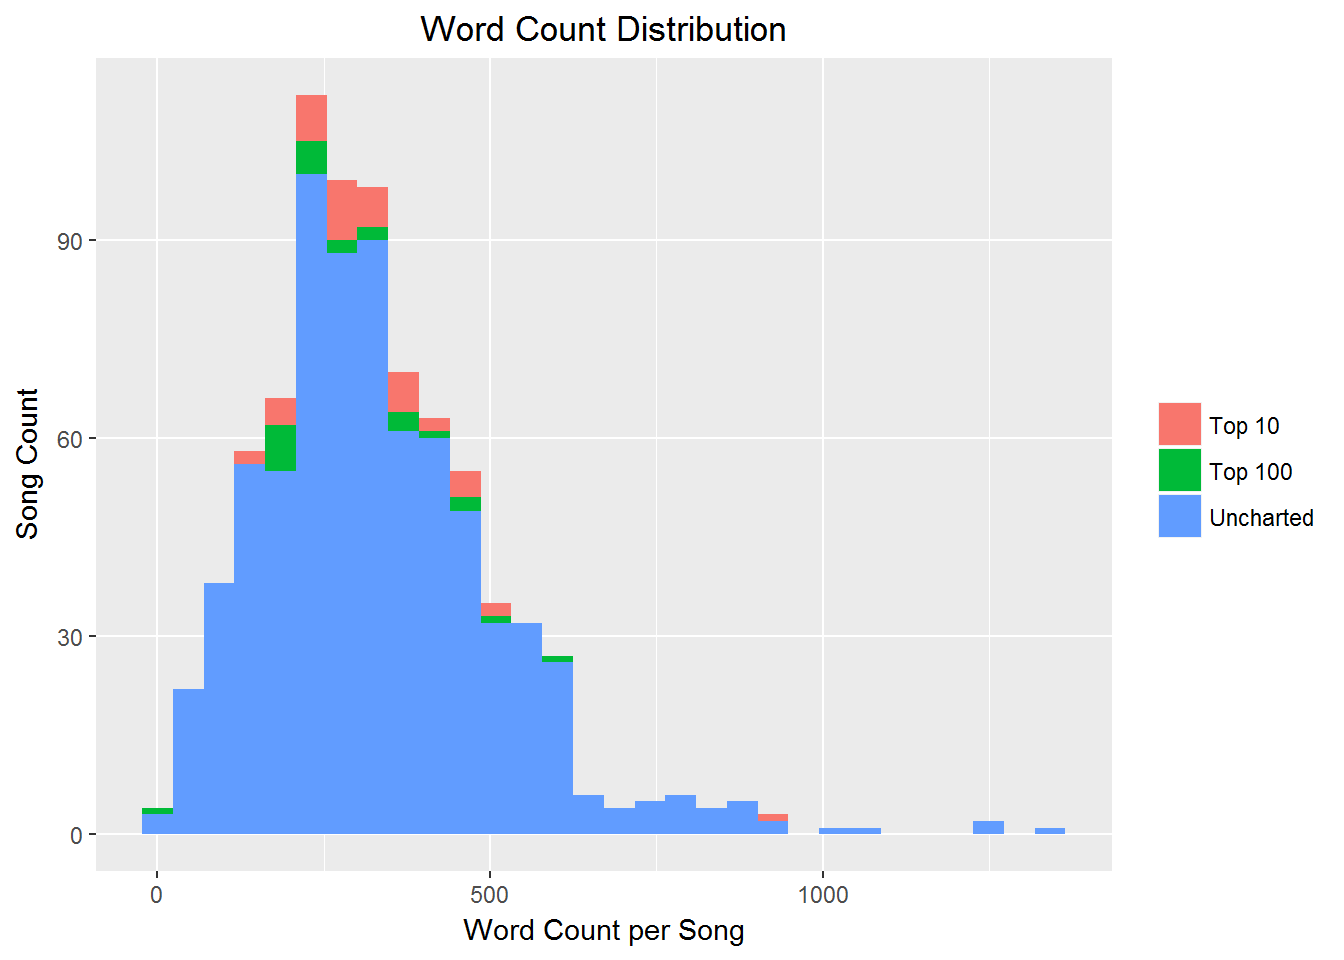
Die Verteilung ist rechtsschief. Angesichts der Transkription war ich skeptisch bezüglich Eingabefehlern. Aus Neugier sehen wir uns den Top‑10‑Song mit über 800 Wörtern an.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Recherche ergab: In diesem Song gibt es einen Gast mit einem Rap-Part – das erklärt die Wortzahl. Der Datensatz umfasst Pop- und R&B‑Charts weltweit; Genre und Geografie beeinflussen Annahmen stark. Beachte z. B. die deutlich schlechtere US‑Pop‑Platzierung gegenüber Kanada. Merke dir das.
Challenge: Wenn du selbst Musik analysieren willst, schau dir das Million Song Dataset an – mit über 50 Merkmalen (Tempo, Lautstärke, Danceability etc.) für fast 50.000 Artists. Musikalische Features plus Lyrics ergeben eine sehr umfassende Analyse.
Für eine einfache Auswertung der häufigsten Wörter im Gesamtkorpus nutzt du count() und top_n(), um die n Top-Wörter aus dem bereinigten Datensatz zu holen. Mit reorder() sortierst du nach Häufigkeit und weist das neu geordnete Ergebnis per mutate() wieder word zu, damit ggplot() schön darstellt.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Song Count") +
    ggtitle("Most Frequently Used Words in Prince Lyrics") +
    coord_flip()
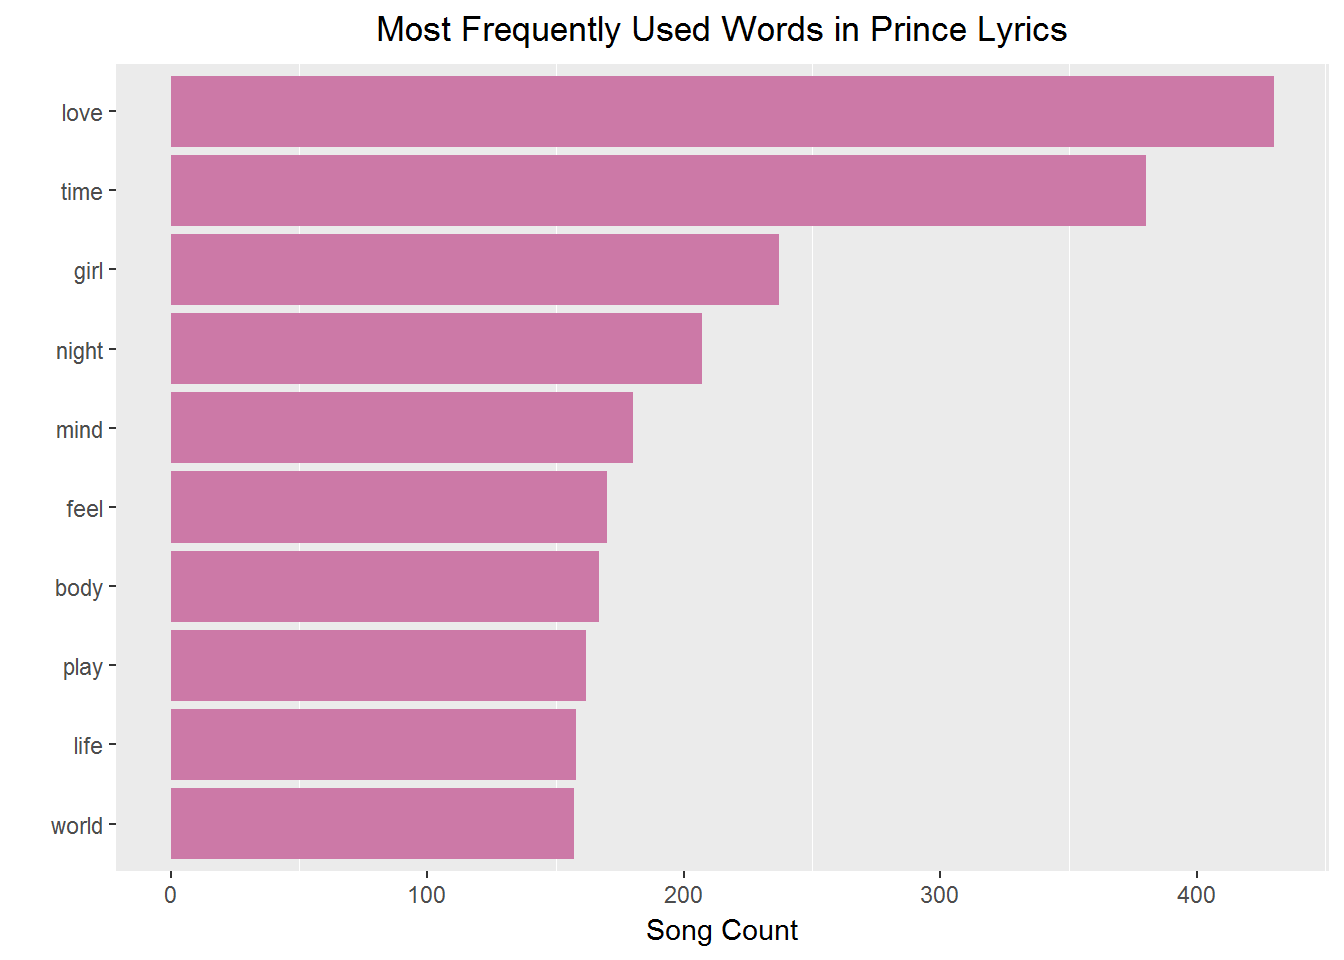
Wie in vieler Popmusik dominiert Liebe als Thema. Aus diesen Top-Wörtern allein würde ich wenig ableiten – sie geben einen Eindruck, aber kein Gesamtbild. Vor der Vertiefung gibt’s etwas visuelles Vergnügen.
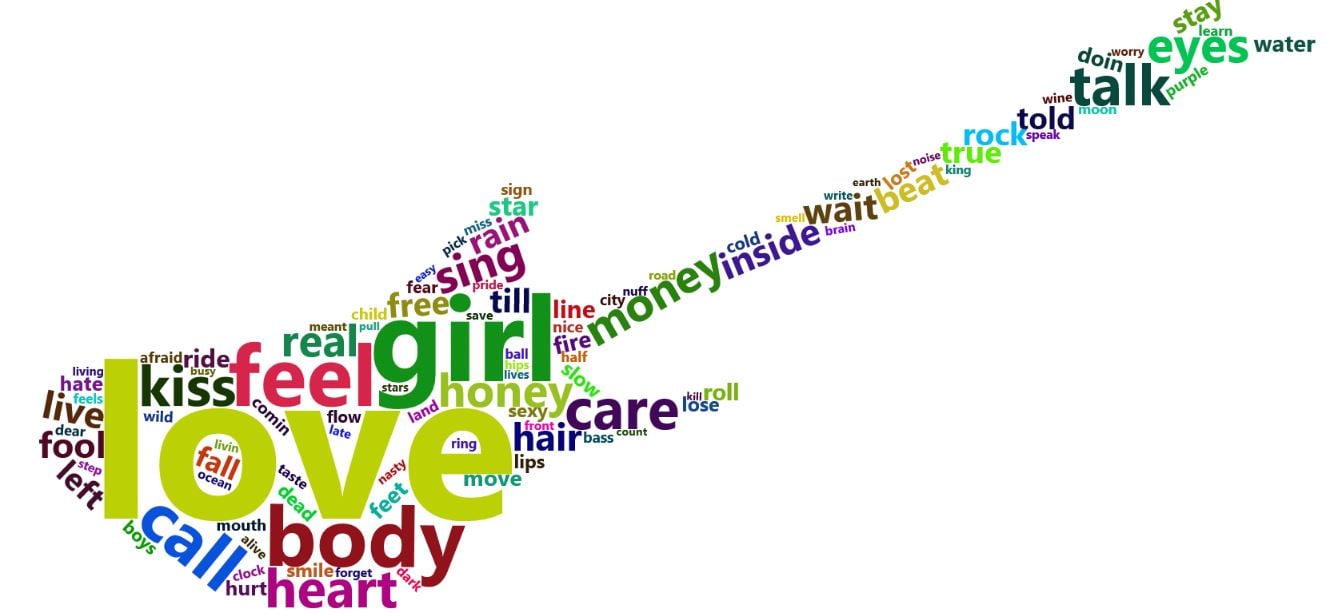
Word Clouds haben einen zweifelhaften Ruf und können fehlinterpretiert werden. Richtig eingesetzt liefern sie aber mitunter echte Insights. Beispiele von Sandy McKee findest du hier. Also mit Maß genießen.
Schau dir das Paket wordcloud2 an – für kreative HTML-Widgets. Du kannst über Wörter hovern und ihre Häufigkeit sehen. (In rMarkdown teils langsam und browserempfindlich – Verbesserungen sind zu hoffen.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
Und noch etwas Datenkunst …
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
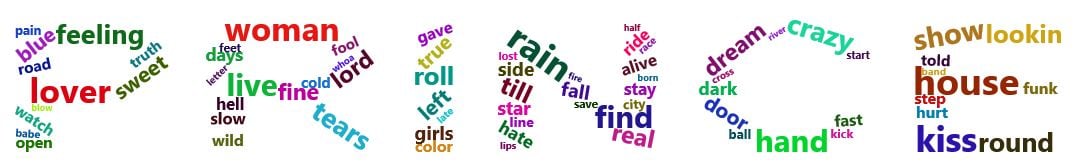
Bisher hast du Top-Wörter über alle Songs betrachtet. Was passiert nach Chart-Level getrennt? Sind bestimmte Wörter in gecharteten Songs häufiger als in ungecharteten? Das wären gesellschaftlich „beliebte“ Wörter.
Beachte im Code unten den Einsatz von slice(seq_len(n)), um die ersten n Wörter je chart_level zu greifen. Das funktioniert anders als top_n() und eignet sich gut für Facetting. Mit row_number() stellst du die richtige Reihenfolge der Wörter auf der Achse sicher. Sortiere vor dem Plotten – ggplot() sortiert sonst alphabetisch.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Popular Words by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
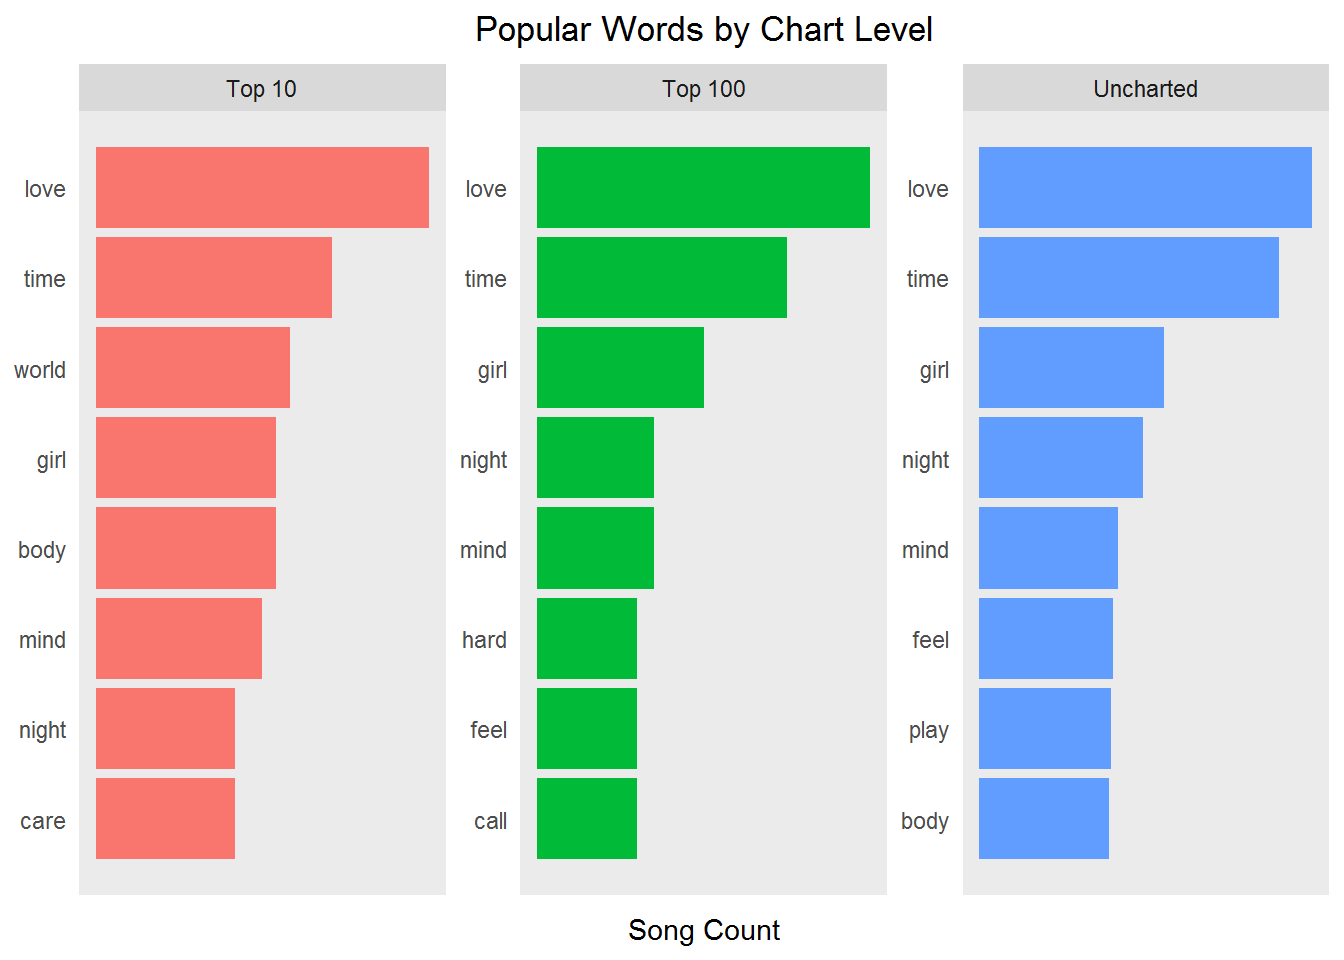
Welche Erkenntnisse ziehst du?
Die Top-Wörter sind über die Chart-Level hinweg sehr ähnlich. Das dämpft die Hoffnung, den Erfolg allein aus Texten vorherzusagen. Aber wir kratzen erst an der Oberfläche – mit NLP und prädiktivem Modellieren geht noch mehr.
Manche Wörter sind „zeitlos“ – sie funktionieren über Jahrzehnte und sprechen viele an. Brich die Analyse nach Jahrzehnten auf, um solche Wörter zu identifizieren. Filtere, gruppiere und aggregiere die Top-Wörter je Dekade und nutze ggplot() mit facet_wrap().
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Timeless Words") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
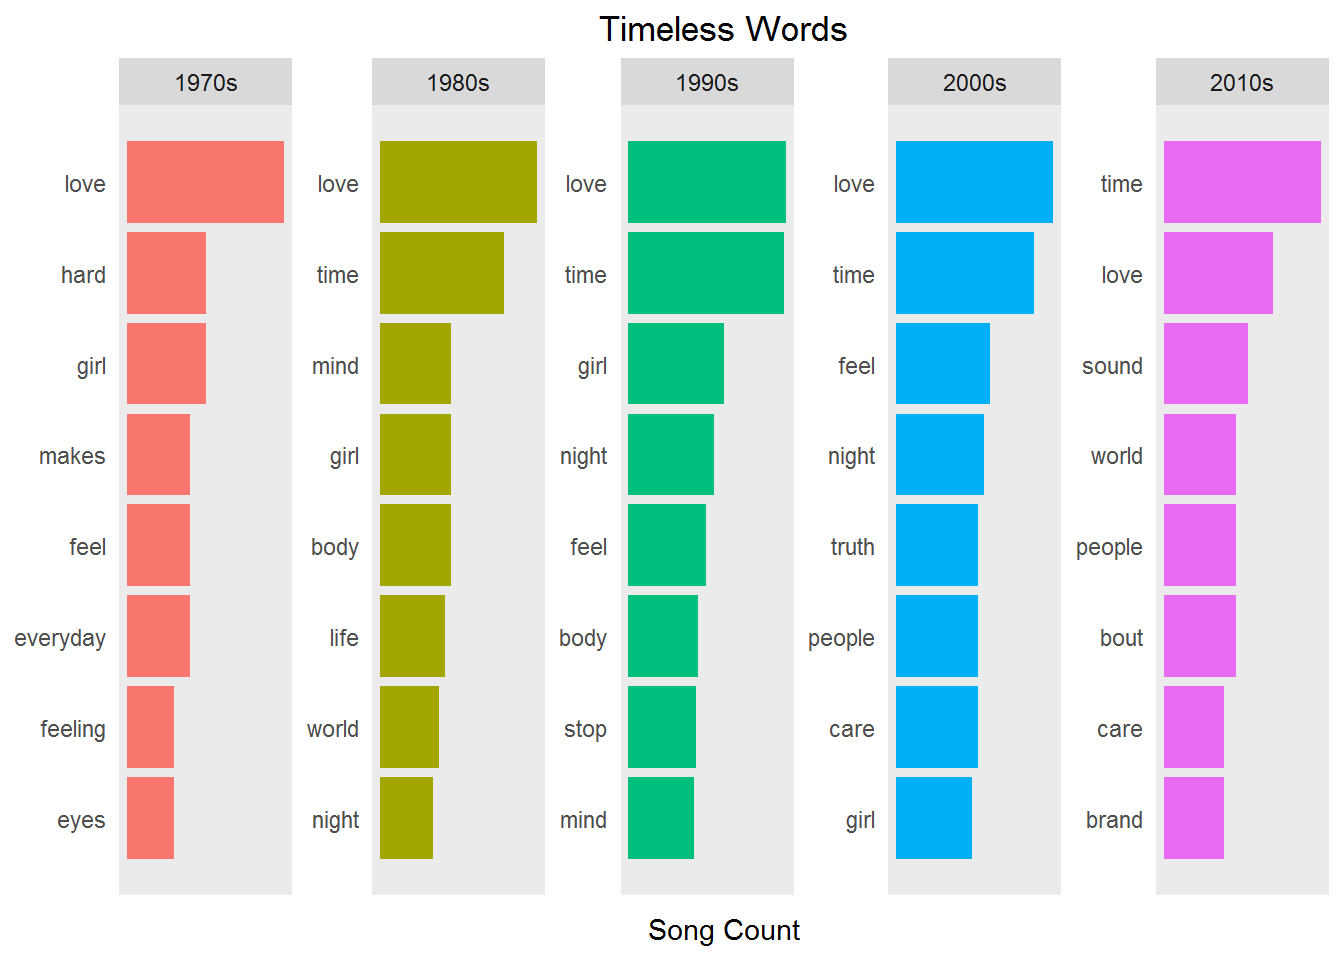
Klar erkennbar: love, time und girl sind zeitlos. Aber wie leicht sind Trendwörter zu erkennen? War truth um die Jahrtausendwende im Trend? Oder ist es einfach ein stark wiederholtes Wort in bestimmten Songs? Zeigt Frequenz wirklich Themen? Funktioniert das bei Lyrics wie bei anderen Texten, etwa „State of the Union“-Reden?
Wortlänge ist für Songwriter spannend. Je länger das Wort, desto schwieriger Reime und Metrik. Das Histogramm unten entspricht der Erwartung – mit wenigen extrem langen Ausreißern.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Word Length") +
    ylab("Word Count") +
    ggtitle("Word Length Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
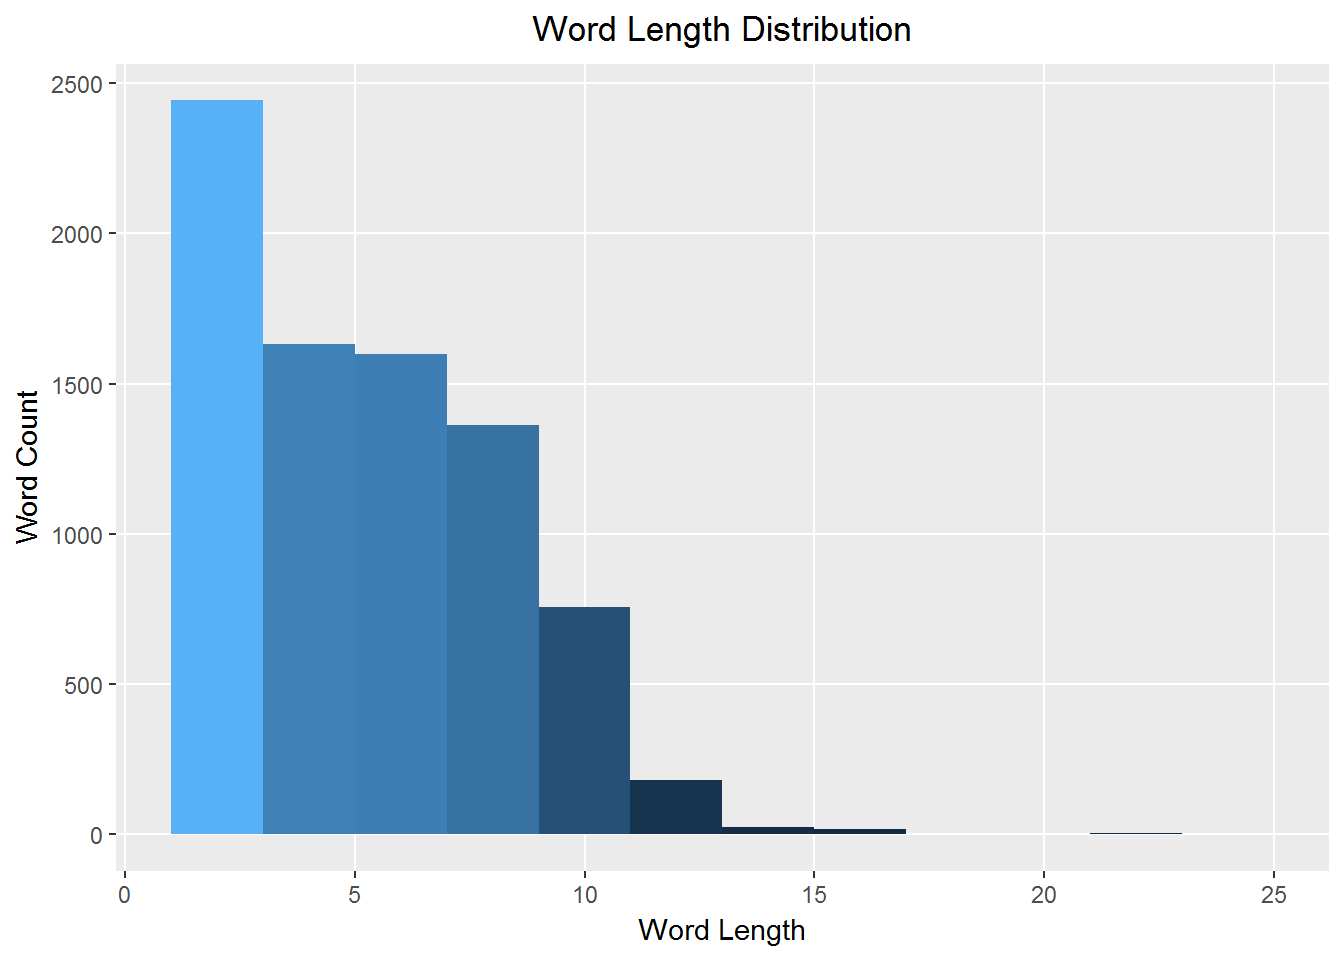
Was sind diese extrem langen Wörter? Zeit für eine unterhaltsame Word Cloud – diesmal basierend auf Wortlänge statt Frequenz:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Je vielfältiger das Vokabular, desto höher die lexikalische Diversität. Der „Song-Wortschatz“ lässt sich als durchschnittliche Zahl einzigartiger Wörter pro Song über die Jahre zeigen. Tokenisiere dafür erneut, diesmal inklusive Stop- und Kurz-Wörtern – hier geht es um quantitative Einblicke.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexical Diversity") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
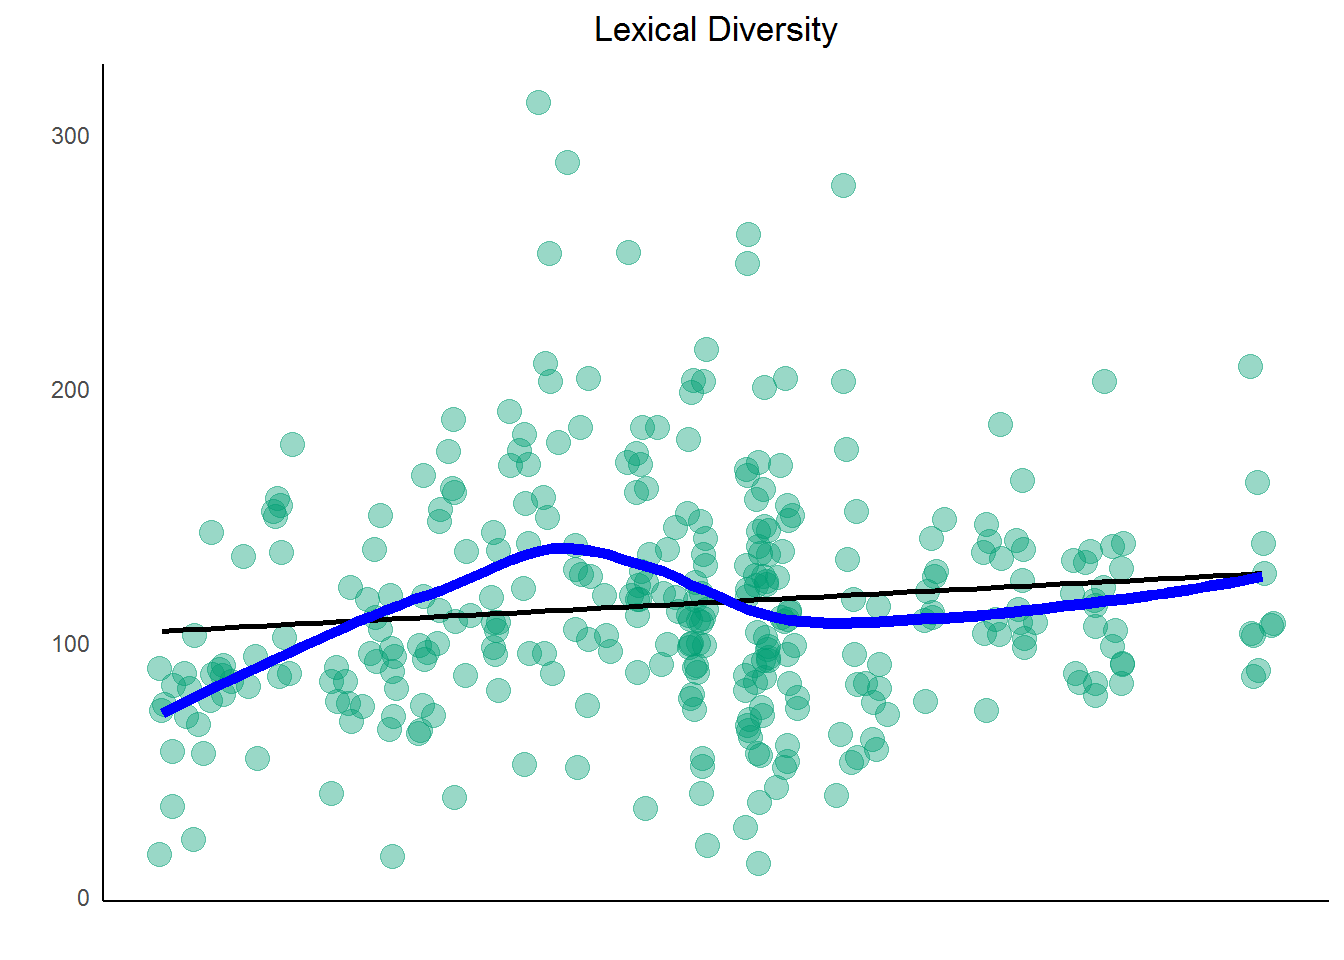
Interpretation: Über die Jahrzehnte zeigt sich ein leichter Anstieg der Diversität in Princes Texten. Korreliert das mit Chart-Erfolg? Schwer zu sagen. Vergleiche ergänzend Dichte und Chart-Historie.
Hier definiert als einzigartige Wörter geteilt durch Gesamtwörter. Das weist auf Wiederholungen hin – ein zentrales Songwriting-Werkzeug. Steigt die Dichte, sinkt Wiederholung. (Das sagt nichts über sequentielle Wiederholung aus – ein weiterer Trick.)
Betrachte die Dichte über die Jahre. Dafür lässt du alle Wörter drin, inkl. Stopwörter. Starte mit dem Originaldatensatz, unnest Tokens, gruppiere nach Song und Jahr und berechne mit n_distinct() und n() die Dichte. Visualisiere mit geom_smooth() und zusätzlichem stat_smooth(method="lm").
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexical Density") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
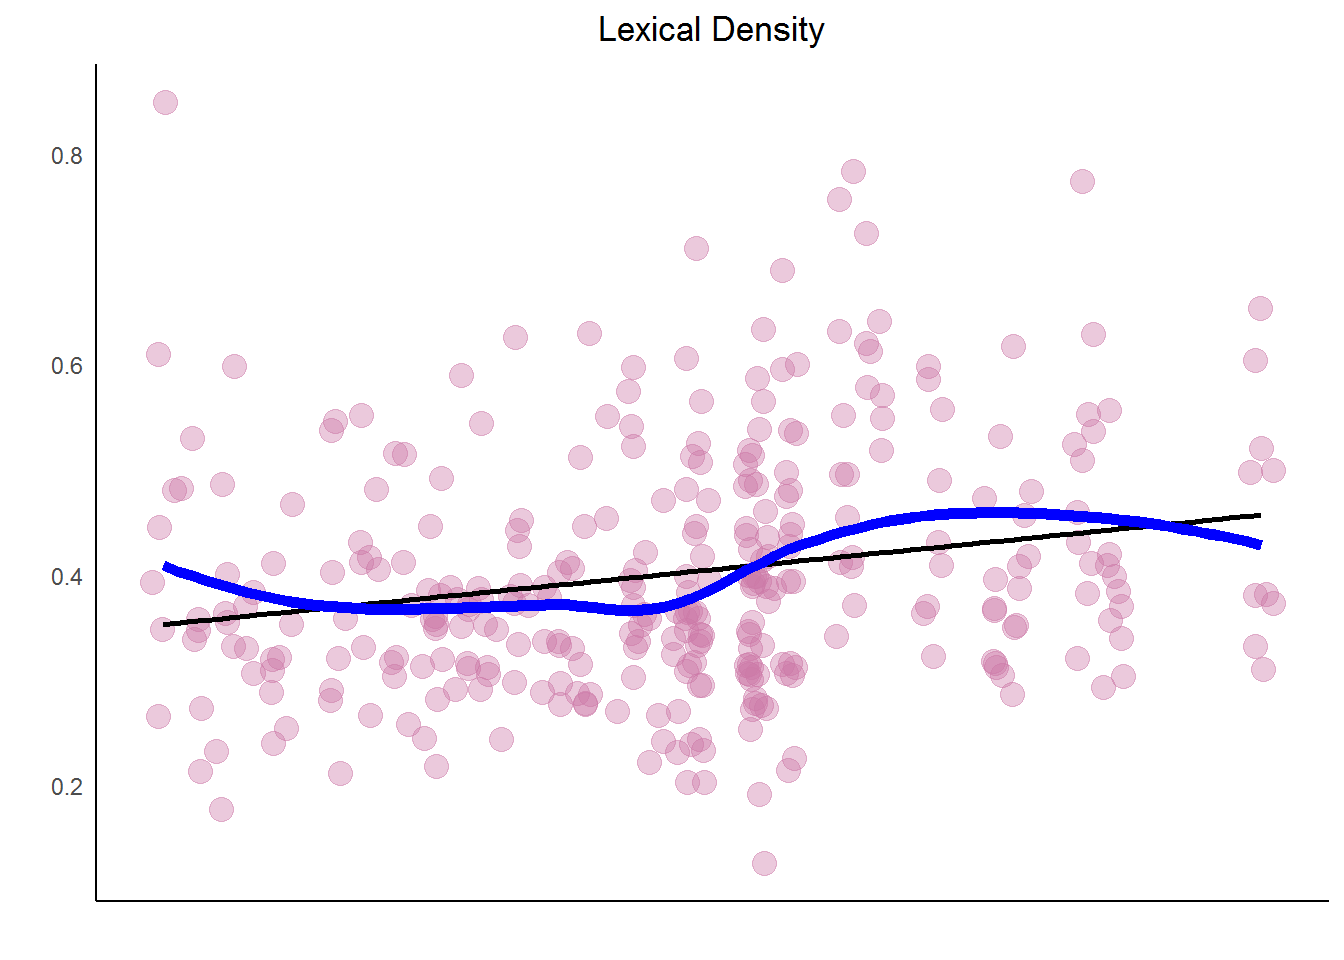
Zum Vergleich erstellst du einen Plot der Chart-Historie (Songs, die die Charts erreichten) und stellst alle drei nebeneinander mit grid.arrange().
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Chart History") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
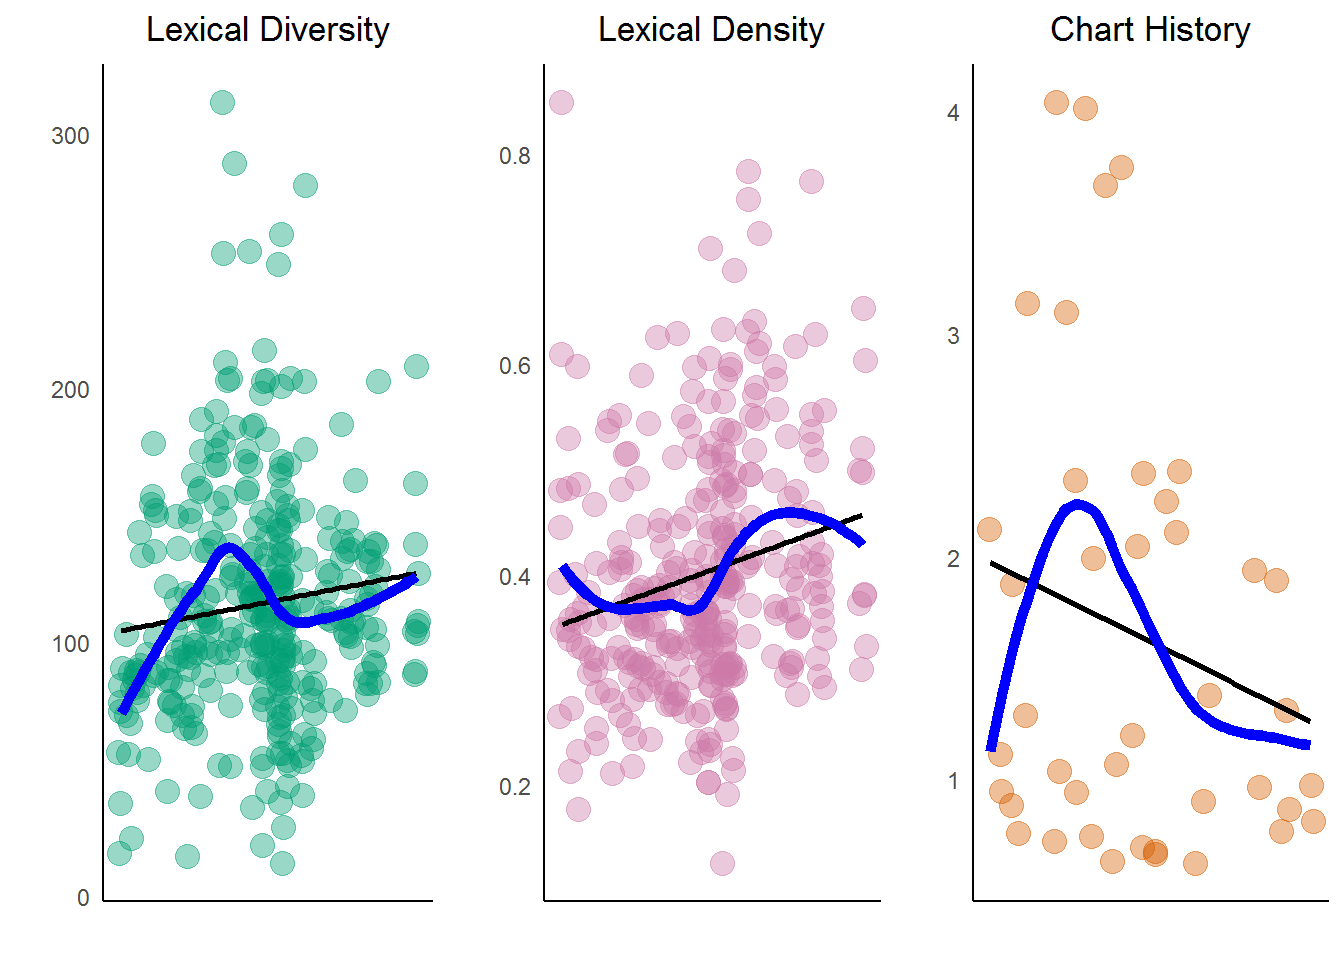
Wir sehen einen leichten Anstieg von Diversität und Dichte in Princes Texten. Wie passt das zum Gesamtbild populärer Musik? Eine Studie zeigt sinkende lexikalische Dichte in Hits, also mehr Wiederholung („mehr Worte, die weniger sagen“). Das traf auf Prince nicht zu. Eine andere Studie zeigt steigende Diversität über die Zeit – das passt wiederum. Möglicherweise hängt das mit größerer Genrevielfalt in den Charts zusammen. Genre fehlt in diesem Datensatz. Könnte seine Pop-Chart-Historie sinken, während R&B/Rap steigt?
Challenge: Denk über diese Ergebnisse nach und such dir andere Datensätze, um die Methoden anzuwenden. Und denk dran: Korrelation ist nicht Kausalität.
Bisher hast du den Gesamtdatensatz betrachtet, aber noch nicht quantifiziert, wie wichtig ein Begriff in einem Dokument relativ zur Gesamtsammlung ist. Du hast Termfrequenzen betrachtet und Stopwörter entfernt – das ist nicht immer der beste Ansatz.
Stichwort TF-IDF. TF ist „Term Frequency“. IDF ist „Inverse Document Frequency“: Häufige Wörter bekommen geringeres Gewicht, seltene höheres. Kombiniert passt TF-IDF die Wichtigkeit eines Terms an dessen Seltenheit an. Annahme: Häufige Terme in einem Dokument sind wichtiger – außer sie kommen in vielen Dokumenten vor. Kurzformeln:
IDF ist also höher für Wörter, die in weniger Dokumenten der Sammlung vorkommen. Mit bind_tf_idf() aus tidytext kannst du die wichtigsten Wörter pro chart_level untersuchen. Die Funktion berechnet TF, IDF und ihr Produkt und bindet die Spalten an das Tidy-Text-Format (ein Token pro Zeile und Dokument = Song).
Nimm also das prince-Data-Frame, unnest Tokens, entferne unerwünschte Wörter, lasse Stopwörter drin, und rufe dann bind_tf_idf() auf.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Du siehst: IDF und TF‑IDF sind 0 für extrem häufige Wörter. Leite die Ergebnisse in arrange() und sortiere nach tf-idf absteigend. Mit ein paar weiteren Schritten bekommst du eine neue Sicht auf wichtige Wörter in Princes Texten.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %> %
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
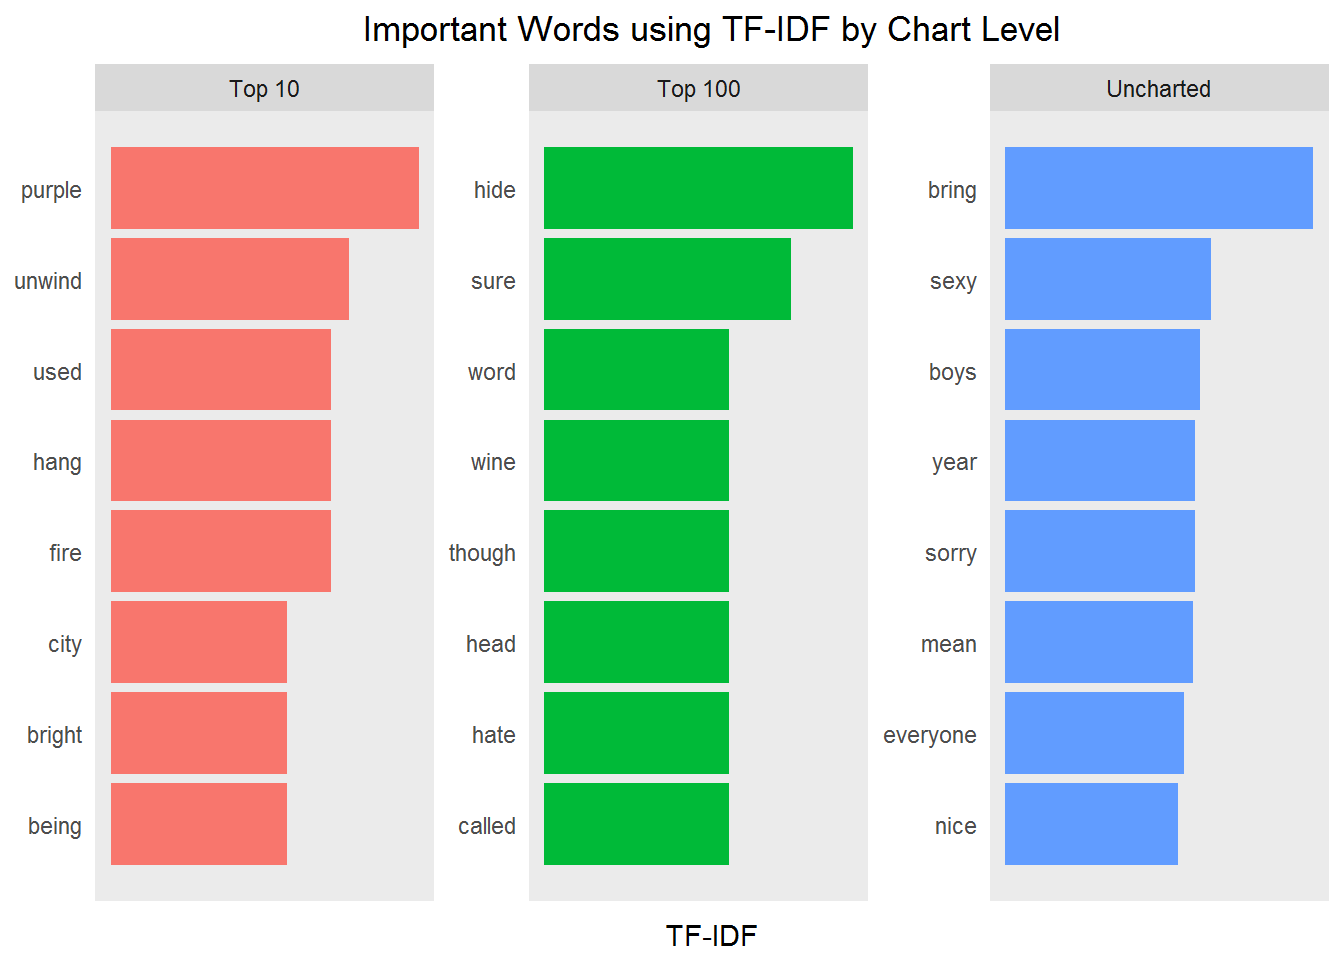
Wow – TF-IDF liefert eine ganz andere Perspektive auf potenziell wichtige Wörter. Die Interpretation bleibt subjektiv. Fallen dir Muster auf?
Als Nächstes betrachtest du TF-IDF über die Zeit:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Decade") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
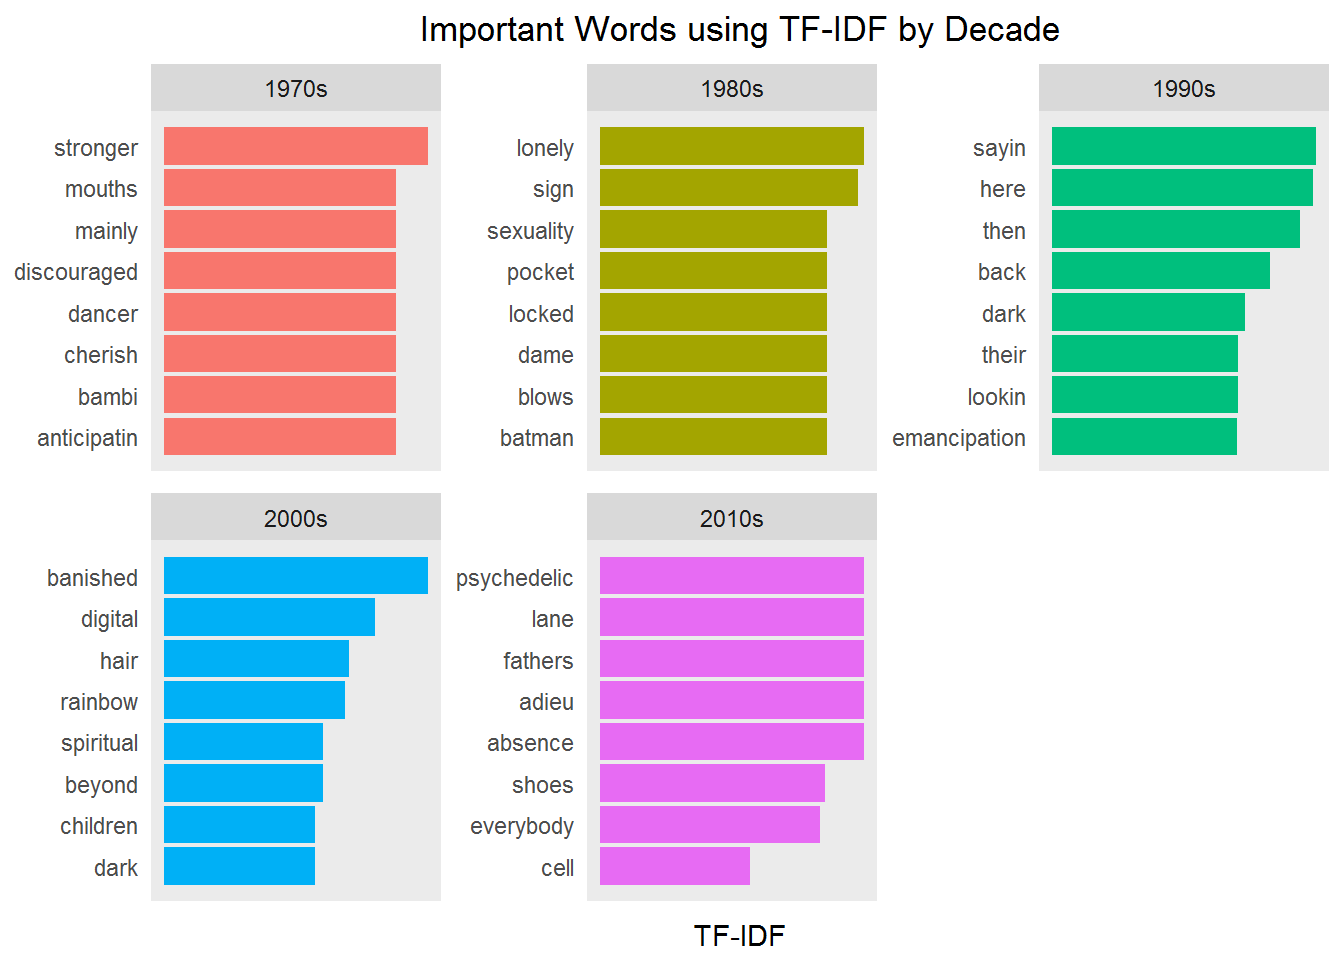
Jetzt entstehen deutlich tiefere Einblicke. Zeitlose Wörter verschwinden aus dem Fokus. Erkennst du Themen? Reicht eine Handvoll Wörter pro Gruppe? In Teil zwei (Sentimentanalyse und Topic Modeling mit NLP) gehst du das umfassender an.
Eine schnelle Word Cloud mit diesem Ansatz zeigt eine neue Perspektive auf wichtige Wörter in Princes Lyrics – visuell spannender …
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
In dieser Fallstudie hast du zunächst einen Blick auf die Rohdaten geworfen. Nach dem Cleaning und dem Entfernen wenig informativer Wörter hast du eine explorative Analyse auf Songebene gestartet.
Anschließend bist du tiefer ins Text Mining eingestiegen, hast Lyrics in Tokens zerlegt und die lyrische Komplexität betrachtet. Die Ergebnisse liefern wichtige Impulse für Sentimentanalyse und Topic Modeling.
Zum Schluss hast du TF-IDF genutzt, um die Informationskraft eines Wortes im Dokument in Bezug auf ein Ergebnis von Interesse zu quantifizieren. Das wirkt geeignet, um Themen in Musik zu identifizieren – erzählt aber nur die halbe Geschichte. Teil zwei behandelt das unüberwachte Verfahren Latent Dirichlet Allocation (LDA). Wie überall in der Data Science gibt es viele Wege zu Einsichten. In Teil zwei und drei lernst du weitere Optionen kennen.
Ich hoffe, du hast genauso Lust wie ich, von der Exploration zur Sentimentanalyse, zum Topic Modeling und zu prädiktiven Insights weiterzugehen.
Danke fürs Lesen – bis zum nächsten Tutorial!
Mehr über R und Machine Learning lernen
Kurs
Kurs
Kurs
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Mark Pedigo
10 Min.




