Curso
Machine Learning com caret em R
4 h
60.8K
Este é o primeiro de uma série de três tutoriais em que você vai usar R para realizar várias tarefas analíticas em um estudo de caso com letras do lendário artista Prince. Os três tutoriais abordam:
Letras podem representar a perspectiva de um artista, mas hits populares revelam o que a sociedade quer ouvir. Analisar letras não é tarefa simples. Como sua estrutura costuma ser bem diferente da prosa, é preciso cuidado com suposições e uma escolha criteriosa de técnicas analíticas. As letras permeiam nossa vida e influenciam nosso pensamento de forma sutil e onipresente. A ideia de "letras preditivas" vem ganhando força e aparece com frequência crescente em artigos acadêmicos e teses. Este estudo de caso toca em alguns aspectos desse tema emergente.
Para celebrar a obra inspiradora e diversa que Prince deixou, você vai explorar as mensagens por vezes explícitas, mas muitas vezes escondidas, em suas letras. E não é preciso gostar da música de Prince para reconhecer sua influência na evolução de vários gêneros pelo mundo. A revista Rolling Stone listou Prince como o 18º maior compositor de todos os tempos, logo atrás de nomes como Bob Dylan, John Lennon, Paul Simon, Joni Mitchell e Stevie Wonder. A análise de letras está, aos poucos, ganhando espaço nas comunidades de data science à medida que a possibilidade de prever "hit songs" se aproxima da realidade.
Prince era um homem transbordando música — um compositor incrivelmente prolífico, virtuose na guitarra, nos teclados e na bateria, e um mestre arquiteto do funk, rock, R&B e pop, mesmo quando sua música desafiava gêneros. - Jon Pareles (NY Times)
Neste tutorial, a Parte 1 da série, você vai aplicar técnicas de mineração de texto em um conjunto de letras usando o framework tidy text. Datasets tidy têm uma estrutura específica: cada variável em uma coluna, cada observação em uma linha e cada tipo de unidade observacional em uma tabela. Depois de limpar e preparar o dataset, você vai criar estatísticas descritivas e visualizações exploratórias, observando diferentes aspectos das letras de Prince.
A Parte 1 desta série exige noções básicas de dados "tidy" — especificamente pacotes como dplyr para transformação de dados, ggplot2 para visualizações e o operador %>% pipe originalmente do pacote magrittr. Cada tutorial descreve as ferramentas que você pode usar na análise, mas pode não detalhar cada passo. Você vai notar que vários passos costumam ser encadeados com o operador %>%. Como este também é um estudo de caso, é importante lembrar que todas as inferências são puramente observacionais; logo, correlação não implica causalidade.
Dica: para conhecer melhor as ferramentas usadas, dois bons recursos são R for Data Science, de Garrett Grolemund e Hadley Wickham; e Text Mining with R, de Julia Silge e David Robinson.
Partes 2 e 3
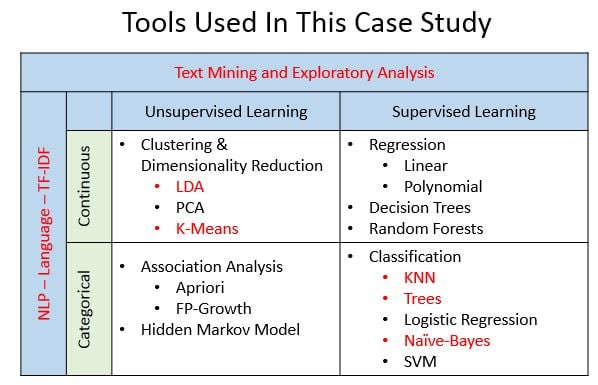
Em um tutorial separado, a Parte 2, você vai abordar sentiment analysis e topic modeling para capturar o clima geral e os temas na música de Prince e sua conexão com perspectivas sociais. Você vai trabalhar com um léxico de sentimentos, avaliar sentimentos binários e categóricos, plotar tendências ao longo do tempo e explorar n-grams e associações entre palavras. Também vai usar Processamento de Linguagem Natural (NLP) e técnicas de clusterização como Latent Dirichlet Allocation (LDA) e K-Means para revelar motivos nas letras.
Em outro tutorial, a Parte 3, você vai fechar o ciclo usando os resultados exploratórios para ajudar a prever em que década uma música foi lançada e, mais interessante, se uma faixa vai entrar nas paradas da Billboard com base apenas nas suas letras. Você usará ferramentas de machine learning como árvores de decisão (rpart e C50), K-Nearest Neighbors (class) e Naive Bayes (e1071) para produzir um classificador que aceita texto.
As três partes utilizam o mesmo dataset com letras de Prince, ano de lançamento e posições nas paradas da Billboard. As técnicas deste estudo podem ser aplicadas a muitos outros tipos de texto. Aliás, resultados com prosa padrão costumam ser mais fáceis de interpretar, já que letras, em geral, são desenhadas com mensagens indiretas e nuances sutis.
Em resumo, há muitos métodos para analisar letras. Estes tutoriais cobrem os destacados em vermelho no gráfico abaixo. Note que o gráfico é apenas uma representação de alto nível de um quadro bem "nebuloso". E não, não estou falando da imagem em si! A verdade é que diferentes aspectos de modelagem e técnicas de machine learning hoje se misturam e nem sempre cabem em uma única caixinha como ali. Então coloque um óculos 3D ao olhar a imagem — pode fazer mais sentido!
Além de aprender e praticar novas habilidades, este tutorial busca responder perguntas básicas sobre o conceito de análise de letras. Estudos recentes indicam que a "inteligência lírica" pode estar caindo na música popular. Alguns trabalhos sugerem até que as palavras usadas em músicas nº 1 se alinham a níveis de leitura do 3º ano do ensino fundamental nos EUA. Dá para usar mineração de texto, NLP, machine learning e outros métodos de data science para jogar luz nesse tema? Dá para identificar temas que agradam à sociedade com base no desempenho de uma música? É possível prever o sucesso só pela análise das letras? Neste primeiro tutorial, você vai examinar a complexidade lexical nas músicas de Prince como um exercício exploratório.
Antes de começar, pense no que você quer descobrir. Que perguntas interessam? Primeiro, você vai percorrer uma análise do dataset. Como ele é? Quantas músicas há? Como as letras estão estruturadas? Quanto de limpeza e preparação é necessário? Quais são os fatos? Quais as frequências de palavras e por que isso importa? Do ponto de vista técnico, você quer entender e preparar os dados para sentiment analysis, NLP e modelos de machine learning.
A música há muito tempo é um meio eficaz de comunicação em massa, e as letras desempenham um papel enorme nessa mensagem. Ainda assim, a oportunidade de pesquisa sobre o papel das letras no bem-estar [da sociedade] é vastamente subutilizada. - Patricia Fox Ransom
Uma forma popular de obter dados para mineração de texto é usar o pacote rvest para fazer scraping de conteúdo da web. Consegui extrair informações das paradas da Billboard e letras de Prince em vários sites e juntei tudo pelo título da música. Foi preciso um pouco de "wrangling" por conta das convenções de nomenclatura inconsistentes. Decidi, de forma subjetiva, remover todas as faixas que não eram versões originais — remixes, versões estendidas, club mixes, regravações etc. Também removi álbuns com coletâneas históricas de hits para evitar repetição. Fiz uma limpeza leve e salvei o resultado em um arquivo csv para uso neste tutorial.
Como a Parte 1 foca em mineração de texto, não incluí esse código aqui, mas o dataset está disponível para download neste link caso você queira acompanhar.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Há várias formas de ler dados de um arquivo csv, mas optei por usar read.csv() para carregar um data frame com letras, ano de lançamento e posições nas paradas da Billboard. Por padrão, o R converte strings em fatores. Isso pode causar problemas adiante, então ajuste o parâmetro stringsAsFactors para FALSE. Agora vamos inspecionar os dados…
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Você pode usar a função names() para ver as colunas do data frame:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Como eu criei este arquivo, sei que X é só o número da linha e text são as letras. Os outros campos necessários incluem song, year e peak (posição nas paradas da Billboard). US.Pop e US.R.B são as posições de pico nos EUA (paradas Pop e R&B), então mantenha-as também e descarte os demais campos por enquanto.
Faça isso pegando o dataset original, prince_orig, e encadeando em select() usando %>%. Assim você lê o código da esquerda para a direita.
Perceba também que select() permite renomear colunas no mesmo passo. Ajuste text para lyrics e renomeie as colunas dos EUA no estilo tidyverse usando "_" em vez de ".". Em seguida, armazene o resultado em prince, que será usado ao longo dos tutoriais. O dplyr oferece a função glimpse() para visualizar os dados em uma visão transposta.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
A primeira pergunta óbvia: quantas observações e colunas existem?
dim(prince)
[1] 824 7
Usando dim(), vemos que há 7 colunas e 824 observações. Cada observação é uma música. Como eu disse… prolífico!
Olhando a coluna de letras de uma das músicas, dá para ver como estão estruturadas.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Há várias oportunidades de limpeza — vamos nessa.
Há diferentes formas de preparar os dados. Uma opção seria converter o data frame em um Corpus e em uma Document Term Matrix usando o pacote de text mining tm e então aplicar tm_map() para a limpeza, mas este tutorial vai ficar no básico por enquanto, usando gsub() e funções apply() para o trabalho pesado.
Primeiro, elimine contrações criando uma pequena função que cobre a maioria dos casos com gsub() e aplique-a às letras.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
Você também vai notar caracteres especiais que sujam o texto. Dá para removê-los com gsub() e uma expressão regular simples. É crucial expandir as contrações antes deste passo!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Para manter a consistência, converta tudo para minúsculas com a prática tolower().
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Agora, as letras exibem uma versão mais limpa do texto bruto original.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Outro passo comum na preparação para text mining é o stemming, que reduz palavras à sua raiz. Esse é um tópico à parte. Por ora, veja o summary do data frame prince.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
São 37 anos de músicas, e a faixa com pior posição (neste dataset) ficou em 88º. Também há muitos NAs para year e peak. Como você fará análises diferentes, mantenha o dataset completo em prince e apenas filtre quando necessário.
Como uma das perguntas é observar tendências ao longo do tempo, e o dataset traz anos individuais, você pode criar faixas e agrupar por décadas. Use mutate() do dplyr para criar o novo campo decade. Uma forma é usar ifelse() com o operador %in% para binar as músicas por década. Depois, salve de volta em prince (adicionando o novo campo).
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Faça o mesmo para chart_level, que indica se a música chegou ao Top 10, ao Top 100 ou não entrou nas paradas (uncharted). São categorias mutuamente exclusivas: Top 100 não inclui Top 10.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Além disso, crie um campo binário charted indicando se a faixa entrou ou não nas paradas da Billboard. Use write.csv() para salvar para uso posterior.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Para personalizar gráficos, gosto de definir uma paleta própria para manter a consistência visual. Há vários sites com paletas distintas em código hexadecimal, como abaixo. Se preferir, você pode criar seu próprio tema e aplicá-lo ao ggplot() quando necessário.
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Antes de entrar em mineração de texto, comece com uma visão básica do que os dados trazem no nível da música. É um bom momento para visualizar quantas músicas Prince lançou por década. Como lembrete, sua carreira profissional começou em 1978 e foi até 2015 (como visto no summary() acima). Mas, como estamos olhando tendências, e o dataset tem muitos anos em branco, filtre os NAs de year no primeiro gráfico.
Usando filter(), group_by() e summarise() do dplyr, agrupe por decade e conte o número de faixas. A função n() é uma das agregações úteis com summarise() em dados agrupados. Depois, com ggplot() e geom_bar(), crie um gráfico de barras preenchendo pela categoria charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Released Songs") +
  labs(x = NULL, y = "Song Count")
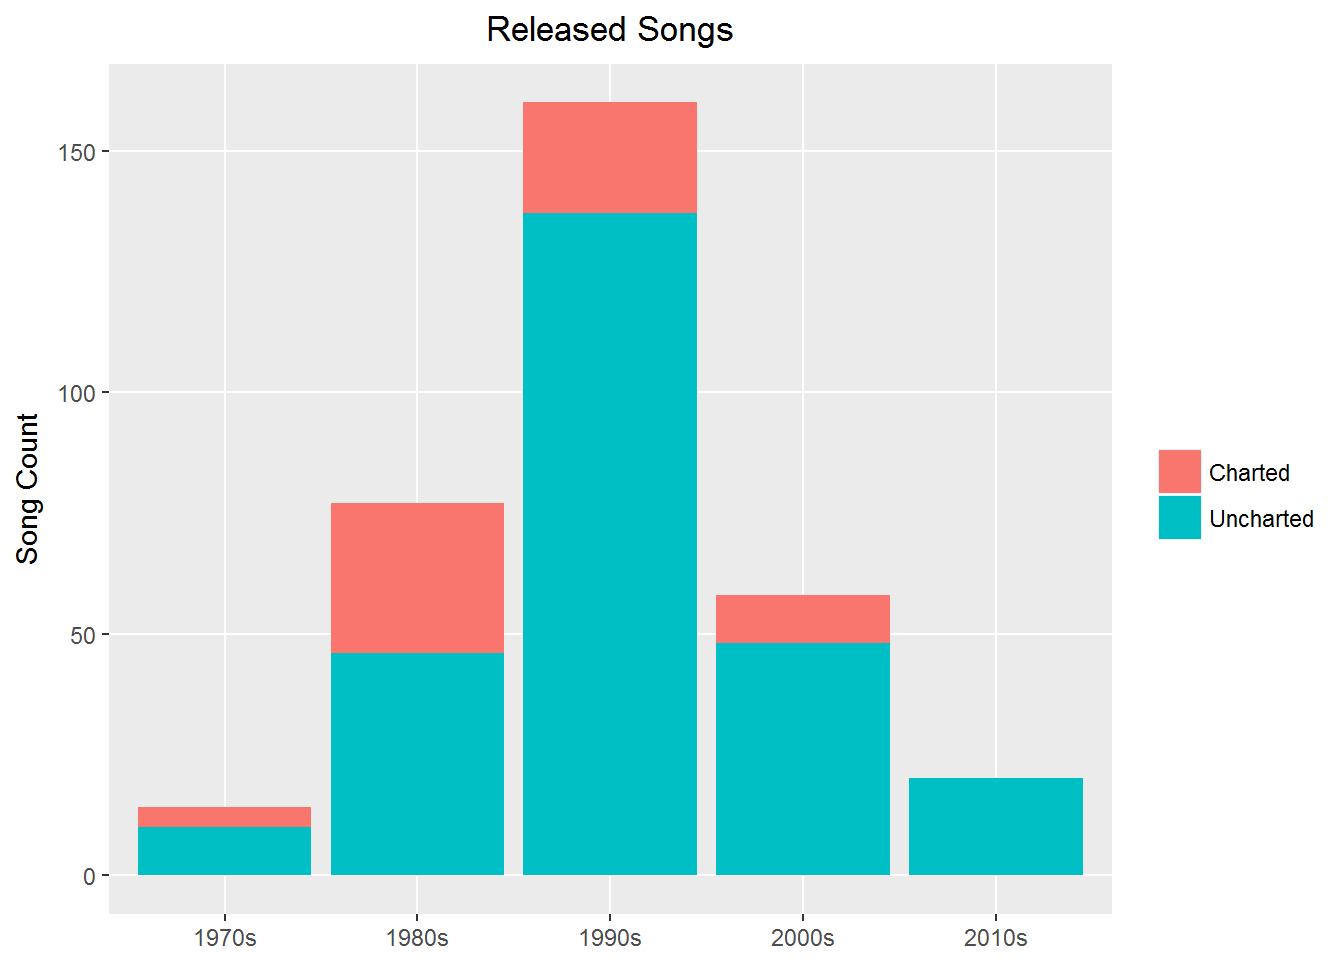
Fica claro que sua década mais ativa foi a de 1990.
Agora crie um gráfico semelhante com chart_level.
Lembre-se de usar group_by() com decade e chart_level para ver a tendência.
Neste gráfico, observe apenas as músicas que entraram nas paradas; então, filtre com peak > 0. Encadeie group_by em summarise() usando n() para contar. Armazene em uma variável e faça o pipe para ggplot() para o gráfico.
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("Charted Songs")
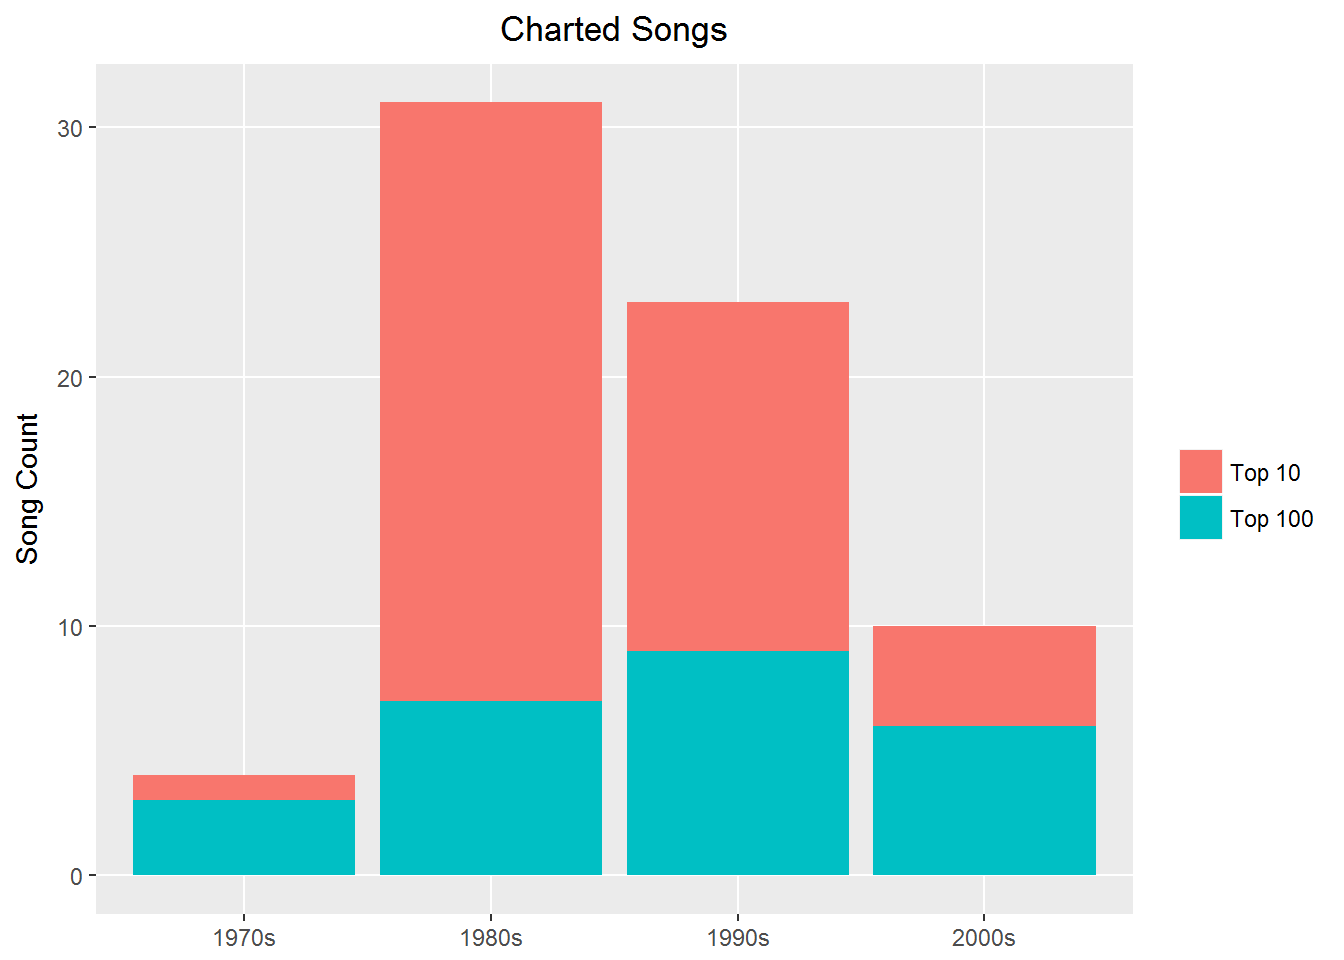
Note que, entre as músicas que entraram nas paradas, a maioria chegou ao Top 10. Mais interessante: sua década mais prolífica em novas faixas foi a de 1990, mas houve mais hits nas paradas nos anos 1980. Por quê? Guarde essa pergunta ao avançar para a seção de mineração de texto.
Para usar todo o poder do dataset completo na análise das letras, você pode ignorar referências a chart_level e ano de lançamento e ter um conjunto bem maior para minerar. Veja:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("All Songs in Data")
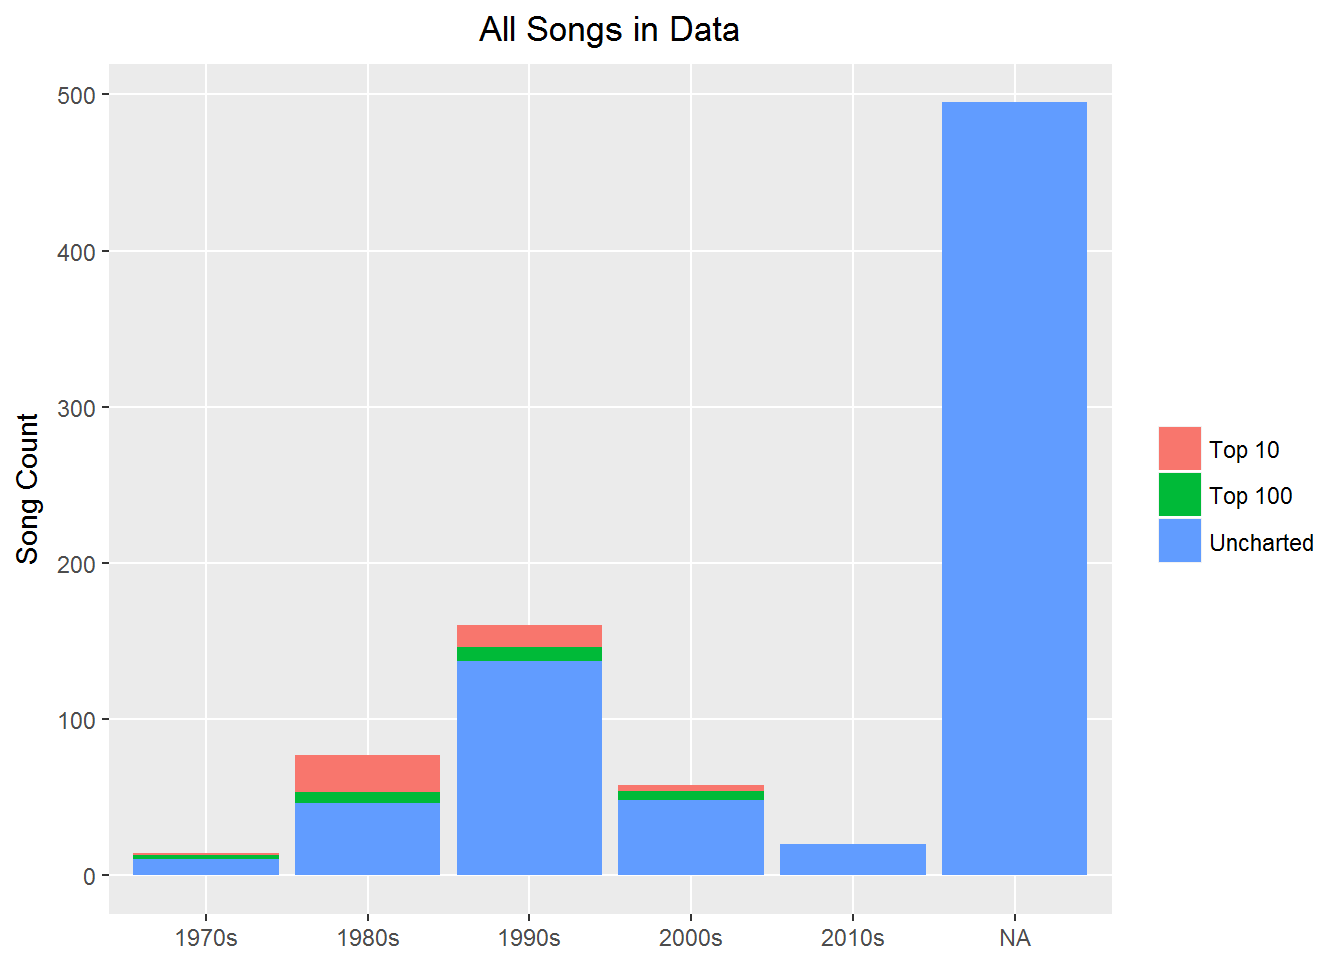
Como dá para ver, Prince escreveu centenas de músicas sem data de lançamento no dataset. Para sentiment analysis ou análise exploratória, você pode usar tudo; para tendências no tempo, o conjunto é menor. Tudo bem — apenas tenha isso em mente.
Para os fãs de Prince, abaixo vai um rápido panorama das faixas que chegaram ao nº 1 nas paradas. (Note que você pode usar kable() e kable_styling() dos pacotes knitr e kableExtra e color_tile() do formattable para gerar HTML bem formatado.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
Mineração de texto também pode ser vista como analytics de texto. O objetivo é descobrir informação relevante que talvez seja desconhecida ou esteja enterrada sob o óbvio. NLP (Processamento de Linguagem Natural) é uma metodologia usada na mineração de texto. Ela tenta decifrar ambiguidades da linguagem escrita com tokenização, clusterização, extração de entidades e relações entre palavras, além de algoritmos para identificar temas e quantificar informações subjetivas. Vamos começar decompondo o conceito de complexidade lexical.
Complexidade lexical pode significar coisas diferentes em contextos diferentes, mas, por enquanto, vamos descrevê-la como uma combinação destas medidas:
Para iniciar a análise, você precisa dividir as letras em palavras individuais e começar a minerar insights. Esse processo é a tokenização.
Lembre-se de que há diferentes métodos e formatos para minerar texto:
Mas antes de tokenizar, há mais um passo de limpeza. Muitas transcrições de letras incluem frases como "Repeat Chorus" ou rótulos como "Bridge" e "Verse". Há também várias palavras indesejáveis que podem atrapalhar os resultados. Após uma análise prévia, selecionei algumas para remover.
Abaixo está uma lista de palavras supérfluas para retirar manualmente:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Para "desempacotar" os tokens, use a biblioteca tidytext (já carregada). Agora você pode aproveitar o dplyr e encadear vários passos.
No framework tidy text, você precisa dividir o texto em tokens (tokenização) e transformá-lo em uma estrutura tidy. Para isso, use unnest_tokens() do tidytext. Ela requer pelo menos dois argumentos: o nome da coluna de saída ("word", aqui) e a coluna de entrada com o texto (lyrics).
Você pode pegar o dataset prince, fazer o pipe em unnest_tokens() e depois remover stop words. O que são stop words? Você as conhece bem: são palavras muito comuns que raramente agregam significado à análise. Há diferentes listas, mas usaremos o léxico stop_words do pacote tidytext.
Use sample() para mostrar uma lista aleatória dessas stop words e head() para limitar a 15 palavras.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Então, após tokenizar as letras em palavras, use anti_join() do dplyr para remover as stop words. Em seguida, elimine as palavras indesejáveis definidas acima com filter() e o operador %in%. Depois, use distinct() para eliminar duplicatas. Por fim, remova palavras com menos de quatro caracteres. É uma decisão subjetiva, mas em letras elas costumam ser interjeições como "yeah" e "hey". Salve o resultado em prince_words_filtered.
Observação: futuramente, prince_words_filtered é a versão tidy do data frame prince sem 1) stop words, 2) palavras indesejáveis e 3) palavras de 1 a 3 caracteres. Você vai usá-lo em algumas análises.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Note que stop_words tem uma coluna word, e unnest_tokens() criou a coluna word; logo, anti_join() associa automaticamente por word.
Agora verifique a classe e as dimensões da nova estrutura tidy:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered é um data frame com 36.916 palavras (não únicas) e 10 colunas. Aqui vai um recorte: (escolhi uma palavra e limitei sua aparição em 10 músicas, selecionei campos de interesse e formatei com knitr). Isso mostra a estrutura tidy tokenizada, sem sumarização.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Perceba que cada linha contém uma palavra individual repetida para cada música em que aparece.
Na música, frequências individuais importam muito, seja pela repetição, seja pela raridade. Ambas afetam a memorização da faixa. Uma pergunta que um compositor pode ter é se há correlação entre frequência de palavras e hits. Agora leve o formato tidy um passo além e obtenha uma contagem sumarizada de palavras por música.
Para examinar isso nas letras de Prince, crie um histograma mostrando a distribuição de contagens de palavras por música, agrupadas pelo desempenho nas paradas da Billboard. Desempacote as letras novamente sem filtrar palavras para uma contagem fiel. Use group_by() e summarise() para as contagens. Depois use arrange() para ordenar. Primeiro, veja as maiores contagens; depois, use ggplot() para o histograma.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Song Count") +
    xlab("Word Count per Song") +
    ggtitle("Word Count Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
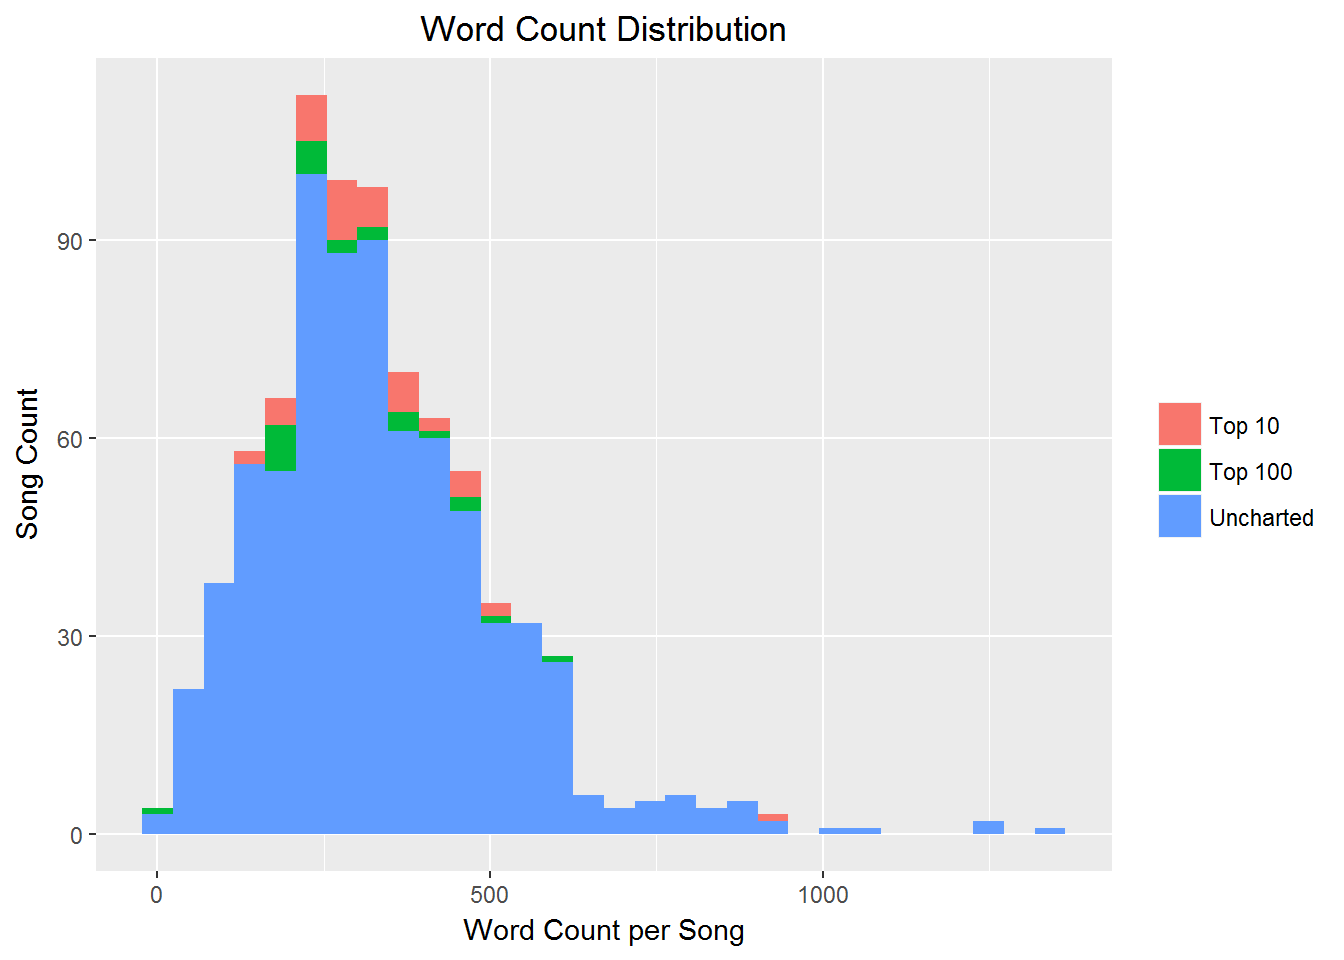
Note o viés à direita. Dada a natureza da transcrição das letras, fico cético sobre possíveis erros de digitação. Por curiosidade, veja a faixa do Top 10 com mais de 800 palavras.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Pesquisando, descobri que essa faixa tem um artista convidado com um trecho de rap. Isso explica bastante! Lembre-se: o dataset cobre paradas Pop e R&B globalmente; gênero e geografia afetam suposições. Note que o ranking no US Pop foi bem mais baixo que em outros lugares, chegando a 5 no Canadá, por exemplo. Fica a dica.
Desafio: se você quiser se aventurar em análise musical, confira o The Million Song Dataset, que traz mais de 50 features (tempo, loudness, danceability etc.) para quase 50.000 artistas! Somar features musicais às letras cria uma análise bem completa.
Para avaliar rapidamente as palavras mais frequentes no conjunto completo de letras, use count() e top_n() para obter as n palavras do seu dataset limpo e filtrado. Depois, use reorder() para ordenar as palavras pelo total e mutate() para reatribuir a ordem em word. Assim, o ggplot() exibe certinho.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Song Count") +
    ggtitle("Most Frequently Used Words in Prince Lyrics") +
    coord_flip()
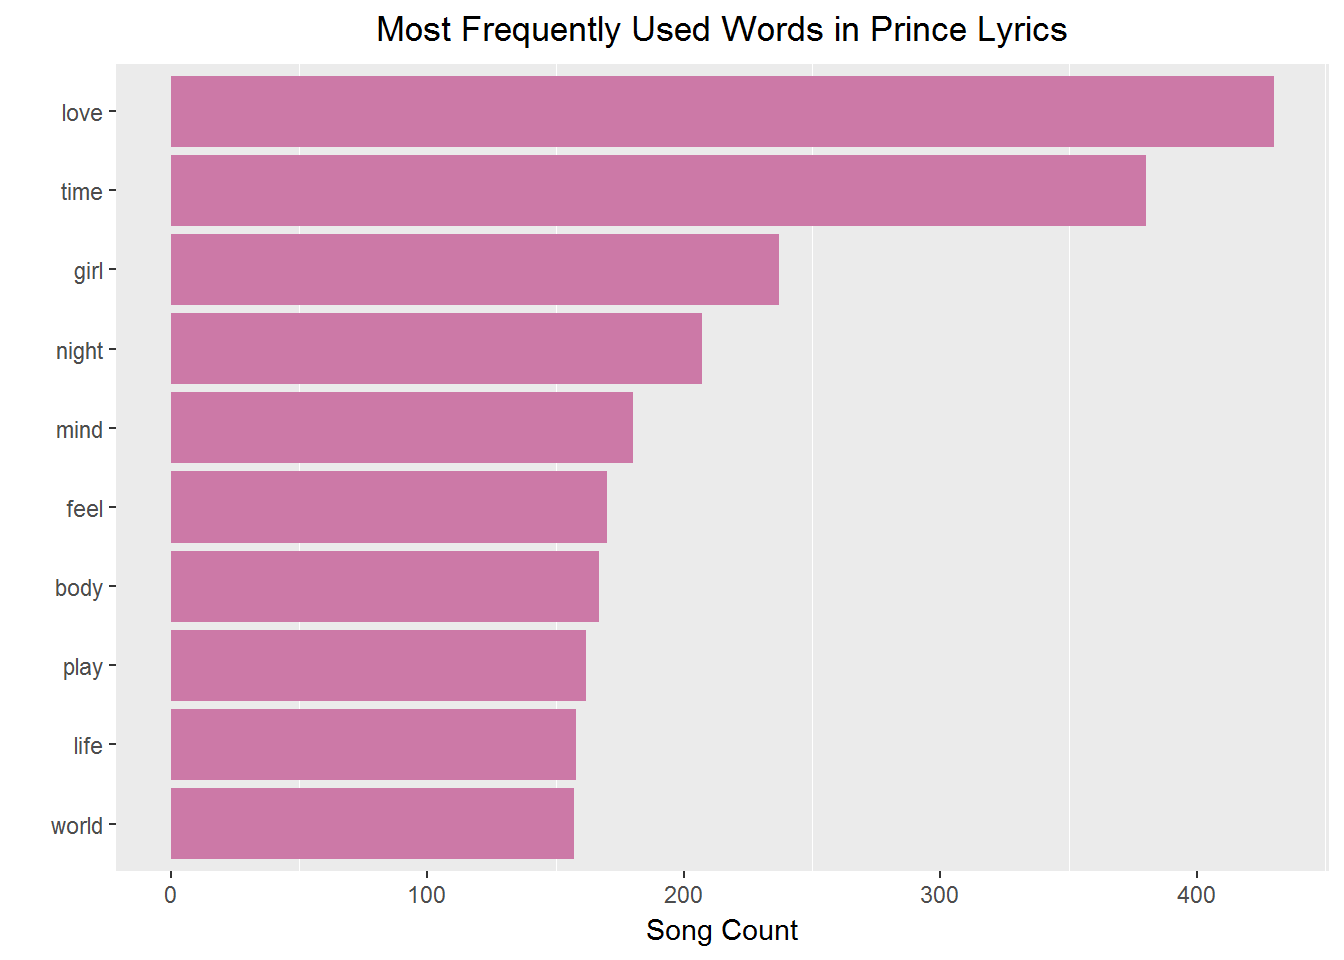
Como em boa parte da música popular, love aparece como tema comum. Eu não tiraria grandes conclusões só por essas palavras, mas dá para sentir um pouco da perspectiva do artista — não o quadro todo. Antes de ir mais fundo, vamos nos divertir visualmente.
Nuvens de palavras recebem críticas em muitos círculos e, se usadas sem cuidado, podem ser inadequadas. Mas somos seres muito visuais, e há casos em que trazem insight real. Veja exemplos de Sandy McKee aqui. Use com parcimônia.
Por enquanto, experimente o pacote wordcloud2 para alguns efeitos legais. Ele gera widgets HTML e você pode passar o mouse para ver a frequência da palavra. (Pode demorar no rMarkdown e ser exigente com navegador. Tomara que melhore.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
E para se divertir mais, dá para adicionar um pouco de data art…
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
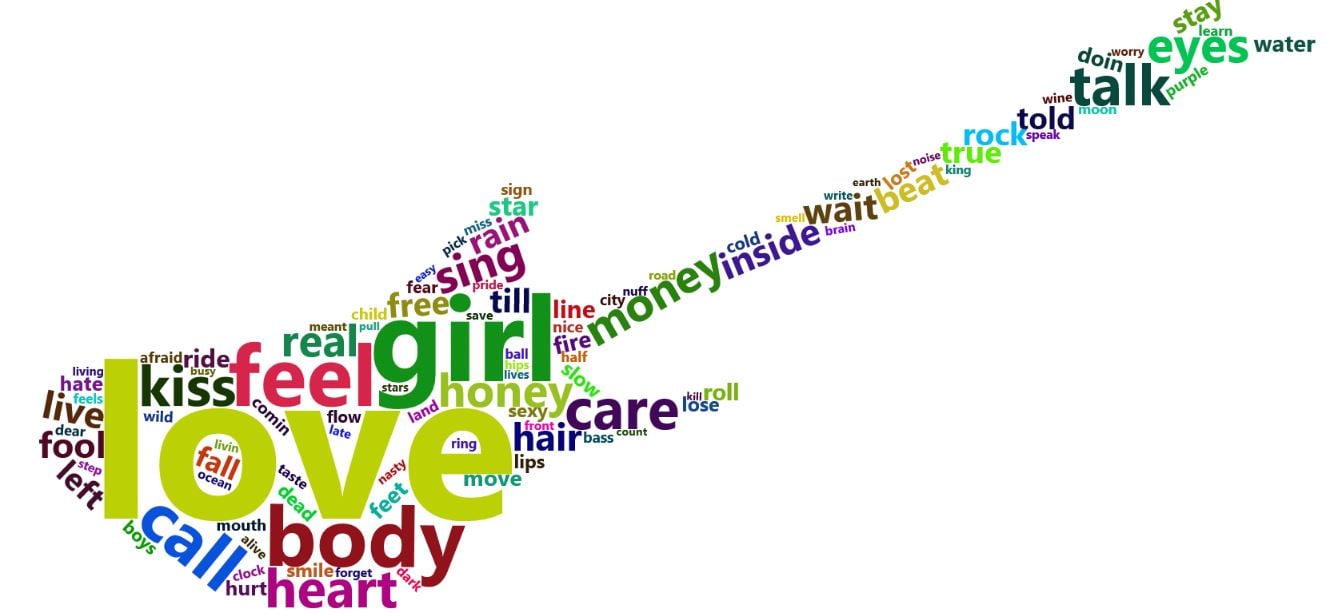
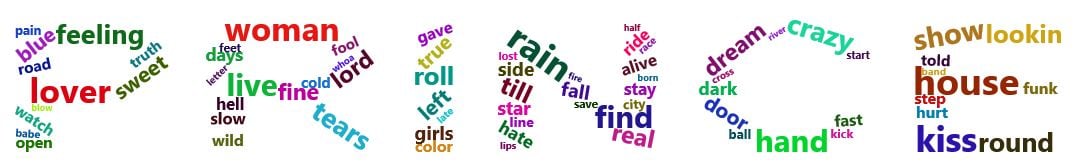
Até aqui você viu as palavras mais usadas em todas as músicas. E se separarmos por nível nas paradas? Certas palavras são mais prevalentes em músicas que entraram nas paradas do que nas que não entraram? Essas seriam as palavras "populares" para a sociedade.
Note no código abaixo o uso de slice(seq_len(n)) para pegar as primeiras n palavras em cada chart_level. Funciona de forma diferente do top_n() e é uma boa escolha quando se usa facet. (Sempre há mais de um jeito de fazer esse tipo de truque.) Também dá para usar row_number() para garantir a ordem correta no gráfico. Por padrão, o ggplot() ordenaria alfabeticamente; é boa prática ordenar antes de plotar.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Popular Words by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
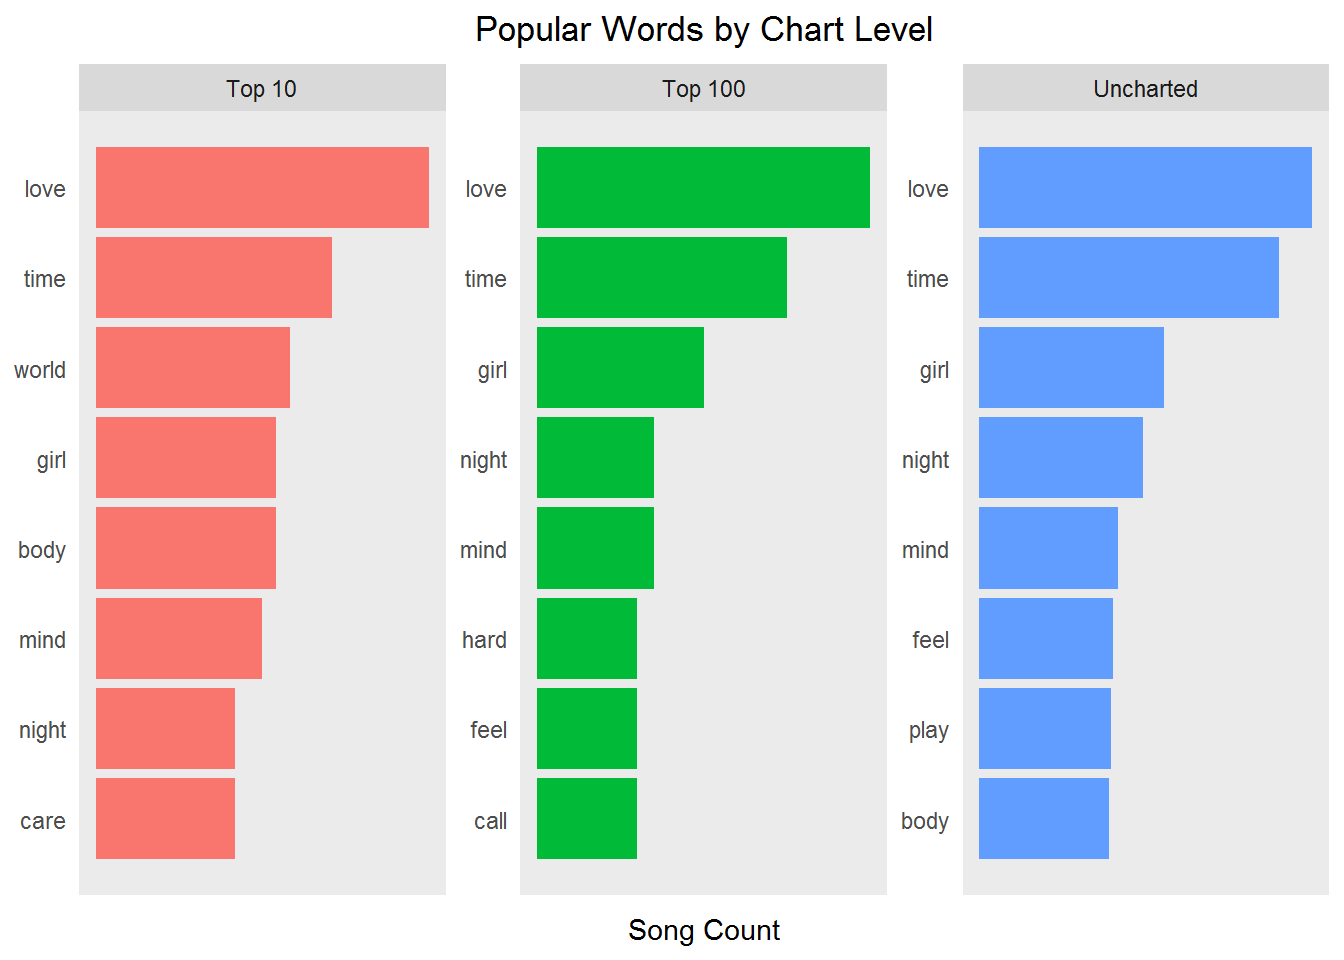
Quais os insights daqui?
Bem, as palavras do topo são muito parecidas entre os níveis. Isso não anima nossas esperanças de prever sucesso só pelas letras! Mas você só arranhou a superfície do que é possível com mineração de texto — e mais adiante com NLP e modelagem preditiva.
Algumas palavras na música são atemporais. Elas persistem ao longo do tempo e agradam a públicos amplos. Se você quebrar a análise por décadas, essas palavras sobem. Use filtragem, agrupamento e agregação para obter as palavras do topo por década nas letras de Prince e ver o que é atemporal ou tendência. Use ggplot() com facet_wrap() para visualizar por década.
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Timeless Words") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
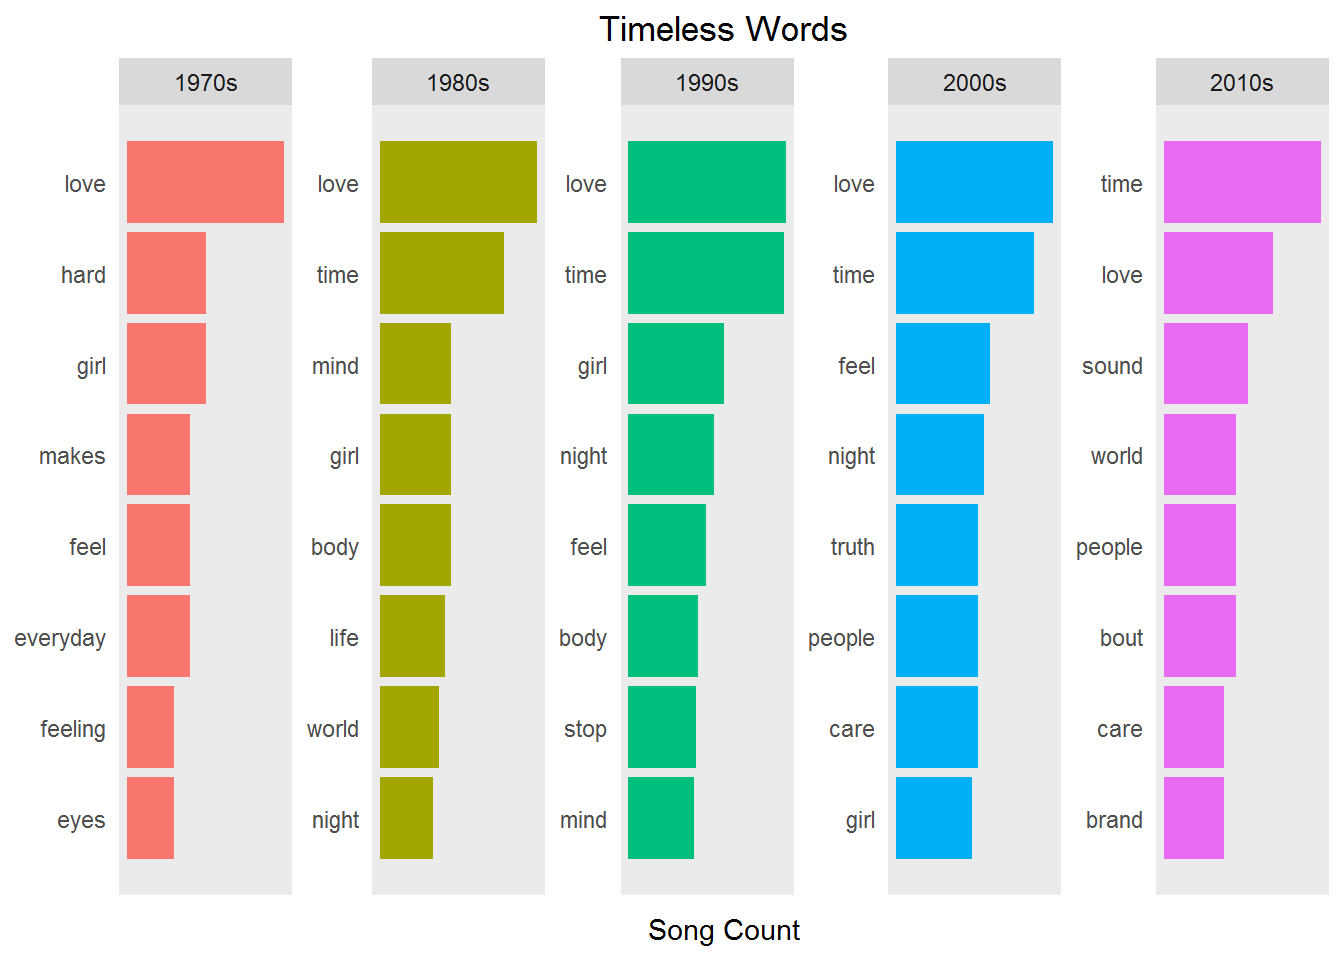
Claramente love, time e girl são atemporais. Mas e as palavras de tendência? Truth estava em alta na virada do século? Ou será só repetição em algumas músicas? A frequência realmente identifica temas? Isso funciona com letras como em outras tarefas de mineração de texto (por exemplo, discursos do Estado da União)?
O tamanho das palavras interessa a compositores. Quanto maior a palavra, mais difícil rimar e encaixar no padrão. O histograma abaixo é o esperado, com algumas exceções enormes.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Word Length") +
    ylab("Word Count") +
    ggtitle("Word Length Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
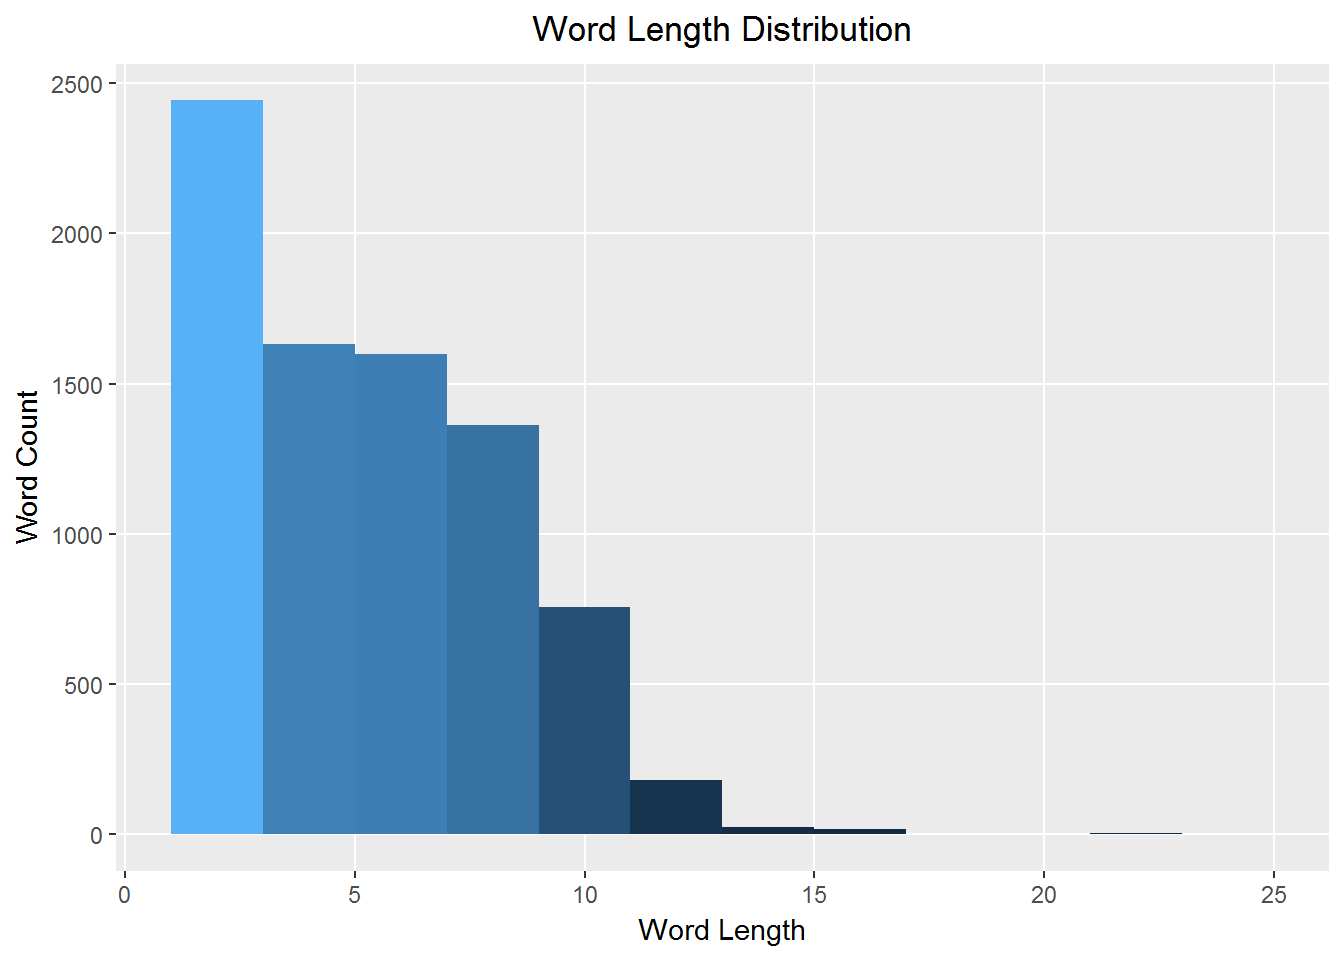
Quais são essas palavras gigantes? Isso pede uma nuvem totalmente divertida! Agora baseada no comprimento, não na frequência. Olha só:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Quanto mais variado o vocabulário, maior a diversidade lexical. O vocabulário da música representa quantas palavras únicas são usadas. Podemos mostrar com um gráfico simples da média de palavras únicas por música ao longo dos anos. Tokenize o dataset original de novo, mantendo stop e palavras curtas, pois aqui buscamos insights quantitativos.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexical Diversity") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
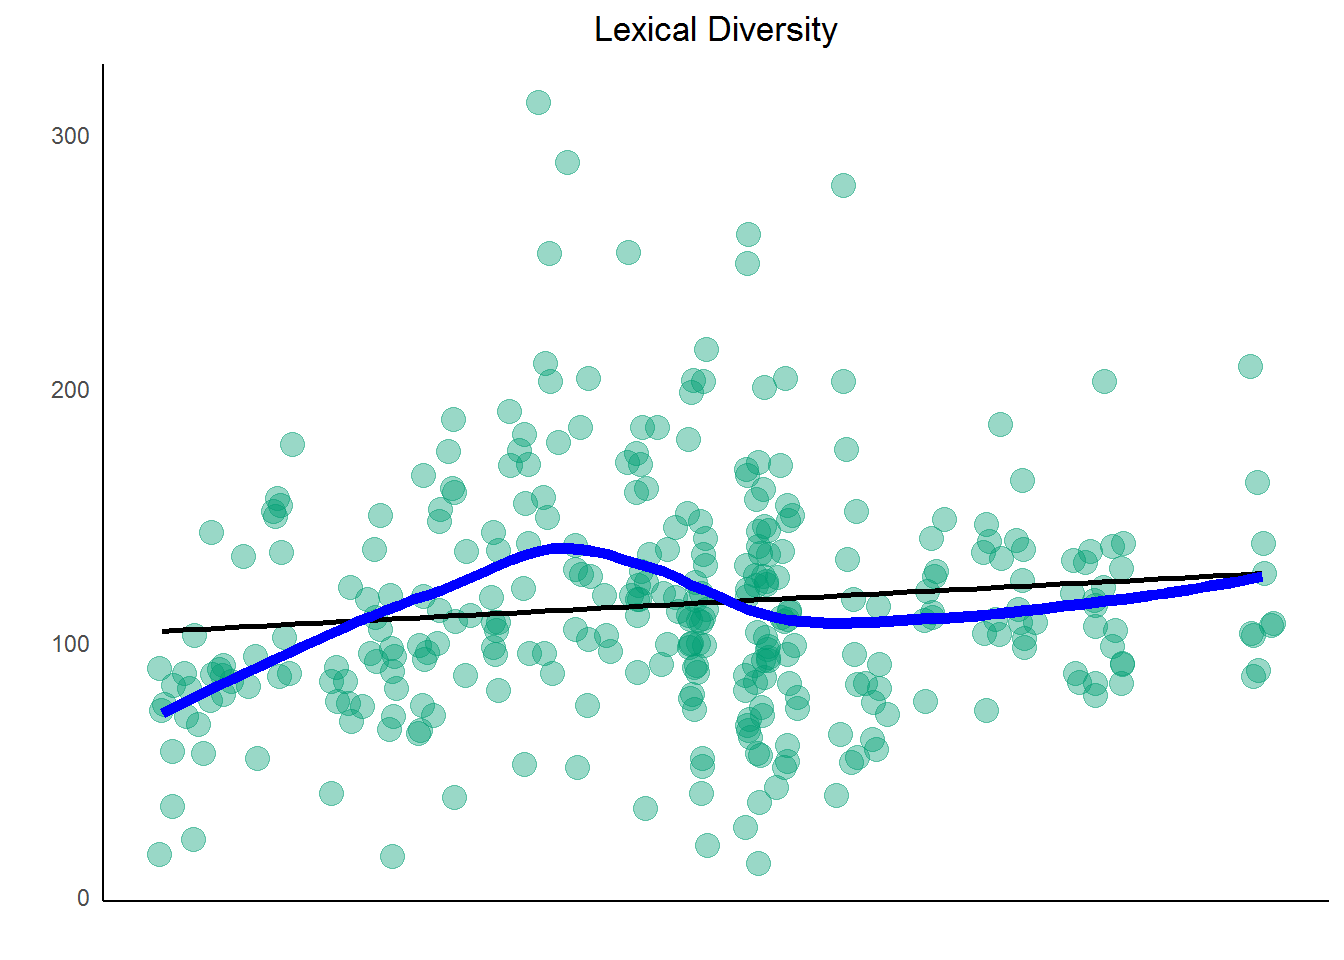
O que isso indica? Nas últimas décadas, há uma leve alta na diversidade lexical das letras de Prince. Como isso se correlaciona ao sucesso nas paradas? Difícil dizer, mas vamos plotar a densidade e o histórico nas paradas para comparar.
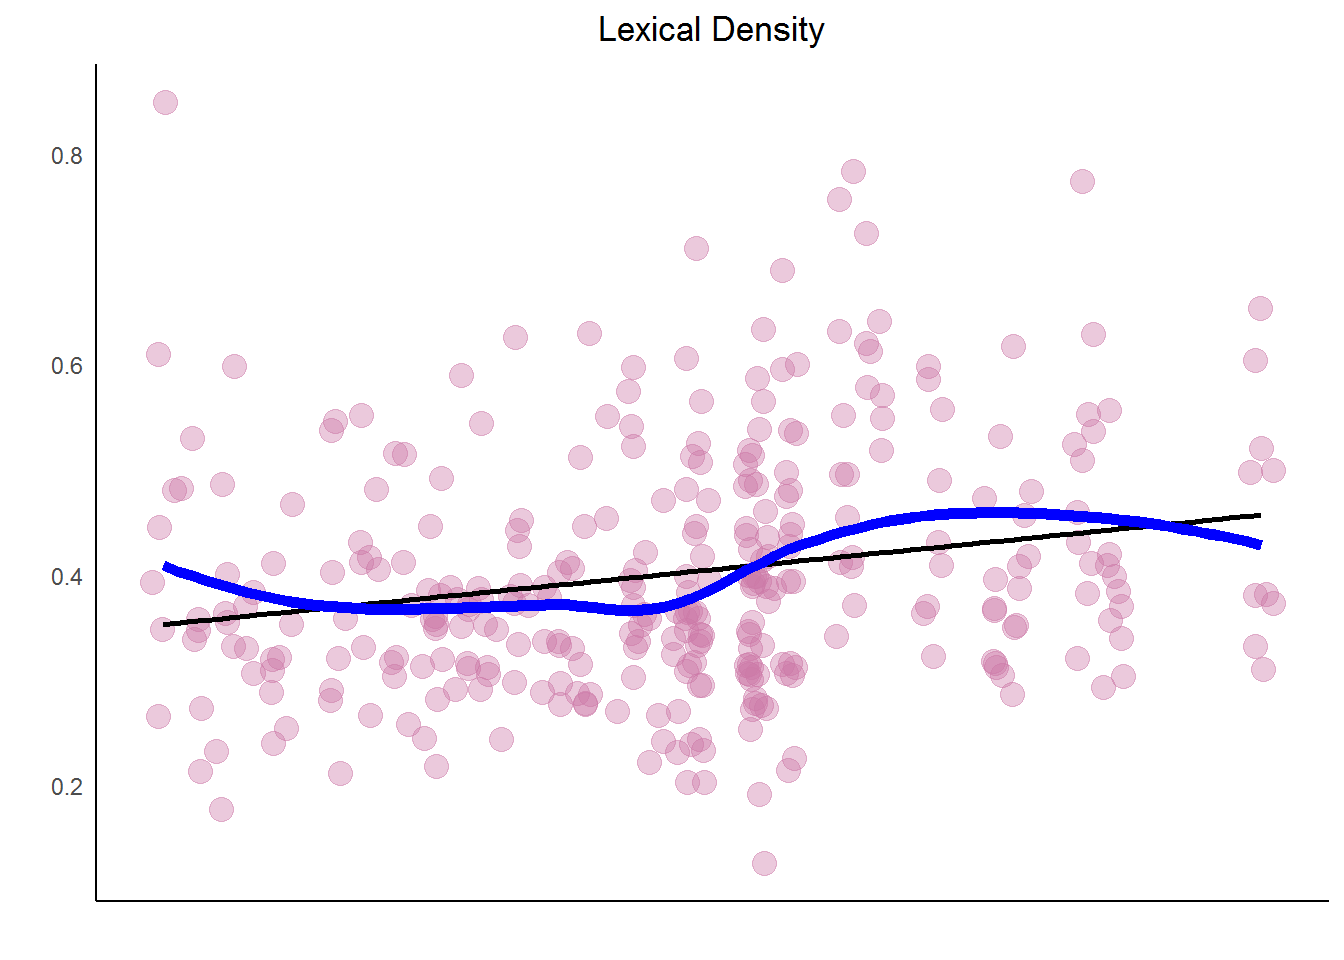
Para este tutorial, densidade lexical é o número de palavras únicas dividido pelo total de palavras. Indica repetição — uma ferramenta crítica de composição. Quanto maior a densidade, menor a repetição. (Observação: isso não implica repetição sequencial, outro truque de composição.)
Veja a densidade lexical de Prince ao longo dos anos. Para densidade, mantenha todas as palavras, incluindo stop words. Comece do dataset original e "desempacote" as palavras. Agrupe por música e ano e use n_distinct() e n() para calcular a densidade. Depois, passe para o ggplot() com geom_smooth(). Adicione um stat_smooth() extra com method="lm" para a linha linear.
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexical Density") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
Para comparar as tendências, crie um gráfico do histórico nas paradas (músicas que chegaram às listas) e compare com diversidade e densidade. Use grid.arrange() do gridExtra para exibir lado a lado.
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Chart History") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
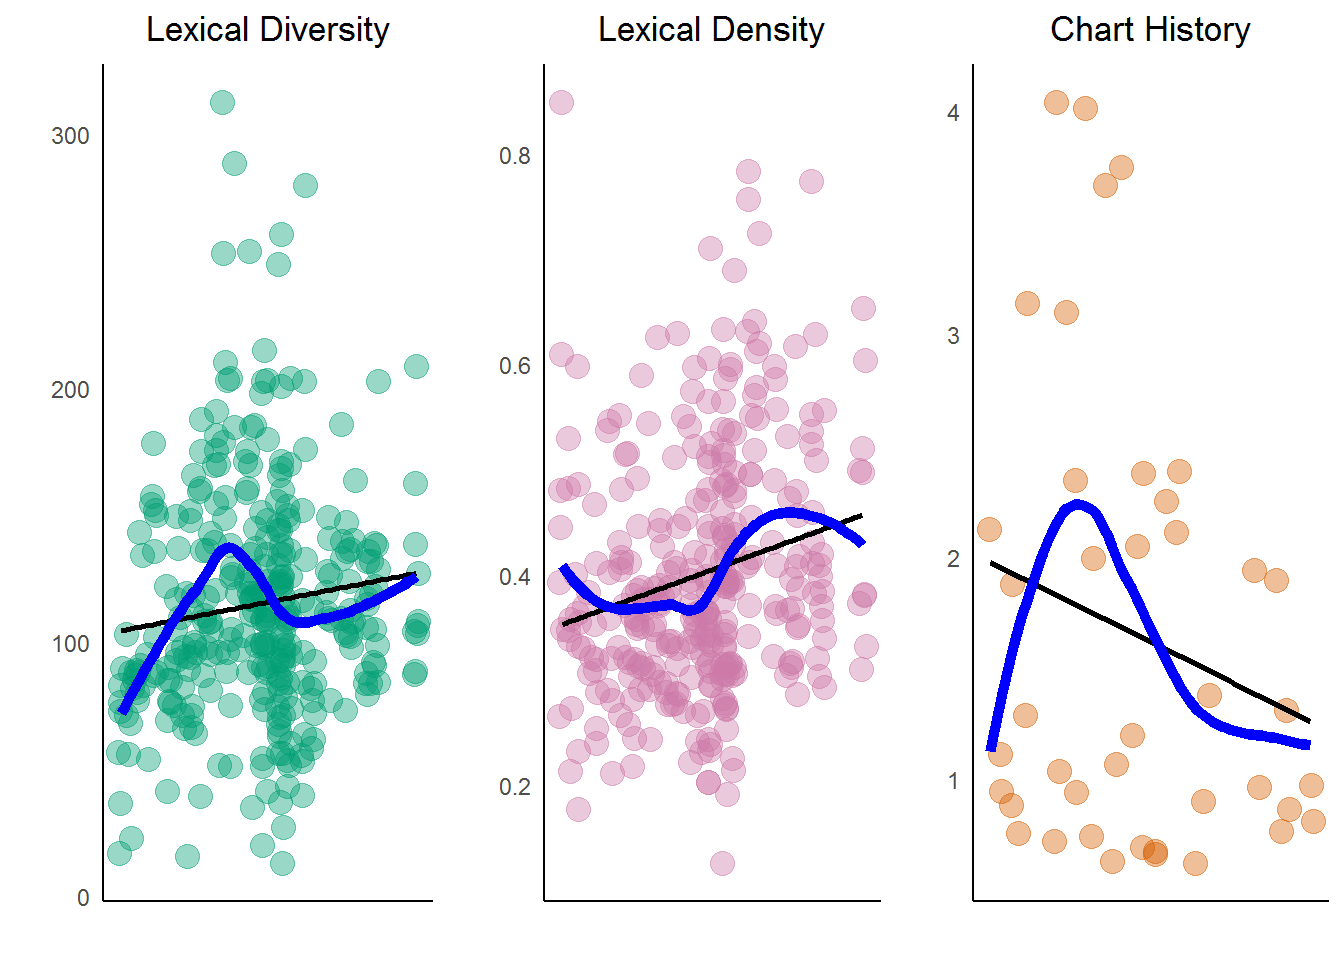
Vemos um leve aumento na diversidade e densidade lexical de Prince ao longo do tempo. Como isso se compara à música popular em geral? Um estudo mostra que hits têm apresentado queda na densidade lexical, indicando maior repetição ("mais palavras dizendo menos"). Não foi o que ocorreu nas músicas de Prince. Outro estudo revela que, na música popular em geral, a diversidade (palavras únicas) aumentou ao longo do tempo, o que se alinha positivamente com Prince. Talvez isso se relacione à maior diversidade de gêneros nos rankings. Gênero é um dado crítico que não está neste dataset. Pode ser que seu histórico nas paradas tenha caído no pop, mas subido no R&B/rap?
Desafio: deixo você refletir sobre esses resultados e incentivo a buscar outros datasets para praticar essas habilidades por conta própria! Lembre-se: correlação não implica causalidade.
Até agora olhamos o dataset todo, mas não tratamos de quantificar a importância de termos em um documento em relação ao conjunto. Você viu frequência de termos e removeu stop words, mas pode haver uma abordagem mais sofisticada.
Entra o TF-IDF. TF é "term frequency". IDF é "inverse document frequency", que dá peso menor a palavras muito comuns e maior às raras no conjunto. Quando você combina TF e IDF, a importância de um termo é ajustada pela sua raridade. A ideia é: termos que aparecem mais em um documento devem ter peso maior — a menos que apareçam em muitos documentos. A fórmula se resume a:
O IDF é maior para palavras que ocorrem em menos documentos do conjunto. Você pode usar essa abordagem para ver as palavras mais importantes por nível nas paradas com bind_tf_idf() do tidytext. Essa função calcula e anexa TF, IDF e o produto TF*IDF. Ela recebe um dataset tidy com uma linha por token (palavra) por documento (música). Os resultados aparecem em novas colunas.
Então, pegue o data frame original de Prince e desempacote tokens em palavras, remova palavras indesejáveis, mas mantenha as stop words. Depois use bind_tf_idf() para aplicar as fórmulas e criar as colunas novas.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Agora dá para ver que IDF e TF-IDF são 0 para palavras extremamente comuns. (Tecnicamente, o IDF será o log natural de 1 e, portanto, zero.) Encadeie em arrange() decrescendo por tf-idf. Some mais alguns passos e você terá outra forma de olhar as palavras nas letras de Prince.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %> %
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
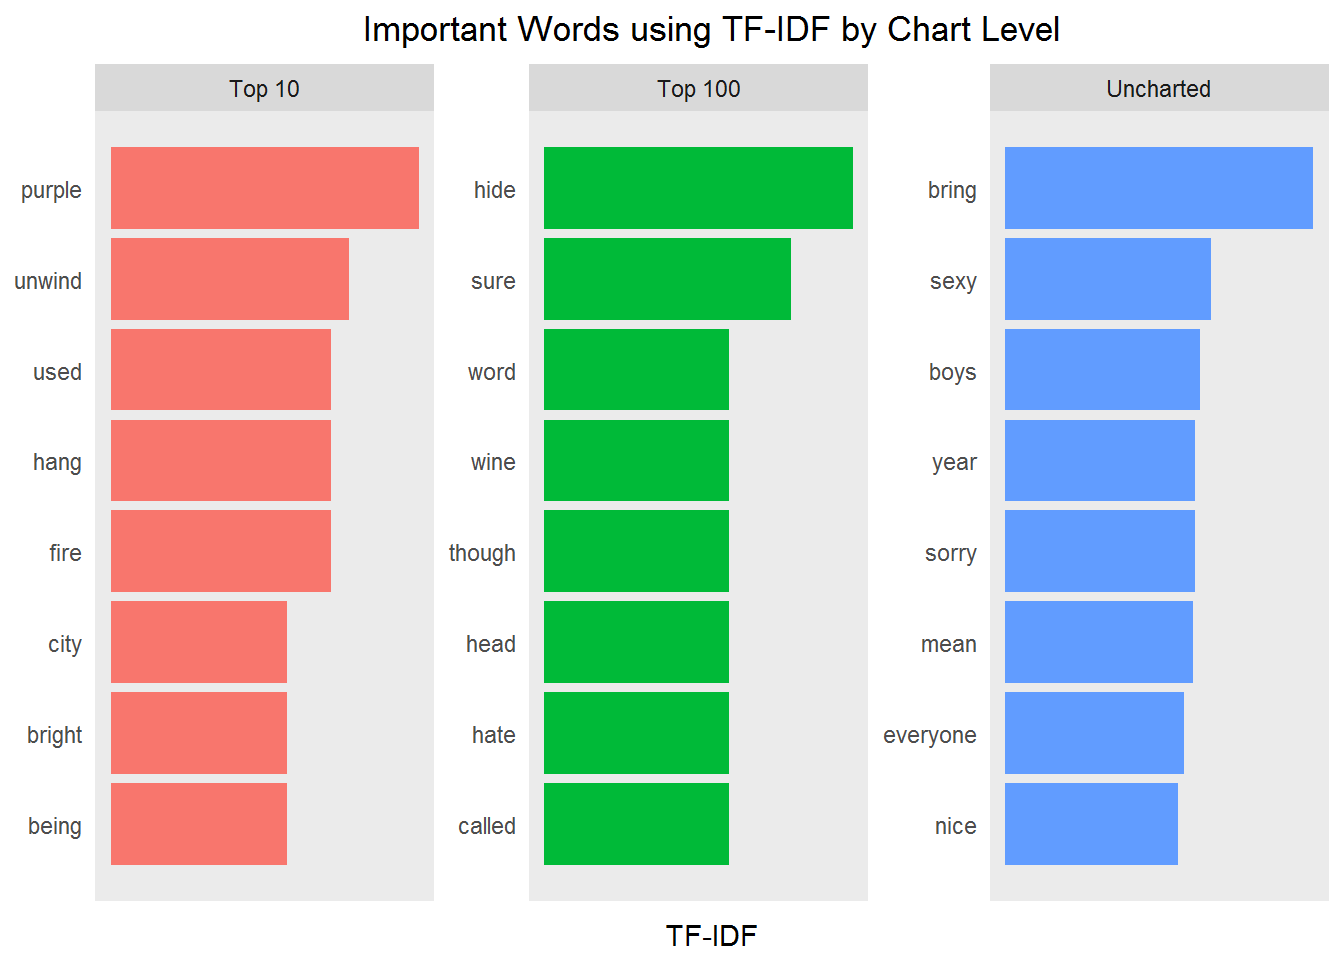
Uau, usar TF-IDF dá outra perspectiva sobre possíveis palavras importantes. Claro, a interpretação é subjetiva. Vê algum padrão?
Agora olhe o TF-IDF ao longo do tempo:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Decade") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
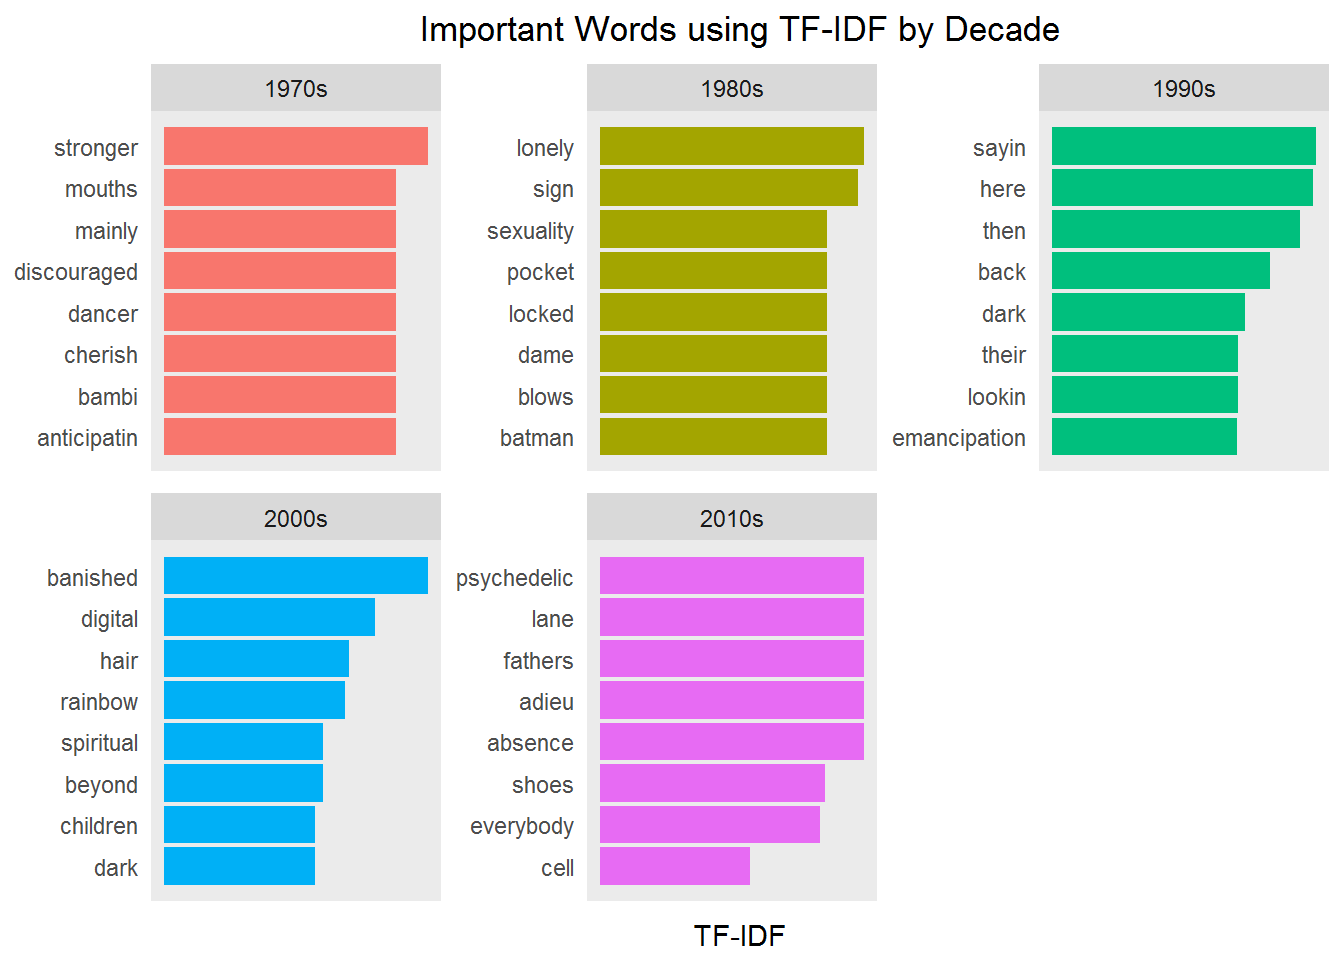
Agora você está chegando a um nível mais profundo de insight. As palavras atemporais deixam de dominar. Começa a enxergar tópicos ou temas? Dá para fazer isso só com algumas palavras por grupo? Vamos levar isso a outro patamar no segundo tutorial (Parte 2: sentiment analysis e topic modeling com NLP).
Uma nuvem rápida com esse método dá uma nova perspectiva sobre palavras importantes nas letras de Prince — e bem mais interessante…
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
Neste estudo de caso, você primeiro deu uma olhada nos dados, focando no básico. Depois de preparar o dataset com limpeza e remoção de palavras pouco informativas, iniciou uma análise exploratória no nível das músicas.
Em seguida, você mergulhou na mineração de texto, desempacotando as letras em palavras tokenizadas para avaliar a complexidade lexical. Os resultados fornecem insumos críticos para os próximos passos de sentiment analysis e topic modeling.
Por fim, você usou TF-IDF para representar a informação por trás de uma palavra em um documento em relação a um resultado de interesse. Talvez pareça uma boa forma de identificar temas na música, mas isso é só metade da história. A Parte 2 aborda um método de aprendizado não supervisionado chamado Latent Dirichlet Allocation (LDA). Como em toda a ciência de dados, há vários caminhos para gerar insights. E nas Partes 2 e 3 deste estudo de caso, você vai explorar mais opções.
Espero que você esteja tão empolgado quanto eu para continuar essa jornada — da análise exploratória para sentiment analysis, topic modeling e insights preditivos.
Obrigado pela leitura e te vejo no próximo tutorial!
Saiba mais sobre R e machine learning
Curso
Curso
Curso
Tutorial
Zoumana Keita
15 min
Tutorial
Moez Ali
13 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Somil Asthana
11 min
Tutorial
Abid Ali Awan
10 min