Corso
Machine Learning con caret in R
4 ore
61K
Questa è la Parte Uno di una serie di tre tutorial in cui userai R per svolgere varie attività analitiche su un case study basato sui testi musicali del leggendario artista Prince. I tre tutorial coprono quanto segue:
I testi musicali possono rappresentare la prospettiva di un artista, ma le canzoni popolari rivelano ciò che la società vuole ascoltare. L’analisi dei testi non è un compito semplice. Poiché sono spesso strutturati in modo molto diverso dalla prosa, richiedono cautela nelle assunzioni e una scelta particolarmente accurata delle tecniche analitiche. I testi musicali permeano le nostre vite e influenzano i nostri pensieri con una sottile ubiquità. Il concetto di Predictive Lyrics sta iniziando a fare rumore ed è sempre più presente come tema di articoli accademici e tesi di laurea. Questo case study toccherà solo alcuni aspetti di questo argomento emergente.
Per celebrare l’ispirante e variegata eredità lasciata da Prince, esplorerai i messaggi a volte evidenti, ma spesso nascosti, nei suoi testi. Tuttavia, non serve amare la musica di Prince per apprezzare l’influenza che ha avuto sullo sviluppo di molti generi a livello globale. La rivista Rolling Stone ha inserito Prince al 18º posto tra i migliori cantautori di tutti i tempi, appena dietro nomi come Bob Dylan, John Lennon, Paul Simon, Joni Mitchell e Stevie Wonder. L’analisi dei testi sta lentamente entrando nelle comunità di data science man mano che la possibilità di prevedere le "Hit Songs" si avvicina alla realtà.
Prince era un uomo colmo di musica: un cantautore incredibilmente prolifico, un virtuoso di chitarra, tastiere e batteria e un maestro architetto di funk, rock, R&B e pop, pur sfuggendo a ogni genere. - Jon Pareles (NY Times)
In questo tutorial, Parte Uno della serie, utilizzerai tecniche di text mining su un insieme di testi usando il framework tidy text. I dataset tidy hanno una struttura specifica in cui ogni variabile è una colonna, ogni osservazione è una riga e ogni tipo di unità osservazionale è una tabella. Dopo aver pulito e preparato il dataset, creerai statistiche descrittive e visualizzazioni esplorative osservando diversi aspetti dei testi di Prince.
La Parte Uno di questa serie richiede una comprensione di base dei dati "tidy" — in particolare pacchetti come dplyr per la trasformazione dei dati, ggplot2 per le visualizzazioni e l’operatore %>% pipe originariamente dal pacchetto magrittr. Ogni tutorial descriverà gli strumenti che puoi usare per l’analisi, ma potrebbe non entrare nel dettaglio di ogni passaggio. Noterai che diversi passaggi sono spesso combinati usando l’operatore %>%. Trattandosi anche di un case study, è importante ricordare che tutte le inferenze che farai sono puramente osservazionali; dunque, la correlazione non implica causalità.
Suggerimento: per approfondire gli strumenti utilizzati, due ottime risorse sono R for Data Science di Garrett Grolemund e Hadley Wickham; e Text Mining with R di Julia Silge e David Robinson.
Parti Due e Tre
In un tutorial separato, la Parte Due, tratterai Sentiment Analysis e Topic Modeling per catturare l’umore generale e i temi nella musica di Prince e la loro applicazione alle prospettive sociali. Lavorerai con un lessico di sentiment, valuterai sentiment binari e categoriali, traccerai tendenze nel tempo e analizzerai n-gram e associazioni tra parole. Userai anche tecniche di Natural Language Processing (NLP) e di clustering come Latent Dirichlet Allocation (LDA) e K-Means per far emergere motivi ricorrenti nei testi.
In un altro tutorial ancora, la Parte Tre, chiuderai il cerchio usando i risultati esplorativi per aiutare a prevedere in quale decennio è stata pubblicata una canzone e, cosa ancor più interessante, se una canzone entrerà nelle classifiche Billboard in base ai suoi testi. Userai strumenti di machine learning come Decision Trees (rpart e C50), K-Nearest-Neighbors (class) e Naive Bayes (e1071) per produrre un classificatore in grado di accettare testo.
Tutte e tre le parti utilizzeranno lo stesso dataset di testi di Prince, anno di pubblicazione e posizioni in classifica Billboard. Le tecniche di questo studio possono essere applicate anche a molti altri tipi di testo. Anzi, i risultati per la prosa standard sono più facilmente interpretabili perché i testi, in generale, sono spesso progettati con messaggi indiretti e sfumature sottili.
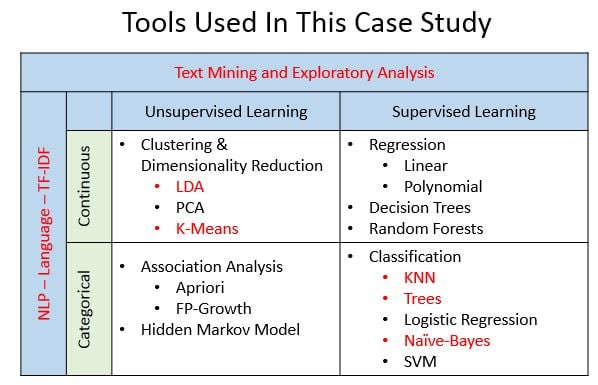
In sintesi, esistono molti metodi per analizzare i testi. Questi tutorial coprono quelli evidenziati in rosso nell’immagine qui sotto. Nota che questa grafica è semplicemente una rappresentazione ad alto livello di un quadro molto "sfocato". E no, non intendo l’immagine in sé! La verità è che i diversi aspetti delle tecniche di modellazione e machine learning sono oggi sfumati e non necessariamente rientrano in una singola categoria come mostrato sotto. Quindi indossa degli occhiali 3D mentre guardi l’immagine e forse avrà più senso!
Oltre a imparare e mettere in pratica nuove competenze, questo tutorial mira ad affrontare domande di base sul concetto di analisi dei testi. Studi recenti mostrano che l’"intelligenza lirica" potrebbe essere in calo nella musica popolare. Alcuni studi suggeriscono persino che le parole usate nelle canzoni al n. 1 delle classifiche corrispondano a livelli di lettura dei bambini di terza elementare negli USA. È possibile utilizzare text mining, NLP, machine learning e altri metodi di data science per far luce su un tema del genere? È possibile identificare temi che attraggono la società in base a come viene accolta una canzone? È possibile prevedere se una canzone avrà successo basandosi solo sull’analisi del testo? In questo primo tutorial, esaminerai la complessità lessicale della musica di Prince come esercizio esplorativo.
Prima di iniziare, pensa a cosa stai cercando di scoprire. Quali domande ti interessano? Per prima cosa passerai in rassegna un’analisi del dataset. Com’è fatto? Quante canzoni ci sono? Come sono strutturati i testi? Quanto lavoro di pulizia e wrangling è necessario? Quali sono i fatti? Quali sono le frequenze delle parole e perché sono importanti? Da una prospettiva tecnica, vuoi comprendere e preparare i dati per sentiment analysis, NLP e modelli di machine learning.
La musica è da tempo un modo efficace per comunicare alle masse, e i testi hanno avuto un ruolo enorme nel veicolare questa comunicazione. Eppure, le opportunità di ricerca sul ruolo che i testi giocano nel benessere [della società] sono ampiamente sotto-utilizzate. - Patricia Fox Ransom
Un metodo comune per ottenere dati per il text mining è usare il pacchetto rvest per effettuare scraping di contenuti dal web. Sono riuscita a raccogliere informazioni delle classifiche Billboard e testi di Prince da vari siti e a unirli per titolo della canzone. È stato necessario un po’ di wrangling a causa di convenzioni di denominazione incoerenti per i titoli. Ho poi preso la decisione soggettiva di rimuovere tutte le canzoni che non erano le versioni originali, ovvero remix, versioni estese, club mix, remake, ecc. Ho anche rimosso album che contenevano raccolte storiche delle sue Hit per evitare ripetizioni. Ho effettuato una piccola pulizia e salvato il risultato in un file csv da usare per questo tutorial.
Poiché la Parte Uno si concentra sul text mining, non ho incluso quel codice per questo tutorial, ma il dataset è disponibile per il download qui se vuoi seguirlo passo passo.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Esistono diversi metodi per leggere i dati da un file csv, ma ho scelto di usare read.csv() per caricare un data frame con testi, anno di pubblicazione e posizioni nelle classifiche Billboard. Nota che per impostazione predefinita R converte tutte le stringhe di caratteri in fattori. Questo può creare problemi in seguito, ma puoi evitarli impostando il parametro stringsAsFactors a FALSE. Ora esaminiamo i dati…
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Puoi usare la funzione names() per vedere le colonne nel data frame:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Poiché ho creato io questo file, so che X è solo un numero di riga e text sono i testi veri e propri. Gli altri campi necessari includono song, year e peak (che mostra la posizione in classifica Billboard). US.Pop e US.R.B sono le posizioni di picco nelle classifiche statunitensi (Pop e R&B), quindi tienile anche queste e per ora elimina gli altri campi.
Fallo prendendo il dataset originale, prince_orig, e passandolo a select() usando %>%. In questo modo puoi leggere il codice da sinistra a destra.
Nota anche che select() ti permette di rinominare le colonne in un solo passaggio. Quindi imposta text su lyrics e rinomina le colonne US nello stile tidyverse usando "_" invece di ".". Poi salva i risultati in prince, che userai in tutti i tutorial. dplyr fornisce una funzione chiamata glimpse() che rende facile dare un’occhiata ai dati in una vista trasposta.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
La prima domanda ovvia è quante osservazioni e quante colonne ci sono?
dim(prince)
[1] 824 7
Usando la funzione dim(), vedi che ci sono 7 colonne e 824 osservazioni. Ogni osservazione è una canzone. Come dicevo… prolifico!
Osservando la colonna dei testi per una delle canzoni, puoi vedere come sono strutturati.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Ci sono molte opportunità per ripulire le cose, quindi iniziamo.
Ci sono diversi metodi che puoi usare per preparare i dati. Un’opzione sarebbe convertire il data frame in un Corpus e in una Document Term Matrix usando il pacchetto di text mining tm e poi usare la funzione tm_map() per la pulizia, ma in questo tutorial resteremo sulle basi e useremo gsub() e le funzioni apply() per fare il lavoro sporco.
Per prima cosa, elimina quelle fastidiose contrazioni creando una piccola funzione che gestisca la maggior parte degli scenari usando gsub(), quindi applicala a tutti i testi.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
Noterai anche caratteri speciali che sporcano il testo. Puoi rimuoverli con la funzione gsub() e una semplice espressione regolare. Nota che è fondamentale espandere le contrazioni prima di questo passaggio!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Per coerenza, converti tutto in minuscolo con la comoda funzione tolower().
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Esaminando ora i testi si vede una versione più pulita del testo grezzo originale.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Un altro passaggio comune nel preparare i dati per il text mining è lo stemming, ovvero ridurre le parole alla loro radice. È un argomento a sé che potrà essere trattato più avanti. Per ora, dai un’occhiata al summary del data frame prince.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
Come puoi vedere, ci sono 37 anni di canzoni, e la canzone con la posizione più bassa (presente nel dataset) è all’88º posto. Noti anche parecchi NA per year e peak. Poiché eseguirai diversi tipi di analisi, mantieni il dataset completo nel data frame prince e applica filtri quando necessario.
Dal momento che una delle tue domande è cercare tendenze delle canzoni nel tempo e il dataset contiene singoli anni di pubblicazione, puoi creare dei bucket e raggruppare gli anni per decenni. Usa il verbo mutate() di dplyr per creare il nuovo campo decade. Un modo per creare i bucket è utilizzare ifelse() insieme all’operatore %in% per filtrare per anno e suddividere le canzoni per decenni. Poi salva i risultati in prince (aggiungendo di fatto un nuovo campo).
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Puoi fare lo stesso per chart_level, che rappresenta se una canzone ha raggiunto la Top 10, la Top 100 o non è entrata in classifica (uncharted). Queste sono mutuamente esclusive, quindi Top 100 non include le canzoni in Top 10.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Inoltre, crea un campo binario chiamato charted che indichi se una canzone ha raggiunto le classifiche Billboard o meno (ovvero, se è popolare). Usa write.csv() per salvare per l’uso nei tutorial successivi.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Per personalizzare i grafici, mi piace creare una lista unica di colori per mantenere coerenti le visualizzazioni. Sul web ci sono molte risorse per ottenere colori distinti tramite il loro codice esadecimale come sotto. Se preferisci, puoi anche creare un tuo tema da applicare a ggplot() quando serve.
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Prima di passare al text mining, inizia con una vista di base di ciò che contengono i tuoi dati a livello di canzone. Ora è un buon momento per visualizzare quante canzoni Prince ha pubblicato per decennio. Come promemoria, la sua carriera professionale è iniziata nel 1978 ed è proseguita fino al 2015 (come mostrato nelle statistiche summary() sopra). Ma dato che stiamo guardando le tendenze e il dataset ha un numero elevato di valori vuoti per l’anno, per il primo grafico vorrai filtrare tutti gli NA sull’anno di pubblicazione.
Usando le funzioni filter(), group_by() e summarise() di dplyr, puoi raggruppare per decennio e poi contare il numero di canzoni. La funzione n() è una delle varie funzioni di aggregazione utili con summarise() su dati raggruppati. Poi, usando ggplot() e geom_bar(), crea un grafico a barre e riempi le barre con la categoria charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Released Songs") +
  labs(x = NULL, y = "Song Count")
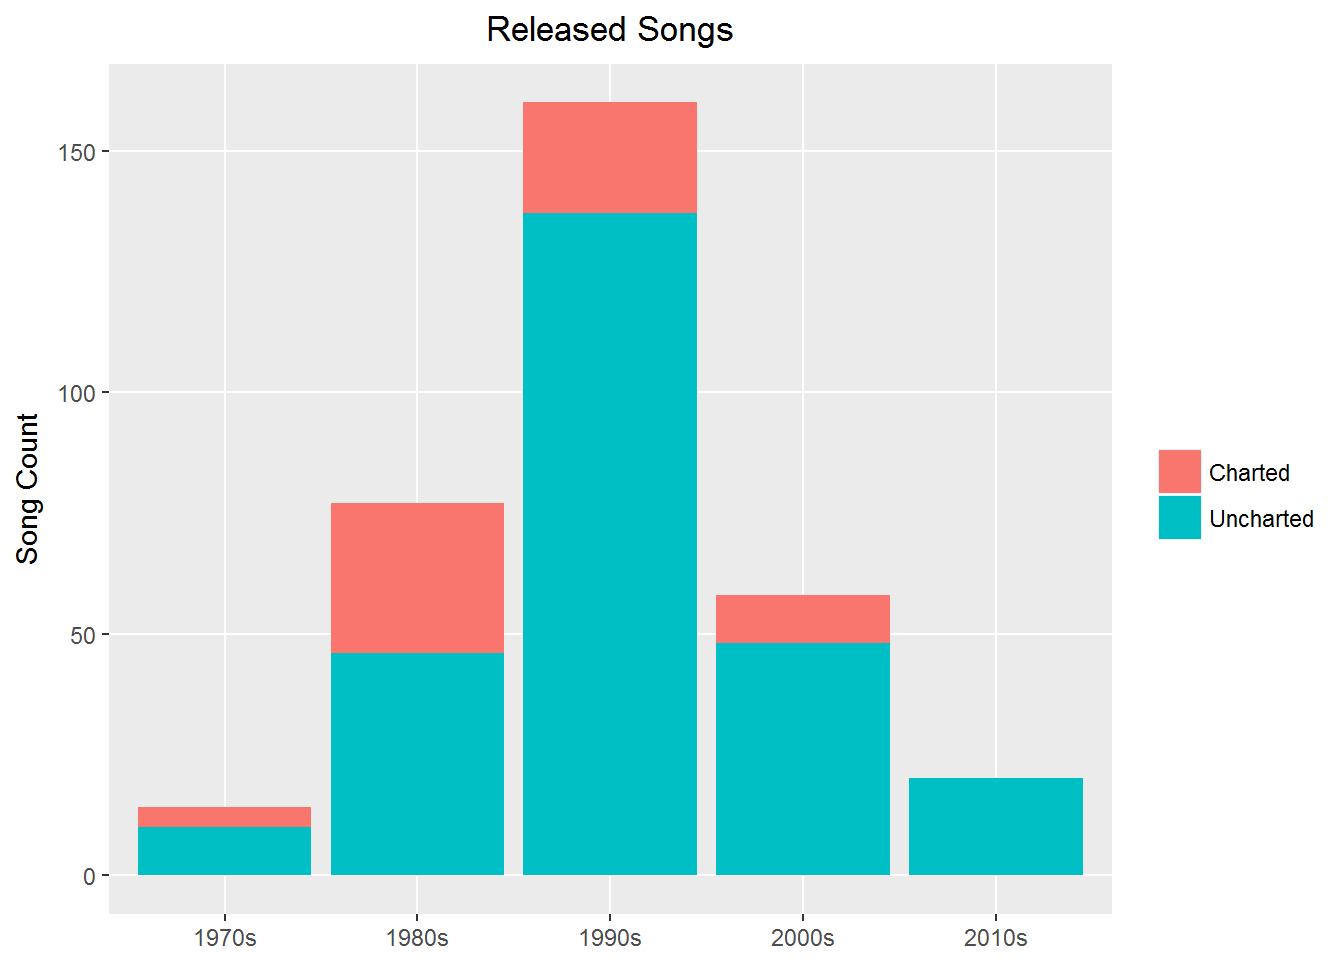
Questo mostra chiaramente che il suo decennio più attivo è stato quello degli anni ’90.
Ora crea un grafico simile con chart_level.
Ricorda di usare group_by() sia per decade che per chart_level per poter vedere la tendenza.
In questo grafico, guarderai solo le canzoni entrate in classifica, quindi filtra tutto il resto usando peak > 0. Passa l’oggetto group_by a summarise() usando n() per contare il numero di canzoni. Memorizzando questo in una variabile, puoi poi passarla a ggplot() per un semplice grafico a barre.
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("Charted Songs")
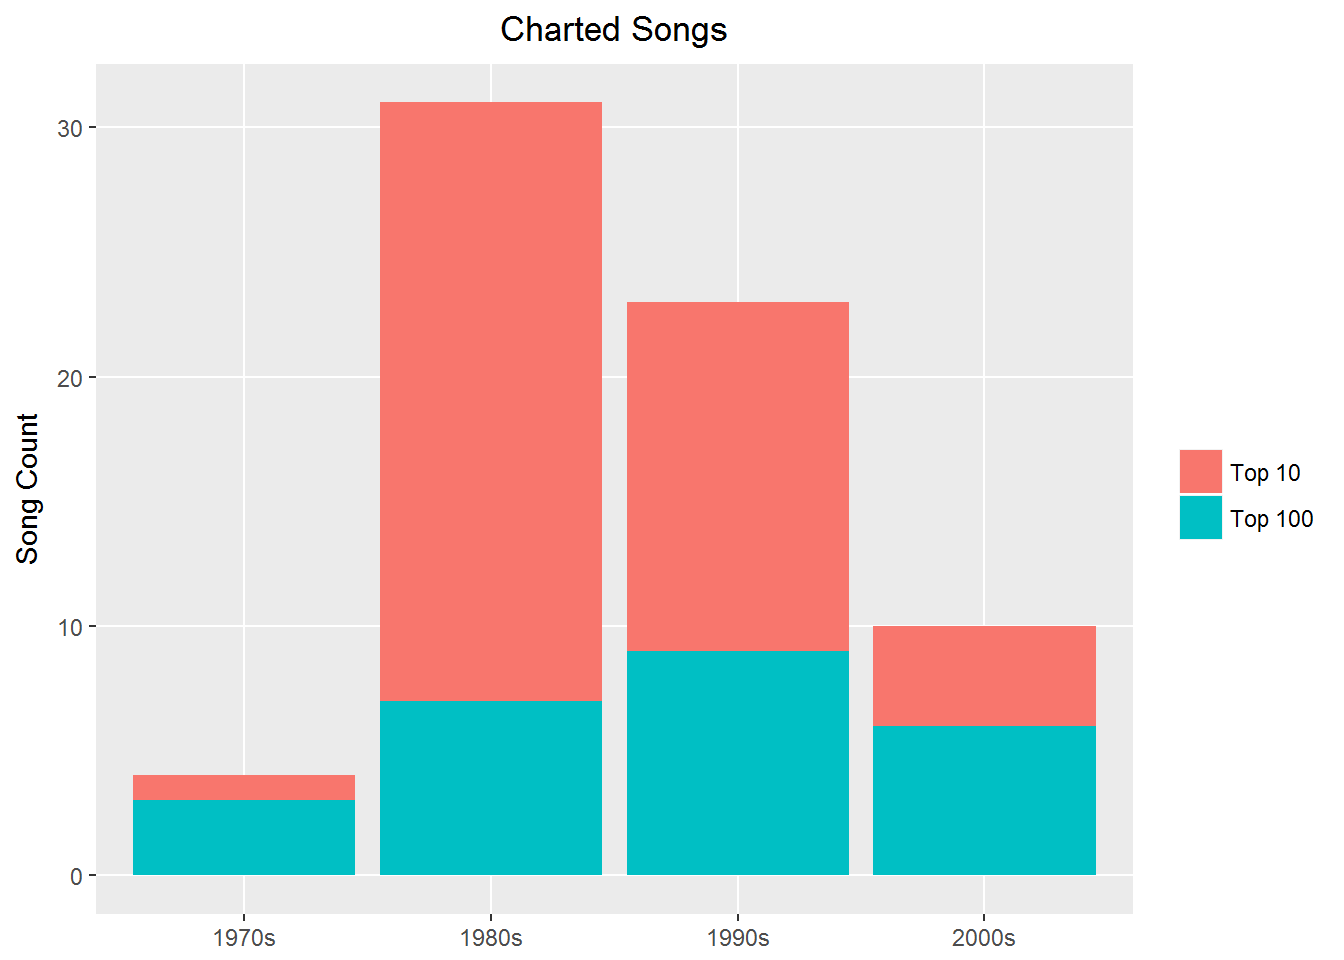
Nota che, tra tutte le canzoni di Prince entrate in classifica, la maggioranza ha raggiunto la Top 10. Ma ciò che è ancor più interessante è che il suo decennio più prolifico per nuove canzoni è stato quello degli anni ’90, eppure più hit in classifica si sono verificate negli anni ’80. Perché? Tieni a mente questa domanda mentre prosegui con le sezioni sul text mining.
Per sfruttare la potenza del dataset completo per l’analisi testuale, puoi rimuovere i riferimenti al livello di classifica e all’anno di pubblicazione e avere un insieme molto più ampio di canzoni da analizzare. Dai un’occhiata:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Song Count") +
  ggtitle("All Songs in Data")
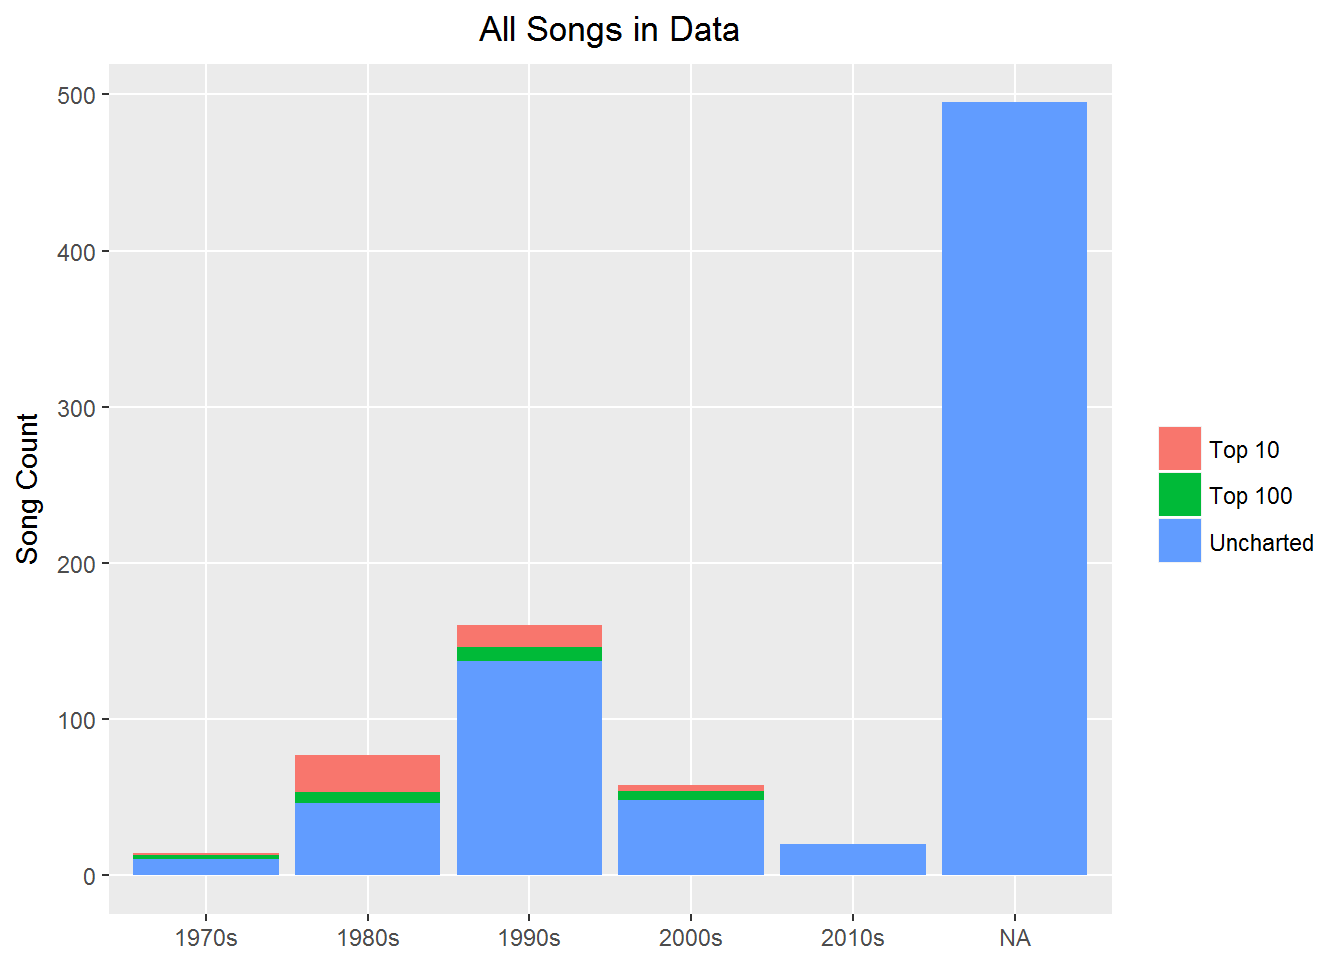
Come puoi vedere, Prince ha scritto centinaia di canzoni per cui non c’è una data di pubblicazione nel dataset. Per sentiment analysis o analisi esplorative puoi usare tutti i dati, ma per le tendenze nel tempo hai un insieme molto più piccolo con cui lavorare. Va bene — è solo qualcosa da tenere a mente.
Per gli appassionati di Prince, qui sotto c’è un rapido sguardo alle canzoni che hanno raggiunto il n. 1 in classifica. (Nota che puoi usare kable() e kable_styling() dai pacchetti knitr e kableExtra e color_tile() da formattable per creare output HTML ben formattati.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
Il text mining può essere visto anche come text analytics. L’obiettivo è scoprire informazioni rilevanti, possibilmente sconosciute o nascoste sotto l’evidenza. Il Natural Language Processing (NLP) è una metodologia usata nel mining del testo. Cerca di decifrare le ambiguità del linguaggio scritto tramite tokenizzazione, clustering, estrazione di entità e relazioni tra parole, e l’uso di algoritmi per identificare temi e quantificare informazioni soggettive. Inizierai scomponendo il concetto di complessità lessicale.
La complessità lessicale può significare cose diverse in contesti diversi, ma per ora assumiamo che possa essere descritta da una combinazione di queste misure:
Per iniziare l’analisi, devi suddividere i testi in parole singole e iniziare a cercare insight. Questo processo si chiama tokenizzazione.
Ricorda che esistono diversi metodi e formati dati che possono essere usati per analizzare il testo:
Ma prima di tokenizzare qualsiasi cosa, c’è un altro passaggio di pulizia. Molti testi, quando trascritti, includono frasi come "Repeat Chorus" o etichette come "Bridge" e "Verse". Ci sono anche molte altre parole indesiderate che possono sporcare i risultati. Avendo fatto un’analisi preliminare, ne ho selezionate alcune che vorrei rimuovere.
Qui sotto trovi un elenco di parole superflue da rimuovere manualmente:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Per "disinnestare" i token, usa la libreria tidytext, che è già stata caricata. Ora puoi sfruttare le capacità di dplyr e combinare diversi passaggi insieme.
Dal framework tidy text, devi sia suddividere il testo in token individuali (tokenizzazione) sia trasformarlo in una struttura dati tidy. Per farlo, usa la funzione unnest_tokens() di tidytext. unnest_tokens() richiede almeno due argomenti: il nome della colonna di output che verrà creata man mano che il testo viene "disinnestato" in essa ("word", in questo caso), e la colonna di input che contiene il testo attuale (cioè lyrics).
Puoi prendere il dataset prince e passararlo a unnest_tokens(), poi rimuovere le stop word. Cosa sono le stop word? Le conosci fin troppo bene. Sono parole estremamente comuni che potrebbero non aggiungere alcun significato ai nostri risultati. Esistono diverse liste tra cui scegliere, ma qui userai il lessico chiamato stop_words del pacchetto tidytext.
Usa sample() per mostrare una lista casuale di queste stop word e head() per limitarla a 15 parole.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Quindi, dopo aver tokenizzato i testi in parole, puoi usare anti_join() di dplyr per rimuovere le stop word. Poi elimina le parole indesiderate definite prima usando il verbo filter() di dplyr con l’operatore %in%. Quindi usa distinct() per eliminare eventuali record duplicati. Infine, rimuovi tutte le parole con meno di quattro caratteri. Anche questa è una decisione soggettiva, ma nei testi spesso si tratta di interiezioni come "yeah" e "hey". Poi salva i risultati in prince_words_filtered.
Nota: per riferimento futuro, prince_words_filtered è la versione tidy text del data frame prince senza 1) stop word, 2) parole indesiderate e 3) parole di 1-3 caratteri. Lo userai in alcune, ma non in tutte le analisi.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Nota che stop_words ha una colonna word e una nuova colonna chiamata word è stata creata dalla funzione unnest_tokens(), quindi anti_join() effettua automaticamente il join sulla colonna word.
Ora puoi esaminare la classe e le dimensioni della tua nuova struttura dati tidy:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered è un data frame con 36916 parole totali (non uniche) e 10 colonne. Ecco un’istantanea: (Ho scelto una parola e limitato la sua presenza a 10 canzoni e ho usato select() per stampare i campi interessanti in ordine, usando di nuovo knitr per la formattazione). Questo ti mostra la struttura tidy tokenizzata e non riassunta.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Puoi vedere che ogni riga contiene una singola parola che viene ripetuta per ogni canzone in cui appare.
Nella musica, le frequenze delle singole parole sono molto importanti, sia per la ripetizione sia per la rarità. Entrambe incidono sulla memorizzazione dell’intera canzone. Una domanda che un autore potrebbe porsi è se esista una correlazione tra frequenza delle parole e canzoni di successo. Quindi ora vuoi fare un passo oltre il formato tidy e ottenere un conteggio riassunto di parole per canzone.
Per esaminare questo formato nei testi di Prince, crea un istogramma che mostri la distribuzione dei conteggi di parole, raggruppati per canzone, in base alla posizione nelle classifiche Billboard. Scompatta di nuovo i testi di prince senza filtrare alcuna parola per ottenere un conteggio reale della frequenza delle parole nelle canzoni. Usa ancora group_by() e summarise() per ottenere i conteggi. Quindi usa il verbo arrange() di dplyr per ordinare per conteggio. Prima osserva i conteggi più alti, poi usa ggplot() per l’istogramma.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Song Count") +
    xlab("Word Count per Song") +
    ggtitle("Word Count Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
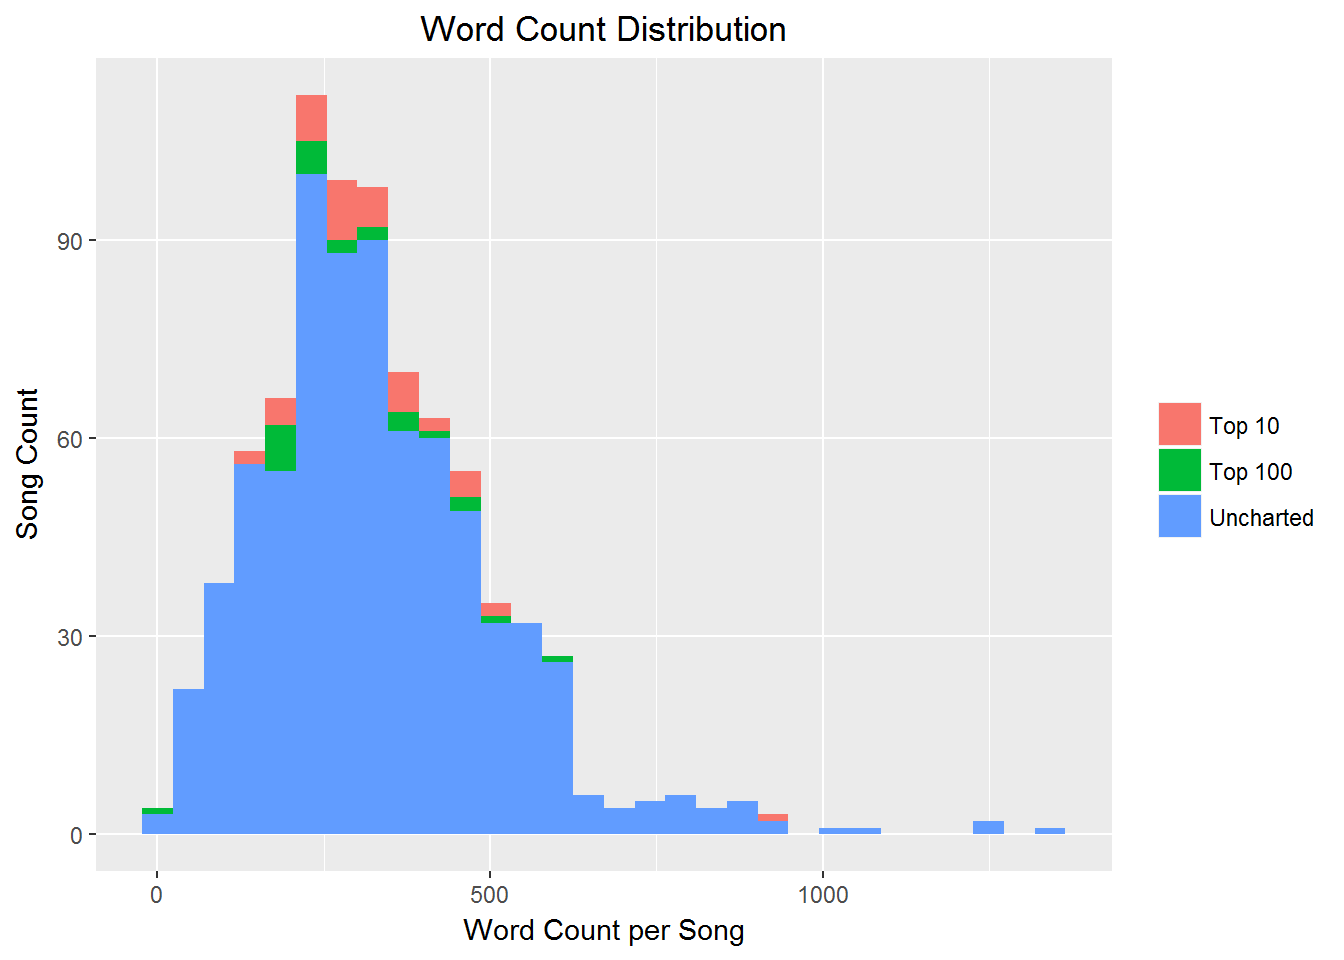
Nota che è asimmetrica a destra. Dato il modo in cui i testi sono stati trascritti, sono scettica riguardo a possibili errori di inserimento dati. Quindi, per curiosità, osserva quella canzone in Top 10 con oltre 800 parole.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Ho fatto qualche ricerca e ho scoperto che questa canzone ha un artista ospite che esegue una parte rap. Questo lo spiega! Ricorda, questo dataset copre le classifiche Pop e R&B a livello globale, quindi il genere e la geografia possono influenzare molto le tue assunzioni. Nota che il posizionamento nella classifica US Pop è stato molto più basso rispetto ad altre classifiche, arrivando per esempio al 5º posto in Canada. Qualcosa da tenere a mente.
Sfida: se sei ispirato a cimentarti nell’analisi musicale in autonomia, potresti dare un’occhiata al Million Song Dataset, che contiene oltre 50 feature (ad es. tempo, loudness, danceability, ecc.) per quasi 50.000 artisti! Aggiungere feature musicali ai testi rende l’analisi davvero completa.
Per fare una semplice valutazione delle parole più usate nell’intero insieme di testi, puoi usare count() e top_n() per ottenere le n parole principali dal tuo dataset pulito e filtrato. Poi usa reorder() per ordinare le parole in base al conteggio e usa il verbo mutate() di dplyr per riassegnare il valore ordinato a word. Questo permette a ggplot() di mostrarle in modo ordinato.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Song Count") +
    ggtitle("Most Frequently Used Words in Prince Lyrics") +
    coord_flip()
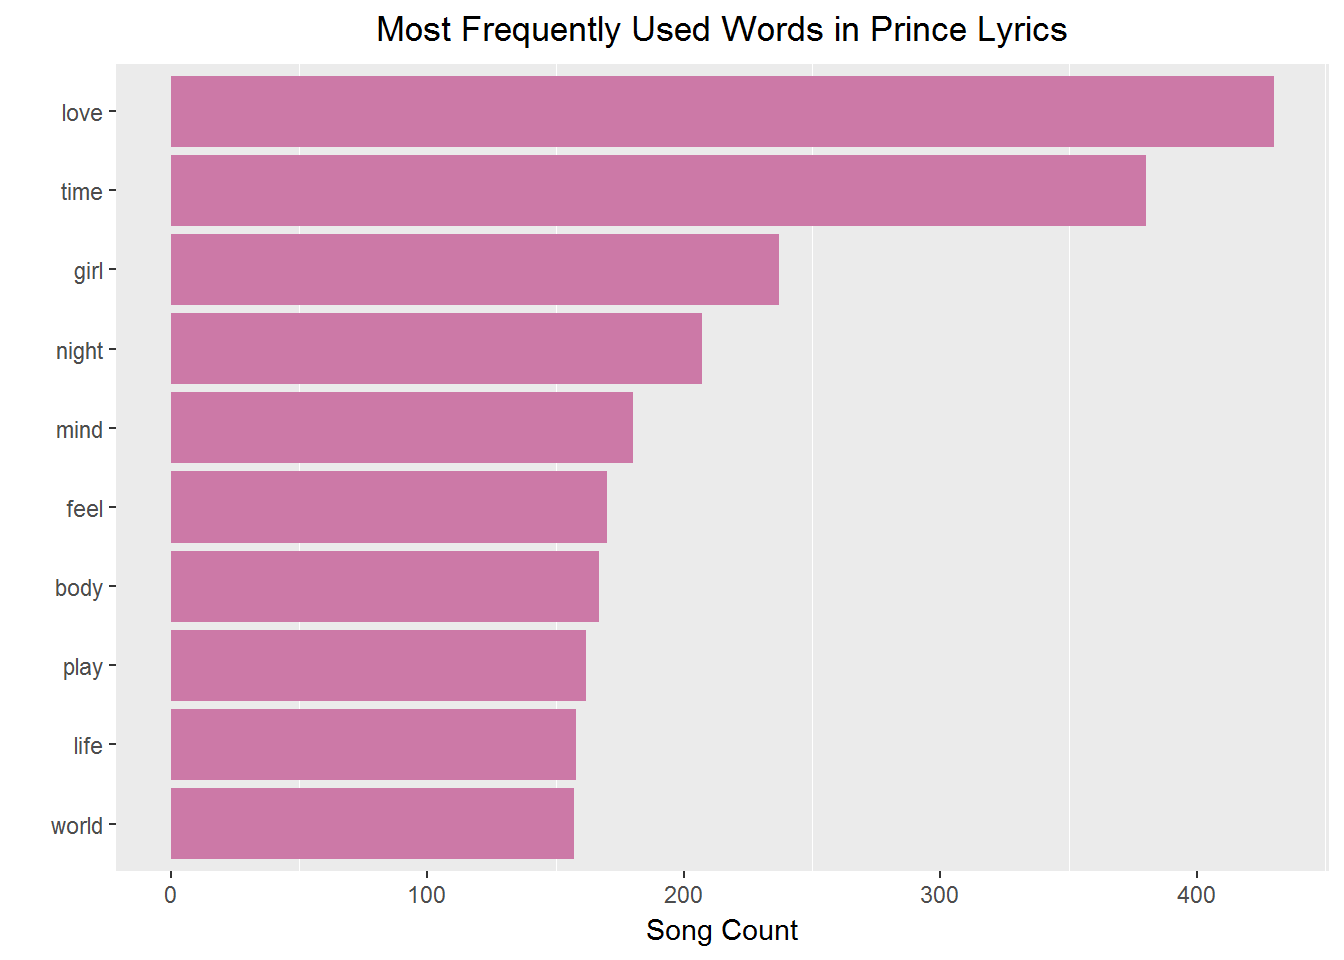
Come nella maggior parte della musica popolare, love sembra essere un tema comune. Non trarrei troppe conclusioni basandomi solo su queste parole principali, ma puoi sicuramente ottenere qualche spunto sulla prospettiva dell’artista, anche se non il quadro completo. Prima di passare a un’indagine più approfondita, prenditi un minuto per divertirti con qualche visual.
Le word cloud hanno cattiva fama in certi ambienti e, se non usate con attenzione, possono essere proposte fuori contesto dove non sono appropriate. Tuttavia, per natura siamo tutti molto visivi e ci sono casi in cui si possono trarre veri insight. Vedi alcuni esempi di Sandy McKee qui. Usale semplicemente con il giusto senso critico.
Per ora, però, dai un’occhiata a un nuovo pacchetto chiamato wordcloud2 per cose davvero interessanti. Questo pacchetto offre una raccolta creativa di cloud che generano widget html. Puoi persino passare il mouse su una parola per vederne la frequenza nel testo. (Questo pacchetto può essere lento a renderizzare in rMarkdown ed è spesso esigente sul browser usato. Speriamo in miglioramenti.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
E per un po’ di divertimento in più, puoi aggiungere un pizzico di data art…
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
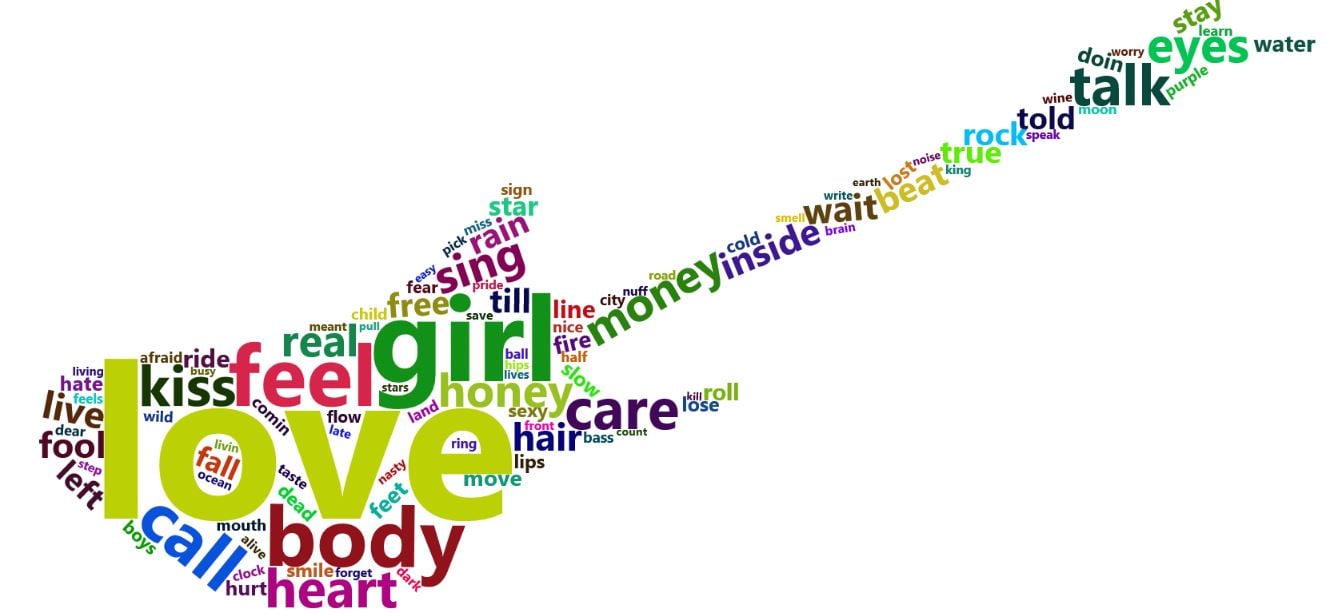
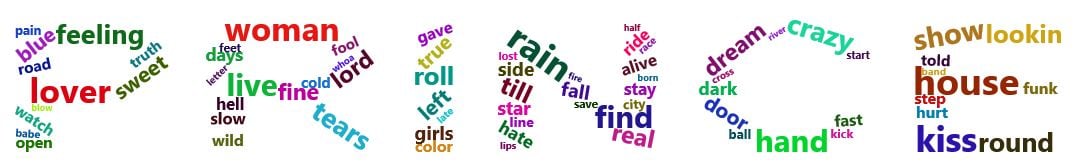
Finora hai visto solo le parole principali in tutte le canzoni. Cosa succede se le suddividi per livello di classifica? Alcune parole sono più diffuse nelle canzoni entrate in classifica rispetto a quelle fuori classifica? Queste sono considerate parole popolari per la società.
Nota nel codice sotto l’uso di slice(seq_len(n)) per prendere le prime n parole in ciascun chart_level. Questo funziona in modo diverso da top_n() e si rivela una buona scelta quando usi il faceting nel grafico. (Ricorda che ci sono sempre modi diversi per fare questi "trucchi".) Puoi anche usare la funzione row_number() per assicurarti di elencare le parole nell’ordine giusto nel grafico. Per impostazione predefinita ggplot() ordinerebbe le parole in ordine alfabetico ed è buona pratica effettuare l’ordinamento prima del grafico.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Popular Words by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
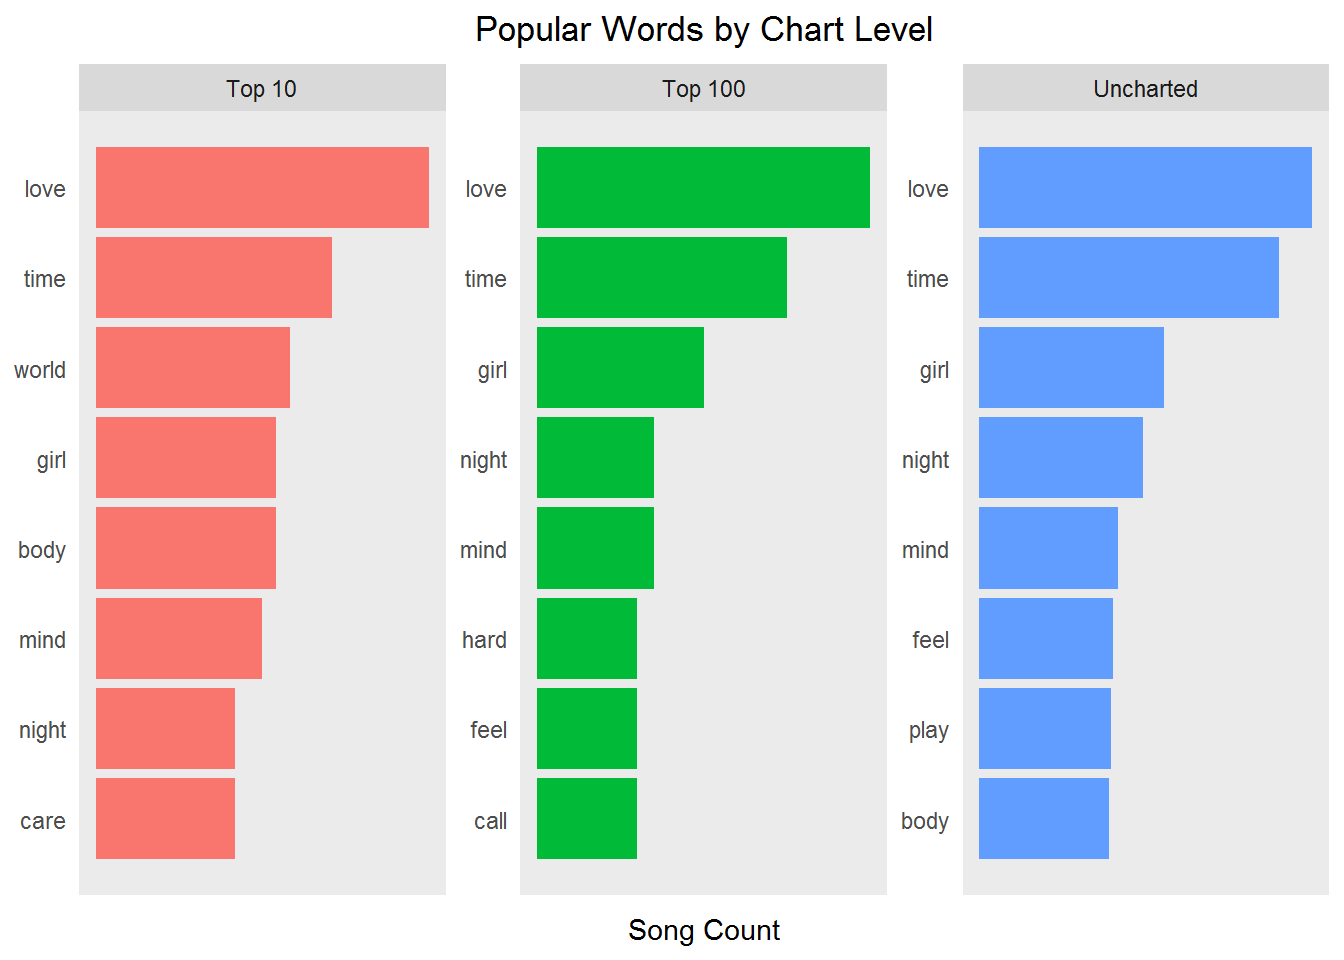
Che insight ricavi ora?
Beh, le parole principali tra i livelli di classifica sono molto, molto simili. Non è un buon segnale per le nostre speranze di prevedere se una canzone avrà successo basandoci sui testi! Ma hai solo scalfito la superficie di ciò che è possibile con il text mining e, in seguito, con NLP e modelli predittivi.
Alcune parole nella musica sono considerate senza tempo. Le parole senza tempo resistono nel tempo, piacendo a un pubblico vasto. Se scomponi l’analisi per decenni, queste parole risaltano. Usa filtri, raggruppamenti e aggregazioni per ottenere le parole principali per ogni decennio dai testi di Prince e vedere quali parole possono essere considerate senza tempo o alla moda. Puoi usare ggplot() con facet_wrap() per visualizzare per decennio.
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Song Count") +
    ggtitle("Timeless Words") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
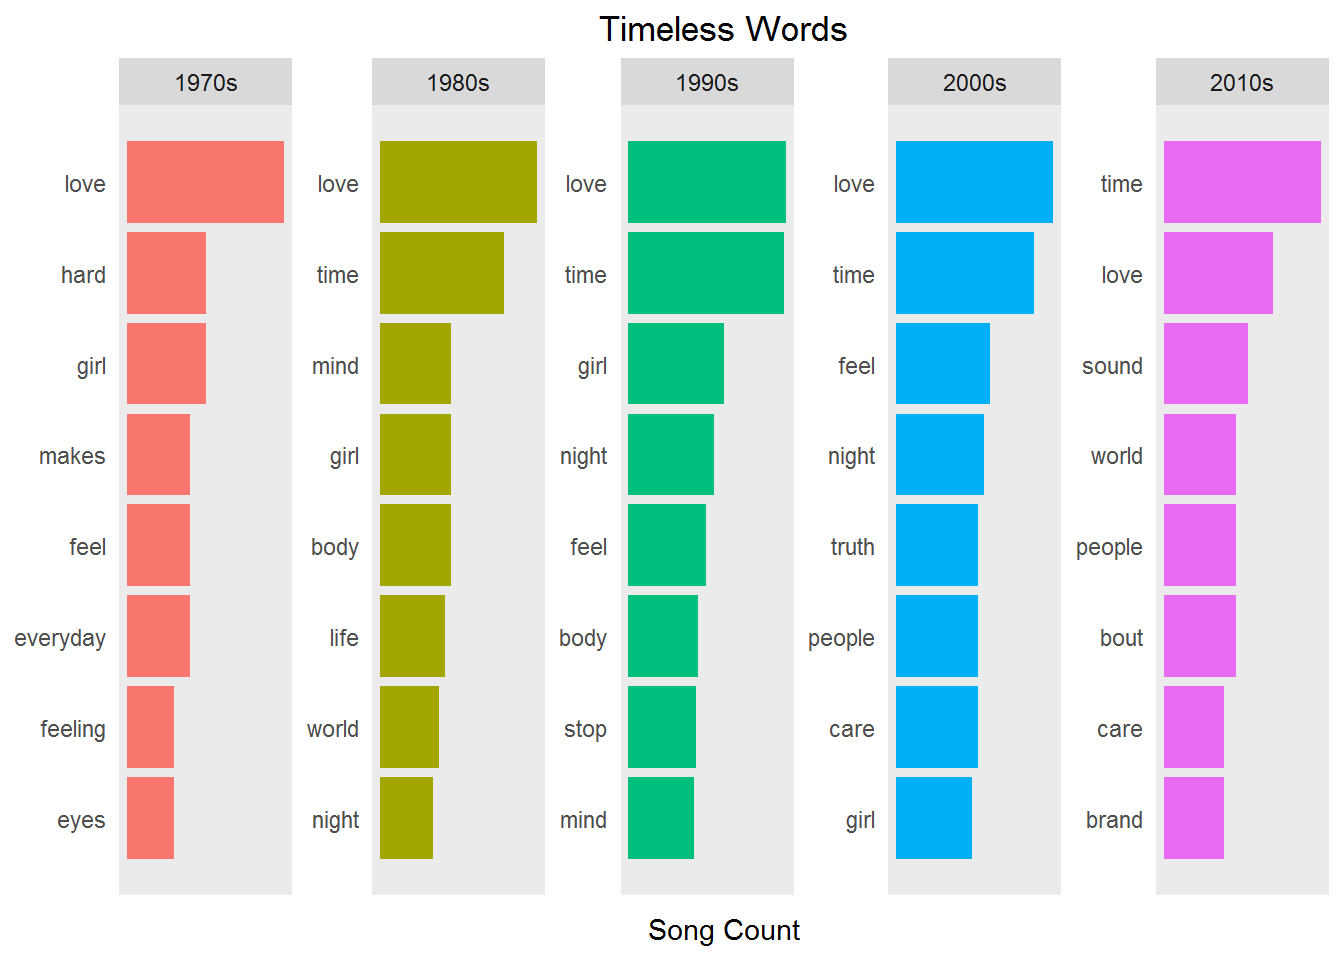
Chiaramente love, time e girl sono senza tempo. Ma quanto è facile individuare parole di tendenza? Truth era di tendenza a cavallo del secolo? Potrebbe semplicemente essere che una parola come it sia molto ripetuta in certe canzoni? La frequenza identifica davvero i temi? Funziona per i testi allo stesso modo che per altri compiti di text mining, come l’analisi dei discorsi sullo Stato dell’Unione?
La lunghezza delle parole è un tema interessante per i parolieri. Più lunga è la parola, più è difficile farla rimare e inserirla in uno schema. L’istogramma delle lunghezze delle parole mostrato sotto è come ti aspetteresti, con poche eccezioni incredibilmente lunghe.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Word Length") +
    ylab("Word Count") +
    ggtitle("Word Length Distribution") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
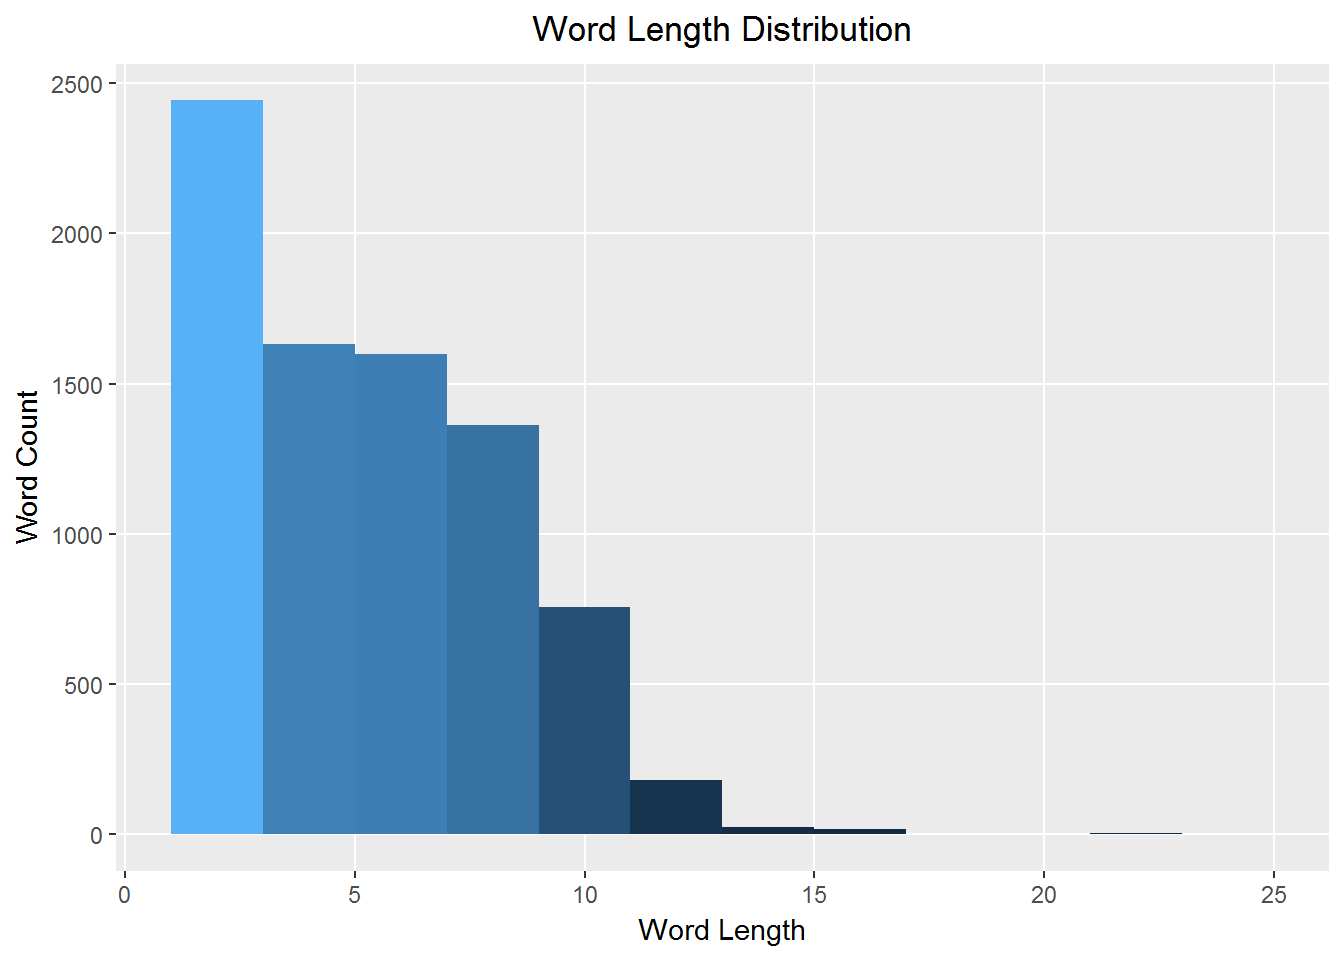
Quali sono quelle parole lunghissime? Questo richiede una word cloud totalmente divertente! È basata sulla lunghezza delle parole anziché sulla frequenza. Dai un’occhiata:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Più variegato è il vocabolario di un testo, maggiore è la sua diversità lessicale. Il vocabolario di una canzone rappresenta quante parole uniche vengono usate in una canzone. Questo può essere mostrato con un grafico semplice della media delle parole uniche per canzone negli anni. Vorrai tokenizzare di nuovo il dataset originale ma lasciare dentro tutte le stop word e le parole corte, dato che in questo grafico cerchi insight più quantitativi.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexical Diversity") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
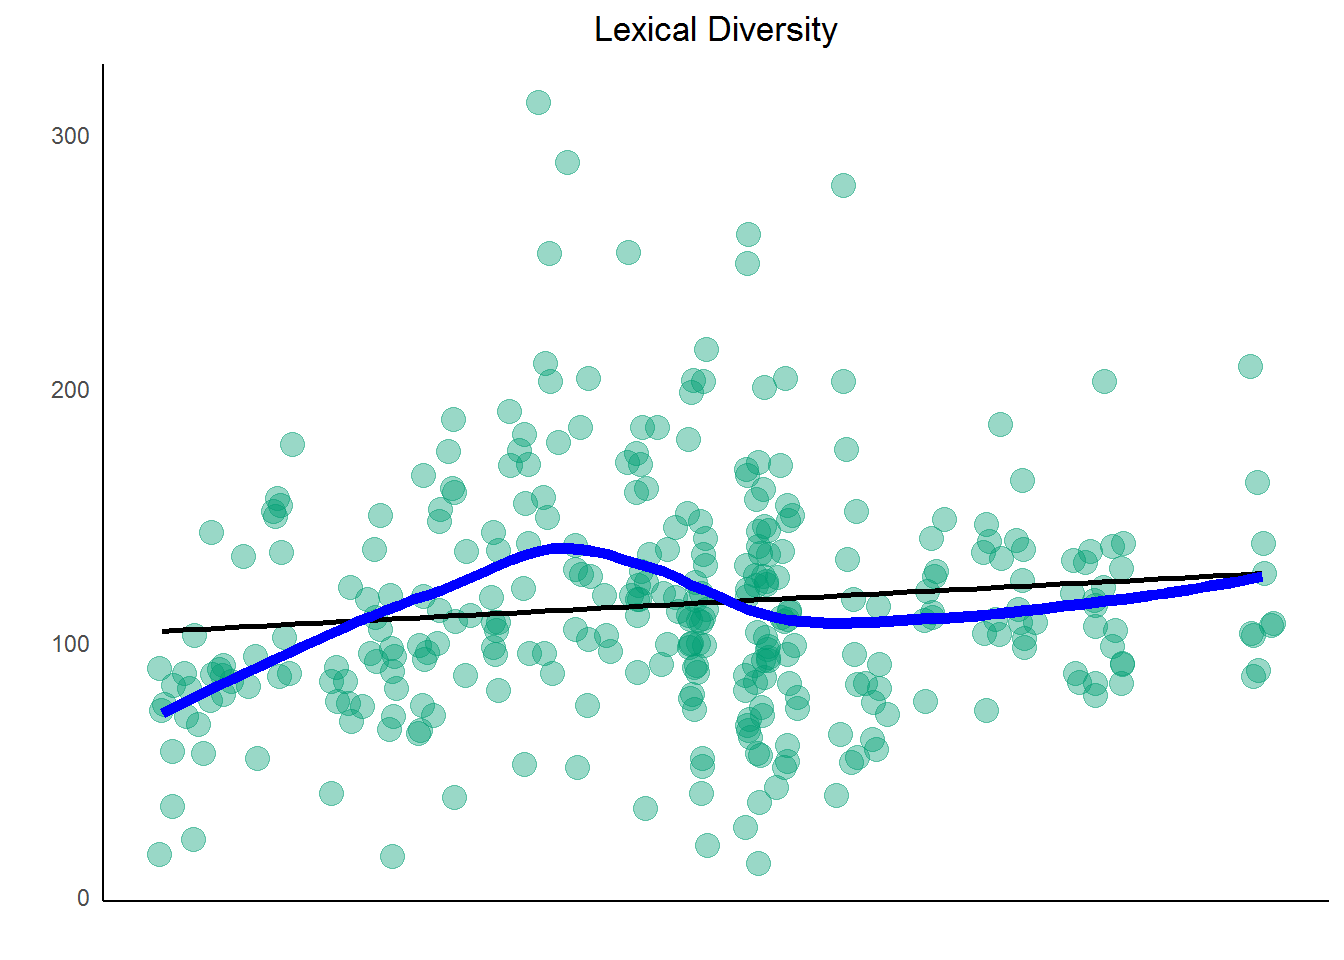
Cosa significa? Negli ultimi decenni c’è stata una leggera tendenza al rialzo nella diversità dei testi di Prince. Come si correla questo al successo in classifica? Difficile dirlo, ma procedi a tracciare densità e storia in classifica per un ulteriore confronto.
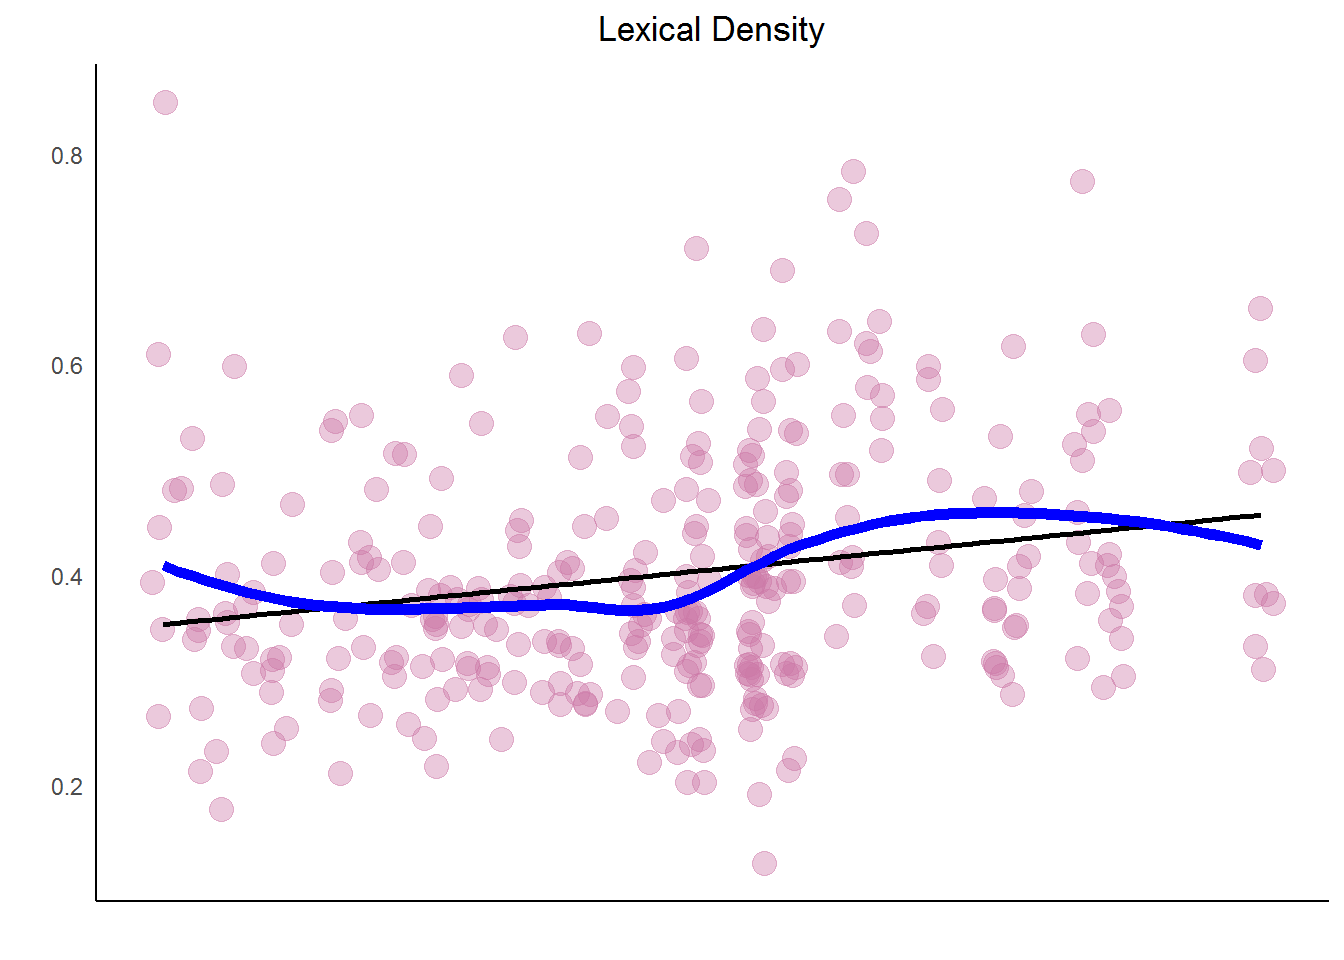
Ricorda che per questo tutorial la densità lessicale è definita come il numero di parole uniche diviso per il totale delle parole. È un indicatore della ripetizione, che è uno strumento fondamentale per i parolieri. All’aumentare della densità lessicale, la ripetizione diminuisce. (Nota: questo non implica ripetizione sequenziale, che è un altro trucco di scrittura.)
Osserva la densità lessicale di Prince nel corso degli anni. Per la densità, è meglio mantenere tutte le parole, comprese le stop word. Quindi parti dal dataset originale e disinnesta le parole. Raggruppa per canzone e anno e usa n_distinct() e n() per calcolare la densità. Passa il tutto a ggplot() con geom_smooth(). Aggiungi anche uno stat_smooth() con method="lm" per una curva di regressione lineare.
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexical Density") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
Per confrontare le tendenze, crea un grafico per la sua storia in classifica (cioè le canzoni di successo entrate in classifica) e confrontalo con diversità e densità. Usa grid.arrange() da gridExtra per tracciarli affiancati.
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Chart History") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
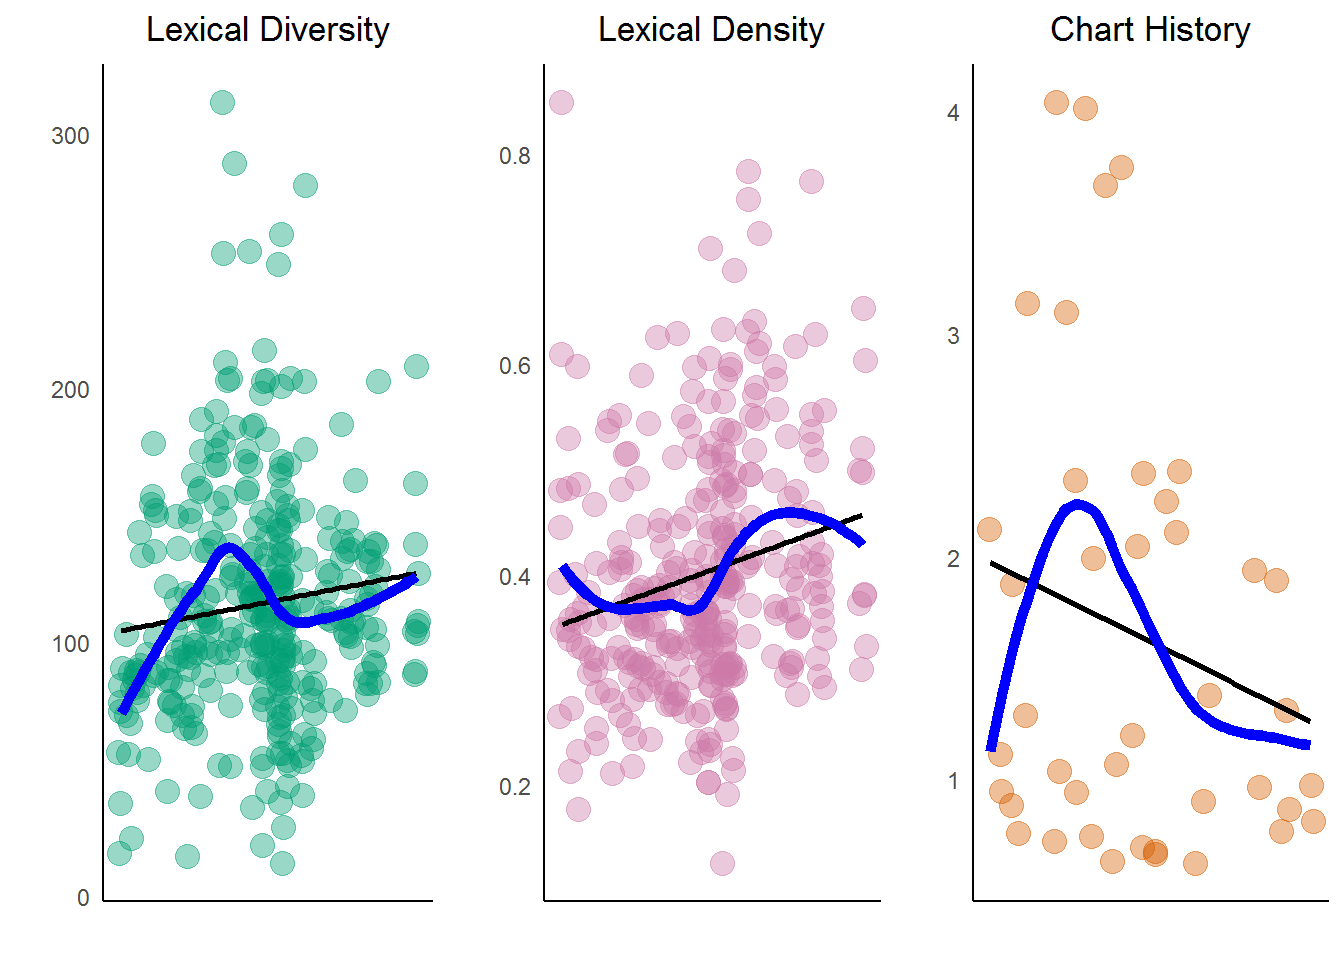
Dal grafico sopra, vedi che c’è un leggero aumento nella diversità e densità lessicale di Prince nel tempo. Come si confronta questa tendenza con tutta la musica popolare? Uno studio mostra che le Hit hanno visto un calo della densità lessicale, indicando una maggiore ripetizione (cioè "più parole con meno da dire"). Non è ciò che è accaduto con le canzoni di Prince. Un altro studio rivela che nella musica popolare in generale la diversità (parole uniche) è aumentata nel tempo, il che correla positivamente con la musica di Prince. Forse è legato a una maggiore diversità di generi nelle classifiche nel corso della storia. Il genere è un’informazione fondamentale che non è presente in questo dataset. Potrebbe essere che la sua storia in classifica diminuisca per la musica pop ma aumenti per R&B/Rap?
Sfida: ti lascio riflettere su questi risultati e ti incoraggio a cercare dataset diversi su cui mettere in pratica queste competenze! Ricorda soltanto: la correlazione non implica causalità.
Il metodo usato finora guarda all’intero dataset, ma non ha affrontato come quantificare quanto siano importanti i vari termini in un documento rispetto all’intera collezione. Hai esaminato la frequenza dei termini e rimosso le stop word, ma potrebbe non essere l’approccio più sofisticato.
Entra in gioco il TF-IDF. TF è "term frequency". IDF è "inverse document frequency", che assegna un peso inferiore alle parole comunemente usate e un peso superiore alle parole poco usate in una collezione di testi. Combinando TF e IDF, l’importanza di un termine viene aggiustata in base alla sua rarità. L’assunto dietro TF-IDF è che i termini che compaiono più frequentemente in un documento dovrebbero avere un peso più alto, a meno che non compaiano anche in molti documenti. La formula può essere riassunta così:
L’IDF di qualsiasi termine è quindi un numero più alto per le parole che compaiono in meno documenti della collezione. Puoi usare questo nuovo approccio per esaminare le parole più importanti per livello di classifica con la funzione bind_tf_idf() fornita da tidytext. Questa funzione calcola e unisce TF e IDF, insieme al prodotto TF*IDF. Accetta in input un dataset tidy con una riga per token (parola), per documento (canzone). Vedrai i risultati in nuove colonne.
Quindi, prendi il data frame originale di Prince e disinnesta i token in parole, rimuovi le parole indesiderate, ma lascia dentro le stop word. Poi usa bind_tf_idf() per applicare le formule e creare nuove colonne.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Ora puoi vedere che IDF e TF-IDF sono 0 per parole estremamente comuni. (Tecnicamente, il termine IDF sarà il log naturale di 1 e dunque sarà zero per queste parole.) Passa i risultati di sopra ad arrange() e ordina in modo decrescente per tf-idf. Aggiungi qualche altro passaggio e vedrai un modo diverso di guardare alle parole nei testi di Prince.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Chart Level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
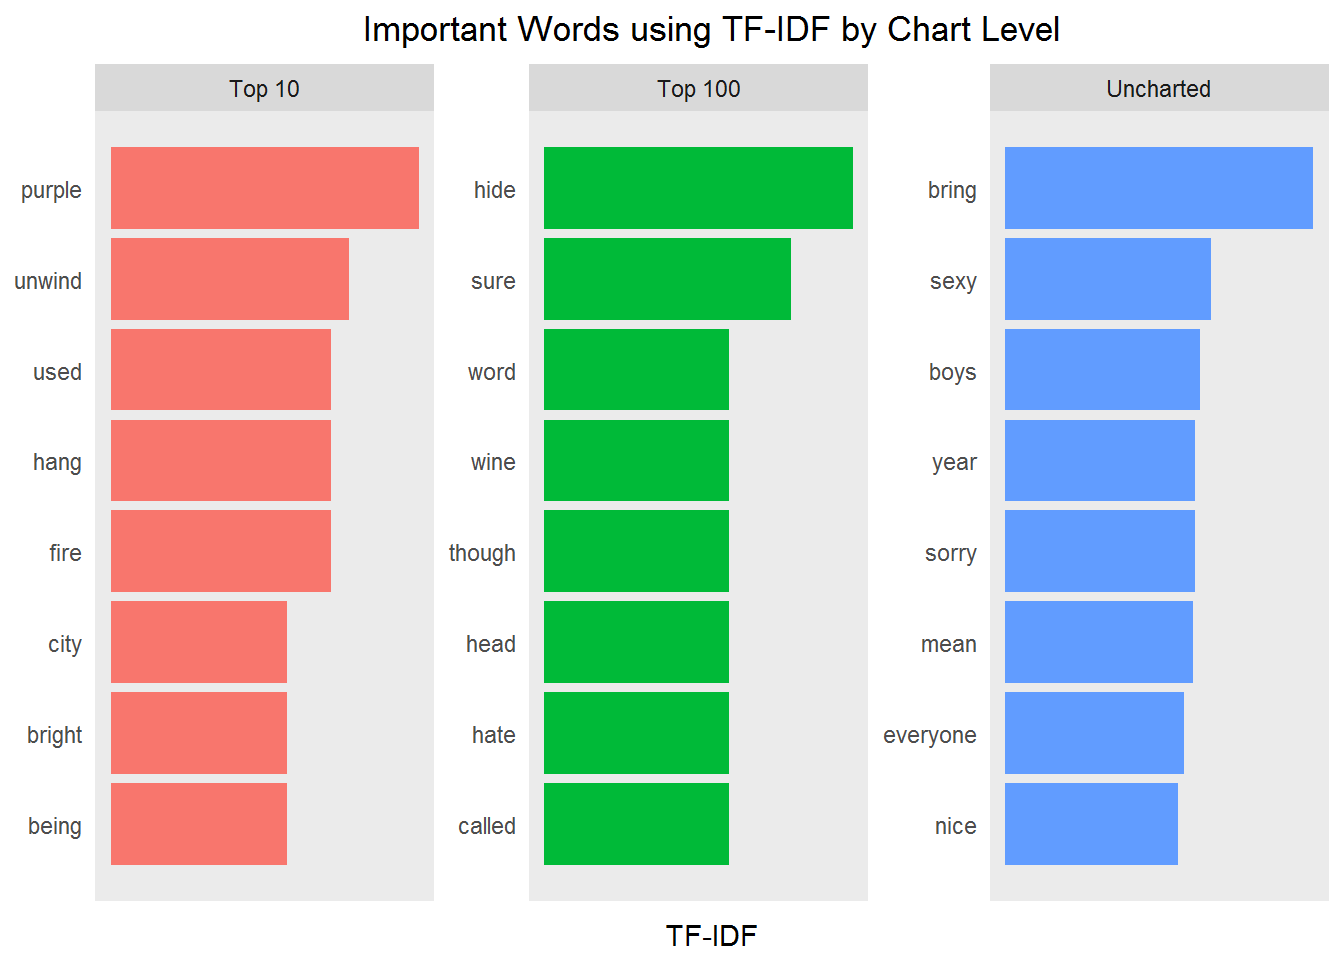
Wow, usare TF-IDF ci offre certamente una prospettiva diversa sulle parole potenzialmente importanti. Ovviamente, l’interpretazione è puramente soggettiva. Noti qualche pattern?
Ora dai un’occhiata al TF-IDF nel tempo:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Important Words using TF-IDF by Decade") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
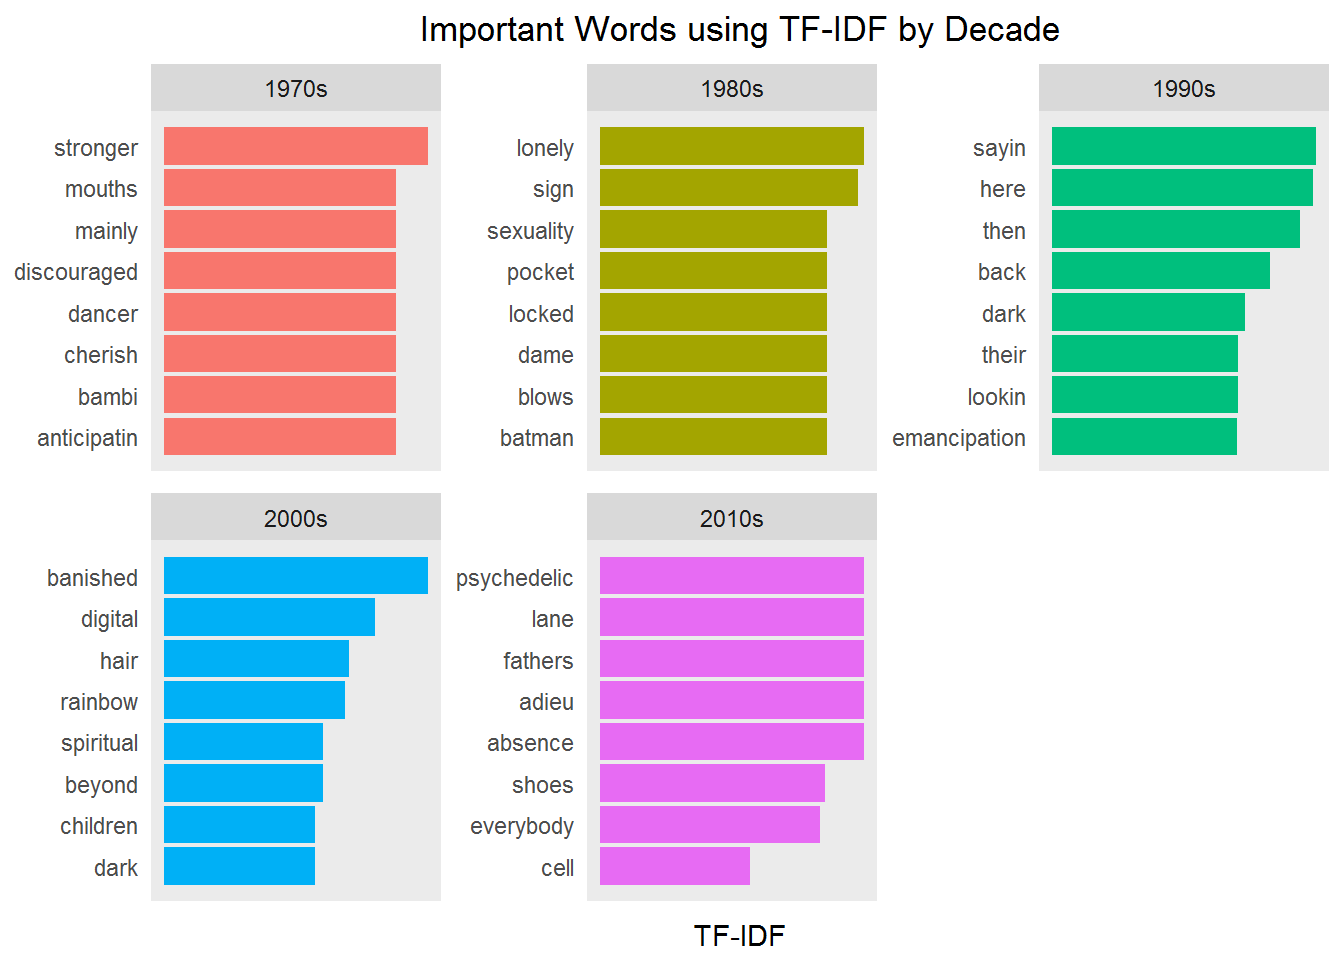
Ora stai sicuramente ottenendo un livello d’insight più profondo. Le parole senza tempo non sono più predominanti. Stai iniziando a vedere emergere argomenti o temi? È davvero possibile con solo poche parole per gruppo? Porterai questo a un nuovo livello nel secondo tutorial (Parte Due: Sentiment Analysis e Topic Modeling con NLP).
Una rapida word cloud con questo metodo mostra una nuova prospettiva sulle parole importanti nei testi di Prince ed è un po’ più interessante…
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
In questo case study, hai prima dato uno sguardo ai dati effettivi, soffermandoti solo sulle basi. Dopo alcune operazioni di conditioning come la pulizia dei dati e la rimozione di parole non informative, hai iniziato un’analisi esplorativa a livello di canzone.
Successivamente, sei entrato più in profondità nel text mining disinnestando i testi in parole tokenizzate per poter osservare la complessità lessicale. I risultati forniscono insight cruciali per i prossimi passi di sentiment analysis e topic modeling.
Infine, hai utilizzato l’analisi TF-IDF per rappresentare l’informazione che una parola contiene in un documento in relazione a un certo esito di interesse. Potresti pensare che sia un buon modo per identificare temi nella musica, ma in realtà hai solo metà della storia. La Parte Due affronta un metodo di apprendimento non supervisionato chiamato Latent Dirichlet Allocation (LDA). Come in tutti gli aspetti della Data Science, ci sono molti metodi tra cui scegliere per ottenere insight. E nelle Parti Due e Tre di questo case study, affronterai altre di queste opzioni.
Spero che tu sia entusiasta quanto me di proseguire questo viaggio dall’analisi esplorativa fino alla sentiment analysis, al topic modeling e agli insight predittivi.
Grazie per la lettura, e spero di rivederti nel prossimo tutorial!
Scopri di più su R e Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



