Curso
Machine Learning con caret en R
4 h
61K
Esta es la primera parte de una serie de tres tutoriales en los que usarás R para realizar varias tareas de análisis sobre un caso práctico de letras musicales del legendario artista Prince. Los tres tutoriales cubren lo siguiente:
Las letras pueden reflejar la mirada del artista, pero las canciones populares revelan lo que la sociedad quiere escuchar. Analizar letras no es tarea fácil. Como su estructura suele diferir de la prosa, exige prudencia con las suposiciones y una elección muy afinada de técnicas analíticas. Las letras impregnan nuestra vida e influyen en nuestras ideas con una ubicuidad sutil. El concepto de letras predictivas empieza a sonar con fuerza y gana presencia en artículos académicos y tesis. Este caso práctico solo rozará algunas piezas de este tema emergente.
Para celebrar la inspiradora y diversa obra que nos dejó Prince, explorarás los mensajes a veces obvios y, a menudo, ocultos de sus letras. No hace falta que te guste su música para apreciar la influencia que tuvo en el desarrollo de muchos géneros a escala global. La revista Rolling Stone incluyó a Prince en el puesto 18 de los mejores compositores de todos los tiempos, justo detrás de figuras como Bob Dylan, John Lennon, Paul Simon, Joni Mitchell y Stevie Wonder. El análisis de letras empieza a hacerse un hueco en la comunidad de ciencia de datos a medida que la posibilidad de predecir "éxitos" se acerca a la realidad.
Prince era un hombre desbordante de música: un compositor prolífico a lo loco, un virtuoso de guitarras, teclados y batería, y un maestro arquitecto del funk, el rock, el R&B y el pop, aunque su música desafiaba los géneros. - Jon Pareles (NY Times)
En este tutorial, la Parte uno de la serie, utilizarás técnicas de minería de texto sobre un conjunto de letras con el marco tidy text. Los conjuntos de datos "tidy" tienen una estructura específica: cada variable es una columna, cada observación es una fila y cada tipo de unidad observacional es una tabla. Tras limpiar y acondicionar el conjunto de datos, crearás estadísticas descriptivas y visualizaciones exploratorias analizando distintos aspectos de las letras de Prince.
La Parte uno de esta serie requiere entender lo básico de datos "tidy": en concreto, paquetes como dplyr para transformar datos, ggplot2 para visualizaciones y el operador %>% pipe original del paquete magrittr. Cada tutorial describirá las herramientas que puedes usar en el análisis, pero puede que no entre en detalle en cada paso. Verás que varios pasos suelen encadenarse con el operador %>%. Al ser también un caso práctico, es importante recordar que todas las inferencias son puramente observacionales; correlación no implica causalidad.
Consejo: para profundizar en las herramientas usadas, dos buenas referencias son R for Data Science, de Garrett Grolemund y Hadley Wickham, y Text Mining with R, de Julia Silge y David Robinson.
Partes dos y tres
En un tutorial aparte, la Parte dos, verás análisis de sentimiento y modelado de temas para capturar el ánimo general y los temas de la música de Prince y su aplicación a perspectivas sociales. Trabajarás con un léxico de sentimientos, evaluarás sentimientos binarios y categóricos, representarás tendencias en el tiempo y explorarás n-gramas y asociaciones de palabras. También usarás procesamiento del lenguaje natural (PLN) y técnicas de clustering como Latent Dirichlet Allocation (LDA) y K-Means para destilar motivos en las letras.
En otro tutorial, la Parte tres, cerrarás el círculo usando los resultados exploratorios para ayudar a predecir en qué década se publicó una canción y, más interesante aún, si entrará en las listas de Billboard a partir de sus letras. Utilizarás herramientas de machine learning como árboles de decisión (rpart y C50), K-Nearest Neighbors (class) y Naive Bayes (e1071) para crear un clasificador que acepte texto.
Las tres partes utilizan el mismo conjunto de datos con letras de Prince, año de publicación y posiciones en Billboard. Las técnicas de este estudio pueden aplicarse también a muchos otros tipos de texto. De hecho, en prosa estándar los resultados suelen interpretarse con más facilidad porque las letras, en general, se diseñan con mensajes indirectos y matices sutiles.
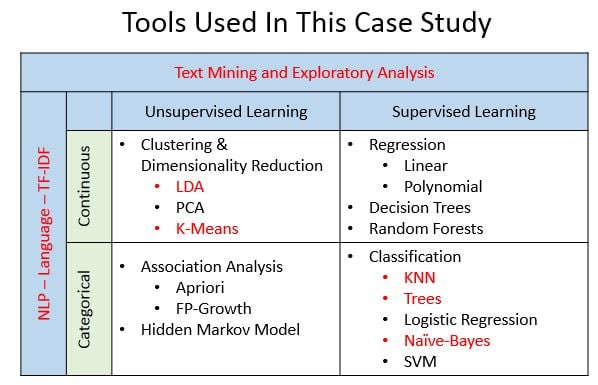
En resumen, hay muchos métodos para analizar letras. Estos tutoriales cubren los que figuran en rojo en el gráfico inferior. Ten en cuenta que el gráfico es solo una representación de alto nivel de una imagen muy "borrosa". Y no, no me refiero a la calidad de la imagen. La realidad es que los aspectos de modelado y de las técnicas de machine learning se difuminan cada vez más y no encajan necesariamente en una sola casilla como la que se muestra. Ponte unas gafas 3D al mirarla y quizá cobre más sentido.
Además de aprender y practicar nuevas habilidades, este tutorial intenta responder a preguntas básicas sobre el análisis de letras. Estudios recientes muestran que la "inteligencia lírica" podría estar disminuyendo en la música popular. Algunos incluso sugieren que las palabras usadas en los No. 1 se alinean con niveles de lectura de alumnado de 3.º de primaria en EE. UU. ¿Es posible usar minería de texto, PLN, machine learning y otros métodos de ciencia de datos para arrojar luz sobre un tema así? ¿Se pueden identificar temas que atraen a la sociedad según la recepción de una canción? ¿Se puede predecir si una canción funcionará bien solo a partir de sus letras? En este primer tutorial, examinarás la complejidad léxica de la música de Prince como ejercicio exploratorio.
Antes de empezar, piensa qué quieres descubrir. ¿Qué preguntas te interesan? Primero recorrerás un análisis del conjunto de datos. ¿Cómo es? ¿Cuántas canciones hay? ¿Cómo están estructuradas las letras? ¿Cuánta limpieza y preparación hacen falta? ¿Qué hechos hay? ¿Cuáles son las frecuencias de palabras y por qué importan? Desde el punto de vista técnico, quieres entender y preparar los datos para análisis de sentimiento, PLN y modelos de machine learning.
La música ha sido durante mucho tiempo una forma efectiva de comunicarse con las masas, y las letras han jugado un papel enorme en esa comunicación. Y aun así, la oportunidad de investigar el efecto de las letras en el bienestar [de la sociedad] está ampliamente desaprovechada. - Patricia Fox Ransom
Un método habitual para obtener datos para minería de texto es usar el paquete rvest para extraer contenido de la web. Pude extraer información de las listas Billboard y letras de Prince de varios sitios y unirlos por título de canción. Hubo que hacer algo de wrangling por las convenciones de nombres inconsistentes en los títulos. Tomé la decisión subjetiva de eliminar todas las canciones que no fueran versiones originales (remixes, extended versions, club mixes, remakes, etc.). También quité álbumes que eran recopilatorios de sus éxitos para evitar repeticiones. Hice una limpieza ligera y guardé el resultado en un archivo csv para este tutorial.
Como la Parte uno se centra en minería de texto, no he incluido ese código aquí, pero el conjunto de datos está disponible para descarga aquí si quieres seguir el proceso.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Hay varios métodos para leer un csv, pero en este caso uso read.csv() para cargar un data frame con letras, año de publicación y posiciones en las listas de Billboard. Ten en cuenta que, por defecto, R convierte las cadenas de caracteres en factores. Esto puede dar problemas más adelante, pero puedes evitarlo estableciendo stringsAsFactors a FALSE. Ahora, a examinar los datos…
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Puedes usar la función names() para ver las columnas del data frame:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Como yo creé este archivo, sé que X es solo un número de fila y text son las letras. Los otros campos necesarios incluyen song, year y peak (su posición en las listas de Billboard). US.Pop y US.R.B son posiciones máximas en las listas de EE. UU. (Pop y R&B), así que conviene mantenerlos y descartar el resto por ahora.
Hazlo tomando el dataset original, prince_orig, y encadenándolo con select() usando %>%. Así puedes leer el código de izquierda a derecha.
Fíjate también en que select() permite renombrar columnas en el mismo paso. Cambia text a lyrics y renombra las columnas de EE. UU. al estilo tidyverse usando "_" en lugar de ".". Guarda el resultado en prince, que usarás durante los tutoriales. dplyr ofrece glimpse() para ver rápidamente los datos en formato transpuesto.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
La primera pregunta evidente es: ¿cuántas observaciones y columnas hay?
dim(prince)
[1] 824 7
Con dim() ves que hay 7 columnas y 824 observaciones. Cada observación es una canción. Ya lo dije… ¡prolífico!
Si miras la columna lyrics de una de las canciones, puedes ver su estructura.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Hay muchas oportunidades de limpieza, así que manos a la obra.
Hay distintos métodos para acondicionar los datos. Una opción sería convertir el data frame en un Corpus y una Document Term Matrix con el paquete tm y luego usar tm_map() para limpiar, pero en este tutorial nos ceñiremos a lo básico con gsub() y funciones apply() para el trabajo sucio.
Primero, elimina las contracciones creando una función que cubra la mayoría de casos con gsub() y aplícala a todas las letras.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
También verás caracteres especiales que enturbian el texto. Puedes quitarlos con gsub() y una expresión regular sencilla. Es clave expandir las contracciones antes de este paso.
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Para ser coherente, convierte todo a minúsculas con la práctica función tolower().
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Si examinas ahora las letras, verás una versión más limpia del texto en bruto.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Otro paso habitual en el acondicionamiento para minería de texto es el stemming, o reducir las palabras a su raíz. Es un tema en sí mismo que podremos tratar más adelante. Por ahora, echa un vistazo al resumen del data frame prince.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
Como ves, hay 37 años de canciones y la canción peor posicionada (del dataset) llegó al puesto 88. También se aprecia que hay bastantes NA en year y peak. Como harás distintos tipos de análisis, conserva el conjunto completo en el data frame prince y filtra cuando lo necesites.
Como una de las preguntas objetivo es buscar tendencias por tiempo, y el conjunto incluye años individuales, puedes crear agrupaciones y juntar los años por décadas. Usa mutate() de dplyr para crear el nuevo campo decade. Una forma de crear los grupos es con ifelse() junto con el operador %in% para filtrar por año y ubicar las canciones en décadas. Guarda de nuevo en prince (añadiendo el nuevo campo).
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Puedes hacer lo mismo con chart_level, que representa si una canción alcanzó Top 10, Top 100 o no entró en listas (uncharted). Son categorías mutuamente excluyentes, así que Top 100 no incluye Top 10.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Además, crea un campo binario llamado charted que indique si una canción llegó a las listas de Billboard o no (es decir, si fue popular). Usa write.csv() para guardar y reutilizar en los siguientes tutoriales.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Para personalizar los gráficos, me gusta crear una paleta de colores para mantener la coherencia visual. Hay muchos sitios donde conseguir colores distintos por su código hexadecimal como abajo. Si tienes preferencias, también puedes crear tu propio tema para aplicarlo a ggplot() cuando lo necesites.
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Antes de entrar en minería de texto, empieza con una vista básica de lo que tienes a nivel de canción. Es buen momento para ver cuántas canciones publicó Prince por década. Como recordatorio, su carrera profesional empezó en 1978 y llegó hasta 2015 (según el summary() anterior). Pero como ahora miras tendencias y el dataset tiene muchos valores en blanco en year, conviene filtrar los NA del primer gráfico.
Con filter(), group_by() y summarise() de dplyr puedes agrupar por decade y contar canciones. La función n() es una de varias funciones agregadas útiles con summarise() en datos agrupados. Luego con ggplot() y geom_bar() crea un gráfico de barras y rellena según la categoría charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Canciones publicadas") +
  labs(x = NULL, y = "Número de canciones")
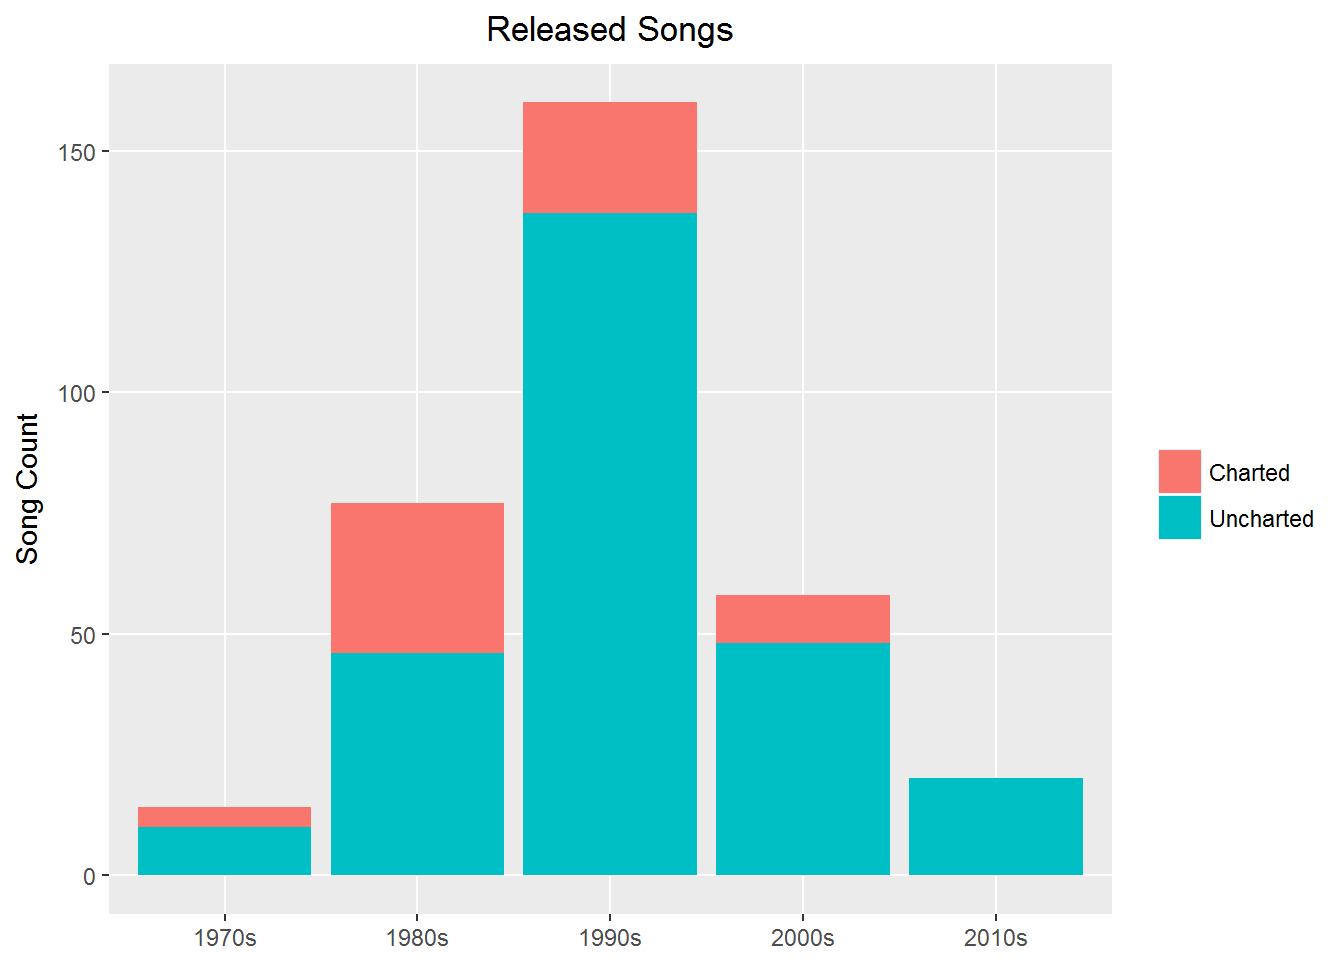
Se ve claramente que su década más activa fueron los 90.
Ahora crea un gráfico similar con chart_level.
Recuerda agrupar con group_by() tanto por decade como por chart_level para apreciar la tendencia.
En este gráfico, solo mirarás las canciones que entraron en listas, así que filtra el resto con peak > 0. Encadena el group_by con summarise() usando n() para contar. Guarda en una variable y pásala a ggplot() para un gráfico de barras sencillo.
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Número de canciones") +
  ggtitle("Canciones en listas")
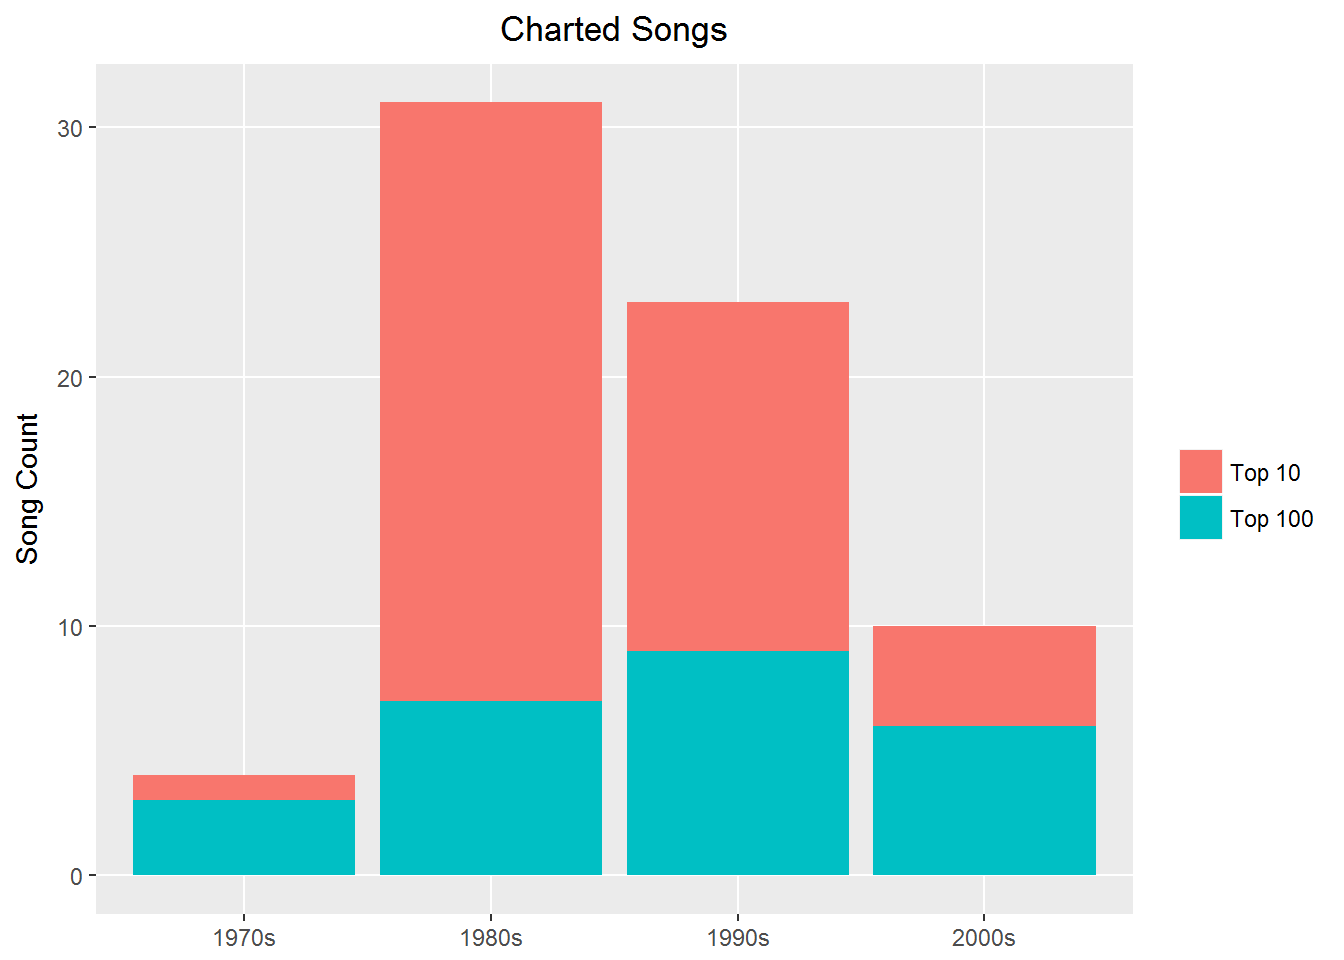
Observa que, de todas las canciones de Prince que entraron en listas, la mayoría alcanzaron el Top 10. Más interesante aún: aunque los 90 fueron su década más prolífica en nuevas canciones, hubo más éxitos en los 80. ¿Por qué? Guarda esta pregunta para las secciones de minería de texto.
Para aprovechar toda la potencia del conjunto completo en el análisis lírico, puedes prescindir de referencias a chart_level y año de publicación y tener así un conjunto mucho mayor que explotar. Mira:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Número de canciones") +
  ggtitle("Todas las canciones del dataset")
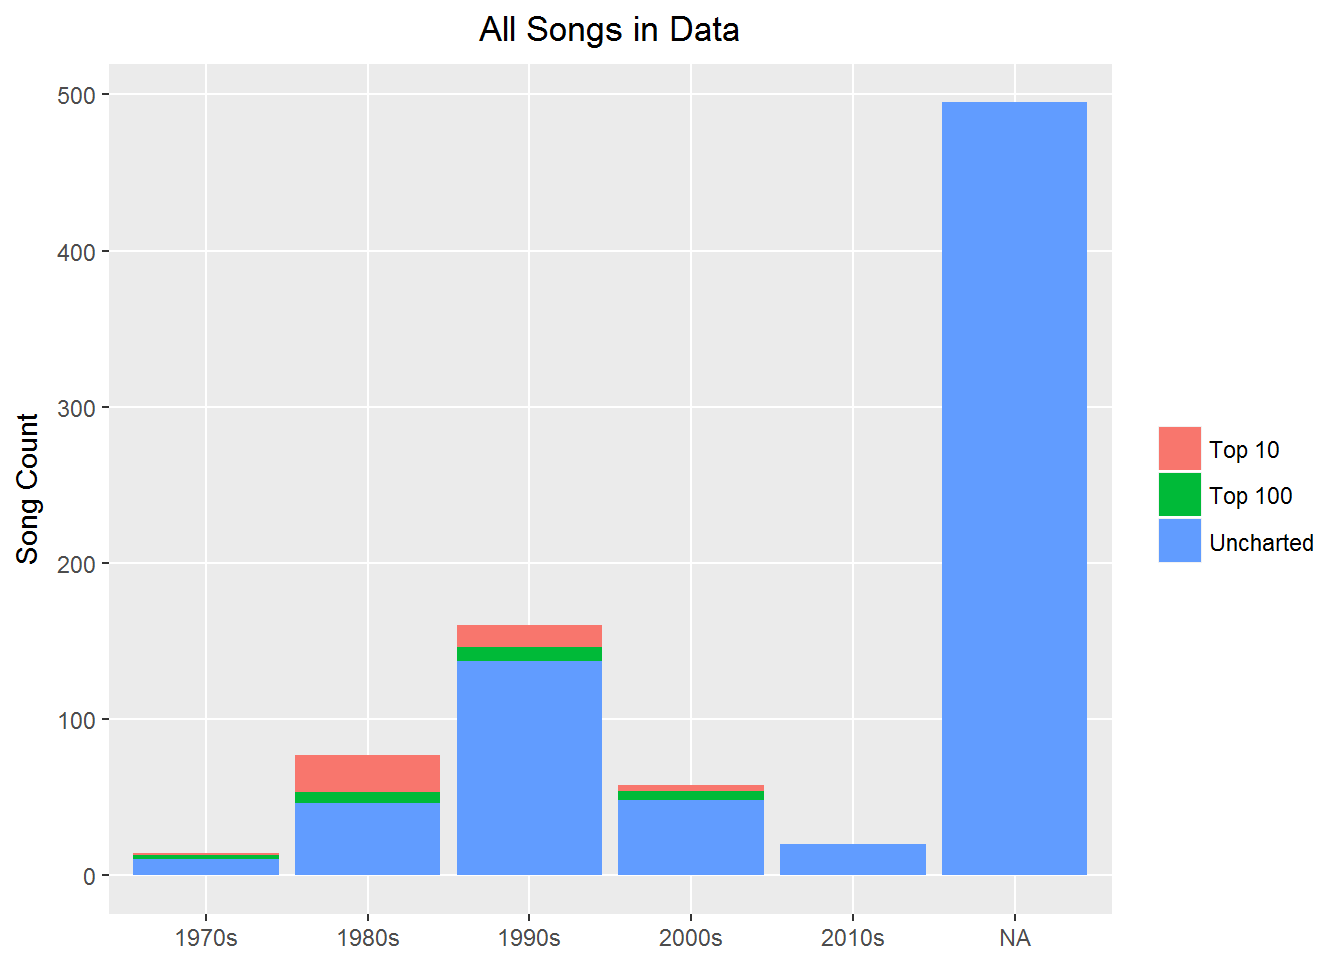
Como ves, Prince escribió cientos de canciones sin fecha de publicación en los datos. Para análisis de sentimiento o exploratorio puedes usar todos los datos, pero para tendencias temporales trabajarás con un subconjunto menor. No pasa nada: solo tenlo presente.
Para fans acérrimos de Prince, aquí va un vistazo rápido a las canciones que alcanzaron el número 1 en las listas. (Observa que puedes usar kable() y kable_styling() de knitr y kableExtra y color_tile() de formattable para producir HTML con formato.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
La minería de texto también se conoce como analítica de texto. El objetivo es descubrir información relevante que quizá sea desconocida o esté enterrada bajo lo obvio. El procesamiento del lenguaje natural (PLN) es una metodología empleada en la minería de texto. Intenta resolver ambigüedades del lenguaje escrito mediante tokenización, clustering, extracción de entidades y relaciones entre palabras, y uso de algoritmos para identificar temas y cuantificar información subjetiva. Empezarás desgranando el concepto de complejidad léxica.
La complejidad léxica puede significar cosas distintas según el contexto, pero de momento asume que puede describirse con una combinación de estas medidas:
Para iniciar el análisis, necesitas dividir las letras en palabras individuales y empezar a extraer insights. Este proceso se llama tokenización.
Recuerda que hay diferentes métodos y formatos de datos para minar texto:
Pero antes de tokenizar, queda un paso más de limpieza. Muchas transcripciones de letras incluyen frases como "Repeat Chorus" o etiquetas como "Bridge" y "Verse". También hay otras muchas palabras indeseables que pueden enturbiar los resultados. Tras análisis previo, he seleccionado algunas que quiero apartar.
Esta es la lista de palabras superfluas a eliminar manualmente:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Para desanidar los tokens, usa la librería tidytext, que ya está cargada. Ahora puedes aprovechar dplyr y encadenar varios pasos.
Desde el marco tidy text, necesitas dividir el texto en tokens (tokenización) y transformarlo a estructura tidy. Para ello, usa unnest_tokens(). Requiere al menos dos argumentos: el nombre de la columna de salida que se creará al desanidar ("word" en este caso) y la columna de entrada que contiene el texto actual (lyrics).
Puedes tomar el dataset prince y pasarlo a unnest_tokens() y luego eliminar stop words. ¿Qué son? Las conoces de sobra: palabras muy comunes que quizá no aporten significado a los resultados. Hay distintas listas; aquí usaremos el léxico stop_words del paquete tidytext.
Usa sample() para mostrar una lista aleatoria de estas stop words y head() para limitar a 15 palabras.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Así que, tras tokenizar las letras en palabras, puedes usar anti_join() de dplyr para quitar stop words. Después, elimina las palabras indeseables definidas antes con filter() y el operador %in%. Luego usa distinct() para retirar duplicados. Por último, elimina todas las palabras con menos de cuatro caracteres. Es una decisión subjetiva, pero en letras suelen ser interjecciones como "yeah" o "hey". Guarda los resultados en prince_words_filtered.
Nota: para referencia, prince_words_filtered es la versión tidy text del data frame prince sin 1) stop words, 2) palabras indeseables y 3) palabras de 1-3 caracteres. La utilizarás en algunos análisis, no en todos.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Observa que stop_words tiene una columna word, y unnest_tokens() creó una nueva columna también llamada word, así que anti_join() une automáticamente por esa columna.
Ahora puedes ver la clase y dimensiones de tu nueva estructura tidy:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered es un data frame con 36916 palabras totales (no únicas) y 10 columnas. Aquí tienes una instantánea: (he elegido una palabra y limitado su aparición en 10 canciones y he usado select() para imprimir los campos interesantes con formato de knitr). Esto muestra la estructura tidy tokenizada y no resumida.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Ves que cada fila contiene una palabra individual repetida por cada canción en la que aparece.
En música, la frecuencia de palabras individuales importa mucho: tanto la repetición como la rareza influyen en la memorabilidad de la canción. Una pregunta que puede hacerse un compositor es si existe correlación entre frecuencia de palabras y éxitos. Así que vamos a llevar el formato tidy un paso más y obtener el recuento de palabras por canción.
Para verlo en las letras de Prince, crea un histograma con la distribución de recuentos de palabras, agrupado por canción, según su posición en Billboard. Desanida de nuevo las letras sin filtrar palabras para obtener un recuento real. De nuevo usa group_by() y summarise() para contar. Luego usa arrange() para ordenar por recuento. Mira primero los valores más altos y después usa ggplot() para el histograma.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Número de canciones") +
    xlab("Palabras por canción") +
    ggtitle("Distribución del recuento de palabras") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
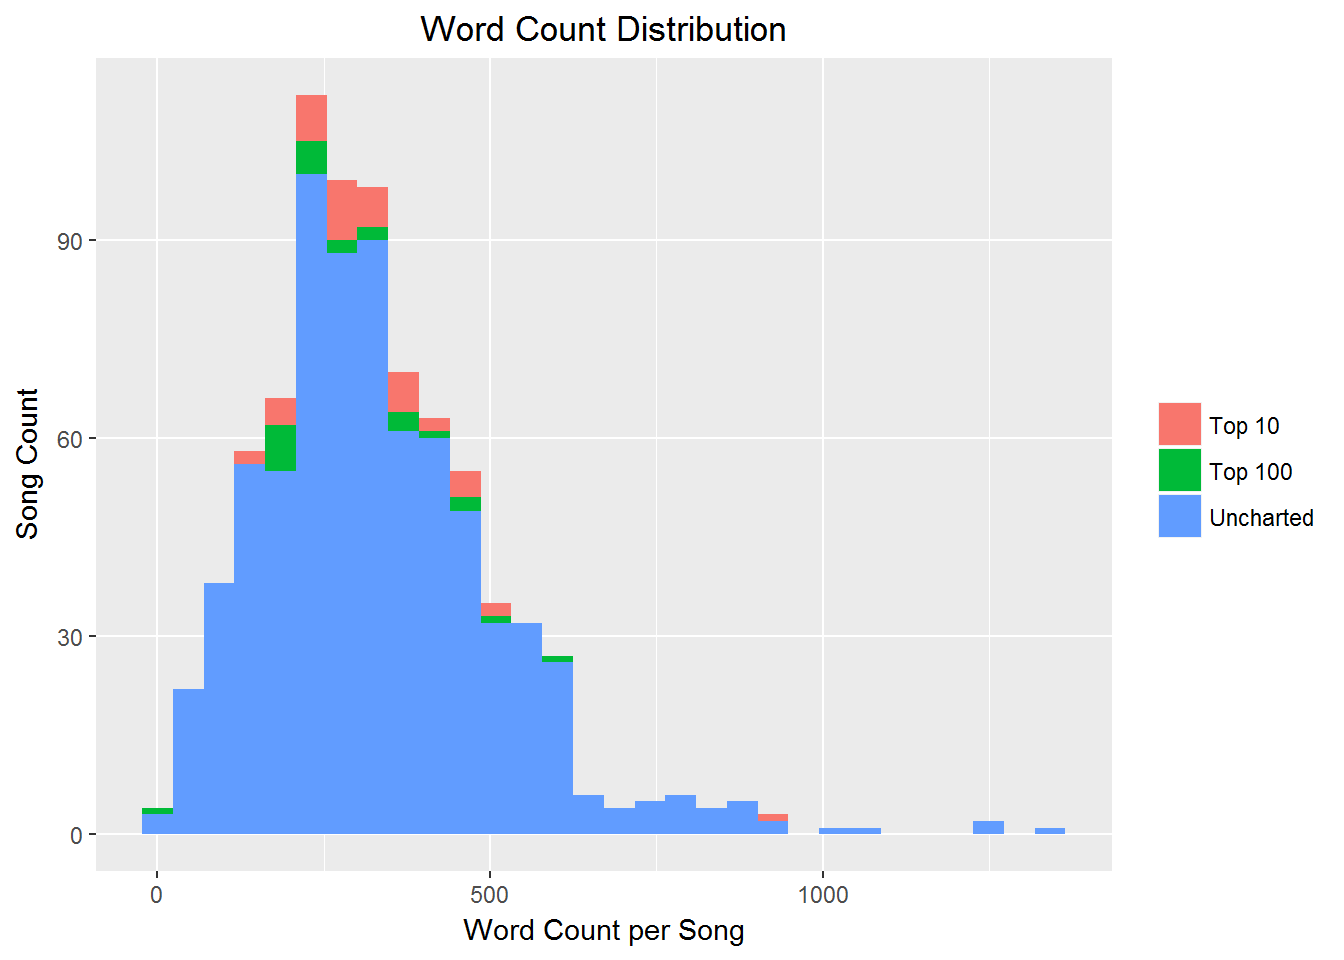
Observa la asimetría a la derecha. Dada la naturaleza de la transcripción, me genera dudas de errores de entrada. Por curiosidad, mira esa canción del Top 10 con más de 800 palabras.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Investigando un poco, vi que esta canción tiene un artista invitado que hace una parte de rap. ¡Eso lo explica! Recuerda que este dataset cubre listas Pop y R&B a nivel global, así que género y geografía pueden afectar mucho tus supuestos. Observa que en la lista US Pop el pico fue mucho peor que en otras, llegando al 5 en Canadá, por ejemplo. Para tenerlo en mente.
Reto: si te apetece lanzarte a analizar música por tu cuenta, echa un vistazo a The Million Song Dataset, con más de 50 características (tempo, sonoridad, bailabilidad, etc.) para casi 50.000 artistas. Añadir rasgos musicales a las letras permite un análisis mucho más completo.
Para una evaluación simple de las palabras más frecuentes en el conjunto completo, puedes usar count() y top_n() para obtener las n palabras principales de tu dataset limpio y filtrado. Luego usa reorder() para ordenar según el recuento y mutate() para reasignar el orden a word. Así ggplot() lo mostrará correctamente.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Número de canciones") +
    ggtitle("Palabras más frecuentes en las letras de Prince") +
    coord_flip()
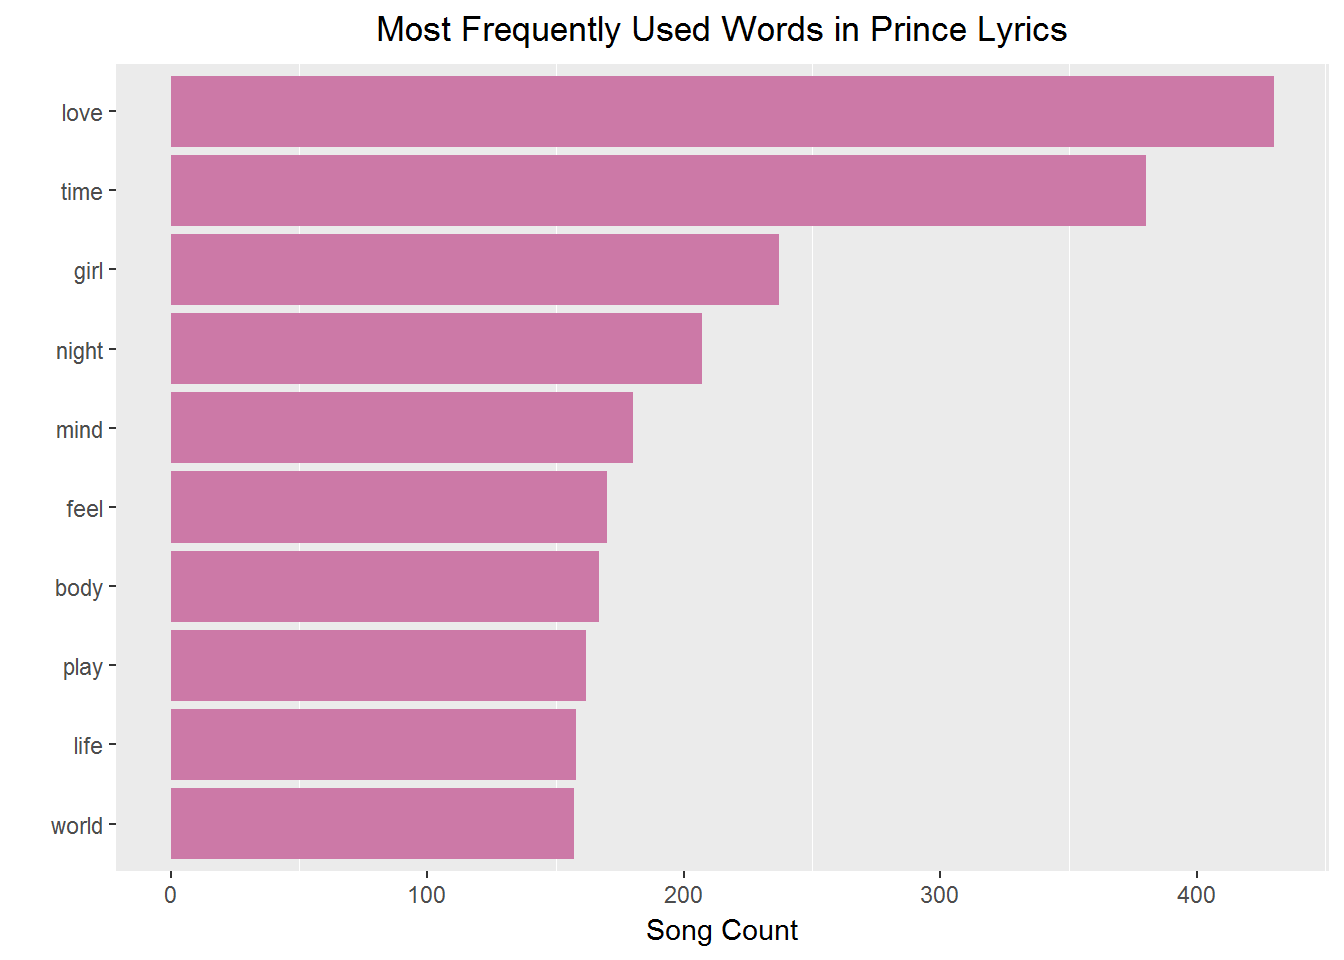
Como en gran parte de la música popular, el amor parece un tema común. Con solo estas palabras no sacaría grandes conclusiones, pero sí puedes intuir la perspectiva del artista, aunque no toda la historia. Antes de pasar a un análisis más profundo, vamos a divertirnos un poco con lo visual.
Las nubes de palabras tienen mala fama en algunos círculos y, si no se usan con cuidado, pueden sacarse de contexto. Aun así, somos muy visuales por naturaleza y hay casos en los que aportan insight real. Mira algunos ejemplos de Sandy McKee aquí. Úsalas con criterio.
Pero, por ahora, prueba con un paquete nuevo, wordcloud2, para cosas chulas. Ofrece una colección creativa de nubes que generan widgets HTML. Puedes incluso pasar el cursor por una palabra para ver su frecuencia. (Este paquete puede ser lento en rMarkdown y a veces es quisquilloso con el navegador. Esperemos mejoras.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
Y para más diversión, añade un poco de data art…
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
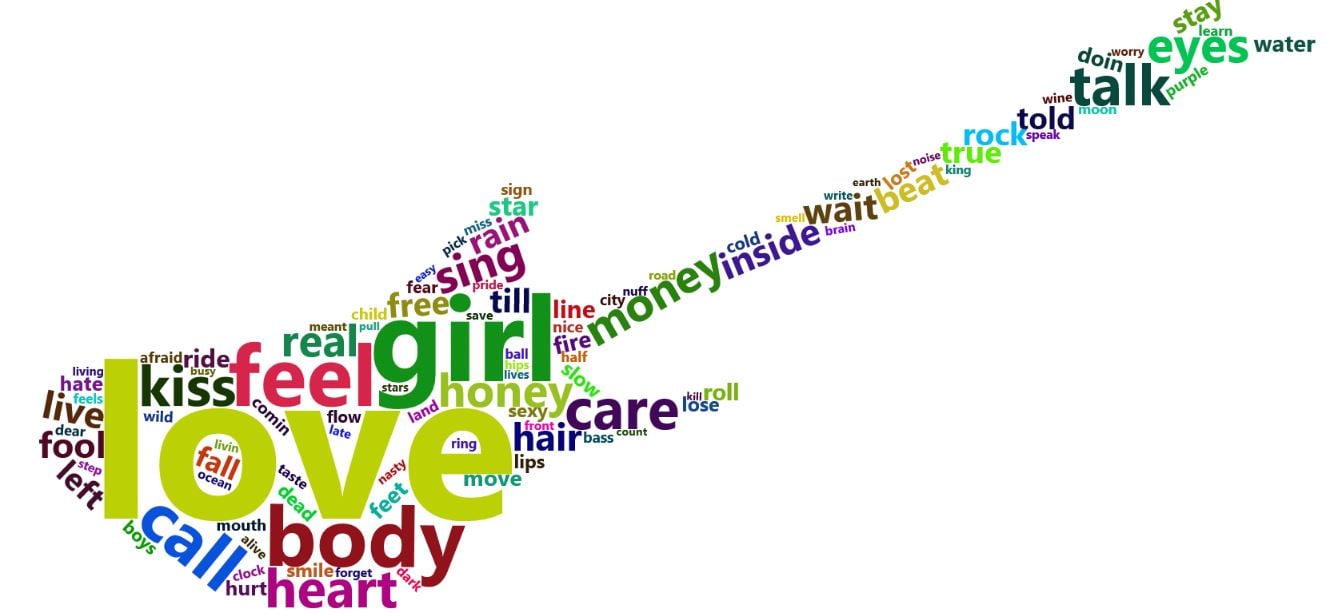
Hasta ahora has visto las palabras principales en todas las canciones. ¿Qué pasa si las separas por chart_level? ¿Hay palabras más frecuentes en canciones que entraron en listas frente a las que no? Estas serían palabras "populares" para la sociedad.
Fíjate en el uso de slice(seq_len(n)) para tomar las primeras n palabras en cada chart_level. Funciona distinto a top_n() y va bien cuando facetamos el gráfico. (Recuerda que siempre hay varias formas de hacer estos trucos.) También puedes usar row_number() para listar las palabras en el orden correcto. Por defecto ggplot() las ordenaría alfabéticamente; es buena práctica ordenar antes de graficar.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Número de canciones") +
    ggtitle("Palabras populares por nivel de listas") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
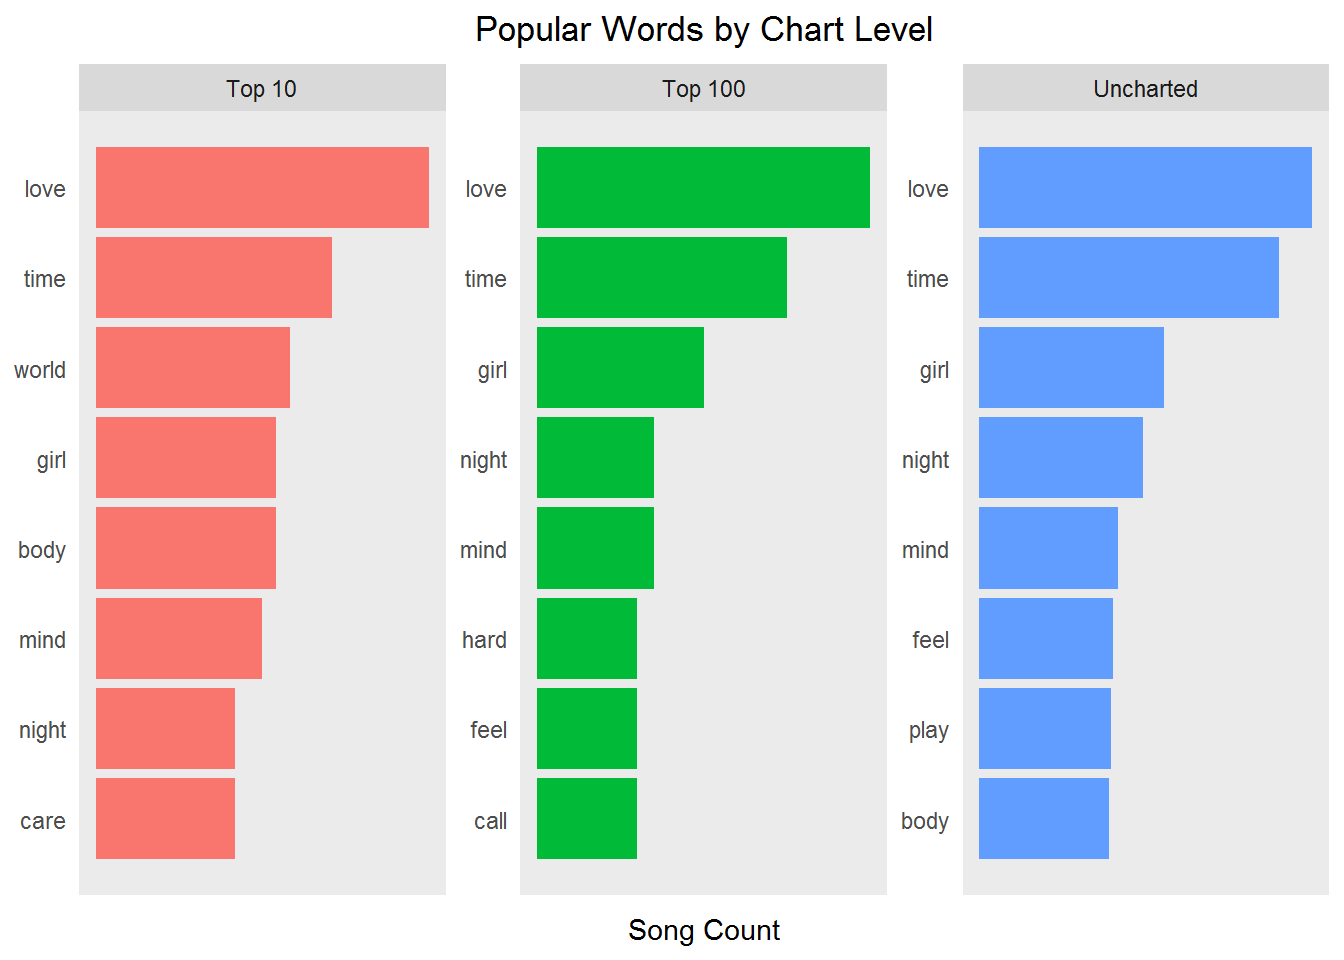
¿Qué insights sacas de aquí?
Pues que las palabras principales son muy, muy parecidas entre niveles. No pinta bien para nuestras aspiraciones de predecir si una canción tendrá éxito basándonos en las letras. Pero solo hemos rascado la superficie de lo posible con minería de texto y, más adelante, PLN y modelado predictivo.
Algunas palabras en música son atemporales. Sobreviven al paso del tiempo y conectan con un público amplio. Si desglosas por décadas, estas palabras escalan a la cima. Usa filtrado, agrupación y agregación para obtener las principales por década en las letras de Prince y ver cuáles son atemporales o de moda. Puedes usar ggplot() con facet_wrap() para ver por década.
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Número de canciones") +
    ggtitle("Palabras atemporales") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
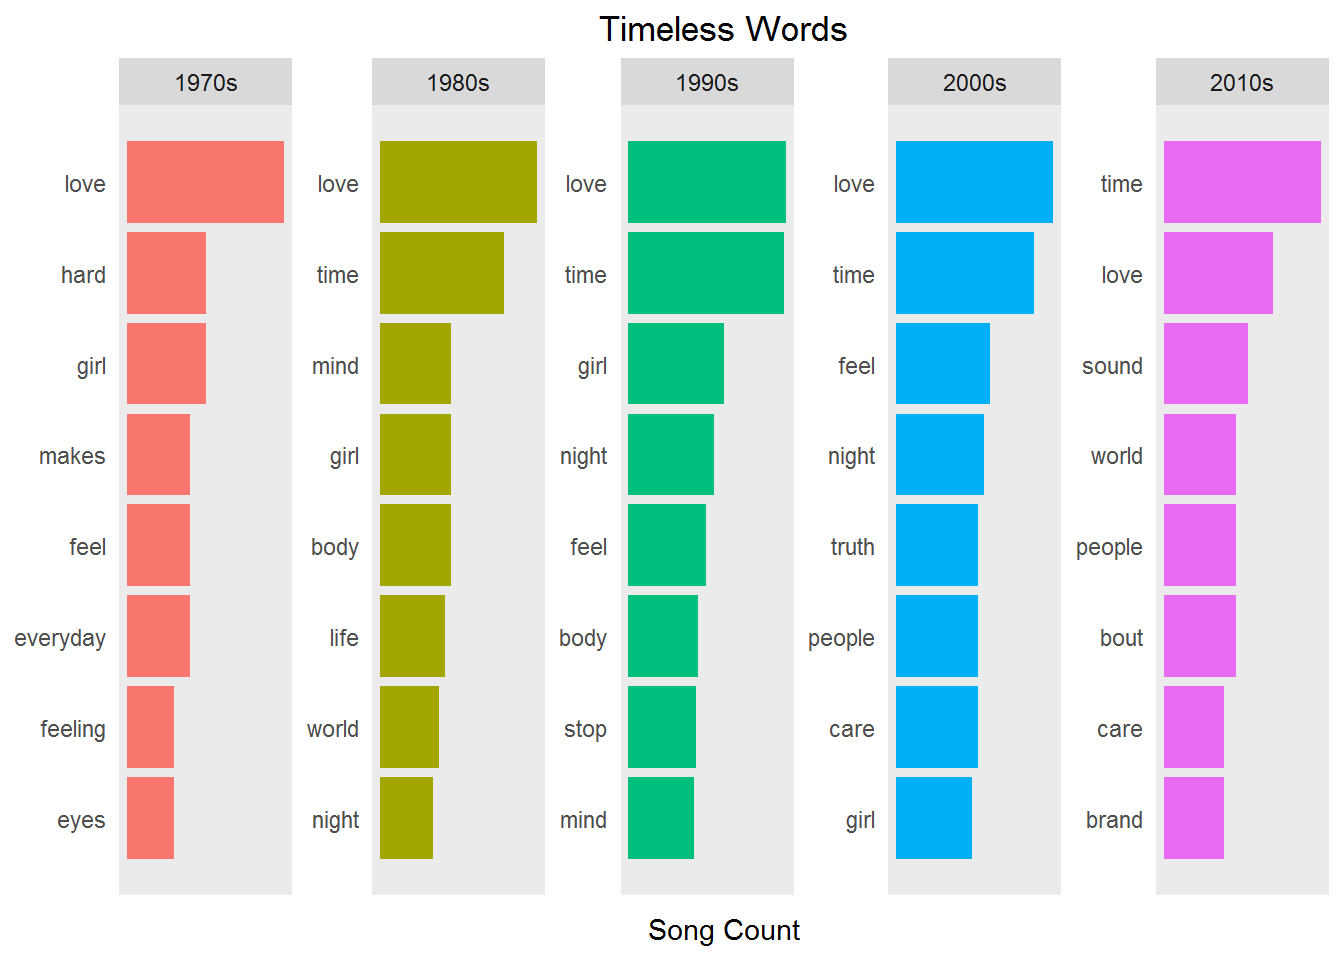
Claramente love, time y girl son atemporales. ¿Pero qué hay de las palabras de moda? ¿Estaba truth en tendencia a comienzos de siglo? ¿O simplemente es muy repetida en ciertas canciones? ¿La frecuencia identifica temas? ¿Funciona igual con letras que con otros textos como los discursos del Estado de la Unión?
La longitud de las palabras es interesante para quienes escriben letras: cuanto más largas, más difícil rimarlas y encajarlas en el patrón. El histograma de longitudes de palabra de abajo es lo esperado, con unas pocas excepciones larguísimas.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Longitud de palabra") +
    ylab("Número de palabras") +
    ggtitle("Distribución de la longitud de palabra") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
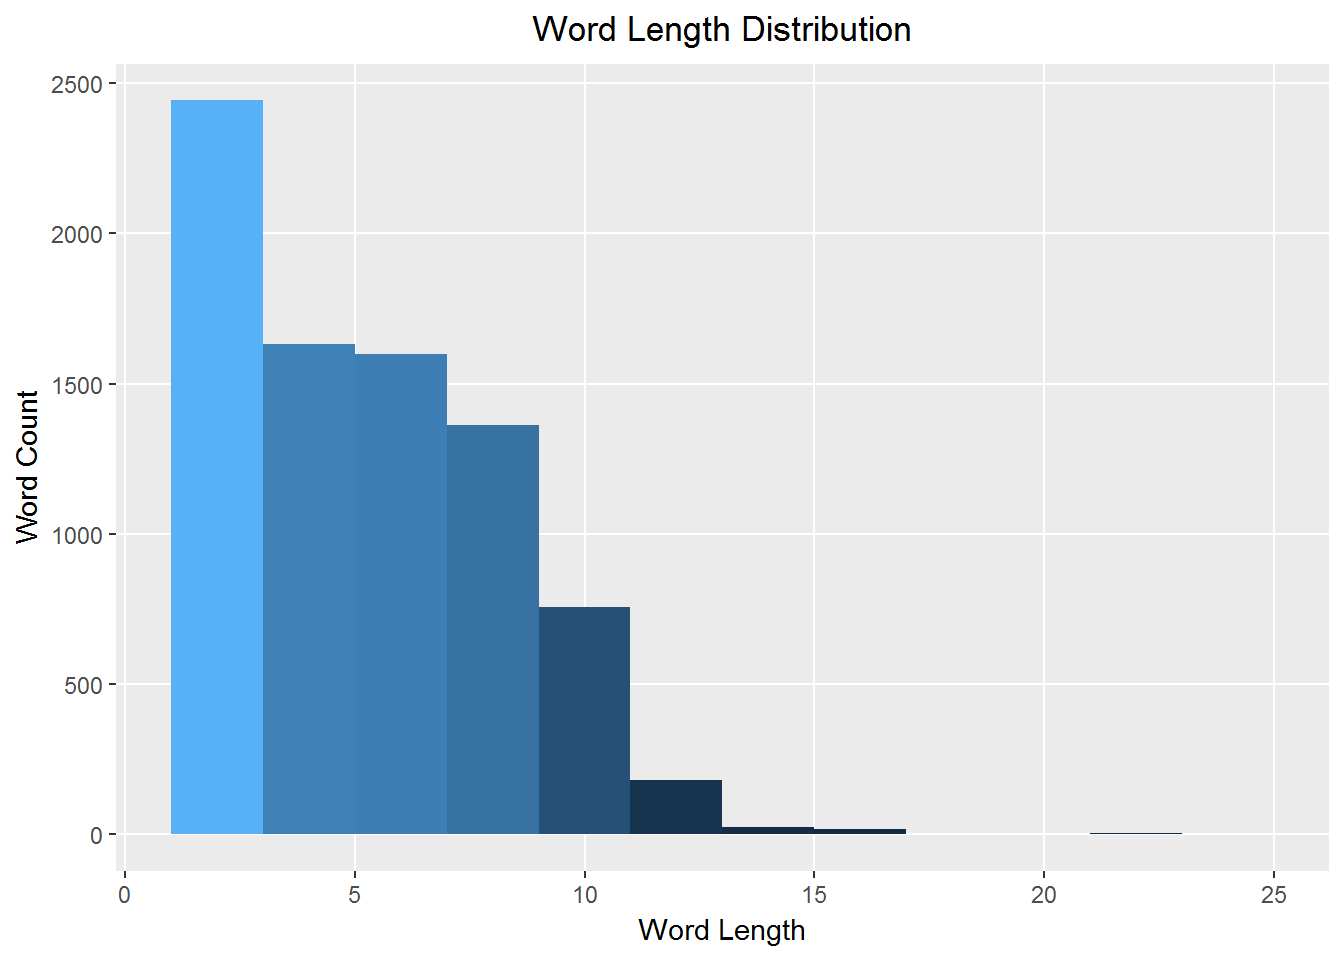
¿Cuáles son esas palabras larguísimas? Esto pide una nube de palabras de lo más entretenida, basada en longitud en lugar de frecuencia. Mira:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Cuanto más variado es el vocabulario de un texto, mayor es su diversidad léxica. El vocabulario de la canción representa cuántas palabras únicas se usan en ella. Puedes mostrarlo con un gráfico simple del promedio de palabras únicas por canción a lo largo de los años. Tokeniza otra vez el dataset original, pero deja las stop y las palabras cortas, ya que aquí buscas insights cuantitativos.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Diversidad léxica") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
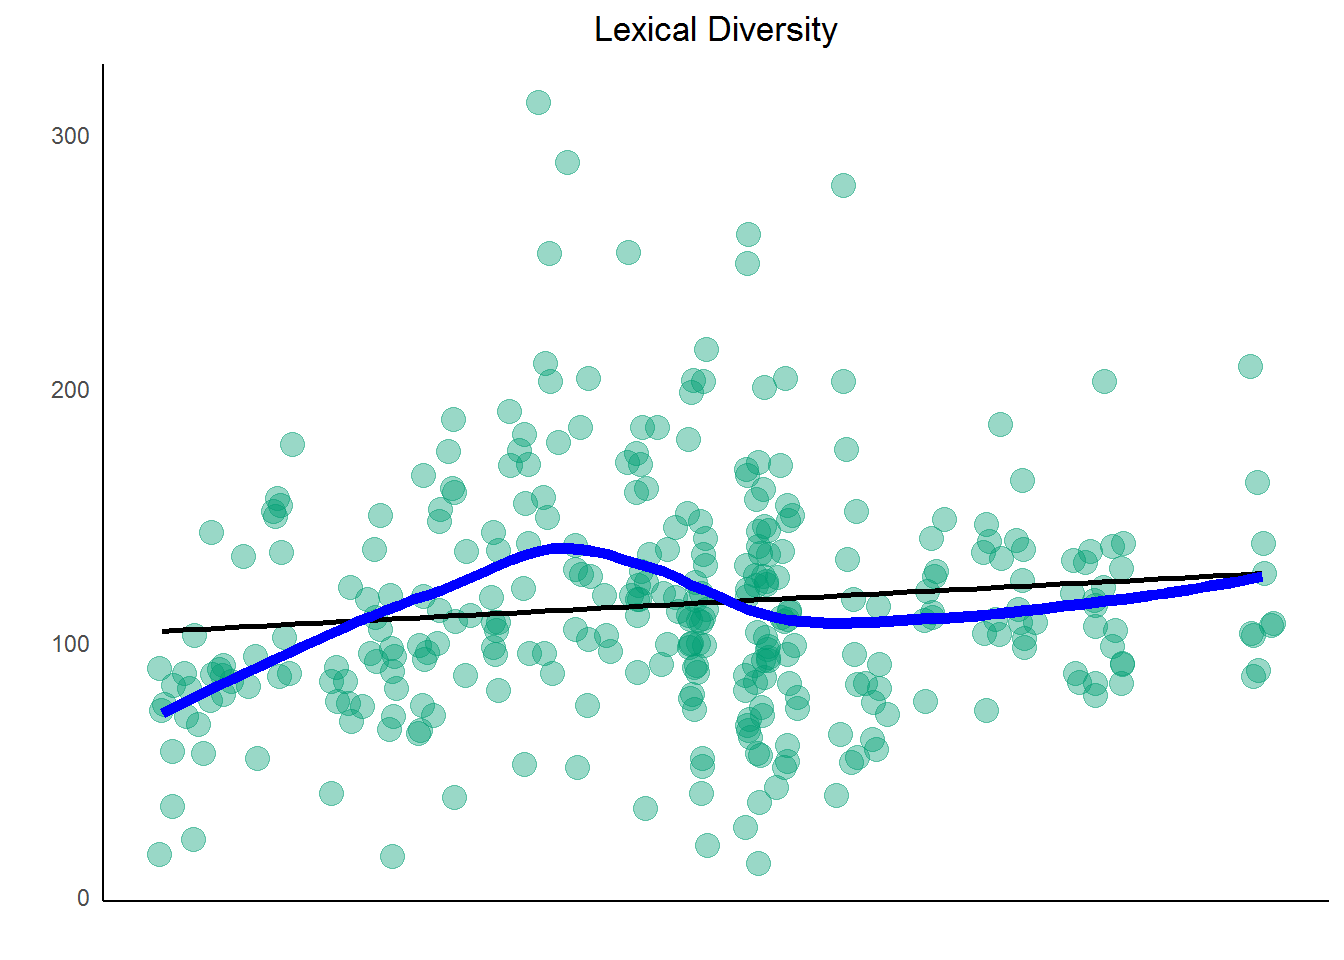
¿Qué significa? En las últimas décadas, hubo una ligera tendencia al alza en la diversidad léxica de las letras de Prince. ¿Cómo se correlaciona con el éxito en listas? Difícil de decir; aun así, representa densidad e historial en listas para comparar.
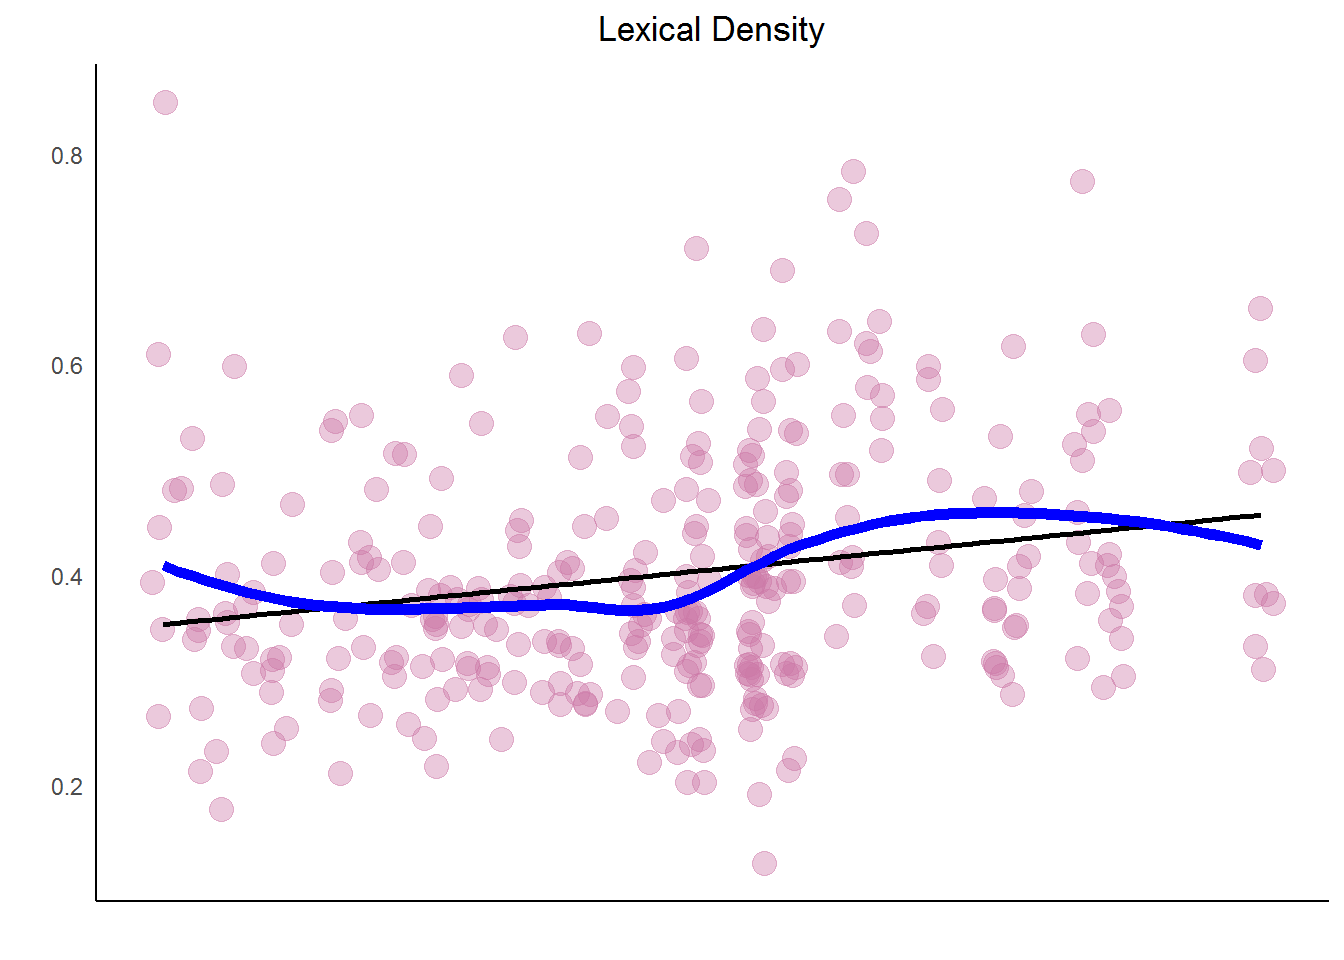
Recuerda que aquí definimos densidad léxica como el número de palabras únicas dividido por el total de palabras. Es un indicador de repetición, una herramienta clave de composición. A mayor densidad, menor repetición. (Nota: no implica repetición secuencial, que es otro recurso.)
Observa la densidad léxica de Prince a lo largo de los años. Para densidad, conviene dejar todas las palabras, incluidas las stop. Empieza con el dataset original y desanida. Agrupa por canción y año y usa n_distinct() y n() para calcular la densidad. Encadena a ggplot() con geom_smooth(). Añade un stat_smooth() extra con method="lm" para suavizado lineal.
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Densidad léxica") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
Para comparar tendencias, crea un gráfico de su historial en listas (canciones que entraron en rankings) y compáralo con diversidad y densidad. Usa grid.arrange() de gridExtra para ponerlos lado a lado.
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Historial en listas") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
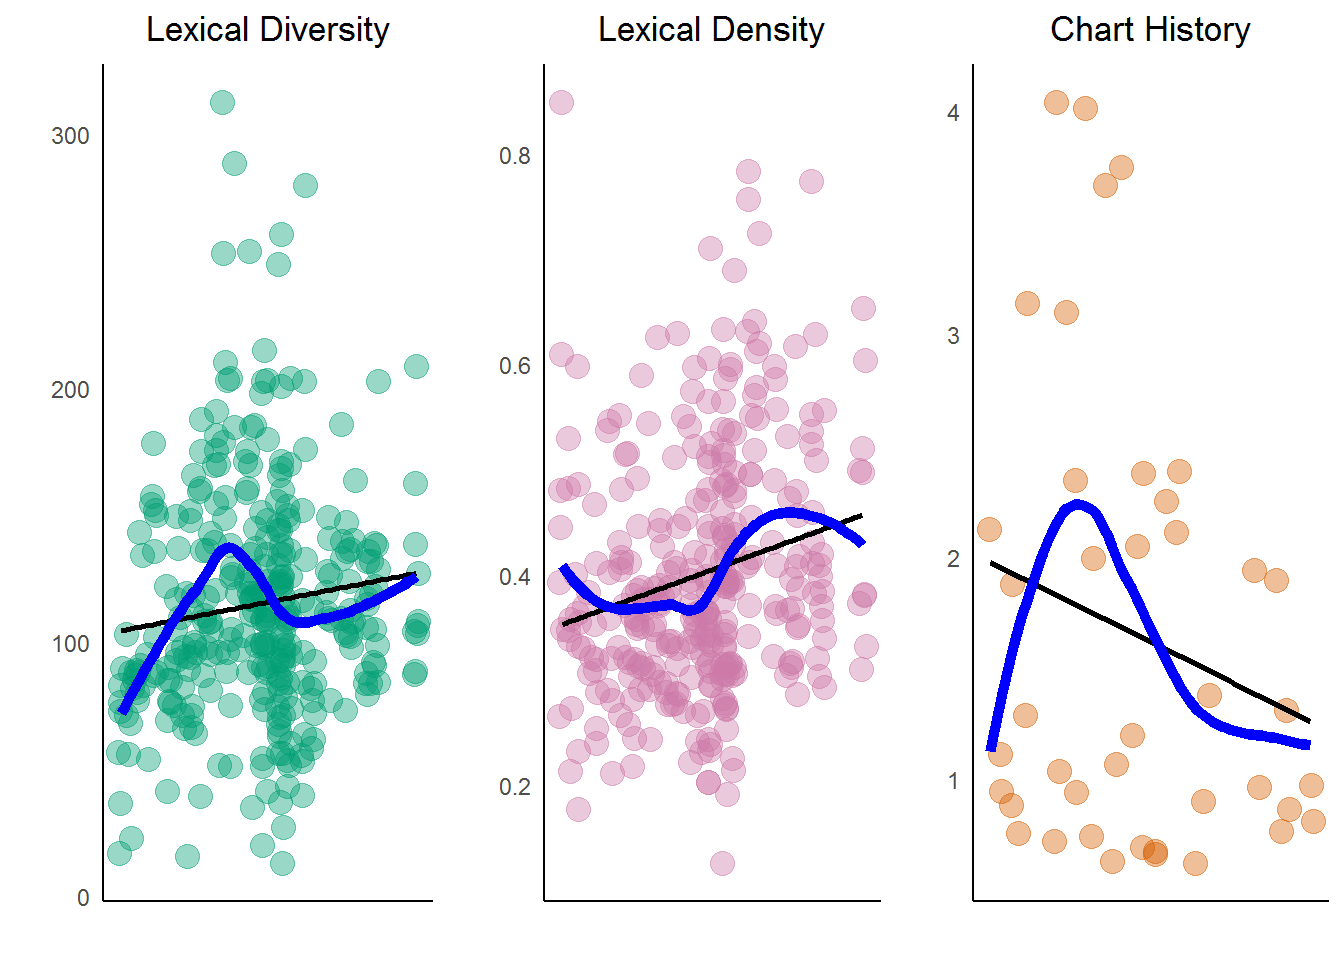
Ves un ligero aumento tanto en diversidad como en densidad léxica con los años. ¿Cómo compara esto con la música popular en general? Un estudio muestra que los hits han visto una densidad léxica decreciente, indicando más repetición ("más palabras con menos que decir"). No es el caso de Prince. Otro estudio revela que, en la música popular en general, la diversidad (palabras únicas) ha aumentado con el tiempo, lo que sí correlaciona con Prince. Quizás ligado a una mayor diversidad de géneros en listas a lo largo de la historia. El género es una pieza crítica que no existe en este dataset. ¿Puede ser que su historial decaiga en pop pero suba en R&B/rap?
Reto: te dejo que reflexiones sobre estos resultados y te animo a buscar datasets distintos donde aplicar estas habilidades por tu cuenta. Recuerda: correlación no implica causalidad.
Hasta ahora has mirado el conjunto completo, pero no has cuantificado cuán importantes son los términos en un documento respecto al conjunto. Has visto la frecuencia de términos y eliminado stop words, pero quizá no sea el enfoque más sofisticado.
Llega TF-IDF. TF es la "frecuencia de término". IDF es la "frecuencia inversa de documento", que asigna menor peso a palabras comunes y mayor a palabras poco frecuentes en la colección. Al combinar TF e IDF, ajustas la importancia de un término por su rareza. La suposición es que los términos más frecuentes en un documento deben tener más peso, salvo que aparezcan en muchos documentos. La fórmula se resume así:
La IDF de un término es mayor cuanto menos aparece en los documentos de la colección. Puedes usar este enfoque para examinar las palabras más importantes por nivel de listas con bind_tf_idf() de tidytext. Esta función calcula y añade las columnas TF, IDF y su producto. Toma un dataset tidy con una fila por token (palabra) por documento (canción).
Toma el data frame original de Prince y desanida tokens a palabras, elimina palabras indeseables, pero deja las stop. Luego usa bind_tf_idf() para ejecutar las fórmulas y crear nuevas columnas.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Ahora ves que IDF y TF-IDF son 0 para palabras extremadamente comunes. (Técnicamente, el término IDF será el log natural de 1 y, por tanto, cero para estas palabras). Encadena a arrange() descendiendo por tf-idf. Añade unos pasos más y verás otra forma de mirar las palabras en las letras de Prince.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %> %
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Palabras importantes con TF-IDF por nivel de listas") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
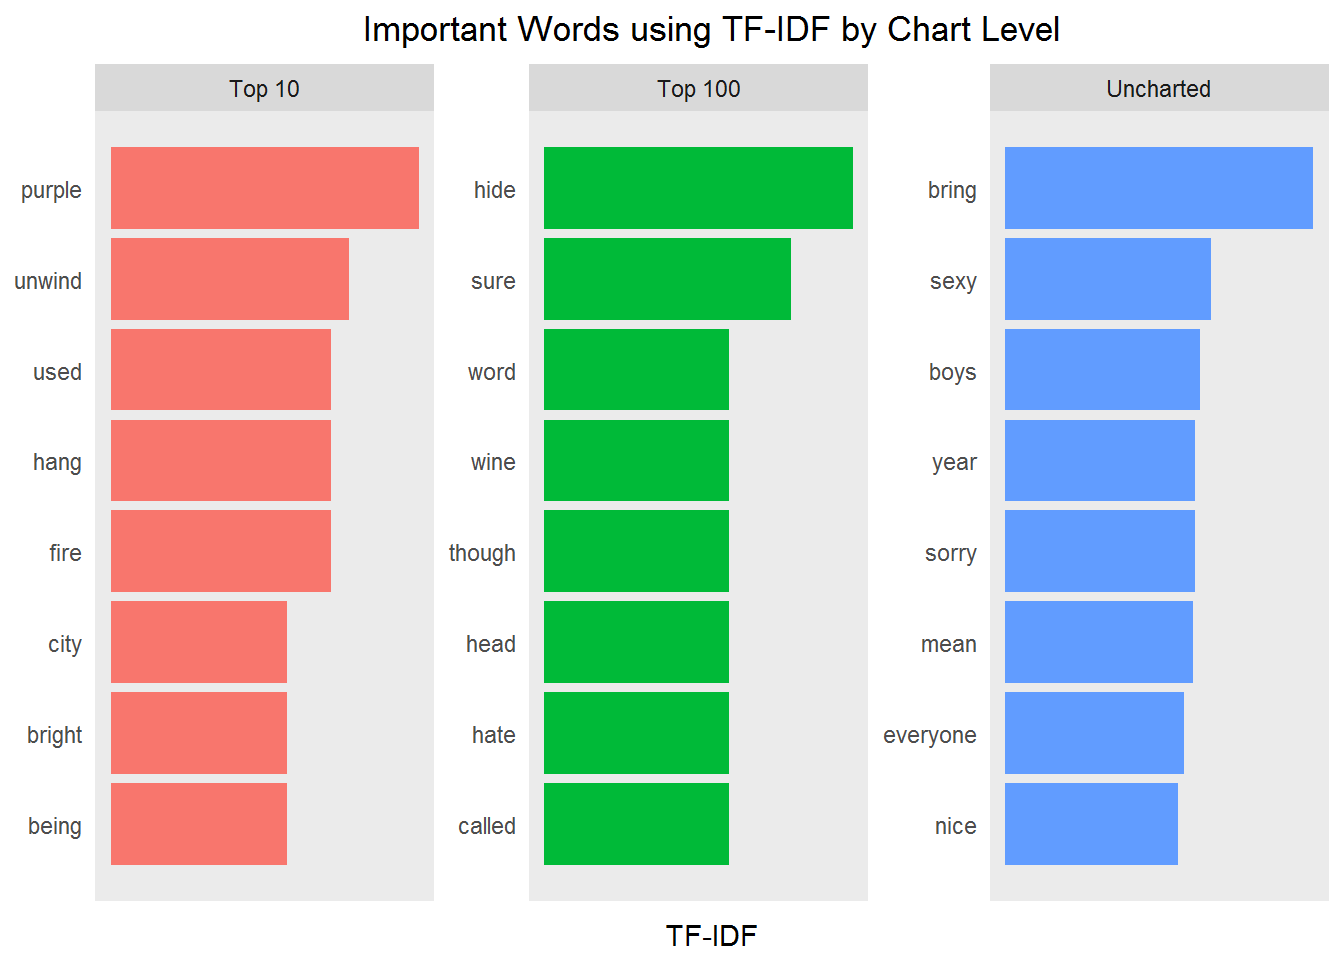
Vaya, usar TF-IDF nos da una perspectiva distinta sobre palabras potencialmente importantes. Claro que la interpretación es subjetiva. ¿Ves algún patrón?
Después, mira TF-IDF a lo largo del tiempo:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Palabras importantes con TF-IDF por década") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
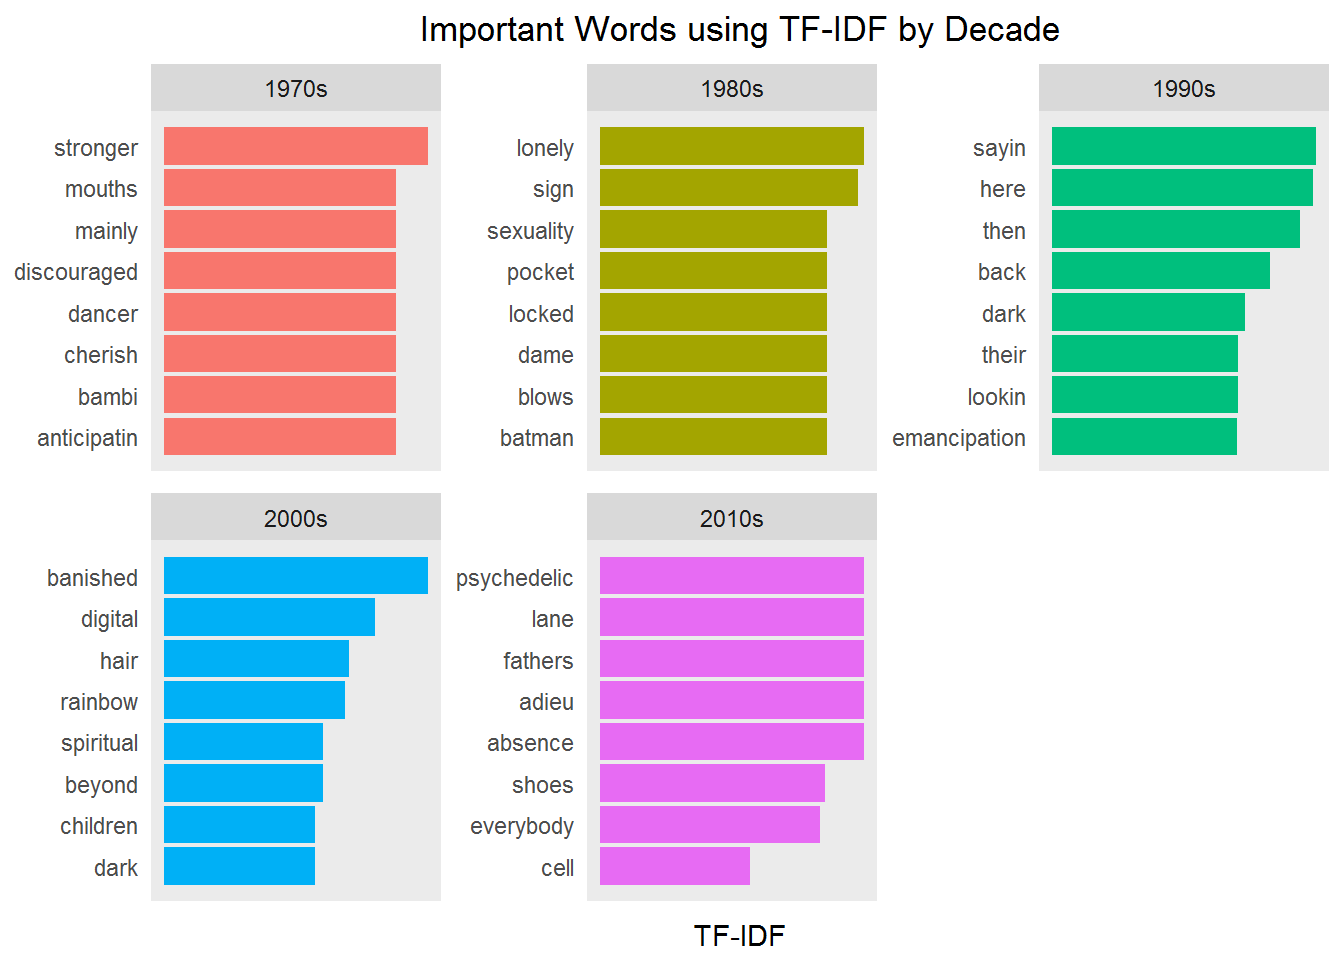
Ahora sí estás obteniendo un nivel de insight más profundo. Las palabras atemporales dejan de dominar. ¿Empiezas a ver temas? ¿Es posible con solo unas pocas palabras por grupo? Lo llevaremos a otro nivel en el segundo tutorial (Parte dos: análisis de sentimiento y modelado de temas con PLN).
Una nube rápida con este método ofrece otra perspectiva de palabras importantes en las letras de Prince y resulta más interesante…
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
En este caso práctico, primero echaste un vistazo a los datos, yendo a lo básico. Tras acondicionar (limpieza y eliminación de palabras poco informativas), iniciaste un análisis exploratorio a nivel de canción.
Luego profundizaste en la minería de texto desanidando las letras en palabras tokenizadas para evaluar la complejidad léxica. Los resultados aportan insights clave para los siguientes pasos de análisis de sentimiento y modelado de temas.
Por último, usaste TF-IDF para representar la información que hay detrás de una palabra en un documento en relación con un resultado de interés. Puede parecer una buena manera de identificar temas en música, pero solo tienes media historia. La Parte dos aborda un método de aprendizaje no supervisado llamado Latent Dirichlet Allocation (LDA). Como en toda la ciencia de datos, hay muchos métodos para extraer insight. En las Partes dos y tres verás más opciones.
Ojalá estés tan motivado como yo para continuar este viaje desde el análisis exploratorio hasta el análisis de sentimiento, el modelado de temas y las predicciones.
¡Gracias por leer y nos vemos en el próximo tutorial!
Aprende más sobre R y machine learning
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Zoumana Keita
15 min
Tutorial
Duong Vu
11 min
Tutorial
Moez Ali
13 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Arunn Thevapalan
15 min