Cursus
Machine Learning met caret in R
4 uur
61K
Dit is deel één van een driedelige tutorialserie waarin je met R diverse analytische taken uitvoert op een casestudy met songteksten van de legendarische artiest Prince. De drie tutorials behandelen het volgende:
Songteksten laten vaak het perspectief van een artiest zien, maar populaire liedjes onthullen wat de samenleving wil horen. Het analyseren van songteksten is geen eenvoudige opgave. Omdat songteksten vaak heel anders zijn opgebouwd dan proza, vraagt het om voorzichtigheid met aannames en een zeer gerichte keuze van analysetechnieken. Songteksten doordringen ons leven en beïnvloeden onze gedachten met een subtiele alomtegenwoordigheid. Het idee van Predictive Lyrics wint aan populariteit en duikt steeds vaker op in onderzoeksartikelen en scripties. Deze casestudy raakt slechts een paar onderdelen van dit opkomende onderwerp.
Ter ere van het inspirerende en diverse oeuvre dat Prince heeft nagelaten, ga je de soms duidelijke, maar vaak verborgen boodschappen in zijn songteksten verkennen. Je hoeft echter geen fan te zijn van Prince’ muziek om de invloed te waarderen die hij wereldwijd op de ontwikkeling van vele genres heeft gehad. Het tijdschrift Rolling Stone noemde Prince de 18e beste songwriter aller tijden, net achter namen als Bob Dylan, John Lennon, Paul Simon, Joni Mitchell en Stevie Wonder. Tekstanalyse vindt langzaam zijn weg naar datasciencegemeenschappen nu de mogelijkheid om "hitnummers" te voorspellen dichterbij komt.
Prince was een man barstensvol muziek – een extreem productieve songwriter, een virtuoos op gitaar, keyboards en drums, en een meesterlijke architect van funk, rock, R&B en pop, zelfs terwijl zijn muziek genres tartte. - Jon Pareles (NY Times)
In deze tutorial, deel één van de serie, gebruik je text-miningtechnieken op een set songteksten met behulp van het tidy text-framework. Tidy datasets hebben een specifieke structuur waarin elke variabele een kolom is, elke observatie een rij, en elk type observationele eenheid een tabel. Na het opschonen en conditioneren van de dataset maak je beschrijvende statistieken en verkennende visualisaties terwijl je verschillende aspecten van Prince’ songteksten bekijkt.
Deel één van deze tutorialserie vereist een basisbegrip van tidy data – specifiek pakketten zoals dplyr voor datatransformatie, ggplot2 voor visualisaties, en de %>% pipe-operator oorspronkelijk uit het magrittr-pakket. Elke tutorial beschrijft de tools die je kunt gebruiken voor je analyse, maar gaat mogelijk niet in detail op elke stap. Je zult merken dat meerdere stappen vaak worden gecombineerd met de %>%-operator. Omdat dit ook een casestudy is, is het belangrijk te onthouden dat alle gevolgtrekkingen die je maakt puur observationeel zijn; correlatie impliceert dus geen causaliteit.
Tip: voor achtergrond over de gebruikte tools zijn twee goede bronnen R for Data Science van Garrett Grolemund en Hadley Wickham; en Text Mining with R van Julia Silge en David Robinson.
Delen twee en drie
In een aparte tutorial, deel twee, behandel je sentimentanalyse en topic modeling om de algemene stemming en thema’s in Prince’ muziek vast te leggen en hun toepassing op maatschappelijke perspectieven. Je werkt met een sentimentlexicon, beoordeelt binaire en categorische sentimenten, plot trends door de tijd en bekijkt n-grams en woordassociaties. Je gebruikt ook Natural Language Processing (NLP) en clusteringstechnieken zoals Latent Dirichlet Allocation (LDA) en K-Means om motieven in de songteksten te ontrafelen.
In nog een andere tutorial, deel drie, rond je het geheel af door je verkennende resultaten te gebruiken om te voorspellen in welk decennium een nummer is uitgebracht en, nog interessanter, of een nummer de Billboard-hitlijsten zal halen op basis van de songteksten. Je gebruikt machinelearningtools zoals Decision Trees (rpart en C50), K-Nearest-Neighbors (class) en Naive Bayes (e1071) om een classifier te maken die tekst kan verwerken.
Alle drie de delen gebruiken dezelfde dataset met Prince-songteksten, uitgavejaar en Billboard-noteringen. De technieken in deze studie zijn ook toepasbaar op veel andere soorten tekst. Resultaten voor standaardproza zijn zelfs vaak makkelijker te interpreteren, omdat songteksten in het algemeen vaak zijn ontworpen met een indirecte boodschap en subtiele nuances.
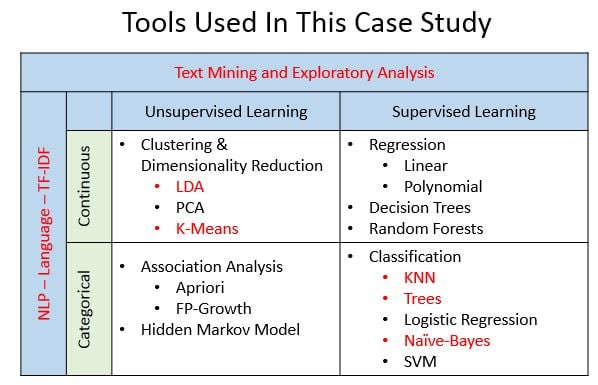
Samengevat zijn er veel verschillende methoden om songteksten te analyseren. Deze tutorials behandelen de methoden die in het rood zijn gemarkeerd in de onderstaande grafiek. Let op: deze grafiek is slechts een weergave op hoofdlijnen van een heel "wazig" plaatje. En nee, ik bedoel niet de afbeelding zelf! De waarheid is dat de verschillende aspecten van modelleer- en machinelearningtechnieken inmiddels in elkaar overlopen en niet per se in één hokje passen zoals hieronder getoond. Zet dus een 3D-bril op terwijl je naar de afbeelding kijkt en het wordt misschien logischer!
Naast het leren en oefenen van nieuwe vaardigheden, wil deze tutorial basisvragen rond het concept van tekstanalyse van songteksten behandelen. Recente studies laten zien dat "lyrical intelligence" in populaire muziek zou kunnen dalen. Sommige studies suggereren zelfs dat woorden in No. 1-hits overeenkomen met het leesniveau van Amerikaanse scholieren uit groep 5. Is het mogelijk om met text mining, NLP, machine learning en andere datasciencemethoden inzicht te krijgen in zo’n onderwerp? Is het mogelijk om thema’s te identificeren die de samenleving aanspreken op basis van hoe goed een nummer wordt ontvangen? Is het mogelijk te voorspellen of een nummer het goed zal doen louter op basis van tekstanalyse? In deze eerste tutorial bekijk je de lyrische complexiteit van Prince’ muziek als een verkennende oefening.
Voordat je erin duikt, denk na over wat je probeert te ontdekken. Welke vragen zijn interessant? Je loopt eerst door een analyse van de dataset. Hoe ziet die eruit? Hoeveel nummers zijn er? Hoe zijn de songteksten opgebouwd? Hoeveel opschoning en wrangling is nodig? Wat zijn de feiten? Wat zijn de woordfrequenties en waarom is dat belangrijk? Vanuit technisch perspectief wil je de data begrijpen en voorbereiden voor sentimentanalyse, NLP en machinelearningmodellen.
Muziek is al lang een effectieve manier om met de massa te communiceren, en songteksten hebben een enorme rol gespeeld bij het overbrengen van die boodschap. Toch wordt de kans om te onderzoeken welke rol songteksten spelen in het welzijn [van de samenleving] nauwelijks benut. - Patricia Fox Ransom
Een populaire methode om data voor text mining te verkrijgen is met het rvest-pakket de inhoud van het web scrapen. Ik kon Billboard Chart-informatie en Prince-songteksten van verschillende sites scrapen en ze op songtitel samenvoegen. Er was wat wrangling nodig door inconsistente naamconventies voor de titels. Vervolgens nam ik de subjectieve beslissing om alle nummers te verwijderen die niet de originele versies waren, dus remixes, extended versions, clubmixes, remakes, enzovoort. Ik verwijderde ook albums met historische verzamelingen van zijn hits om herhaling te voorkomen. Ik voerde wat kleine opschoning uit en sloeg het resultaat op in een csv-bestand dat voor deze tutorial kon worden gebruikt.
Aangezien deel één zich richt op text mining, heb ik die code niet in deze tutorial opgenomen, maar de dataset is beschikbaar om te downloaden hier als je wilt meedoen.
#most of the libraries needed
library(dplyr) #data manipulation
library(ggplot2) #visualizations
library(gridExtra) #viewing multiple plots together
library(tidytext) #text mining
library(wordcloud2) #creative visualizations
Er zijn meerdere methoden om data uit een csv-bestand in te lezen, maar ik koos voor read.csv() om een data frame met songteksten, uitgavejaar en Billboard-noteringen te laden. Let op: standaard zet R alle tekenreeksen om in factors. Dit kan later problemen geven, maar je kunt dat voorkomen door de parameter stringsAsFactors op FALSE te zetten. Nu de data bekijken...
prince_orig <- read.csv("prince_raw_data.csv", stringsAsFactors = FALSE)
Met de functie names() kun je de kolommen in het data frame bekijken:
names(prince_orig)
##  [1] "X"            "text"         "artist"       "song"
##  [5] "year"         "album"        "Release.Date" "US.Pop"
##  [9] "US.R.B"       "CA"           "UK"           "IR"
## [13] "NL"           "DE"           "AT"           "FR"
## [17] "JP"           "AU"           "NZ"           "peak"
Omdat ik dit bestand heb gemaakt, weet ik dat X slechts een regelnummer is en text de daadwerkelijke songtekst. De andere benodigde velden zijn song, year en peak (dat de positie op de Billboard-hitlijsten aangeeft). US.Pop en US.R.B zijn piekposities op de Amerikaanse (Pop- en R&B-)lijsten, dus die houden we ook bij en we laten de overige velden voorlopig vallen.
Doe dit door de originele dataset, prince_orig, te nemen en die met %>% in select() te pipen. Zo kun je code van links naar rechts lezen.
Let ook op dat je met select() kolommen in één stap kunt hernoemen. Stel text dus in op lyrics en hernoem de US-kolommen naar tidyverse-stijl met "_" in plaats van ".". Sla het resultaat op in prince, die je in de hele tutorial gebruikt. dplyr biedt een functie glimpse() die het makkelijk maakt om je data in een getransponeerde weergave te bekijken.
prince <- prince_orig %>%
  select(lyrics = text, song, year, album, peak,
         us_pop = US.Pop, us_rnb = US.R.B)

glimpse(prince[139,])
Observations: 1
Variables: 7
$ lyrics <chr> "I just can't believe all the things people say, controversy\nAm I ...
$ song   <chr> "controversy"
$ year   <int> 1981
$ album  <chr> "Controversy"
$ peak   <int> 3
$ us_pop <chr> "70"
$ us_rnb <chr> "3"
De eerste voor de hand liggende vraag: hoeveel observaties en kolommen zijn er?
dim(prince)
[1] 824 7
Met de functie dim() zie je dat er 7 kolommen en 824 observaties zijn. Elke observatie is een nummer. Zoals ik al zei... productief!
Kijkend naar de kolom lyrics van een van de nummers zie je hoe de songteksten zijn opgebouwd.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "I just can't believe all the things people say, controversy\nAm I Black or White? Am I straight or gay? Controversy\nDo I believe in God? Do I believe in me? Controversy\nControversy, controversy\nI can't understand human curiosity, controversy\nWas it good for you? Was I what you w"| __truncated__
Er zijn genoeg mogelijkheden om de boel op te schonen, dus aan de slag.
Er zijn verschillende methoden om de data te conditioneren. Een optie is om het data frame met het tm-tekstminingpakket om te zetten in een Corpus en Document Term Matrix en vervolgens met de functie tm_map() op te schonen, maar in deze tutorial houden we het bij de basis en gebruiken we gsub() en apply()-functies om het vuile werk te doen.
Verlos je eerst van lastige samentrekkingen door een kleine functie te maken die de meeste scenario’s afhandelt met gsub(), en pas die functie dan toe op alle songteksten.
# function to expand contractions in an English-language source
fix.contractions <- function(doc) {
  # "won't" is a special case as it does not expand to "wo not"
  doc <- gsub("won't", "will not", doc)
  doc <- gsub("can't", "can not", doc)
  doc <- gsub("n't", " not", doc)
  doc <- gsub("'ll", " will", doc)
  doc <- gsub("'re", " are", doc)
  doc <- gsub("'ve", " have", doc)
  doc <- gsub("'m", " am", doc)
  doc <- gsub("'d", " would", doc)
  # 's could be 'is' or could be possessive: it has no expansion
  doc <- gsub("'s", "", doc)
  return(doc)
}

# fix (expand) contractions
prince$lyrics <- sapply(prince$lyrics, fix.contractions)
Je zult ook speciale tekens opmerken die de tekst vervuilen. Die kun je verwijderen met de functie gsub() en een simpele reguliere expressie. Let op: het is cruciaal om samentrekkingen eerst uit te schrijven vóór je deze stap doet!
# function to remove special characters
removeSpecialChars <- function(x) gsub("[^a-zA-Z0-9 ]", " ", x)
# remove special characters
prince$lyrics <- sapply(prince$lyrics, removeSpecialChars)
Voor consistentie kun je alles omzetten naar kleine letters met de handige functie tolower().
# convert everything to lower case
prince$lyrics <- sapply(prince$lyrics, tolower)
Als je de songteksten nu bekijkt, zie je een mooie, opgeschoonde versie van de originele, ruwe tekst.
str(prince[139, ]$lyrics, nchar.max = 300)
chr "i just can not believe all the things people say controversy am i black or white
Een andere veelvoorkomende stap bij het conditioneren van data voor text mining is stemming, oftewel woorden terugbrengen tot hun stam. Dat is een onderwerp op zich en kan later aan bod komen. Bekijk nu eerst de samenvatting van het prince-data frame.
#get facts about the full dataset
summary(prince)
    lyrics              song                year         album
 Length:824         Length:824         Min.   :1978   Length:824
 Class :character   Class :character   1st Qu.:1989   Class :character
 Mode  :character   Mode  :character   Median :1996   Mode  :character
                                       Mean   :1995
                                       3rd Qu.:1999
                                       Max.   :2015
                                       NA's   :495
      peak          us_pop             us_rnb
 Min.   : 0.00   Length:824         Length:824
 1st Qu.: 2.00   Class :character   Class :character
 Median : 7.00   Mode  :character   Mode  :character
 Mean   :15.48
 3rd Qu.:19.00
 Max.   :88.00
 NA's   :751
Zoals je ziet zijn er 37 jaren aan nummers, en het laagst genoteerde nummer (dat in de dataset voorkomt) staat op positie 88. Je ziet ook dat er behoorlijk wat NA’s zijn voor year en peak. Omdat je verschillende typen analyses gaat doen, houd je de volledige dataset aan in het data frame prince en filter je waar nodig.
Omdat een van je doelvragen is om trends in nummers door de tijd te bekijken, en de dataset individuele uitgavejaren bevat, kun je buckets maken en de jaren groeperen in decennia. Gebruik dplyr’s mutate()-werkwoord om het nieuwe veld decade te maken. Een manier om de buckets te maken is met ifelse() in combinatie met de %in%-operator om op jaar te filteren en de nummers in decennia te verdelen. Sla de resultaten vervolgens weer op in prince (je voegt in feite een nieuw veld toe).
#create the decade column
prince <- prince %>%
  mutate(decade =
           ifelse(prince$year %in% 1978:1979, "1970s",
           ifelse(prince$year %in% 1980:1989, "1980s",
           ifelse(prince$year %in% 1990:1999, "1990s",
           ifelse(prince$year %in% 2000:2009, "2000s",
           ifelse(prince$year %in% 2010:2015, "2010s",
                  "NA"))))))
Hetzelfde kun je doen voor chart_level, dat aangeeft of een nummer piekte in de Top 10, Top 100 of niet in de lijsten kwam (uncharted). Deze zijn onderling exclusief, dus Top 100 bevat geen Top 10-nummers.
#create the chart level column
prince <- prince %>%
  mutate(chart_level =
           ifelse(prince$peak %in% 1:10, "Top 10",
           ifelse(prince$peak %in% 11:100, "Top 100", "Uncharted")))
Maak daarnaast een binair veld charted aan dat aangeeft of een nummer de Billboard-lijsten heeft gehaald of niet (dus een populair nummer). Gebruik write.csv() om op te slaan voor later gebruik.
#create binary field called charted showing if a song hit the charts at all
prince <- prince %>%
  mutate(charted =
           ifelse(prince$peak %in% 1:100, "Charted", "Uncharted"))

#save the new dataset to .csv for use in later tutorials
write.csv(prince, file = "prince_new.csv")
Om grafieken aan te passen maak ik graag een unieke lijst met kleuren om de visuals consistent te houden. Er zijn genoeg plaatsen op het web waar je onderscheidende kleuren kunt vinden via hun hexadecimale code, zoals hieronder. Heb je een voorkeur voor je grafieken, dan kun je ook je eigen thema maken dat je naar behoefte toepast op ggplot().
#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00")

theme_lyrics <- function()
{
  theme(plot.title = element_text(hjust = 0.5),
        axis.text.x = element_blank(),
        axis.ticks = element_blank(),
        panel.grid.major = element_blank(),
        panel.grid.minor = element_blank(),
        legend.position = "none")
}
Voordat je aan text mining begint, start je met een basisblik op wat je data op nummerniveau bevat. Dit is een goed moment om te visualiseren hoeveel nummers Prince per decennium heeft uitgebracht. Ter herinnering: zijn professionele carrière begon in 1978 en liep tot 2015 (zoals te zien in de summary()-statistieken hierboven). Maar omdat we nu naar trends kijken en de dataset veel lege waarden voor year heeft, wil je voor de eerste grafiek alle NA’s in releasejaar eruit filteren.
Met de functies filter(), group_by() en summarise() van dplyr kun je groeperen op decennium en vervolgens het aantal nummers tellen. De functie n() is een van de aggregatiefuncties die handig zijn met summarise() op gegroepeerde data. Maak daarna met ggplot() en geom_bar() een staafdiagram en vul de staven met de categorie charted.
prince %>%
  filter(decade != "NA") %>%
  group_by(decade, charted) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = charted), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  ggtitle("Uitgebrachte nummers") +
  labs(x = NULL, y = "Aantal nummers")
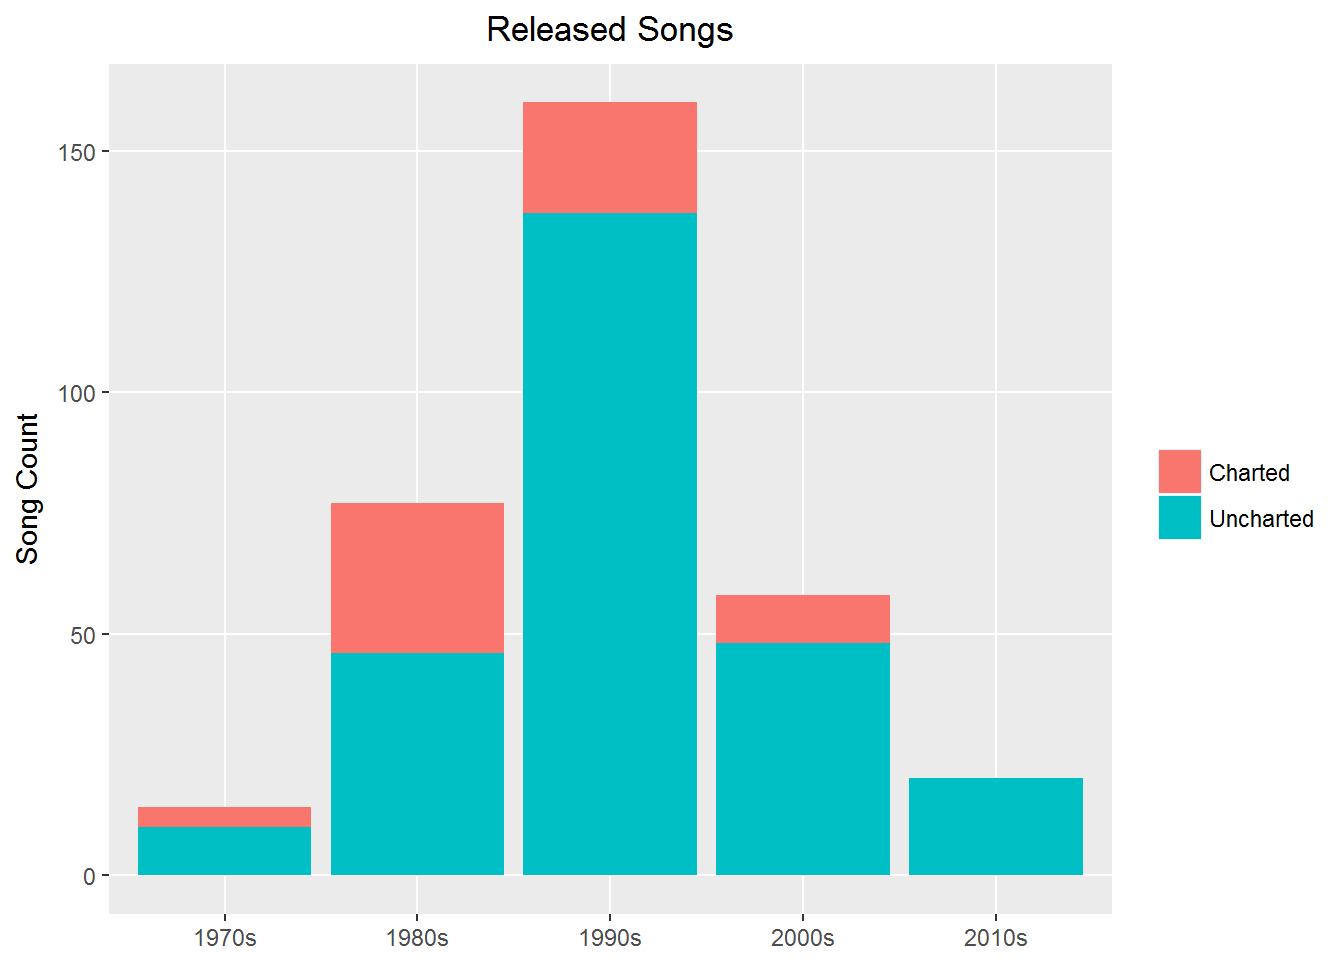
Hieruit blijkt duidelijk dat de jaren 90 zijn meest actieve decennium waren.
Maak nu een vergelijkbare grafiek met chart_level.
Vergeet niet te group_by() op zowel decade als chart_level zodat je de trend kunt zien.
In deze grafiek kijk je alleen naar genoteerde nummers, dus filter alles met peak > 0. Pipe het group_by-object naar summarise() met n() om het aantal nummers te tellen. Sla dit op in een variabele en pipe dat naar ggplot() voor een eenvoudig staafdiagram.
charted_songs_over_time <- prince %>%
  filter(peak > 0) %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n())

charted_songs_over_time %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity") +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Aantal nummers") +
  ggtitle("Genoteerde nummers")
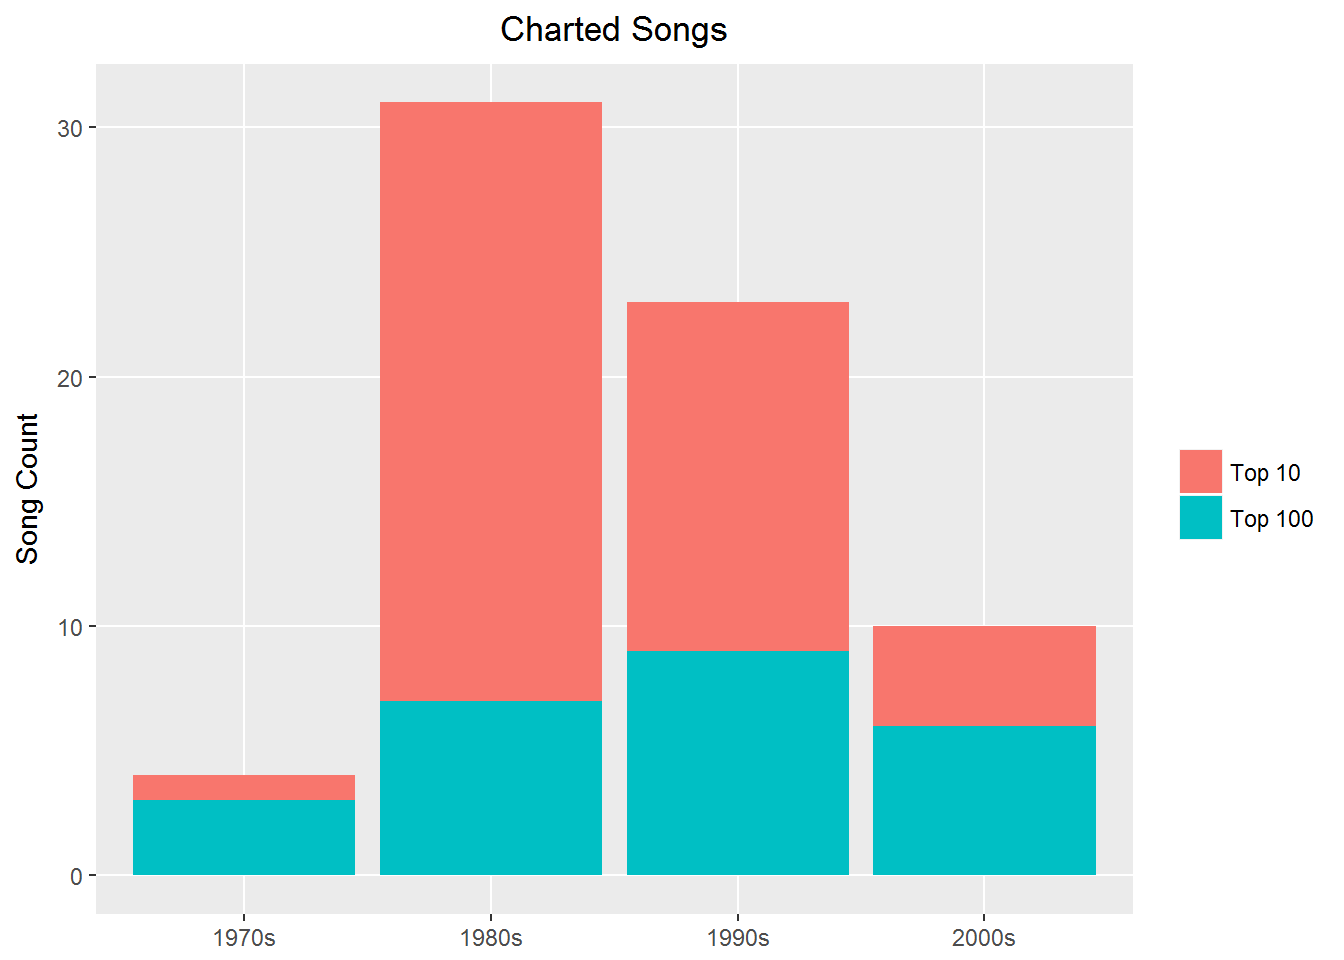
Val op dat van alle genoteerde nummers van Prince de meerderheid de Top 10 haalde. Nog interessanter: zijn meest productieve decennium qua nieuwe nummers was de jaren 90, maar meer hits verschenen in de jaren 80. Waarom is dat zo? Houd deze vraag in gedachten terwijl je de secties over text mining doorloopt.
Om de kracht van de volledige dataset voor tekstanalyse te gebruiken, kun je verwijzingen naar chart level en releasejaar verwijderen en heb je een veel grotere set nummers om te minen. Kijk maar:
#look at the full data set at your disposal
prince %>%
  group_by(decade, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot() +
  geom_bar(aes(x = decade, y = number_of_songs,
               fill = chart_level), stat = "identity")  +
  theme(plot.title = element_text(hjust = 0.5),
        legend.title = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = NULL, y = "Aantal nummers") +
  ggtitle("Alle nummers in data")
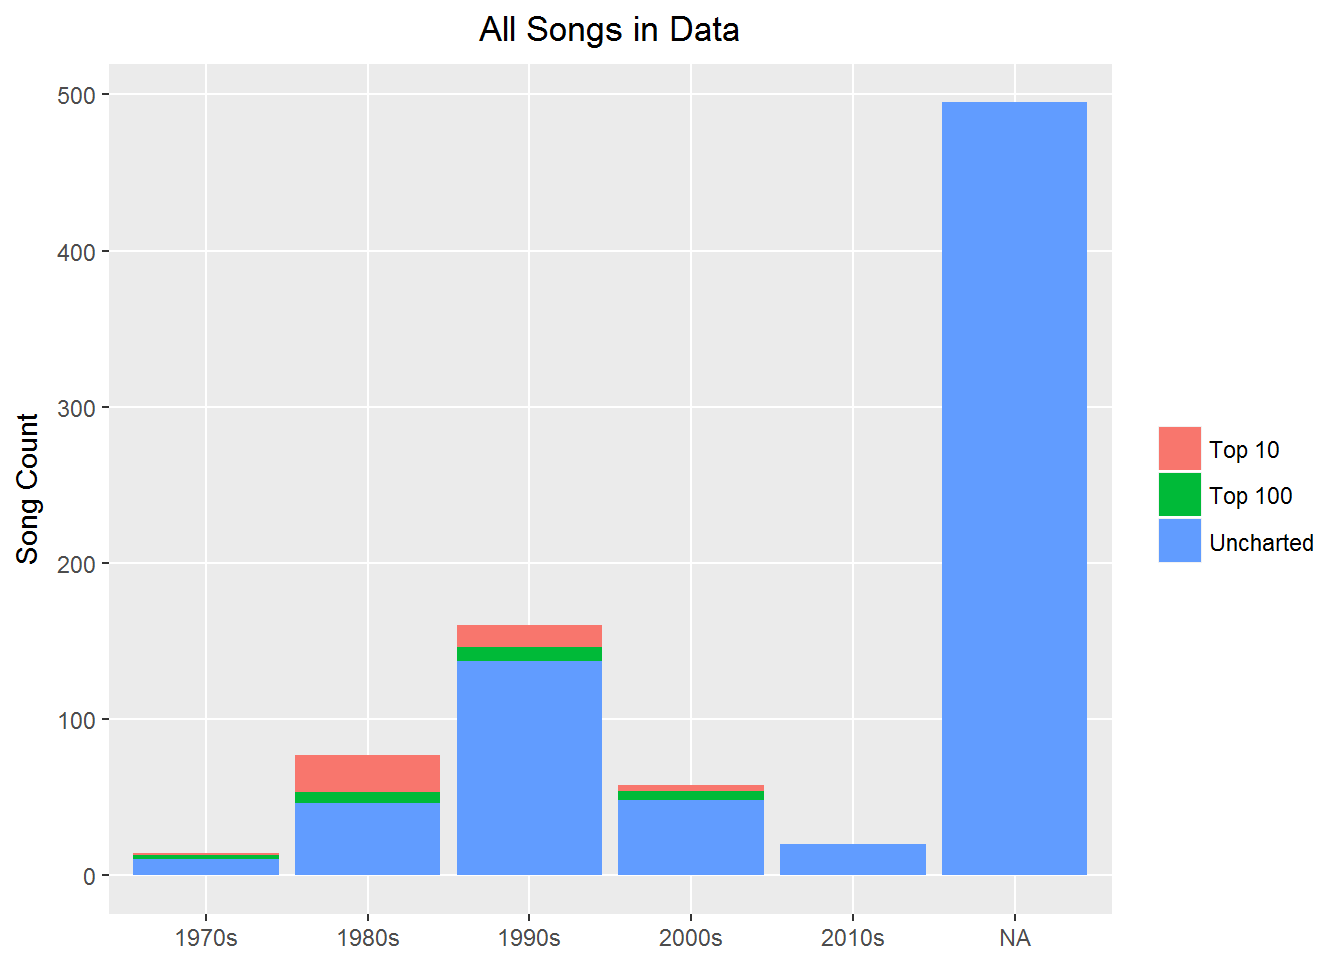
Zoals je ziet schreef Prince honderden nummers waarvoor in de data geen uitgavenaam staat. Voor sentimentanalyse of verkennende analyse kun je alle data gebruiken, maar voor trends door de tijd heb je met een veel kleinere set te maken. Dat is prima – maar goed om te onthouden.
Voor de fervente Prince-fans: hieronder een snelle blik op de nummers die op nr. 1 kwamen. (Merk op dat je kable() en kable_styling() uit de knitr- en kableExtra-pakketten en color_tile() uit formattable kunt gebruiken om netjes opgemaakte HTML-output te maken.)
library(knitr) # for dynamic reporting
library(kableExtra) # create a nicely formated HTML table
library(formattable) # for the color_tile function
prince %>%
  filter(peak == "1") %>%
  select(year, song, peak) %>%
  arrange(year) %>%
  mutate(year = color_tile("lightblue", "lightgreen")(year)) %>%
  mutate(peak = color_tile("lightgreen", "lightgreen")(peak)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Prince's No. 1 Songs") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| year | song | peak |
|---|---|---|
| 1979 | i wanna be your lover | 1 |
| 1984 | erotic city | 1 |
| 1984 | purple rain | 1 |
| 1984 | when doves cry | 1 |
| 1985 | around the world in a day | 1 |
| 1986 | kiss | 1 |
| 1988 | lovesexy | 1 |
| 1989 | batdance | 1 |
| 1990 | thieves in the temple | 1 |
| 1991 | diamonds and pearls | 1 |
| 1995 | the most beautiful girl in the world | 1 |
| 2006 | 3121 | 1 |
| 2007 | planet earth | 1 |
Text mining wordt ook wel text analytics genoemd. Het doel is relevante informatie te ontdekken die mogelijk onbekend is of onder de oppervlakte ligt. Natural Language Processing (NLP) is een methodologie die wordt gebruikt bij text mining. NLP probeert de ambiguïteiten in geschreven taal te doorgronden via tokenization, clustering, het extraheren van entiteiten en woordrelaties, en met algoritmen thema’s te identificeren en subjectieve informatie te kwantificeren. Je begint met het ontleden van het concept lexicale complexiteit.
Lexicale complexiteit kan in verschillende contexten verschillende dingen betekenen, maar ga er nu van uit dat het kan worden beschreven door een combinatie van deze maten:
Om de analyse te beginnen, moet je de songteksten opsplitsen in afzonderlijke woorden en beginnen met het delven naar inzichten. Dit proces heet tokenization.
Onthoud dat er verschillende methoden en dataformaten zijn die je kunt gebruiken voor text mining:
Maar voordat je iets tokenizet, is er nog één stap in de opschoning. Veel songteksten bevatten bij transcriptie zinnen als "Repeat Chorus" of labels zoals "Bridge" en "Verse". Er zijn ook nog veel andere ongewenste woorden die de resultaten vertroebelen. Na wat vooranalyse heb ik er een paar gekozen die ik alvast wil verwijderen.
Hieronder staat een lijst met overbodige woorden die handmatig moeten worden verwijderd:
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats")
Om de tokens te unnesten gebruik je de tidytext-library, die al is geladen. Nu kun je profiteren van de mogelijkheden van dplyr en meerdere stappen aan elkaar rijgen.
Binnen het tidy text-framework moet je zowel de tekst opsplitsen in afzonderlijke tokens (tokenization) als omzetten naar een tidy datastructuur. Gebruik hiervoor de functie unnest_tokens() van tidytext. unnest_tokens() vereist minimaal twee argumenten: de naam van de uitvoerkolom die wordt aangemaakt wanneer de tekst wordt uitgepakt (in dit geval "word"), en de invoerkolom die de huidige tekst bevat (dus lyrics).
Je kunt de dataset prince naar unnest_tokens() pipen en vervolgens stopwoorden verwijderen. Wat zijn stopwoorden? Die ken je maar al te goed. Het zijn zeer algemene woorden die mogelijk niets toevoegen aan onze resultaten. Er zijn verschillende lijsten om uit te kiezen, maar hier gebruik je het lexicon stop_words uit het tidytext-pakket.
Gebruik sample() om een willekeurige lijst van deze stopwoorden te tonen en head() om te beperken tot 15 woorden.
head(sample(stop_words$word, 15), 15)
 [1] "where"      "sensible"   "except"     "wouldn't"   "normally"   "relatively"
 [7] "has"        "said"       "yet"        "how"        "this"       "available"
[13] "therein"    "different"  "followed"
Dus na het tokenizen van de songteksten in woorden kun je dplyr’s anti_join() gebruiken om stopwoorden te verwijderen. Verwijder daarna de eerder gedefinieerde ongewenste woorden met dplyr’s filter()-werkwoord en de %in%-operator. Gebruik vervolgens distinct() om dubbele records te verwijderen. Tot slot kun je alle woorden met minder dan vier tekens verwijderen. Dit is opnieuw een subjectieve keuze, maar in songteksten zijn dit vaak tussenwerpsels zoals "yeah en hey". Sla de resultaten op in prince_words_filtered.
Opmerking: voor later gebruik is prince_words_filtered de tidy tekstversie van het data frame prince zonder 1) stopwoorden, 2) ongewenste woorden en 3) woorden van 1–3 tekens. Je gebruikt dit in sommige, maar niet alle analyses.
#unnest and remove stop, undesirable and short words
prince_words_filtered <- prince %>%
  unnest_tokens(word, lyrics) %>%
  anti_join(stop_words) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3)
Merk op dat stop_words een kolom word heeft, en dat door de functie unnest_tokens() een nieuwe kolom word is aangemaakt, dus anti_join() voegt automatisch samen op de kolom word.
Nu kun je de klasse en dimensies van je nieuwe tidy datastructuur bekijken:
class(prince_words_filtered)
[1] "data.frame"
dim(prince_words_filtered)
[1] 36916 10
prince_words_filtered is een data frame met 36916 totale woorden (niet unieke woorden) en 10 kolommen. Hier is een momentopname: (ik heb één woord gekozen, de weergave beperkt tot 10 nummers en select() gebruikt om de interessante velden op volgorde te printen, opnieuw met knitr voor de opmaak). Dit toont je de getokenizeerde, niet-gesommeerde, tidy datastructuur.
 prince_words_filtered %>%
  filter(word == "race") %>%
  select(word, song, year, peak, decade, chart_level, charted) %>%
  arrange() %>%
  top_n(10,song) %>%
  mutate(song = color_tile("lightblue","lightblue")(song)) %>%
  mutate(word = color_tile("lightgreen","lightgreen")(word)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Tokenized Format Example") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| word | song | year | peak | decade | chart_level | charted |
|---|---|---|---|---|---|---|
| race | lovesexy | 1988 | 1 | 1980s | Top 10 | Charted |
| race | my tree | NA | NA | NA | Uncharted | Uncharted |
| race | positivity | 1988 | NA | 1980s | Uncharted | Uncharted |
| race | race | 1994 | NA | 1990s | Uncharted | Uncharted |
| race | sexuality | 1981 | 88 | 1980s | Top 100 | Charted |
| race | slow love | 1987 | NA | 1980s | Uncharted | Uncharted |
| race | the rest of my life | 1999 | NA | 1990s | Uncharted | Uncharted |
| race | the undertaker | NA | NA | NA | Uncharted | Uncharted |
| race | u make my sun shine | NA | NA | NA | Uncharted | Uncharted |
| race | welcome 2 the rat race | NA | NA | NA | Uncharted | Uncharted |
Je ziet dat elke rij een individueel woord bevat dat wordt herhaald voor elk nummer waarin het voorkomt.
In muziek zijn individuele woordfrequenties erg belangrijk, of het nu om herhaling of zeldzaamheid gaat. Beide beïnvloeden de memorabiliteit van het hele nummer. Een vraag die een songwriter mogelijk wil weten, is of er een correlatie is tussen woordfrequentie en hits. Je wilt het tidy formaat nu een stap verder brengen en een gesommeerde telling van woorden per nummer krijgen.
Om dit formaat in Prince’ songteksten te onderzoeken, maak je een histogram dat de verdeling van woordentellingen laat zien, gegroepeerd per nummer, per plaatsing op de Billboard Charts. Unnest de prince-songteksten opnieuw zonder woorden te filteren om een echte telling van woordfrequentie over nummers te krijgen. Gebruik opnieuw group_by() en summarise() om tellingen te krijgen. Gebruik daarna het dplyr-werkwoord arrange() om op telling te sorteren. Bekijk eerst de hoogste tellingen en gebruik daarna ggplot() voor het histogram.
full_word_count <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,chart_level) %>%
  summarise(num_words = n()) %>%
  arrange(desc(num_words))

full_word_count[1:10,] %>%
  ungroup(num_words, song) %>%
  mutate(num_words = color_bar("lightblue")(num_words)) %>%
  mutate(song = color_tile("lightpink","lightpink")(song)) %>%
  kable("html", escape = FALSE, align = "c", caption = "Songs With Highest Word Count") %>%
  kable_styling(bootstrap_options =
                  c("striped", "condensed", "bordered"),
                  full_width = FALSE)
| song | chart_level | num_words |
|---|---|---|
| johnny | Uncharted | 1349 |
| cloreen bacon skin | Uncharted | 1263 |
| push it up | Uncharted | 1240 |
| the exodus has begun | Uncharted | 1072 |
| wild and loose | Uncharted | 1031 |
| jughead | Uncharted | 940 |
| my name is prince | Top 10 | 916 |
| acknowledge me | Uncharted | 913 |
| the walk | Uncharted | 883 |
| the purple medley | Uncharted | 874 |
full_word_count %>%
  ggplot() +
    geom_histogram(aes(x = num_words, fill = chart_level )) +
    ylab("Aantal nummers") +
    xlab("Aantal woorden per nummer") +
    ggtitle("Verdeling woordentelling") +
    theme(plot.title = element_text(hjust = 0.5),
          legend.title = element_blank(),
          panel.grid.minor.y = element_blank())
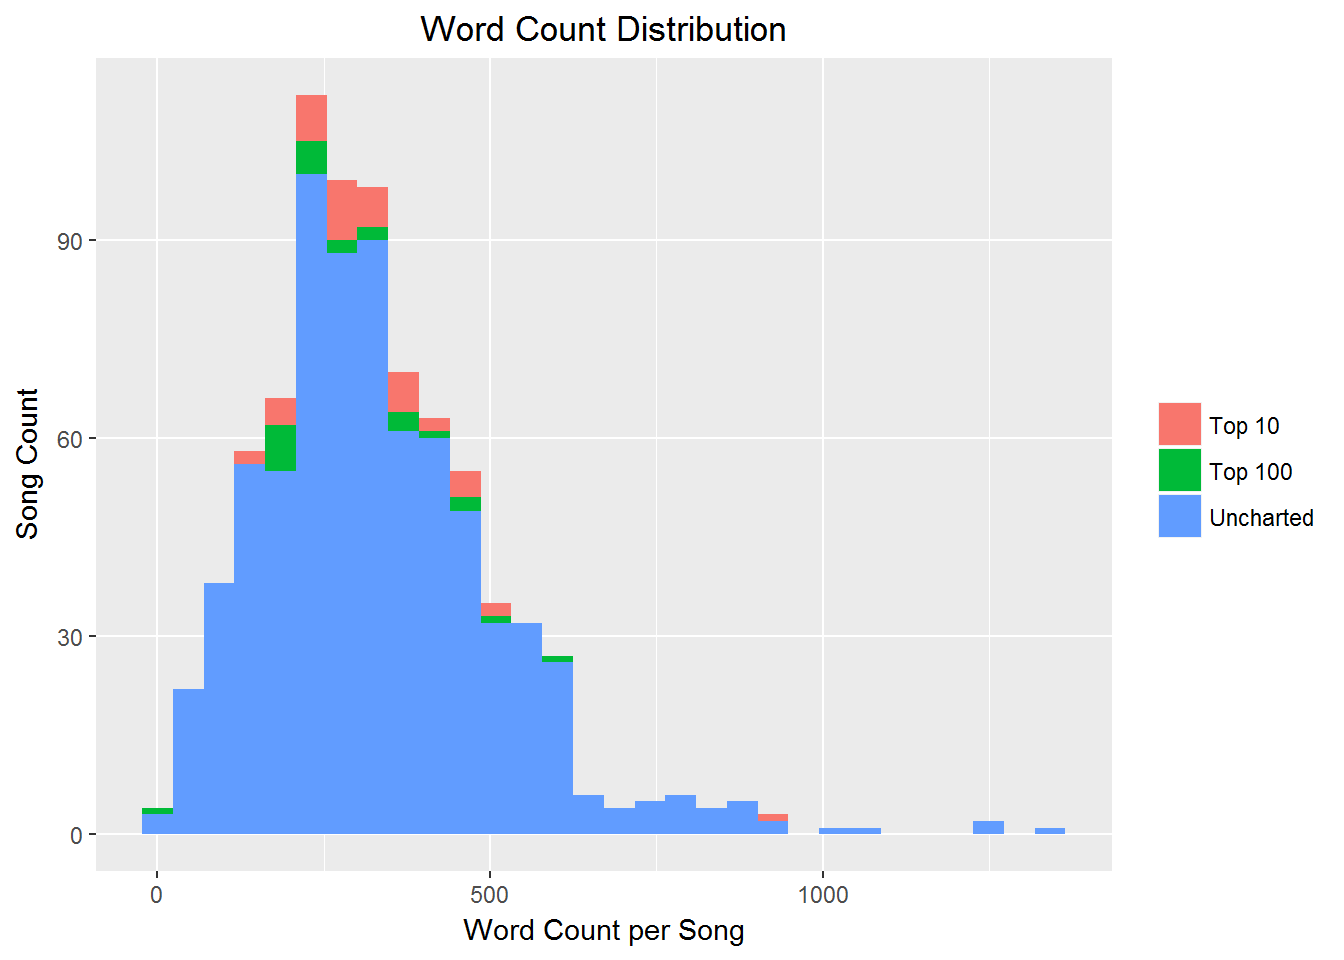
Let op de scheve verdeling naar rechts. Gezien de aard van de transcriptie van songteksten ben ik sceptisch over invoerfouten. Uit nieuwsgierigheid: bekijk dat Top 10-nummer met meer dan 800 woorden eens.
full_word_count %>%
  filter(chart_level == 'Top 10' & num_words > 800) %>%
  left_join(prince_orig, by = "song") %>%
  select(Song = song,
         "Word Count" = num_words,
         "Peak Position" = peak,
         "US Pop" = US.Pop,
         "US R&B" = US.R.B,
         Canada = CA,
         Ireland = IR) %>%
  kable("html", escape = FALSE) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"))
| Song | Word Count | Peak Position | US Pop | US R&B | Canada | Ireland |
|---|---|---|---|---|---|---|
| my name is prince | 916 | 5 | 36 | 25 | 5 | 5 |
Uit een beetje onderzoek bleek dat dit specifieke nummer een gastartiest heeft die een rapgedeelte doet. Dat verklaart het zeker! Onthoud dat deze dataset Pop- en R&B-lijsten wereldwijd beslaat, dus genre en geografie kunnen je aannames sterk beïnvloeden. Merk op dat de Amerikaanse Popnotering veel lager was dan andere lijsten, met een piek op 5 in Canada, bijvoorbeeld. Goed om in gedachten te houden.
Challenge: als je geïnspireerd bent om zelf met muziekanalyse aan de slag te gaan, kijk dan eens naar The Million Song Dataset, met meer dan 50 features (bijv. tempo, luidheid, danceability, enz.) voor bijna 50.000 artiesten! Het toevoegen van muzikale features aan songteksten levert een zeer uitgebreide analyse op.
Om een simpele evaluatie te doen van de meest gebruikte woorden in de volledige set songteksten, kun je count() en top_n() gebruiken om de n topwoorden uit je schone, gefilterde dataset te halen. Gebruik daarna reorder() om woorden op basis van de telling te sorteren en dplyr’s mutate() om de geordende waarde toe te wijzen aan word. Zo kan ggplot() dit netjes weergeven.
prince_words_filtered %>%
  count(word, sort = TRUE) %>%
  top_n(10) %>%
  ungroup() %>%
  mutate(word = reorder(word, n)) %>%
  ggplot() +
    geom_col(aes(word, n), fill = my_colors[4]) +
    theme(legend.position = "none",
          plot.title = element_text(hjust = 0.5),
          panel.grid.major = element_blank()) +
    xlab("") +
    ylab("Aantal nummers") +
    ggtitle("Meest gebruikte woorden in Prince’ songteksten") +
    coord_flip()
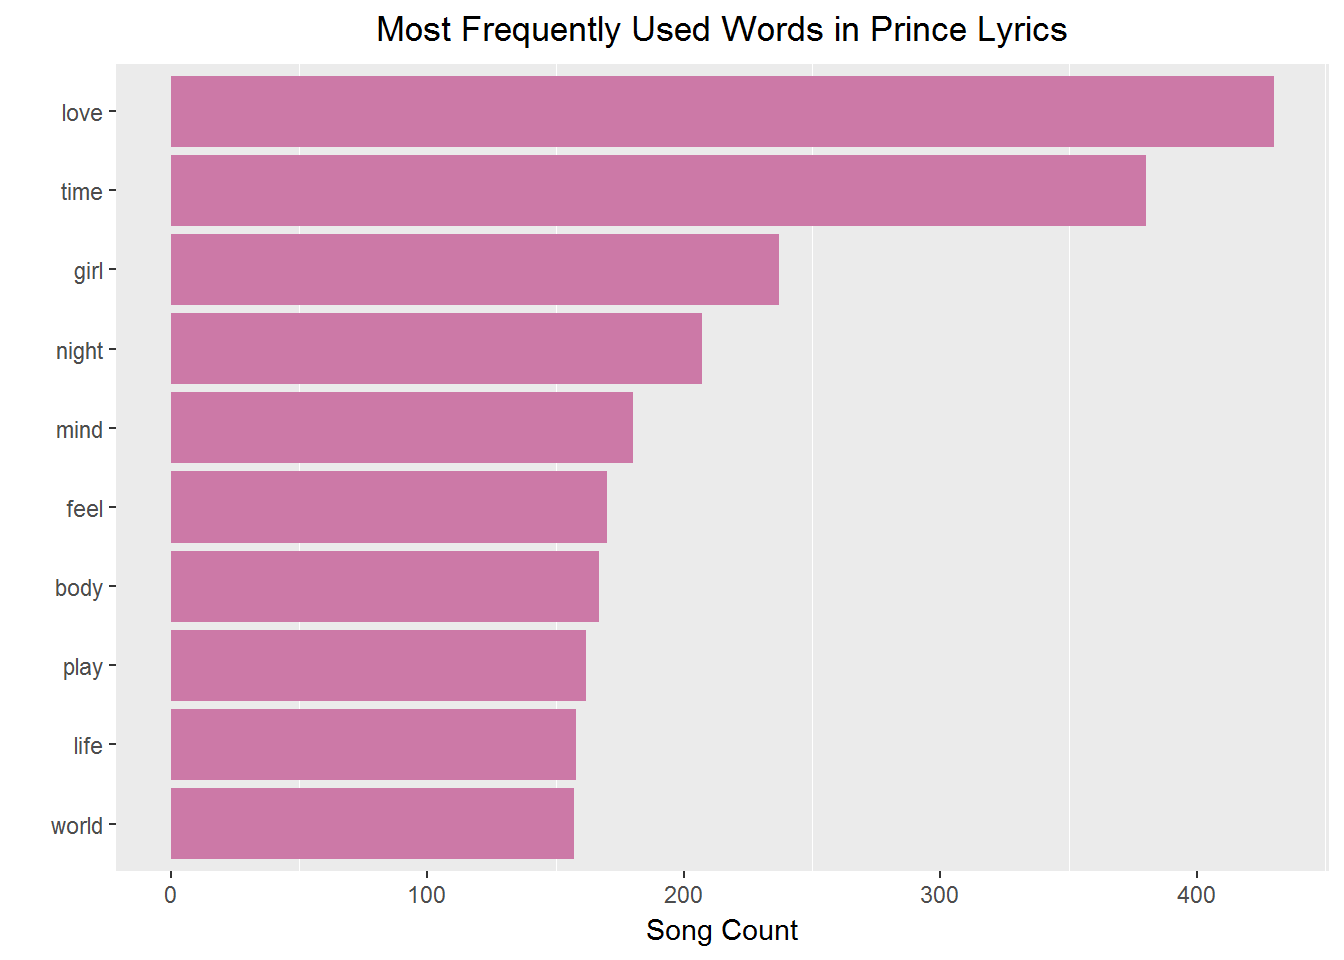
Zoals in de meeste populaire muziek lijkt love een veelvoorkomend thema. Ik zou op basis van alleen deze topwoorden weinig aannames doen, maar je krijgt zeker enig inzicht in het perspectief van de artiest – alleen nog niet het volledige beeld. Neem voordat we dieper graven even de tijd voor wat visueel plezier.
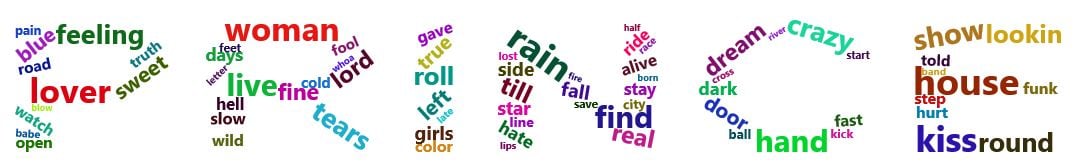
Woordwolken hebben een slechte reputatie in bepaalde kringen, en als je er niet zorgvuldig mee omgaat, kunnen ze buiten context worden gebruikt waar ze niet passend zijn. Maar we zijn van nature zeer visueel ingesteld, en er zijn gevallen waarin je er echt inzicht mee kunt krijgen. Bekijk enkele voorbeelden van Sandy McKee hier. Gebruik ze met een korreltje zout.
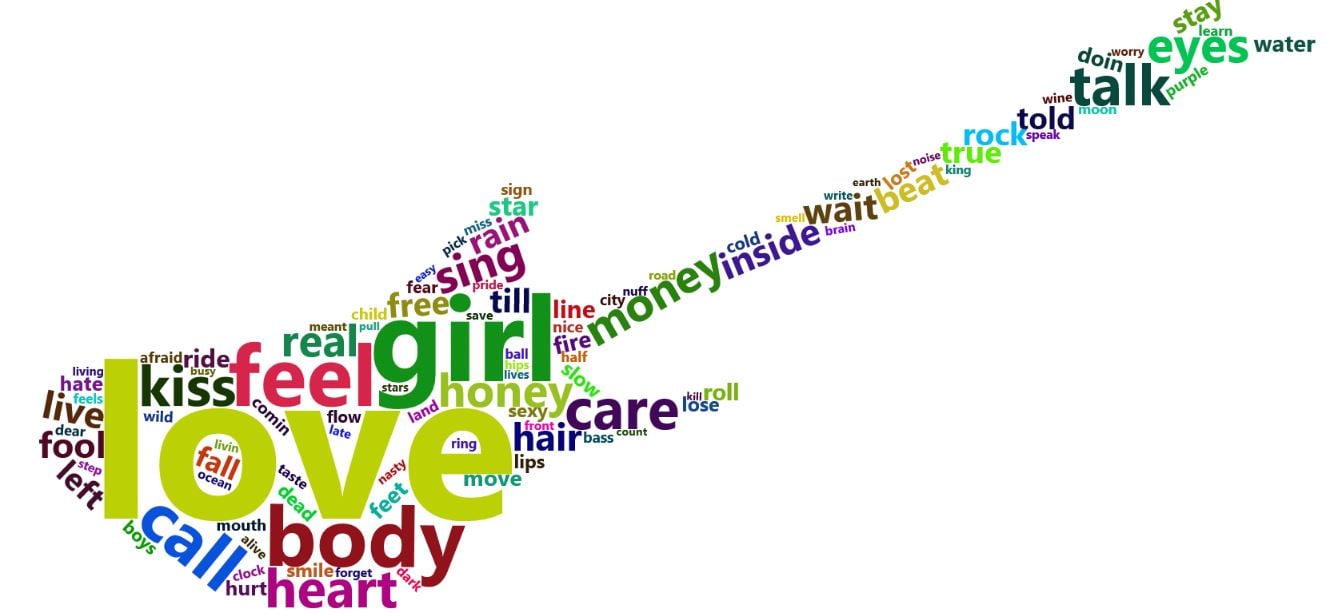
Maar kijk nu eens naar een nieuw pakket, wordcloud2, voor wat coole dingen. Dit pakket geeft je een creatieve verzameling clouds die html-widgets genereren. Je kunt zelfs over een woord hoveren om de frequentie ervan in de tekst te zien. (Dit pakket kan traag renderen in rMarkdown en is vaak kieskeurig over de gebruikte browser. Hopelijk volgen er verbeteringen.)
prince_words_counts <- prince_words_filtered %>%
  count(word, sort = TRUE)

wordcloud2(prince_words_counts[1:300, ], size = .5)
En voor nóg meer plezier kun je een beetje data art toevoegen ...
wordcloud2(prince_words_counts[1:300, ], figPath = "guitar_icon.png",
           color = "random-dark", size = 1.5)

letterCloud(prince_words_counts[1:300, ], word = "PRINCE", size = 2)
Tot nu toe heb je alleen de topwoorden over alle nummers bekeken. Wat gebeurt er als je ze opdeelt naar chart level? Komen bepaalde woorden vaker voor in nummers die de lijsten haalden dan in ongenoteerde nummers? Dit zijn woorden die door de samenleving als populair worden gezien.
Let in de onderstaande code op het gebruik van slice(seq_len(n)) om de eerste n woorden in elk chart_level te pakken. Dit werkt anders dan top_n() en blijkt een goede keuze bij facetten in je plot. (Onthoud: er zijn altijd verschillende manieren om dit soort trucjes te doen.) Je kunt ook de functie row_number() gebruiken om ervoor te zorgen dat je de woorden in de juiste volgorde in de grafiek kunt tonen. ggplot() sorteert woorden standaard alfabetisch en het is goede gewoonte om vóór het plotten zelf te sorteren.
popular_words <- prince_words_filtered %>%
  group_by(chart_level) %>%
  count(word, chart_level, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level,n) %>%
  mutate(row = row_number())

popular_words %>%
  ggplot(aes(row, n, fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Aantal nummers") +
    ggtitle("Populaire woorden per chart level") +
    theme_lyrics() +
    facet_wrap(~chart_level, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = popular_words$row, # notice need to reuse data frame
      labels = popular_words$word) +
    coord_flip()
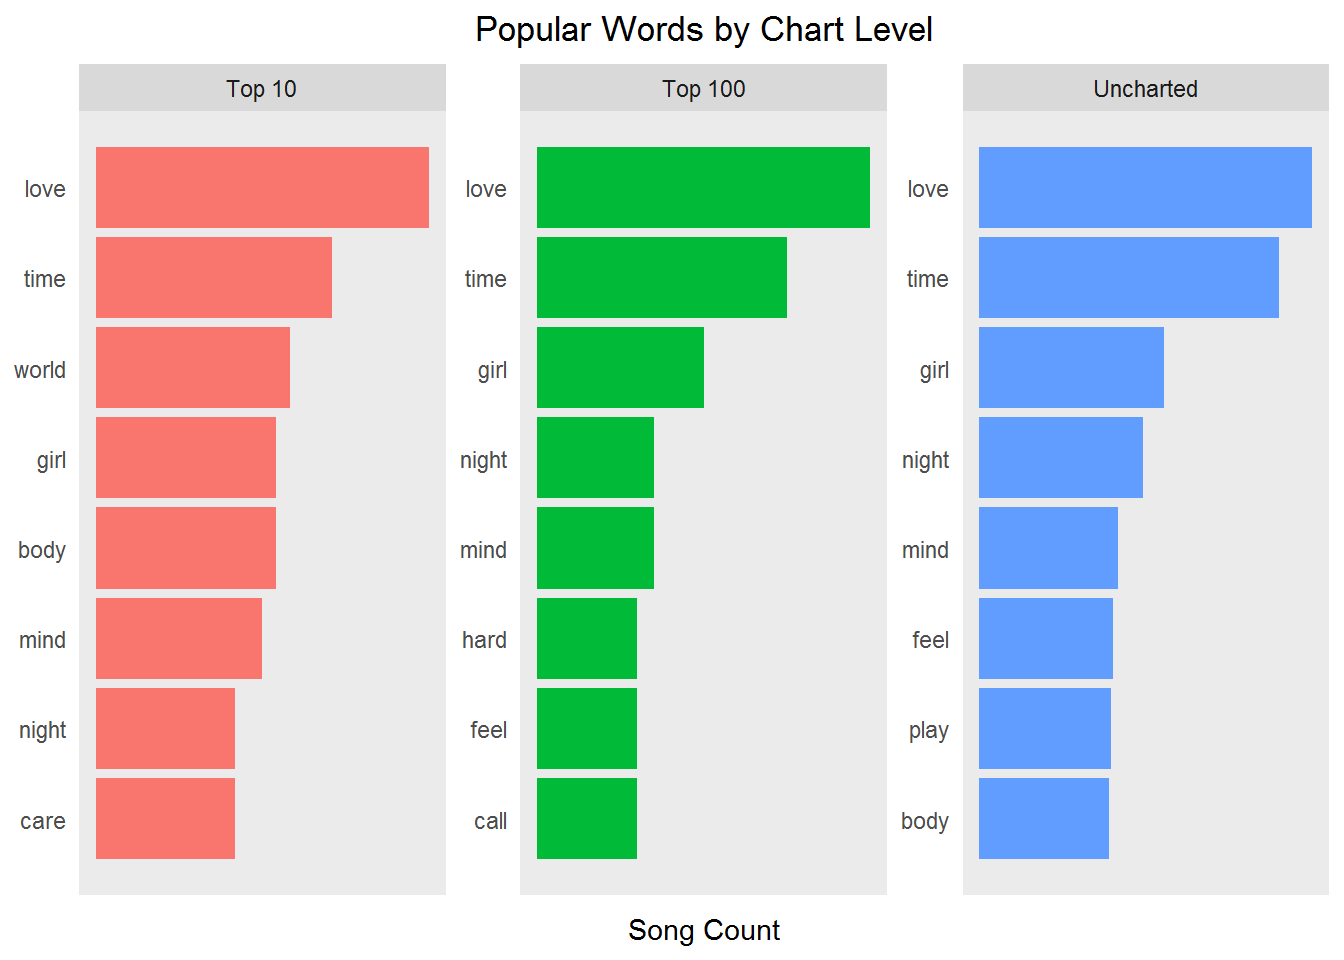
Welke inzichten haal je hier nu uit?
Nou, de topwoorden over de chart levels heen zijn erg, erg vergelijkbaar. Dit ziet er niet best uit voor onze hoop om te voorspellen of een nummer succesvol zal zijn op basis van songteksten! Maar je hebt nog maar aan de oppervlakte gekrabd van wat mogelijk is met text mining, en later NLP en voorspellende modellering.
Sommige woorden in muziek worden als tijdloos beschouwd. Tijdloze woorden doorstaan de tand des tijds en spreken een groot publiek aan. Als je je analyse uitsplitst per decennium, zullen deze woorden boven komen drijven. Gebruik filteren, groeperen en aggregatie om de topwoorden per decennium uit Prince’ songteksten te halen en te zien welke woorden als tijdloos of trendy kunnen worden beschouwd. Je kunt ggplot() met facet_wrap() gebruiken om per decennium te bekijken.
timeless_words <- prince_words_filtered %>%
  filter(decade != 'NA') %>%
  group_by(decade) %>%
  count(word, decade, sort = TRUE) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade,n) %>%
  mutate(row = row_number())

timeless_words %>%
  ggplot(aes(row, n, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "Aantal nummers") +
    ggtitle("Tijdloze woorden") +
    theme_lyrics() +
    facet_wrap(~decade, scales = "free", ncol = 5) +
    scale_x_continuous(  # This handles replacement of row
      breaks = timeless_words$row, # notice need to reuse data frame
      labels = timeless_words$word) +
    coord_flip()
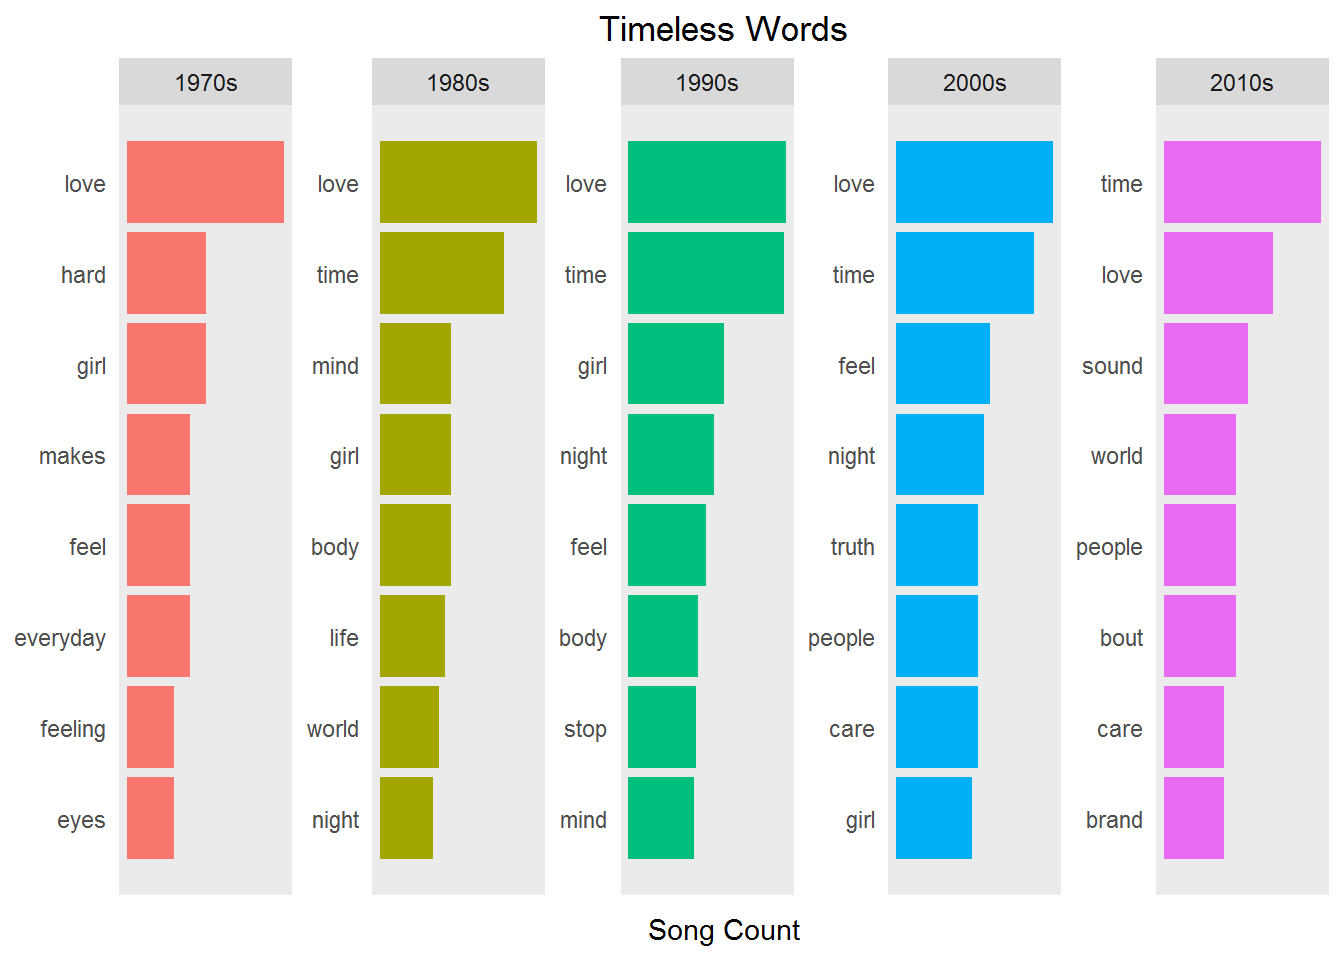
Duidelijk is dat love, time en girl tijdloos zijn. Maar hoe makkelijk is het om trendwoorden te spotten? Was truth rond de eeuwwisseling in opkomst? Of is het simpelweg zo dat zoiets gewoon een sterk herhaald woord is in bepaalde nummers? Identificeert frequentie daadwerkelijk thema’s? Werkt dit voor songteksten op dezelfde manier als voor andere text-miningtaken, zoals het analyseren van State of the Union-toespraken?
Woordlengte is een interessant onderwerp voor songwriters. Hoe langer het woord, hoe lastiger het is om te rijmen en in een patroon te persen. Het onderstaande histogram van woordlengtes is zoals je zou verwachten, met een paar extreem lange uitzonderingen.
#unnest and remove undesirable words, but leave in stop and short words
prince_word_lengths <- prince %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,decade) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  mutate(word_length = nchar(word))

prince_word_lengths %>%
  count(word_length, sort = TRUE) %>%
  ggplot(aes(word_length),
         binwidth = 10) +
    geom_histogram(aes(fill = ..count..),
                   breaks = seq(1,25, by = 2),
                   show.legend = FALSE) +
    xlab("Woordlengte") +
    ylab("Aantal woorden") +
    ggtitle("Verdeling woordlengte") +
    theme(plot.title = element_text(hjust = 0.5),
          panel.grid.minor = element_blank())
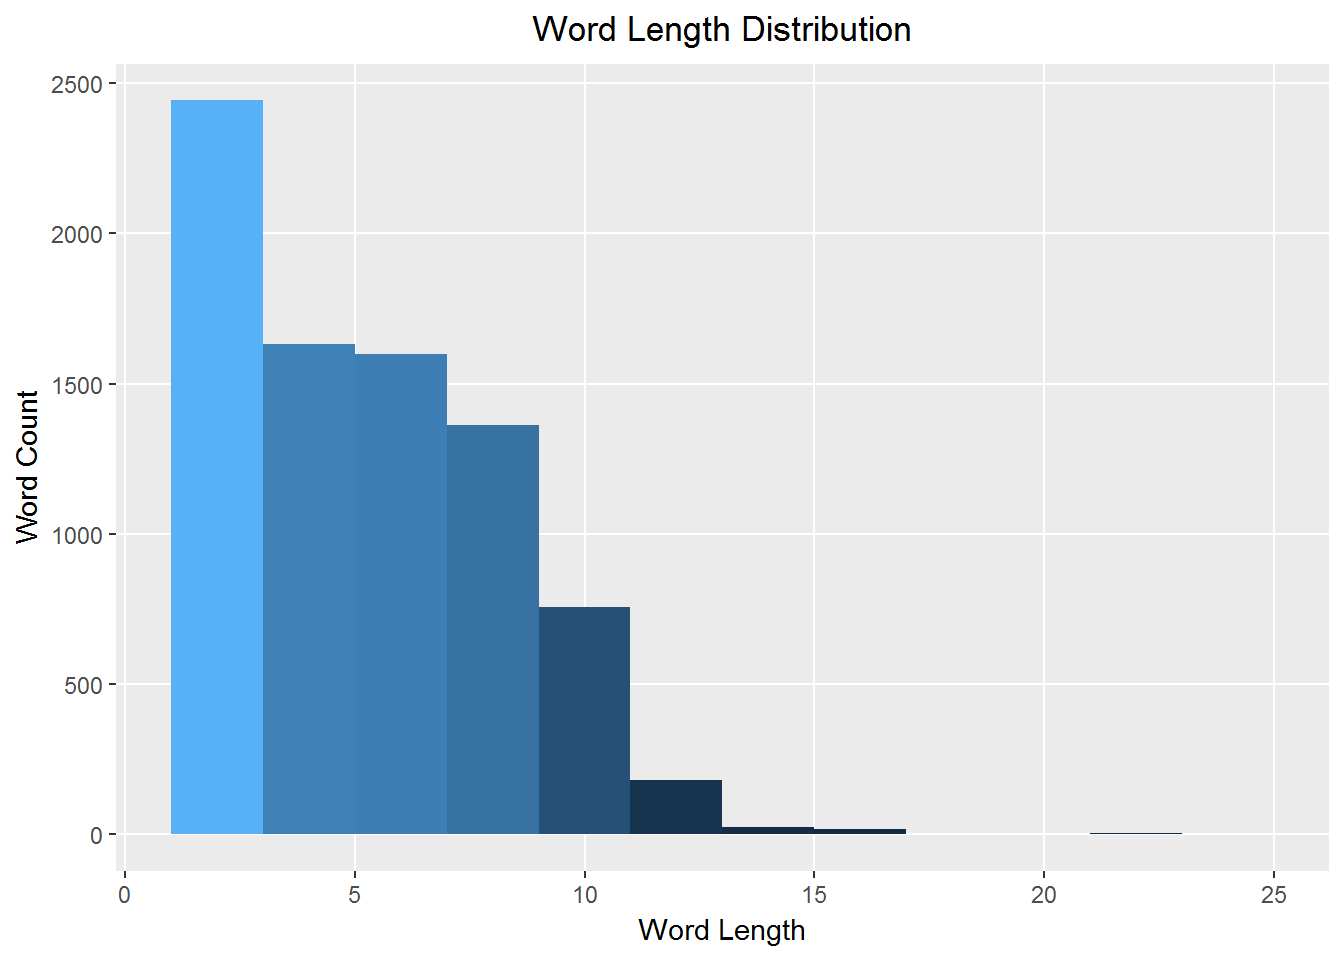
Wat zijn die extreem lange woorden? Tijd voor een uiterst vermakelijke woordwolk! Deze is gebaseerd op woordlengte in plaats van woordfrequentie. Kijk maar:
wc <- prince_word_lengths %>%
  ungroup() %>%
  select(word, word_length) %>%
  distinct() %>%
  arrange(desc(word_length))

wordcloud2(wc[1:300, ],
           size = .15,
           minSize = .0005,
           ellipticity = .3,
           rotateRatio = 1,
           fontWeight = "bold")
Hoe gevarieerder het vocabulaire van een tekst, hoe hoger de lexicale diversiteit. Songvocabulaire is een weergave van hoeveel unieke woorden in een nummer worden gebruikt. Dit kun je tonen met een eenvoudige grafiek van het gemiddelde aantal unieke woorden per nummer over de jaren. Je wilt de originele dataset opnieuw tokenizen maar alle stop- en korte woorden laten staan, omdat je in deze plot meer naar kwantitatieve inzichten kijkt.
lex_diversity_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_diversity = n_distinct(word)) %>%
  arrange(desc(lex_diversity))

diversity_plot <- lex_diversity_per_year %>%
  ggplot(aes(year, lex_diversity)) +
    geom_point(color = my_colors[3],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black", se = FALSE, method = "lm") +
    geom_smooth(aes(x = year, y = lex_diversity), se = FALSE,
                color = "blue", lwd = 2) +
    ggtitle("Lexicale diversiteit") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

diversity_plot
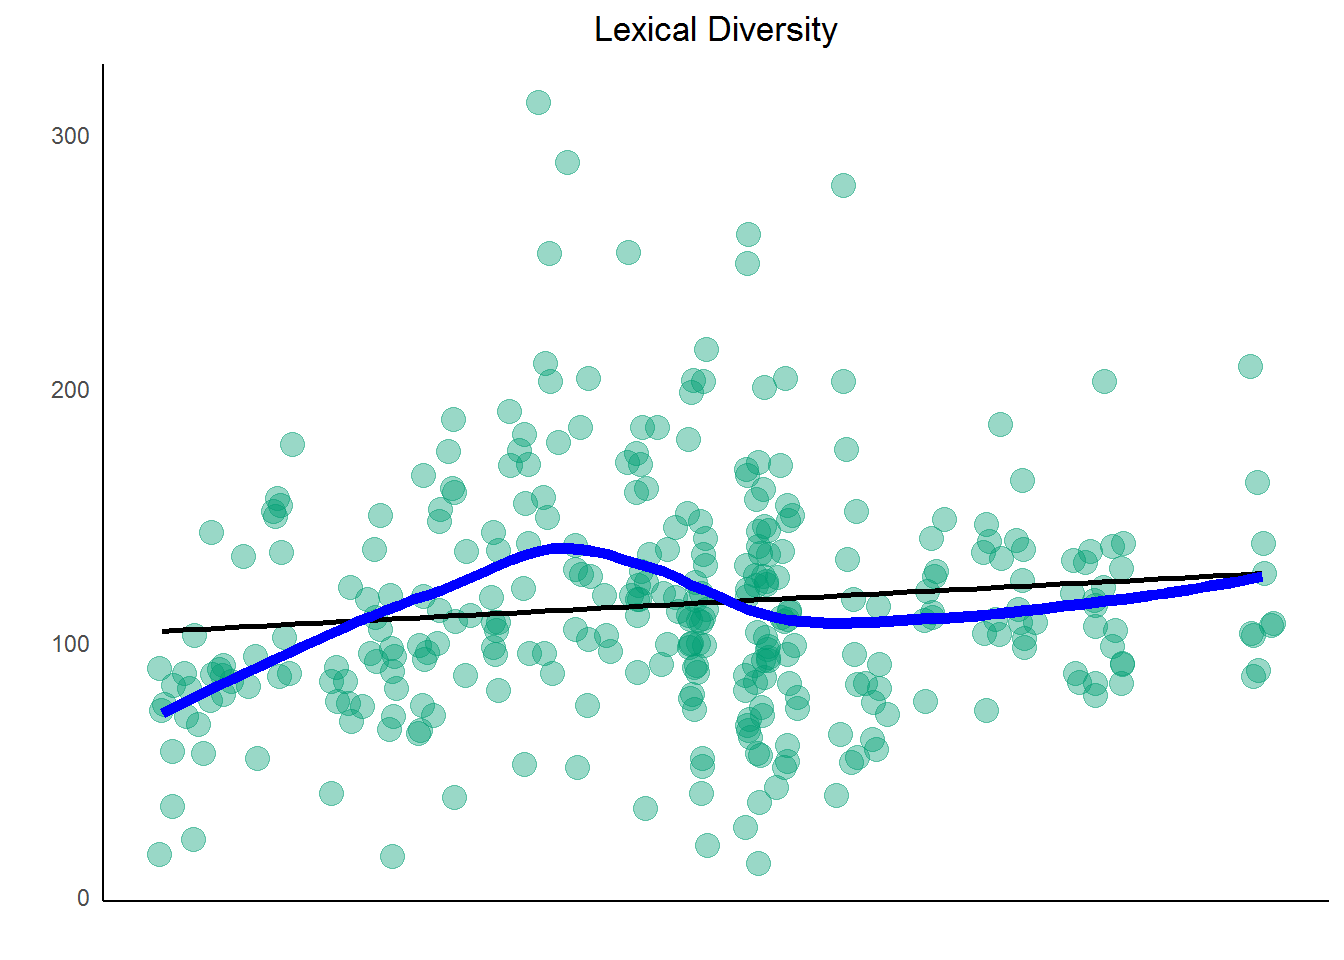
Wat betekent dit? In de afgelopen decennia is er een lichte opwaartse trend in de diversiteit van Prince’ songteksten. Hoe correleert dit met chartsucces? Lastig te zeggen, maar plot alvast dichtheid en hitlijstgeschiedenis ter vergelijking.
Onthoud dat voor deze tutorial lexicale dichtheid is gedefinieerd als het aantal unieke woorden gedeeld door het totale aantal woorden. Dit is een indicator van woordherhaling, een cruciaal gereedschap voor songwriters. Naarmate de lexicale dichtheid toeneemt, neemt herhaling af. (Opmerking: dit impliceert geen sequentiële herhaling, wat weer een ander songwriterstrucje is.)
Bekijk de lexicale dichtheid van Prince door de jaren heen. Voor dichtheid kun je het beste alle woorden, inclusief stopwoorden, laten staan. Start dus met de originele dataset en unnest de woorden. Groepeer op song en year en gebruik n_distinct() en n() om de dichtheid te berekenen. Pipe dat naar ggplot() met geom_smooth(). Voeg een extra stat_smooth() toe met method="lm" voor een lineair smoothmodel.
lex_density_per_year <- prince %>%
  filter(decade != "NA") %>%
  unnest_tokens(word, lyrics) %>%
  group_by(song,year) %>%
  summarise(lex_density = n_distinct(word)/n()) %>%
  arrange(desc(lex_density))

density_plot <- lex_density_per_year %>%
  ggplot(aes(year, lex_density)) +
    geom_point(color = my_colors[4],
               alpha = .4,
               size = 4,
               position = "jitter") +
    stat_smooth(color = "black",
                se = FALSE,
                method = "lm") +
    geom_smooth(aes(x = year, y = lex_density),
                se = FALSE,
                color = "blue",
                lwd = 2) +
    ggtitle("Lexicale dichtheid") +
    xlab("") +
    ylab("") +
    scale_color_manual(values = my_colors) +
    theme_classic() +
    theme_lyrics()

density_plot
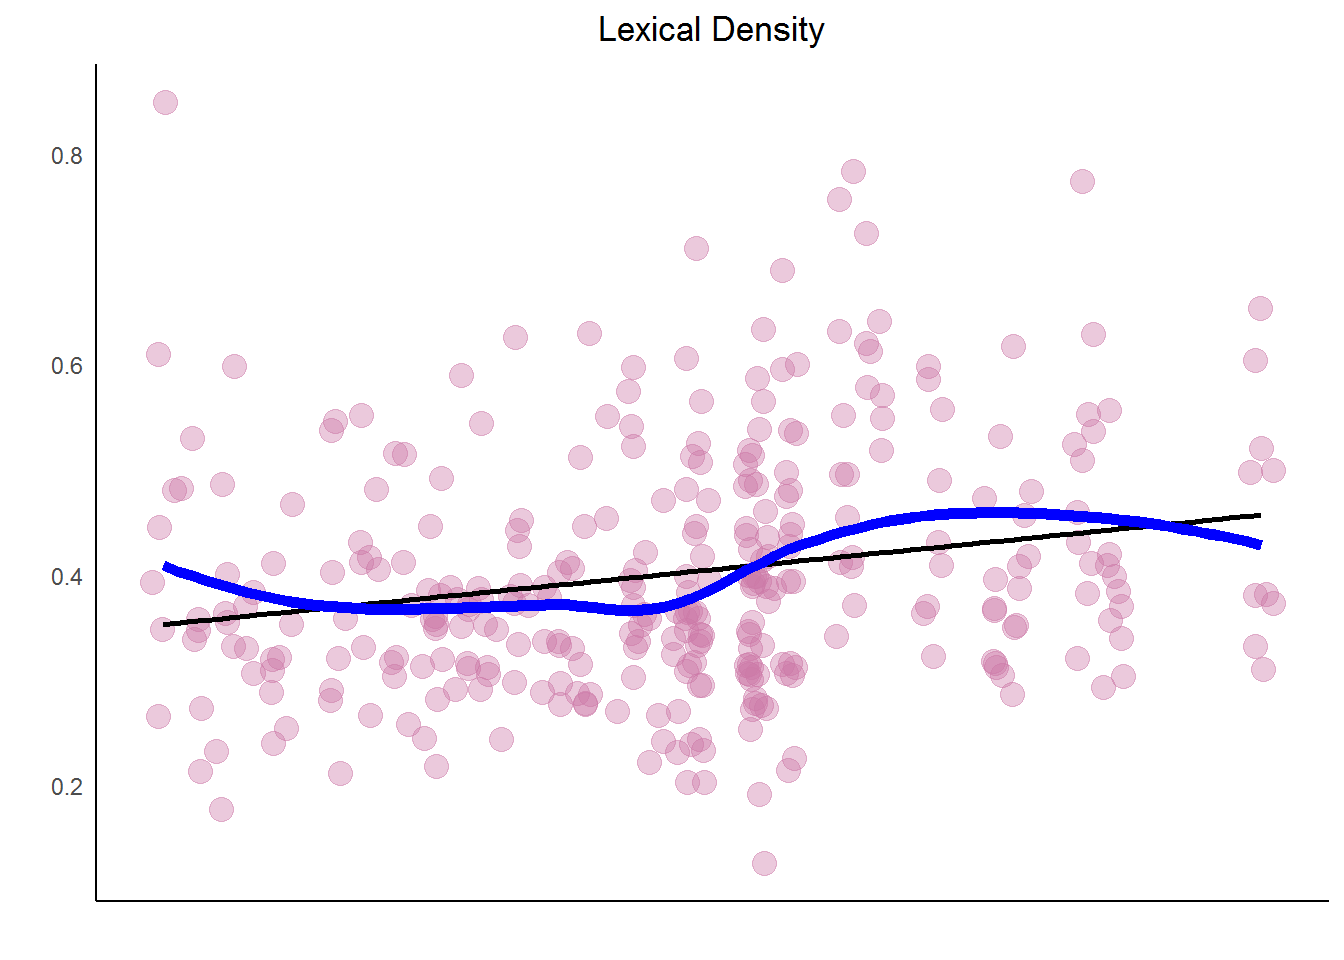
Om de trends te vergelijken, maak je een plot van zijn hitlijstgeschiedenis (d.w.z. succesvolle nummers die de lijsten haalden) en vergelijk je die met diversiteit en dichtheid. Gebruik grid.arrange() uit gridExtra om ze naast elkaar te zetten.
chart_history <- prince %>%
  filter(peak > 0) %>%
  group_by(year, chart_level) %>%
  summarise(number_of_songs = n()) %>%
  ggplot(aes(year, number_of_songs)) +
    geom_point(color = my_colors[5],
               alpha = .4,
               size = 4,
               position = "jitter") +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                method = "lm",
                color = "black" ) +
    geom_smooth(aes(x = year, y = number_of_songs),
                se = FALSE,
                color = "blue",
                lwd = 2) +
   ggtitle("Hitlijstgeschiedenis") +
   xlab("") +
   ylab("") +
   scale_color_manual(values = my_colors) +
   theme_classic() +
   theme_lyrics()

grid.arrange(diversity_plot, density_plot, chart_history, ncol = 3)
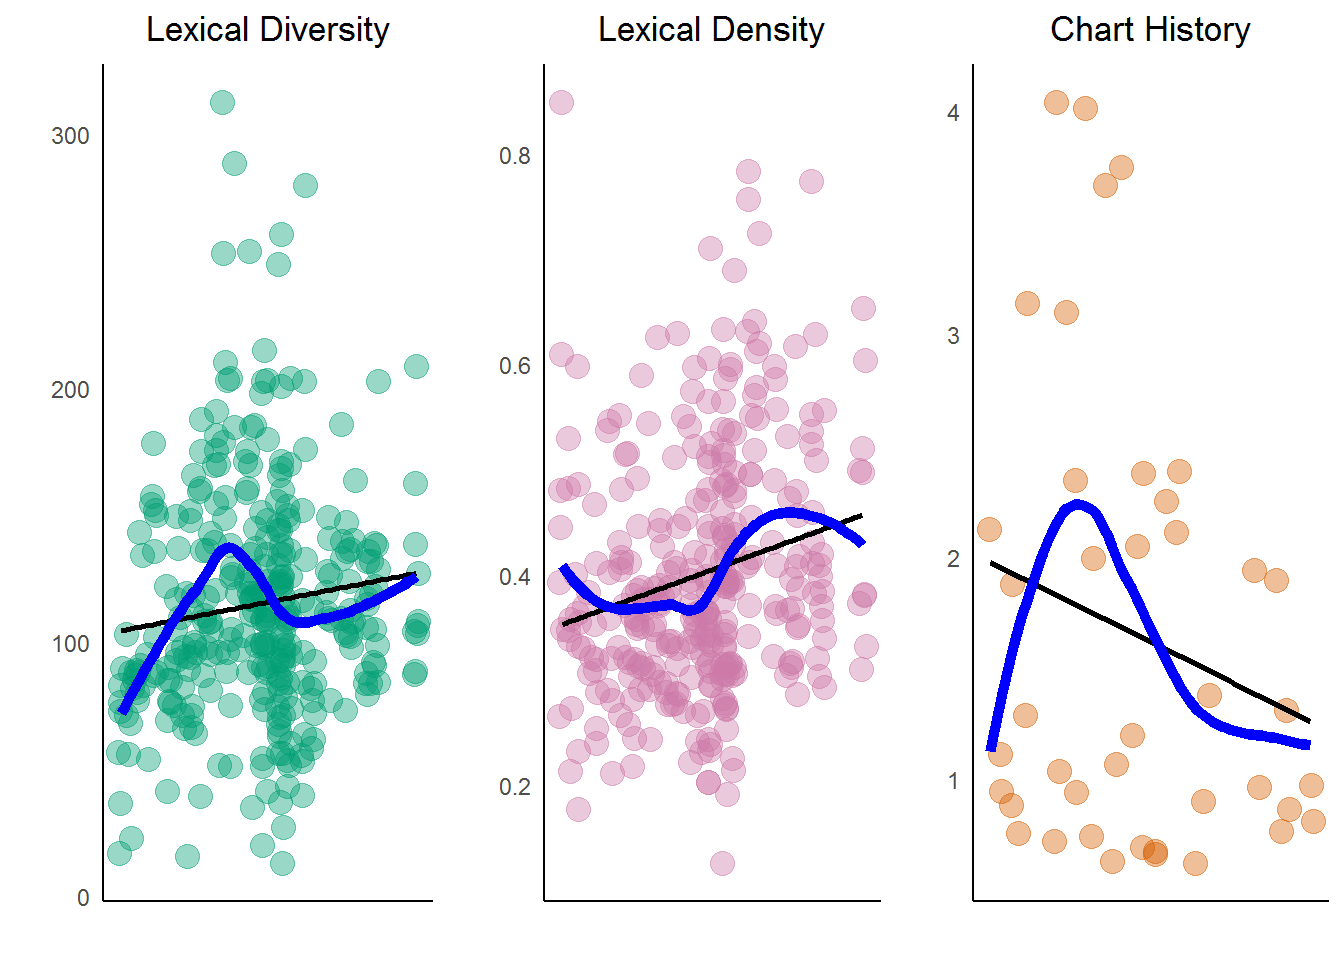
Hieruit zie je dat er een lichte toename is in de lexicale diversiteit en dichtheid van Prince’ werk door de jaren heen. Hoe verhoudt deze trend zich tot alle populaire muziek? Eén studie laat zien dat hits een dalende lexicale dichtheid laten zien, wat wijst op meer herhaling (oftewel "meer woorden met minder te zeggen"). Dat is niet wat er bij Prince’ nummers gebeurde. Een andere studie onthult dat in alle populaire muziek de diversiteit (unieke woorden) door de tijd is toegenomen, wat positief correleert met Prince’ muziek. Dit hangt wellicht samen met grotere genrediversiteit in hitlijsten door de geschiedenis heen. Genre is een cruciaal stuk data dat in deze dataset ontbreekt. Zou het kunnen dat zijn hitlijstgeschiedenis afneemt voor popmuziek maar toeneemt voor R&B/rap?
Challenge: ik laat het aan jou om over deze resultaten na te denken en moedig je zelfs aan om andere datasets te zoeken waarop je deze vaardigheden zelf kunt toepassen! Onthoud: correlatie impliceert geen causaliteit.
De methode die je tot nu toe hebt gebruikt, kijkt naar de gehele dataset, maar heeft nog niet aangepakt hoe je kunt kwantificeren hoe belangrijk bepaalde termen in een document zijn ten opzichte van een hele collectie. Je hebt naar termfrequentie gekeken en stopwoorden verwijderd, maar dat is misschien niet de meest geavanceerde aanpak.
Enter TF-IDF. TF is "term frequency". IDF is "inverse document frequency", dat een lagere weging geeft aan veelgebruikte woorden en een hogere weging aan woorden die weinig voorkomen in een tekstcollectie. Als je TF en IDF combineert, wordt het belang van een term aangepast op basis van hoe zelden die wordt gebruikt. De aanname achter TF-IDF is dat termen die vaker in een document voorkomen een hogere weging moeten krijgen, tenzij ze ook in veel documenten voorkomen. De formule kan als volgt worden samengevat:
De IDF van een term is dus hoger voor woorden die in minder documenten in de collectie voorkomen. Je kunt deze nieuwe aanpak gebruiken om de belangrijkste woorden per chart level te onderzoeken met de functie bind_tf_idf() uit tidytext. Deze functie berekent en voegt TF en IDF toe, samen met het product TF*IDF. Het neemt een tidy tekstdataset als input met één rij per token (woord), per document (nummer). Je ziet de resultaten in nieuwe kolommen.
Nemen we dus het oorspronkelijke Prince-data frame en unnest tokens naar woorden, verwijder ongewenste woorden, maar laat de stopwoorden staan. Gebruik vervolgens bind_tf_idf() om de formules te draaien en nieuwe kolommen aan te maken.
 popular_tfidf_words <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words) %>%
  filter(nchar(word) > 3) %>%
  count(chart_level, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, chart_level, n)

head(popular_tfidf_words)
## # A tibble: 6 x 6
##   chart_level  word     n          tf   idf tf_idf
##         <chr> <chr> <int>       <dbl> <dbl>  <dbl>
## 1   Uncharted  that   622 0.010942420     0      0
## 2   Uncharted  your   529 0.009306335     0      0
## 3   Uncharted  what   496 0.008725789     0      0
## 4   Uncharted  will   481 0.008461904     0      0
## 5   Uncharted  this   464 0.008162834     0      0
## 6   Uncharted  know   441 0.007758211     0      0
Nu zie je dat IDF en TF-IDF 0 zijn voor extreem algemene woorden. (Technisch gezien is de IDF-term de natuurlijke logaritme van 1 en dus nul voor deze woorden.) Pipe je resultaten van hierboven naar arrange() en sorteer aflopend op tf-idf. Voeg nog een paar stappen toe en je ziet een andere manier om naar de woorden in Prince’ songteksten te kijken.
top_popular_tfidf_words <- popular_tfidf_words %>%
  arrange(desc(tf_idf)) %>%
  mutate(word = factor(word, levels = rev(unique(word)))) %>%
  group_by(chart_level) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(chart_level, tf_idf) %>%
  mutate(row = row_number())

top_popular_tfidf_words %>%
  ggplot(aes(x = row, tf_idf,
             fill = chart_level)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Belangrijke woorden met TF-IDF per chart level") +
    theme_lyrics() +
    facet_wrap(~chart_level, ncol = 3, scales = "free") +
    scale_x_continuous(  # This handles replacement of row
      breaks = top_popular_tfidf_words$row, # notice need to reuse data frame
      labels = top_popular_tfidf_words$word) +
    coord_flip()
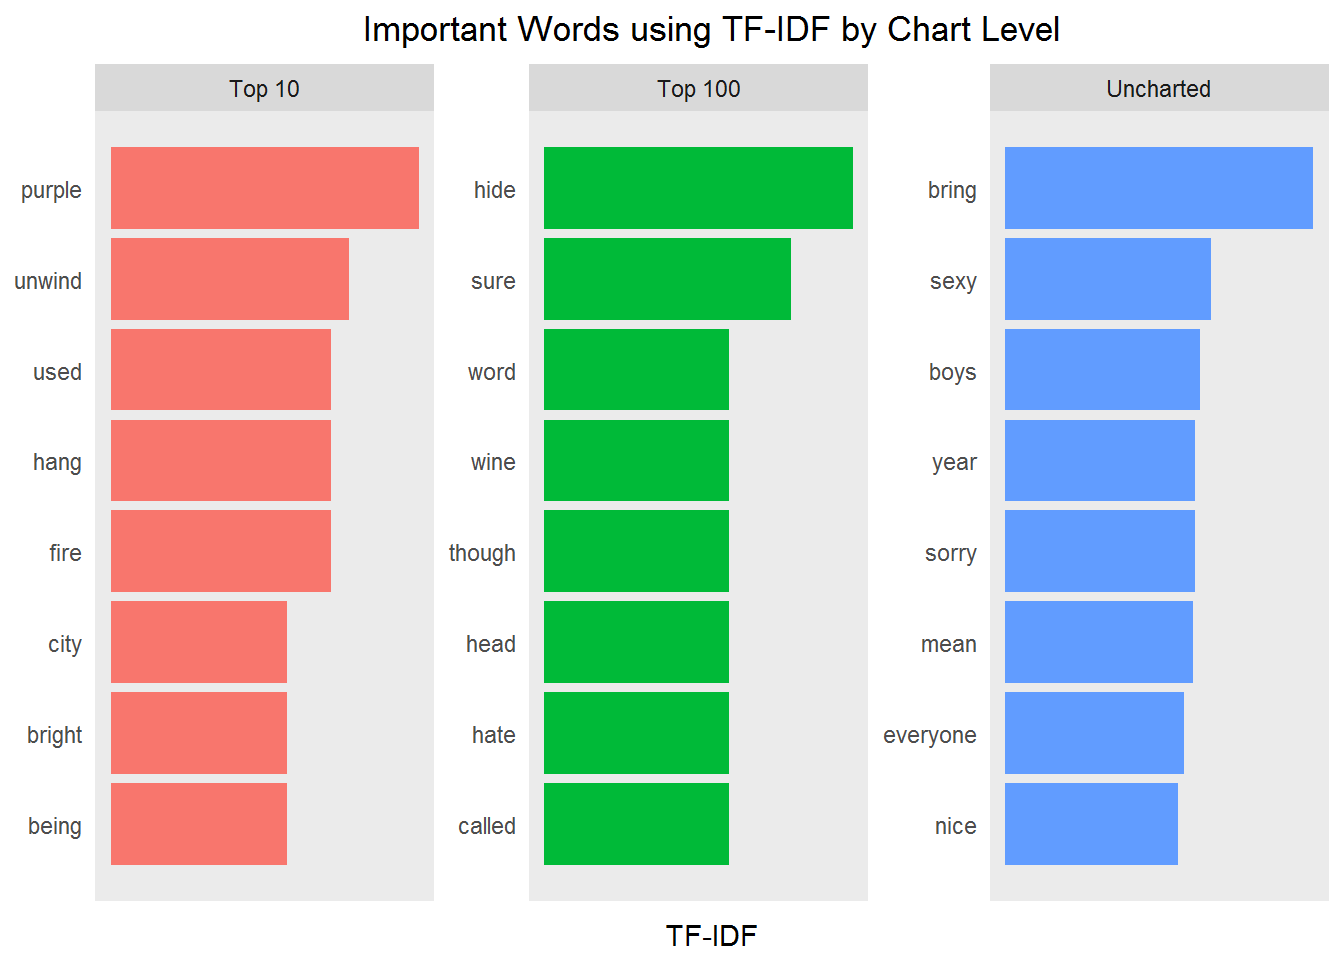
Wauw, met TF-IDF krijg je zeker een ander perspectief op mogelijk belangrijke woorden. De interpretatie blijft natuurlijk subjectief. Zie je patronen?
Bekijk vervolgens TF-IDF door de tijd:
tfidf_words_decade <- prince %>%
  unnest_tokens(word, lyrics) %>%
  distinct() %>%
  filter(!word %in% undesirable_words & decade != 'NA') %>%
  filter(nchar(word) > 3) %>%
  count(decade, word, sort = TRUE) %>%
  ungroup() %>%
  bind_tf_idf(word, decade, n) %>%
  arrange(desc(tf_idf))

top_tfidf_words_decade <- tfidf_words_decade %>%
  group_by(decade) %>%
  slice(seq_len(8)) %>%
  ungroup() %>%
  arrange(decade, tf_idf) %>%
  mutate(row = row_number())

top_tfidf_words_decade %>%
  ggplot(aes(x = row, tf_idf, fill = decade)) +
    geom_col(show.legend = NULL) +
    labs(x = NULL, y = "TF-IDF") +
    ggtitle("Belangrijke woorden met TF-IDF per decennium") +
    theme_lyrics() +
    facet_wrap(~decade,
               ncol = 3, nrow = 2,
               scales = "free") +
    scale_x_continuous(  # this handles replacement of row
      breaks = top_tfidf_words_decade$row, # notice need to reuse data frame
      labels = top_tfidf_words_decade$word) +
    coord_flip()
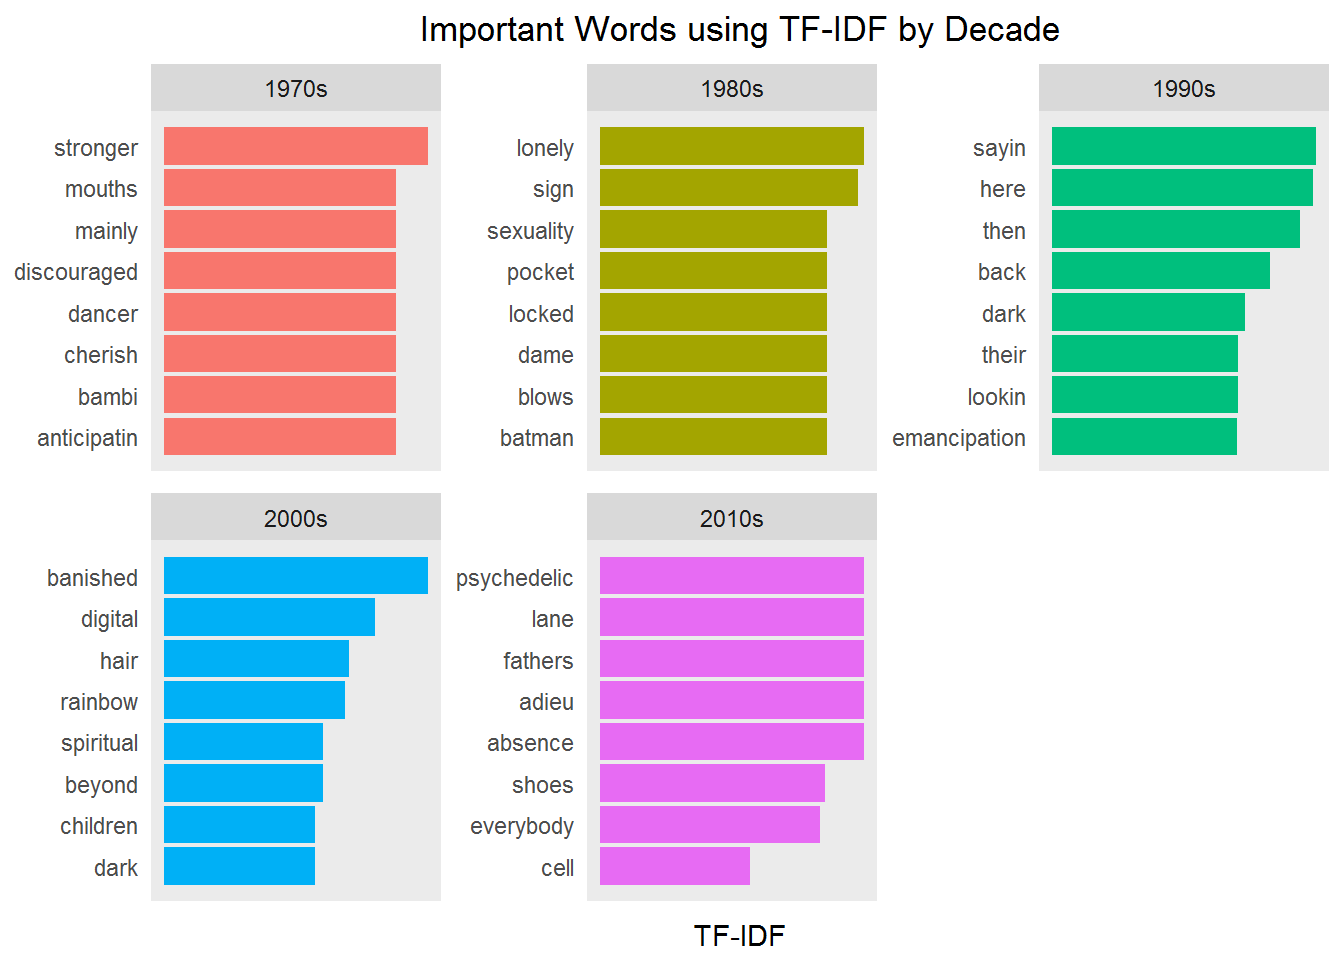
Je krijgt nu duidelijk een dieper niveau van inzicht. De tijdloze woorden zijn niet langer dominant. Begin je onderwerpen of thema’s te zien? Is dat echt mogelijk met slechts enkele woorden per groep? In de tweede tutorial (deel twee: sentimentanalyse en topic modeling met NLP) til je dit naar een hoger niveau.
Een snelle woordwolk met deze methode geeft een nieuw perspectief op belangrijke woorden in Prince’ songteksten en is net wat interessanter...
wc <- tfidf_words_decade %>%
  arrange(desc(tf_idf)) %>%
  select(word, tf_idf)

wordcloud2(wc[1:300, ],
           color = "random-dark",
           minRotation = -pi / 6,
           maxRotation = -pi / 3,
           minSize = .002,
           ellipticity = .3,
           rotateRatio = 1,
           size = .2,
           fontWeight = "bold",
           gridSize = 1.5 )
In deze casestudy heb je eerst een blik geworpen op de daadwerkelijke data, en alleen naar de basis gekeken. Na wat conditionering zoals opschonen en het verwijderen van niet-informatieve woorden, begon je met een verkennende analyse op nummerniveau.
Vervolgens dook je dieper de text mining in door songteksten te unnesten naar getokenizeerde woorden, zodat je naar lyrische complexiteit kon kijken. De resultaten leveren cruciale inzichten voor de volgende stappen van sentimentanalyse en topic modeling.
Tot slot heb je TF-IDF-analyse gebruikt om de informatiewaarde van een woord in een document te representeren met betrekking tot een uitkomst van interesse. Je zou kunnen denken dat dit een goede manier is om thema’s in muziek te identificeren, maar je hebt pas de helft van het verhaal. Deel twee behandelt een unsupervised leermethode genaamd Latent Dirichlet Allocation (LDA). Zoals in alle aspecten van data science zijn er veel methoden om inzicht te krijgen. En in delen twee en drie van deze casestudy behandel je meer van deze opties.
Hopelijk ben je net zo enthousiast als ik om deze reis voort te zetten van verkennende analyse naar sentimentanalyse, topic modeling en voorspellende inzichten.
Bedankt voor het lezen, en hopelijk zie ik je in de volgende tutorial!
Leer meer over R en machine learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

