

在线运行和编辑此教程中的代码
运行代码您是否想进一步学习如何用 dplyr 在 R 中整理与变换数据?欢迎查看我们的课程 使用 dplyr 进行 R 语言数据操作。
R 中的管道运算符:简介
要理解 R 中的管道运算符是什么、能做什么,就有必要放到更大的背景下,了解其历史。诸如“这个奇怪的符号组合从何而来、为什么会这样设计?”之类的问题,也许正萦绕在您心头。本节将为您解答这些以及更多问题。
考察历史可以从三个视角展开:数学视角、编程语言整体视角,以及 R 语言自身的视角。接下来我们将一一涉及!
R 中管道运算符的历史
数学渊源
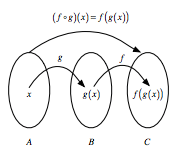
如果有两个函数,设 $f : B → C$ 和 $g : A → B$,您可以把一个函数的输出作为下一个函数的输入来“串联”。简言之,“串联”就是把中间结果传递给下一个函数,稍后您会看到更多示例。
例如,可写作 $f(g(x))$:其中 $g(x)$ 作为 $f()$ 的输入,而 $x$ 当然作为 $g()$ 的输入。
若要记号化表示,常用 $f ◦ g$,读作“f 接在 g 之后”。或者,您也可以用如下方式直观表示:
其他编程语言中的管道运算符
正如本节开头所述,这并非编程中的新事物:在 Shell 或终端中,您可以用管道字符 | 将一个命令的输出传递给下一个命令。类似地,F# 具有前向管道运算符,这一点稍后会显得尤为重要!最后,Haskell 也包含许多源自 Shell/终端的管道操作。
R 中的管道
了解了其他语言中的管道历史后,我们把目光转向 R。R 中该运算符的历史始于 2012 年 1 月 17 日,一位匿名用户在这篇 Stack Overflow 帖子中提问:
如何在 R 中实现 F# 的前向管道运算符?该运算符能轻松串联一系列计算。例如,当有一个输入数据并想依次调用函数
foo和bar时,可以写data |> foo |> bar?
答案来自麦克马斯特大学教授 Ben Bolker,他回复道:
我不确定在真实使用场景下表现如何,但下面这个(?)看起来能实现您想要的效果,至少针对单参数函数……
"%>%" <- function(x,f) do.call(f,list(x)) pi %>% sin [1] 1.224606e-16 pi %>% sin %>% cos [1] 1 cos(sin(pi)) [1] 1
大约九个月后,Hadley Wickham 在 GitHub 上启动了 dplyr 包。您或许认识 Hadley(现任 RStudio 首席科学家),他是许多流行R 包(包括这个包!)的作者,也是我们课程R 函数编写入门的讲师。
不过,直到 2013 年该包中才首次出现管道 %.%。正如 Adolfo Álvarez 在博文中提到的,相关函数被命名为 chain(),旨在简化将多个函数应用于单个R 数据框的记法。
%.% 管道并未存在太久。2013 年 12 月 29 日,Stefan Bache 提出了一个替代方案,其中包含了如今大家熟悉的运算符:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
Bache 继续打磨该管道操作,并在 2013 年底发布了 magrittr 包。与此同时,Hadley Wickham 继续推进 dplyr 的开发,并于 2014 年 4 月将 %.% 运算符替换为如今的 %>%。
同年稍后,Kun Ren 在 GitHub 上发布了 pipeR 包,引入了另一个不同的管道运算符 %>>%,以提升管道过程的灵活性。不过,可以说 %>% 现已在 R 语言中站稳脚跟,尤其随着 Tidyverse 的流行。
什么是 R 的管道运算符?
了解历史是一方面,但这并不能直接告诉您 F# 的前向管道运算符究竟是什么、在 R 中实际上做什么。
在 F# 中,前向管道运算符 |> 是链式方法调用的语法糖。更简单地说,它允许您把中间结果传递给下一个函数。
请记住,“串联”意味着您调用多个方法。随着每个方法返回一个对象,您实际上可以在一条语句中把这些调用串在一起,而无需用变量存储中间结果。
在 R 中,管道运算符如您所见是 %>%。如果您不熟悉 F#,可以把它类比为 ggplot2 语句中的 +。其功能与 F# 运算符非常相似:把前一条语句的输出作为下一条语句的输入。描述它时,您可以把它理解为一个“然后”。
例如,看看下面这段代码,并大声读出来:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
没错,上面的代码可以读作“取 Iris 数据,然后对数据进行子集筛选,然后进行聚合”。
这正是 Tidyverse 的强大之处之一。事实上,一系列标准化的处理步骤串联起来,就称为“管道(pipeline)”。为某种数据格式构建管道非常有用,因为您可以把该管道应用到具有相同格式的后续数据上,例如最终输出为 ggplot2 友好的格式。
为什么要使用 R 管道?
R 是一门函数式语言,这意味着您的代码里常常充满括号 ( 和 )。当代码变复杂时,您往往不得不进行多层嵌套,这会让 R 代码难以阅读和理解。这时,%>% 就能派上用场!
看看下面这个典型的嵌套代码示例:
# 初始化 `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)
# 计算 `x` 的对数,返回适当滞后并迭代的差分,
# 计算指数函数并对结果四舍五入
round(exp(diff(log(x))), 1)
- 3.3
- 1.8
- 1.6
- 0.5
- 0.3
- 0.1
- 48.8
- 1.1
借助 %<%,您可以将上述代码改写为:
# 导入 `magrittr`
library(magrittr)
# 对 `x` 执行与上面相同的计算
x %>% log() %>%
diff() %>%
exp() %>%
round(1)
这看起来难吗?别担心!稍后在本教程中您会学到更多如何这样编写。
注意,要使上述代码运行,您需要导入 magrittr 库。因为管道运算符正如上文所述属于 magrittr,并自 2014 年起也成为 dplyr 的一部分。如果忘记导入库,您会看到类似 Error in eval(expr, envir, enclos): could not find function "%>%" 的错误。
另外需要注意的是,在 log、diff 和 exp 后面并不强制要求加括号,但在 R 社区中,一些人会用它来增强代码可读性。
简而言之,使用 R 管道的四个理由:
- 您将按从左到右的顺序组织数据操作,而非从内到外;
- 避免嵌套函数调用;
- 尽量减少对局部变量与函数定义的需求;以及
- 便于在操作序列中的任意位置添加步骤。
这些理由摘自magrittr 文档。可见其背后的核心诉求是可读性与灵活性。
其他管道
尽管 %>% 是 magrittr 包的(主要)管道运算符,但该包中还有其他几个值得了解的运算符:
- 复合赋值运算符
%<>%;
# 初始化 `x`
x <- rnorm(100)
# 更新 `x` 的值并回写给 `x`
x %<>% abs %>% sort
- 分流(tee)运算符
%T>%;
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
注意,目前先知道上面的代码片段实际上是以下形式的简写即可:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
稍后您会看到更多相关内容!
- 展开(exposition)管道运算符
%$%。
data.frame(z = rnorm(100)) %$%
ts.plot(z)
当然,这三个运算符与主力的 %>% 运算符在工作方式上略有不同。您将在本教程后续部分看到它们的功能与用法。
注意,尽管最常见的是 magrittr 的管道,您在实践中也可能遇到其他管道!比如 wrapr 的点箭头管道 %.>% 或 to dot 管道 %>.%,以及“Bizarro 管道” ->.;。
如何在 R 中使用管道
现在您已了解 %>% 的起源、它是什么以及为什么要用它,接下来看看如何真正将其用于实战。您会发现它有不少用法!
基础管道用法
在深入更高级的用法前,先看看使用该运算符的最基础示例。实质上,初学时可遵循三条规则:
f(x)可改写为x %>% f
简而言之,对于只接收一个参数的函数 function(argument),可改写为 argument %>% function()。请看下面更实用的例子,理解两者如何等价:
# 计算 `x` 的对数
log(x)
# 计算 `x` 的对数
x %>% log()
f(x, y)可改写为x %>% f(y)
当然,许多函数并非只接收一个参数,而是多个。就像这里:函数接收 x 和 y 两个参数。类似第一个例子,您可按 argument1 %>% function(argument2) 的结构改写,其中 argument1 是 magrittr 占位符,argument2 是函数调用中的另一参数。
这些听起来仍较抽象。看看更实际的例子:
# 对 pi 四舍五入
round(pi, 6)
# 对 pi 四舍五入
pi %>% round(6)
x %>% f %>% g %>% h可改写为h(g(f(x)))
这看似复杂,但放到真实 R 示例就很直观:
# 导入 `babynames` 数据
library(babynames)
# 导入 `dplyr` 库
library(dplyr)
# 加载数据
data(babynames)
# 统计名为 "Taylor" 的新生男婴数量
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# 用 `%>%` 实现同样的操作
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
注意 改写嵌套代码时您是从内到外工作:先放入 babynames,然后用 %>% 先 filter() 数据,接着 select 出 n,最后 sum() 求和。
也请记住,在本教程开头我们已将一段嵌套代码改写为更易读的版本,即用 log()、diff()、exp() 和 round() 对 x 进行计算。
使用当前环境的函数
可惜的是,上述通用规则也有例外。下面看几个例子。
考虑使用 assign() 函数将值 10 赋给变量 x:
# 将 `10` 赋给 `x`
assign("x", 10)
# 将 `100` 赋给 `x`
"x" %>% assign(100)
# 返回 `x`
x
10
您会发现结合管道的第二次 assign() 调用并未如预期工作。x 的值没有更新。
为什么?
因为该函数把新值 100 赋给了 %>% 使用的一个临时环境。因此若要在管道中使用 assign(),您必须显式指定环境:
# 定义您的环境
env <- environment()
# 将环境传递给 `assign()`
"x" %>% assign(100, envir = env)
# 返回 `x`
x
100
惰性求值的函数
在 R 中,函数的参数只有在函数真的使用它们时才会被计算。这意味着在调用函数前不会预先计算任何参数,也意味着管道会依次计算函数的每个元素。
tryCatch() 是一个可能出问题的地方,它允许您捕获并处理错误,如下例所示:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
可见嵌套写法工作正常,而管道写法会报错。其他具有相同行为的 base R 函数还有 try()、suppressMessages() 和 suppressWarnings()。
参数占位符
在某些情况下,您可以把管道运算符用作参数占位符。请看以下示例:
f(x, y)可改写为y %>% f(x, .)
在有些情形下,您并不希望将值或 magrittr 占位符放在函数调用的第一个位置——此前的示例都是这样。再看这行代码:
pi %>% round(6)
若改写,上述代码会让 pi 成为 round() 的第一个参数。但如果您想替换第二个、第三个……参数,并让它成为函数调用的 magrittr 占位符呢?
看看这个例子,其中该值实际上位于函数调用的第三个位置:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x)可改写为x %>% f(y, z = .)
同样地,您也可能希望将函数调用中某个特定参数的值设置为 magrittr 占位符。考虑下面这行代码:
6 %>% round(pi, digits=.)
在属性中重复使用占位符
在右侧表达式中多次使用占位符是直观的。然而,当占位符仅出现在嵌套表达式中时,magrittr 仍会应用“第一个参数”规则,这是因为大多数情况下这样可产生更简洁的代码。
下面是处理嵌套函数调用中参数占位符时可以参考的一些“一般规则”:
f(x, y = nrow(x), z = ncol(x))可改写为x %>% f(y = nrow(.), z = ncol(.))
# 初始化矩阵 `ma`
ma <- matrix(1:12, 3, 4)
# 返回输入值中的最大值
max(ma, nrow(ma), ncol(ma))
# 返回输入值中的最大值
ma %>% max(nrow(ma), ncol(ma))
12
12
可以通过用花括号包裹右侧表达式来覆盖这种行为:
f(y = nrow(x), z = ncol(x))可改写为x %>% {f(y = nrow(.), z = ncol(.))}
# 只返回 `nrow(ma)` 与 `ncol(ma)` 中的最大值
ma %>% {max(nrow(ma), ncol(ma))}
4
最后再看一个例子,您也许会希望调整嵌套函数调用中占位符的行为:
# 需要改写的函数
paste(1:5, letters[1:5])
# 使用点占位符的嵌套调用
1:5 %>%
paste(., letters[.])
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
您会看到,如果占位符只在嵌套调用中使用,magrittr 仍会把占位符放到第一个参数位置!若要避免这种情况,可以使用花括号 { 与 }:
# 带点占位符与花括号的嵌套调用
1:5 %>% {
paste(letters[.])
}
# 改写上述调用
paste(letters[1:5])
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
构建一元函数
一元函数是只接收一个参数的函数。任何由一个点 . 开始、后接若干函数,并以 %>% 串联起来的管道,日后都可以作为函数应用到值上。请看下面这样的管道例子:
. %>% cos %>% sin
该管道会接收某个输入,然后对其先后应用 cos() 与 sin() 函数。
但还差一步!若要让该管道如上文所述那样工作,您需要先把它赋给一个变量,例如 f。之后即可复用它,对其他值执行管道中包含的操作。
# 一元函数
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))另请记住,若想提高可读性,您也可以在 cos() 与 sin() 后加括号。同样的例子加上括号即为:. %>% cos() %>% sin()。
您看,在 magrittr 中构建函数与在 base R 中构建函数非常相似!若不确定它们到底有多相似,请比较上面的代码与下一行代码;两者结果相同!
# 等价于
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))复合赋值管道操作
在某些情况下,您希望覆盖左侧的值,就像下面的例子。直觉上,您会使用赋值运算符 <-。
# 读取 Iris 数据
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# 为 Iris 数据添加列名
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# 计算 `iris$Sepal.Length` 的平方根并赋回变量
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
不过,还有一个复合赋值管道运算符,它允许您用更简洁的记法把管道的结果立即赋给左侧:
# 计算 `iris$Sepal.Length` 的平方根并赋回变量
iris$Sepal.Length %<>% sqrt
# 返回 `Sepal.Length`
iris$Sepal.Length
注意,复合赋值运算符 %<>% 必须是链中的第一个管道运算符才能生效。这与您刚读到的“它是更长重复写法的简写形式(使用常规 <- 赋值)”完全一致。
因此,该运算符会把管道的结果赋值,而不是返回它。
使用 tee 运算符的分流操作
tee 运算符的工作方式与 %>% 完全一致,但它返回的是左侧的值,而不是右侧操作可能产生的结果。
这意味着在包含“具有副作用”的函数(如使用 plot() 作图或输出到文件)时,tee 运算符很有用。
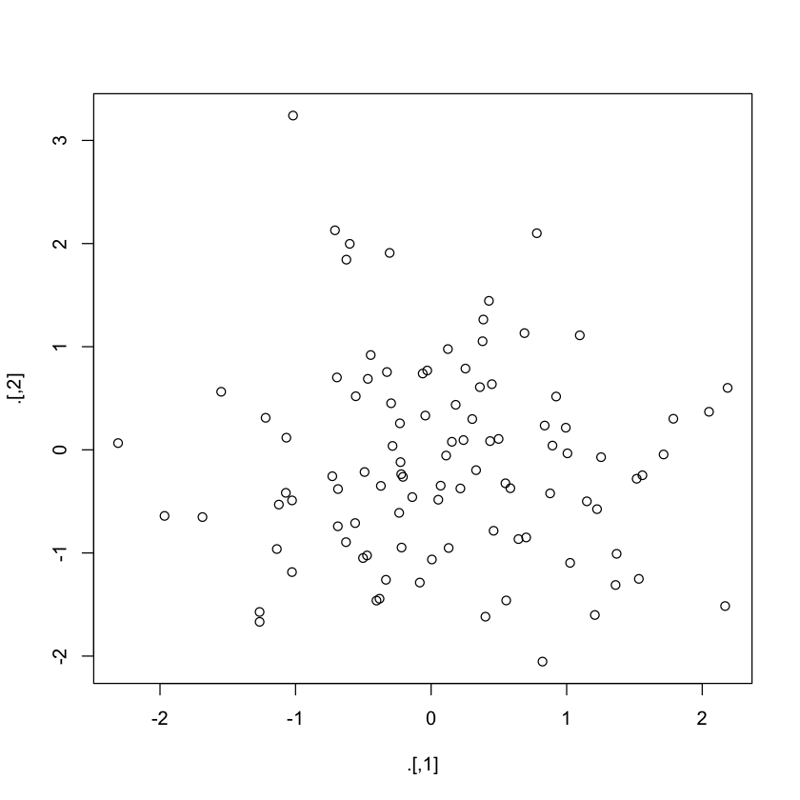
换言之,像 plot() 这样的函数通常不返回任何内容。这意味着例如在调用 plot() 之后,您的管道会终止。然而,在下面的示例中,tee 运算符 %T>% 允许您在使用 plot() 之后继续管道:
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
使用展开运算符暴露数据变量
在 R 中,您会发现许多函数都有 data 参数。例如 lm() 函数 或 with() 函数。当您的数据先被处理、再传入函数时,这些函数在管道中很有用。
对于没有 data 参数的函数,比如 cor(),如果能暴露数据中的变量同样很方便。这就是 %$% 运算符的用武之地。看如下示例:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
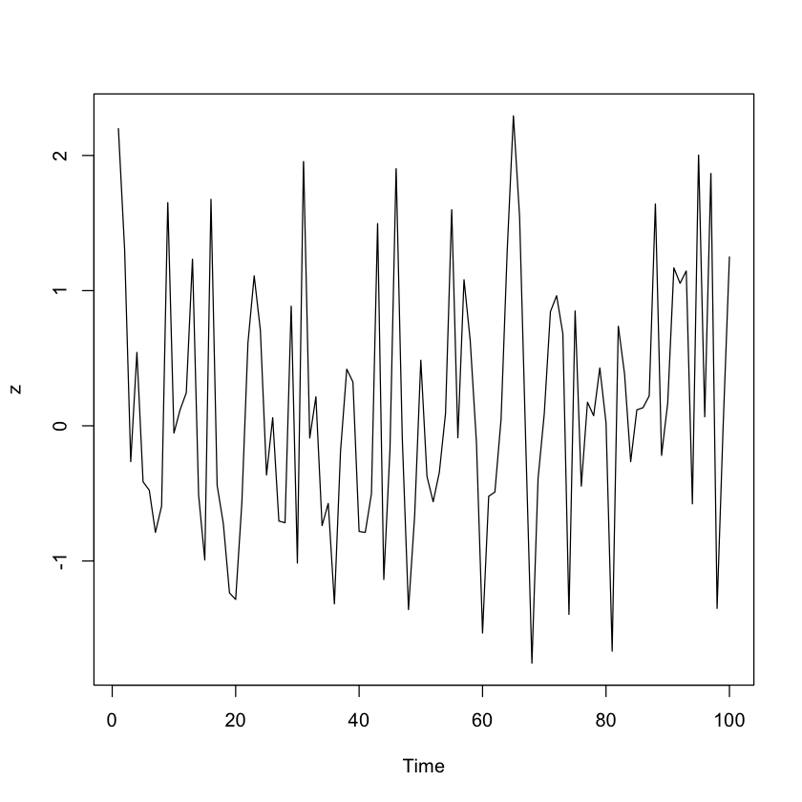
借助 %$%,您确保 Sepal.Length 与 Sepal.Width 可被 cor() 直接访问。同样地,您也看到 data.frame() 中的数据被传递给 ts.plot(),在同一图上绘制多条时间序列:
data.frame(z = rnorm(100)) %$%
ts.plot(z)
dplyr 与 magrittr
在本教程的介绍中,您已经了解到 dplyr 与 magrittr 的开发几乎同步,约在 2013–2014 年间。且如上所述,magrittr 也是 Tidyverse 的一部分。
本节将向您展示在 R 代码中结合这两个包会多么出彩。
对 dplyr 新手而言,需要知道这个包围绕五个动词构建,即 “select” “filter” “arrange” “mutate” 和 “summarize”。如果您做过数据科学项目的数据处理,会知道这些动词覆盖了大多数常见的数据操作任务。
下面是一段使用这些 dplyr 函数的传统代码:
library(hflights)
grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
arr = mean(ArrDelay, na.rm = TRUE),
dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)
final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
看到这个例子,您会立刻明白为什么 dplyr 与 magrittr 配合得如此出色:
hflights %>%
group_by(Year, Month, DayofMonth) %>%
select(Year:DayofMonth, ArrDelay, DepDelay) %>%
summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
filter(arr > 30 | dep > 30)
两段代码都不算短,但若要顺着操作过程一步步跟进,第二段更为清晰。第一段中创建了多个中间变量,可能会打断代码的“流动性”。使用 %>%,您可以更清楚地总览对数据执行的各项操作!
简而言之,dplyr 与 magrittr 是您在 R 中操纵数据的梦幻组合!
RStudio 中的管道快捷键
在 R 代码里不断加入管道可能会让人吃力!为此,Win-Vector, LLC 的联合创始人兼首席顾问、DataCamp 讲师 John Mount 发布了一个包含 RStudio 插件(add-ins)的包,帮助您为管道创建键盘快捷键。Addin 本质上是带有一些特殊注册元数据的 R 函数。一个简单的 addin 可以是插入常用文本片段的函数,也可以非常复杂!
借助这些 addin,您可以在 RStudio IDE 中交互式地执行 R 函数,既可使用快捷键,也可通过 Addins 菜单。
注意,该包实际上是对 RStudio 原始 add-in 包的一个 fork。需要留意的是,Addins 的支持仅在 RStudio 的最新版本中提供!想了解更多,请查阅关于 RStudio addins 的文章。
您可以从 GitHub 下载这些 add-ins 与快捷键。
何时不该在 R 中使用管道运算符
上文已看到,在使用 R 编程时,管道的确值得一用。尤其在若干场景中,它们非常有用!不过,Hadley Wickham 在 《R for Data Science》中也概括了几类应尽量避免使用的情况:
- 您的管道长度超过(比如)十步。
在这种情况下,建议创建有意义名称的中间对象。这不仅能让您更容易调试代码,也能让您与他人更好地理解代码。
- 存在多个输入或输出。
如果您不是在变换一个主对象,而是需要将两个或多个对象组合在一起,最好不要使用管道。
- 您开始考虑一个具有复杂依赖结构的有向图。
管道从根本上是线性的,用它来表达复杂关系只会导致又长又难读的代码。
- 您在做内部包开发。
在内部包开发中使用管道是不推荐的,因为这会增加调试难度!
如需更多思考,请查看这条 Stack Overflow 讨论。其中还提到了循环、包依赖、参数顺序与可读性等情形。
简而言之,可以这样概括:牢记让这一构造出色的两点——可读性与灵活性。一旦这两大优势之一被削弱,您就应考虑采用管道之外的替代方案。
R 中的管道替代方案
读到这里,您或许也对 R 语言中可用的一些替代方案感兴趣。本文中提到的解决思路包括:
- 使用有意义名称的中间变量;
与其将所有操作串成一条链并输出单个结果,不如拆分链条,并把中间结果分别保存到变量。注意变量命名:目标始终是让代码尽可能易懂!
- 将代码嵌套,按从内到外的顺序阅读;
有人对管道的一个可能反对意见是:它与 base R 的“阅读流”相悖。那么就继续使用嵌套代码吧!但如果您既不喜欢管道,又觉得嵌套也容易混乱?可以用缩进来强调层级结构。
结语
在本教程中,您已经覆盖了大量关于 R 管道的内容:了解了 %>% 的来历、它究竟是什么、为什么要用、以及如何使用。您也看到 dplyr 与 magrittr 的绝佳配合,以及更多其他运算符。最后,还了解了在 R 编程时不宜使用管道的若干情形,以及在这些情况下可以采用的替代方案。
如果您有兴趣进一步学习 Tidyverse,欢迎考虑 DataCamp 的课程 Tidyverse 入门。
R 管道常见问答
什么是 R 管道?它如何工作?
R 管道是一种将多个操作以简洁而富有表现力的方式串联起来的方法。管道由 %>% 运算符表示,它会把左侧表达式的输出作为右侧函数的第一个参数传入。使用管道可以将一连串分析步骤连贯地链接起来。
%>% 和 %<>% 有何区别?
%>% 运算符会将左侧表达式的输出作为右侧函数的第一个参数传入。%<>% 运算符也会这样做,但它还会就地更新管道左侧对象的值。
为什么要使用 R 管道?
R 管道能以更简洁、直观的方式编写代码,使其更易读、易理解。它还允许您以类似自然语言叙述的方式将操作串联起来,让代码更符合直觉,也更便于他人理解。
R 管道有哪些缺点?
一个潜在缺点是:管道可能对某些 R 用户来说不够熟悉,因此需要一些额外的学习与练习才能熟练使用。
当您使用
dplyr、magrittr等包时,或许已经见过或用过管道运算符。但您知道管道以及知名的%>%运算符从何而来、究竟是什么、以及应如何、何时、为何使用吗?您又能否提出一些替代方案?本教程将为您介绍 R 中的管道,并涵盖以下主题: