主动学习是那类经常被提及、却总没腾出时间深入理解的话题。本文将解释主动学习的动机、优势,以及它在当代机器学习研究中的定位。
能够正确运用主动学习,将为您在标注数据稀缺时提供一件非常强大的工具。可以把主动学习看作一种“设计方法论”,类似迁移学习,同样能在标注数据较少的情况下发挥作用。
在下一篇文章中,您将进一步了解如何将主动学习与迁移学习结合使用,以最优方式利用已有(和新增)数据。
动机
与其先给出主动学习的形式化定义,不如先看一个简单示例,帮助您理解主动学习为何有效。
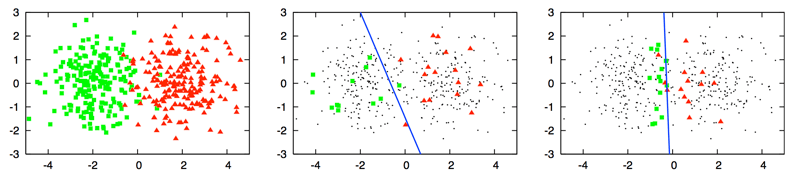
观察上面最左侧的图(取自这篇综述),有两类簇:绿色和红色。细心的读者会知道,这是一个分类任务,目标是创建一条“决策边界”(此处是一条直线)来分隔红色与绿色的形状。然而,假设您并不知道这些数据点的标签(红或绿),而给每个点找出标签的代价非常高。因此,您希望抽样少量点获取其标签,并将这些已标注的数据点用作分类器的训练数据。
在中间的图中,使用逻辑回归分类。首先随机抽样一小部分点并进行标注。但是,由逻辑回归得到的决策边界(蓝线)并不理想。它明显偏离红色数据点,侵入绿色区域。这意味着会有许多绿色数据点被误判为红色。这种偏移源于用于标注的数据点选择不佳。在最右侧的图中,仍然使用逻辑回归,但这次通过主动学习的查询方法选择了一小部分点。新的决策边界显著更好,更好地分开了两种颜色。这一改进来自更优的数据点选择,使分类器能够学习到更合理的决策边界。
主动学习的查询方法如何挑选到这些高质量的数据点,是主动学习的主要研究方向之一。稍后您将看到一些最常用的数据点查询方法。
主动学习:定义与概念
主动学习的核心假设是:如果学习算法可以自行选择用于学习的数据,那么在训练数据显著减少的情况下,它仍能比传统方法表现更好。
那么所谓的传统方法是什么?
传统任务通常是从底层分布中随机采集大量数据,并用这份大数据集来训练一个模型以进行某种预测。我们称这种典型方法为被动学习。
被动学习中最耗时的任务之一是收集有标注的数据。在许多场景中,存在各种限制因素,阻碍获取大规模标注数据。
以胰腺癌研究为例。您可能希望预测某位患者是否会患胰腺癌,但您可能只能为少数患者安排进一步检查以收集特征等信息。在这种情况下,与其随机挑选患者,不如基于某些标准进行选择。一个示例标准可能是“患者饮酒且年龄超过40岁”。该标准不必一成不变,可以根据先前患者的结果而调整。比如,如果您发现模型对50岁以上人群预测较好,但对40-50岁群体预测困难,那么这可能就成为您的新选择标准。
基于迄今收集的数据来选择这些患者(更一般地说是样本)的过程称为主动学习。
情景
在主动学习中,学习器通常有三种情景或设置来查询样本的标签。文献中主要考虑的三种情景是:
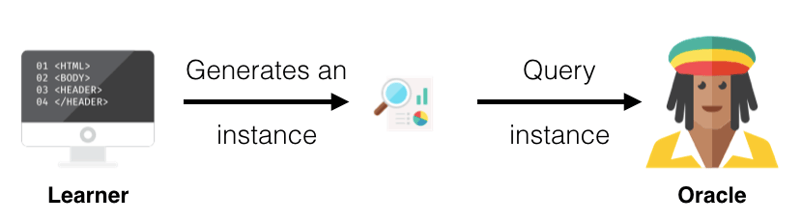
- 成员查询合成(Membership Query Synthesis):这是个很大的术语,意思很简单:学习器自行生成/构造一个样本(来自某个底层的自然分布)。例如,如果数据是数字图片,学习器会创建一张与某个数字相似的图像(可能被旋转或缺失一部分笔画),然后将该生成图像交给“预言机”进行标注。
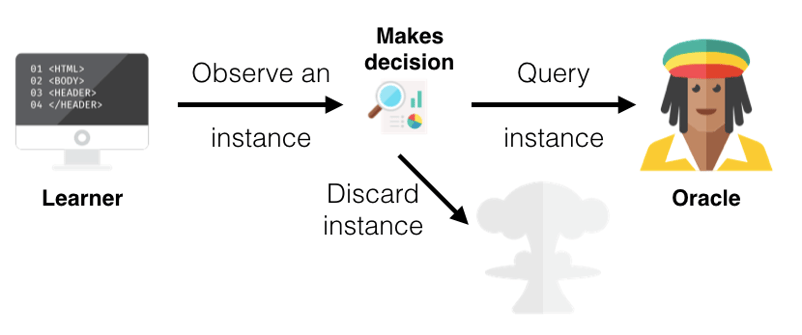
- 基于流的选择性采样(Stream-Based Selective Sampling):在该设置中,您假设获取一个未标注样本是免费的。基于此假设,您一次选取一个未标注样本,让学习器决定是否查询其标签,或者根据其信息量将其丢弃。用于判定样本信息量的,是一种查询策略(见下一节)。延续上面的例子,您从未标注图片集中选取一张,判断是否需要标注或丢弃,然后对下一张图片重复此过程。
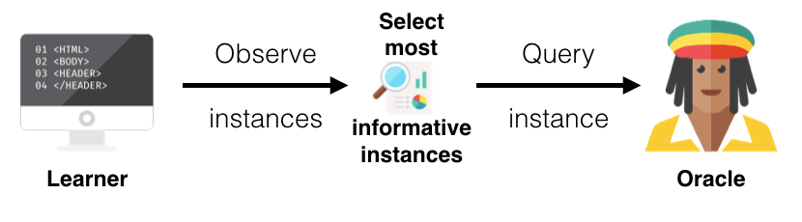
- 基于池的采样(Pool-Based sampling):该设置同样假设存在一个大型未标注数据池,类似基于流的选择性采样。然后根据某种信息量度量从池中抽取样本。该度量会应用于池中的所有样本(或若池很大则应用于其子集),再选择信息量最高的样本。这是主动学习社区中最常见的情景。延续前两个情景的例子,所有未标注的数字图像会被排序,然后选出最佳(信息量最高)的样本并请求其标签。
查询策略
主动学习者与被动学习者的核心差别在于:前者能够基于以往的查询及其返回的标签结果来决定后续要查询的样本。正如前文所述,所有主动学习情景都需要对未标注样本进行某种信息量度量。本节我将解释三种在“基于不确定性的采样”这一常见主题下的流行查询方法,它们都会用到概率(关于更多查询策略及主动学习的深入信息,推荐阅读这篇综述论文)。
我将用下表来说明这些查询策略。表中给出两个数据点(样本)及其在每个标签下的概率。样本 d1 属于 A、B、C 标签的概率分别为 0.9、0.09 和 0.01;而 d2 分别为 0.2、0.5 和 0.3。
| Instances | Label A | Label B | Label C |
|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
-
最小置信度(LC):该策略选择学习器对其最可能标签置信度最低的样本。观察表格,学习器对 d1 的标签很有把握,因为它认为标注为 A 的概率为 0.9;但对 d2 则没那么确定,概率更分散,且认为标注为 B 的概率仅为 0.5。因此,使用最小置信度策略时,学习器会选择 d2 来查询其真实标签。
-
间隔采样(Margin Sampling):LC 策略的不足在于只考虑最可能的标签,忽略了其他标签的概率。间隔采样通过选择“第一、第二可能标签之间差值最小”的样本来克服这一劣势。对 d1 而言,前两大概率之差为 0.81(0.9 - 0.09);对 d2 则为 0.2(0.5 - 0.3)。因此,学习器仍会选择 d2。
-
熵采样(Entropy Sampling):为利用所有可能标签的概率,可以使用一种常见度量——熵。对每个样本计算熵值,并查询熵值最大的样本。在我们的例子中,d1 的值为 0.155,而 d2 的值为 0.447,因此学习器再次选择 d2。
整合所有步骤
到目前为止,您已了解构成主动学习的不同组件。也许把所有步骤串起来仍有些混乱或困难,本节将通过一个完整但非常简单的示例带您走一遍流程。
步骤 0:收集数据
这一步看似简单,但务必要确保您收集的数据集能够代表数据的真实分布。换言之,尽量避免严重偏斜的数据。在现实中,由于法律、时间或可获得性等限制,不可能获得完全具有代表性的样本。
在本示例中,您将有以下 5 个数据点。特征 A 和特征 B 表示数据点可能具有的某些特征。需要注意的是,我们收集到的数据是未标注的。
| Instances | Feature A | Feature B |
|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
步骤 1:划分种子集与未标注数据集
接下来,需要把数据划分成一小部分将被标注的数据集,以及一大部分未标注数据集。在主动学习术语中,这个小型的已标注数据集称为种子集(seed)。未标注数据中用于种子集的数量或比例并无固定标准。将用于种子集的数据单独放好后,您应对其进行标注。
注意,在多数文献中,研究者并不会请预言机或专家来标注这些样本。通常做法是获取一个完全标注好的数据集,抽取少量作为种子集(因为标签已知),其余部分则当作未标注数据。当学习器选择某个样本去查询orcale时,他们只是直接查阅该样本的既有标签。
继续示例,您选择 d1 和 d3 作为种子集。本例的可能标签是“Y”和“N”。
种子/已标注数据集
| Instances | Feature A | Feature B | Label |
|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
未标注数据集
| Instances | Feature A | Feature B |
|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
步骤 2:训练模型
完成数据划分后,像常规机器学习项目一样,使用种子集来训练学习器(采用交叉验证等)。此外,所用学习器的类型取决于您对领域的了解;通常会选择能为某个样本是否属于某标签给出概率性响应的学习器,因为后续查询策略要用到这些概率。
在本示例中,您可以使用任意分类器,并在两个已标注样本上进行训练。
步骤 3:选择未标注样本
训练好学习器后,您就可以选择一个或多个样本进行查询。您需要确定要采用的情景类型(即成员查询合成、基于流的选择性采样或基于池的采样)以及查询策略。
您将使用基于池的采样,批量大小为 2。这意味着在每次迭代中,您从未标注数据集中选择两个样本,然后将它们加入已标注数据集。您使用最小置信度来选择样本。学习器选择了 d2 和 d4,其查询得到的标签分别为“Y”和“N”。
已标注数据集
| Instances | Feature A | Feature B | Label |
|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
未标注数据集
| Instances | Feature A | Feature B |
|---|
| d5 | 5 | 5 |
步骤 4:停止准则
现在,您可以在达到某个停止准则前,不断重复步骤 2 和 3。也就是说,在得到新的已标注数据集后,重新训练学习器,然后选择更多未标注数据进行查询。停止准则可以是已查询样本的数量、步骤 2 和 3 的迭代轮数,或当性能提升未显著超过某个阈值时停止。
在本示例中,您在一轮迭代后停止,至此主动学习算法结束。您还可以准备一个单独的测试数据集,对学习器进行评估并记录其性能。这样,您就能看到随着加入标注数据,测试集性能如何提升或停滞。
主动学习的应用与前沿研究
主动学习最热门的领域之一是自然语言处理(NLP)。这主要因为许多 NLP 应用(如词性标注、命名实体识别)需要大量标注数据,而标注这些数据的成本非常高。
事实上,NLP 领域中可自由获取且为这些应用完全标注的数据集屈指可数。因此,使用主动学习可以显著减少所需的标注数据规模以及准确标注所需的专家投入。同样的思路也可应用于许多语音识别任务,甚至诸如信息检索等任务。
主动学习仍在被大量研究。许多研究开始将不同的深度学习算法(如 CNN 和 LSTM)用作学习器,并探索在主动学习框架下提升其效率(Kronrod and Anandkumar, 2017;Sener and Savarese, 2017)。也有研究将生成对抗网络(GAN)引入主动学习框架(Zhu and Bento, 2017)。随着深度强化学习的兴起,研究者尝试将主动学习重新表述为一个强化学习问题(Fang 等, 2017)。此外,还有论文尝试在元学习设置下学习主动学习策略(Fang 等, 2017)。


主动学习是那类经常被提及、却总没腾出时间深入理解的话题。本文将解释主动学习的动机、优势,以及它在当代机器学习研究中的定位。
能够正确运用主动学习,将为您在标注数据稀缺时提供一件非常强大的工具。可以把主动学习看作一种“设计方法论”,类似迁移学习,同样能在标注数据较少的情况下发挥作用。
在下一篇文章中,您将进一步了解如何将主动学习与迁移学习结合使用,以最优方式利用已有(和新增)数据。
动机
与其先给出主动学习的形式化定义,不如先看一个简单示例,帮助您理解主动学习为何有效。
观察上面最左侧的图(取自这篇综述),有两类簇:绿色和红色。细心的读者会知道,这是一个分类任务,目标是创建一条“决策边界”(此处是一条直线)来分隔红色与绿色的形状。然而,假设您并不知道这些数据点的标签(红或绿),而给每个点找出标签的代价非常高。因此,您希望抽样少量点获取其标签,并将这些已标注的数据点用作分类器的训练数据。
在中间的图中,使用逻辑回归分类。首先随机抽样一小部分点并进行标注。但是,由逻辑回归得到的决策边界(蓝线)并不理想。它明显偏离红色数据点,侵入绿色区域。这意味着会有许多绿色数据点被误判为红色。这种偏移源于用于标注的数据点选择不佳。在最右侧的图中,仍然使用逻辑回归,但这次通过主动学习的查询方法选择了一小部分点。新的决策边界显著更好,更好地分开了两种颜色。这一改进来自更优的数据点选择,使分类器能够学习到更合理的决策边界。
主动学习的查询方法如何挑选到这些高质量的数据点,是主动学习的主要研究方向之一。稍后您将看到一些最常用的数据点查询方法。
主动学习:定义与概念
主动学习的核心假设是:如果学习算法可以自行选择用于学习的数据,那么在训练数据显著减少的情况下,它仍能比传统方法表现更好。
那么所谓的传统方法是什么?
传统任务通常是从底层分布中随机采集大量数据,并用这份大数据集来训练一个模型以进行某种预测。我们称这种典型方法为被动学习。
被动学习中最耗时的任务之一是收集有标注的数据。在许多场景中,存在各种限制因素,阻碍获取大规模标注数据。
以胰腺癌研究为例。您可能希望预测某位患者是否会患胰腺癌,但您可能只能为少数患者安排进一步检查以收集特征等信息。在这种情况下,与其随机挑选患者,不如基于某些标准进行选择。一个示例标准可能是“患者饮酒且年龄超过40岁”。该标准不必一成不变,可以根据先前患者的结果而调整。比如,如果您发现模型对50岁以上人群预测较好,但对40-50岁群体预测困难,那么这可能就成为您的新选择标准。
基于迄今收集的数据来选择这些患者(更一般地说是样本)的过程称为主动学习。
情景
在主动学习中,学习器通常有三种情景或设置来查询样本的标签。文献中主要考虑的三种情景是:
查询策略
主动学习者与被动学习者的核心差别在于:前者能够基于以往的查询及其返回的标签结果来决定后续要查询的样本。正如前文所述,所有主动学习情景都需要对未标注样本进行某种信息量度量。本节我将解释三种在“基于不确定性的采样”这一常见主题下的流行查询方法,它们都会用到概率(关于更多查询策略及主动学习的深入信息,推荐阅读这篇综述论文)。
我将用下表来说明这些查询策略。表中给出两个数据点(样本)及其在每个标签下的概率。样本 d1 属于 A、B、C 标签的概率分别为 0.9、0.09 和 0.01;而 d2 分别为 0.2、0.5 和 0.3。
最小置信度(LC):该策略选择学习器对其最可能标签置信度最低的样本。观察表格,学习器对 d1 的标签很有把握,因为它认为标注为 A 的概率为 0.9;但对 d2 则没那么确定,概率更分散,且认为标注为 B 的概率仅为 0.5。因此,使用最小置信度策略时,学习器会选择 d2 来查询其真实标签。
间隔采样(Margin Sampling):LC 策略的不足在于只考虑最可能的标签,忽略了其他标签的概率。间隔采样通过选择“第一、第二可能标签之间差值最小”的样本来克服这一劣势。对 d1 而言,前两大概率之差为 0.81(0.9 - 0.09);对 d2 则为 0.2(0.5 - 0.3)。因此,学习器仍会选择 d2。
熵采样(Entropy Sampling):为利用所有可能标签的概率,可以使用一种常见度量——熵。对每个样本计算熵值,并查询熵值最大的样本。在我们的例子中,d1 的值为 0.155,而 d2 的值为 0.447,因此学习器再次选择 d2。
整合所有步骤
到目前为止,您已了解构成主动学习的不同组件。也许把所有步骤串起来仍有些混乱或困难,本节将通过一个完整但非常简单的示例带您走一遍流程。
步骤 0:收集数据
这一步看似简单,但务必要确保您收集的数据集能够代表数据的真实分布。换言之,尽量避免严重偏斜的数据。在现实中,由于法律、时间或可获得性等限制,不可能获得完全具有代表性的样本。
在本示例中,您将有以下 5 个数据点。特征 A 和特征 B 表示数据点可能具有的某些特征。需要注意的是,我们收集到的数据是未标注的。
步骤 1:划分种子集与未标注数据集
接下来,需要把数据划分成一小部分将被标注的数据集,以及一大部分未标注数据集。在主动学习术语中,这个小型的已标注数据集称为种子集(seed)。未标注数据中用于种子集的数量或比例并无固定标准。将用于种子集的数据单独放好后,您应对其进行标注。
注意,在多数文献中,研究者并不会请预言机或专家来标注这些样本。通常做法是获取一个完全标注好的数据集,抽取少量作为种子集(因为标签已知),其余部分则当作未标注数据。当学习器选择某个样本去查询
orcale时,他们只是直接查阅该样本的既有标签。继续示例,您选择 d1 和 d3 作为种子集。本例的可能标签是“Y”和“N”。
种子/已标注数据集
未标注数据集
步骤 2:训练模型
完成数据划分后,像常规机器学习项目一样,使用种子集来训练学习器(采用交叉验证等)。此外,所用学习器的类型取决于您对领域的了解;通常会选择能为某个样本是否属于某标签给出概率性响应的学习器,因为后续查询策略要用到这些概率。
在本示例中,您可以使用任意分类器,并在两个已标注样本上进行训练。
步骤 3:选择未标注样本
训练好学习器后,您就可以选择一个或多个样本进行查询。您需要确定要采用的情景类型(即成员查询合成、基于流的选择性采样或基于池的采样)以及查询策略。
您将使用基于池的采样,批量大小为 2。这意味着在每次迭代中,您从未标注数据集中选择两个样本,然后将它们加入已标注数据集。您使用最小置信度来选择样本。学习器选择了 d2 和 d4,其查询得到的标签分别为“Y”和“N”。
已标注数据集
未标注数据集
步骤 4:停止准则
现在,您可以在达到某个停止准则前,不断重复步骤 2 和 3。也就是说,在得到新的已标注数据集后,重新训练学习器,然后选择更多未标注数据进行查询。停止准则可以是已查询样本的数量、步骤 2 和 3 的迭代轮数,或当性能提升未显著超过某个阈值时停止。
在本示例中,您在一轮迭代后停止,至此主动学习算法结束。您还可以准备一个单独的测试数据集,对学习器进行评估并记录其性能。这样,您就能看到随着加入标注数据,测试集性能如何提升或停滞。
主动学习的应用与前沿研究
主动学习最热门的领域之一是自然语言处理(NLP)。这主要因为许多 NLP 应用(如词性标注、命名实体识别)需要大量标注数据,而标注这些数据的成本非常高。
事实上,NLP 领域中可自由获取且为这些应用完全标注的数据集屈指可数。因此,使用主动学习可以显著减少所需的标注数据规模以及准确标注所需的专家投入。同样的思路也可应用于许多语音识别任务,甚至诸如信息检索等任务。
主动学习仍在被大量研究。许多研究开始将不同的深度学习算法(如 CNN 和 LSTM)用作学习器,并探索在主动学习框架下提升其效率(Kronrod and Anandkumar, 2017;Sener and Savarese, 2017)。也有研究将生成对抗网络(GAN)引入主动学习框架(Zhu and Bento, 2017)。随着深度强化学习的兴起,研究者尝试将主动学习重新表述为一个强化学习问题(Fang 等, 2017)。此外,还有论文尝试在元学习设置下学习主动学习策略(Fang 等, 2017)。