
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Active learning is zo'n onderwerp waar je wel eens over hoort, maar waar je nooit echt de tijd voor neemt om het goed te begrijpen. In deze blogpost leggen we de gedachte achter active learning uit, de voordelen ervan en hoe het past in hedendaags onderzoek naar machine learning.
Active learning op de juiste manier inzetten geeft je een krachtig hulpmiddel wanneer er een tekort is aan gelabelde data. Je kunt active learning zien als een soort 'ontwerpstrategie', vergelijkbaar met transfer learning, die je ook kunt gebruiken om kleine hoeveelheden gelabelde data beter te benutten.
In een volgende post leer je hoe je active learning samen met transfer learning kunt gebruiken om bestaande (en nieuwe) data optimaal te benutten.
In plaats van eerst een formele definitie van active learning te geven, beginnen we beter met een eenvoudig voorbeeld om duidelijk te maken waarom active learning werkt.
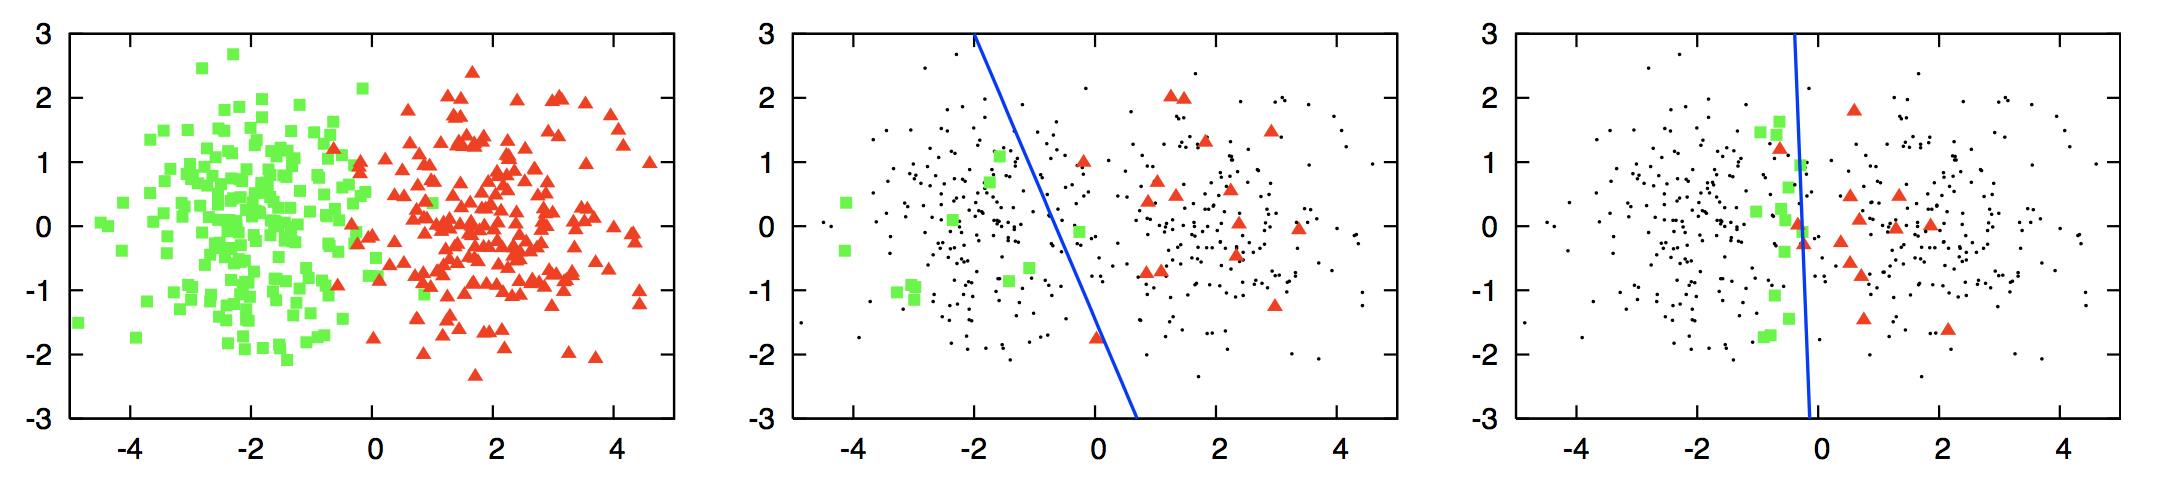
Kijkend naar het meest linkse plaatje hierboven (afkomstig uit deze survey), zie je twee clusters: groen en rood. Oplettende lezers herkennen dit als een classificatietaak: je wilt een 'beslisgrens' maken (hier gewoon een lijn) die de groene en rode vormen scheidt. Stel echter dat je de labels (rood of groen) van de datapunten niet kent, en dat het achterhalen van elk label erg duur is. Daarom wil je een kleine subset punten bemonsteren, de labels daarvan bepalen en deze gelabelde punten gebruiken als trainingsdata voor een classifier.
In het middelste plaatje wordt logistische regressie gebruikt om de vormen te classificeren door eerst willekeurig een kleine subset punten te selecteren en te labelen. Je ziet echter dat de beslisgrens (de blauwe lijn) suboptimaal is. De lijn is duidelijk weggedrukt van de rode punten en trekt het groene gebied in. Daardoor zullen veel groene punten onterecht als rood gelabeld worden. Deze vertekening komt door een slechte selectie van punten om te labelen. In het meest rechtse plaatje is opnieuw logistische regressie gebruikt, maar nu is de kleine subset punten gekozen met een active-learning-querymethode. Deze nieuwe beslisgrens is aanzienlijk beter omdat hij de twee kleuren beter scheidt. Deze verbetering komt door het selecteren van betere datapunten, waardoor de classifier een veel betere beslisgrens kon leren.
Hoe de active-learning-querymethode zulke goede punten weet te kiezen, is een van de belangrijkste onderzoeksthema's binnen active learning. Later zie je enkele van de populairste methoden om datapunten te bevragen.
De hoofdhypothese in active learning is dat een leeralgoritme beter kan presteren met beduidend minder trainingsdata als het zelf mag kiezen van welke data het wil leren, vergeleken met traditionele methoden.
Maar wat zijn die traditionele methoden precies?
Dat zijn taken waarbij je veel data verzamelt die willekeurig uit de onderliggende verdeling is getrokken, en dat grote dataset gebruikt om een model te trainen dat voorspellingen kan doen. We noemen deze typische aanpak passive learning.
Een van de tijdrovende taken bij passive learning is het verzamelen van gelabelde data. In veel situaties zijn er beperkende factoren die het lastig maken om grote hoeveelheden gelabelde data te verzamelen.
Neem het voorbeeld van onderzoek naar alvleesklierkanker. Je wilt misschien voorspellen of een patiënt alvleesklierkanker krijgt, maar je kunt slechts een klein aantal patiënten nader onderzoeken om features te verzamelen, enzovoort. In dat geval kun je, in plaats van willekeurig te selecteren, patiënten kiezen op basis van bepaalde criteria. Een voorbeeldcriterium kan zijn: de patiënt drinkt alcohol en is ouder dan 40 jaar. Dit criterium hoeft niet statisch te zijn, maar kan veranderen op basis van resultaten van eerdere patiënten. Als je bijvoorbeeld merkt dat je model goed voorspelt voor mensen boven de 50, maar moeite heeft met accurate voorspellingen voor 40-50 jaar, dan kan dat je nieuwe criterium worden.
Het proces van het selecteren van deze patiënten (of algemener: instanties) op basis van de data die we tot nu toe hebben verzameld, heet active learning.
In active learning zijn er doorgaans drie scenario's of settings waarin de learner de labels van instanties opvraagt. De drie belangrijkste scenario's die in de literatuur worden besproken, zijn:
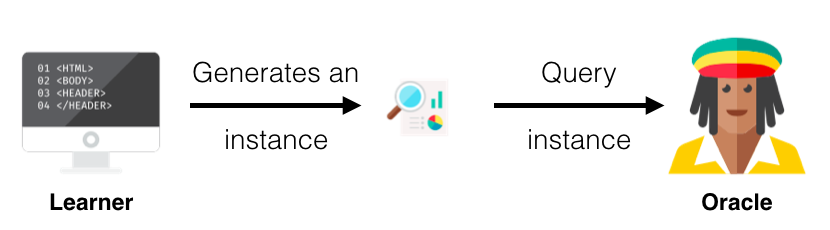
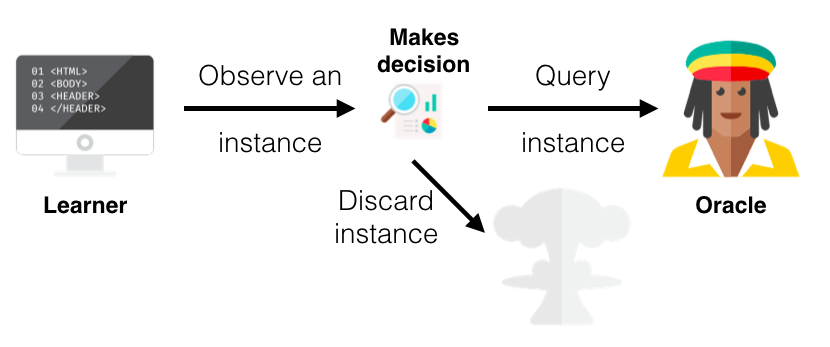
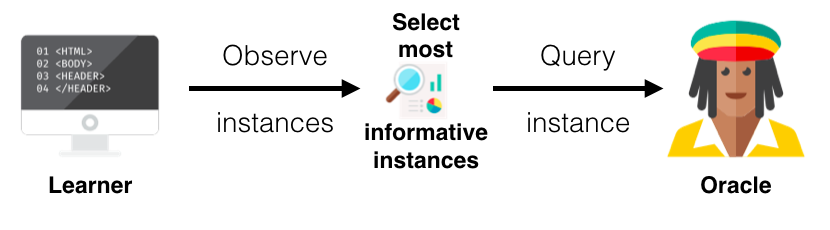
Het belangrijkste verschil tussen een active en een passive learner is het vermogen om instanties te bevragen op basis van eerdere queries en de daarop ontvangen responses (labels). Zoals je eerder las, vereisen alle active-learningscenario's een vorm van informatiewaarde voor de ongelabelde instanties. In deze sectie leg ik drie populaire benaderingen uit om instanties te bevragen onder de noemer uncertainty sampling vanwege het gebruik van waarschijnlijkheden (voor meer querystrategieën en diepgang over active learning in het algemeen raad ik deze survey aan).
Ik gebruik de onderstaande tabel om de querystrategieën uit te leggen. De tabel toont twee datapunten (instanties) en de kansen dat elke instantie elk label heeft. De kans dat d1 label A, B en C heeft is respectievelijk 0,9, 0,09 en 0,01, en voor d2 0,2, 0,5 en 0,3.
| Instanties | Label A | Label B | Label C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least Confidence (LC): bij deze strategie kiest de learner de instantie waarvoor hij het minst zeker is van het meest waarschijnlijke label. Kijkend naar de tabel: de learner is vrij zeker van het label voor d1, want hij denkt dat label A met kans 0,9 hoort, maar hij is minder zeker over d2 omdat de kansen daar meer verspreid zijn en hij denkt dat B slechts met kans 0,5 klopt. Met least confidence zou de learner dus d2 selecteren om het echte label op te vragen.
Margin Sampling: het nadeel van LC is dat het alleen naar het meest waarschijnlijke label kijkt en de andere labelkansen negeert. Margin sampling probeert dit te ondervangen door de instantie te kiezen met het kleinste verschil tussen de eerste en tweede meest waarschijnlijke labels. Voor d1 is het verschil tussen de eerste en tweede meest waarschijnlijke labels 0,81 (0,9 - 0,09) en voor d2 is dat 0,2 (0,5 - 0,3). De learner kiest dus opnieuw d2.
Entropy Sampling: om alle mogelijke labelkansen te benutten, gebruik je een populaire maat: entropie. De entropieformule wordt op elke instantie toegepast en de instantie met de grootste waarde wordt bevraagd. In ons voorbeeld heeft d1 waarde 0,155, terwijl d2 waarde 0,447 heeft, en dus kiest de learner wederom d2.
Tot nu toe heb je gelezen over de verschillende bouwstenen van active learning. Het kan wat verwarrend lijken om alle stappen samen te brengen, maar in deze sectie doorlopen we een compleet voorbeeld — zij het een heel eenvoudig.
Deze stap lijkt triviaal, maar het is belangrijk om te zorgen dat de dataset die je verzamelt representatief is voor de echte dataverdeling. Met andere woorden: probeer sterk scheve data te vermijden. In de praktijk is een volledig representatieve steekproef onmogelijk door beperkingen zoals wetgeving, tijd of beschikbaarheid.
In dit voorbeeld heb je de volgende 5 datapunten. Feature A en Feature B staan voor kenmerken die een datapunt kan hebben. Belangrijk: de data die we verzamelen is ongelabeld.
| Instanties | Feature A | Feature B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Vervolgens splits je de data in een heel kleine dataset die we gaan labelen en een grote ongelabelde dataset. In de active-learningterminologie noemen we die kleine gelabelde dataset de seed. Er is geen vast aantal of percentage van de ongelabelde data dat typisch wordt gebruikt. Zodra je de data voor de seed apart hebt gezet, label je die.
Let op dat onderzoekers in veel literatuur geen orakel of expert gebruiken om deze instanties te labelen. Doorgaans hebben ze een volledig gelabelde dataset, gebruiken ze een klein deel als seed (omdat die al een label heeft) en behandelen ze de rest alsof die ongelabeld is. Telkens wanneer de learner een instantie selecteert om bij de orcale op te vragen, kijken ze simpelweg het label van die instantie op.
In het voorbeeld selecteer je twee instanties voor de seed, d1 en d3. De mogelijke labels zijn hier 'Y' en 'N'.
Seed/gelabelde dataset
| Instanties | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Ongelabelde dataset
| Instanties | Feature A | Feature B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Na het splitsen gebruik je de seed om je learner te trainen zoals bij een normaal machine-learningproject (met cross-validatie enz.). Het type learner is gebaseerd op je domeinkennis en doorgaans gebruik je learners die een probabilistische respons geven of een instantie een bepaald label heeft, omdat je die kansen gebruikt voor de querystrategieën.
In het voorbeeld kun je elke gewenste classifier gebruiken en train je op je twee gelabelde instanties.
Zodra je je learner hebt getraind, kun je een of meer instanties selecteren om te bevragen. Je moet bepalen welk scenario je wilt gebruiken (Membership Query Synthesis, Stream-Based Selective Sampling of Pool-Based sampling) en welke querystrategie.
Je gebruikt pool-based sampling met een batchgrootte van 2. Dit betekent dat je bij elke iteratie twee instanties uit je ongelabelde dataset kiest en deze toevoegt aan je gelabelde dataset. Je gebruikt least confidence om je instanties te selecteren. Je learner kiest d2 en d4, waarvan de opgevraagde labels respectievelijk 'Y' en 'N' zijn.
Gelabelde dataset
| Instanties | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Ongelabelde dataset
| Instanties | Feature A | Feature B |
|---|---|---|
| d5 | 5 | 5 |
Nu kun je stappen 2 en 3 herhalen tot een bepaald stopcriterium. Dat betekent dat je, wanneer je een nieuwe gelabelde dataset hebt, je learner opnieuw traint en vervolgens meer ongelabelde data selecteert om te bevragen. Een stopcriterium kan het aantal bevraagde instanties zijn, een ander het aantal iteraties van stappen 2 en 3; je kunt ook stoppen wanneer de performance niet meer significant verbetert boven een bepaalde drempel.
In jouw voorbeeld stop je na één iteratie en ben je dus klaar met je active-learningalgoritme. Je kunt ook een aparte testdataset gebruiken om je learner op te evalueren en de prestaties te noteren. Zo kun je zien hoe de performance op de testset verbeterde of stagneerde naarmate je gelabelde data toevoegde.
Een van de populairste gebieden voor active learning is natural language processing (NLP). Veel NLP-toepassingen vereisen namelijk grote hoeveelheden gelabelde data (bijvoorbeeld Part-of-Speech Tagging, Named Entity Recognition) en het labelen is zeer kostbaar.
Er zijn zelfs maar een handvol NLP-datasets die vrij beschikbaar en volledig gelabeld zijn voor deze toepassingen. Met active learning kun je dus de benodigde hoeveelheid gelabelde data en het aantal experts dat nauwkeurig kan labelen, aanzienlijk verminderen. Dezelfde redenering geldt voor veel spraakherkenningstaken en zelfs taken zoals information retrieval.
Active learning wordt nog steeds intensief onderzocht. Veel onderzoekers zijn gaan kijken naar het gebruik van verschillende deep-learningalgoritmen zoals CNN's en LSTM's als learner en hoe je hun efficiëntie kunt verbeteren binnen active-learningkaders (Kronrod en Anandkumar, 2017; Sener en Savarese, 2017). Er wordt ook onderzoek gedaan naar het opnemen van Generative Adversarial Networks (GAN's) in het active-learningkader (Zhu en Bento, 2017). Met de groeiende interesse in deep reinforcement learning proberen onderzoekers active learning te herformuleren als een reinforcement-learningprobleem (Fang et. al, 2017). Ook zijn er papers die proberen active-learningstrategieën te leren via een meta-learningopzet (Fang et. al, 2017).
Leer meer over Machine Learning
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

