{count, plural, one {कोर्स} other {कोर्स}}
Understanding Machine Learning
{hours} घंटा
312K
एक्टिव लर्निंग ऐसा विषय है जिसके बारे में आपने सुना तो होगा, लेकिन शायद उसे पूरी तरह समझने का समय नहीं मिला। आज की ब्लॉग पोस्ट में हम एक्टिव लर्निंग के पीछे की सोच, इसके लाभ, और यह आधुनिक मशीन लर्निंग शोध में कहाँ फिट होती है, समझाएँगे।
एक्टिव लर्निंग का सही उपयोग करने की क्षमता आपके पास एक शक्तिशाली साधन दे देती है, जो उन स्थितियों में काम आता है जब लेबल्ड डेटा की कमी हो। एक्टिव लर्निंग को आप एक तरह की 'डिज़ाइन पद्धति' मान सकते हैं, जो ट्रांसफर लर्निंग की तरह, कम मात्रा में लेबल्ड डेटा का बेहतर लाभ उठाने में मदद करती है।
अगली पोस्ट में, आप सीखेंगे कि एक्टिव लर्निंग को ट्रांसफर लर्निंग के साथ मिलाकर मौजूदा (और नए) डेटा का सर्वोत्तम लाभ कैसे उठाया जा सकता है।
एक्टिव लर्निंग की औपचारिक परिभाषा पहले देने के बजाय, एक साधारण उदाहरण से शुरू करना बेहतर रहेगा ताकि आपको समझ आ सके कि एक्टिव लर्निंग क्यों काम करती है।
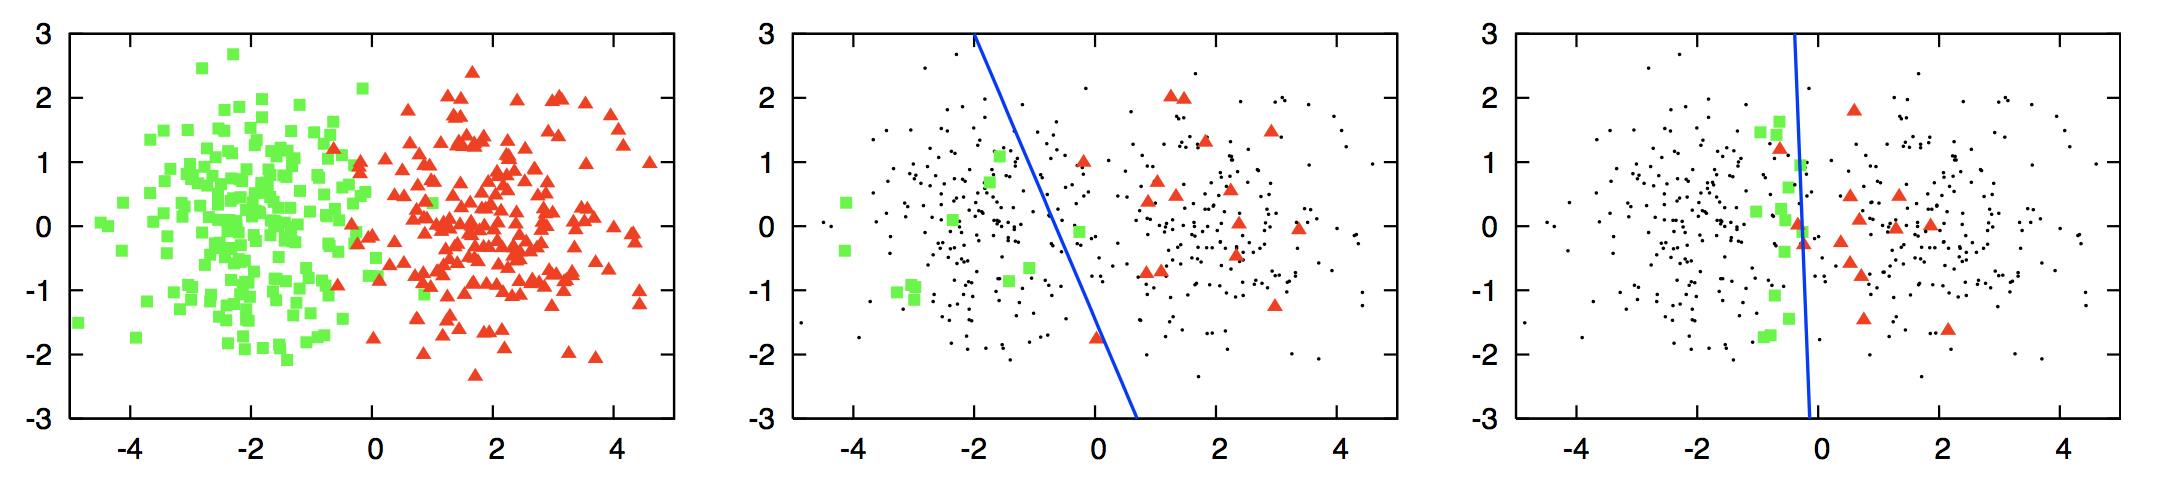
ऊपर बाएँ चित्र (जो इस सर्वे से लिया गया है) में, दो क्लस्टर हैं—हरे और लाल। समझदार पाठक समझेंगे कि यह एक क्लासिफिकेशन कार्य है और आपको एक 'डिसीज़न बाउंड्री' (यहाँ एक रेखा) बनानी है जो हरे और लाल आकारों को अलग कर दे। हालाँकि, मान लीजिए कि आपको डेटा बिंदुओं के लेबल (लाल या हरा) नहीं पता, और हर एक का लेबल जानना बहुत महंगा पड़ेगा। इसलिए, आप कुछ गिने-चुने बिंदुओं के नमूने लेकर उनके लेबल पता करेंगे और इन्हें एक क्लासिफायर के प्रशिक्षण डेटा के रूप में उपयोग करेंगे।
मध्य चित्र में, लॉजिस्टिक रिग्रेशन का उपयोग आकारों को वर्गीकृत करने के लिए किया गया है—पहले बेतरतीब ढंग से कुछ बिंदु चुनकर उन्हें लेबल किया गया। लेकिन आप देखेंगे कि लॉजिस्टिक रिग्रेशन से बनी डिसीज़न बाउंड्री (नीली रेखा) उपयुक्त नहीं है। यह रेखा स्पष्ट रूप से लाल बिंदुओं से हटकर हरे क्षेत्र में खिसकी हुई है। यानी कई हरे बिंदुओं को गलत तरीके से लाल लेबल मिल जाएगा। यह टेढ़ापन लेबलिंग के लिए खराब बिंदु-चयन के कारण है। दाएँ चित्र में, फिर से लॉजिस्टिक रिग्रेशन इस्तेमाल हुआ है, लेकिन इस बार बिंदुओं का छोटा उपसमूह एक्टिव लर्निंग की क्वेरी विधि से चुना गया। नई डिसीज़न बाउंड्री काफी बेहतर है क्योंकि यह दोनों रंगों को बेहतर अलग करती है। यह सुधार इसलिए आया क्योंकि बेहतर बिंदु चुने गए, जिससे क्लासिफायर ने बहुत अच्छी डिसीज़न बाउंड्री सीखी।
एक्टिव लर्निंग की क्वेरी विधि इतने अच्छे बिंदु चुनने में कैसे सक्षम हुई—यह एक्टिव लर्निंग के प्रमुख शोध क्षेत्रों में से एक है। आगे आप डेटा बिंदु क्वेरी करने की कुछ लोकप्रिय विधियाँ देखेंगे।
एक्टिव लर्निंग का मुख्य मत है कि यदि कोई लर्निंग एल्गोरिदम यह चुन सके कि वह किस डेटा से सीखे, तो वह पारंपरिक विधियों की तुलना में बहुत कम प्रशिक्षण डेटा के साथ बेहतर प्रदर्शन कर सकता है।
लेकिन ये पारंपरिक विधियाँ होती क्या हैं?
ये वे कार्य हैं जिनमें मूल वितरण से बेतरतीब ढंग से बहुत सारा डेटा एकत्र किया जाता है, और उसी बड़े डेटासेट से एक मॉडल को प्रशिक्षित किया जाता है जो कोई भविष्यवाणी कर सके। आप इस सामान्य विधि को पैसिव लर्निंग कहेंगे।
पैसिव लर्निंग में सबसे समय लेने वाले कार्यों में से एक है लेबल्ड डेटा इकट्ठा करना। कई परिस्थितियों में ऐसे अवरोधक होते हैं जो बड़े पैमाने पर लेबल्ड डेटा जुटाने में बाधा बनते हैं।
उदाहरण लें—अग्न्याशय कैंसर का अध्ययन। आप यह भविष्यवाणी करना चाहेंगे कि किसी रोगी को अग्न्याशय कैंसर होगा या नहीं; लेकिन संभव है कि आप केवल कुछ ही रोगियों की अतिरिक्त जाँच कर पाएँ ताकि फीचर्स इकट्ठा किए जा सकें। ऐसे में, बेतरतीब चयन के बजाय, हम कुछ मानदंडों के आधार पर रोगी चुन सकते हैं। जैसे, रोगी शराब पीता हो और 40 वर्ष से अधिक हो। यह मानदंड स्थिर नहीं होना चाहिए—यह पहले के रोगियों के नतीजों के आधार पर बदल सकता है। उदाहरण के लिए, यदि आपको पता चले कि आपका मॉडल 50 वर्ष से अधिक वालों के लिए अच्छी भविष्यवाणी करता है, लेकिन 40-50 वर्ष के बीच के लिए संघर्ष करता है, तो यह आपका नया मानदंड बन सकता है।
अब तक इकट्ठे किए गए डेटा के आधार पर इन रोगियों (या सामान्य रूप से इंस्टेंसेज़) का चयन करने की प्रक्रिया को एक्टिव लर्निंग कहा जाता है।
एक्टिव लर्निंग में आम तौर पर तीन परिदृश्य या सेटिंग्स होती हैं जिनमें लर्नर इंस्टेंसेज़ के लेबल पूछता है। साहित्य में जिन तीन मुख्य परिदृश्यों पर विचार किया गया है, वे हैं:
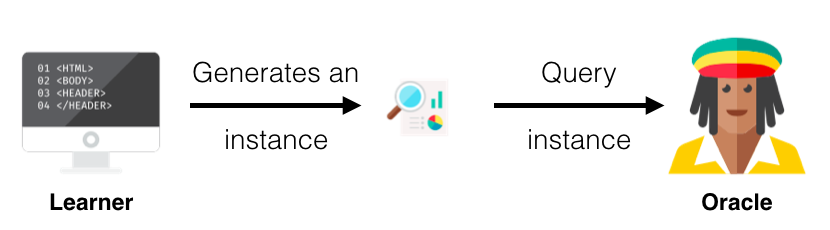
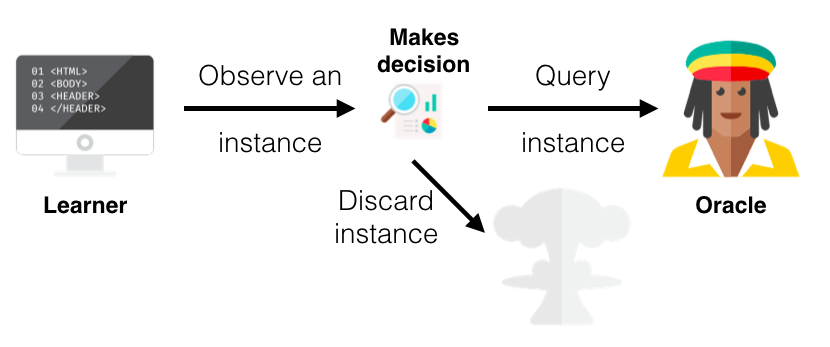
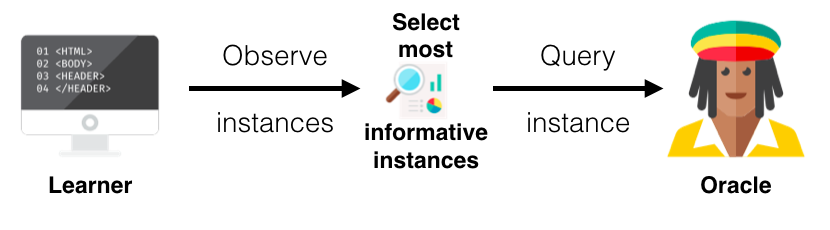
एक्टिव और पैसिव लर्नर के बीच मुख्य अंतर यह है कि एक्टिव लर्नर पिछले प्रश्नों और उनके उत्तरों (लेबल्स) के आधार पर इंस्टेंस क्वेरी कर सकता है। जैसा कि आपने पढ़ा, सभी एक्टिव लर्निंग परिदृश्यों में अनलेबल्ड इंस्टेंस की किसी न किसी सूचना-प्रदता माप की आवश्यकता होती है। इस खंड में मैं अनिश्चितता सैंपलिंग नामक सामान्य विषय के अंतर्गत तीन लोकप्रिय तरीकों को समझाऊँगा, जो संभावनाओं का उपयोग करते हैं (और अधिक क्वेरी रणनीतियों तथा एक्टिव लर्निंग पर विस्तृत जानकारी के लिए मैं यह सर्वे पेपर सुझाता हूँ)।
मैं नीचे दी गई तालिका का उपयोग करके क्वेरी रणनीतियाँ समझाऊँगा। इस तालिका में दो डेटा बिंदु (इंस्टेंस) और प्रत्येक के लिए प्रत्येक लेबल की संभावनाएँ दी गई हैं। d1 के लेबल A, B और C की संभावनाएँ क्रमशः 0.9, 0.09 और 0.01 हैं; और d2 के लिए 0.2, 0.5 और 0.3 हैं।
| Instances | Label A | Label B | Label C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
लीस्ट कॉन्फिडेंस (LC): इस रणनीति में, लर्नर उस इंस्टेंस का चयन करता है जिसके सबसे संभावित लेबल पर उसका सबसे कम भरोसा है। तालिका देखें—d1 के बारे में लर्नर काफ़ी आश्वस्त है, क्योंकि उसे लगता है कि इसे 0.9 प्रायिकता के साथ A होना चाहिए; जबकि d2 के बारे में वह कम आश्वस्त है, क्योंकि उसकी संभावनाएँ अधिक फैली हुई हैं और उसे लगता है कि यह 0.5 प्रायिकता के साथ B होना चाहिए। इसलिए, लीस्ट कॉन्फिडेंस का उपयोग करते हुए, लर्नर d2 को उसके वास्तविक लेबल के लिए चुनेगा।
मार्जिन सैंपलिंग: LC की कमी यह है कि यह केवल सबसे संभावित लेबल को देखती है और अन्य लेबल की संभावनाओं की अनदेखी करती है। मार्जिन सैंपलिंग इस कमी को दूर करने के लिए उस इंस्टेंस को चुनती है जिसके पहले और दूसरे सबसे संभावित लेबलों के बीच का अंतर सबसे छोटा हो। d1 के लिए यह अंतर 0.81 (0.9 - 0.09) है और d2 के लिए 0.2 (0.5 - 0.3)। अतः, लर्नर फिर से d2 चुनेगा।
एंट्रॉपी सैंपलिंग: सभी संभावित लेबलों की संभावनाओं का उपयोग करने के लिए, आप एंट्रॉपी नामक लोकप्रिय माप का उपयोग करते हैं। प्रत्येक इंस्टेंस पर एंट्रॉपी का सूत्र लगाया जाता है और सबसे बड़े मान वाले इंस्टेंस को क्वेरी किया जाता है। हमारे उदाहरण में, d1 का मान 0.155 है जबकि d2 का 0.447, इसलिए लर्नर एक बार फिर d2 का चयन करेगा।
अब तक आपने एक्टिव लर्निंग के विभिन्न घटकों के बारे में पढ़ा। सारे चरणों को जोड़ना थोड़ा उलझनभरा लग सकता है, लेकिन इस खंड में आप एक पूरा—भले ही बहुत सरल—उदाहरण देखेंगे।
यह चरण तुच्छ लग सकता है, लेकिन यह सुनिश्चित करना महत्वपूर्ण है कि जो डेटासेट आप जुटाएँ, वह डेटा के वास्तविक वितरण का प्रतिनिधि हो। दूसरे शब्दों में, बहुत अधिक टेढ़े-मेढ़े डेटा से बचने का प्रयास करें। वास्तविकता में, कानूनी, समय या उपलब्धता जैसी सीमाओं के कारण पूरी तरह प्रतिनिधि नमूना पाना असंभव है।
इस उदाहरण में, आपके पास निम्न 5 डेटा बिंदु होंगे। फीचर A और फीचर B वे कुछ विशेषताएँ दर्शाते हैं जो किसी डेटा बिंदु में हो सकती हैं। ध्यान दें कि जो डेटा हम जुटाते हैं, वह अनलेबल्ड है।
| Instances | Feature A | Feature B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
अगला कदम है डेटा को दो भागों में बाँटना—एक बहुत छोटा डेटासेट जिसे हम लेबल करेंगे और एक बड़ा अनलेबल्ड डेटासेट। एक्टिव लर्निंग की शब्दावली में, इस छोटे लेबल्ड डेटासेट को सीड कहते हैं। अनलेबल्ड डेटा का कोई तय अंश सामान्यतः उपयोग नहीं होता। एक बार जब आप सीड के लिए डेटा अलग रख लें, तो उन्हें लेबल कर दें।
ध्यान दें कि अधिकतर साहित्य में, शोधकर्ता इन इंस्टेंसेज़ को लेबल करने के लिए ओरेकल या विशेषज्ञ का उपयोग नहीं करते। आमतौर पर, वे एक पूरी तरह लेबल्ड डेटासेट लेते हैं और उसका एक छोटा हिस्सा सीड के लिए उपयोग कर लेते हैं (क्योंकि उनके पास पहले से लेबल होता है) और शेष को ऐसा मानते हैं जैसे वे अनलेबल्ड हों। जब भी लर्नर किसी इंस्टेंस को orcale से क्वेरी करने के लिए चुनता है, वे बस उस इंस्टेंस का लेबल देख लेते हैं।
उदाहरण जारी रखते हुए, आप सीड के लिए दो इंस्टेंस चुनते हैं—d1 और d3। इस मामले में संभावित लेबल 'Y' और 'N' हैं।
सीड/लेबल्ड डेटासेट
| Instances | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
अनलेबल्ड डेटासेट
| Instances | Feature A | Feature B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
डेटा विभाजित करने के बाद, आप सीड का उपयोग करके अपने लर्नर को एक सामान्य मशीन लर्निंग प्रोजेक्ट की तरह प्रशिक्षित करेंगे (क्रॉस-वैलिडेशन आदि के साथ)। साथ ही, किस प्रकार का लर्नर उपयोग करना है, यह आपके डोमेन ज्ञान पर निर्भर करेगा; आमतौर पर आप ऐसे लर्नर का इस्तेमाल करेंगे जो किसी इंस्टेंस के किसी विशेष लेबल का प्रायिकतामूलक उत्तर दें—क्योंकि इन्हीं संभावनाओं का उपयोग आप क्वेरी रणनीतियों में करते हैं।
उदाहरण में, आप कोई भी क्लासिफायर चुन सकते हैं और अपने दो लेबल्ड इंस्टेंस पर प्रशिक्षण करेंगे।
लर्नर के प्रशिक्षित होने के बाद, अब आप क्वेरी के लिए एक या अधिक इंस्टेंस चुनने के लिए तैयार हैं। आपको यह तय करना होगा कि आप किस परिदृश्य का उपयोग करेंगे (यानी, मेंबरशिप क्वेरी सिंथेसिस, स्ट्रीम-आधारित चयनात्मक सैंपलिंग या पूल-आधारित सैंपलिंग) और कौन सी क्वेरी रणनीति अपनाएँगे।
आप पूल-आधारित सैंपलिंग का उपयोग करेंगे, बैच आकार 2 के साथ। इसका अर्थ है कि प्रत्येक पुनरावृत्ति में, आप अपने अनलेबल्ड डेटासेट से दो इंस्टेंस चुनेंगे और फिर उन्हें अपने लेबल्ड डेटासेट में जोड़ देंगे। आप इंस्टेंस चुनने के लिए लीस्ट कॉन्फिडेंस का उपयोग करते हैं। आपका लर्नर d2 और d4 चुनता है, जिनके क्वेरी किए गए लेबल क्रमशः 'Y' और 'N' हैं।
लेबल्ड डेटासेट
| Instances | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
अनलेबल्ड डेटासेट
| Instances | Feature A | Feature B |
|---|---|---|
| d5 | 5 | 5 |
अब, आप चरण 2 और 3 को तब तक दोहरा सकते हैं जब तक कोई रोकने का मानदंड पूरा न हो जाए। यानी, नया लेबल्ड डेटासेट मिलने पर, आप अपने लर्नर को फिर से प्रशिक्षित करेंगे और फिर आगे क्वेरी के लिए अनलेबल्ड डेटा चुनेंगे। रोकने का एक मानदंड क्वेरी किए गए इंस्टेंसों की संख्या हो सकता है, दूसरा चरण 2 और 3 की पुनरावृत्तियों की संख्या; आप तब भी रुक सकते हैं जब प्रदर्शन किसी तय सीमा से अधिक महत्वपूर्ण सुधार न दिखाए।
अपने उदाहरण में, आप एक पुनरावृत्ति पर रुकेंगे, और इस तरह आपका एक्टिव लर्निंग एल्गोरिदम पूरा हो गया। आप एक अलग टेस्ट डेटासेट भी रख सकते हैं जिस पर लर्नर का मूल्यांकन करें और उसका प्रदर्शन दर्ज करें। इससे आप देख पाएँगे कि टेस्ट सेट पर प्रदर्शन अतिरिक्त लेबल्ड डेटा के साथ कैसे बेहतर हुआ या ठहर गया।
एक्टिव लर्निंग के सबसे लोकप्रिय क्षेत्रों में से एक है नेचुरल लैंग्वेज प्रोसेसिंग (NLP)। इसका कारण यह है कि NLP के कई अनुप्रयोगों (जैसे पार्ट-ऑफ-स्पीच टैगिंग, नेम्ड एंटिटी रिकग्निशन) में बहुत सारे लेबल्ड डेटा की आवश्यकता होती है और इस डेटा को लेबल करना बहुत महँगा होता है।
वास्तव में, NLP में ऐसे अनुप्रयोगों के लिए केवल मुट्ठीभर डेटासेट ही मुफ़्त में उपलब्ध हैं और पूरी तरह टैग किए हुए हैं। इसलिए, एक्टिव लर्निंग का उपयोग करके आवश्यक लेबल्ड डेटा की मात्रा और उन्हें सही ढंग से लेबल करने के लिए विशेषज्ञों की जरूरत को काफी कम किया जा सकता है। यही तर्क कई स्पीच रिकग्निशन कार्यों और यहाँ तक कि सूचना पुनर्प्राप्ति जैसे कार्यों पर भी लागू होता है।
एक्टिव लर्निंग पर अभी भी व्यापक रूप से शोध हो रहा है। कई शोधकर्ता विभिन्न डीप लर्निंग एल्गोरिदम, जैसे CNNs और LSTMs, को लर्नर के रूप में उपयोग करने और एक्टिव लर्निंग फ्रेमवर्क में उनकी दक्षता बढ़ाने पर काम कर रहे हैं (Kronrod और Anandkumar, 2017; Sener और Savarese, 2017)। जनरेटिव एड्वरसिरियल नेटवर्क्स (GANs) को एक्टिव लर्निंग फ्रेमवर्क में शामिल करने पर भी शोध हो रहा है (Zhu और Bento, 2017)। डीप रिइन्फोर्समेंट लर्निंग में बढ़ती दिलचस्पी के साथ, शोधकर्ता एक्टिव लर्निंग को रिइन्फोर्समेंट लर्निंग समस्या के रूप में ढालने की कोशिश कर रहे हैं (Fang आदि, 2017)। इसके अलावा, कुछ पेपर मेटा-लर्निंग सेटिंग के माध्यम से एक्टिव लर्निंग रणनीतियाँ सीखने की कोशिश करते हैं (Fang आदि, 2017)।
मशीन लर्निंग के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}