Corso
Capire il Machine Learning
2 ore
311.3K
L’active learning è uno di quegli argomenti di cui senti parlare di sfuggita ma a cui non hai mai dedicato il tempo per capirlo davvero. Il post di oggi spiegherà la logica alla base dell’active learning, i suoi benefici e come si inserisce nella ricerca moderna sul machine learning.
Saper utilizzare bene l’active learning ti fornirà uno strumento molto potente quando i dati etichettati scarseggiano. L’active learning può essere visto come una sorta di “metodologia di progettazione”, simile al transfer learning, che consente di sfruttare anche piccole quantità di dati etichettati.
In un prossimo post, imparerai come usare l’active learning insieme al transfer learning per sfruttare al meglio i dati esistenti (e nuovi).
Piuttosto che partire con una definizione formale di active learning, è meglio cominciare da un semplice esempio per capire perché funziona.
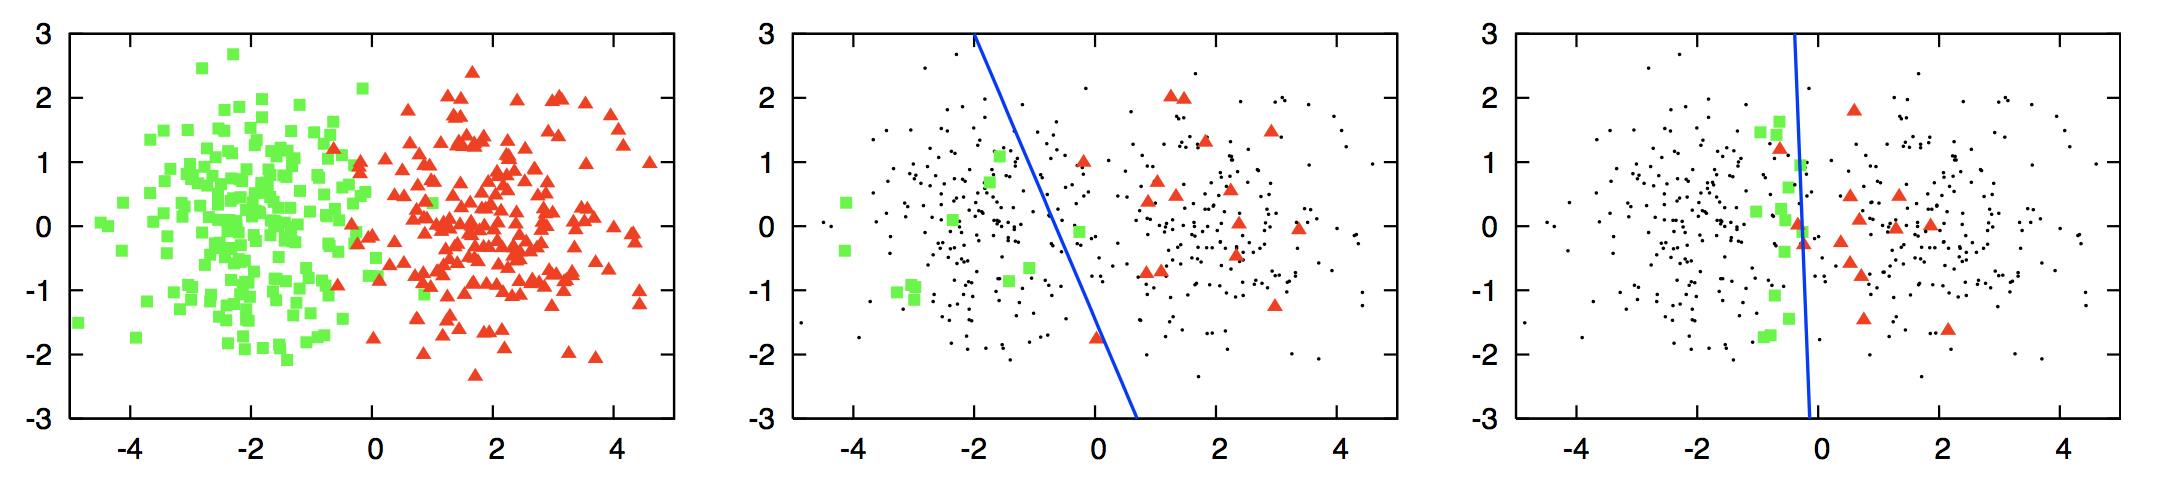
Osservando l’immagine più a sinistra (tratta da questo survey), vedi due cluster, uno verde e uno rosso. I lettori più attenti riconosceranno un compito di classificazione: vuoi creare una “frontiera di decisione” (in questo caso, una linea) che separi le forme verdi da quelle rosse. Tuttavia, puoi assumere di non conoscere le etichette (rosso o verde) dei punti, e ricavare l’etichetta per ciascuno sarebbe molto costoso. Di conseguenza, vuoi campionare un piccolo sottoinsieme di punti, ottenere le loro etichette e usare questi dati etichettati come training set per un classificatore.
Nell’immagine centrale, si usa la regressione logistica per classificare le forme campionando casualmente un piccolo sottoinsieme di punti e assegnando loro un’etichetta. Tuttavia, la frontiera di decisione ottenuta (la linea blu) è subottimale. È chiaramente spostata lontano dai punti rossi e verso l’area delle forme verdi. Questo significa che molti punti verdi verranno etichettati erroneamente come rossi. Lo spostamento è dovuto alla scarsa selezione dei punti da etichettare. Nell’immagine a destra, si usa di nuovo la regressione logistica, ma questa volta si seleziona un piccolo sottoinsieme di punti con un metodo di query di active learning. La nuova frontiera di decisione è notevolmente migliore perché separa meglio i due colori. Il miglioramento deriva dalla scelta di punti più informativi, che ha permesso al classificatore di tracciare una frontiera molto efficace.
Come il metodo di query dell’active learning sia riuscito a selezionare punti così buoni è uno dei principali temi di ricerca nell’active learning. Più avanti vedrai alcuni dei metodi più popolari per interrogare i punti dati.
L’ipotesi principale dell’active learning è che, se un algoritmo può scegliere i dati da cui imparare, può ottenere prestazioni migliori dei metodi tradizionali utilizzando sostanzialmente meno dati per l’addestramento.
Ma quali sono esattamente questi metodi tradizionali?
Si tratta di compiti che prevedono la raccolta di una grande quantità di dati campionati casualmente dalla distribuzione sottostante e l’uso di questo ampio dataset per addestrare un modello che effettui una qualche previsione. Chiamerai questo metodo tipico apprendimento passivo.
Uno dei passaggi più dispendiosi in termini di tempo nell’apprendimento passivo è la raccolta di dati etichettati. In molti contesti, ci sono fattori limitanti che ostacolano la raccolta di grandi quantità di dati etichettati.
Prendiamo l’esempio dello studio del cancro al pancreas. Potresti voler prevedere se un paziente svilupperà un cancro al pancreas, ma potresti avere l’opportunità di sottoporre a esami approfonditi solo un numero ridotto di pazienti per raccogliere caratteristiche, ecc. In questo caso, invece di selezionare i pazienti a caso, possiamo selezionarli in base a determinati criteri. Un criterio potrebbe essere se il paziente consuma alcol ed è sopra i 40 anni. Questo criterio non deve essere statico, ma può cambiare a seconda dei risultati dei pazienti precedenti. Ad esempio, se ti rendi conto che il tuo modello è bravo a prevedere il cancro al pancreas per gli over 50, ma fatica tra i 40 e i 50 anni, questo potrebbe diventare il tuo nuovo criterio.
Il processo di selezione di questi pazienti (o più in generale istanze) in base ai dati raccolti finora si chiama active learning.
Nell’active learning, ci sono in genere tre scenari o impostazioni in cui il learner richiede le etichette delle istanze. I tre principali scenari considerati in letteratura sono:
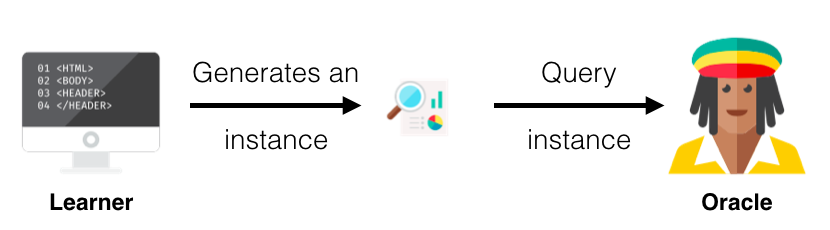
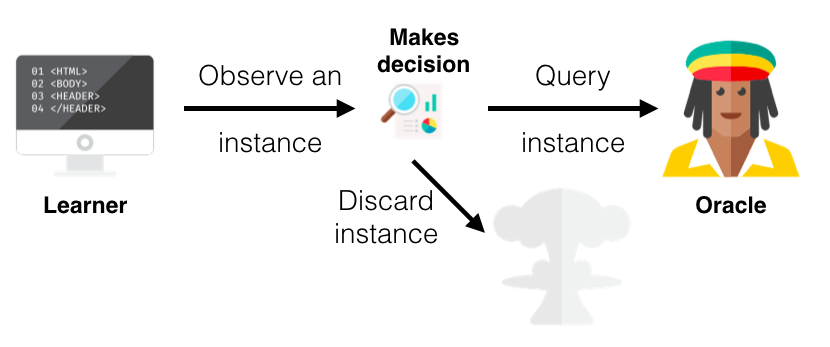
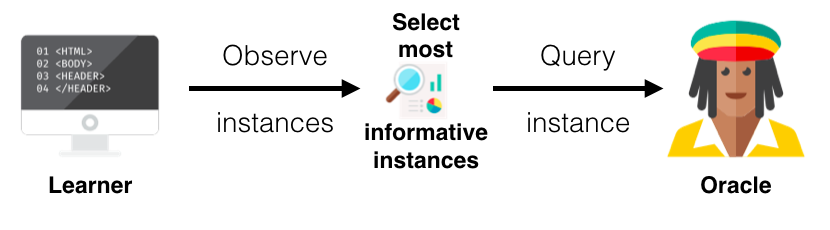
La principale differenza tra un learner attivo e uno passivo è la capacità di interrogare istanze in base alle query passate e alle relative risposte (etichette). Come hai letto, tutti gli scenari di active learning richiedono una qualche misura di informatività delle istanze non etichettate. In questa sezione spiegherò tre approcci popolari per interrogare le istanze, raggruppati sotto il tema comune dell’uncertainty sampling per via dell’uso di probabilità (per ulteriori strategie di query e una trattazione più approfondita dell’active learning in generale, consiglio questo survey).
Userò la tabella seguente per spiegare le strategie. La tabella mostra due punti dati (istanze) e le probabilità che ciascuna istanza abbia ciascuna etichetta. La probabilità che d1 abbia etichetta A, B e C è rispettivamente 0,9, 0,09 e 0,01; per d2 è 0,2, 0,5 e 0,3.
| Istanze | Etichetta A | Etichetta B | Etichetta C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least Confidence (LC): in questa strategia, il learner seleziona l’istanza per cui ha meno confidenza nella sua etichetta più probabile. Guardando la tabella, il learner è piuttosto sicuro dell’etichetta di d1, dato che ritiene debba avere etichetta A con probabilità 0,9; è invece meno sicuro dell’etichetta di d2 poiché le probabilità sono più distribuite e pensa che debba essere etichettata B con probabilità solo 0,5. Quindi, usando la least confidence, il learner selezionerebbe d2 per interrogare la sua etichetta reale.
Margin Sampling: il limite della strategia LC è che considera solo l’etichetta più probabile e trascura le altre. La margin sampling cerca di superare questo svantaggio selezionando l’istanza con la differenza più piccola tra la prima e la seconda etichetta più probabile. Guardando d1, la differenza tra la prima e la seconda etichetta più probabile è 0,81 (0,9 - 0,09) e per d2 è 0,2 (0,5 - 0,3). Di conseguenza, il learner selezionerà di nuovo d2.
Entropy Sampling: per utilizzare tutte le probabilità delle etichette possibili, si usa una misura popolare chiamata entropia. La formula dell’entropia è applicata a ciascuna istanza e si interroga l’istanza con il valore più grande. Nel nostro esempio, d1 ha valore 0,155 mentre il valore di d2 è 0,447, quindi il learner selezionerà ancora una volta d2.
Finora hai visto le diverse componenti che costituiscono l’active learning. Può sembrare un po’ confuso o difficile concatenare tutti i passaggi, ma in questa sezione percorrerai un esempio completo — seppur molto semplice.
Questo passo può sembrare banale, ma è importante assicurarsi che il dataset raccolto sia rappresentativo della vera distribuzione dei dati. In altre parole, cerca di evitare dati troppo sbilanciati. Nella pratica è impossibile avere un campione perfettamente rappresentativo per limiti legali, di tempo o di disponibilità.
In questo esempio, avrai i seguenti 5 punti dati. Feature A e Feature B rappresentano alcune caratteristiche che un punto dati può avere. È importante notare che i dati raccolti non sono etichettati.
| Istanze | Feature A | Feature B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Successivamente, devi dividere i dati in un dataset molto piccolo che etichettiamo e in un ampio dataset non etichettato. In terminologia di active learning, chiamiamo questo piccolo dataset etichettato seed. Non esiste un numero o una percentuale fissa dei dati non etichettati da usare. Una volta messo da parte il set per il seed, dovresti etichettarlo.
Nota che, nella maggior parte della letteratura, i ricercatori non usano un oracolo o un esperto per etichettare queste istanze. Tipicamente dispongono di un dataset completamente etichettato e ne usano una piccola parte come seed (dato che le etichette ci sono già) e trattano il resto come se fosse non etichettato. Ogni volta che il learner seleziona un’istanza da interrogare con l’orcale, semplicemente ne consultano l’etichetta.
Proseguendo con l’esempio, selezioni due istanze per il seed, d1 e d3. Le possibili etichette in questo caso sono “Y” e “N”.
Seed/dataset etichettato
| Istanze | Feature A | Feature B | Etichetta |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Dataset non etichettato
| Istanze | Feature A | Feature B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Dopo la suddivisione dei dati, usi il seed per addestrare il learner come in un normale progetto di machine learning (usando cross-validation ecc.). Inoltre, il tipo di learner usato dipenderà dalla conoscenza del dominio e, in genere, si preferiscono learner che diano una risposta probabilistica sul fatto che un’istanza abbia una certa etichetta, poiché userai queste probabilità per le strategie di query.
Nell’esempio, puoi usare qualsiasi classificatore e addestrarlo sulle due istanze etichettate.
Una volta addestrato il learner, sei pronto a selezionare una o più istanze da interrogare. Devi determinare lo scenario che vuoi usare (Membership Query Synthesis, Stream-Based Selective Sampling o Pool-Based sampling) e la strategia di query.
Userai il pool-based sampling con una batch size di 2. Significa che a ogni iterazione selezionerai due istanze dal dataset non etichettato e poi le aggiungerai al dataset etichettato. Usi la least confidence per selezionare le istanze. Il learner sceglie d2 e d4, le cui etichette richieste sono rispettivamente “Y” e “N”.
Dataset etichettato
| Istanze | Feature A | Feature B | Etichetta |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Dataset non etichettato
| Istanze | Feature A | Feature B |
|---|---|---|
| d5 | 5 | 5 |
Ora puoi ripetere i passi 2 e 3 fino a soddisfare un criterio di arresto. Significa che, con il nuovo dataset etichettato, ri-addestrerai il learner e poi selezionerai ulteriori dati non etichettati da interrogare. Un criterio di arresto potrebbe essere il numero di istanze interrogate, un altro il numero di iterazioni dei passi 2 e 3; puoi anche fermarti quando le prestazioni non migliorano in modo significativo oltre una certa soglia.
Nell’esempio, ti fermerai dopo un’iterazione e quindi hai concluso il tuo algoritmo di active learning. Puoi anche avere un dataset di test separato su cui valutare il learner e registrare le prestazioni. In questo modo, puoi osservare come le prestazioni sul test set migliorano o ristagnano con l’aggiunta di dati etichettati.
Uno dei campi più popolari per l’active learning è il Natural Language Processing (NLP). Questo perché molte applicazioni in NLP richiedono grandi quantità di dati etichettati (ad esempio, Part-of-Speech Tagging, Named Entity Recognition) e l’etichettatura è molto costosa.
Infatti, ci sono pochi dataset in NLP liberamente disponibili e completamente annotati per queste applicazioni. Di conseguenza, l’active learning può ridurre in modo significativo la quantità di dati etichettati necessaria e il numero di esperti richiesti per etichettarli accuratamente. Lo stesso ragionamento si applica a molti compiti di riconoscimento vocale e persino a task come l’information retrieval.
L’active learning è ancora oggetto di intensa ricerca. Molti hanno iniziato a usare diversi algoritmi di deep learning come CNN e LSTM come learner e a studiare come migliorarne l’efficienza all’interno di framework di active learning (Kronrod e Anandkumar, 2017; Sener e Savarese, 2017). C’è anche ricerca sull’integrazione delle Generative Adversarial Networks (GAN) nei framework di active learning (Zhu e Bento, 2017). Con il crescente interesse per il deep reinforcement learning, i ricercatori stanno cercando di riformulare l’active learning come un problema di reinforcement learning (Fang et al., 2017). Inoltre, ci sono articoli che cercano di apprendere strategie di active learning tramite un’impostazione di meta-learning (Fang et al., 2017).
Scopri di più sul Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



