Kursus
Memahami Machine Learning
2 jam
311.7K
Active learning adalah salah satu topik yang sering terdengar sekilas namun entah kenapa Anda tak pernah benar-benar meluangkan waktu untuk memahaminya. Postingan blog hari ini akan menjelaskan alasan di balik active learning, manfaatnya, dan bagaimana posisinya dalam riset machine learning modern.
Mampu memanfaatkan active learning dengan tepat akan memberi Anda alat yang sangat kuat saat terjadi kekurangan data berlabel. Active learning dapat dipandang sebagai jenis 'metodologi perancangan' mirip dengan transfer learning, yang juga dapat digunakan untuk memanfaatkan sejumlah kecil data berlabel.
Dalam postingan berikutnya, Anda akan mempelajari cara menggunakan active learning bersama transfer learning untuk memaksimalkan pemanfaatan data yang ada (dan baru).
Alih-alih langsung memberikan definisi formal untuk active learning, lebih baik kita mulai dengan contoh sederhana agar Anda lebih memahami mengapa active learning bekerja.
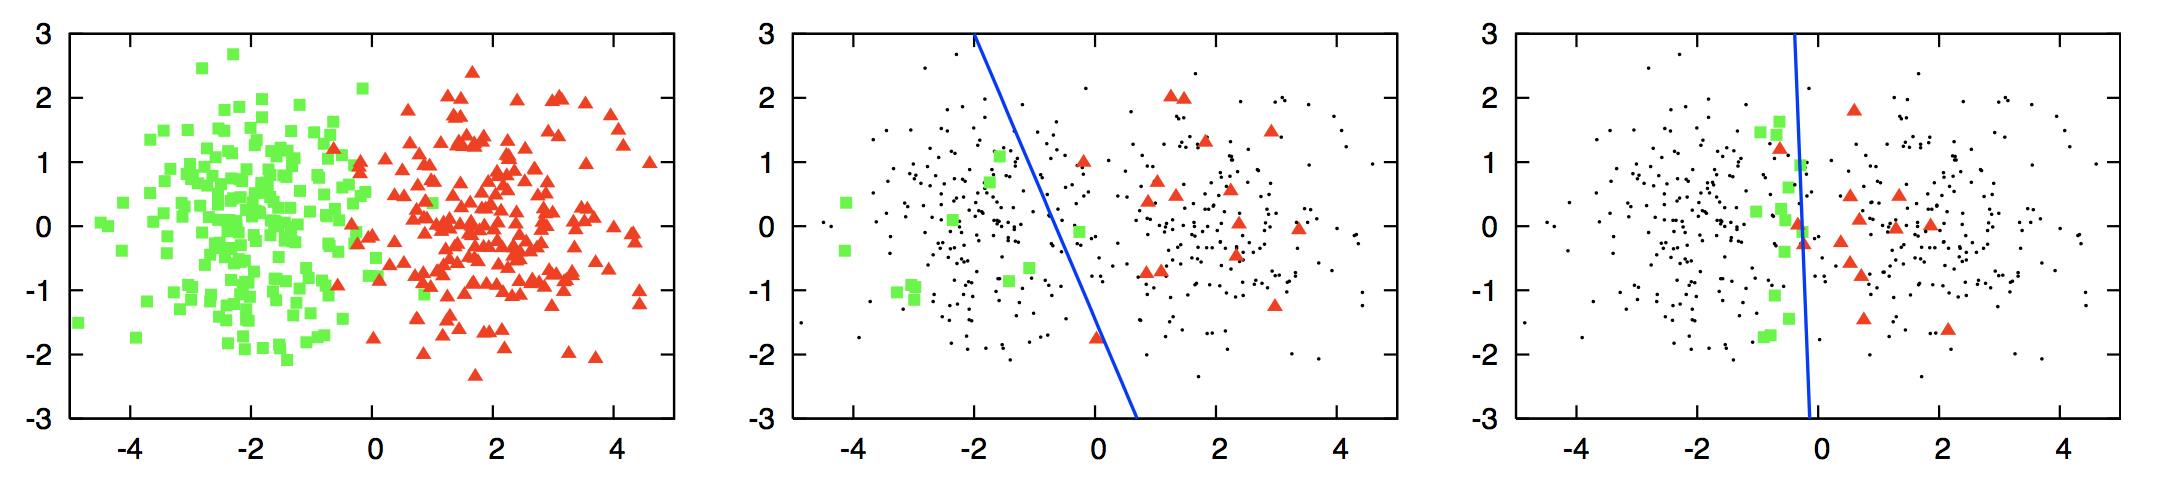
Melihat gambar paling kiri di atas (diambil dari survei ini), terdapat dua klaster, yang berwarna hijau dan yang berwarna merah. Pembaca yang jeli akan tahu bahwa ini adalah tugas klasifikasi dan Anda ingin membuat 'batas keputusan' (dalam kasus ini, hanya sebuah garis) yang memisahkan bentuk hijau dan merah. Namun, Anda dapat mengasumsikan bahwa Anda tidak mengetahui label (merah atau hijau) dari titik-titik data ini, sementara mencari label untuk masing-masing akan sangat mahal. Akibatnya, Anda ingin mengambil sampel subset kecil dari titik-titik tersebut, mencari labelnya, dan menggunakan titik data berlabel ini sebagai data latih untuk sebuah pengklasifikasi.
Pada gambar tengah, regresi logistik digunakan untuk mengklasifikasikan bentuk-bentuk dengan terlebih dahulu mengambil sampel acak subset kecil titik dan memberi label. Namun, terlihat bahwa batas keputusan yang dibuat menggunakan regresi logistik (garis biru) kurang optimal. Garis ini jelas miring menjauh dari titik data merah dan masuk ke area bentuk hijau. Artinya, akan ada banyak titik data hijau yang salah diberi label sebagai merah. Kemiringan ini terjadi karena pemilihan titik data untuk pelabelan yang kurang baik. Pada gambar paling kanan, regresi logistik digunakan lagi, tetapi kali ini, Anda memilih subset kecil titik menggunakan metode kueri active learning. Batas keputusan baru ini jauh lebih baik karena lebih memisahkan kedua warna. Peningkatan ini berasal dari pemilihan titik data yang lebih baik sehingga pengklasifikasi mampu membuat batas keputusan yang sangat baik.
Bagaimana metode kueri active learning dapat memilih titik-titik yang begitu baik adalah salah satu area riset utama dalam active learning. Nanti, Anda akan melihat beberapa metode paling populer untuk mengueri titik data.
Hipotesis utama dalam active learning adalah bahwa jika sebuah algoritma pembelajaran dapat memilih data yang ingin dipelajarinya, ia dapat berkinerja lebih baik daripada metode tradisional dengan data latih yang jauh lebih sedikit.
Lalu, apa sebenarnya metode tradisional itu?
Ini adalah tugas yang melibatkan pengumpulan sejumlah besar data yang diambil secara acak dari distribusi dasar dan menggunakan dataset besar ini untuk melatih model yang dapat melakukan semacam prediksi. Metode tipikal ini akan Anda sebut sebagai passive learning.
Salah satu tugas yang memakan waktu dalam passive learning adalah mengumpulkan data berlabel. Dalam banyak situasi, ada faktor pembatas yang menghambat pengumpulan data berlabel dalam jumlah besar.
Ambil contoh studi kanker pankreas. Anda mungkin ingin memprediksi apakah seorang pasien akan terkena kanker pankreas, namun Anda mungkin hanya memiliki kesempatan untuk memberikan pemeriksaan lanjutan kepada sejumlah kecil pasien guna mengumpulkan fitur, dan sebagainya. Dalam kasus ini, alih-alih memilih pasien secara acak, kita dapat memilih pasien berdasarkan kriteria tertentu. Contoh kriteria mungkin apakah pasien mengonsumsi alkohol dan berusia di atas 40 tahun. Kriteria ini tidak harus statis dan dapat berubah bergantung pada hasil dari pasien sebelumnya. Misalnya, jika Anda menyadari bahwa model Anda bagus dalam memprediksi kanker pankreas untuk usia di atas 50 tahun, tetapi kesulitan membuat prediksi akurat untuk usia 40–50 tahun, ini bisa menjadi kriteria baru Anda.
Proses memilih pasien (atau secara lebih umum instans) berdasarkan data yang telah kita kumpulkan sejauh ini disebut active learning.
Dalam active learning, umumnya ada tiga skenario atau pengaturan di mana pembelajar akan meminta label instans. Tiga skenario utama yang dibahas dalam literatur adalah:
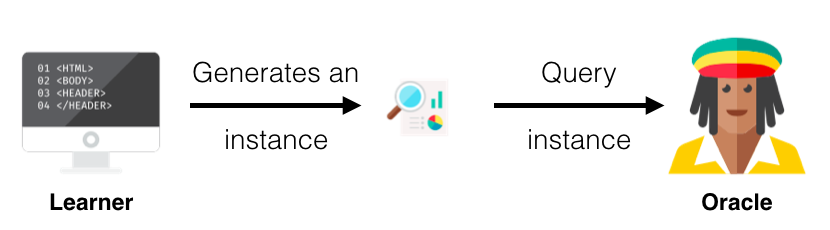
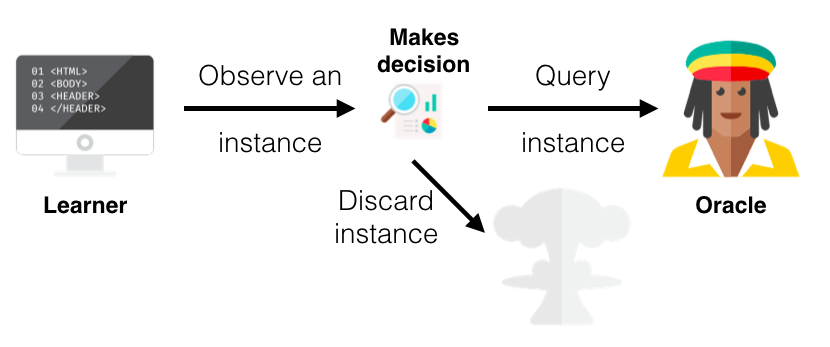
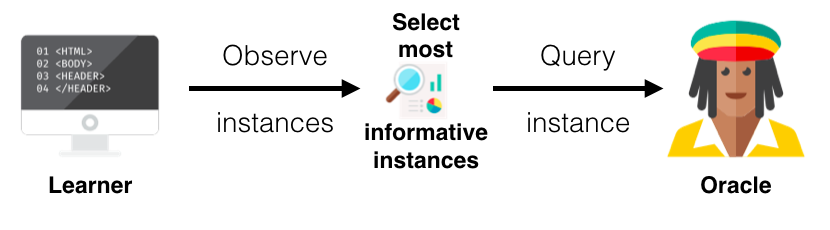
Perbedaan utama atau inti antara pembelajar aktif dan pasif adalah kemampuan untuk mengueri instans berdasarkan kueri sebelumnya dan respons (label) dari kueri-kueri tersebut. Seperti yang telah Anda baca, semua skenario active learning memerlukan semacam ukuran informativeness untuk instans tanpa label. Di bagian ini saya akan menjelaskan tiga pendekatan populer untuk mengueri instans dalam topik umum yang disebut uncertainty sampling karena menggunakan probabilitas (untuk lebih banyak strategi kueri dan informasi mendalam tentang active learning secara umum saya sarankan makalah survei ini).
Saya akan menggunakan tabel di bawah untuk menjelaskan strategi kueri. Tabel ini menunjukkan dua titik data (instans) dan probabilitas bahwa tiap instans memiliki setiap label. Probabilitas d1 memiliki label A, B, dan C adalah 0,9, 0,09, dan 0,01 masing-masing, dan 0,2, 0,5, dan 0,3 untuk d2.
| Instans | Label A | Label B | Label C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least Confidence (LC): dalam strategi ini, pembelajar memilih instans yang paling tidak ia yakini untuk label yang paling mungkin. Melihat tabel, pembelajar cukup yakin akan label untuk d1, karena ia menilai seharusnya berlabel A dengan probabilitas 0,9, namun ia kurang yakin terhadap label d2 karena probabilitasnya lebih tersebar dan menilai seharusnya berlabel B dengan probabilitas hanya 0,5. Jadi, dengan least confidence, pembelajar akan memilih d2 untuk mengueri label sebenarnya.
Margin Sampling: kekurangan strategi LC adalah hanya mempertimbangkan label paling mungkin dan mengabaikan probabilitas label lain. Strategi margin sampling berupaya mengatasi kekurangan ini dengan memilih instans yang memiliki selisih terkecil antara label pertama dan kedua yang paling mungkin. Melihat d1, selisih antara label pertama dan kedua yang paling mungkin adalah 0,81 (0,9 - 0,09) dan untuk d2 adalah 0,2 (0,5 - 0,3). Maka, pembelajar akan memilih d2 lagi.
Entropy Sampling: untuk memanfaatkan semua probabilitas label yang mungkin, Anda menggunakan ukuran populer bernama entropi. Rumus entropi diterapkan pada setiap instans dan instans dengan nilai terbesar akan dikueri. Menggunakan contoh kita, d1 bernilai 0,155 sementara nilai d2 adalah 0,447 sehingga pembelajar akan memilih d2 sekali lagi.
Sampai sekarang, Anda telah membaca tentang berbagai komponen yang membentuk active learning. Mungkin terlihat agak membingungkan atau sulit merangkai semua langkahnya, tetapi di bagian ini, Anda akan melalui sebuah contoh lengkap — walaupun sangat sederhana.
Langkah ini mungkin tampak sepele, namun penting untuk memastikan bahwa dataset yang Anda kumpulkan mewakili distribusi data yang sebenarnya. Dengan kata lain, usahakan menghindari data yang sangat bias. Pada kenyataannya mustahil memiliki sampel yang benar-benar representatif karena keterbatasan seperti legalitas, waktu, atau ketersediaan.
Dalam contoh ini, Anda memiliki 5 titik data berikut. Fitur A dan Fitur B merepresentasikan beberapa fitur yang mungkin dimiliki sebuah titik data. Penting untuk dicatat bahwa data yang kita kumpulkan tidak berlabel.
| Instans | Fitur A | Fitur B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Berikutnya, Anda perlu membagi data menjadi dataset yang sangat kecil yang akan kita labeli dan dataset besar tanpa label. Dalam terminologi active learning, dataset kecil berlabel ini disebut seed. Tidak ada jumlah atau persentase baku dari data tanpa label yang biasanya digunakan. Setelah Anda menyisihkan data yang akan digunakan untuk seed, Anda harus memberi label padanya.
Catatan bahwa, dalam sebagian besar literatur, peneliti tidak menggunakan orakel atau pakar untuk memberi label pada instans ini. Biasanya, mereka memperoleh dataset yang sudah berlabel penuh dan menggunakan sebagian kecil sebagai seed (karena labelnya sudah ada) dan menggunakan sisanya seolah-olah tanpa label. Kapan pun pembelajar memilih sebuah instans untuk diueri ke orcale, mereka cukup melihat label instans tersebut.
Melanjutkan contoh, Anda memilih dua instans untuk seed, d1 dan d3. Label yang mungkin dalam kasus ini adalah 'Y' dan 'N'.
Dataset Seed/berlabel
| Instans | Fitur A | Fitur B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Dataset Tanpa Label
| Instans | Fitur A | Fitur B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Setelah membagi data, Anda menggunakan seed untuk melatih pembelajar seperti proyek machine learning biasa (menggunakan cross-validation, dll.). Selain itu, jenis pembelajar yang digunakan akan didasarkan pada pengetahuan Anda tentang domain dan umumnya Anda menggunakan pembelajar yang memberikan respons probabilistik apakah sebuah instans memiliki label tertentu, karena Anda menggunakan probabilitas ini untuk strategi kueri.
Dalam contoh, Anda dapat menggunakan pengklasifikasi apa pun yang Anda inginkan dan Anda akan melatih pada dua instans berlabel Anda.
Setelah melatih pembelajar, Anda siap memilih satu atau beberapa instans untuk dikueri. Anda harus menentukan jenis skenario yang ingin digunakan (yaitu, Membership Query Synthesis, Stream-Based Selective Sampling, atau Pool-Based sampling) dan strategi kuerinya.
Anda akan menggunakan pool-based sampling dengan ukuran batch 2. Ini berarti pada setiap iterasi, Anda akan memilih dua instans dari dataset tanpa label Anda lalu menambahkan instans ini ke dataset berlabel Anda. Anda menggunakan least confidence untuk memilih instans. Pembelajar Anda memilih d2 dan d4 yang label hasil kuerinya masing-masing adalah 'Y' dan 'N'.
Dataset Berlabel
| Instans | Fitur A | Fitur B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Dataset Tanpa Label
| Instans | Fitur A | Fitur B |
|---|---|---|
| d5 | 5 | 5 |
Sekarang, Anda dapat mengulangi langkah 2 dan 3 hingga memenuhi suatu kriteria penghentian. Artinya, saat Anda memiliki dataset berlabel baru, Anda akan melatih ulang pembelajar dan kemudian memilih data tanpa label lebih lanjut untuk dikueri. Salah satu kriteria penghentian bisa berupa jumlah instans yang dikueri, yang lain bisa berupa jumlah iterasi langkah 2 dan 3, Anda juga dapat berhenti setelah kinerja tidak meningkat secara signifikan di atas ambang tertentu.
Dalam contoh Anda, Anda akan berhenti pada satu iterasi sehingga selesai dengan algoritma active learning Anda. Anda juga dapat memiliki dataset uji terpisah untuk mengevaluasi pembelajar dan mencatat kinerjanya. Dengan cara ini, Anda dapat melihat bagaimana kinerja pada set uji meningkat atau stagnan seiring penambahan data berlabel.
Salah satu area paling populer dalam active learning adalah natural language processing (NLP). Ini karena banyak aplikasi dalam NLP memerlukan banyak data berlabel (misalnya, Part-of-Speech Tagging, Named Entity Recognition) dan biaya pelabelan data ini sangat tinggi.
Faktanya, hanya ada segelintir dataset di NLP yang tersedia bebas dan berlabel lengkap untuk aplikasi-aplikasi tersebut. Oleh karena itu, menggunakan active learning dapat secara signifikan mengurangi jumlah data berlabel yang dibutuhkan dan jumlah pakar yang diperlukan untuk memberi label secara akurat. Alasan yang sama dapat diterapkan pada banyak tugas pengenalan ucapan dan bahkan tugas seperti penelusuran informasi.
Active learning masih diteliti secara intensif. Banyak orang mulai meneliti penggunaan berbagai algoritma deep learning seperti CNN dan LSTM sebagai pembelajar dan bagaimana meningkatkan efisiensinya saat menggunakan kerangka kerja active learning (Kronrod dan Anandkumar, 2017; Sener dan Savarese, 2017). Ada juga riset tentang penerapan Generative Adversarial Networks (GAN) ke dalam kerangka kerja active learning (Zhu dan Bento, 2017). Seiring meningkatnya minat pada deep reinforcement learning, para peneliti mencoba membingkai ulang active learning sebagai masalah reinforcement learning (Fang dkk., 2017). Selain itu, ada makalah yang mencoba mempelajari strategi active learning melalui pengaturan meta-learning (Fang dkk., 2017).
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



