Cours
Comprendre le Machine Learning
2 h
308.2K
L’apprentissage actif fait partie de ces sujets que l’on croise souvent sans jamais prendre le temps de vraiment les comprendre. Cet article va expliquer la logique derrière l’apprentissage actif, ses avantages et sa place dans la recherche moderne en apprentissage automatique.
Bien maîtrisé, l’apprentissage actif devient un levier puissant lorsqu’on manque de données étiquetées. On peut le voir comme une « méthodologie de conception », à l’image du transfert d’apprentissage, qui permet elle aussi de tirer parti d’un petit volume de données annotées.
Dans un prochain article, vous verrez comment combiner apprentissage actif et transfert d’apprentissage pour exploiter au mieux les données existantes (et à venir).
Plutôt que de commencer par une définition formelle, partons d’un exemple simple pour comprendre pourquoi l’apprentissage actif fonctionne.
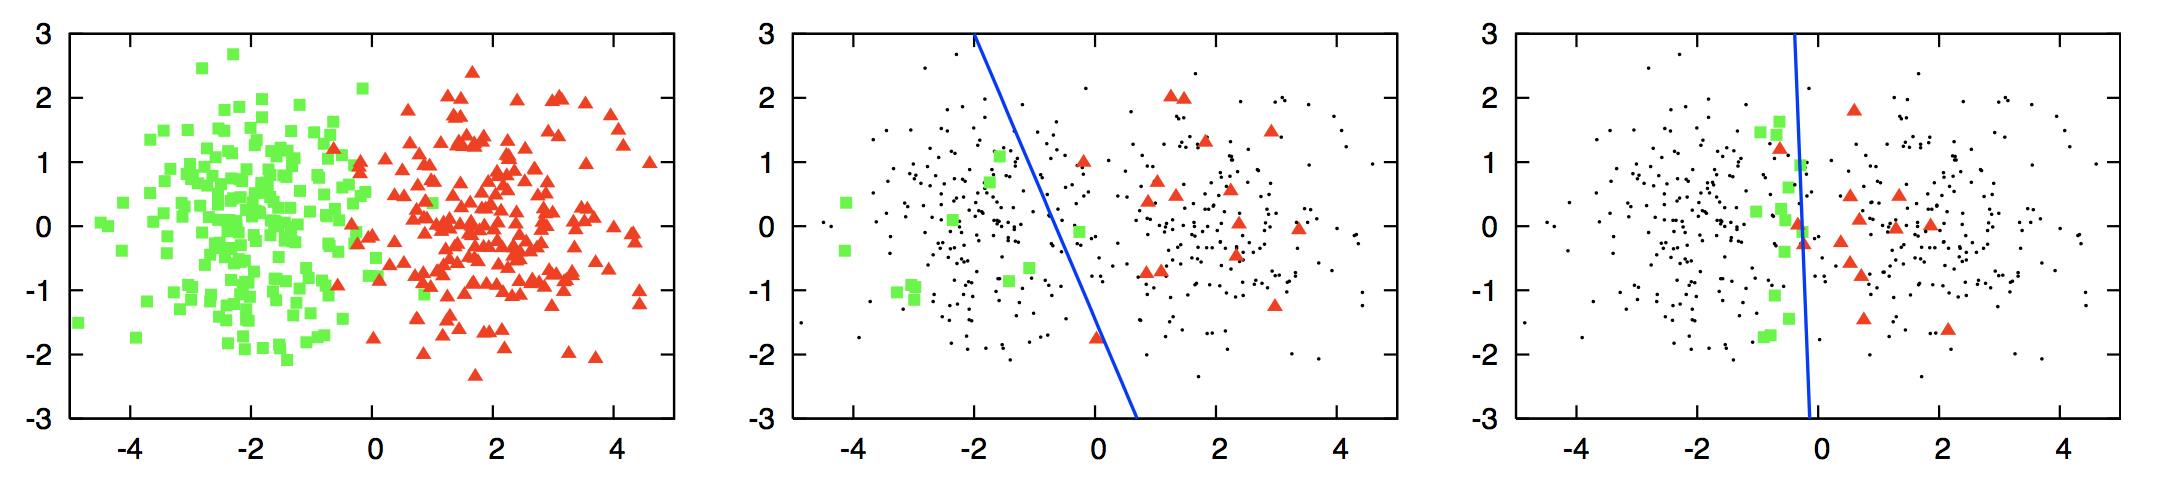
Dans l’image de gauche ci-dessus (tirée de cette synthèse), vous voyez deux amas, en vert et en rouge. Les lecteurs attentifs reconnaîtront une tâche de classification pour laquelle il faut tracer une « frontière de décision » (ici, une simple ligne) séparant les formes vertes des rouges. Supposons toutefois que vous ne connaissiez pas les étiquettes (rouge ou vert) des points, et qu’obtenir ces étiquettes pour chacun soit très coûteux. Vous souhaitez alors échantillonner un petit sous-ensemble de points, obtenir leurs étiquettes et utiliser ces données étiquetées comme jeu d’entraînement pour un classifieur.
Au centre, une régression logistique est entraînée après avoir échantillonné et étiqueté aléatoirement quelques points. La frontière de décision obtenue (la ligne bleue) est sous-optimale : elle est clairement décalée vers les points rouges et empiète sur la zone des formes vertes. De nombreux points verts seront donc mal classés en rouge. Ce biais provient d’un mauvais choix de points à étiqueter. À droite, on utilise à nouveau la régression logistique, mais cette fois les quelques points sont sélectionnés via une méthode de requête d’apprentissage actif. La nouvelle frontière est nettement meilleure, séparant plus efficacement les deux couleurs. Ce gain provient d’une sélection plus judicieuse des points, permettant au classifieur d’apprendre une frontière de décision pertinente.
Comment la méthode de requête a-t-elle identifié de si bons points ? C’est l’un des grands axes de recherche en apprentissage actif. Vous verrez plus loin quelques-unes des approches les plus utilisées pour interroger les points de données.
L’hypothèse centrale de l’apprentissage actif est la suivante : si un algorithme peut choisir les données sur lesquelles il apprend, il peut atteindre de meilleures performances que les méthodes traditionnelles avec beaucoup moins de données annotées.
Mais que recouvrent exactement ces « méthodes traditionnelles » ?
Il s’agit des approches où l’on collecte aléatoirement un grand volume de données issues de la distribution sous-jacente, puis on entraîne un modèle prédictif sur ce vaste jeu. Appelons cette approche apprentissage passif.
L’une des tâches les plus chronophages de l’apprentissage passif est la collecte de données étiquetées. Dans de nombreux contextes, des contraintes fortes limitent l’obtention d’un grand volume d’annotations.
Prenons l’exemple du dépistage du cancer du pancréas. Vous souhaitez prédire si un patient développera ce cancer, mais vous n’avez la possibilité de faire passer des examens approfondis qu’à un petit nombre d’entre eux pour en extraire des caractéristiques, etc. Plutôt que de sélectionner ces patients au hasard, on peut les choisir selon certains critères. Par exemple : consommation d’alcool et âge supérieur à 40 ans. Ces critères peuvent évoluer au fil des résultats. Si vous constatez que votre modèle prédit bien chez les plus de 50 ans mais peine pour les 40–50 ans, cela peut devenir votre nouveau critère.
Le processus de sélection des patients (ou plus généralement des instances) sur la base des données déjà collectées s’appelle apprentissage actif.
En apprentissage actif, trois grands scénarios sont étudiés pour interroger les étiquettes des instances :
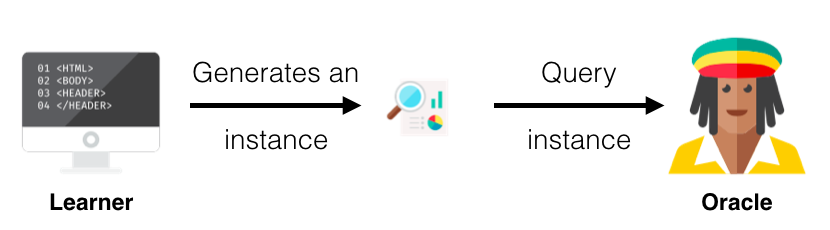
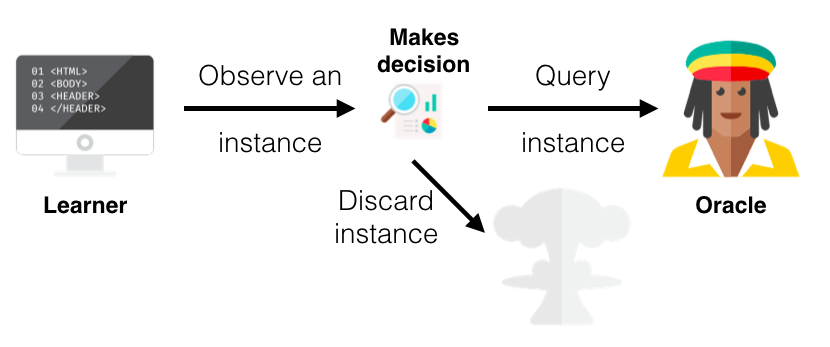
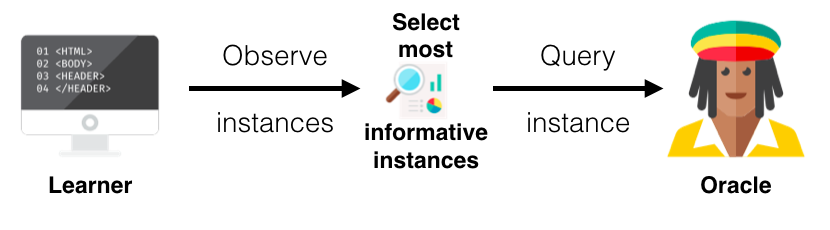
La grande différence entre un apprenant actif et passif tient à sa capacité à interroger des instances en s’appuyant sur l’historique des requêtes et des réponses (les étiquettes). Tous les scénarios d’apprentissage actif nécessitent une mesure d’informativité des instances non étiquetées. Cette section présente trois approches populaires, regroupées sous le terme d’« échantillonnage par incertitude », car elles s’appuient sur des probabilités (pour d’autres stratégies et une vue d’ensemble, voir cette synthèse).
Appuyons-nous sur le tableau ci-dessous : il montre deux instances et les probabilités associées à chaque étiquette. La probabilité que d1 ait les labels A, B, C est respectivement 0,9 ; 0,09 ; 0,01, et pour d2 0,2 ; 0,5 ; 0,3.
| Instances | Label A | Label B | Label C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Moindre confiance (Least Confidence, LC) : on sélectionne l’instance pour laquelle la confiance dans son label le plus probable est la plus faible. Dans le tableau, le modèle est très confiant pour d1 (label A avec une probabilité de 0,9), mais beaucoup moins pour d2 dont les probabilités sont plus réparties et dont le label le plus probable (B) n’atteint que 0,5. Avec LC, on choisit donc d2 pour interroger son étiquette réelle.
Échantillonnage par marge : la limite de LC est de ne considérer que le label le plus probable, en ignorant les autres. L’échantillonnage par marge sélectionne l’instance ayant l’écart le plus faible entre les deux labels les plus probables. Pour d1, la différence entre les deux premières probabilités est 0,81 (0,9 − 0,09), et pour d2 elle est 0,2 (0,5 − 0,3). Le modèle choisira donc encore d2.
Échantillonnage par entropie : pour exploiter l’ensemble des probabilités, on utilise l’entropie. On calcule l’entropie de chaque instance et on interroge celle au score le plus élevé. Dans notre exemple, d1 vaut 0,155 tandis que d2 vaut 0,447 ; on sélectionne donc une fois de plus d2.
Vous avez vu les différentes briques de l’apprentissage actif. Pour clarifier l’enchaînement, parcourons maintenant un exemple complet — très simple.
Cette étape peut sembler triviale, mais il est essentiel que l’échantillon recueilli soit représentatif de la distribution réelle. Autrement dit, évitez autant que possible les jeux de données trop biaisés. En pratique, un échantillon parfaitement représentatif est illusoire en raison de contraintes juridiques, temporelles ou d’accès.
Dans cet exemple, vous disposez de 5 instances. Les caractéristiques A et B représentent des descripteurs potentiels d’un point de donnée. Notez que les données collectées sont non étiquetées.
| Instances | Caractéristique A | Caractéristique B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Il faut maintenant scinder les données en un tout petit jeu que l’on va étiqueter et un grand jeu non étiqueté. En apprentissage actif, ce petit jeu annoté est appelé la « graine ». Il n’existe ni nombre ni pourcentage standard à appliquer. Une fois la graine mise de côté, étiquetez ces instances.
Remarque : dans la littérature, on n’implique généralement pas un oracle ou un expert pour étiqueter ces premières instances. On part souvent d’un jeu entièrement annoté, on en prélève une petite partie comme graine (puisqu’on connaît déjà les étiquettes) et on traite le reste comme s’il était non étiqueté. Quand l’apprenant interroge l’orcale pour une instance, on va simplement lire son étiquette connue.
Dans notre exemple, vous choisissez deux instances pour la graine, d1 et d3. Les étiquettes possibles sont « Y » et « N ».
Jeu graine / étiqueté
| Instances | Caractéristique A | Caractéristique B | Étiquette |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Jeu non étiqueté
| Instances | Caractéristique A | Caractéristique B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
À partir de la graine, entraînez votre apprenant comme dans tout projet de machine learning (validation croisée, etc.). Le choix du modèle dépend du domaine, et l’on privilégie souvent des apprenants fournissant des sorties probabilistes par label, utiles pour les stratégies de requête.
Dans l’exemple, vous pouvez utiliser le classifieur de votre choix et l’entraîner sur vos deux instances étiquetées.
Une fois le modèle entraîné, vous êtes prêt à sélectionner une ou plusieurs instances à interroger. Il faut déterminer le scénario (génération de requêtes, flux sélectif, ou bassin) ainsi que la stratégie de requête.
Nous utiliserons l’échantillonnage par bassin, avec un lot (batch) de 2. À chaque itération, vous sélectionnez donc deux instances du jeu non étiqueté, puis vous les ajoutez au jeu étiqueté. La stratégie retenue est la moindre confiance. Votre modèle choisit d2 et d4, dont les étiquettes obtenues sont respectivement « Y » et « N ».
Jeu étiqueté
| Instances | Caractéristique A | Caractéristique B | Étiquette |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Jeu non étiqueté
| Instances | Caractéristique A | Caractéristique B |
|---|---|---|
| d5 | 5 | 5 |
Répétez les étapes 2 et 3 jusqu’à satisfaire un critère d’arrêt. Concrètement, après mise à jour du jeu étiqueté, on réentraîne l’apprenant puis on sélectionne de nouvelles instances à interroger. Le critère peut être un nombre maximal d’instances annotées, un nombre d’itérations, ou l’absence d’amélioration significative au-delà d’un seuil.
Dans notre exemple, on s’arrête après une itération : l’algorithme d’apprentissage actif est terminé. Vous pouvez également disposer d’un jeu de test séparé pour évaluer le modèle et suivre l’évolution des performances au fur et à mesure que vous ajoutez des données étiquetées.
L’un des domaines phares d’application est le traitement automatique du langage (NLP). De nombreuses tâches en NLP exigent d’importants volumes de données étiquetées (par exemple, l’étiquetage morpho-syntaxique ou la reconnaissance d’entités nommées), et le coût d’annotation est très élevé.
En réalité, peu de jeux de données NLP entièrement annotés et libres existent pour ces usages. L’apprentissage actif peut donc réduire sensiblement le volume d’annotations nécessaires et le recours à des experts. Le même raisonnement s’applique à de nombreuses tâches de reconnaissance vocale et à des cas comme la recherche d’information.
L’apprentissage actif reste un champ de recherche très actif. De nombreux travaux explorent l’usage d’algorithmes de deep learning comme les CNN et les LSTM comme apprenants, et comment améliorer leur efficacité dans ces cadres (Kronrod and Anandkumar, 2017 ; Sener and Savarese, 2017). D’autres intègrent des Generative Adversarial Networks (GAN) au cadre d’apprentissage actif (Zhu and Bento, 2017). Avec l’essor de l’apprentissage par renforcement profond, des chercheurs reformulent l’apprentissage actif comme un problème de renforcement (Fang et. al, 2017). On trouve aussi des travaux qui apprennent des stratégies d’apprentissage actif via du méta-apprentissage (Fang et. al, 2017).
Pour aller plus loin en machine learning
Cours
Cours
Cours