Curso
Comprender el machine learning
2 h
308K
El active learning es uno de esos temas de los que oyes hablar, pero para los que nunca sacas tiempo de entender a fondo. En la entrada de hoy te explicamos el razonamiento detrás del active learning, sus beneficios y cómo encaja en la investigación moderna de machine learning.
Saber utilizar bien el active learning te da una herramienta potentísima cuando hay escasez de datos etiquetados. Puedes verlo como un tipo de "metodología de diseño", similar al transfer learning, que también permite aprovechar pequeñas cantidades de datos etiquetados.
En un próximo post, aprenderás cómo combinar active learning y transfer learning para exprimir al máximo los datos existentes (y los nuevos).
En lugar de empezar con una definición formal, es mejor ver un ejemplo sencillo para entender por qué funciona el active learning.
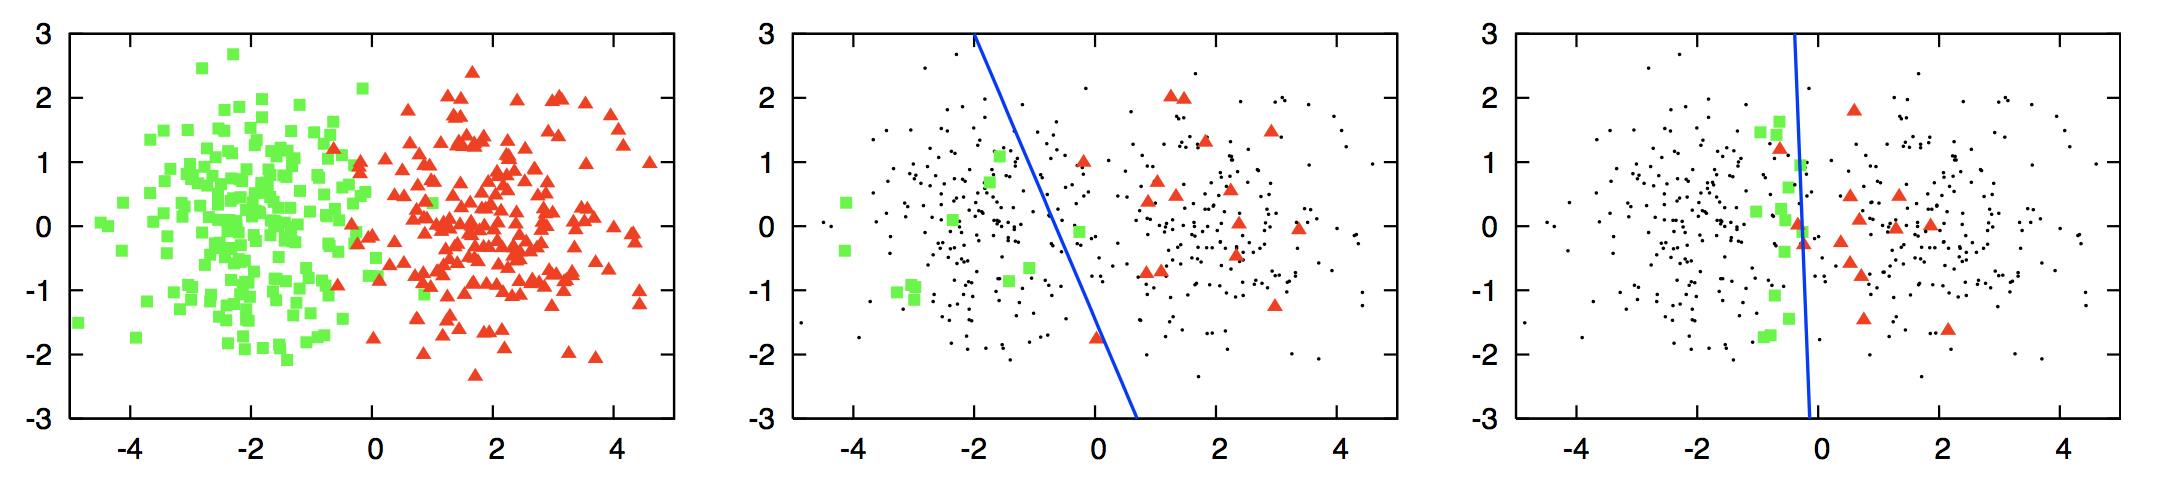
En la imagen de la izquierda (tomada de este estudio), hay dos grupos: puntos verdes y puntos rojos. Es un problema de clasificación y queremos una "frontera de decisión" (aquí, una línea) que separe las figuras verdes de las rojas. Pero no conocemos las etiquetas (rojo o verde) de los puntos y obtenerlas para todos sería muy costoso. Así que queremos muestrear un subconjunto pequeño, averiguar sus etiquetas y usar esos puntos etiquetados como datos de entrenamiento para un clasificador.
En la imagen central, se usa regresión logística tras muestrear y etiquetar aleatoriamente unos pocos puntos. La frontera resultante (línea azul) es subóptima: está sesgada hacia los rojos e invade la zona de los verdes, así que muchos verdes se clasificarán mal como rojos. Este sesgo se debe a una mala selección de puntos para etiquetar. En la imagen de la derecha, volvemos a usar regresión logística, pero ahora elegimos un subconjunto pequeño con un método de consulta de active learning. La nueva frontera es mucho mejor porque separa mejor ambos colores. La mejora viene de seleccionar mejores puntos para que el clasificador pueda trazar una frontera de decisión sólida.
Cómo ese método de consulta logró escoger puntos tan buenos es una de las grandes líneas de investigación en active learning. Más abajo verás algunos de los métodos más populares para consultar puntos.
La hipótesis principal del active learning es que, si un algoritmo puede elegir de qué datos quiere aprender, puede rendir mejor que los métodos tradicionales con sustancialmente menos datos de entrenamiento.
¿Y cuáles son exactamente esos métodos tradicionales?
Son tareas que consisten en recopilar una gran cantidad de datos muestreados aleatoriamente de la distribución subyacente y usar ese gran conjunto para entrenar un modelo que haga predicciones. A este enfoque típico lo llamaremos aprendizaje pasivo.
Una de las tareas más laboriosas del aprendizaje pasivo es recopilar datos etiquetados. En muchos contextos, hay factores que dificultan reunir grandes volúmenes de datos con etiqueta.
Pensemos en el estudio del cáncer de páncreas. Quieres predecir si una persona podría desarrollarlo, pero quizá solo puedes someter a un pequeño número de pacientes a pruebas adicionales para recoger variables, etc. En ese caso, en lugar de seleccionar pacientes al azar, puedes elegirlos según ciertos criterios. Por ejemplo, que consuman alcohol y tengan más de 40 años. Ese criterio no tiene por qué ser fijo: puede cambiar según los resultados previos. Si descubres que tu modelo predice bien en mayores de 50, pero falla más entre 40 y 50, ese podría ser tu nuevo criterio.
El proceso de seleccionar esos pacientes (o instancias, en general) en función de los datos recopilados hasta el momento se llama active learning.
En active learning, suele haber tres escenarios o configuraciones en los que el aprendiz consulta las etiquetas de las instancias. Los más estudiados en la literatura son:
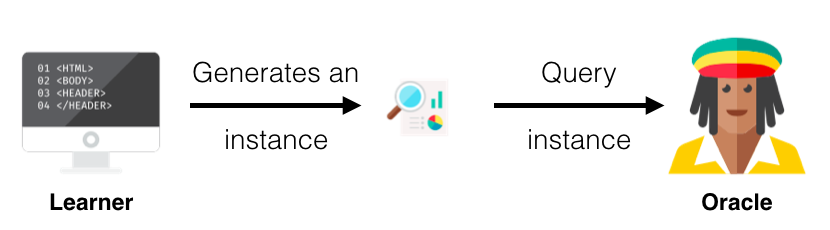
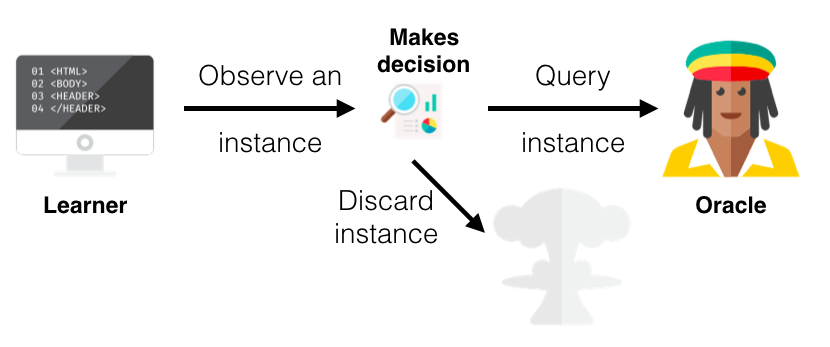
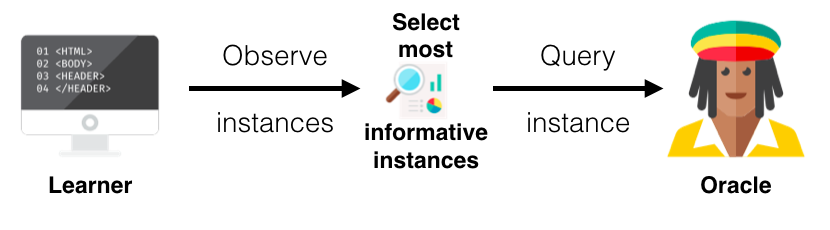
La gran diferencia entre un aprendiz activo y uno pasivo es su capacidad para consultar instancias basándose en consultas previas y las respuestas (etiquetas) obtenidas. Como has visto, todos los escenarios de active learning requieren alguna medida de informatividad sobre las instancias sin etiqueta. En esta sección explico tres enfoques populares bajo el paraguas de uncertainty sampling, ya que se apoyan en probabilidades (para más estrategias y detalle, recomiendo este artículo de revisión).
Usaré la siguiente tabla para ilustrarlas. Muestra dos instancias y las probabilidades de cada etiqueta. Para d1, las probabilidades de las etiquetas A, B y C son 0,9, 0,09 y 0,01 respectivamente; y para d2, 0,2, 0,5 y 0,3.
| Instancias | Etiqueta A | Etiqueta B | Etiqueta C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least confidence (LC): el aprendiz elige la instancia en la que tiene menor confianza en su etiqueta más probable. En la tabla, está bastante seguro de d1 (probabilidad 0,9 de A), pero menos de d2, cuyas probabilidades están más repartidas y su etiqueta más probable (B) solo alcanza 0,5. Con least confidence, elegiría d2 para consultar su etiqueta real.
Margin sampling: la debilidad del método LC es que solo considera la etiqueta más probable e ignora el resto. Margin sampling lo corrige eligiendo la instancia con la menor diferencia entre la primera y la segunda etiquetas más probables. En d1, la diferencia es 0,81 (0,9 - 0,09) y en d2 es 0,2 (0,5 - 0,3). De nuevo, se seleccionaría d2.
Entropy sampling: para aprovechar todas las probabilidades, se usa la entropía. Se calcula para cada instancia y se consulta la de mayor valor. En el ejemplo, d1 tiene 0,155 y d2 0,447, así que el aprendiz volvería a escoger d2.
Hasta ahora hemos visto las piezas que componen el active learning. Puede parecer lioso unir todos los pasos, pero en esta sección recorrerás un ejemplo completo —aunque muy sencillo—.
Parece trivial, pero es clave que el conjunto que reúnas sea representativo de la distribución real. Es decir, intenta evitar sesgos fuertes. En la práctica, es imposible tener una muestra perfectamente representativa por limitaciones legales, de tiempo o de disponibilidad.
En este ejemplo, partimos de 5 instancias. Feature A y Feature B representan características de cada punto. Importante: los datos que reunimos no están etiquetados.
| Instancias | Feature A | Feature B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
A continuación, divide los datos en un conjunto muy pequeño que vas a etiquetar y un conjunto grande sin etiquetas. En la jerga de active learning, ese pequeño conjunto etiquetado es la seed. No hay un número o porcentaje fijo. Una vez apartado, etiqueta esas instancias.
Nota: en gran parte de la literatura, no se usa un oráculo o experto para etiquetar estas instancias. Suele partirse de un dataset ya etiquetado, se toma una pequeña parte como seed (ya tienen etiqueta) y se trata el resto como si no la tuviera. Cuando el aprendiz selecciona una instancia para consultarla al orcale, simplemente se mira su etiqueta en el dataset.
En el ejemplo, eliges dos instancias para la seed, d1 y d3. Las etiquetas posibles son "Y" y "N".
Seed/conjunto etiquetado
| Instancias | Feature A | Feature B | Etiqueta |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Conjunto sin etiquetar
| Instancias | Feature A | Feature B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Con los datos divididos, usa la seed para entrenar el aprendiz como en cualquier proyecto de machine learning (con validación cruzada, etc.). El tipo de modelo dependerá del dominio y, en general, interesa usar aprendices que devuelvan probabilidades sobre las etiquetas, ya que las usaremos en las estrategias de consulta.
En el ejemplo, puedes usar el clasificador que quieras y entrenarlo con las dos instancias etiquetadas.
Una vez entrenado el aprendiz, ya puedes seleccionar las instancias a consultar. Tienes que decidir el escenario (Membership Query Synthesis, Stream-based selective sampling o Pool-based sampling) y la estrategia de consulta.
Usaremos pool-based sampling con un tamaño de lote de 2. Es decir, en cada iteración seleccionas dos instancias del conjunto sin etiquetar y las añades al conjunto etiquetado. Usas least confidence para elegir. El aprendiz selecciona d2 y d4, cuyas etiquetas consultadas son "Y" y "N", respectivamente.
Conjunto etiquetado
| Instancias | Feature A | Feature B | Etiqueta |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Conjunto sin etiquetar
| Instancias | Feature A | Feature B |
|---|---|---|
| d5 | 5 | 5 |
Ahora puedes repetir los pasos 2 y 3 hasta cumplir un criterio de parada. Es decir, con el nuevo conjunto etiquetado reentrenas el aprendiz y vuelves a seleccionar datos sin etiqueta para consultar. Un criterio puede ser el número de instancias consultadas, otro el número de iteraciones, o parar cuando el rendimiento deje de mejorar por encima de un umbral.
En el ejemplo, paramos tras una iteración y damos por terminado el algoritmo de active learning. También puedes tener un conjunto de test independiente para evaluar el aprendiz y registrar su rendimiento. Así verás si mejora o se estanca al añadir datos etiquetados.
Uno de los campos más populares es el procesamiento de lenguaje natural (NLP). Muchas tareas de NLP requieren grandes volúmenes de datos etiquetados (por ejemplo, etiquetado gramatical o reconocimiento de entidades) y etiquetar es muy costoso.
De hecho, hay pocos datasets en NLP que estén completamente etiquetados y sean de libre acceso. Por eso, usar active learning puede reducir de forma significativa la cantidad de datos etiquetados y de expertos necesarios. El mismo razonamiento aplica a reconocimiento de voz e incluso a tareas como la recuperación de información.
El active learning sigue siendo un área muy activa. Se está investigando su aplicación con distintos algoritmos de deep learning como CNNs y LSTMs como aprendices y cómo mejorar su eficiencia en estos marcos (Kronrod y Anandkumar, 2017; Sener y Savarese, 2017). También hay trabajos que incorporan Generative Adversarial Networks (GANs) al framework de active learning (Zhu y Bento, 2017). Con el auge del aprendizaje por refuerzo profundo, se intenta replantear el active learning como un problema de refuerzo (Fang et al., 2017). Además, hay artículos que buscan aprender estrategias de active learning mediante meta-learning (Fang et al., 2017).
Aprende más sobre machine learning
Curso
Curso
Curso
blog
DataCamp Team
11 min
blog
Zoumana Keita
14 min
blog
Moez Ali
8 min
blog
Kurtis Pykes
9 min
Tutorial
Zoumana Keita
12 min
Tutorial
DataCamp Team
15 min