Curso
Entendendo Machine Learning
2 h
308K
Active learning é um daqueles temas que a gente ouve por aí, mas raramente tem tempo para entender de verdade. No post de hoje, vamos explicar a lógica por trás do active learning, seus benefícios e como ele se encaixa na pesquisa moderna de machine learning.
Usar bem o active learning coloca na sua mão uma ferramenta poderosa para quando há escassez de dados rotulados. Você pode encarar o active learning como um tipo de "metodologia de design", semelhante ao transfer learning, que também ajuda a aproveitar pequenas quantidades de dados com rótulo.
No próximo post, você vai ver como combinar active learning com transfer learning para aproveitar ao máximo dados existentes (e novos).
Em vez de começar com uma definição formal de active learning, é melhor partir de um exemplo simples para entender por que essa abordagem funciona.
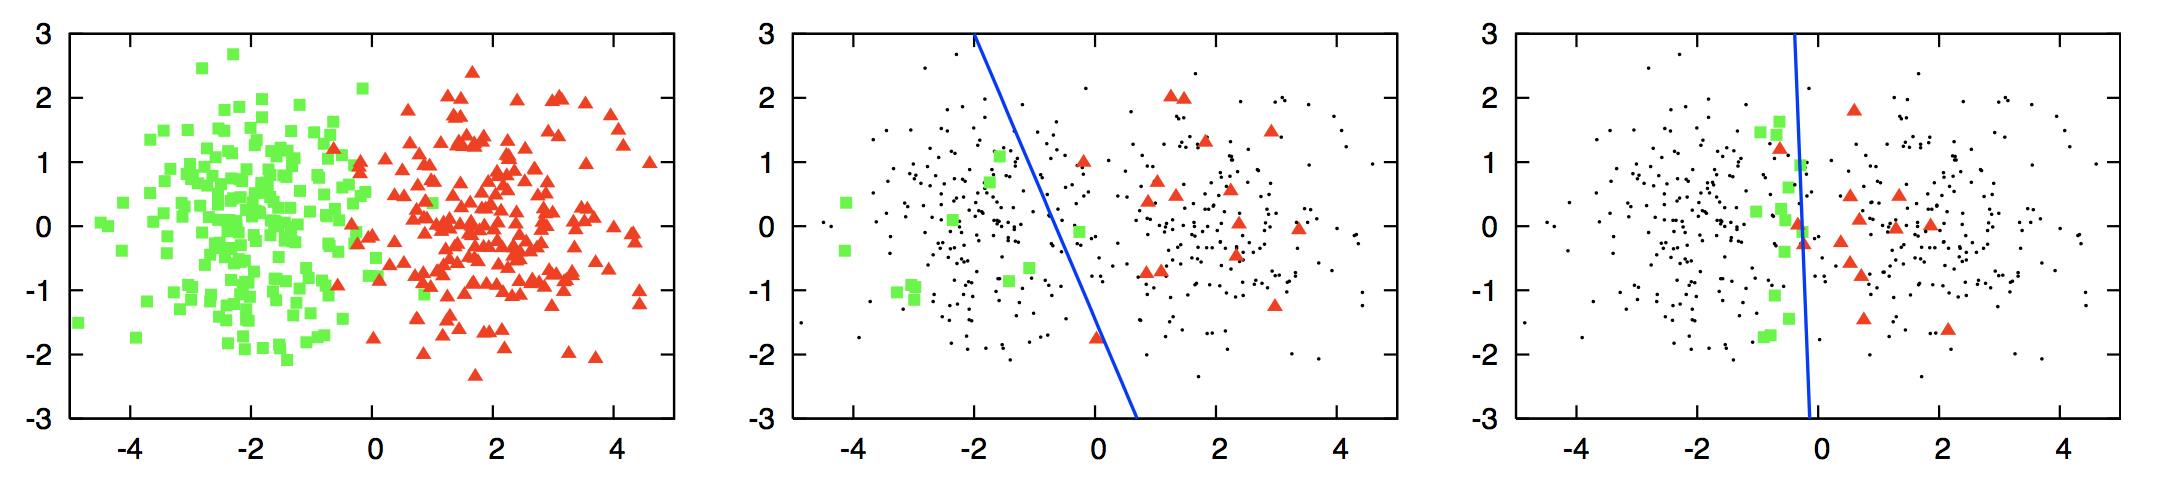
Observando a figura mais à esquerda (retirada desta survey), temos dois aglomerados: um verde e outro vermelho. Quem já tem prática percebe que isso é uma tarefa de classificação e que queremos criar uma "fronteira de decisão" (aqui, apenas uma linha) que separe as formas verdes das vermelhas. Porém, vamos supor que você não conhece os rótulos (vermelho ou verde) dos pontos de dados e que rotular cada um deles seria muito caro. Assim, você preferiria amostrar um subconjunto pequeno de pontos, descobrir seus rótulos e usar esses dados rotulados como treino para um classificador.
Na imagem do meio, foi usada regressão logística para classificar as formas a partir de uma amostra aleatória pequena de pontos que foram rotulados. Só que a fronteira de decisão criada (a linha azul) ficou aquém do ideal. Ela pende para longe dos pontos vermelhos e invade a região verde. Isso significa que muitos pontos verdes serão rotulados incorretamente como vermelhos. Esse desvio acontece por causa da seleção ruim de pontos para rotular. Na imagem da direita, a regressão logística é usada de novo, mas desta vez você seleciona um pequeno subconjunto de pontos com um método de consulta de active learning. A nova fronteira de decisão fica bem melhor, separando de forma mais adequada as duas cores. Essa melhoria vem da escolha de pontos mais informativos, que permite ao classificador traçar uma fronteira de decisão muito boa.
Como o método de consulta do active learning consegue selecionar pontos tão bons é um dos grandes temas de pesquisa na área. Mais adiante, você vai conhecer alguns dos métodos mais populares para consultar pontos de dados.
A hipótese central do active learning é: se um algoritmo de aprendizado pode escolher de quais dados quer aprender, ele pode ter um desempenho melhor do que métodos tradicionais usando substancialmente menos dados de treino.
Mas o que seriam exatamente esses métodos tradicionais?
São tarefas em que coletamos uma grande quantidade de dados amostrados aleatoriamente da distribuição subjacente e usamos esse conjunto para treinar um modelo que faça algum tipo de predição. Vamos chamar esse método típico de passive learning.
Uma das etapas mais demoradas no passive learning é coletar dados rotulados. Em muitos contextos, há fatores limitantes que dificultam reunir grandes volumes de dados com rótulo.
Pense no exemplo do estudo de câncer de pâncreas. Você pode querer prever se um paciente terá a doença, mas talvez só consiga submeter um número pequeno de pacientes a exames adicionais para coletar variáveis, etc. Nesse caso, em vez de escolher pacientes aleatoriamente, podemos selecioná-los com base em certos critérios. Um critério de exemplo poderia ser: paciente que consome álcool e tem mais de 40 anos. Esse critério não precisa ser fixo — ele pode mudar conforme os resultados anteriores. Por exemplo, se você perceber que o modelo está indo bem para pacientes com mais de 50 anos, mas tem dificuldade entre 40 e 50, esse pode se tornar o novo critério.
O processo de selecionar esses pacientes (ou, de forma mais geral, instâncias) com base nos dados já coletados é chamado de active learning.
No active learning, há três cenários (ou configurações) típicos em que o aprendiz consulta os rótulos das instâncias. Os três principais, discutidos na literatura, são:
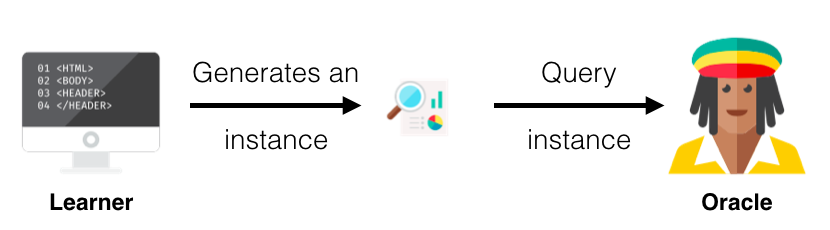
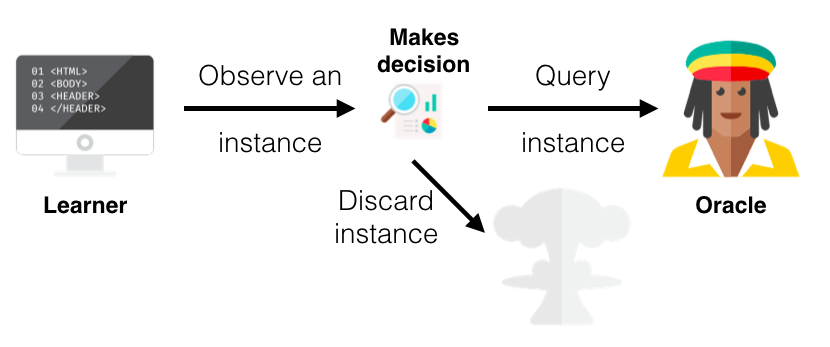
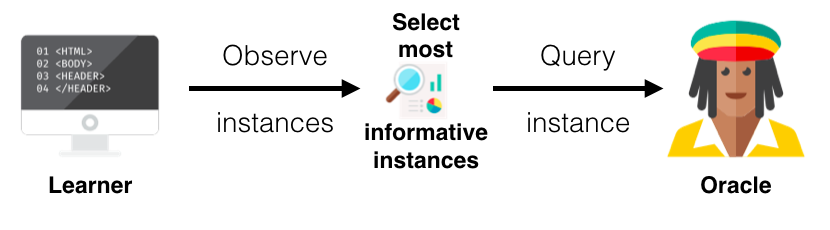
A principal diferença entre um aprendiz ativo e um passivo é a capacidade de consultar instâncias com base nas consultas anteriores e nas respostas (rótulos) recebidas. Como vimos, todos os cenários de active learning exigem alguma medida de informatibilidade das instâncias não rotuladas. Nesta seção, explico três abordagens populares de consulta sob o guarda-chuva do chamado uncertainty sampling, que usa probabilidades (para mais estratégias e detalhes sobre active learning em geral, recomendo esta survey).
Vou usar a tabela abaixo para explicar as estratégias. Ela mostra dois pontos de dados (instâncias) e as probabilidades de cada rótulo para cada instância. A probabilidade de d1 ter rótulo A, B e C é 0,9, 0,09 e 0,01, respectivamente; para d2 é 0,2, 0,5 e 0,3.
| Instâncias | Rótulo A | Rótulo B | Rótulo C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least Confidence (LC): aqui, o aprendiz escolhe a instância em que tem menos confiança no rótulo mais provável. Pela tabela, ele está bem confiante em d1, já que acha que o rótulo A tem probabilidade 0,9. Já em d2, as probabilidades são mais espalhadas, e o rótulo mais provável (B) tem só 0,5. Portanto, com least confidence, o aprendiz escolheria d2 para consultar o rótulo verdadeiro.
Margin sampling: a limitação do LC é considerar apenas o rótulo mais provável e ignorar os demais. O margin sampling contorna isso ao selecionar a instância com a menor diferença entre os dois rótulos mais prováveis. Em d1, a diferença entre o primeiro e o segundo rótulos mais prováveis é 0,81 (0,9 - 0,09); em d2 é 0,2 (0,5 - 0,3). Logo, o aprendiz escolheria d2 novamente.
Entropy sampling: para considerar todas as probabilidades, usamos a entropia. Calculamos a entropia de cada instância e consultamos aquela com maior valor. No exemplo, d1 tem 0,155 e d2 tem 0,447, então o aprendiz escolheria d2 mais uma vez.
Até aqui, você viu os componentes que formam o active learning. Pode parecer confuso montar o passo a passo, então vamos passar por um exemplo completo — bem simples, mas funcional.
Pode parecer trivial, mas é importante garantir que o conjunto coletado represente bem a distribuição real dos dados. Em outras palavras, evite amostras muito enviesadas. Na prática, é impossível ter uma amostra totalmente representativa por limitações legais, de tempo ou de disponibilidade.
Neste exemplo, teremos os 5 pontos abaixo. Atributo A e Atributo B representam características de cada ponto. Importante: os dados coletados não estão rotulados.
| Instâncias | Atributo A | Atributo B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Agora, precisamos dividir os dados em um conjunto bem pequeno que vamos rotular e um conjunto grande não rotulado. Em active learning, chamamos o pequeno conjunto rotulado de seed. Não há um número ou porcentagem fixa de dados para a seed. Depois de separar os dados da seed, rotule-os.
Observação: na maioria dos estudos, os pesquisadores não usam um oráculo ou especialista para rotular essas instâncias em tempo real. Normalmente, eles partem de um dataset totalmente rotulado, usam uma pequena parte como seed (já que o rótulo existe) e tratam o restante como se não tivesse rótulo. Quando o aprendiz seleciona uma instância para consultar o orcale, eles simplesmente buscam o rótulo correspondente.
Seguindo o exemplo, você escolhe duas instâncias para a seed, d1 e d3. Os rótulos possíveis aqui são "Y" e "N".
Seed/conjunto rotulado
| Instâncias | Atributo A | Atributo B | Rótulo |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Conjunto não rotulado
| Instâncias | Atributo A | Atributo B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Depois da divisão, use a seed para treinar o aprendiz como em qualquer projeto de machine learning (com validação cruzada etc.). O tipo de aprendiz depende do seu conhecimento de domínio e, em geral, preferimos modelos que retornem probabilidades de rótulo, já que usamos essas probabilidades nas estratégias de consulta.
No exemplo, você pode usar qualquer classificador e treiná-lo nas duas instâncias rotuladas.
Com o aprendiz treinado, você está pronto para selecionar instâncias a consultar. Defina o cenário (Membership Query Synthesis, Stream-based selective sampling ou Pool-based sampling) e a estratégia de consulta.
Vamos usar pool-based sampling com tamanho de lote 2. Isso significa que, a cada iteração, você seleciona duas instâncias do conjunto não rotulado e as adiciona ao conjunto rotulado. Usaremos least confidence para selecionar. O aprendiz escolhe d2 e d4, cujos rótulos consultados são "Y" e "N", respectivamente.
Conjunto rotulado
| Instâncias | Atributo A | Atributo B | Rótulo |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Conjunto não rotulado
| Instâncias | Atributo A | Atributo B |
|---|---|---|
| d5 | 5 | 5 |
Agora, repita os passos 2 e 3 até atender a um critério de parada. Ou seja, com o novo conjunto rotulado, reentreine o aprendiz e selecione mais dados não rotulados para consultar. Um critério pode ser o número total de instâncias consultadas; outro, o número de iterações dos passos 2 e 3; você também pode parar quando o desempenho não melhorar acima de um certo limiar.
No nosso exemplo, vamos parar após uma iteração — e pronto, terminamos o algoritmo de active learning. Você também pode ter um conjunto de teste separado para avaliar o aprendiz e registrar o desempenho. Assim, dá para ver como o resultado no teste melhora (ou estagna) conforme adiciona dados rotulados.
Uma das áreas mais populares é o processamento de linguagem natural (NLP). Muitos casos em NLP exigem bastante dado rotulado (por exemplo, Part-of-Speech Tagging e Named Entity Recognition), e o custo de rotulagem é alto.
Na prática, há poucos datasets em NLP que são livres e totalmente anotados para essas aplicações. Por isso, usar active learning pode reduzir bastante a quantidade de dados rotulados e de especialistas necessários para rotular com precisão. A mesma lógica vale para várias tarefas de reconhecimento de fala e até para recuperação de informação.
Active learning continua sendo muito pesquisado. Muita gente tem explorado usar diferentes algoritmos de deep learning, como CNNs e LSTMs, como aprendizes e como aumentar sua eficiência em frameworks de active learning (Kronrod e Anandkumar, 2017; Sener e Savarese, 2017). Há também pesquisas sobre como incorporar Generative Adversarial Networks (GANs) ao framework de active learning (Zhu e Bento, 2017). Com o interesse crescente em deep reinforcement learning, pesquisadores têm reformulado o active learning como um problema de aprendizado por reforço (Fang et al., 2017). Além disso, há trabalhos que tentam aprender estratégias de active learning via meta-learning (Fang et al., 2017).
Saiba mais sobre machine learning
Curso
Curso
Curso
blog
DataCamp Team
11 min
blog
Kurtis Pykes
9 min
blog
Abid Ali Awan
5 min
blog
Javier Canales Luna
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Zoumana Keita
12 min