Kurs
Machine Learning verstehen
2 Std.
308.8K
Active Learning ist eines dieser Themen, das man immer wieder aufgreift, aber nie so richtig bis zum Ende durchdringt. In diesem Beitrag erfährst du, warum Active Learning funktioniert, welche Vorteile es bietet und wie es in die moderne Machine-Learning-Forschung passt.
Wenn du Active Learning richtig einsetzt, hast du ein mächtiges Werkzeug an der Hand – besonders dann, wenn es an gelabelten Daten mangelt. Active Learning lässt sich als eine Art „Designmethodik“ verstehen, ähnlich wie Transfer Learning, mit der sich auch kleine Mengen gelabelter Daten optimal nutzen lassen.
Im nächsten Beitrag lernst du, wie du Active Learning mit Transfer Learning kombinierst, um vorhandene (und neue) Daten bestmöglich zu verwerten.
Statt mit einer formalen Definition zu starten, ist ein einfaches Beispiel oft hilfreicher, um zu verstehen, warum Active Learning wirkt.
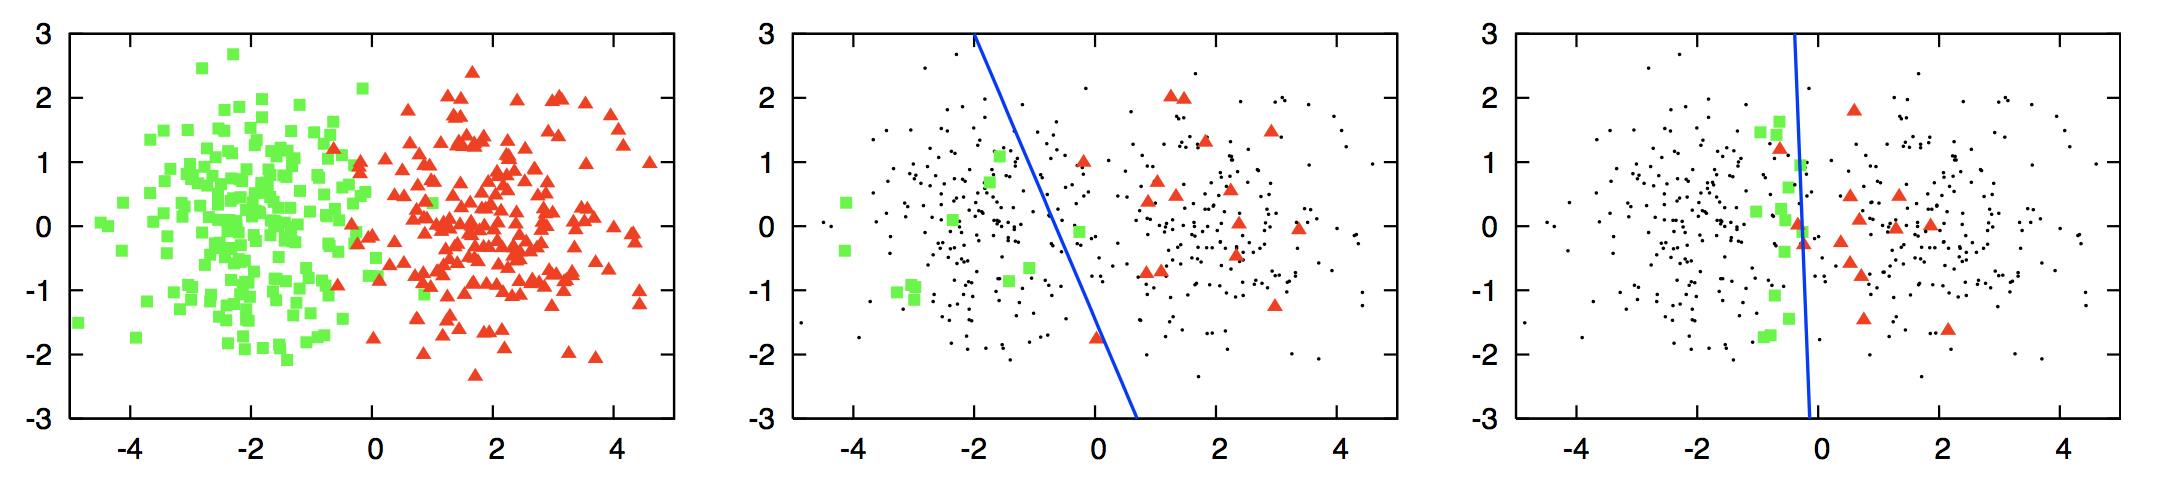
Im linken Bild oben (aus diesem Survey) siehst du zwei Cluster: grüne und rote Punkte. Klar ist: Es handelt sich um eine Klassifikationsaufgabe, und du möchtest eine Entscheidungsgrenze (hier: eine Linie) finden, die die grünen von den roten Formen trennt. Du kennst jedoch die Labels (rot oder grün) der Datenpunkte nicht, und das Labeln aller Punkte wäre sehr teuer. Also möchtest du eine kleine Teilmenge ziehen, deren Labels bestimmen und diese gelabelten Punkte als Trainingsdaten für einen Klassifikator nutzen.
Im mittleren Bild wird mit logistischer Regression gearbeitet. Zunächst wird zufällig eine kleine Teilmenge gelabelt. Die resultierende Entscheidungsgrenze (die blaue Linie) ist jedoch suboptimal: Sie ist klar zu den roten Punkten hin verschoben und schneidet in den grünen Bereich hinein. Das führt dazu, dass viele grüne Punkte fälschlich als rot klassifiziert werden. Der Grund ist die ungünstige Auswahl der zu labelnden Punkte. Im rechten Bild kommt wieder logistische Regression zum Einsatz, aber diesmal wurde die kleine Punktmenge per Active-Learning-Abfrageverfahren ausgewählt. Die neue Entscheidungsgrenze trennt die Farben deutlich besser. Der Zugewinn entsteht durch die überlegene Auswahl der Datenpunkte, wodurch der Klassifikator eine gute Entscheidungsgrenze lernen konnte.
Wie das Active-Learning-Abfrageverfahren solche guten Punkte auswählt, ist eines der zentralen Forschungsthemen. Später lernst du gängige Methoden kennen, um Datenpunkte zu „queryen“.
Die Kernhypothese von Active Learning lautet: Wenn ein Lernalgorithmus die Daten auswählen kann, aus denen er lernt, erreicht er mit deutlich weniger Trainingsdaten eine bessere Performance als herkömmliche Methoden.
Was sind diese herkömmlichen Methoden genau?
Gemeint sind Ansätze, bei denen man viele Daten zufällig aus der zugrunde liegenden Verteilung sammelt und damit ein Modell trainiert, das Vorhersagen trifft. Diesen typischen Ansatz nennst du passives Lernen.
Einer der zeitintensivsten Schritte im passiven Lernen ist das Sammeln gelabelter Daten. In vielen Szenarien gibt es Hürden, die das Zusammenstellen großer gelabelter Datensätze erschweren.
Nehmen wir das Beispiel Bauchspeicheldrüsenkrebs. Du möchtest vorhersagen, ob eine Person erkrankt, hast aber nur die Möglichkeit, eine kleine Anzahl von Patientinnen und Patienten weitergehend zu untersuchen, um Merkmale zu erheben. Statt Patientinnen und Patienten zufällig auszuwählen, kannst du sie anhand bestimmter Kriterien auswählen. Ein mögliches Kriterium: Alkoholkonsum und über 40 Jahre. Diese Kriterien müssen nicht statisch sein – sie können sich basierend auf bisherigen Ergebnissen ändern. Wenn dein Modell zum Beispiel bei Personen über 50 gut funktioniert, aber bei 40–50 Schwierigkeiten hat, könnte das dein neues Kriterium werden.
Der Prozess, Instanzen (hier: Patientinnen und Patienten) auf Basis der bisher gesammelten Daten auszuwählen, heißt Active Learning.
Im Active Learning gibt es in der Regel drei Szenarien, in denen der Lerner die Labels von Instanzen abfragt. Die Literatur unterscheidet:
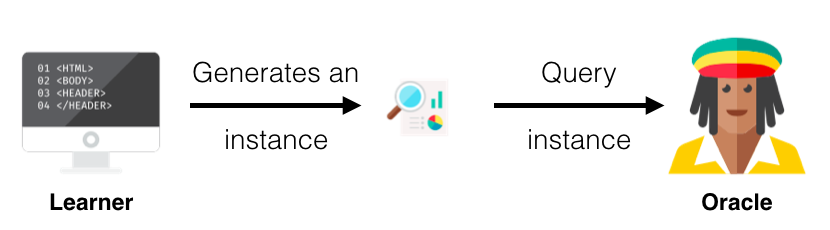
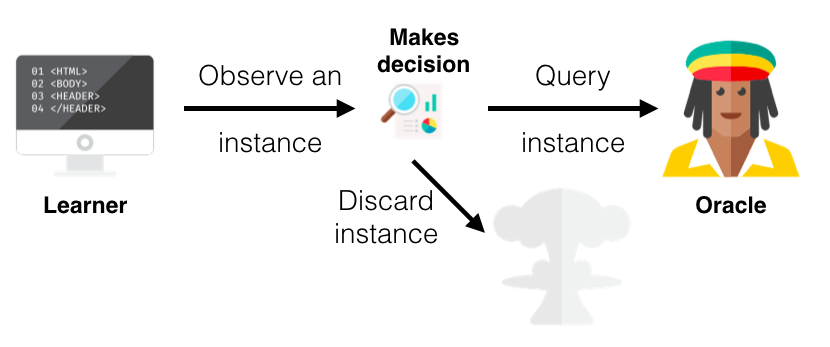
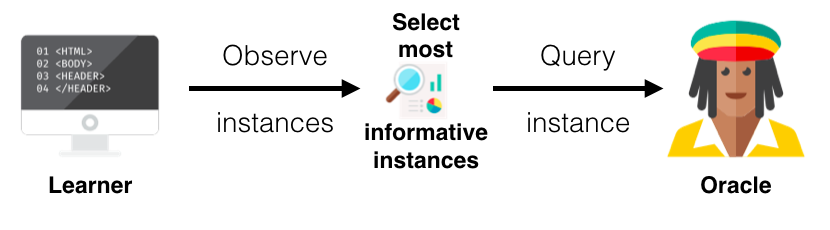
Der zentrale Unterschied zwischen aktivem und passivem Lernen ist die Fähigkeit, Instanzen basierend auf früheren Abfragen und deren Antworten (Labels) gezielt auszuwählen. Wie erwähnt, brauchen alle Active-Learning-Szenarien ein Maß für die Nützlichkeit ungelabelter Instanzen. In diesem Abschnitt erkläre ich drei beliebte Ansätze unter dem Oberbegriff Uncertainty Sampling, das mit Wahrscheinlichkeiten arbeitet (für weitere Strategien und mehr Tiefe empfehle ich dieses Survey-Paper).
Zur Veranschaulichung dient die Tabelle unten. Sie zeigt zwei Instanzen und die Wahrscheinlichkeiten für die Labels A, B und C. Für d1 sind es 0,9, 0,09 und 0,01; für d2 0,2, 0,5 und 0,3.
| Instanzen | Label A | Label B | Label C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Least Confidence (LC): Der Lerner wählt die Instanz, bei der er sich beim wahrscheinlichsten Label am wenigsten sicher ist. Bei d1 ist er mit p=0,9 recht sicher, dass A passt. Bei d2 sind die Wahrscheinlichkeiten verteilter; B liegt nur bei 0,5. Mit LC würde der Lerner daher d2 auswählen und dessen echtes Label abfragen.
Margin Sampling: LC betrachtet nur das wahrscheinlichste Label und ignoriert den Rest. Margin Sampling behebt das, indem es die Instanz mit dem kleinsten Abstand zwischen dem erst- und dem zweitwahrscheinlichsten Label wählt. Bei d1 beträgt der Abstand 0,81 (0,9 − 0,09), bei d2 0,2 (0,5 − 0,3). Also wird erneut d2 gewählt.
Entropy Sampling: Um alle Labelwahrscheinlichkeiten zu berücksichtigen, nutzt man die Entropie als Maß. Die Entropie wird für jede Instanz berechnet; die mit dem größten Wert wird abgefragt. Im Beispiel hat d1 0,155, d2 0,447 – der Lerner wählt also wieder d2.
Bis hierhin hast du die Bausteine von Active Learning kennengelernt. Falls die Schritte noch abstrakt wirken: In diesem Abschnitt gehen wir sie einmal komplett durch – in einem sehr einfachen Beispiel.
Klingt banal, ist aber wichtig: Achte darauf, dass dein Datensatz die wahre Verteilung möglichst gut widerspiegelt. Vermeide starke Verzerrungen. In der Praxis ist eine perfekte Repräsentativität wegen rechtlicher, zeitlicher oder organisatorischer Grenzen kaum erreichbar.
Im Beispiel hast du folgende 5 Datenpunkte. Feature A und Feature B stehen für Merkmale einer Instanz. Wichtig: Die gesammelten Daten sind ungelabelt.
| Instanzen | Feature A | Feature B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Als Nächstes teilst du die Daten in einen sehr kleinen Datensatz, den du labelst, und einen großen ungelabelten Datensatz. In der Active-Learning-Terminologie heißt der kleine gelabelte Datensatz Seed. Es gibt keine feste Anzahl oder Quote für den Seed. Sobald du die Seed-Daten beiseitegelegt hast, solltest du sie labeln.
Hinweis: In vielen Studien nutzen Forschende kein Orakel bzw. keine Expertinnen und Experten zum Labeln. Oft arbeiten sie mit vollständig gelabelten Datensätzen, nehmen einen kleinen Teil als Seed (Label liegen ja vor) und behandeln den Rest so, als wäre er ungelabelt. Wenn der Lerner eine Instanz beim orcale anfragt, wird schlicht das bekannte Label nachgeschlagen.
Im Beispiel wählst du zwei Instanzen für den Seed: d1 und d3. Mögliche Labels sind „Y“ und „N“.
Seed/gelabelter Datensatz
| Instanzen | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Ungelabelter Datensatz
| Instanzen | Feature A | Feature B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Nach der Aufteilung trainierst du den Lerner wie in einem normalen Machine-Learning-Projekt auf dem Seed (inklusive Cross-Validation etc.). Der gewählte Lerner hängt von deinem Domänenwissen ab. Häufig nutzt man Modelle, die probabilistische Ausgaben liefern, da diese Wahrscheinlichkeiten für die Abfragestrategien benötigt werden.
Im Beispiel kannst du jeden Klassifikator verwenden und auf den zwei gelabelten Instanzen trainieren.
Nach dem Training wählst du Instanzen zur Abfrage aus. Dafür legst du das Szenario fest (Membership Query Synthesis, Stream-based Selective Sampling oder Pool-based Sampling) und die Abfragestrategie.
Du nutzt Pool-based Sampling mit einer Batchgröße von 2. Das bedeutet: In jeder Iteration wählst du zwei Instanzen aus dem ungelabelten Datensatz und fügst sie dem gelabelten Datensatz hinzu. Zur Auswahl verwendest du Least Confidence. Dein Lerner wählt d2 und d4; deren Labels sind „Y“ bzw. „N“.
Gelabelter Datensatz
| Instanzen | Feature A | Feature B | Label |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Ungelabelter Datensatz
| Instanzen | Feature A | Feature B |
|---|---|---|
| d5 | 5 | 5 |
Nun wiederholst du Schritt 2 und 3 bis zu einem Stoppkriterium. Heißt: Mit dem erweiterten gelabelten Datensatz trainierst du erneut und wählst weitere ungelabelte Instanzen zur Abfrage. Mögliche Stoppkriterien sind die Anzahl abgefragter Instanzen, die Zahl der Iterationen oder ein Performance-Gewinn, der einen Schwellenwert nicht mehr überschreitet.
Im Beispiel stoppst du nach einer Iteration – der Active-Learning-Durchlauf ist damit beendet. Du kannst zusätzlich einen separaten Testdatensatz nutzen, dein Modell evaluieren und die Entwicklung der Performance mit wachsendem Labelumfang nachvollziehen.
Einer der beliebtesten Einsatzbereiche ist das Natural Language Processing (NLP). Viele NLP-Aufgaben (etwa Part-of-Speech-Tagging, Named Entity Recognition) brauchen große Mengen gelabelter Daten, deren Erstellung sehr teuer ist.
Tatsächlich gibt es nur wenige frei verfügbare, vollständig annotierte NLP-Datensätze. Active Learning kann den Bedarf an gelabelten Daten und Expertinnen/Experten deutlich reduzieren. Ähnlich gilt das für viele Aufgaben in der Spracherkennung und selbst für Informationsretrieval.
Active Learning wird weiterhin intensiv erforscht. Viele Arbeiten untersuchen den Einsatz verschiedener Deep-Learning-Algorithmen wie CNNs und LSTMs als Lerner und wie sich ihre Effizienz im Active-Learning-Rahmen verbessern lässt (Kronrod und Anandkumar, 2017; Sener und Savarese, 2017). Es gibt auch Forschung zur Integration von Generative Adversarial Networks (GANs) in Active-Learning-Frameworks (Zhu und Bento, 2017). Mit dem wachsenden Interesse an Deep Reinforcement Learning versuchen Forschende, Active Learning als Reinforcement-Learning-Problem zu formulieren (Fang et al., 2017). Außerdem gibt es Arbeiten, die Active-Learning-Strategien in einem Meta-Learning-Setup erlernen (Fang et al., 2017).
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Laiba Siddiqui
6 Min.





