Kurs
Machine Learning'i Anlamak
2 sa
310.7K
Etkin öğrenme, adını ara sıra duyduğunuz ama bir türlü derinlemesine vakit ayıramadığınız konulardan biridir. Bugünkü blog yazısında etkin öğrenmenin arkasındaki mantığı, sağladığı faydaları ve modern makine öğrenimi araştırmalarındaki yerini açıklayacağız.
Etkin öğrenmeyi doğru şekilde kullanabilmek, etiketli verinin kıt olduğu durumlarda başvurabileceğiniz çok güçlü bir araç sunar. Etkin öğrenmeyi, az miktarda etiketli veriden yararlanmak için kullanılan transfer öğrenmesine benzer bir tür “tasarım metodolojisi” olarak düşünebilirsiniz.
Bir sonraki yazıda, mevcut (ve yeni) veriyi en iyi şekilde kullanmak için etkin öğrenmeyi transfer öğrenmesiyle birlikte nasıl uygulayabileceğinizi öğreneceksiniz.
Önce etkin öğrenmenin resmi tanımını vermek yerine, neden işe yaradığını daha iyi kavramanız için basit bir örnekle başlamak daha iyi olacaktır.
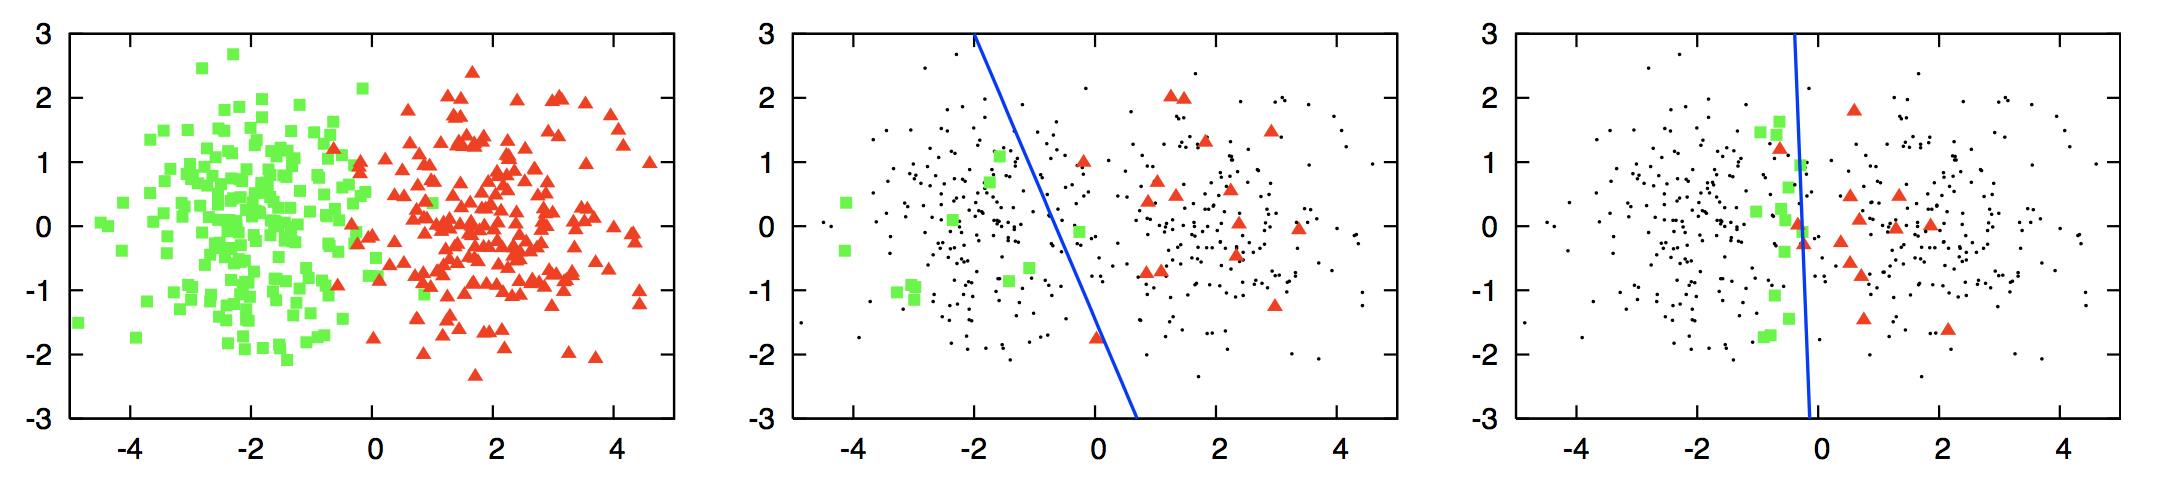
Yukarıdaki en soldaki resme bakıldığında (bkz. bu derleme), yeşil ve kırmızı renkle gösterilen iki küme görürsünüz. Dikkatli okurlar bunun bir sınıflandırma görevi olduğunu ve yeşil ile kırmızı şekilleri ayıracak bir “karar sınırı” (bu durumda bir doğru) oluşturmak istediğinizi bilir. Ancak veri noktalarının etiketlerini (kırmızı veya yeşil) bilmediğinizi varsayabilirsiniz ve her birinin etiketini bulmak çok pahalı olabilir. Bu nedenle, küçük bir alt küme nokta örneklemek, bu noktaların etiketlerini bulmak ve bunları bir sınıflandırıcı için eğitim verisi olarak kullanmak istersiniz.
Ortadaki resimde, küçük bir nokta alt kümesi rastgele örneklenip etiketlenerek şekillerin sınıflandırılması için lojistik regresyon kullanılmıştır. Ancak lojistik regresyonla oluşturulan karar sınırının (mavi çizgi) optimal olmadığı görülür. Çizgi, kırmızı veri noktalarından belirgin şekilde uzaklaşıp yeşil şekillerin alanına kaymıştır. Bu, birçok yeşil veri noktasının yanlış biçimde kırmızı olarak etiketleneceği anlamına gelir. Bu kayma, etiketlenecek veri noktalarının kötü seçilmesinden kaynaklanır. En sağdaki resimde yine lojistik regresyon kullanılmış, ancak bu kez küçük bir nokta alt kümesi etkin öğrenme sorgulama yöntemiyle seçilmiştir. Yeni karar sınırı her iki rengi daha iyi ayırdığı için belirgin ölçüde daha iyidir. Bu iyileşme, sınıflandırıcının çok iyi bir karar sınırı oluşturabilmesi için üstün veri noktalarının seçilmesinden gelir.
Etkin öğrenme sorgulama yönteminin nasıl bu kadar iyi noktaları seçebildiği, etkin öğrenme alanındaki başlıca araştırma konularından biridir. İlerleyen kısımda, veri noktalarını sorgulamak için en popüler yöntemlerden bazılarını göreceksiniz.
Etkin öğrenmedeki temel varsayım, bir öğrenme algoritması öğrenmek istediği veriyi kendisi seçebilirse, çok daha az eğitim verisiyle geleneksel yöntemlere göre daha iyi performans gösterebileceğidir.
Peki bu geleneksel yöntemler tam olarak nedir?
Bunlar, altta yatan dağılımdan rastgele örneklenmiş büyük miktarda veri toplayıp bu büyük veri kümesini bir tür tahmin yapabilen bir modeli eğitmek için kullanan görevlerdir. Bu tipik yönteme pasif öğrenme diyeceksiniz.
Pasif öğrenmede en çok zaman alan görevlerden biri etiketli veri toplamaktır. Birçok bağlamda, büyük miktarda etiketli veri toplamayı zorlaştıran kısıtlar olabilir.
Örneğin pankreas kanserini incelemeyi ele alalım. Bir hastanın pankreas kanseri olup olmayacağını tahmin etmek isteyebilirsiniz, ancak özellikleri toplamak vb. için yalnızca az sayıda hastaya ileri tetkik yapma imkânınız olabilir. Bu durumda, hastaları rastgele seçmek yerine belirli ölçütlere göre seçebiliriz. Örnek bir ölçüt, hastanın alkol kullanması ve 40 yaşın üzerinde olması olabilir. Bu ölçüt statik olmak zorunda değildir; önceki hastalardan elde edilen sonuçlara göre değişebilir. Örneğin, modelinizin 50 yaş üzerindekiler için pankreas kanserini iyi tahmin ettiğini, ancak 40-50 yaş aralığındakilerde zorlandığını fark ederseniz, bu aralık yeni ölçütünüz olabilir.
Şu ana kadar topladığımız verilere dayanarak bu hastaları (veya daha genel olarak örnekleri) seçme süreci etkin öğrenme olarak adlandırılır.
Etkin öğrenmede, öğrenicinin örneklerin etiketlerini sorguladığı tipik olarak üç senaryo veya kurulum vardır. Literatürde ele alınan üç ana senaryo şunlardır:
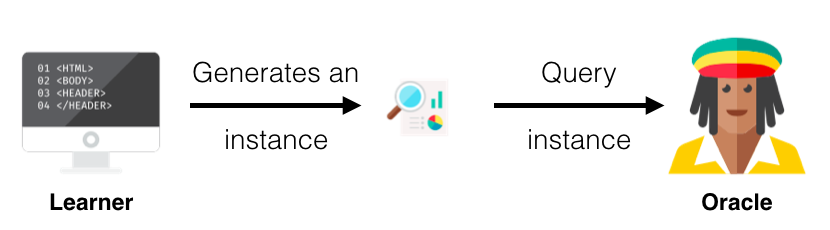
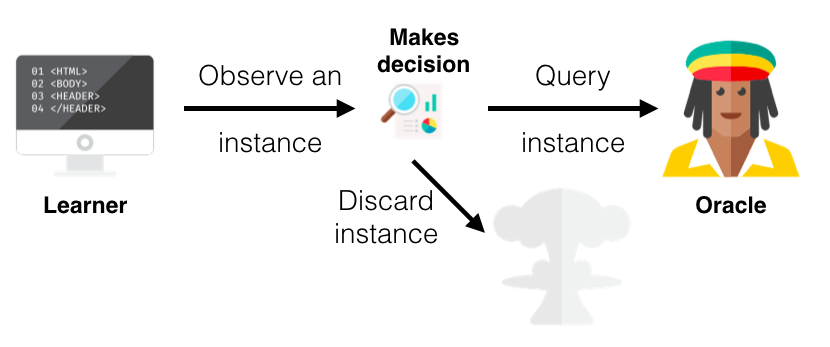
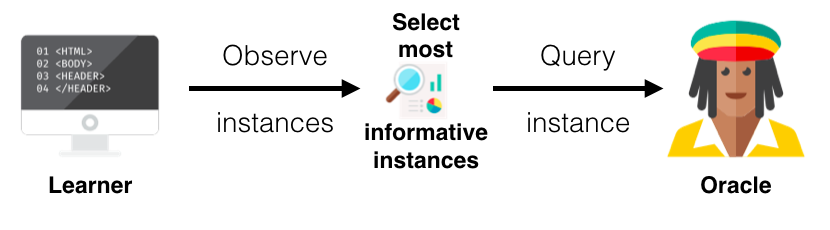
Etkin bir öğreniciyle pasif bir öğrenici arasındaki temel fark, geçmiş sorgular ve bu sorgulardan gelen yanıtlar (etiketler) temelinde örnekleri sorgulayabilme yeteneğidir. Daha önce okuduğunuz gibi, tüm etkin öğrenme senaryoları, etiketlenmemiş örneklerin bir tür bilgilendiricilik ölçütünü gerektirir. Bu bölümde, olasılıkları kullandığı için belirsizlik örneklemesi olarak adlandırılan ortak başlık altında, örnekleri sorgulamaya yönelik üç popüler yaklaşımı açıklayacağım (daha fazla sorgu stratejisi ve genel olarak etkin öğrenme hakkında daha derin bilgi için bu derleme makaleyi öneririm).
Sorgulama stratejilerini açıklamak için aşağıdaki tabloyu kullanacağım. Bu tablo iki veri noktasını (örnek) ve her bir örneğin her etikete sahip olma olasılıklarını gösterir. d1 için A, B ve C etiketlerinin olasılıkları sırasıyla 0,9, 0,09 ve 0,01; d2 için ise 0,2, 0,5 ve 0,3’tür.
| Örnekler | Etiket A | Etiket B | Etiket C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
En Az Güven (LC): Bu stratejide, öğrenici en olası tek etiketi konusunda en az güvene sahip olduğu örneği seçer. Tabloya bakıldığında, öğrenici d1’in etiketinden oldukça emindir; A etiketi olasılığını 0,9 olarak görür. Ancak d2’nin etiketinden daha az emindir; olasılıklar daha yaygındır ve B etiketi olasılığını yalnızca 0,5 olarak görür. Dolayısıyla en az güven stratejisiyle, öğrenici d2’yi gerçek etiketini sorgulamak üzere seçecektir.
Marj Örneklemesi: LC stratejisinin eksikliği, yalnızca en olası etiketi dikkate alıp diğer etiket olasılıklarını göz ardı etmesidir. Marj örnekleme stratejisi, en olası birinci ve ikinci etiketler arasındaki farkı en küçük olan örneği seçerek bu dezavantajı gidermeye çalışır. d1 için birinci ve ikinci en olası etiketler arasındaki fark 0,81’dir (0,9 - 0,09); d2 için ise 0,2’dir (0,5 - 0,3). Bu nedenle öğrenici yine d2’yi seçecektir.
Entropi Örneklemesi: Tüm olası etiket olasılıklarını kullanmak için entropi adı verilen popüler bir ölçü kullanırsınız. Entropi formülü her örneğe uygulanır ve en büyük değere sahip örnek sorgulanır. Örneğimizde d1’in değeri 0,155 iken d2’nin değeri 0,447’dir; dolayısıyla öğrenici yine d2’yi seçecektir.
Buraya kadar, etkin öğrenmeyi oluşturan farklı bileşenleri okudunuz. Adımların tümünü bir araya getirmek kafa karıştırıcı veya zor görünebilir; ancak bu bölümde, çok basit de olsa baştan sona bir örnek üzerinden gideceksiniz.
Bu adım önemsiz gibi görünse de, topladığınız veri kümesinin verinin gerçek dağılımını temsil ettiğinden emin olmak önemlidir. Başka bir deyişle, çok fazla çarpık veriden kaçınmaya çalışın. Gerçek dünyada, hukuki, zaman veya erişilebilirlik gibi kısıtlar nedeniyle tamamen temsilî bir örnekleme yapmak imkânsızdır.
Bu örnekte aşağıdaki 5 veri noktanız olacak. Özellik A ve Özellik B, bir veri noktasının sahip olabileceği bazı özellikleri temsil eder. Topladığımız verinin etiketlenmemiş olduğuna dikkat etmek önemlidir.
| Örnekler | Özellik A | Özellik B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Sonraki adımda, verimizi etiketleyeceğimiz çok küçük bir veri kümesine ve büyük bir etiketlenmemiş veri kümesine ayırmanız gerekir. Etkin öğrenme terminolojisinde, bu küçük etiketli veri kümesine çekirdek (seed) denir. Tipik olarak kullanılan belirli bir sayı veya etiketlenmemiş veri yüzdesi yoktur. Çekirdek için kullanacağınız veriyi ayırdıktan sonra bunları etiketlemelisiniz.
Not: Literatürün çoğunda araştırmacılar bu örnekleri etiketlemek için bir kâhin veya uzmana başvurmaz. Genellikle tamamen etiketli bir veri kümesi alırlar ve küçük bir kısmını (etiket zaten mevcut olduğu için) çekirdek olarak kullanırlar; kalanını ise etiketlenmemişmiş gibi kabul ederler. Öğrenici orcale’a sorgulamak üzere bir örnek seçtiğinde, yalnızca o örneğin etiketine bakarlar.
Örneğe devam ederek, çekirdek için iki örnek seçersiniz: d1 ve d3. Bu durumda olası etiketler ‘Y’ ve ‘N’dir.
Çekirdek/Etiketli Veri Kümesi
| Örnekler | Özellik A | Özellik B | Etiket |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Etiketlenmemiş Veri Kümesi
| Örnekler | Özellik A | Özellik B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Veriyi ayırdıktan sonra, çekirdeği kullanarak öğrenicinizi normal bir makine öğrenimi projesindeki gibi (çapraz doğrulama vb.) eğitirsiniz. Ayrıca kullanılacak öğrenici türü alan bilgisine bağlı olacaktır ve genellikle, bir örneğin belirli bir etikete sahip olup olmadığına olasılıksal yanıt veren öğreniciler tercih edilir; çünkü sorgulama stratejilerinde bu olasılıkları kullanırsınız.
Örnekte, istediğiniz herhangi bir sınıflandırıcıyı kullanabilir ve iki etiketli örneğinizle eğitebilirsiniz.
Öğrenicinizi eğittikten sonra, artık sorgulamak üzere bir veya daha fazla örnek seçmeye hazırsınız. Kullanmak istediğiniz senaryo türünü (Üyelik Sorgusu Sentezi, Akış Tabanlı Seçmeli Örnekleme veya Havuz Tabanlı Örnekleme) ve sorgulama stratejisini belirlemeniz gerekir.
Havuz tabanlı örneklemeyi, 2’lik yığın boyutuyla kullanacaksınız. Bu, her yinelemede etiketlenmemiş veri kümenizden iki örnek seçeceğiniz ve ardından bu örnekleri etiketli veri kümenize ekleyeceğiniz anlamına gelir. Örnekleri seçmek için en az güven stratejisini kullanırsınız. Öğreniciniz d2 ve d4’ü seçer; sorgulanan etiketleri sırasıyla ‘Y’ ve ‘N’dir.
Etiketli Veri Kümesi
| Örnekler | Özellik A | Özellik B | Etiket |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Etiketlenmemiş Veri Kümesi
| Örnekler | Özellik A | Özellik B |
|---|---|---|
| d5 | 5 | 5 |
Artık 2. ve 3. adımları bazı durdurma ölçütlerine kadar tekrarlayabilirsiniz. Yani yeni etiketli veri kümenize sahip olduğunuzda, öğrenicinizi yeniden eğitecek ve sonra sorgulamak üzere daha fazla etiketlenmemiş veri seçeceksiniz. Durdurma ölçütü olarak sorgulanan örnek sayısı, 2. ve 3. adımların yineleme sayısı veya performansın belirli bir eşik üzerinde anlamlı şekilde artmaması kullanılabilir.
Örneğinizde bir yinelemede duracaksınız ve böylece etkin öğrenme algoritmanızı tamamlamış olacaksınız. Ayrıca, öğrenicinizi değerlendirip performansını kaydedeceğiniz ayrı bir test veri kümesine sahip olabilirsiniz. Bu şekilde, test kümesindeki performansınızın eklenen etiketli verilerle nasıl iyileştiğini veya durağanlaştığını görebilirsiniz.
Etkin öğrenmenin en popüler alanlarından biri doğal dil işleme (NLP)’dir. Bunun nedeni, NLP’deki birçok uygulamanın (örneğin, Sözcük Türü Etiketleme, Ad Varlık Tanıma) çok miktarda etiketli veri gerektirmesi ve bu veriyi etiketlemenin çok yüksek maliyetli olmasıdır.
Aslında, bu uygulamalar için serbestçe erişilebilen ve tamamen etiketlenmiş yalnızca bir avuç NLP veri kümesi vardır. Bu nedenle etkin öğrenme, gereken etiketli veri miktarını ve bunları doğru şekilde etiketlemek için gerekli uzman sayısını önemli ölçüde azaltabilir. Benzer gerekçeler birçok konuşma tanıma görevine ve hatta bilgi erişimi gibi görevlere de uygulanabilir.
Etkin öğrenme hâlâ yoğun biçimde araştırılmaktadır. Birçok araştırmacı, CNN’ler ve LSTM’ler gibi farklı derin öğrenme algoritmalarını öğrenici olarak kullanmayı ve etkin öğrenme çerçevelerinde bunların verimliliğini nasıl artıracaklarını incelemeye başladı (Kronrod ve Anandkumar, 2017; Sener ve Savarese, 2017). Generative Adversarial Network’lerin (GAN) etkin öğrenme çerçevesine uygulanmasına dair araştırmalar da bulunmaktadır (Zhu ve Bento, 2017). Derin pekiştirmeli öğrenmeye artan ilgiyle birlikte, araştırmacılar etkin öğrenmeyi bir pekiştirmeli öğrenme problemi olarak yeniden çerçevelemeye çalışmaktadır (Fang vd., 2017). Ayrıca, etkin öğrenme stratejilerini bir meta-öğrenme düzeninde öğrenmeye çalışan çalışmalar da vardır (Fang vd., 2017).
Makine Öğrenimi hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



