Khóa học
Tìm hiểu Machine Learning
2 giờ
313.8K
Học chủ động là một trong những chủ đề bạn đôi khi nghe lướt qua nhưng lại không có thời gian để hiểu tường tận. Bài viết hôm nay sẽ giải thích lý do đằng sau học chủ động, lợi ích của nó và cách nó phù hợp với nghiên cứu máy học hiện đại.
Nếu biết tận dụng đúng cách, học chủ động sẽ mang lại cho bạn một công cụ rất mạnh khi thiếu dữ liệu gán nhãn. Có thể xem học chủ động như một dạng "phương pháp thiết kế" tương tự học chuyển giao, cũng giúp khai thác hiệu quả lượng nhỏ dữ liệu đã gán nhãn.
Trong bài tiếp theo, bạn sẽ tìm hiểu cách kết hợp học chủ động với học chuyển giao để tận dụng tối ưu dữ liệu hiện có (và dữ liệu mới).
Thay vì đưa ra định nghĩa chính thức về học chủ động ngay từ đầu, tốt hơn là bắt đầu bằng một ví dụ đơn giản để bạn hiểu vì sao học chủ động hiệu quả.
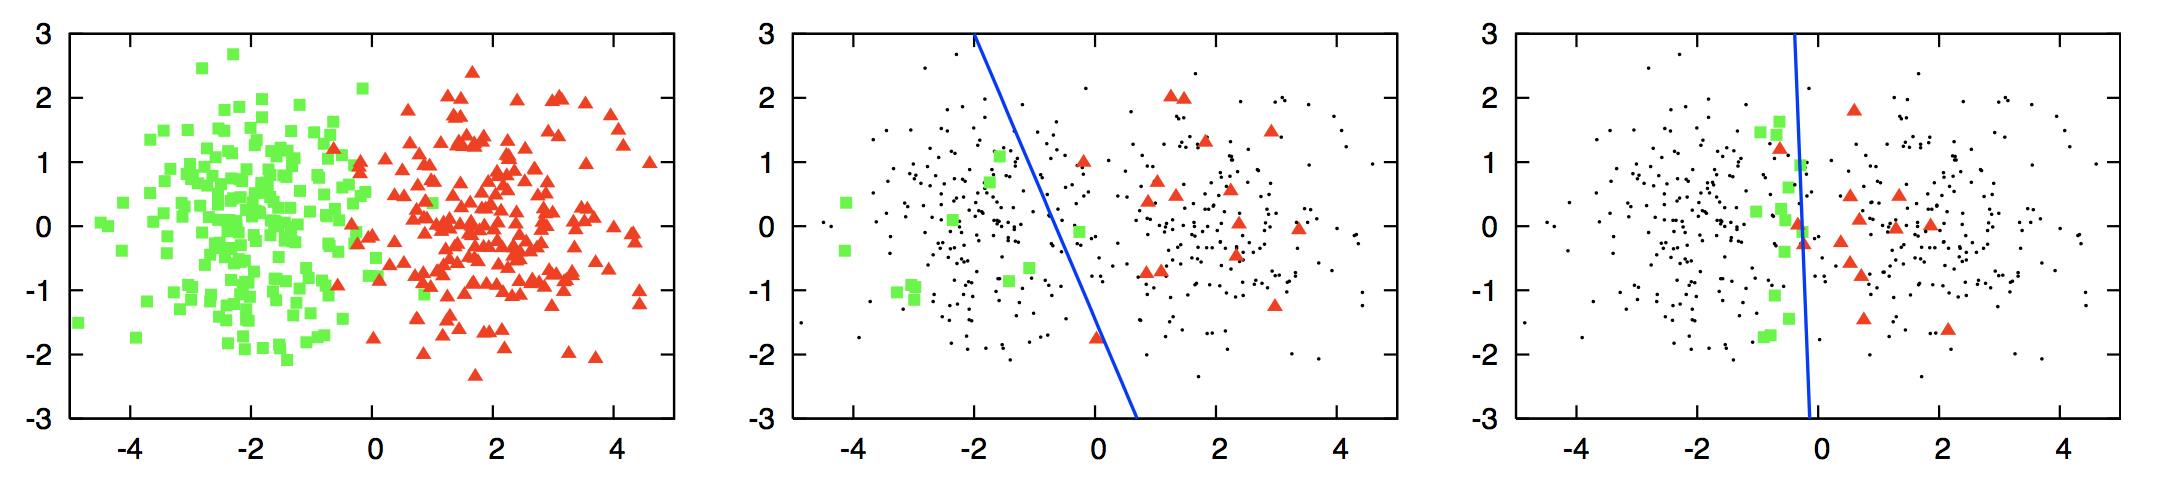
Nhìn vào hình ngoài cùng bên trái ở trên (lấy từ khảo sát này), bạn có hai cụm, một màu xanh lá và một màu đỏ. Những độc giả tinh ý sẽ biết đây là một bài toán phân loại và bạn muốn tạo một "ranh giới quyết định" (trong trường hợp này chỉ là một đường thẳng) để tách các hình màu xanh và màu đỏ. Tuy nhiên, giả sử bạn không biết nhãn (đỏ hay xanh) của các điểm dữ liệu, và việc tìm nhãn cho từng điểm sẽ rất tốn kém. Do đó, bạn muốn lấy mẫu một tập con nhỏ các điểm, tìm nhãn cho chúng và dùng các điểm dữ liệu đã gán nhãn này làm dữ liệu huấn luyện cho bộ phân loại.
Ở hình giữa, hồi quy logistic được dùng để phân loại các hình bằng cách ngẫu nhiên lấy mẫu một tập con nhỏ các điểm và gán nhãn cho chúng. Tuy nhiên, bạn thấy rằng ranh giới quyết định tạo bằng hồi quy logistic (đường màu xanh dương) là chưa tối ưu. Đường này rõ ràng lệch khỏi các điểm dữ liệu màu đỏ và lấn vào vùng các hình màu xanh. Điều này có nghĩa sẽ có nhiều điểm dữ liệu màu xanh bị gán nhãn sai thành màu đỏ. Sự lệch này là do chọn điểm dữ liệu để gán nhãn chưa tốt. Ở hình ngoài cùng bên phải, hồi quy logistic lại được dùng, nhưng lần này bạn chọn một tập con nhỏ các điểm bằng một phương pháp truy vấn học chủ động. Ranh giới mới tốt hơn hẳn vì tách biệt hai màu rõ ràng hơn. Cải thiện này đến từ việc chọn được các điểm dữ liệu chất lượng hơn nên bộ phân loại tạo được ranh giới quyết định rất tốt.
Cách mà phương pháp truy vấn trong học chủ động có thể chọn được các điểm tốt như vậy là một trong những hướng nghiên cứu chính của học chủ động. Ở phần sau, bạn sẽ thấy một số phương pháp phổ biến nhất để truy vấn điểm dữ liệu.
Giả thuyết chính trong học chủ động là nếu một thuật toán học có thể chọn dữ liệu mà nó muốn học, thì nó có thể đạt hiệu quả tốt hơn các phương pháp truyền thống với lượng dữ liệu huấn luyện ít hơn đáng kể.
Vậy chính xác các phương pháp truyền thống là gì?
Đó là các tác vụ liên quan đến việc thu thập lượng lớn dữ liệu được lấy mẫu ngẫu nhiên từ phân phối nền, rồi dùng bộ dữ liệu lớn này để huấn luyện một mô hình dự đoán. Bạn sẽ gọi phương pháp điển hình này là học thụ động.
Một trong những công việc tốn thời gian nhất trong học thụ động là thu thập dữ liệu đã gán nhãn. Trong nhiều bối cảnh, có những yếu tố hạn chế cản trở việc thu thập lượng lớn dữ liệu gán nhãn.
Lấy ví dụ nghiên cứu ung thư tuyến tụy. Bạn có thể muốn dự đoán bệnh nhân có mắc ung thư tuyến tụy hay không, tuy nhiên bạn chỉ có cơ hội cho một số ít bệnh nhân làm thêm xét nghiệm để thu thập đặc trưng, v.v. Trong trường hợp này, thay vì chọn bệnh nhân ngẫu nhiên, ta có thể chọn dựa trên một số tiêu chí. Ví dụ, bệnh nhân có uống rượu và trên 40 tuổi. Các tiêu chí này không nhất thiết phải cố định mà có thể thay đổi tùy theo kết quả từ các bệnh nhân trước đó. Chẳng hạn, nếu bạn nhận ra mô hình dự đoán tốt cho nhóm trên 50 tuổi nhưng gặp khó với nhóm 40–50 tuổi, thì đây có thể trở thành tiêu chí mới.
Quy trình chọn các bệnh nhân (hay nói chung là các điểm dữ liệu) dựa trên dữ liệu đã thu thập cho đến thời điểm hiện tại được gọi là học chủ động.
Trong học chủ động, thường có ba kịch bản hoặc thiết lập mà người học sẽ truy vấn nhãn của các điểm dữ liệu. Ba kịch bản chính được đề cập trong tài liệu gồm:
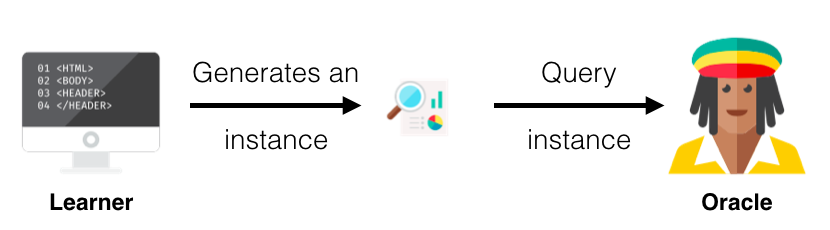
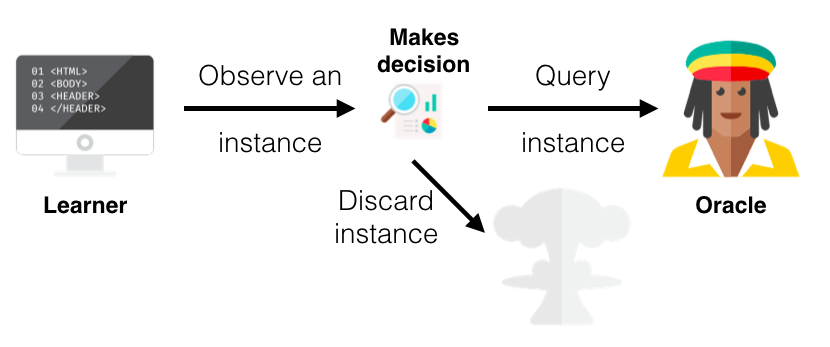
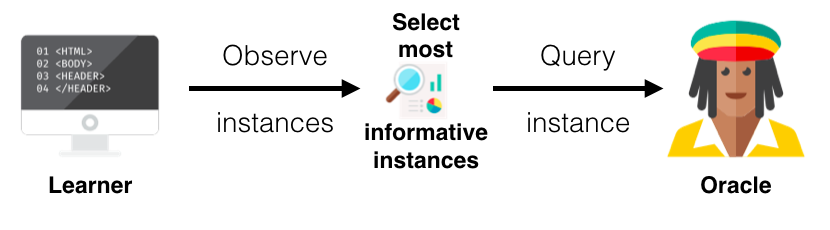
Khác biệt cốt lõi giữa người học chủ động và thụ động là khả năng truy vấn các điểm dựa trên các truy vấn trước đó và phản hồi (nhãn) từ những truy vấn ấy. Như bạn đã đọc, tất cả các kịch bản học chủ động đều cần một thước đo mức độ cung cấp thông tin cho các điểm chưa gán nhãn. Phần này tôi sẽ giải thích ba cách tiếp cận phổ biến để truy vấn điểm dữ liệu thuộc chủ đề chung là lấy mẫu theo độ bất định, do sử dụng xác suất (để biết thêm chiến lược và thông tin chuyên sâu về học chủ động nói chung, tôi khuyến nghị bài khảo sát này).
Tôi sẽ dùng bảng dưới đây để giải thích các chiến lược truy vấn. Bảng cho thấy hai điểm dữ liệu (các điểm) và xác suất mỗi điểm mang mỗi nhãn. Xác suất d1 có nhãn A, B và C lần lượt là 0,9; 0,09 và 0,01; còn d2 là 0,2; 0,5 và 0,3.
| Các điểm | Nhãn A | Nhãn B | Nhãn C |
|---|---|---|---|
| d1 | 0.9 | 0.09 | 0.01 |
| d2 | 0.2 | 0.5 | 0.3 |
Độ tự tin thấp nhất (Least Confidence - LC): trong chiến lược này, người học chọn điểm mà nó ít tự tin nhất vào nhãn có khả năng cao nhất. Nhìn vào bảng, người học khá tự tin về nhãn của d1, vì nó cho rằng nhãn A với xác suất 0,9; tuy nhiên, nó kém chắc chắn hơn về nhãn của d2 vì các xác suất phân tán hơn và cho rằng nhãn B chỉ với xác suất 0,5. Do đó, với LC, người học sẽ chọn d2 để truy vấn nhãn thực.
Lấy mẫu theo biên (Margin Sampling): điểm yếu của LC là chỉ xét nhãn có xác suất cao nhất và bỏ qua các xác suất còn lại. Chiến lược lấy mẫu theo biên khắc phục nhược điểm này bằng cách chọn điểm có chênh lệch nhỏ nhất giữa nhãn có xác suất cao nhất và nhãn có xác suất cao thứ hai. Với d1, chênh lệch giữa hai nhãn có xác suất cao nhất là 0,81 (0,9 - 0,09) và với d2 là 0,2 (0,5 - 0,3). Do đó, người học lại chọn d2.
Lấy mẫu theo entropy (Entropy Sampling): để tận dụng toàn bộ các xác suất nhãn, bạn dùng thước đo phổ biến là entropy. Áp dụng công thức entropy cho từng điểm và truy vấn điểm có giá trị lớn nhất. Với ví dụ này, d1 có giá trị 0,155 còn d2 là 0,447, nên người học một lần nữa sẽ chọn d2.
Đến giờ, bạn đã đọc về các thành phần cấu thành học chủ động. Có thể hơi rối khi ghép tất cả các bước, nhưng phần này bạn sẽ đi qua một ví dụ hoàn chỉnh — dù rất đơn giản.
Bước này có vẻ hiển nhiên, nhưng điều quan trọng là đảm bảo bộ dữ liệu bạn thu thập đại diện cho phân phối thực của dữ liệu. Nói cách khác, cố tránh dữ liệu bị lệch quá nhiều. Trên thực tế, việc có mẫu hoàn toàn đại diện là không thể do các hạn chế như pháp lý, thời gian hoặc khả dụng.
Trong ví dụ này, bạn có 5 điểm dữ liệu sau. Đặc trưng A và Đặc trưng B đại diện cho một số đặc trưng mà một điểm dữ liệu có thể có. Lưu ý quan trọng là dữ liệu bạn thu thập chưa được gán nhãn.
| Các điểm | Đặc trưng A | Đặc trưng B |
|---|---|---|
| d1 | 10 | 0 |
| d2 | 4 | 9 |
| d3 | 8 | 5 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Tiếp theo, bạn cần chia dữ liệu thành một tập rất nhỏ mà bạn sẽ gán nhãn và một tập lớn chưa gán nhãn. Trong thuật ngữ học chủ động, bạn gọi tập nhỏ đã gán nhãn này là hạt giống (seed). Không có con số hay tỷ lệ cố định nào của dữ liệu chưa gán nhãn được dùng. Khi bạn đã tách phần dữ liệu dùng làm seed, bạn nên gán nhãn cho chúng.
Lưu ý rằng trong phần lớn tài liệu, các nhà nghiên cứu không dùng oracle hay chuyên gia để gán nhãn cho các điểm này. Thông thường, họ có một bộ dữ liệu đã gán nhãn đầy đủ và dùng một phần nhỏ làm seed (vì họ đã có nhãn), phần còn lại coi như chưa gán nhãn. Bất cứ khi nào người học chọn một điểm để truy vấn orcale, họ đơn giản tra cứu nhãn của điểm đó.
Tiếp tục ví dụ, bạn chọn hai điểm làm seed, d1 và d3. Các nhãn có thể có ở đây là 'Y' và 'N'.
Tập seed/đã gán nhãn
| Các điểm | Đặc trưng A | Đặc trưng B | Nhãn |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
Tập chưa gán nhãn
| Các điểm | Đặc trưng A | Đặc trưng B |
|---|---|---|
| d2 | 4 | 9 |
| d4 | 3 | 3 |
| d5 | 5 | 5 |
Sau khi chia dữ liệu, bạn dùng seed để huấn luyện người học như một dự án máy học thông thường (dùng cross-validation, v.v.). Ngoài ra, loại mô hình dùng sẽ dựa trên hiểu biết về miền bài toán và thường bạn sẽ dùng các mô hình cho phản hồi xác suất về việc một điểm mang một nhãn cụ thể, vì bạn dùng các xác suất này cho chiến lược truy vấn.
Trong ví dụ, bạn có thể dùng bất kỳ bộ phân loại nào và bạn sẽ huấn luyện trên hai điểm đã gán nhãn.
Khi đã huấn luyện xong, bạn sẵn sàng chọn một hoặc một vài điểm để truy vấn. Bạn cần xác định loại kịch bản muốn dùng (tức Membership Query Synthesis, Stream-Based Selective Sampling hay Pool-Based sampling) và chiến lược truy vấn.
Bạn sẽ dùng lấy mẫu dựa trên bể với kích thước lô là 2. Nghĩa là ở mỗi vòng lặp, bạn sẽ chọn hai điểm từ tập chưa gán nhãn rồi thêm vào tập đã gán nhãn. Bạn dùng độ tự tin thấp nhất để chọn điểm. Mô hình của bạn chọn d2 và d4 với nhãn được truy vấn lần lượt là 'Y' và 'N'.
Tập đã gán nhãn
| Các điểm | Đặc trưng A | Đặc trưng B | Nhãn |
|---|---|---|---|
| d1 | 10 | 0 | Y |
| d3 | 8 | 5 | N |
| d2 | 4 | 9 | Y |
| d4 | 3 | 3 | N |
Tập chưa gán nhãn
| Các điểm | Đặc trưng A | Đặc trưng B |
|---|---|---|
| d5 | 5 | 5 |
Bây giờ, bạn có thể lặp lại bước 2 và 3 cho đến khi thỏa một tiêu chí dừng nào đó. Tức là, khi có tập đã gán nhãn mới, bạn sẽ huấn luyện lại mô hình rồi chọn thêm dữ liệu chưa gán nhãn để truy vấn. Một tiêu chí dừng có thể là số lượng điểm đã truy vấn, một tiêu chí khác là số vòng lặp của bước 2 và 3; bạn cũng có thể dừng khi hiệu năng không cải thiện đáng kể vượt qua một ngưỡng nhất định.
Trong ví dụ, bạn sẽ dừng sau một vòng lặp, như vậy thuật toán học chủ động của bạn đã hoàn tất. Bạn cũng có thể có một tập kiểm thử riêng để đánh giá mô hình và ghi nhận hiệu năng. Cách này cho phép bạn thấy hiệu năng trên tập kiểm thử được cải thiện hay chững lại khi bổ sung dữ liệu đã gán nhãn.
Một trong những lĩnh vực phổ biến nhất của học chủ động là xử lý ngôn ngữ tự nhiên (NLP). Lý do là nhiều ứng dụng NLP cần rất nhiều dữ liệu gán nhãn (ví dụ, gán nhãn từ loại, nhận dạng thực thể có tên) và chi phí gán nhãn dữ liệu này rất cao.
Trên thực tế, chỉ có một số ít bộ dữ liệu trong NLP là miễn phí và được gán nhãn đầy đủ cho các ứng dụng này. Vì vậy, dùng học chủ động có thể giảm đáng kể lượng dữ liệu gán nhãn cần thiết và số chuyên gia cần để gán nhãn chính xác. Lập luận tương tự áp dụng cho nhiều tác vụ nhận dạng giọng nói và cả các tác vụ như truy hồi thông tin.
Học chủ động vẫn đang được nghiên cứu mạnh mẽ. Nhiều người đã bắt đầu nghiên cứu việc dùng các thuật toán học sâu khác nhau như CNN và LSTM làm mô hình học, và cách cải thiện hiệu quả của chúng trong khung học chủ động (Kronrod và Anandkumar, 2017; Sener và Savarese, 2017). Cũng có nghiên cứu triển khai Mạng đối sinh (GAN) vào khung học chủ động (Zhu và Bento, 2017). Với sự quan tâm ngày càng tăng đến học tăng cường sâu, các nhà nghiên cứu đang cố gắng tái diễn giải học chủ động như một bài toán học tăng cường (Fang và cộng sự, 2017). Ngoài ra, có các bài báo cố gắng học các chiến lược học chủ động theo thiết lập học meta (Fang và cộng sự, 2017).
Tìm hiểu thêm về Máy học
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
