

什么是 ROC 曲线?
ROC 曲线可直观呈现不同阈值下真正例率(TPR)与假正例率(FPR)之间的权衡。它揭示了模型在不同阈值下如何平衡对正类实例的捕捉与避免误报。AUC(曲线下面积)是介于 0 到 1 的单一标量值,可作为模型表现的快照。AUC 必须在生成 ROC 曲线之后计算,因为它表示曲线下方的面积。
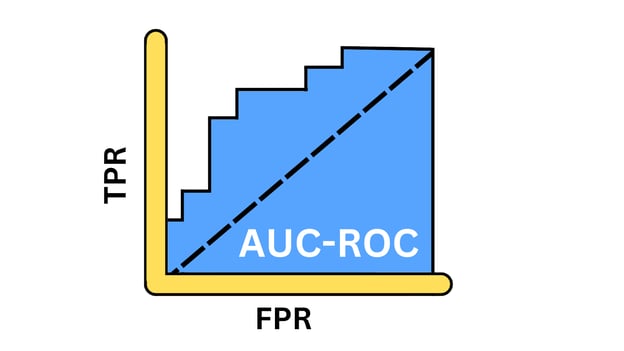
AUC-ROC 曲线示意图。图片来自作者
真正例率
真正例率(也称灵敏度或召回率)反映模型正确识别正类实例的能力。它衡量模型成功识别的实际正类样本所占比例。数学上可用如下公式表示:
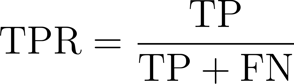
其中:
- TP(真正例)是模型将正类样本正确预测为正类的数量。
- FN(假负例)是模型将正类样本错误预测为负类的数量。
假正例率
FPR 表示模型将负类样本误判为正类的频率。它衡量被模型错误识别为正类的实际负类样本所占比例,体现误报率。数学上可表示如下。
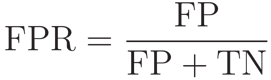
其中:
- FP(假正例)是被错误预测为正类的负类样本数量。
- TN(真负例)是被正确预测为负类的负类样本数量。
为何使用 AUC-ROC 曲线?
来看一些 AUC-ROC 更具相关性的场景。
衡量整体表现
AUC-ROC 在所有可能的分类阈值上给出聚合的性能度量。不同于依赖特定阈值的准确率、精确率或 F1 分数,它考虑模型在不同工作点下的表现。
模型比较
AUC-ROC 是一个单一标量,便于比较多个模型,而不受其分类阈值的影响。由于其与阈值无关的特性,它更适合公平比较拥有不同最优阈值的模型。
关注类别不平衡
大多数真实世界的数据集都存在类别不平衡,即一类样本远多于另一类,例如情感分析、欺诈检测和癌症检测。在这类场景下,准确率等指标因偏向多数类而可能产生误导性评估;而 AUC-ROC 等指标更为可靠。
AUC-ROC 曲线的关键概念
下面来看看一些关键要点。
绘制 ROC 曲线
要绘制 ROC 曲线,我们需要在不同阈值下计算 TPR 和 FPR。先导入本示例所需的库。
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt接着使用 make-classification() 函数生成一个包含 1000 个样本、20 个特征的二元分类数据集。
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)将数据集划分为训练集与测试集——我们在训练集上训练模型,并在未见过的测试集上评估其表现。
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)然后,通过调用 LogisticRegression() 类定义模型对象,并使用训练数据上的 fit 方法进行训练,其中 X_train 为特征,y_train 为标签。
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)现在模型已训练完成,可以生成预测。我们调用 predict_proba() 生成正类的概率。我们使用 predict() 方法计算准确率、精确率、召回率和 F1 分数等评估指标。
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]
# Predict the classes for the test set
y_pred = model.predict(X_test)接下来,我们使用各自的函数来计算并打印这些指标。
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87现在,我们将可视化 ROC 曲线,同时绘制表示随机模型的对角线。为此,我们需要 0 到 1 之间各个离散阈值对应的 FPR 与 TPR。下图中,橙色曲线为 ROC,曲线下面积为 0.93。
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()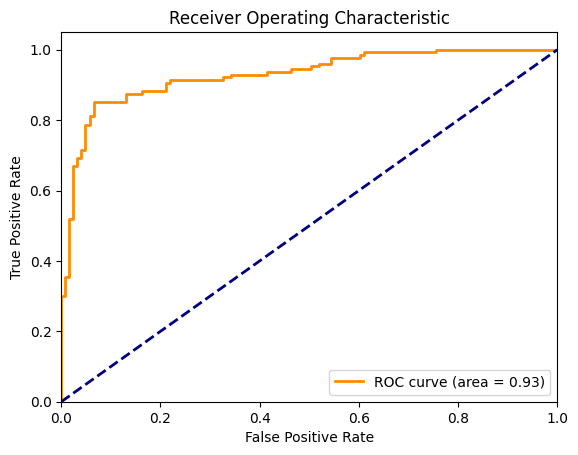
逻辑回归的 ROC 曲线。图片来自作者
使用 ROC 曲线选择最佳算法
现在,我们用同一数据集,借助 ROC 比较四种分类算法的表现。我们将导入 RandomForestClassifier、KNeighborsClassifier 和 SVC,并与 LogisticRegression 进行对比。
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
# Define the models
models = {
"Logistic Regression": LogisticRegression(),
"Random Forest": RandomForestClassifier(),
"SVM": SVC(probability=True),
"K-Nearest Neighbors": KNeighborsClassifier()
}
# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}
# Plot the ROC curves
plt.figure(figsize=(10, 8))
for name, model in models.items():
# Train the model
model.fit(X_train, y_train)
# Predict the probabilities
y_probs = model.predict_proba(X_test)[:, 1]
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)
roc_auc_scores[name] = roc_auc
# Compute ROC curve
fpr, tpr, _ = roc_curve(y_test, y_probs)
# Plot ROC curve
plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')
# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()
# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
print(f'{name}: AUC - ROC = {score:.2f}')对于每个模型对象,我们重复调用 fit() 与 predict_proba(),计算相应的 FPR 与 TPR,并绘制各自的曲线。
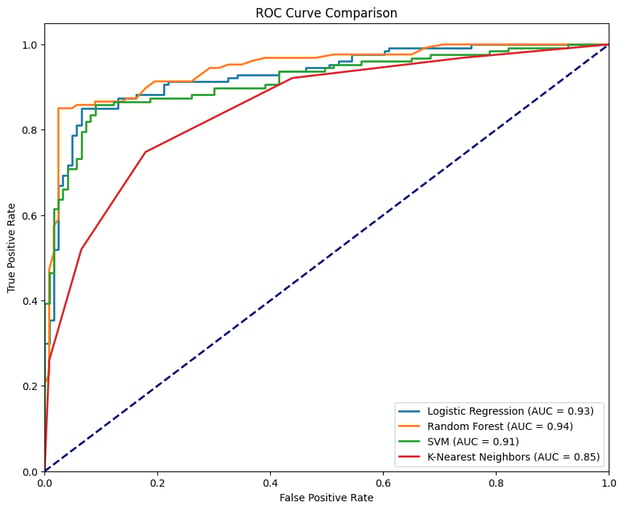
不同模型的 ROC 曲线。图片来自作者
上图展示了四个分类器对应的四条曲线,其中 RandomForestClassifier 表现最佳,AUC-ROC 为 0.94;而 KNeighborsClassifier 表现最弱,AUC-ROC 为 0.85。理想的模型会尽量贴近图像的左上角——在那里 TPR 最大化且 FPR 最小化。曲线越接近该点,模型表现越好。
如何解读与理解 AUC-ROC 曲线
让我们拆解 AUC-ROC 曲线提供的指标,并理解其意义。
解读 AUC 值
AUC 值可以快速帮助理解模型表现。当 AUC 接近 1 时,模型表现优异,能够很好地区分类别。AUC 约为 0.5 时值得警惕,说明模型不比随机猜测更好,几乎没有判别力。AUC 接近 0 则是危险信号,表示模型几乎完全判断错误,甚至比掷硬币更差。
真正例率:衡量成功
TPR(灵敏度)是关键指标,告诉我们模型对正类实例的捕捉能力。TPR 是被模型正确识别的实际正类所占比例,是模型发现真实信号(正类)的有效性指示器。较高的 TPR 表明模型能很好地识别最重要的目标。
假正例率:评估噪声
相对地,FPR 帮助我们了解“噪声”——模型将负类误判为正类的频率。FPR 是实际负类被模型误报为正类的比例。它对于评估模型权衡取舍至关重要。高 FPR 表明模型容易产生误报,在某些应用中代价不菲。
平衡灵敏度与特异性
二元分类的魅力与挑战在于阈值设定,因此我们要微调模型的灵敏度(TPR)与特异性(1 - FPR)。通过调整阈值,我们既能控制模型对正类实例的敏感度,也能减少误报。在多数实际场景中,漏报(假负)与误报(假正)的代价差异很大。
AUC-ROC 曲线的实际应用
AUC-ROC 并非纯理论概念;以下是该实用指标在各行业助力关键决策的方式:
医学诊断
AUC-ROC 常用于比较不同的诊断测试。当假负(例如漏诊疾病)的代价远高于假正(例如不必要治疗)时尤为有用。一个典型例子是癌症筛查,可根据风险因素与资源可用性来调整进一步检测的阈值。
欺诈检测
在金融领域,机器学习模型被越来越多地用于识别欺诈行为。考虑到欺诈交易非常少见,此类数据集高度不平衡。因此,AUC-ROC 是一种有效的评估指标,并且可以根据多种因素调整阈值,例如交易所涉风险的大小、逐笔人工核验的成本以及对客户造成不便的成本。
网络安全
与欺诈检测类似,网络攻击也是相对罕见的事件。因此,AUC-ROC 在网络安全中同样适用,以在发现威胁与避免误报疲劳之间取得平衡。
AUC-ROC 曲线的替代方案
AUC-ROC 是评估二元分类模型的热门指标,但在某些情况下,替代指标可能更合适。下面探讨一些替代方案及其使用时机:
精确率-召回率曲线
精确率-召回率曲线(PRC)适用于类别不平衡的数据集,且当假正与假负的成本不同、对模型价值影响显著时尤为重要。不同于在不平衡数据中可能给出过于乐观结论的 AUC-ROC,PRC 更关注正类相关的性能。
F1 分数
F1 分数是精确率与召回率的调和平均,提供兼顾二者的单一指标。当我们需要在不平衡数据集中用一个清晰的单值来概括模型表现时,它很有用。AUC-ROC 提供更全局的视角,而 F1 则对应于 PRC 曲线上的一个具体点。
总结
AUC-ROC 是二元分类问题中的黄金标准之一,因为它能在不同阈值下提供更均衡的模型表现视图,尤其适用于类别不平衡的情形。
我们相信,巩固所学的最佳方式是动手实践。Python 的多样性为我们掌握核心概念提供了绝佳机会。无论是复习基础还是探索更高级主题,现在都是深入学习的理想时机。让我们重温 Python 基础,并在更复杂的数据集上用 AUC-ROC 挑战自己。

我是一名 AI 策略与伦理专家,致力于在数据科学、产品与工程的交汇处构建可扩展的机器学习系统。曾入选全球“200 位顶尖商业与技术创新者”之一,我的使命是让机器学习走向大众,打破术语壁垒,让每个人都能参与这场变革。
常见问题解答
什么是 AUC?
什么是 AUC-ROC 曲线?
AUC-ROC 曲线是一种图表,通过在不同阈值下绘制真正例率与假正例率,来展示二元分类模型的性能。
为何 AUC-ROC 曲线在模型评估中很重要?
AUC-ROC 曲线在所有阈值上提供全面的性能度量,特别适用于比较模型以及评估其区分类别的能力。
如何解读 AUC 分数?
AUC 分数的范围为 0 到 1,越接近 1 表明模型表现越好;0.5 表示与随机猜测相当;接近 0 则意味着表现很差。
何时应优先使用 AUC-ROC 而非其他指标?
当您需要与阈值无关的指标时,尤其是在类别不平衡的数据集中,传统指标(如准确率)可能具有误导性,此时 AUC-ROC 是理想选择。
AUC-ROC 曲线有哪些替代方案?
替代方案包括针对不平衡数据集的精确率-召回率曲线,以及平衡精确率与召回率的 F1 分数。后者给出的是一个具体点的评估,而非整体表现视图。
分类模型是最常用的预测算法之一。针对同一问题可以使用多种算法建模,但如何判断哪个模型最有效?
模型选择需要根据多种性能指标进行评估,例如精确率(precision)、召回率(recall)、F1 分数以及 AUC-ROC。精确率、召回率和 F1 分数等指标能够提供关于哪个模型更契合数据的洞见,但它们仅在单一阈值下给出结论。相比之下,AUC-ROC(受试者工作特征曲线下面积)是一项稳健指标,可在完整阈值范围内评估模型的优劣。
在本文中,我们将理解为何 AUC-ROC 是评估二元分类模型表现的首选指标,以及如何用它区分两类样本。开始之前,建议您同时报名我们的Machine Learning Scientist with Python 职业路径课程。该课程将帮助您精通本教程中会用到的 sklearn。