
Cursus
Inleiding tot statistiek in Python
4 uur
200.5K
De ROC-curve geeft een visuele weergave van de trade-offs tussen de true positive rate (TPR) en false positive rate (FPR) bij verschillende drempelwaarden. Het biedt inzicht in hoe goed het model het evenwicht bewaart tussen het detecteren van positieve voorbeelden en het vermijden van false positives over verschillende drempels heen. AUC, of Area Under the Curve, is een enkele scalair tussen 0 en 1 die een momentopname van de modelprestatie geeft. Je berekent AUC pas nadat je de ROC-curve hebt gegenereerd, omdat de AUC het gebied onder de curve vertegenwoordigt.
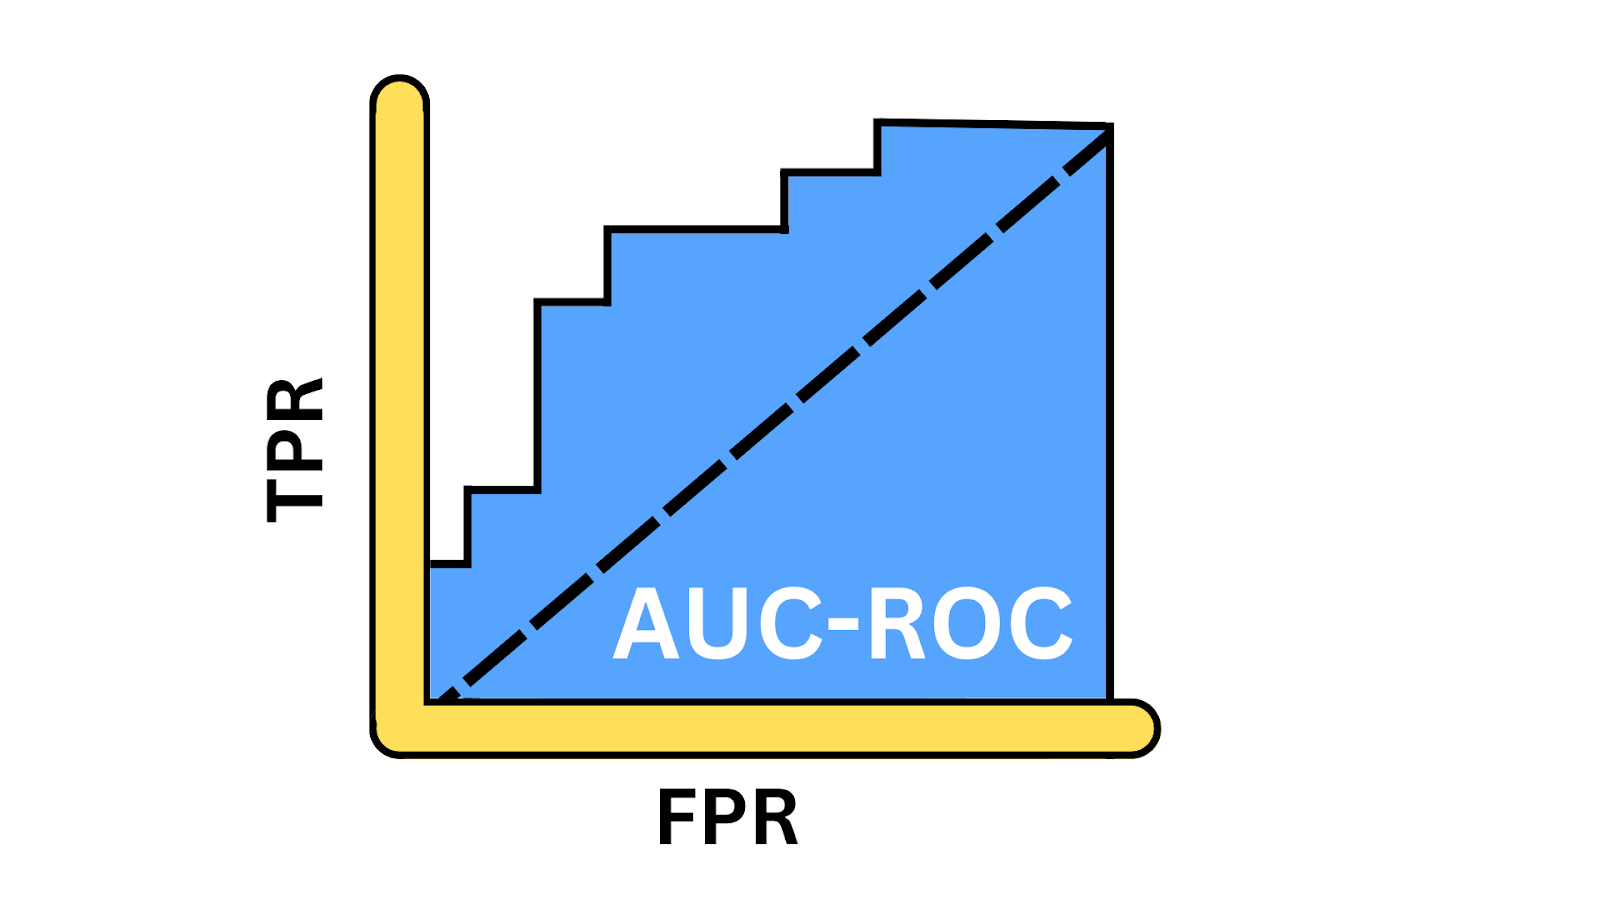
Illustratie van de AUC-ROC-curve. Afbeelding door de auteur
De true positive rate, ook wel sensitiviteit of recall genoemd, weerspiegelt het vermogen van een model om positieve gevallen correct te identificeren. Het meet de proportie van werkelijk positieve gevallen die het model succesvol herkent. Wiskundig kan dit worden uitgedrukt door de volgende vergelijking:
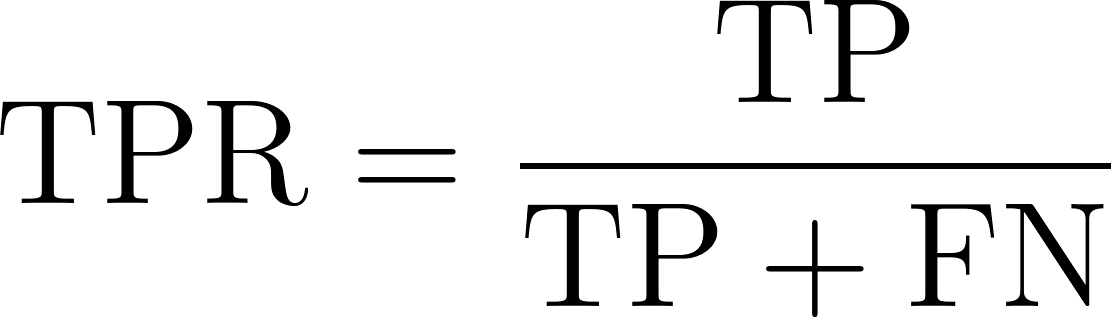
Waarbij:
FPR geeft aan hoe vaak ons model negatieve voorbeelden onterecht als positief classificeert. Het meet de proportie van werkelijk negatieve voorbeelden die door het model ten onrechte als positief worden geïdentificeerd, en geeft daarmee de mate van valse alarmen aan. Wiskundig kan dit als volgt worden uitgedrukt.
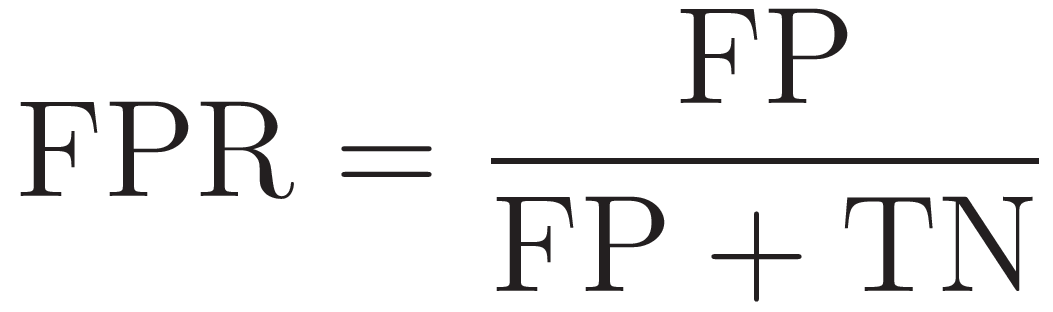
Waarbij:
Laten we situaties bekijken waarin AUC-ROC een relevantere metric is.
AUC-ROC geeft een geaggregeerde prestatiemaat over alle mogelijke classificatiedrempels. In tegenstelling tot accuracy, precision of F1-score, die afhankelijk zijn van een specifieke drempel, kijkt AUC-ROC naar de modelprestatie bij verschillende operating points.
AUC-ROC is een enkele scalair, waardoor het eenvoudiger wordt om meerdere modellen te vergelijken, ongeacht hun classificatiedrempels. Door het drempelonafhankelijke karakter kun je eerlijker vergelijken tussen modellen met verschillende optimale drempels.
De meeste datasets in de praktijk zijn onevenwichtig: de ene klasse komt veel vaker voor dan de andere, bijvoorbeeld bij sentimentanalyse, fraudedetectie en kankerdetectie. In zulke gevallen geeft een maatstaf als accuracy een misleidend beeld van de modelprestatie, omdat deze bevooroordeeld is richting de meerderheidsklasse. Maatstaven zoals AUC-ROC zijn in dit soort scenario’s betrouwbaarder.
Laten we enkele kernideeën doornemen.
Om de ROC-curve tot leven te brengen, berekenen we TPR en FPR bij verschillende drempels. We beginnen met het importeren van de bibliotheken die we voor deze demo nodig hebben.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt
Vervolgens genereren we een binaire classificatiedataset met de functie make-classification(), met 1000 samples en 20 features.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)
Laten we de dataset opdelen in trainings- en testdata–we trainen het model op de trainingsset en meten de prestaties op de onzichtbare testset.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
Daarna definiëren we het modelobject door de klasse LogisticRegression() aan te roepen en trainen we het met de methode fit op de trainingsdata, waarbij X_train de features bevat en y_train de labels vertegenwoordigt.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)
Nu is het model getraind en klaar om voorspellingen te genereren. We roepen de functie predict_proba() aan om de kans op de positieve klasse te genereren. We gebruiken de methode predict() om evaluatiemaatstaven zoals accuracy, precision, recall en F1-score te berekenen.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]

# Predict the classes for the test set
y_pred = model.predict(X_test)
Vervolgens berekenen en printen we al deze maatstaven met hun respectieve functies.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)

# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")
AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Laten we nu de ROC-curve visualiseren, samen met de diagonale lijn die een random model voorstelt. Hiervoor hebben we FPR en TPR nodig voor elke discrete drempel tussen 0 en 1. In de onderstaande grafiek stelt de oranje curve de ROC voor en het gebied onder deze curve is 0,93.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)

plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()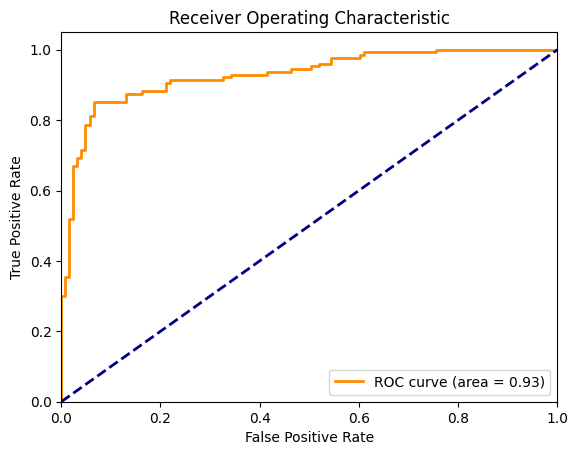
ROC-curve voor logistic regression. Afbeelding door de auteur
Laten we nu dezelfde dataset gebruiken en de prestaties van vier classificatie-algoritmen vergelijken met behulp van ROC. We beginnen met het importeren van de RandomForestClassifier, KNeighborsClassifier en SVC en vergelijken deze met de LogisticRegression.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# Define the models
models = {
    "Logistic Regression": LogisticRegression(),
    "Random Forest": RandomForestClassifier(),
    "SVM": SVC(probability=True),
    "K-Nearest Neighbors": KNeighborsClassifier()
}

# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}

# Plot the ROC curves
plt.figure(figsize=(10, 8))

for name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)

    # Predict the probabilities
    y_probs = model.predict_proba(X_test)[:, 1]

    # Calculate the AUC - ROC score
    roc_auc = roc_auc_score(y_test, y_probs)
    roc_auc_scores[name] = roc_auc

    # Compute ROC curve
    fpr, tpr, _ = roc_curve(y_test, y_probs)

    # Plot ROC curve
    plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')

# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')

# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()

# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
    print(f'{name}: AUC - ROC = {score:.2f}')
Voor elk modelobject herhalen we fit() en predict_proba(), berekenen we de bijbehorende FPR en TPR en plotten we de respectieve curves.
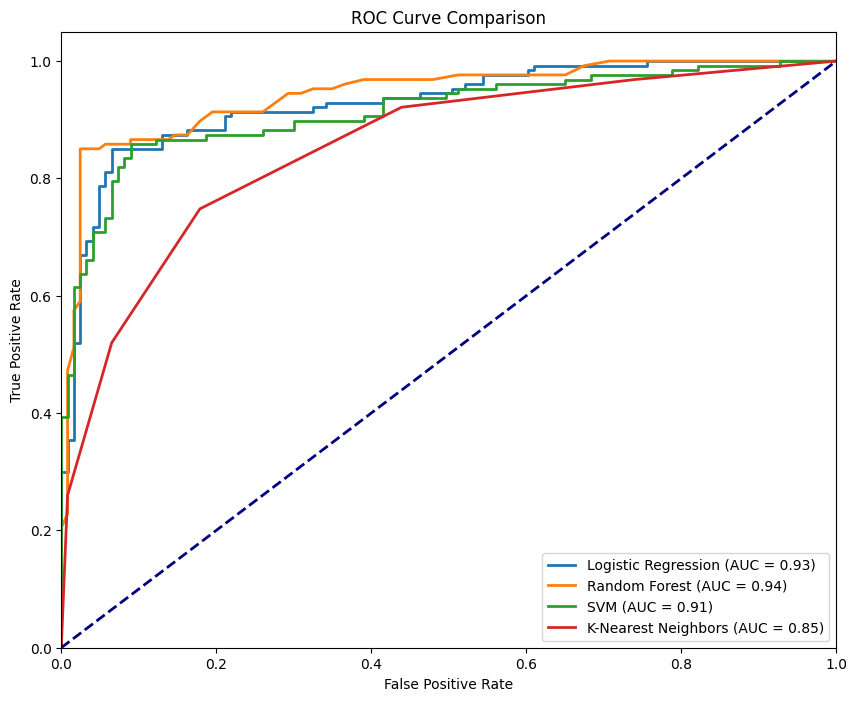
ROC-curve voor verschillende modellen. Afbeelding door de auteur
De bovenstaande figuur toont de vier curves die horen bij de vier classificators. De RandomForestClassifier presteert het best met een AUC-ROC van 0,94, terwijl de KNeighborsClassifier het minst presteert met een AUC-ROC van 0,85. Een ideaal model klemt zich tegen de linkerbovenhoek van de plot—waar TPR gemaximaliseerd en FPR geminimaliseerd is. Hoe dichter de curve dit punt nadert, hoe beter de modelprestatie.
Laten we de maatstaven die de AUC-ROC-curve biedt uitsplitsen en hun betekenis begrijpen.
AUC-waarden geven snel inzicht in hoe goed het model presteert. Als AUC dicht bij 1 ligt, is ons model op z’n best. Het laat uitstekende prestaties zien met een sterk onderscheidend vermogen tussen klassen. Een AUC rond 0,5 is zorgelijk, omdat dit aangeeft dat het model niet beter presteert dan willekeurig gokken en dus geen onderscheidend vermogen heeft. Een AUC-score dichter bij 0 is alarmerend en duidt erop dat het model het volledig verkeerd heeft, zelfs slechter dan een muntopgooi.
TPR, of sensitiviteit, is een cruciale maat die aangeeft hoe goed ons model de positieve gevallen oppikt. TPR wordt berekend als het aandeel werkelijk positieven dat door het model correct is geïdentificeerd. Het is een belangrijke indicator voor het vermogen van ons model om de echte signalen (positieven) te detecteren. Een hoge TPR betekent dat ons model het belangrijkste goed herkent.
Aan de andere kant helpt FPR ons de ruis te begrijpen—hoe vaak ons model negatieven ten onrechte als positief aanmerkt. FPR is de proportie werkelijk negatieven die ons model onterecht als positief bestempelt. Het is een essentiële maat om de trade-offs van ons model te beoordelen. Een hoge FPR wijst op een neiging tot valse alarmen, wat kostbaar kan zijn afhankelijk van de toepassing.
De schoonheid en de uitdaging van binaire classificatie liggen in de drempelinstellingen; daarmee stemmen we de sensitiviteit (TPR) en specificiteit (1 - FPR) van ons model af. Door de drempel te tunen kunnen we bepalen hoe gevoelig ons model is voor het detecteren van positieve gevallen en het aantal false positives terugdringen. In de meeste praktijksituaties kunnen de kosten van false negatives (een positieve missen) en false positives (valse alarmen) sterk verschillen.
AUC-ROC is niet alleen een theoretisch concept; zo wordt deze praktische metric in verschillende sectoren gebruikt om cruciale beslissingen te ondersteunen:
AUC-ROC wordt gebruikt om verschillende diagnostische tests te vergelijken. Het is vooral nuttig wanneer de kosten van false negatives (bijvoorbeeld een ziekte missen) veel hoger kunnen zijn dan die van false positives (bijvoorbeeld onnodige behandeling). Een sprekend voorbeeld is kankerscreening, waar de drempel voor vervolgonderzoek kan worden aangepast op basis van risicofactoren en beschikbare middelen.
Machinelearningmodellen worden steeds vaker gebruikt om frauduleuze activiteiten in de financiële sector op te sporen. Aangezien fraudetransacties relatief zeldzaam zijn, zijn dergelijke datasets sterk onevenwichtig. Daarom is AUC-ROC een effectieve evaluatiemetric die het bovendien mogelijk maakt om de drempel aan te passen op basis van verschillende factoren, zoals de omvang van het risico van de transactie, de kosten van handmatige verificatie en de kosten van klantongemak.
Net als bij fraudedetectie zijn cyberaanvallen relatief zeldzame gebeurtenissen. Daarom wordt AUC-ROC ook toegepast in cybersecurity, om het evenwicht te vinden tussen het detecteren van dreigingen en het voorkomen van alarmermoeheid door false positives.
AUC-ROC is een populaire metric voor het evalueren van binaire classificatiemodellen, maar er zijn situaties waarin alternatieve maatstaven geschikter zijn. Laten we enkele alternatieven verkennen en wanneer je ze gebruikt:
De precision-recall-curve (PRC) is een metric voor onevenwichtige datasets die de waarde van het machinelearningmodel sterk beïnvloedt wanneer false positives en false negatives verschillende kosten hebben. In tegenstelling tot AUC-ROC, die bij onevenwichtige datasets een misleidend optimistisch beeld kan geven, focust PRC meer op prestaties ten aanzien van de positieve klasse.
De F1-score is het harmonisch gemiddelde van precision en recall en geeft een enkele maat die beiden balanceert. Je gebruikt deze wanneer je een duidelijke, eenduidige samenvatting van de modelprestatie nodig hebt, vooral bij onevenwichtige datasets. AUC-ROC geeft een globaler beeld, terwijl F1 een specifiek punt op de PRC-curve is.
AUC-ROC is een gouden standaard bij binaire classificatieproblemen, omdat het een evenwichtiger beeld geeft van hoe goed het model presteert over verschillende drempels, vooral in scenario’s met klasse-imbalans.
Wij geloven dat je het beste leert door praktisch aan de slag te gaan. De veelzijdigheid van Python biedt de perfecte kans om essentiële concepten te beheersen. Of we nu onze basis opfrissen of meer geavanceerde onderwerpen verkennen, dit is het ideale moment om erin te duiken. Laten we onze Python-basiskennis herzien en onszelf uitdagen door met AUC-ROC op complexe datasets te werken.
Leer Python en statistiek met DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

